
tocreator/tostore has 67 GitHub stars and 11 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-15 04:06 UTC. Last push 2026-11-05.
できること
- Declarative schema changes—automatic refactoring, no manual versioning
- Key rotation, schema migration, massive refactoring—all online, business-transparent
- Built-in status spec for automated O&M and Agent recognition
- Supports autonomous evolution and continuous iteration without interrupting service
計測したスター増加
- 24時間
- 0
- 7日間
- 0
- 15日間
- 履歴を収集中
- 1か月
- 履歴を収集中
期間ごとの純増数です。期間は重複しており、日別の値ではありません。未計測の値は空欄です。スター数は注目度の指標であり、品質の保証ではありません。
概要
Data engine: AI vector & SQL/NoSQL database. Key-value/KV, embeddings, BM25 full-text, hybrid & semantic search for RAG/LLM. Local storage, TTL/LRU cache, offline encrypted.
AIdoc/translations/ja/README.md
オリジナル


English | 简体中文 | 日本語 | 한국어 | Español | Português (Brasil) | Русский | Deutsch | Français | Italiano | Türkçe
クイックナビゲーション
- ストアする理由 | 【主な特長】(#key-features) | インストールガイド | KVモード | テーブルモード | メモリーモード
- スキーマ定義 | 分散アーキテクチャ | カスケード外部キー | モバイル/デスクトップ | サーバー/エージェント | 主キーのアルゴリズム
- 高度なクエリ (JOIN) | 集計と統計 | 複雑なロジック(QueryCondition) | リアクティブクエリ (監視) | ストリーミングクエリ
- KV高度な操作 | 一括操作 | リカバリ保証 | ハイブリッド検索(密 / 疎 / テキスト) | テーブルレベル TTL | 容量エビクション | 効率的なページネーション | メモリプローブと同期検索 (peek) | クエリキャッシュ | 原子式 | 【取引】(#transactions)
- 管理 | セキュリティ設定 | エラー処理 | パフォーマンスと診断 | 貢献 | AI コーディング支援
ToStore を選ぶ理由
ToStore は、AGI 時代とエッジ インテリジェンス シナリオ向けに設計された最新のデータ エンジンです。Self-Routing ノード アーキテクチャに基づき、ノードに高い自律性と柔軟な水平スケーラビリティを与え、パフォーマンスとデータ規模を論理的に切り離します——エッジとクラウドの単一ノードは、構造化テーブルで兆件超、ベクトル/疎テキスト検索でも 100 億件超規模を想定して設計されています。
ランタイム モデリングと非ブロッキング実行パスにより、アーキテクチャの進化は常にオンラインでビジネスに完全に透過的です——宣言的スキーマ変更、データエンコーディングキーのローテーション、大規模なデータリファクタリングはすべてオンラインでシームレスに実行されます。エージェントと自動運用向けに、ランタイムでのテーブル作成、動的なメモリ進化、およびそれらによる自律的な進化と継続的なイテレーションを支え、サービスは中断しません。
関係型の構造化データ、密ベクトル、ニューラル疎ベクトル、非構造化テキストを単一エンジンに統合し、語彙テキスト検索・密ベクトル検索・ニューラル疎検索・多路リコール融合を内蔵します。あわせて ACID トランザクション、複雑な関係クエリ(JOIN、カスケード外部キー)、テーブル レベル TTL、集計、分散主キー アルゴリズム、アトミック式、暗号化、マルチスペース分離、自己修復リカバリなど、エンタープライズグレードの能力を備えます。
コンピューティングがエッジ インテリジェンスに移行し続ける中、デバイスはもはや単なる「コンテンツ ディスプレイ」ではなく、ローカル生成、環境認識、リアルタイムの意思決定、調整されたデータフローを担うインテリジェント ノードです。ToStore はエッジに大規模データセットと複雑なローカル AI 生成を支える分散機能を提供し、エッジとクラウドの深いインテリジェント コラボレーションにより、マルチモーダル対話、長期メモリ、RAG とローカル知識ベース、ハイブリッド検索、空間モデリング、エッジ自律連携などのシナリオに信頼できるデータ基盤を提供します。
主な機能
🤖 ランタイム進化とインテリジェント運用
- 宣言的スキーマ変更——自動リファクタリング、手動バージョン管理不要
- キーローテーション、スキーマ移行、大規模リファクタリング——すべてオンライン、ビジネス透過
- 自動運用とエージェント認識のためのステータス仕様を内蔵
- サービスを中断せず、自律的な進化と継続的なイテレーションを支援
🧠 Self-Routing 分散アーキテクチャ
- 物理アドレッシングとデータ規模を切り離す Self-Routing ノードアーキテクチャ
- 高度に自律的なノードが連携して柔軟なデータトポロジを構築
- 弾力的な水平スケーリング;単一ノードは表で兆件超、ベクトルで 100 億件超
🌐 統合クロスプラットフォーム データエンジン
- モバイル、デスクトップ、Web、サーバー環境にわたる統合 API
- 関係データ、密 / ニューラル疎ベクトル、テキスト検索をカバー
- ローカルストレージからエッジクラウドコラボレーションまでの完全なデータパイプライン
🔍 構造化クエリとハイブリッド検索
- 複雑な条件、JOIN、集計、テーブルレベル TTL、および容量エビクション(FIFO / LRU)
- 語彙テキスト・密ベクトル・ニューラル疎検索を同一クエリチェーンで組み合わせ
- 多路リコール融合ランキング。スコアとチャネル診断を結果とともに返却
⚡ 並列実行とリソーススケジューリング
- コールドスタートはデータ規模に依存せず約 35 ms を維持
- リソース認識の負荷スケジューリング;マルチノード並列タスク分解
- 高負荷時でも UI アニメーションをスムーズに保つタイムスライシング
🔐 オフライン優先とプライバシー
- データを端末に保持しオフラインでも利用可能——クラウド依存と漏洩面を低減
- マルチスペース分離とオプションのグローバル共有、マルチユーザー・マルチテナントに対応
- ChaCha20-Poly1305 および AES-256-GCM 暗号化を内蔵
- 複数の複雑なディザスタリカバリシナリオにより検証済み
インストール
[!IMPORTANT] v2.x からアップグレードしますか? 重要な移行手順と重大な変更については、v3.x アップグレード ガイド をお読みください。
tostore を pubspec.yaml に追加します。
dependencies:
  tostore: any # Please use the latest version
For AI Coding Assistants
AI アシスタントで ToStore のクライアントコードを生成する場合は、単一ファイルの仕様 llms-full.txt を渡してください。IDE で @llms-full.txt、ファイルのアップロード/貼り付け、または raw URL をアシスタントのドキュメントに登録する方法があります。API シグネチャ、制約、アンチパターンが含まれ、公開 API に沿った出力を助けます。索引:llms.txt。
クイックスタート
[!TIP] ストレージ モードはどのように選択すればよいですか?
- Key-Value モード (KV): 構成アクセス、分散状態管理、または JSON データ ストレージに最適です。これが最も早く始める方法です。
- 構造化テーブル モード: 複雑なクエリ、制約の検証、または大規模なデータ ガバナンスを必要とするコア ビジネス データに最適です。整合性ロジックをエンジンにプッシュすることで、アプリケーション層の開発とメンテナンスのコストを大幅に削減できます。
- メモリ モード: 一時的な計算、単体テスト、有界インメモリキャッシュ(TTL と FIFO / LRU 容量エビクション)、または 超高速のグローバル状態管理に最適です。グローバル クエリと
watchリスナーを使用すると、大量のグローバル変数を維持することなく、アプリケーションの対話を再構築できます。
キーバリューストレージ (KV)
このモードは、事前定義された構造化テーブルが必要ない場合に適しています。シンプルで実用的で、高性能ストレージ エンジンを搭載しています。 その効率的なインデックス作成アーキテクチャにより、非常に大規模なデータ規模の通常のモバイル デバイスでもクエリ パフォーマンスが非常に安定し、非常に応答性が高くなります。 異なるスペース内のデータは自然に分離され、グローバル共有もサポートされます。
// Initialize the database
final db = await ToStore.open();

// Set key-value pairs (supports String, int, bool, double, Map, List, Json, and more)
await db.setValue('user_profile', {
  'name': 'John',
  'age': 25,
});

// Switch space - isolate data for different users
await db.switchSpace(spaceName: 'user_123');

// Set a globally shared variable (isGlobal: true enables cross-space sharing, such as login state)
await db.setValue('current_user', 'John', isGlobal: true);

// Automatic expiration cleanup (TTL)
// Supports either a relative lifetime (ttl) or an absolute expiration time (expiresAt)
await db.setValue('temp_config', 'value', ttl: Duration(hours: 2));
await db.setValue('session_token', 'abc', expiresAt: DateTime(2026, 2, 31));

// Read data
final profile = await db.getValue('user_profile'); // Map<String, dynamic>

// Listen for real-time value changes (useful for refreshing local UI without extra state frameworks)
db.watchValue('current_user', isGlobal: true).listen((value) {
  print('Logged-in user changed to: $value');
});

// Listen to multiple keys at once
db.watchValues(['current_user', 'login_status']).listen((map) {
  print('Multiple config values were updated: $map');
});

// Remove data
await db.removeValue('current_user');
[!TIP] より多くの鍵値ペア機能が必要ですか? 型安全な読み取り(
getInt、getBool)、アトミックインクリメント、プレフィックス検索、チェーン式のページネーション付きレコードクエリ(db.kv.query())などの高度な操作については、鍵値ペアの高度な操作 (db.kv) を参照してください。
Flutter UI 自動更新の例
Flutter では、StreamBuilder と watchValue により、非常に簡潔なリアクティブな更新フローが得られます。
StreamBuilder(
  // When listening to a global variable, remember to set isGlobal: true
  stream: db.watchValue('current_user', isGlobal: true),
  builder: (context, snapshot) {
    // snapshot.data is the latest value of 'current_user' in KV storage
    final user = snapshot.data ?? 'Not logged in';
    return Text('Current user: $user');
  },
)
構造化テーブルモード
構造化テーブルの CRUD では、スキーマを事前に作成する必要があります (スキーマ定義 を参照)。さまざまなシナリオに推奨される統合アプローチ:
- モバイル/デスクトップ: 頻繁に起動するシナリオ の場合、初期化中に
schemasを渡すことをお勧めします。 - サーバー/エージェント: 長時間実行シナリオ の場合は、
createTablesを通じてテーブルを動的に作成することをお勧めします。
// 1. Initialize the database
final db = await ToStore.open();

// 2. Insert data (prepare some base records)
final result = await db.insert('users', {
  'username': 'John',
  'email': '[email protected]',
  'age': 25,
});

// Unified operation result model: DbResult
// It is recommended to check hasErrors
if (!result.hasErrors) {
  print('Insert succeeded, generated primary key ID: ${result.firstPrimaryKey}');
} else {
  print('Insert failed: ${result.message}');
}

// Chained query (see [Query Operators](#query-operators); supports =, !=, >, <, LIKE, IN, and more)
final users = await db.query('users')
    .where('age', '>', 20)
    .where('username', 'like', '%John%')
    .orderByDesc('age')
    .limit(20);

// Update and delete
await db.update('users', {'age': 26}).where('username', '=', 'John');
await db.delete('users').where('username', '=', 'John');

// Real-time listening (see [Reactive Query](#reactive-query) for more details)
db.query('users').where('age', '>', 18).watch().listen((users) {
  print('Users matching the condition have changed: $users');
});

// Pair with Flutter StreamBuilder for automatic local UI refresh
StreamBuilder(
  stream: db.query('users').where('age', '>', 18).watch(),
  builder: (context, snapshot) {
    final users = snapshot.data ?? [];
    return ListView.builder(
      itemCount: users.length,
      itemBuilder: (context, index) => Text(users[index]['username']),
    );
  },
);
メモリモード
キャッシュ、一時的な計算、ディスクへの永続化を必要としないワークロードなどのシナリオの場合は、ToStore.memory() を介して純粋なインメモリ データベースを初期化できます。このモードでは、読み取り/書き込みパフォーマンスを最大限に高めるために、スキーマ、インデックス、キーと値のペアを含むすべてのデータが完全にメモリ内に存在します。
メモリモードでも複数の淘汰戦略を使えます。時間ベースのテーブルレベル TTL / KV TTL と、件数・サイズベースの容量エビクション(FIFO / LRU)。単独でも併用でも、ホットデータを期限切れにしたり上限内に保てます—セッションキャッシュやクエリ結果プールなど、メモリに敏感な用途に最適です。
💡 グローバル状態管理としても機能します
大量のグローバル変数や強力な状態管理フレームワークは必要ありません。メモリ モードと watchValue または watch() を組み合わせると、ウィジェットやページ全体で完全に自動の UI 更新を実現できます。データベースの強力な検索機能を維持しながら、通常の変数をはるかに超えた反応的なエクスペリエンスを提供するため、ログイン状態、ライブ構成、またはグローバル メッセージ カウンターに最適です。
[!CAUTION] 注意: ピュア メモリ モードで作成されたデータは、アプリを閉じるか再起動すると完全に失われます。コアビジネスデータには使用しないでください。
// Pure in-memory DB — TTL and/or FIFO/LRU capacity eviction as needed
final memDb = await ToStore.memory(
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
  ),
);

// Set a global state value (for example: unread message count)
await memDb.setValue('unread_count', 5, isGlobal: true);

// Listen from anywhere in the UI without passing parameters around
memDb.watchValue<int>('unread_count', isGlobal: true).listen((count) {
  print('UI automatically sensed the message count change: $count');
});

// All CRUD, KV access, and vector search run at in-memory speed
await memDb.insert('active_users', {'name': 'Marley', 'status': 'online'});
スキーマ定義
一度定義すれば、エンジンがエンドツーエンドの自動ガバナンスを処理できるため、アプリケーションは重度の検証メンテナンスを行う必要がなくなります。
次のモバイル、サーバー側、およびエージェントの例はすべて、ここで定義された appSchemas を再利用します。
TableSchema の概要
const userSchema = TableSchema(
  name: 'users', // Table name, required
  tableId: 'users', // Unique identifier of the table, optional
  primaryKeyConfig: PrimaryKeyConfig(
    name: 'id', // Primary key field name, defaults to id
    type: PrimaryKeyType.sequential, // Primary key auto-generation strategy
    sequentialConfig: SequentialIdConfig(
      initialValue: 1000, // Initial value for sequential IDs
      increment: 1, // Step size
      useRandomIncrement: false, // Whether to use random step sizes
    ),
  ),
  fields: [
    FieldSchema(
      name: 'username', // Field name, required
      type: DataType.text, // Field data type, required
      nullable: false, // Whether null is allowed
      minLength: 3, // Minimum length
      maxLength: 32, // Maximum length
      unique: true, // Whether it must be unique
      fieldId: 'username', // Stable field identifier, optional, used to detect field renames
      comment: 'Login name', // Optional comment
    ),
    FieldSchema(
      name: 'status',
      type: DataType.integer,
      minValue: 0, // Minimum numeric value
      maxValue: 150, // Maximum numeric value
      defaultValue: 0, // Static default value
      createIndex: true, // Shortcut for creating an index
    ),
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      defaultValueType: DefaultValueType.currentTimestamp, // Automatically fill with current time
      createIndex: true,
    ),
  ],
  indexes: const [
    IndexSchema(
      indexName: 'idx_users_status_created_at', // Optional index name
      fields: ['status', 'created_at'], // Composite index fields
      unique: false, // Whether it is a unique index
      type: IndexType.btree, // Index type: btree/vector
    ),
  ],
  foreignKeys: const [], // Optional foreign-key constraints; see "Foreign Keys & Cascading"
  isGlobal: false, // Whether this is a global table; true means it can be shared across spaces
  ttlConfig: null, // Optional table-level TTL; see "Table-level TTL"
  capacityConfig: null, // Optional capacity eviction; see "Capacity Eviction"
);

const appSchemas = [userSchema];
一般的な
DataTypeマッピング:タイプ 対応ダーツタイプ 説明 integerintID、カウンタ、および同様のデータに適した標準整数 bigIntBigInt/String大きな整数。数値が 18 桁を超える場合は、精度の低下を避けるために推奨されます。 doubledouble価格、座標、および同様のデータに適した浮動小数点数 textStringオプションの長さ制限のあるテキスト文字列 blobUint8List生のバイナリデータ booleanboolブール値 datetimeDateTime/String日付/時刻。 ISO8601 として内部的に保存 arrayListリストまたは配列型 jsonMap<String, dynamic>JSON オブジェクト、動的構造化データに適しています vectorVectorData/List<num>意味近傍検索向け密ベクトル(Embedding) sparseSparseVectorData疎検索向けニューラル疎ベクトル PrimaryKeyType自動生成戦略:戦略 説明 特徴 none自動生成なし 挿入時に主キーを手動で指定する必要があります。 sequential順次増分 人間に優しい ID には適していますが、分散パフォーマンスにはあまり適していません。 timestampBasedタイムスタンプベース 分散環境に推奨 datePrefixed日付の接頭辞付き 日付の読みやすさがビジネスにとって重要な場合に役立ちます shortCodeショートコードの主キー コンパクトで外部ディスプレイに最適
すべての主キーはデフォルトで
text(String) として保存されます。
制約と自動検証
共通の検証ルールを FieldSchema に直接記述して、アプリケーション コード内のロジックの重複を避けることができます。
nullable: false: 非null制約minLength/maxLength: テキストの長さの制限minValue/maxValue: 整数または浮動小数点の範囲制約defaultValue/defaultValueType: 静的デフォルト値と動的デフォルト値unique: 一意の制約createIndex: 高頻度のフィルタリング、並べ替え、または関係のためのインデックスを作成します。fieldId/tableId: 移行中のフィールドおよびテーブルの名前変更検出を支援します。
さらに、unique: true は単一フィールドの一意のインデックスを自動的に作成します。 createIndex: true と外部キーは、単一フィールドの通常のインデックスを自動的に作成します。複合インデックス、名前付きインデックス、またはテキスト / 疎 / ベクトル検索インデックスが必要な場合は、indexes を使用します。
スキーマの進化 (Schema Evolution)
エンジンは表構造の変更(テーブル/フィールドの追加・削除・名前変更、属性の更新、インデックス変更など)を自動検出し、データ移行を完了します。手動でのバージョン管理や移行スクリプトは不要です。宣言的な schemas は ToStore.open() 時に進化し、実行時は updateSchema でも変更できます——ビジネスロジックに透過的で、読み書きは中断されません。
一意フィールドの主キー昇格
既存の一意かつ非 nullフィールドを主キーに昇格できます(名前変更可;既存データありでも可;ビジネス透過)。setPrimaryKeyConfig と同時に変更しないでください。
- モバイル(宣言的
schemas):ToStore.open()時に自動検出。対象主キーは必ずPrimaryKeyType.none(値は元の一意フィールドから取得;他の自動生成タイプは非対応)。名前が同じなら名称一致でよく、リネーム時はfromFieldIdに元フィールドのfieldIdを指定します。 - サーバー(実行時):
updateSchema(...).promoteFieldToPrimaryKey(sourceFieldName: ..., targetPrimaryKeyName: ...)を呼び出します。targetPrimaryKeyNameは任意で、省略すると元フィールド名を維持します。
統合方法の選択
- モバイル/デスクトップ:
appSchemasをToStore.open(...)に直接渡す場合に最適です。 - サーバー/エージェント:
createTables(appSchemas)を介して実行時にスキーマを動的に作成する場合に最適です。
モバイル、デスクトップ、その他の頻繁な起動シナリオのための統合
import 'package:path/path.dart' as p;
import 'package:path_provider/path_provider.dart';

// On Android/iOS, resolve the app's writable directory first, then pass dbPath explicitly
final docDir = await getApplicationDocumentsDirectory();
final dbRoot = p.join(docDir.path, 'common');

// Reuse the appSchemas defined above
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
);

// Multi-space architecture - isolate data for different users
await db.switchSpace(spaceName: 'user_123');
スタートアップ進捗の追跡
通常のスキーマ変更はビジネスロジックに影響を与えず、起動をブロックしません。モバイルアプリを頻繁に強制終了するなど、まれな特殊ケース(異常終了後の短時間のデータ検証やクラッシュ回復)でのみ、起動に時間がかかることがあります。その際は onStartupProgress を使用してスプラッシュスクリーンやプログレスインジ케이터を表示できます:
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
  onStartupProgress: (progress, stage) {
    // progress: 0.0 – 1.0  |  stage: opening → recovering → optimizing → ready
    print('起動進捗 ${(progress * 100).toStringAsFixed(0)}% [$stage]');
    // スプラッシュスクリーン / プログレスバーを更新
  },
);
// データベースは完全に準備完了
各ステージ:
opening— 設定を読み込み、基本エンジンを準備recovering— セキュリティチェックとクラッシュリカバリoptimizing— 内部エンジンのチューニングと構造の最適化ready— 初期化完了、使用可能
ログイン状態の維持とログアウト (アクティブ スペース)
マルチスペースは ユーザー データの分離に最適です。ユーザーごとに 1 つのスペースがあり、ログインがオンになります。 アクティブ スペース と閉じるオプションを使用すると、アプリを再起動しても現在のユーザーを保持し、クリーンなログアウト動作をサポートできます。
- ログイン状態を維持: ユーザーを自分のスペースに切り替えた後、そのスペースをアクティブとしてマークします。次回の起動では、デフォルトのインスタンスを開いたときに、「最初にデフォルトを選択してから切り替える」手順を行わずに、そのスペースに直接入ることができます。
- ログアウト: ユーザーがログアウトするときは、
keepActiveSpace: falseを使用してデータベースを閉じます。次回の起動では、前のユーザーのスペースには自動的には入りません。
// After login: switch to the user's space and mark it active
await db.switchSpace(spaceName: 'user_$userId', keepActive: true);

// Optional: strictly stay in default when needed (for example, login screen only)
// final db = await ToStore.open(..., applyActiveSpaceOnDefault: false);

// On logout: close and clear the active space so the next launch starts from default
await db.close(keepActiveSpace: false);
サーバー側/エージェントの統合 (長期実行シナリオ)
🖥️ 例: server_quickstart.dart
final db = await ToStore.open();

// Create table structures while the process is running
await db.createTables(appSchemas);

// Online schema updates
final result = await db.updateSchema('users')
  .renameTable('users_new')                // Rename table
  .modifyField(
    'username',
    minLength: 5,
    maxLength: 20,
    unique: true
  )                                        // Modify field attributes
  .renameField('old_name', 'new_name')     // Rename field
  .removeField('deprecated_field')         // Remove field
  .addField('created_at', type: DataType.datetime)  // Add field
  .removeIndex(fields: ['age'])            // Remove index
  .setPrimaryKeyConfig(                    // Change auto-generated PK strategy; avoid when the table already has data
    const PrimaryKeyConfig(type: PrimaryKeyType.shortCode)
  );
// Promote a unique field to PK (see "Promote a Unique Field to Primary Key"; do not chain with the above):
// await db.updateSchema('users').promoteFieldToPrimaryKey(
//   sourceFieldName: 'user_id',
//   targetPrimaryKeyName: 'uid', // optional; omit to keep the source field name
// );

// Monitor migration progress
final taskId = result.taskId;
if (taskId != null) {
  // Inspect migration metadata
  print('Estimated duration: ${result.estimateDuration?.inMilliseconds} ms');
  print('Migration write mode: ${result.writeMode}'); // e.g. MigrationWriteMode.indexOnly

  final status = await db.queryMigrationTaskStatus(taskId);
  print('Migration progress: ${status?.progressPercentage}%');
}


// Optional performance tuning for pure server workloads
// yieldDurationMs controls how often long-running work yields time slices.
// The default is tuned to 8ms to keep frontend UI animations smooth.
// In environments without UI, 50ms is recommended for higher throughput.
final dbServer = await ToStore.open(
  config: DataStoreConfig(yieldDurationMs: 50),
);
高度な使用法
ToStore は、複雑なビジネス シナリオに対応する高度な機能の豊富なセットを提供します。
鍵値ペアの高度な操作 (db.kv)
より複雑な Key-Value シナリオでは、db.kv 名前空間の使用をお勧めします。これは、スペースの分離、グローバル共有、複数のデータ型、およびチェーン式の複雑なクエリ/フィルタ(例: db.kv.query().prefix(...).orderBy...().limit(...) によるページネーション、ソート、期限切れフィルタなど)をサポートする完全な API セットを提供します。
基本的なアクセス (Basic Access)
// 値を設定 (String, int, bool, double, Map, List などをサポート)
await db.kv.set('key', 'value', ttl: Duration(hours: 1));

// 生の動的な値を取得
dynamic val = await db.kv.get('key');

// 単一のキーを削除
await db.kv.remove('key');
型安全な取得 (Type-Safe Getters) 型を手動で変換することなく、ターゲット形式のデータを直接取得します:
String? name = await db.kv.getString('user_name');
int? age = await db.kv.getInt('user_age');
bool? isVip = await db.kv.getBool('is_vip');
Map<String, dynamic>? profile = await db.kv.getMap('profile');
List<String>? tags = await db.kv.getList<String>('tags');
一括操作 (Bulk Operations) 単一の操作で複数のキー値ペアを効率的に処理します:
// 一括設定
await db.kv.setMany({
  'theme': 'dark',
  'language': 'ja_JP',
});

// 一括削除
await db.kv.removeKeys(['temp_1', 'temp_2']);
アトミックカウンタ (Atomic Increment) 高並列シナリオで数値の増減を安全に行います:
// 1増やす (デフォルト値)
await db.kv.setIncrement('view_count');
// 5減らす (負数を渡してデクリメント)
await db.kv.setIncrement('stock_count', amount: -5);
チェーン式レコードクエリ (db.kv.query)
db.query()に類似したチェーン API で、キー値レコード(デコード済みのvalueを含む)をクエリし、ページネーションをサポートします。getKeys(キー名のみ)とは異なり、完全なレコードを返します。// 最初のページ: プレフィックスでフィルタ、更新日時の降順、1ページあたり 20 件 final page = await db.kv.query() .prefix('setting_') .orderByUpdatedAtDesc() // または orderByKeyAsc / orderByKeyDesc / orderByUpdatedAtAsc .limit(20); for (final record in page.data) { // record には: key, value, updated_at, expires_at が含まれる print('${record['key']} = ${record['value']}'); } // 推奨: next() / prev() でページ送り(テーブルクエリと同様、最も簡単) if (page.hasMore) { final page2 = await page.next(); print('次のページ: ${page2.data.length}'); if (page2.hasPrev) { final back = await page2.prev(); print('前のページ: ${back.data.length}'); } } // Offset ページネーション(cursor と排他; 深いページ送りには上の next() を推奨) final byOffset = await db.kv.query() .orderByKeyAsc() .limit(20) .offset(20); // 条件に一致するレコード総数(prefix なしの場合は O(1) メタデータ集計) final total = await db.kv.query().prefix('setting_').count(); // 最初の一致レコードを取得 final first = await db.kv.query().prefix('setting_').orderByKeyAsc().first(); // グローバル KV 空間 final globalPage = await db.kv.query(isGlobal: true).limit(50); // デフォルトでは期限切れレコードを除外; 未クリーンアップの期限切れを含める場合: final withExpired = await db.kv.query() .includeExpired() .limit(20);よく使うチェーンメソッド:
メソッド 説明 prefix(String)key プレフィックスでフィルタ orderByKeyAsc/orderByKeyDesckey(主キー)でソート orderByUpdatedAtAsc/orderByUpdatedAtDescupdated_atでソートlimit(n)1ページあたりの最大件数(常に明示することを推奨) offset(n)オフセットページネーション(cursor をクリア) cursor(token)特殊ケースのみ: プロセス/ネットワーク間でページネーション Token を渡す includeExpired([true])期限切れだが未クリーンアップのレコードを含めるか count()一致件数を集計 first()最初のレコードを返す(元の builder の limit には影響しない) クエリ結果
QueryResult: 日常のページ送りはhasMore/hasPrev+next()/prev();nextCursorToken/prevCursorTokenはクロスエンド転送などの特殊シナリオ向け(用法はテーブルクエリと同じ)。キー空間の探索と管理 (Discovery & Management)
// キー名のみを列挙(value は含まない); 任意で prefix / limit / offset
final keys = await db.kv.getKeys(prefix: 'setting_');
final pageKeys = await db.kv.getKeys(
  prefix: 'setting_',
  limit: 100,
  offset: 0,
);

// 現在の空間内のキー値ペアの総数を取得
final count = await db.kv.count();

// キーが存在し、期限切れでないか確認
final exists = await db.kv.exists('config_cache');

// メモリプローブ(同期、キャッシュヒット時のみ — [メモリプローブと同期検索 (peek)](#query-peek) を参照)
final theme = db.kv.peekGet('theme') ?? await db.kv.get('theme');
if (db.kv.peekExists('config_cache')) { /* ... */ }

// 現在の空間のすべての KV データをクリア
await db.kv.clear();
ライフサイクル管理 (TTL) 既存のキーの有効期限を取得または更新します:
// 残りの有効期限を取得
Duration? ttl = await db.kv.getTtl('token');

// 既存のキーの有効期限を更新(7日後に期限切れ)
await db.kv.setTtl('token', Duration(days: 7));
リアクティブ監視 (Reactive Watch)
// 単一のキーを監視
db.kv.watch<int>('unread_count').listen((count) => print(count));

// 複数のキーの変化スナップショットを監視
db.kv.watchValues(['theme', 'font_size']).listen((map) => print(map));
グローバル共有パラメータ (isGlobal) 上記のすべてのメソッドはオプションの引数
isGlobalをサポートしています:trueはグローバル空間(すべてのスペースで共有)での操作を、false(デフォルト)は現在の隔離されたスペースでの操作を表します。
一括操作 (Bulk Operations)
ToStore は、大規模なデータスループット向けに最適化された専用の一括処理インターフェースを提供します。これらのインターフェースは並列タスク分散とタイムスライススケジューリングを内蔵しており、高スループットの書き込みを実行する際に UI メインスレッドへの影響を効果的に低減できます。
| インターフェース | 主な用途 | データ要件 | 特徴 |
|---|---|---|---|
batchInsert |
複数レコードを一括挿入 | すべての非空フィールドが必要 | 純粋な挿入、最高効率 |
batchUpsert |
存在すれば更新、なければ一括挿入 | すべての非空フィールドが必要 | 全量同期、主キーまたは唯一のフィールドに基づく自動判定 |
batchUpdate |
既存レコードを一括局部更新 | 主キーまたは唯一のフィールド + 更新フィールド | 増量更新、既存レコードの変更に特化 |
一括挿入 (batchInsert)
await db.batchInsert('users', [
  {'username': 'user1', 'email': '[email protected]'},
  {'username': 'user2', 'email': '[email protected]'},
]);
インテリジェントな一括同期 (batchUpsert) 主キーまたは唯一のフィールドに基づいて「挿入」または「更新」を自動的に識別します。データの全量同期シナリオでよく使用されます。
[!IMPORTANT] データ要件: 挿入操作がトリガーされる可能性があるため、
batchUpsertは各レコードにすべての非空(nullable: false)フィールドが含まれている必要があります。高効率な一括更新 (batchUpdate) 既存レコードの更新に特化しています。各レコードには、識別子としての主キーまたは唯一のフィールドと、修正が必要なフィールドが含まれている必要があります。
[!TIP] 局部更新:
batchUpdateは提供されたフィールドのみを更新し、すべての非空フィールドを含める必要はないため、増量修正シナリオに適しています。await db.batchUpdate('users', [ {'username': 'john', 'age': 27}, // 唯一のフィールド username で特定して age を更新 {'id': '1002', 'status': 'active'}, // 主キーを直接指定することも可能 ]);
[!TIP]
allowPartialErrors: trueを設定することで、個別のデータエラー(単一レコードの衝突など)がバッチ操作全体を拒否しないようにできます。
データ書き込みリカバリ保証 (Recovery Durability)
ToStore は、**書き込み操作が結果を返す時点(await 完了時)**に備える自己修復リカバリレベルを柔軟に制御できます:
| レベル | 応答時のリカバリ保証 | 適用シナリオと特性 |
|---|---|---|
RecoveryDurability.standard(デフォルト推奨) |
応答前にクラッシュ自己修復保証 | アプリの異常終了、未処理の例外、およびシステムによる OOM 強制終了から保護。極めて高いスループットと日常業務の安全性を両立。 |
RecoveryDurability.durable |
応答前に停電耐性自己修復保証 | 物理ストレージへの強制同期を行ってから復帰。突然の停電やカーネルクラッシュ時でも完全自己修復。金融取引や重要監査データに最適。 |
RecoveryDurability.async |
超高速スループット(応答後非同期保存) | メモリキューに追加後直ちに応答。応答を返した後、少量のデータであれば通常わずか数ミリ秒の極めて短いデータ損失ウィンドウが存在するのみ。大量のログやメトリクスに最適。 |
1. グローバルデフォルト設定
データベース初期化時に DataStoreConfig でインスタンス全体のデフォルト復旧レベルを設定:
final db = await ToStore.open(
  config: DataStoreConfig(
    defaultRecoveryDurability: RecoveryDurability.standard, // デフォルト:応答前にクラッシュ耐性を保証
  ),
);
2. 単一操作レベルでの柔軟な上書き
構造化テーブル書き込み、バッチ操作、チェーン更新/削除、およびキー・バリューストア (KV) のすべてにおいて、オプション引数 durability による個別指定をサポート:
// 1. 構造化テーブル操作
await db.insert('orders', orderData, durability: RecoveryDurability.durable); // 重要注文:停電耐性
await db.batchInsert('logs', logList, durability: RecoveryDurability.async); // 大量ログ:高速非同期

// 2. チェーン更新および削除
await db.update('users', {'status': 'active'})
  .where('id', '=', userId)
  .durability(RecoveryDurability.durable);

// 3. キー・バリュー (KV) 操作
await db.setValue('token', tokenVal, durability: RecoveryDurability.standard);
await db.kv.set('session_id', 'xyz', durability: RecoveryDurability.async);
await db.kv.setMany(settingsMap, durability: RecoveryDurability.durable);
ベクトル、テキスト、ハイブリッド検索
語彙テキスト検索・密ベクトル検索・ニューラル疎検索は同一のクエリチェーン(matchText / matchVector / matchSparse)を共有します。同一チェーン上で構造化条件と組み合わせることも、多路融合することもできます。スコアとチャネル診断は QueryResult.retrieval で返され、data 行と 1:1 で対応します。主キーとスコアだけが必要な場合は .select(['id'])(または PK フィールド名)を優先し、エンジンが表側の完全行マテリアライズをスキップできるようにしてください。省略するとハイブリッド検索は完全レコード(大きな embedding を含む)を読み込み、スループットが大きく低下することがあります。フィルタや融合が不要な専用 ANN では、同じコア検索パスで db.vectorSearch(...) が List<VectorSearchResult>(主キー + スコア)を返します。
検索可視性:挿入/更新が成功を返した直後、通常インデックス・テキストインデックス・疎インデックスはすぐに検索に参加できます。ベクトルインデックスはスループットへの影響を避けるため書き込みに同梱構築せず、すぐには検索できません。検索に参加させたい場合は、業務バッチの後に await db.flush()(任意の便利 API)を実行し、完了後に matchVector / vectorSearch で利用できます。
await db.createTables([
  const TableSchema(
    name: 'documents',
    primaryKeyConfig: PrimaryKeyConfig(
      name: 'id',
      type: PrimaryKeyType.timestampBased,
    ),
    fields: [
      FieldSchema(name: 'content', type: DataType.text, nullable: false),
      FieldSchema(
        name: 'category',
        type: DataType.text,
        nullable: false,
        createIndex: true,
      ),
      FieldSchema(
        name: 'features',
        type: DataType.sparse, // Neural sparse vector
        nullable: false,
      ),
      FieldSchema(
        name: 'embedding',
        type: DataType.vector, // Dense vector
        nullable: false,
        vectorConfig: VectorFieldConfig(
          dimensions: 128, // Written and queried vectors must match this width
        ),
      ),
    ],
    indexes: [
      IndexSchema(fields: ['content'], type: IndexType.text), // Lexical text index
      IndexSchema(fields: ['features'], type: IndexType.sparse), // Neural sparse index
      IndexSchema(
        fields: ['embedding'],
        type: IndexType.vector, // Dense vector index
        vectorConfig: VectorIndexConfig(
          indexType: VectorIndexType.ngh, // NGH: ToStore built-in dense index
          distanceMetric: VectorDistanceMetric.cosine,
        ),
      ),
    ],
  ),
]);

final queryVector =
    VectorData.fromList(List.generate(128, (i) => i * 0.01));
final querySparse = SparseVectorData.fromMap({12: 0.8, 45: 0.6, 90: 0.3});

// 1) Lexical text retrieval (engine tokenizes TextQuery.text;
//    or use pre-tokenized TextQuery.terms / termsWeighted)
final textHits = await db
    .query('documents')
    .select(['id'])
    .matchText('content', TextQuery.text('distributed kernel storage'))
    .limit(5);

// 2) Neural sparse retrieval
final sparseHits = await db
    .query('documents')
    .select(['id'])
    .matchSparse('features', querySparse, minScore: 0.30)
    .limit(5);

// 3) Dense vector ANN (default searchDepth = 50)
final result = await db
    .query('documents')
    .select(['id'])
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

for (var i = 0; i < result.data.length; i++) {
  final record = result.data[i];
  final entry = result.retrieval?.entries[i];
  print('pk=${record['id']}, score=${entry?.score}, '
      'rawScore=${entry?.rawScore}, distance=${entry?.meta?['distance']}');
}

// 4) Structured filter + vector (AND)
final filtered = await db
    .query('documents')
    .whereEqual('category', 'tech')
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

// 5) Multi-way fusion: text + sparse + vector (default weightedScore)
final fused = await db
    .query('documents')
    .matchText('content', TextQuery.text('distributed storage'), weight: 0.4)
    .matchSparse('features', querySparse, weight: 0.3, minScore: 0.20)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .limit(10);
print('fusion=${fused.retrieval?.fusionMethod}'); // weightedScore

// Opt into rank-only fusion (relative scores — not absolute relevance bands)
final fusedRrf = await db
    .query('documents')
    .matchText('content', TextQuery.text('distributed storage'), weight: 0.4)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .fusionMethod(RetrievalFusionMethod.rrf)
    .limit(10);
print('fusion=${fusedRrf.retrieval?.fusionMethod}'); // rrf

// Dedicated ANN (PK + score only; no query chain / fusion)
final ann = await db.vectorSearch(
  'documents',
  fieldName: 'embedding',
  queryVector: queryVector,
  topK: 5,
  minScore: 0.40,
);
チャネル / スキーマ対応:
| チャネル | フィールド型 | インデックス | クエリ API | クエリ値 |
|---|---|---|---|---|
| 語彙テキスト | DataType.text |
IndexType.text |
matchText / orMatchText |
TextQuery.text / terms / termsWeighted |
| ニューラル疎 | DataType.sparse |
IndexType.sparse |
matchSparse / orMatchSparse |
SparseVectorData |
| 密ベクトル | DataType.vector |
IndexType.vector |
matchVector / orMatchVector |
VectorData など |
密ベクトル設定(VectorFieldConfig、VectorIndexConfig):
dimensions: 実際に書き込む埋め込み幅と一致する必要がありますindexType: 密ベクトルアルゴリズム識別子。現在はnghdistanceMetric: インデックス側の類似度メトリクス(構築と検索で共通)。cosineはセマンティック埋め込みに一般的、l2はユークリッド距離、innerProductは内積検索に適しています。データ書き込み後の変更は通常ベクトルインデックスの再構築が必要です。
チェーン検索パラメータ(各 match* / orMatch*、およびクエリチェーン上の limit):
- テキスト
TextQuery.text: エンジンがトークン化TextQuery.terms/termsWeighted: 事前トークン化済み。再トークン化なし。ラテン語トークンはインデックス側と一致させること(通常は小文字)operator:or(デフォルト、語彙の和集合でランキング)またはand(正の重みの語がすべてヒットしてからランキング)- フレーズ一致は非対応
- 疎
SparseVectorData/SparseVectorData.fromMap(...): 疎クエリベクトル- ドキュメント側の重みは
(0, 1]に収めるのが望ましい
- ベクトル
field/vector: 対象フィールドとクエリベクトルsearchDepth:>= 1、デフォルト50。大きいほど通常リコールとレイテンシが上がる。近似最近傍であり recall@K を保証しませんdistanceThreshold: 距離の上限
- 共通
weight: 多路融合ウェイト。デフォルト1.0minScore: 関連度の下限limit: 返却件数(topK).fusionMethod(...): 多路のデフォルトはweightedScore。rrfに切替可能
結果とスコアの説明(QueryResult / VectorSearchResult):
- 業務レコードは
data、検索スコアとチャネル情報はretrieval.entriesにあり、dataと 1:1 対応。主キーとスコアだけなら.select(['id'])を優先。 score(正規化関連度、0.0 ~ 1.0):テキスト / 疎 / ベクトルで統一(高いほど関連)。ベクトル完全自己一致は1.0。minScoreで強ヒットを残し弱ヒットを落とす。デフォルトの多路weightedScore融合は強い単一路ヒットを保持。テキストと疎は[0.0, 1.0)に収まる。rawScore: 非正規化物理量(コサイン / 内積 / L2 / テキスト強度)。下層メトリクスが必要ならrawScore/distance。entry.meta['distance']: ベクトルチャネルの ANN 距離(小さいほど近い)。retrieval.fusionMethod: 単一チャネルはnull;多路はデフォルトweightedScore(.fusionMethod(RetrievalFusionMethod.rrf)で切替可能)。- トップレベル
db.vectorSearch(...)は専用 ANN 向けにList<VectorSearchResult>(primaryKey/score/rawScore/distance)を返す。任意のminScoreはmatchVectorと同じ関連度下限(件数はtopK未満になり得る)。
関連度(score)と閾値リファレンス基線(単一チャネルおよび多路 weightedScore;rrf は対象外)。一般的な embedding(次元 ≥ 128)向け。低次元では弱い近傍も高得点になり得るため、必要に応じて minScore を上げるか rawScore を使ってください:
関連度(score) |
意味と典型シナリオ |
|---|---|
>= 0.85 |
同一エンティティ(顔認証、生体、厳密重複排除) |
>= 0.70 |
高信頼セマンティック(核心事実、精密 Q&A) |
>= 0.40 |
基本セマンティック関連(一般 RAG、幻覚抑制) |
>= 0.30 |
広い初回リコール(曖昧探索、再ランク候補池) |
< 0.30 |
弱い関連または背景ノイズ |
必要に応じてチャネル minScore で低関連ヒットをフィルタしてください。
テーブルレベルの TTL (時間ベースの自動有効期限)
ログ、テレメトリ、イベント、および時間の経過とともに期限切れになるその他のデータについては、ttlConfig を通じてテーブル レベルの TTL を定義できます。エンジンは期限切れのレコードをバックグラウンドで自動的にクリーンアップします。
const TableSchema(
  name: 'event_logs',
  fields: [
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      createIndex: true,
      defaultValueType: DefaultValueType.currentTimestamp,
    ),
  ],
  ttlConfig: TableTtlConfig(
    ttlMs: 7 * 24 * 60 * 60 * 1000, // 7日間保持
    // 新規テーブル / 初めて TTL を有効にする場合は必須:
    // 1) DataType.datetime  2) nullable: false
    // 3) DefaultValueType.currentTimestamp
    sourceField: 'created_at',
  ),
);
容量エビクション(FIFO / LRU)
件数および/または概算サイズでテーブルの保持量を制限します。TTL とは独立しており、同時に有効化できます。上限超過分はバックグラウンドで自動削除されます。
// FIFO(デフォルト): 主キー順に古いものから削除。
// sourceField は設定しない(PrimaryKeyType.none の場合を除く)。
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  // maxBytes: 50 * 1024 * 1024, // 任意のサイズ上限
  policy: CapacityEvictionPolicy.fifo,
),

// LRU: sourceField 必須(datetime、非 null、currentTimestamp)。
// 再使用時にそのフィールドを更新する。
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  policy: CapacityEvictionPolicy.lru,
  sourceField: 'last_active_at',
),
maxEntries/maxBytesの少なくとも一方を設定。- FIFO かつ
PrimaryKeyType.noneの場合もsourceFieldが必要(同じ datetime ルール)。
既存テーブルでも、実行時に容量エビクションの有効化・変更・無効化ができます(再オープン不要):
// 有効化 / 更新
await db.updateSchema('recent_events').setCapacityConfig(
  CapacityConfig(
    maxEntries: 10000,
    policy: CapacityEvictionPolicy.lru,
    sourceField: 'last_active_at',
  ),
);

// 無効化(既存行は保持;容量による削除は停止)
await db.updateSchema('recent_events').disableCapacity();
KV の容量上限は DB オープン時に DataStoreConfig で設定します(kv.set ごとではありません):
kvCapacityConfig:現在のスペースのキー上限globalKvCapacityConfig:グローバル KV の上限- 表の
CapacityConfigと同じ形だが、sourceFieldは設定しない
final db = await ToStore.open(
  dbPath: '...',
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
    globalKvCapacityConfig: CapacityConfig(
      maxEntries: 2000,
      policy: CapacityEvictionPolicy.fifo,
    ),
  ),
);
インテリジェント ストレージ (アップサート)
ToStoreはdataに含まれる主キーか唯一のフィールドに基づいて更新するか挿入するかを決定します。 where はここではサポートされていません。競合ターゲットはデータ自体によって決まります。
// By primary key
final result = await db.upsert('users', {
  'id': 1,
  'username': 'john',
  'email': '[email protected]',
});

// 按唯一键(記録は、一意の制約に関与するすべてのフィールドと必須フィールドを含める必要があります)
await db.upsert('users', {
  'username': 'john',
  'email': '[email protected]',
  'age': 26,
});

// Batch upsert (supports atomic mode or partial-success mode)
// allowPartialErrors: true means some records may fail while others still succeed
final batchResult = await db.batchUpsert('users', [
  {'username': 'a', 'email': '[email protected]'},
  {'username': 'b', 'email': '[email protected]'},
], allowPartialErrors: true);
高度なクエリ
ToStore は、柔軟なフィールド処理と複雑な複数テーブルのリレーションシップを備えた、宣言型のチェーン可能なクエリ API を提供します。
1. フィールドの選択 (select)
select メソッドは、どのフィールドを返すかを指定します。これを呼び出さない場合は、デフォルトですべてのフィールドが返されます。
- エイリアス: 結果セット内のキーの名前を変更するための
field as alias構文 (大文字と小文字を区別しない) をサポートします。 - テーブル修飾フィールド: 複数テーブル結合では、
table.fieldにより名前の競合が回避されます。 - 集約混合:
Aggオブジェクトはselectリスト内に直接配置できます
final results = await db.query('orders')
    .select([
      'orders.id',
      'users.name as customer_name',
      'orders.amount',
      Agg.count('id', alias: 'total_items')
    ])
    .join('users', 'orders.user_id', '=', 'users.id')
    .where('orders.amount', '>', 1000)
    .limit(20);
2. 参加 (join)
標準の join (内部結合)、leftJoin、および rightJoin をサポートします。
3. スマートな外部キーベースの結合 (推奨)
foreignKeys が TableSchema に正しく定義されていれば、結合条件を手書きする必要はありません。このエンジンは参照関係を解決し、最適な JOIN パスを自動的に生成できます。
joinReferencedTable(tableName): 現在のテーブルが参照する親テーブルを自動的に結合します。joinReferencingTable(tableName): 現在のテーブルを参照する子テーブルを自動的に結合します。
// Assume posts defines a foreign key to users
final posts = await db.query('posts')
    .joinReferencedTable('users') // Automatically resolves to ON posts.user_id = users.id
    .select(['posts.title', 'users.username'])
    .limit(20);
集計、グループ化、統計 (Agg および GroupBy)
1. 集計 (Agg ファクトリー)
集計関数は、データセットの統計を計算します。 alias パラメータを使用すると、結果のフィールド名をカスタマイズできます。
| 方法 | 目的 | 例 |
|---|---|---|
Agg.count(field) |
null 以外のレコードをカウントする | Agg.count('id', alias: 'total') |
Agg.sum(field) |
合計値 | Agg.sum('amount', alias: 'total_price') |
Agg.avg(field) |
平均値 | Agg.avg('score', alias: 'average_score') |
Agg.max(field) |
最大値 | Agg.max('age') |
Agg.min(field) |
最小値 | Agg.min('price') |
[!TIP] 2 つの一般的な集計スタイル
- ショートカット メソッド (単一メトリクスに推奨): チェーン上で直接呼び出し、計算された値をすぐに取得します。
num? totalAge = await db.query('users').sum('age');selectに埋め込み (複数のメトリクスまたはグループ化用):Aggオブジェクトをselectリストに渡します。final stats = await db.query('orders').select(['status', Agg.sum('amount')]).groupBy(['status']);
2. グループ化とフィルタリング (groupBy / having)
SQL の HAVING 動作と同様に、groupBy を使用してレコードを分類し、次に having を使用して集計結果をフィルタリングします。
final stats = await db.query('orders')
    .select([
      'status',
      Agg.sum('amount', alias: 'sum_amount'),
      Agg.count('id', alias: 'order_count')
    ])
    .groupBy(['status'])
    // having accepts a QueryCondition used to filter aggregated results
    .having(QueryCondition().where(Agg.sum('amount'), '>', 5000))
    .limit(10);
3. ヘルパー クエリ メソッド
exists()(高パフォーマンス): 一致するレコードがあるかどうかを確認します。count() > 0とは異なり、一致が 1 つ見つかるとすぐにショートするため、非常に大規模なデータセットに最適です。count(): 一致するレコードの数を効率的に返します。first():limit(1)と同等の便利なメソッドで、最初の行をMapとして直接返します。distinct([fields]): 結果の重複を排除します。fieldsが指定されている場合、それらのフィールドに基づいて一意性が計算されます。
// Efficient existence check
if (await db.query('users').whereEqual('email', '[email protected]').exists()) {
  print('Email is already registered');
}

// Get a deduplicated city list
final cities = await db.query('users').distinct(['city']);
4. QueryCondition を使用した複雑なロジック
QueryCondition は、ネストされたロジックと括弧で囲まれたクエリ構築のための ToStore の中核ツールです。 (A AND B) OR (C AND D) のような式には、単純な連鎖 where 呼び出しでは不十分な場合に使用するツールです。
condition(QueryCondition sub):ANDネストされたグループを開きますorCondition(QueryCondition sub):ORネストされたグループを開きますor(): 次のコネクタをORに変更します (デフォルトはAND)
例 1: 混合 OR 条件
同等の SQL: WHERE is_active = true AND (role = 'admin' OR fans >= 1000)
final subGroup = QueryCondition()
    .whereEqual('role', 'admin')
    .or()
    .whereGreaterThanOrEqualTo('fans', 1000);

final results = await db.query('users')
    .whereEqual('is_active', true)
    .condition(subGroup);
例 2: 再利用可能な条件フラグメント
再利用可能なビジネス ロジック フラグメントを一度定義し、それらをさまざまなクエリで組み合わせることができます。
final hotUser = QueryCondition().whereGreaterThan('fans', 5000);
final recentLogin = QueryCondition().whereGreaterThan('last_login', '2024-01-01');

final targetUsers = await db.query('users')
    .condition(hotUser)
    .condition(recentLogin);
5. ストリーミングクエリ
すべてを一度にメモリにロードしたくない場合に、非常に大規模なデータセットに適しています。結果は読み取られながら処理できます。
db.streamQuery('users').listen((data) {
  print('Processing one record: $data');
});
6. リアクティブクエリ
watch() メソッドを使用すると、クエリ結果をリアルタイムで監視できます。 Stream を返し、ターゲット テーブルで一致するデータが変更されるたびにクエリを自動的に再実行します。
- 自動デバウンス: 組み込みのインテリジェントなデバウンス機能により、クエリの冗長なバーストを回避します。
- UI 同期: リストをライブ更新するために Flutter
StreamBuilderと自然に連携します
// Simple listener
db.query('users').whereEqual('is_online', true).watch().listen((users) {
  print('Online user count changed: ${users.length}');
});

// Flutter StreamBuilder integration example
// Local UI refreshes automatically when data changes
StreamBuilder<List<Map<String, dynamic>>>(
  stream: db.query('messages').orderByDesc('id').limit(50).watch(),
  builder: (context, snapshot) {
    if (snapshot.hasData) {
      return ListView.builder(
        itemCount: snapshot.data!.length,
        itemBuilder: (context, index) => MessageTile(snapshot.data![index]),
      );
    }
    return CircularProgressIndicator();
  },
)
手動クエリ結果のキャッシュ (オプション)
[!IMPORTANT] ToStore には、効率的なマルチレベルのインテリジェント LRU キャッシュがすでに内部に組み込まれています。 日常的な手動キャッシュ管理は推奨されません。 特別な場合にのみ考慮してください。
- めったに変更されないインデックスのないデータに対する高価なフル スキャン
- 非ホットクエリでも持続的な超低レイテンシー要件
useQueryCache([Duration? expiry]): キャッシュを有効にし、オプションで有効期限を設定しますnoQueryCache(): このクエリのキャッシュを明示的に無効にしますclearQueryCache(): このクエリ パターンのキャッシュを手動で無効にします
final results = await db.query('heavy_table')
    .where('non_indexed_field', '=', 'value')
    .useQueryCache(const Duration(minutes: 10)); // Manual acceleration for a heavy query only
クエリと効率的なページネーション
[!TIP] ページサイズとして limit を明示的に指定する: クエリを実行する際は、常に
limitを指定することを強く推奨します。省略した場合、エンジンは一度に大量のデータを照会するのを避けるため、デフォルトで 1000 件に制限します。
ToStore は、2 つのページネーション モードをサポートしています。リストのスクロールや無限ロードには、組み込みのシームレスなカーソル ページネーションを強く推奨します。特定のページへジャンプする場合は、通常のオフセット ページネーションを使用できます。
1. 基本的なページネーション (オフセット モード)
データ量が少ない場合(例: 1万件未満)や、特定のページに正確にジャンプする必要がある場合に適しています。
final result = await db.query('users')
    .orderByDesc('created_at')
    .offset(40) // 最初の 40 行をスキップ
    .limit(20); // 20 行を取得
[!TIP]
offsetが非常に大きくなると、データベースは大量のレコードをスキャンして破棄する必要があるため、パフォーマンスが直線的に低下します。ディープ ページネーションや大規模なデータセットの場合は、カーソル モードの使用をお勧めします。
2. カーソルのページネーション (カーソル モード - 推奨)
大規模なデータセットや無限スクロールに最適です。現在のページデータストリームの開始位置を記録することで、ページ移動時にその位置へ直接シークして読み込むため、履歴データのスキャンと破棄を回避し、ディープ ページネーションの速度を常に一定に保ちます。
- 自動管理: 1ページあたりの表示件数
limitを設定し、以降はnext()またはprev()を呼び出すだけで、非常にシンプルかつ迅速に優れたページネーション パフォーマンスを得られます。 - 開始位置のオフセット: 初回クエリで
.offset(N)を指定して開始位置を設定し、その後は直接next()を呼び出して次のページデータを取得することをサポートします。
// 1. 初回クエリの実行
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

// 2. 次のページを取得
if (page1.hasMore) {
  final page2 = await page1.next();
  print('次のページのデータ件数: ${page2.data.length}');

  // 3. 前のページを取得
  if (page2.hasPrev) {
    final prevPage = await page2.prev();
    print('前のページのデータ: ${prevPage.data}');
  }
}
高度なシナリオ: ステートレス トークン ページネーション (Token-based Cursor)
日常のアプリ内ページングでは、上記の next() / prev() を優先してください。カーソル トークンは、クライアント・サーバー API や、プロセス/ネットワーク間でページネーション状態をシリアライズする必要がある場合にのみ使用します:
- 初回クエリは
nextCursorToken/prevCursorToken文字列を返します。 - 次回クエリでは
.cursor(token)を介してトークンを渡し、seek します。 - 注意:
cursorとoffsetは互いに排他的です。一方を設定すると他方がクリアされます。
// 初回クエリ(例: API サーバー側)
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

final String? nextToken = page1.nextCursorToken; // このトークンをシリアライズしてクライアントに返却

// クライアントがトークンを指定して次のページを要求した際:
if (nextToken != null) {
  final page2 = await db.query('users')
      .orderByDesc('id')
      .limit(20)
      .cursor(nextToken); // トークンを渡して正確にシークして読み込み
}
| 特徴 | オフセットモード | カーソルモード |
|---|---|---|
| クエリのパフォーマンス | ページ数が増えるにつれて低下 | ディープページングでも速度は常に一定 |
| 最適な用途 | 小規模なデータセット、正確なページジャンプ | 大規模なデータセット、無限スクロール |
| データ変更時の一貫性 | データの変更によって行の重複や欠落が発生しやすい | データ変更による重複や欠落を回避 |
メモリプローブと同期検索 (peek)
スループットとレイテンシに極端な要求があるシナリオ向けに、ToStore は peek 純同期メモリ検索シリーズを提供します。プロセス内でバースト的なホットリードを直接さばけます:エッジ側は百万件/秒級の読み取りに対応、サーバー側はより強力なハードウェアで単機千万件/秒級に達可能(詳細は ベンチマーク)。
[!NOTE] メモリキャッシュのみ:
peekはゼロスケジューリングの純メモリバイパスです。キャッシュミス時は即座に空/nullを返し、エンジンは同期ファイル I/O を行いません(高並行時のイベントループブロックを回避)。完全な永続化結果が必要な場合は、アプリケーション側でawait query()を使用してください。
peek API メソッド
| メソッド | 戻り値の型 | 説明 |
|---|---|---|
peekFirst() |
Map<String, dynamic>? |
単一レコード;キャッシュミス時は null |
peek() |
QueryResult<T> |
data リストとページネーションメタデータ(hasMore、カーソル等)を含む QueryResult;キャッシュヒット時のみデータあり |
peekExists() |
bool |
メモリキャッシュ内の一致レコードの存在を同期的に確認 |
peekCount() |
int |
メモリキャッシュ内の一致レコード数を同期的にカウント |
result.peekNext() |
QueryResult<T> |
ページネーション結果がキャッシュされている場合の同期次ページ |
result.peekPrev() |
QueryResult<T> |
ページネーション結果がキャッシュされている場合の同期前ページ |
ベストプラクティス:メモリプローブ優先 (Peek-Through)
// 単一レコード:メモリプローブを先に試行、ミス時は標準非同期クエリ
final q = db.query('users').where('id', '=', userId);
final user = q.peekFirst() ?? await q.first();

// ページネーションプローブ
final listQ = db.query('users').orderByDesc('id').limit(20);
var page = listQ.peek();
if (page.data.isEmpty) page = await listQ;

if (page.hasMore) {
  final next = page.peekNext(); // キャッシュヒット:同期ページ送り
  if (next.data.isEmpty) await page.next();
}
KV プローブ (db.kv)
| メソッド | 非同期対応 | 説明 |
|---|---|---|
peekGet(key) |
get(key) |
同期メモリ点検索;期限切れキーは null |
peekExists(key) |
exists(key) |
同期メモリ存在確認 |
db.kv.query().peek() |
await db.kv.query() |
ページネーション同期プローブ(プレフィックス / ソート / limit) |
db.kv.query().peekFirst() |
await db.kv.query().first() |
先頭レコード同期プローブ |
// 点検索:プローブ優先、ミス時は非同期にフォールバック
final theme = db.kv.peekGet('theme', isGlobal: true) ?? await db.kv.get('theme', isGlobal: true);

// ページネーション KV プローブ
var page = db.kv.query().prefix('setting_').limit(20).peek();
if (page.data.isEmpty) page = await db.kv.query().prefix('setting_').limit(20);
[!TIP] 推奨:標準の非同期クエリ(
await query())はイベントスケジューリングにより長期安定性とマルチタスクの公平性を保証し、10万 QPS 以上で大多数の業務に十分です。peekシリーズは単機で百万/千万件/秒級の極端なホットリード削峰向けに設計されています。
外部キーとカスケード
外部キーは参照整合性を保証し、カスケード更新と削除を構成できるようにします。関係は書き込みおよび更新時に検証されます。カスケード ポリシーが有効になっている場合、関連データが自動的に更新され、アプリケーション コードでの整合性作業が軽減されます。
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(name: 'id'),
    fields: [
      FieldSchema(name: 'username', type: DataType.text, nullable: false),
    ],
  ),
  TableSchema(
    name: 'posts',
    primaryKeyConfig: const PrimaryKeyConfig(name: 'id'),
    fields: [
      const FieldSchema(name: 'title', type: DataType.text, nullable: false),
      const FieldSchema(name: 'user_id', type: DataType.integer, nullable: false),
      const FieldSchema(name: 'content', type: DataType.text),
    ],
    foreignKeys: [
        ForeignKeySchema(
          name: 'fk_posts_user',
          fields: ['user_id'],              // Field in the current table
          referencedTable: 'users',         // Referenced table
          referencedFields: ['id'],         // Referenced field
          onDelete: ForeignKeyCascadeAction.cascade,  // Delete posts automatically when the user is deleted
          onUpdate: ForeignKeyCascadeAction.cascade,  // Cascade updates
        ),
    ],
  ),
]);
クエリ演算子
すべての where(field, operator, value) 条件は、次の演算子をサポートしています (大文字と小文字は区別されません)。
| 演算子 | 説明 | 例 / パフォーマンス |
|---|---|---|
= |
等しい | where('status', '=', 'val') — [推奨] インデックス Seek |
!=、<> |
等しくない | where('role', '!=', 'val') — [注意] 全表スキャン |
> , >=, <, <= |
比較 | where('age', '>', 18) — [推奨] インデックス Scan |
IN |
リスト内 | where('id', 'IN', [...]) — [推奨] インデックス Seek |
NOT IN |
リストにありません | where('status', 'NOT IN', [...]) — [注意] 全表スキャン |
BETWEEN |
2 つの値の間 (両端を含む) | where('age', 'BETWEEN', [18, 65]) — [推奨] インデックス Scan |
LIKE |
パターン一致 (% = 任意の文字、_ = 単一の文字) |
where('name', 'LIKE', 'John%') — [注意] 下記の注意事項を参照 |
NOT LIKE |
パターンの不一致 | where('email', 'NOT LIKE', '...') — [注意] 全表スキャン |
IS |
nullです |
where('deleted_at', 'IS', null) — [推奨] インデックス Seek |
IS NOT |
null ではありません |
where('email', 'IS NOT', null) — [注意] 全表スキャン |
セマンティック クエリ メソッド (推奨)
手書きの演算子文字列を回避し、より適切な IDE 支援を得るために推奨されます。
1. 比較
数値または文字列の直接比較に使用されます。
db.query('users').whereEqual('username', 'John');           // Equal
db.query('users').whereNotEqual('role', 'guest');          // Not equal
db.query('users').whereGreaterThan('age', 18);             // Greater than
db.query('users').whereGreaterThanOrEqualTo('score', 60);  // Greater than or equal
db.query('users').whereLessThan('price', 100);             // Less than
db.query('users').whereLessThanOrEqualTo('quantity', 10);  // Less than or equal
db.query('users').whereTrue('is_active');                  // Is true
db.query('users').whereFalse('is_banned');                 // Is false
2. コレクションと範囲
フィールドがセットまたは範囲内にあるかどうかをテストするために使用されます。
db.query('users').whereIn('id', ['id1', 'id2']);                 // In list
db.query('users').whereNotIn('status', ['banned', 'pending']);   // Not in list
db.query('users').whereBetween('age', 18, 65);                   // In range (inclusive)
3. Null チェック
フィールドに値があるかどうかをテストするために使用されます。
db.query('users').whereNull('deleted_at');    // Is null
db.query('users').whereNotNull('email');      // Is not null
db.query('users').whereEmpty('nickname');     // Is null or empty string
db.query('users').whereNotEmpty('bio');       // Is not null and not empty
4. パターン マッチング
SQL スタイルのワイルドカード検索をサポートします (% は任意の数の文字に一致し、_ は単一の文字に一致します)。
db.query('users').whereLike('name', 'John%');                        // SQL-style pattern match
db.query('users').whereContains('bio', 'flutter');                   // Contains match (LIKE '%value%')
db.query('users').whereStartsWith('name', 'Admin');                  // Prefix match (LIKE 'value%')
db.query('users').whereEndsWith('email', '.com');                    // Suffix match (LIKE '%value')
db.query('users').whereContainsAny('tags', ['dart', 'flutter']);     // Fuzzy match against any item in the list
// Equivalent to: .where('age', '>', 18).where('name', 'like', '%John%')
final users = await db.query('users')
    .whereGreaterThan('age', 18)
    .whereLike('username', '%John%')
    .orderByDesc('age')
    .limit(20);
[!CAUTION] クエリ性能ガイド (インデックス vs フルスキャン)
大規模データ(数百万行以上)のシナリオでは、メインスレッドの遅延やクエリのタイムアウトを避けるため、以下の原則に従ってください。
インデックス最適化 - [推奨]:
- セマンティック メソッド:
whereEqual、whereGreaterThan、whereLessThan、whereIn,whereBetween,whereNull,whereTrue,whereFalseおよびwhereStartsWith(前方一致)。- 演算子:
=,>,<,>=,<=,IN,BETWEEN,IS null,LIKE 'prefix%'。- 説明: これらの操作は、インデックスを介して超高速なポジショニングを実現します。
whereStartsWith/LIKE 'abc%'の場合、インデックスは引き続き前方一致の範囲スキャンを実行できます。フルスキャンのリスク - [注意]:
- 曖昧一致:
whereContains(LIKE '%val%')、whereEndsWith(LIKE '%val')、whereContainsAny。- 否定クエリ:
whereNotEqual(!=,<>),whereNotIn(NOT IN),whereNotNull(IS NOT null/whereNotEmpty)。- パターンの不一致:
NOT LIKE。- 説明: 上記の操作は、インデックスが作成されていても、通常、データ記憶領域全体をトラバースする必要があります。モバイルや少量のデータセットでは影響は最小限ですが、分散型または超大規模なデータ分析シナリオでは、他のインデックス条件(ID や時間範囲による絞り込みなど)や
limit句と組み合わせて慎重に使用する必要があります。
分散アーキテクチャ
// Configure distributed nodes
final db = await ToStore.open(
  config: DataStoreConfig(
    distributedNodeConfig: const DistributedNodeConfig(
      enableDistributed: true,            // Enable distributed mode
      clusterId: 1,                       // Cluster ID
      centralServerUrl: 'https://127.0.0.1:8080',
      accessToken: 'b7628a4f9b4d269b98649129'
    )
  )
);

// Batch insert
await db.batchInsert('vector_data', [
  {'vector_name': 'face_2365', 'timestamp': DateTime.now()},
  {'vector_name': 'face_2366', 'timestamp': DateTime.now()},
  // ... efficient one-shot insertion of vector records
]);

// Stream and process large datasets
await for (final record in db.streamQuery('vector_data')
  .where('vector_name', '=', 'face_2366')
  .where('timestamp', '>=', DateTime.now().subtract(Duration(days: 30)))
  .stream) {
  // Process each result incrementally to avoid loading everything at once
  print(record);
}
主キーの例
ToStore は、さまざまなビジネス シナリオ向けに複数の分散主キー アルゴリズムを提供します。
- 連続主キー (
PrimaryKeyType.sequential):238978991 - タイムスタンプベースの主キー (
PrimaryKeyType.timestampBased):1306866018836946 - 日付プレフィックス付き主キー (
PrimaryKeyType.datePrefixed):20250530182215887631 - ショートコード主キー (
PrimaryKeyType.shortCode):9eXrF0qeXZ
// Sequential primary key configuration example
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(
      type: PrimaryKeyType.sequential,
      sequentialConfig: SequentialIdConfig(
        initialValue: 10000,      // Starting value
        increment: 50,            // Step size
        useRandomIncrement: true, // Random step size to hide business volume
      ),
    ),
    fields: [/* field definitions */]
  ),
]);
アトミック式
式システムは、タイプセーフなアトミック フィールド更新を提供します。すべての計算はデータベース層でアトミックに実行され、同時競合を回避します。
// Simple increment: balance = balance + 100
await db.update('accounts', {
  'balance': Expr.field('balance') + Expr.value(100),
}).where('id', '=', accountId);

// Complex calculation: total = price * quantity + tax
await db.update('orders', {
  'total': Expr.field('price') * Expr.field('quantity') + Expr.field('tax'),
}).where('id', '=', orderId);

// Multi-layer parentheses: finalPrice = ((price * quantity) + tax) * (1 - discount)
await db.update('orders', {
  'finalPrice': ((Expr.field('price') * Expr.field('quantity')) + Expr.field('tax')) *
                 (Expr.value(1) - Expr.field('discount')),
}).where('id', '=', orderId);

// Use functions: price = min(price, maxPrice)
await db.update('products', {
  'price': Expr.min(Expr.field('price'), Expr.field('maxPrice')),
}).where('id', '=', productId);

// Timestamp: updatedAt = now()
await db.update('users', {
  'updatedAt': Expr.now(),
}).where('id', '=', userId);
条件式 (たとえば、更新/挿入での更新と挿入の区別): Expr.isUpdate() / Expr.isInsert() を Expr.ifElse または Expr.when と一緒に使用して、式が更新時のみまたは挿入時にのみ評価されるようにします。
// Upsert: increment on update, set to 1 on insert
// The insert branch can use a plain literal; expressions are only evaluated on the update path
await db.upsert('counters', {
  'key': 'visits',
  'count': Expr.ifElse(
    Expr.isUpdate(),
    Expr.field('count') + Expr.value(1),
    1,
  ),
});

// Use Expr.when (single branch, otherwise null)
await db.upsert('orders', {
  'id': orderId,
  'updatedAt': Expr.when(Expr.isUpdate(), Expr.now(), otherwise: Expr.now()),
});
トランザクション
トランザクションは、複数の操作にわたるアトミック性を保証します。つまり、すべてが成功するか、すべてがロールバックされ、データの一貫性が維持されます。
トランザクションの特性
- 複数の操作がすべて成功するか、すべてロールバックされます
- 未完了の作業はクラッシュ後に自動的に回復されます
- 成功した操作は安全に永続化されます
// Basic transaction - atomically commit multiple operations
final txResult = await db.transaction(() async {
  // Insert a user
  await db.insert('users', {
    'username': 'john',
    'email': '[email protected]',
    'fans': 100,
  });

  // Atomic update using an expression
  await db.update('users', {
    'fans': Expr.field('fans') + Expr.value(50),
  }).where('username', '=', 'john');

  // If any operation fails, all changes are rolled back automatically
});

if (!txResult.hasErrors) {
  print('トランザクションが正常にコミットされました');
} else {
  print('トランザクションは次の理由でロールバックされました:');
  for (final status in txResult.statuses) {
    if (status.type != ResultType.success) {
      print(' - [$status.codeKey}] $status.message}');
    }
  }
}

// Automatic rollback on error
final txResult2 = await db.transaction(() async {
  await db.insert('users', {
    'username': 'jane',
    'email': '[email protected]',
  });
  throw Exception('Business logic error'); // Trigger rollback
}, rollbackOnError: true);
管理とメンテナンス
次の API は、プラグイン スタイルの開発、管理パネル、運用シナリオのデータベース管理、診断、メンテナンスをカバーします。
- テーブル管理
createTable(schema): 単一のテーブルを手動で作成します。モジュールのロードまたはオンデマンドのランタイムテーブル作成に役立ちますgetTableSchema(tableName): 定義されたスキーマ情報を取得します。自動検証または UI モデル生成に役立ちますgetTableNames({isGlobal}): グローバル schema 一覧のユーザー表名を取得。任意のisGlobal:trueグローバルのみ、false非グローバルのみ、省略で両方。非グローバル表構造はスペース間で共有され、データのみ隔離。getTableInfo(tableName): 実行時統計(totalRecordCount、totalTableDataSizeBytes、totalIndexDataSizeBytes、indexCount、作成時間、グローバル可否)を取得します。clear(tableName): スキーマ、インデックス、内部/外部キー制約を安全に保持しながら、すべてのテーブル データをクリアしますdropTable(tableName): テーブルとそのスキーマを完全に破棄します。可逆的ではない
- スペース管理
currentSpaceName: 現在のアクティブなスペースをリアルタイムで取得しますlistSpaces(): 現在のデータベース インスタンスに割り当てられているすべてのスペースをリストします。getSpaceInfo(useCache: true): スペース局所の集計(totalRecordCount、表/インデックスデータサイズ)。useCache: falseでメタから再計算。deleteSpace(spaceName):defaultと現在のアクティブ スペースを除く、特定のスペースとそのすべてのデータを削除します
- インスタンスの検出
config: インスタンスの最終的な有効なDataStoreConfigスナップショットを検査します。instancePath: 物理ストレージ ディレクトリを正確に特定しますgetVersion()/setVersion(version): アプリケーション レベルの移行決定のためのビジネス定義のバージョン管理 (エンジンのバージョンではありません)
- メンテナンス
flush(mode: FlushMode.full): 保留中の書き込みをストレージへ強制反映します。モード:recovery(最速。復旧ログのみ OS バッファへ。アプリクラッシュ再開は復旧可能、停電ではデータ損失の可能性)、recoveryDurable(復旧ログを物理ストレージへ。停電耐性を想定)、full(デフォルト。復旧ログ + テーブルデータ + インデックスを物理ストレージへ)。deleteDatabase(): 現在のインスタンスのすべての物理ファイルとメタデータを削除します。慎重に使用してください
- 診断
db.status.memory(): キャッシュ ヒット率、インデックス ページの使用状況、および全体的なヒープ割り当てを検査します。db.status.space()/db.status.table(tableName): スペースとテーブルのライブ統計と正常性情報を検査します。db.status.config(): 現在のランタイム構成スナップショットを検査します。db.status.migration(taskId): 非同期移行の進行状況をリアルタイムで追跡します
final spaces = await db.listSpaces();
final tableNames = await db.getTableNames();
final spaceInfo = await db.getSpaceInfo(useCache: false);
final tableSchema = await db.getTableSchema('users');
final tableInfo = await db.getTableInfo('users');

print('spaces: $spaces');
print('tables: $tableNames');
print(spaceInfo.toJson());
print(tableSchema?.toJson());
print(tableInfo?.toJson());

await db.flush();

final memoryInfo = await db.status.memory();
final configInfo = await db.status.config();
print(memoryInfo.toJson());
print(configInfo.toJson());
バックアップと復元
シングルユーザーのローカルインポート/エクスポート、大規模なオフラインデータの移行、障害後のシステムのロールバックに特に役立ちます。
- バックアップ (
backup)compress: 圧縮を有効にするかどうか。デフォルトで推奨および有効化されているscope: バックアップ範囲を制御しますBackupScope.database: すべてのスペースとグローバル テーブルを含む データベース インスタンス全体をバックアップしますBackupScope.currentSpace: グローバル テーブルを除く、現在のアクティブ スペースのみをバックアップしますBackupScope.currentSpaceWithGlobal: 現在のスペースとそれに関連するグローバル テーブルをバックアップします。シングル テナントまたはシングル ユーザーの移行に最適です。
- 復元 (
restore)backupPath: バックアップ パッケージへの物理パスcleanupBeforeRestore: 復元前に関連する現在のデータをサイレントに消去するかどうか。論理状態の混合を避けるためにtrueを推奨しますdeleteAfterRestore: 復元が成功した後、バックアップ ソース ファイルを自動的に削除します。
// Example: export the full data package for the current user
final backupPath = await db.backup(
  compress: true,
  scope: BackupScope.currentSpaceWithGlobal,
);

// Example: restore from a backup package and clean up the source file automatically
final restored = await db.restore(
  backupPath,
  cleanupBeforeRestore: true,
  deleteAfterRestore: true,
);
ステータスコードとエラー処理
ToStore には、エラーと例外のフィードバック用に次の 2 つのチャネルがあります。
[!NOTE] 統一された診断基盤: 応答結果モデル(DbResult/QueryResult 内の statuses)を介して返されるか、致命的な例外(DbException 内の statuses)を介してスローされるかに関係なく、すべての診断ステータスは構造化された
ResultStatusシステムに統一され、同じステータスコードを共有するため、一貫性が保証されます。
- 応答結果モデル(Result-based Response)
挿入、更新、削除、クエリ、トランザクション、および実行時のテーブルスキーマの作成や変更などの日常的な操作を対象とします。これらの操作は、制約違反、バリデーションエラー、または無効な引数に遭遇した場合でも、例外をスローしてデータ操作を中断することはありません。代わりに、ToStore は
DbResultまたはQueryResultを使用して結果をラップし、すべての診断情報をステータスリストに記録します。これにより、通常のビジネスロジックエラーがデータベースの正常な稼働を妨げないことが保証されます。
hasErrors: 現在の操作にエラーが存在するかどうかを示します。一括操作またはトランザクションにおいて、少なくとも 1 つのエラーが含まれる場合、この属性はtrueになります。statuses: 操作に関するすべてのResultStatus診断情報の詳細リスト。1:1 の順序一致をサポートしているため、一括操作で非常に便利です。firstPrimaryKey: 単一の挿入/書き込み操作의成功時に、statusesを手動で解析することなく、物理的に生成された主キーを直接読み取ります。ResultType: 分岐処理や大枠のチェックに便利な、ステータスのカテゴリを示す列挙型(例:isBusinessError、isDeveloperError)。
- 例外のスロー(Exception-based Throwing)
開発者の過失または設計上の欠陥に起因する致命的なエラー(例:
ToStore.open時のスキーマ検証エラー、エンジンバージョンの不一致、致命的なデータ移行破損など)を対象とします。これらのケースでは、ToStore は実行を停止するためにDbExceptionをスローし、開発者に修正を促します。
[!WARNING] 開発ガイドライン: 通常のビジネスエラーは例外をスローしてはなりません。アプリケーションの実行を妨げないように、応答結果モデルで返す必要があります。
エラーと例外の処理例
1. 単一書き込みに対する応答の処理
final result = await db.insert('users', {
  'username': 'john',
  'email': '[email protected]',
});

if (result.hasErrors) {
  // 最初のエラータイプと説明を取得
  print('Operation failed: [\${result.firstType.codeKey}] \${result.message}');
} else {
  print('書き込み成功、主キーは: \${result.firstPrimaryKey}');
}
2. 一括書き込みにおける詳細な診断
final batchResult = await db.batchInsert('users', [
  {'username': 'alice', 'email': '[email protected]'},
  {'username': 'bob', 'email': 'invalid-email-format'}, // Validation fails
]);

if (batchResult.hasErrors) {
  print('一括操作が一部失敗しました: 成功 \${batchResult.successCount}, 失敗 \${batchResult.failedCount}');

  for (final status in batchResult.statuses) {
    final int idx = status.index;

    if (status is ConstraintStatus) {
      print('Index [\$idx] 制約違反!テーブル! テーブル: \${status.tableName}, フィールド: \${status.fields}');
    } else if (status is InvalidArgumentStatus) {
      print('Index [\$idx] 引数エラー!パラメーター! Parameter: \${status.parameterName}, 渡された値: \${status.passedValue}');
    } else if (status.type != ResultType.success) {
      print('Index [\$idx] エラーが発生しました: [\${status.codeKey}] \${status.message}');
    }
  }
}
3. 致命的なエラーと初期化例外のキャッチ(DbException)
try {
  // Initialize database with schemas that might have validation issues
  final db = await ToStore.open(schemas: appSchemas);
} on DbException catch (e) {
  print('❌ 致命的なデータベース例外! エラーメッセージ: \n\${e.message}');

  // Iterate through the detailed status list in the exception
  for (final status in e.statuses) {
    if (status is SchemaValidationStatus) {
      print('スキーマ検証失敗!テーブル! テーブル: \${status.tableName}, フィールド: \${status.field}, 無効な構成: \${status.wrongValue}');
    } else {
      print('診断情報: [\${status.codeKey}] \${status.message}');
    }
  }
}
エラータイプ、詳細なステータスコード、JSON シリアル化形式、およびフィールドマッピングの完全なリストについては、完全な仕様書を参照してください: ToStore ResultStatus 自動診断およびステータス解決仕様書.
ログ コールバックとデータベース診断
ToStore は、ToStore.setLogConfig(...) を通じて、データベースのライフサイクルログをビジネス層にルーティングできます。
onLogコールバックは、現在のenableLogフィルターとlogLevelフィルターを通過するすべてのLogRecordログレコードを受信します。- LogLevel.error: 局所的なエラーが発生しましたが、通常の動作には影響しません。
- LogLevel.critical: グローバルな災害級エラー(ディスクフル、メモリ不足、移行の重大な失敗など)であり、手動での介入が必要です。このレベルでアラート通知をトリガーすることをお勧めします。
- 初期化前に
ToStore.setLogConfig(...)を呼び出し、初期化および自動移行中に生成されたログもキャプチャされるようにします。
  // ログパラメータまたはコールバックの構成
  ToStore.setLogConfig(
    enableLog: true,
    logLevel: debugMode ? LogLevel.debug : LogLevel.warn,
    logLabel: 'my_app_db', // ログ上部の薄いグレーのタイトル。アプリやデータベースインスタンスの区別用,
    onLog: (log) {
      // 本番環境では warn/error/critical をバックエンドやログプラットフォームに報告できます
      // log.level はログレベルに対応します (LogLevel.debug, info, warn, error, critical)
      // log.message は処理後のログテキストに対応します
      // log.status は下層の ResultStatus 診断ステータスに対応します (code と codeKey を含む)
      if (!debugMode && (log.level == LogLevel.warn || log.level == LogLevel.error || log.level == LogLevel.critical)) {
        developer.log(log.message, name: 'my_app_db', time: log.timestamp);
      }
    },
  );

  final db = await ToStore.open();
セキュリティ構成
[!WARNING] キー管理
キー 役割 変更方法 データ全量再書き込み encodingKeyデータ暗号化キー 新しい値を設定して再度 openはい(時間がかかる) encryptionKeyセキュリティキー、 encodingKeyを保護実行時に db.rotateEncryptionKeyを呼び出すいいえ(高速) 機密キーをハードコーディングしないでください。デバイスに紐づける場合は、
encryptionKeyを OS の Keychain / Keystore / セキュアエンクレーブに保存してからエンジンへ渡してください。
final db = await ToStore.open(
  config: DataStoreConfig(
    encryptionConfig: EncryptionConfig(
      // Supported: none, xorObfuscation, chacha20Poly1305, aes256Gcm
      encryptionType: EncryptionType.chacha20Poly1305,

      // Data encryption key: encrypts table/index/log data; changing it triggers a background rewrite
      encodingKey: 'Your-Encoding-Key...',

      // Security key: protects encodingKey; rotate online via db.rotateEncryptionKey
      encryptionKey: 'Your-Secure-Encryption-Key...',

      // standard: critical table data, B-tree indexes, and log payloads
      // full: encrypts the entire engine files
      encryptionScope: EncryptionScope.standard,
    ),
    // Enable crash recovery logging (Write-Ahead Logging), enabled by default
    enableJournal: true,
    // Whether transactions force data to disk on commit; set false to reduce sync overhead
    persistRecoveryOnCommit: true,
  ),
);
encodingKey の変更:EncryptionConfig に新しい値を設定して再度 open します。エンジンが変更を検出し、バックグラウンドで自動的にデータを移行します。アプリケーション側の操作は不要です。
encryptionKey のローテーション(セキュリティ/コンプライアンスの定期ローテーション):データの再書き込みなし、オンラインで実行可能。
// If encryptionKey was never set explicitly, oldKey can be omitted
final result = await db.rotateEncryptionKey(newKey: 'new-secure-key');
// Or: await db.rotateEncryptionKey(oldKey: 'old-key', newKey: 'new-key');
if (result.hasErrors) {
  // 失敗時の処理(oldKey が不正、encodingKey 移行中など)
  return;
}
// 成功:メモリ上の設定が更新済み。次回 ToStore.open 時に最新の encryptionKey を渡す
値レベルの暗号化 (ToCrypto)
フルデータベース暗号化はすべてのテーブルとインデックスのデータを保護しますが、全体的なパフォーマンスに影響を与える可能性があります。少数の機密値のみを保護する必要がある場合は、代わりに ToCrypto を使用してください。これはデータベースから切り離されており、db インスタンスを必要とせず、アプリケーションは書き込み前または読み取り後に値をエンコード/デコードできます。出力は Base64 であり、JSON または TEXT 列に自然に適合します。
key(必須):StringまたはUint8List。 32 バイトでない場合は、SHA-256 を使用して 32 バイトのキーが導出されます。type(オプション):ToCryptoTypeの暗号化タイプ (ToCryptoType.chacha20Poly1305やToCryptoType.aes256Gcmなど)。デフォルトはToCryptoType.chacha20Poly1305です。aad(オプション):Uint8Listタイプの追加の認証データ。エンコード中に提供された場合は、デコード中にもまったく同じバイトを提供する必要があります。
const key = 'my-secret-key';
// Encode: plaintext -> Base64 ciphertext (can be stored in DB or JSON)
final cipher = ToCrypto.encode('sensitive data', key: key);
// Decode when reading
final plain = ToCrypto.decode(cipher, key: key);

// Optional: bind contextual data with aad (must match during decode)
final aad = Uint8List.fromList(utf8.encode('users:id_number'));
final cipher2 = ToCrypto.encode('secret', key: key, aad: aad);
final plain2 = ToCrypto.decode(cipher2, key: key, aad: aad);
高度な構成の説明 (DataStoreConfig)
[!TIP] ゼロ構成インテリジェンス ToStore は、プラットフォーム、パフォーマンス特性、利用可能なメモリ、および I/O 動作を自動的に感知し、同時実行性、シャード サイズ、キャッシュ バジェットなどのパラメーターを最適化します。 一般的なビジネス シナリオの 99% では、
DataStoreConfigを手動で微調整する必要はありません。 デフォルトでは、現在のプラットフォームで優れたパフォーマンスがすでに提供されています。
| パラメータ | デフォルト | 目的と推奨事項 |
|---|---|---|
yieldDurationMs |
8ms | 主要な推奨事項。 長いタスクが完了するときに使用されるタイム スライス。 8ms は 120fps/60fps レンダリングとうまく連携し、大規模なクエリや移行中に UI をスムーズに保つのに役立ちます。 |
maxQueryOffset |
10000 | クエリ保護。 offset がこのしきい値を超えると、エラーが発生します。これにより、深いオフセット ページネーションによる異常な I/O が防止されます。 |
defaultQueryLimit |
1000 | リソース ガードレール。 クエリで limit が指定されていない場合に適用され、大量の結果セットの誤った読み込みや潜在的な OOM の問題を防ぎます。 |
cacheMemoryBudgetMB |
(自動) | きめ細かいメモリ管理。 総キャッシュ メモリ バジェット。エンジンはこれを使用して、LRU 再利用を自動的に実行します。 |
enableJournal |
本当 | クラッシュ自己修復 有効にすると、クラッシュまたは停電後にエンジンが自動的に回復します。 |
defaultRecoveryDurability |
standard |
応答時のリカバリ保証。 書き込み操作が結果を返す前に備える自己修復リカバリレベルを定義します: • standard(デフォルト):応答前にクラッシュ自己修復保証。アプリのクラッシュ、未処理例外、OOM強制終了から保護します。• durable:応答前に停電耐性自己修復保証。物理ストレージへの同期後に復帰し、突発的な停電でも復旧可能です。• async:超高速スループット。即座に応答しバックグラウンドで保存します。応答後、少量データでは数ミリ秒程度の極めて短い損失ウィンドウが存在します。 |
persistRecoveryOnCommit |
本当 | 強力な耐久性の保証。 true の場合、コミットされたトランザクションは物理ストレージに同期されます。 false の場合、速度を上げるためにフラッシュがバックグラウンドで非同期に実行されますが、極端なクラッシュで少量のデータが失われるリスクは低くなります。 |
ttlCleanupIntervalMs |
300000 | グローバル TTL ポーリング。 エンジンがアイドル状態でないときに期限切れデータをスキャンするバックグラウンド間隔。値を小さくすると、期限切れのデータがすぐに削除されますが、オーバーヘッドが増加します。 |
kvCapacityConfig |
null | スペース KV 容量。 スペース内キーの FIFO/LRU 上限;sourceField は設定しない。詳しくは容量エビクション。 |
globalKvCapacityConfig |
null | グローバル KV 容量。 kvCapacityConfig と同じ形。 |
maxConcurrency |
(自動) | コンピューティング同時実行制御。 ベクトル計算や暗号化/復号化などの集中的なタスクの最大並列ワーカー数を設定します。通常は自動のままにしておくのが最善です。 |
final db = await ToStore.open(
  config: DataStoreConfig(
    yieldDurationMs: 8, // Excellent for frontend UI smoothness; for servers, 50ms is often better
    defaultQueryLimit: 50, // Force a maximum result-set size
    enableJournal: true, // Ensure crash self-healing
    defaultRecoveryDurability: RecoveryDurability.standard, // 応答前にクラッシュ耐性を保証
  ),
);
パフォーマンスと経験
ベンチマーク
ハイライト — 100K スイートと 10 億規模エッジ実測(3 ラウンド、standard durability、2026-10-08):
| Metric | Result |
|---|---|
| Cold start | ~35 ms (stable vs data scale) |
| PK Read (Hot Cache) | 4.5M ops/s |
| Batch Insert | 588K ops/s |
| Pagination (Hot Cache) | 579K ops/s |
| ANN @ depth 1 (~91%) | 36K ops/s |
詳細チャートと全項目: Benchmarks。
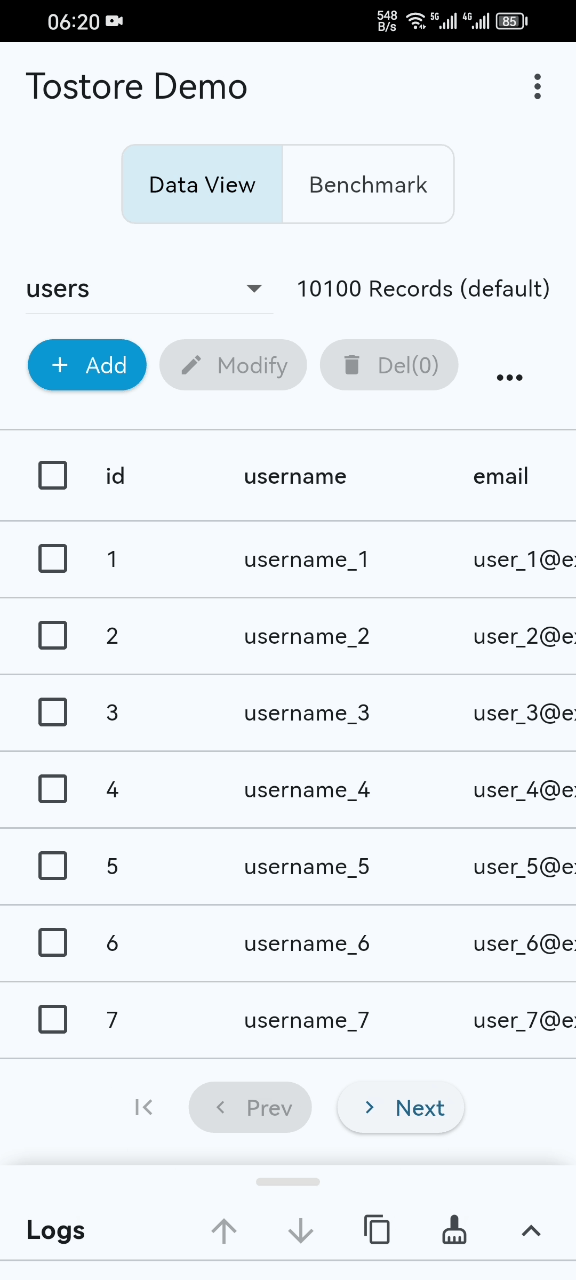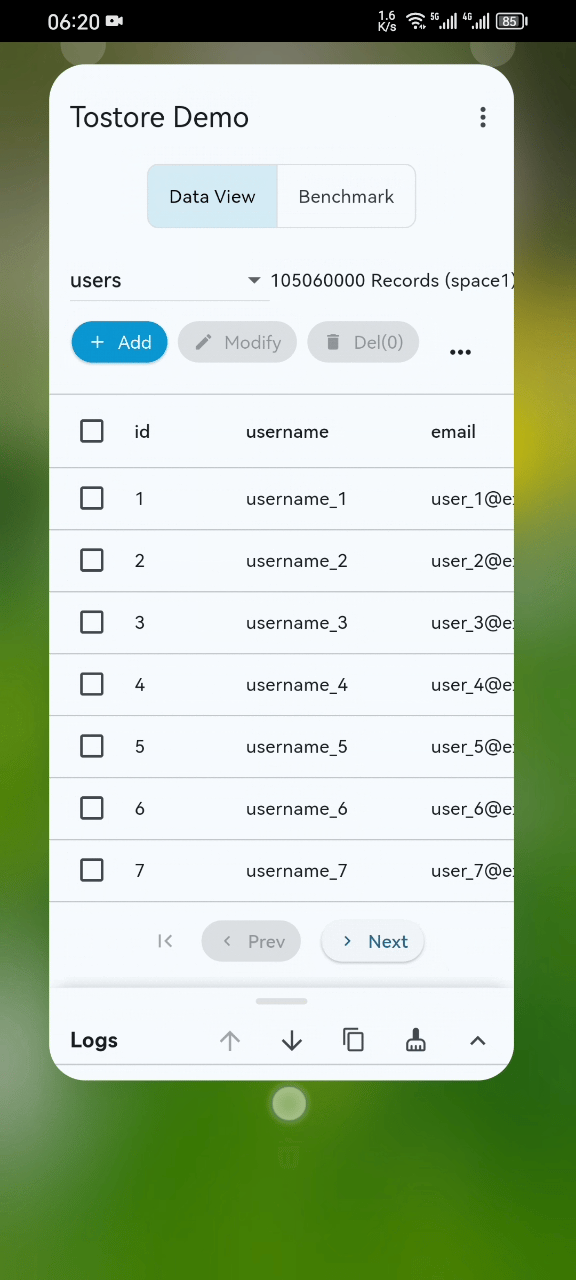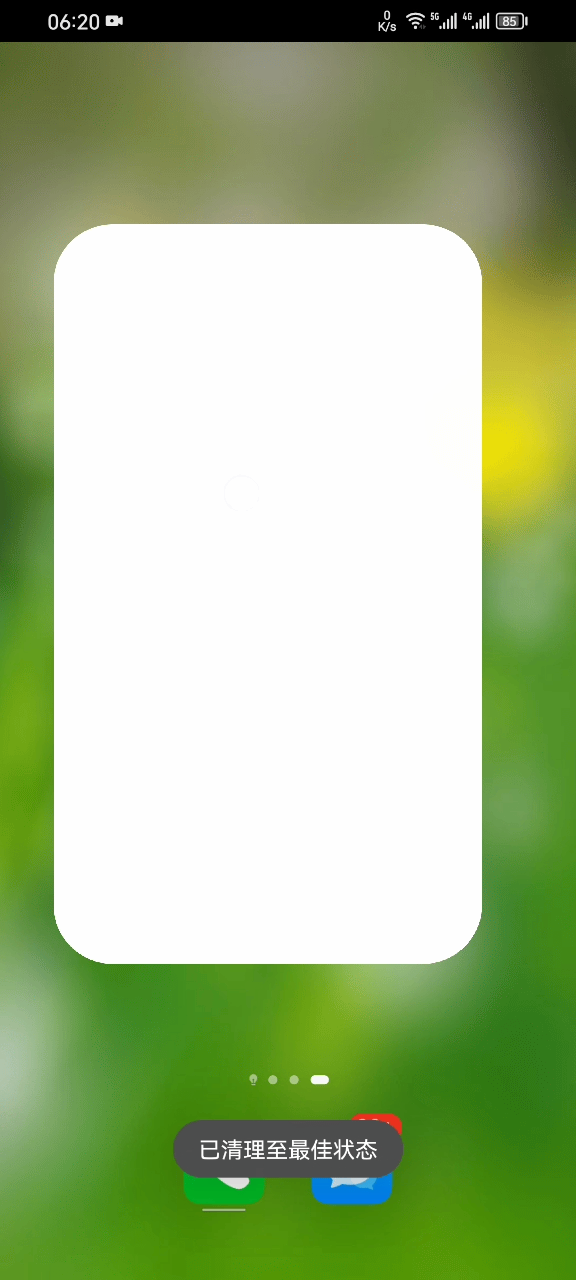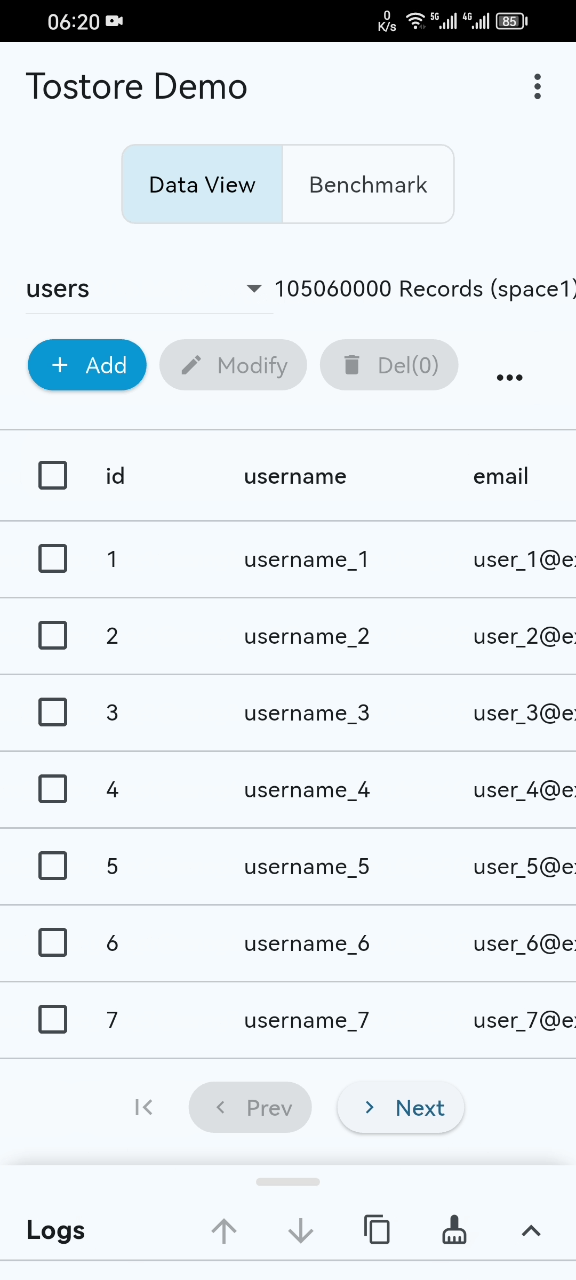
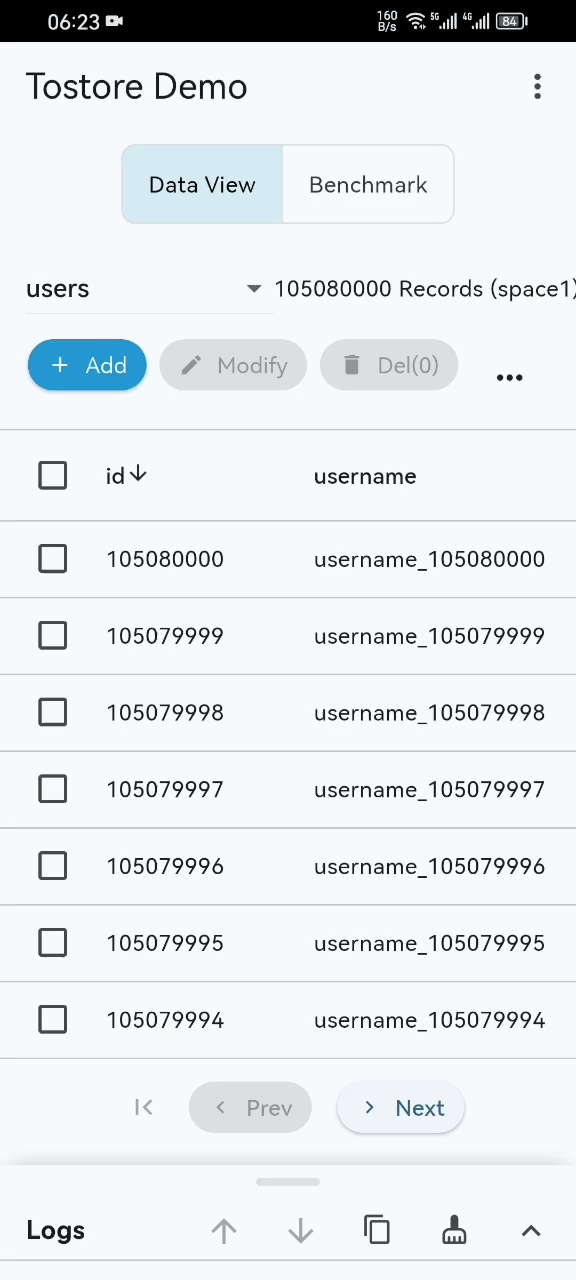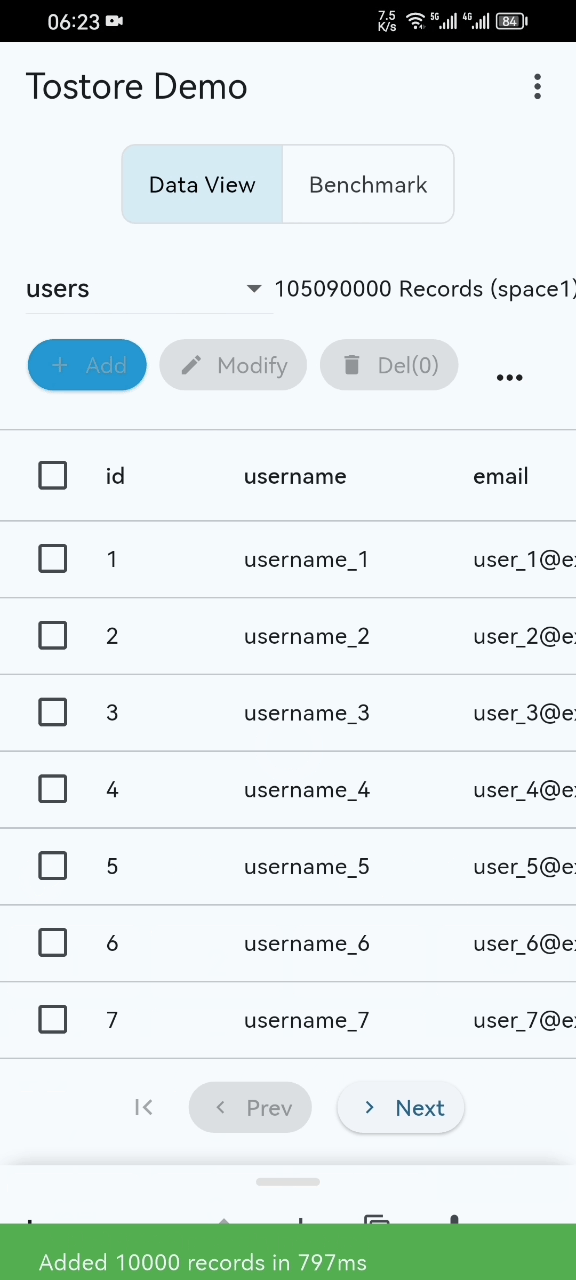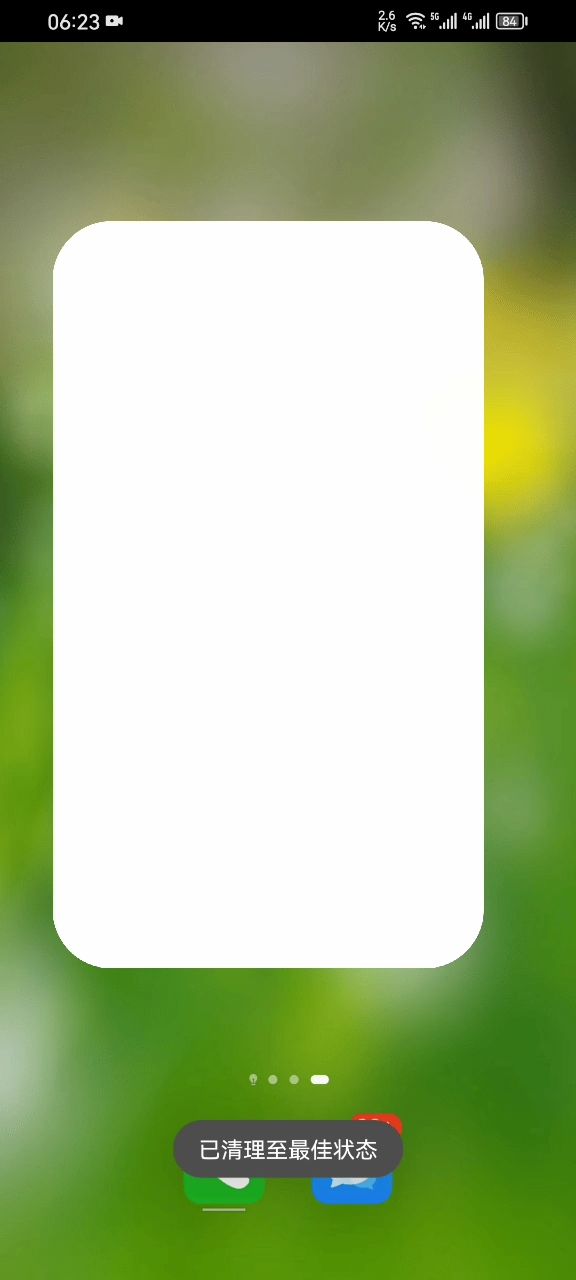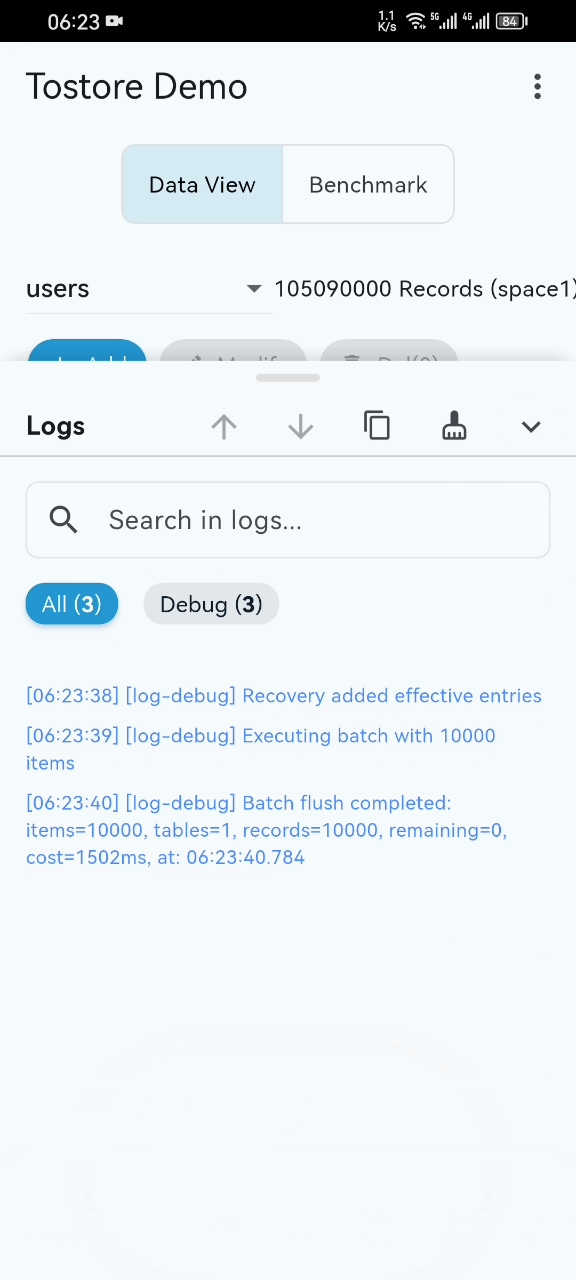
- 基本パフォーマンス デモ (basic-demo.mp4): GIF プレビューにはすべてが表示されない場合があります。完全なデモンストレーションについてはビデオを開いてください。通常のモバイル デバイスでも、データセットが 1 億レコードを超えても、起動、ページング、検索が安定してスムーズに行われます。
- 災害復旧ストレス テスト (disaster-recovery.mp4): 高頻度の書き込み中に、クラッシュや電源障害をシミュレートするために、プロセスが意図的に何度も中断されます。 ToStore は迅速に回復できます。
体験のヒント
- 📱 サンプルプロジェクト:
exampleディレクトリには完全な Flutter アプリケーションが含まれています - 🚀 本番ビルド: リリース モードでパッケージ化してテストします。リリースのパフォーマンスはデバッグモードをはるかに超えています
- ✅ 標準テスト: コア機能は標準化されたテストでカバーされます
ToStore がお役に立てましたら、ぜひ ⭐️ をお願いします。プロジェクトをサポートする最良の方法の 1 つです。どうもありがとうございます!
🤝 貢献
ToStore は継続的に進化し続ける現代のデータエンジンであり、コミュニティからの貢献を心より歓迎します。 バグ修正、ドキュメント改善、アーキテクチャの改良、新しいアイデアの提案など、PR を通じてご参加ください:
- 🔗 PR 提出: Pull Requests
- 📖 ドキュメント: Wiki
- 📢 問題報告: GitHub Issues
- 💬 技術的なディスカッション: GitHub Discussions