
simplexai-labs/PolyStrata
simplexai-labs/PolyStrata has 998 GitHub stars and 134 forks. GitHot measured +13 stars in 24 hours and +135 in 7 days. Last checked 2026-11-12 10:44 UTC. Last push 2026-11-03.
自分の PC で大規模 AI モデルを実行できます。Qwen3.8-Flash-Next は Strata のエンジンで、GLM 5.3 Flash、DeepSeek V4 Flash、LFM2.5、Qwen3.6、Ornith 1.5、Gemma 4、Tiel Coder、MiniCPM-V は PolyStrata 用に開発された別のエンジンで動作します。Windows と Linux にワンクリックでインストールでき、localhost で OpenAI/Anthropic API を利用できます。
計測したスター増加
- 24時間
- +13
- 7日間
- +135
- 15日間
- 履歴を収集中
- 1か月
- 履歴を収集中
期間ごとの純増数です。期間は重複しており、日別の値ではありません。未計測の値は空欄です。スター数は注目度の指標であり、品質の保証ではありません。
README.ja.md
オリジナルPolyStrata
English · 简体中文 · 日本語 · Deutsch · Français · Español · Português
大きな AI モデルを、手元の PC で動かす
Qwen3.8-Flash-Next、GLM 5.3 Flash、DeepSeek V4 Flash、LFM2.5、Flint、Qwen3.6、Clover、Ornith 1.5、Gemma 4、Tiel Coder、MiniCPM-V、Kolibri 1 · 無料のオープンソース
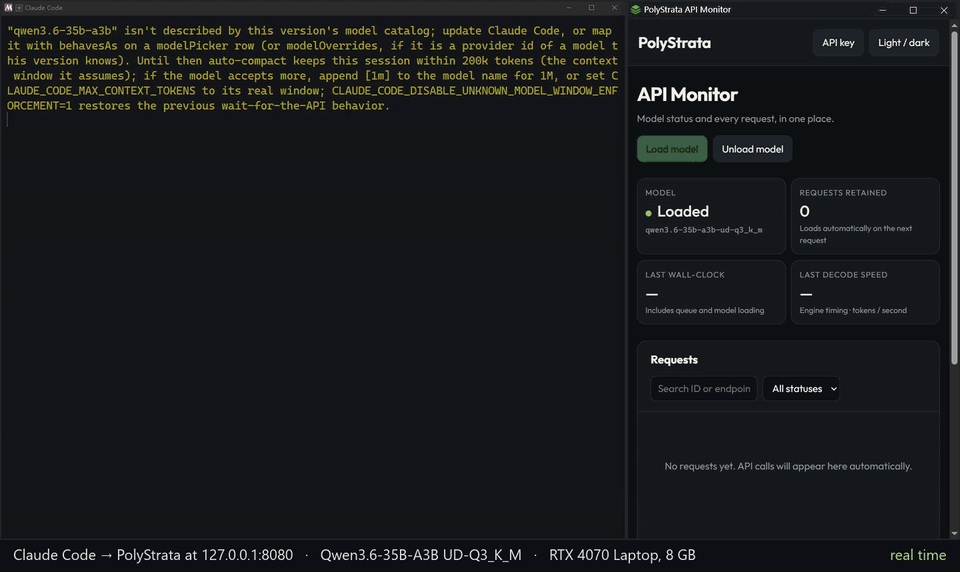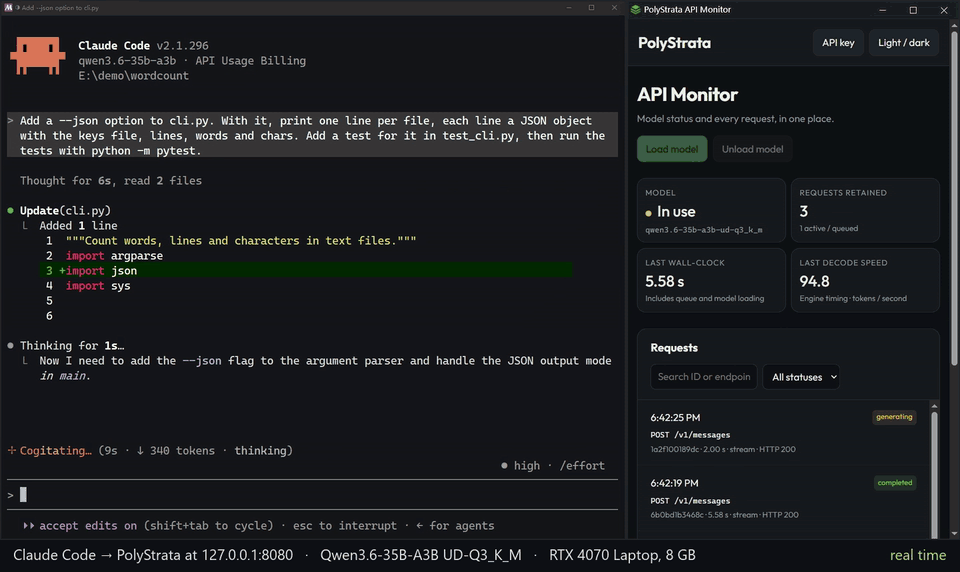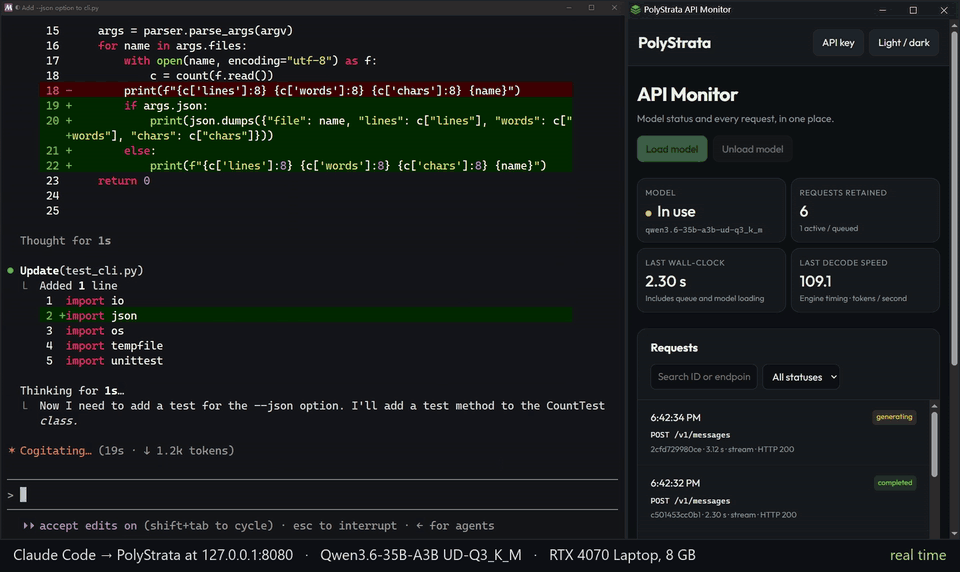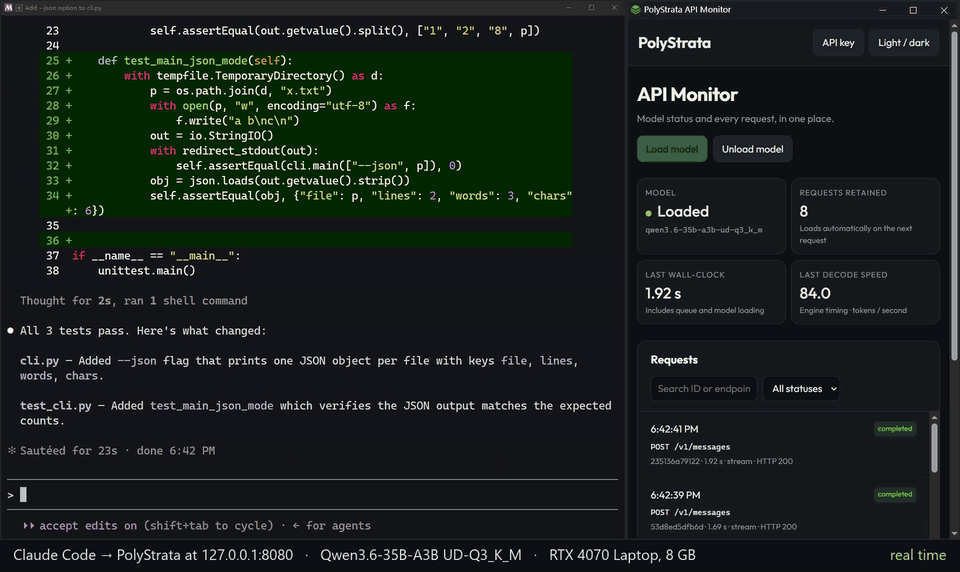
Claude Code と Qwen3.6-35B-A3B UD-Q3_K_M、8 GB のカードのノート PC で、実時間:小さなプログラムに --json オプションを足し、テストを書いて実行します。サーバーは起動時に Claude Code のシステムプロンプトを読んであります("warm_start": true)。
ボクセルの五重塔の庭。1 回のプロンプトで作成し、RTX 5070 上の Strata(Qwen3.8-Flash-Next IQ3_S、128K コンテキスト)で実行 ·
動画全体(49 秒)
PolyStrata は、ふつうはサーバーが必要な大きな AI モデルを普通の PC で動かします。チャットをしたり、コードを書いたり、 アプリやコーディングエージェントと連携したりできます。データが PC の外に出ることはありません。
動かせるモデルは 12 個で、エンジンは 2 つです。
- Qwen3.8-Flash-Next:12 GB 以上の NVIDIA または AMD の グラフィックカード、Windows または Linux。画像も読めます。エンジンは Strata のものをそのまま使っています。
残りの 11 個は PolyStrata のために書いたエンジンで動きます。NVIDIA カードが 1 枚必要です(2 枚でも動きます)。11 個とも Linux で動き、 GLM 5.3 Flash と DeepSeek V4 Flash 以外は Windows でも動きます。まだ実験的で、動かしたのは 32 GB のカードを載せた 1 台の PC と、 小さい 8 つについては 8 GB のカードを載せたノート PC 1 台だけです。
- GLM 5.3 Flash:いちばん大きいモデル。ファイルは 79〜114 GB で、その大部分は RAM に置かれます。
- DeepSeek V4 Flash:ファイルは 91 GB で、これも大部分は RAM に置かれます。会話を覚えておくための VRAM が少なく、128K のコンテキストでも 32K より 0.7 GB 多いだけです。
- LFM2.5-24B-A2B:Liquid AI のモデルで、ファイルは 11〜25 GB。ほとんどの層にアテンションがないので、 長い会話でも VRAM をあまり使いません。128K のコンテキストでも 32K より 2 GB 多いだけです。ライセンスで商用利用が認められるのは、 年間売上が 1,000 万ドル未満の会社だけです。
- Flint 40B-A2.5B:Recursive がコーディングエージェント向けに作ったモデルで、ファイルは 18〜42 GB。 ほとんどの層は直前の 513 トークンしか見ないので、長い会話でも VRAM をあまり使いません。128K のコンテキストでも 32K より 2.6 GB 多いだけです。
- Qwen3.6-35B-A3B:ファイルは 13〜23 GB。画像も読めます。
- Clover-35B-A3B-Preview:DiffuSpace のモデル。Qwen3.6-35B-A3B をさらに学習させ、トークンのまとまりを一度に書けるようにしたもの。ファイルは 13〜21 GB。読めるのはテキストだけです。
- Ornith 1.5:構造は Qwen3.6-35B-A3B と同じで、重みが違います。ファイルは 14〜24 GB。画像も読めます。
- Gemma 4 26B-A4B:ファイルは 11〜17 GB。画像も読めます。
- Tiel Coder 35B-A3B:peculiar-ragdoll がコーディングエージェント向けに量子化した Ornith 1.5。ファイルは 14〜23 GB。画像も読めます。
- MiniCPM-V 4.7 35B-A3B:OpenBMB のモデル。Qwen3.6-35B-A3B と同じ構造で、重みは独自のもの。画像を読むために作られています。ファイルは 16〜29 GB。
- Kolibri 1:Aleph Alpha のモデル。英語と同じようにドイツ語も書けます。ファイルは 29〜48 GB で、小さいカードではほとんどが RAM に置かれます。
サーバーは動かしたまま、インストール済みのモデルを切り替えられます(方法、英語)。
PolyStrata は VecSzn が作りました。 PolyStrata は Niko1221 の Strata をもとにしています。 別のリポジトリにしている理由、AMD や VRAM の少ないカード、ファインチューンなどの質問は FAQ(英語)にあります。
どのくらい速い?
1 トークンは英単語のおよそ ¾ です。
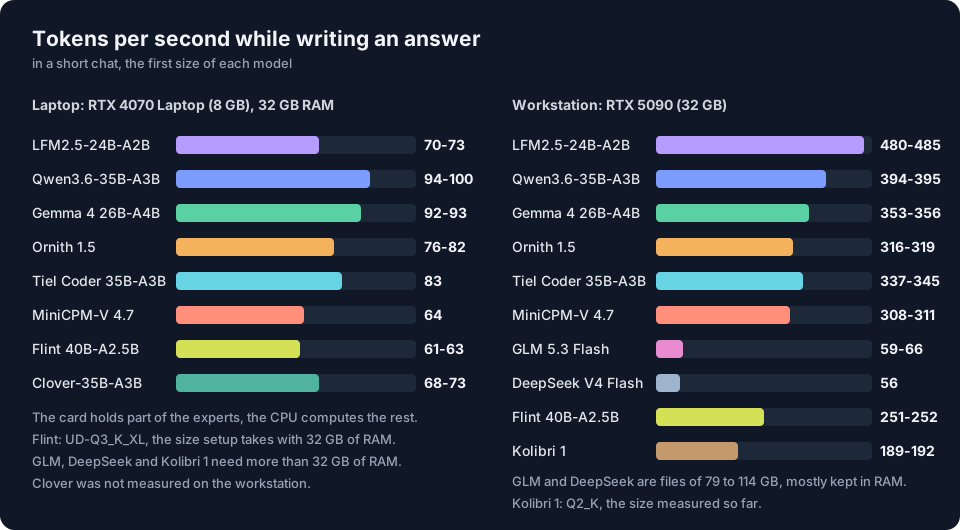
- 回答の書き出し: 短いチャットで返答が表示される速さです。毎秒 60 トークンあれば、読むより速く表示されます。
- プロンプトの読み込み: 送った内容を取り込む速さです(ここでは 32K トークンの文書、コード、またはチャット履歴)。
表はインストーラーが選ぶサイズで、単位は毎秒のトークン数です。各サイズの数値、llama.cpp との比較、測り方は各モデルのページにあります。
| モデル | 8 GB のカードのノート PC 書き出し / 読み込み |
RTX 5090 書き出し / 読み込み |
全サイズ |
|---|---|---|---|
| LFM2.5-24B-A2B | 70-73 / 3,590-3,620 | 480-485 / 23,390-23,460 | LFM2.5 |
| Flint 40B-A2.5B | 61-63 / 2,000-2,010 | 251-252 / 12,900 | Flint |
| Qwen3.6-35B-A3B | 94-100 / 1,690 | 394-395 / 7,800-7,810 | Qwen3.6 |
| Clover-35B-A3B-Preview | 68-73 / 1,560-1,700 | 未測定 | Clover |
| Ornith 1.5 | 76-82 / 1,620 | 316-319 / 8,040-8,110 | Ornith |
| Gemma 4 26B-A4B | 92-93 / 2,240 | 353-356 / 8,420-8,480 | Gemma 4 |
| Tiel Coder 35B-A3B | 83 / 1,700 | 337-345 / 8,080-8,110 | Tiel Coder |
| MiniCPM-V 4.7 35B-A3B | 64 / 1,150 | 308-311 / 7,910-7,950 | MiniCPM-V |
| Kolibri 1 | 未測定 | 189-192 / 4,980-5,070 | Kolibri 1 |
| GLM 5.3 Flash | 動きません(32 GB のカードが必要) | 59-66 / 820 | GLM |
| DeepSeek V4 Flash | 動きません(32 GB のカードが必要) | 56 / 1,040 | DeepSeek |
ノート PC:RTX 4070 Laptop(8 GB)、Core i7-14700HX、RAM 32 GB。ワークステーション:RTX 5090(32 GB)、Xeon Platinum 8470Q(25 vCPU)、RAM 90〜120 GB。Flint はノート PC では UD-Q3_K_XL(RAM 32 GB でインストーラーが選ぶサイズ)、ワークステーションでは UD-Q4_K_XL です。Kolibri 1 はワークステーションでは Q2_K です。そこでインストーラーが選ぶ Q4_K_M は測っていません。
Qwen3.8-Flash-Next は Strata プロジェクトのエンジンで動き、そのプロジェクトが RTX 5070(12 GB)、RAM 64 GB の PC で測りました:IQ2_XS で書き出し 79、32K プロンプトの読み込み 2,090(全サイズ)。
PolyStrata 独自のエンジンで動く 11 個のモデルは、付属のベンチマークで測りました。あなたの PC でも実行できます:
python polystrata.py benchmark --model <name> --prompt-tokens 24000
(何を送り、何を表示するか、英語)。
ほかの人が自分のカードで測った結果と、あなたの PC で llama.cpp と比べる方法:
コミュニティの測定結果(英語)。
ノート PC では Qwen3.6 でも Tiel Coder でも、PolyStrata はプロンプトを llama.cpp b11540 の 2.7〜3.5 倍の速さで読み、
1.5〜1.8 倍の速さで書きました(2 回の測定、英語)。
RAM をどれだけ使うか
0.1.45-poly.7 から、11 モデルのエンジンが使う RAM が減りました。グラフィックカードに載せ終えたモデルファイルの部分を、 RAM に持たなくなったためです。ノート PC で Qwen3.6-35B-A3B が 32,000 トークンのプロンプトを読んだあと、0.1.45-poly.6 は 17.9 GiB、いまは 13.1 GiB で、書く速さは変わりません。Linux では 17.8 GiB から 12.6 GiB になりました。
さらに減らすには、strata-<model>.json の "args" に "--ram-experts-mib", "6144" を加えて
(場所)再起動します。エンジンは VRAM の外に残るエキスパートのために、回答中も含めて
その MiB だけ RAM を使い、起動時にそう表示します。残りはシステムのファイルキャッシュに残り、ほかのプログラムがそのメモリを
使えます。トークンが必要とするときにそこから読みます。書く速度が落ちるので既定ではオフで、改善は続けています。ノート PC
(RTX 4070 Laptop 8 GB、RAM 32 GB、Windows 11)で Qwen3.6-35B-A3B UD-Q3_K_M の場合:
| 既定 | --ram-experts-mib 6144 |
|
|---|---|---|
| 読み込み後にエンジンが使う RAM | 11.7 GiB | 6.5 GiB |
| 書いている間の最大:短い会話 / 32K プロンプトのあと | 14.3 / 14.0 GiB | 6.7 / 7.3 GiB |
| リクエストの合間 | 12.8 GiB | 7.1 GiB |
| 書く速度(トークン/秒):最初の短い会話 | 71.6 | 69.4(3% 遅い) |
| 32K プロンプトのあと | 65.4 | 63.7(3% 遅い) |
| そのあとの短い会話 | 84.2 | 72.9(13% 遅い) |
| 長い回答(短い会話で 1,024 トークン) | 90.6 | 78.3(14% 遅い) |
この測定ではほかのプログラムが VRAM の一部を使っていたので、どちらの列もカードが空いているときより遅くなっています。ほかの 2 回では、32K プロンプトのあとで 6〜8%、そのあとの短い会話で 8〜10% 遅くなりました。Linux(約 8 GB に制限した RTX PRO 6000)では既定の 12.3〜14.3 GiB が 7.0〜7.7 GiB になり、書く速度は 7〜14% 落ちました。エキスパートキャッシュを固定すると (リリース前の確認と同じ条件)、回答はトークン単位で同じです。
プロンプトを読むための VRAM も 350〜400 MiB 減りました。その分はエキスパートキャッシュが使うか(Qwen3.6 は VRAM の
エキスパートが 2,444 個から 2,712 個に)、--vram-reserve-mib でほかのプログラムに残せます。
しくみと測り方:docs/BACKENDS.md。
必要なもの
| モデル | グラフィックカード | RAM(インストーラーのサイズ) | ディスク | OS |
|---|---|---|---|---|
| Qwen3.8-Flash-Next | NVIDIA RTX 20〜50 シリーズ、または AMD RX 6800 / 6900, RX 7700 XT / 7800 XT / 7900 XT / XTX, RX 9060 XT / 9070 / 9070 XT, Radeon AI PRO R9700、12 GB 以上 | 32 GB 以上、64 GB ですべてのサイズ | 約 80 GB | Windows、Linux |
| GLM 5.3 Flash | NVIDIA RTX 20 シリーズ以降、32 GB のカードでのみ動作確認 | 32 GB のカードで 96 GB | 79〜114 GB、SSD に | Linux |
| DeepSeek V4 Flash | 同上 | 32 GB のカードで 72 GB | 91 GB、SSD に | Linux |
| LFM2.5-24B-A2B | NVIDIA RTX 20 シリーズ以降、8 GB 以上 | 8 GB のカードで約 20 GB | 11〜25 GB | Windows、Linux |
| Flint 40B-A2.5B | 同上 | 8 GB のカードで約 22 GB | 18〜42 GB | Windows、Linux |
| Qwen3.6-35B-A3B | 同上、AMD はベータ | 8 GB のカードで約 21 GB | 13〜23 GB | Windows、Linux |
| Clover-35B-A3B-Preview | NVIDIA RTX 20 シリーズ以降、8 GB 以上 | 8 GB のカードで約 20 GB | 13〜21 GB | Windows、Linux |
| Ornith 1.5 | 同上、AMD はベータ | 8 GB のカードで約 22 GB | 14〜24 GB | Windows、Linux |
| Gemma 4 26B-A4B | 同上、AMD はベータ | 8 GB のカードで約 18 GB | 11〜17 GB | Windows、Linux |
| Tiel Coder 35B-A3B | 同上、AMD はベータ | 8 GB のカードで約 21 GB | 14〜23 GB | Windows、Linux |
| MiniCPM-V 4.7 35B-A3B | 同上、AMD はベータ | 8 GB のカードで約 25 GB | 16〜29 GB | Windows、Linux |
| Kolibri 1 | NVIDIA RTX 20 シリーズ以降、8 GB 以上 | 8 GB のカードで約 33 GB | 29〜48 GB | Windows、Linux |
RAM はインストーラーの見積もりで、カードが大きいほど少なくて済みます。ほかはすべてインストーラーが用意します。Windows ではビルド済みのエンジンをダウンロードし、AVX2 のないプロセッサーや、手元のエンジンが最新リリースより新しいときだけ PC でコンパイルします(足りないツールは入れるか聞きます)。2〜3 枚のカードで 1 つのモデルを分担できます(マルチ GPU)。古いグラフィックカード、Intel Arc、Strix Halo、AVX2 のない古いプロセッサー:詳しい一覧。各モデルのカード、RAM、サイズの詳細はそれぞれのページにあります。
Qwen3.6、Clover、Ornith 1.5、Gemma 4、Tiel Coder、MiniCPM-V の 6 つのモデルそれぞれに必要なものと確認の方法:docs/BACKENDS.md(英語)。
インストール
AI にセットアップしてもらう
AI コーディングアシスタント(Claude Code、Cursor、Codex、GitHub Copilot など)を使っていますか? これを貼り付けてください:
Set up PolyStrata on this PC for me: https://github.com/simplexai-labs/PolyStrata - follow docs/AI_SETUP.md in that repository.
AI がグラフィックカード、RAM、ディスクを調べて、合うモデルを選びます。それからインストールして起動し、 アプリのつなぎ方を教えてくれます。AI ツールは PolyStrata の MCP サーバー を通じて、 PolyStrata のインストール、起動、停止もできます。
自分でやる
PolyStrata をダウンロードして展開します(または git clone します)。
Windows: START-HERE.bat をダブルクリック。Linux: PolyStrata フォルダーで ./setup.sh を実行します。
手順は NVIDIA でも AMD でも同じです。インストーラーがカードを見つけて、それに合うエンジンを用意します。 いくつか質問があります:
- どのモデルを、どのサイズで使うか
- コンテキストをどのくらいにするか(モデルが覚えておけるテキストの量)
- 画像を読ませるかどうか(GLM 5.3 Flash、DeepSeek V4 Flash、LFM2.5、Flint、Clover、Kolibri 1 は画像を読めません)
Mac(Apple シリコン、M1〜M5、macOS 15 以降): まず一度だけ Apple の Command Line Tools をインストールします(ターミナルで xcode-select --install。Xcode 本体は不要です)。次に PolyStrata フォルダーでターミナルを開き、./setup.sh を実行します。Mac 用エンジンをお使いの Mac 上でビルドし(約 7 分)、同じ質問をしてからモデルをダウンロードして起動します。次回からは ./setup.sh ですぐに起動します。どのサイズが Mac に合うかと速度:docs/MAC.md。Mac 用エンジンで動くのは Qwen3.8-Flash-Next だけで、残りの 11 個には NVIDIA か AMD のグラフィックカードが必要です。
毎回 Enter を押せば、おすすめの答えになります。そのあとモデル(Qwen3.8-Flash-Next は約 70 GB、GLM 5.3 Flash は 79〜114 GB、DeepSeek V4 Flash は 91 GB、Kolibri 1 は 29〜48 GB、ほかの 8 つは 11〜42 GB)をダウンロードして起動します。
ダウンロードが止まったら、もう一度実行してください。続きから再開します。ブラウザーで PolyStrata アプリが
http://127.0.0.1:8080 に開きます。
12 個ともインストーラーのモデル一覧にあります。./setup.sh --family glm(または deepseek、lfm25、flint、qwen36、clover、ornith、gemma4、tiel、minicpmv、kolibri)なら
直接そこへ進みます(何を尋ね、何を書き出すか、英語)。
モデルの起動中、1-3 分ほど PC が重くなったり、反応しなくなったりすることがあります(初回がいちばん長いです)。 PolyStrata は 35-55 GB を RAM に読み込み、その一部をグラフィックカード用に固定します。これは正常です。 ウィンドウを閉じずに待ってください。PolyStrata が何をしているかはウィンドウに表示されます。
次回からは START-HERE.bat(または ./setup.sh)をもう一度実行します。すぐに起動し、同じものを 2 回ダウンロードすることはありません。
モデルを止めるときはウィンドウを閉じます。UPDATE.bat(./update.sh)を使うと、PolyStrata を起動せずに更新できます。
更新、Docker、複数のカード、ファイルの保存場所、すべてのオプションについて:docs/INSTALL.md。
自分の PC で速いか知りたいときは BENCH.bat(./bench.sh)を実行します。5〜10 分ほどで、チャット、4K/16K のプロンプト、エージェント風のセッションを自分の設定のまま測り、共有できるレポートを書き出します(やり方)。
どのモデルを選べばいい
同じモデルにも圧縮の度合いが違うサイズがいくつかあります。小さいサイズほど速く RAM も少なくて済み、大きいほど元のモデルに近くなります。Enter を押せばインストーラーが RAM とカードに合わせて選びます。別のサイズはインストール時に --model <サイズ> を付けます。
| モデル | インストーラーの選択 | RAM が足りないとき | 名前で指定 |
|---|---|---|---|
| Qwen3.8-Flash-Next | RAM 32 GB:Coder、48〜64 GB:IQ2_XS、96 GB 以上:IQ3_S | Q2_0、IQ3_XXS、Unsloth の 4〜8 bit | |
| GLM 5.3 Flash | 3.0BIT | UD-IQ2_XXS、さらに足りなければ REAP50-Q3_K_M | |
| DeepSeek V4 Flash | UD-IQ2_XXS(これだけ) | ||
| LFM2.5-24B-A2B | UD-Q4_K_XL | UD-Q3_K_XL | QAD-Q4_0, UD-Q6_K_XL, Q8_0 |
| Flint 40B-A2.5B | RAM 約 40 GB から UD-Q4_K_XL | UD-Q3_K_XL | UD-Q6_K_XL, Q8_0 |
| Qwen3.6-35B-A3B | UD-Q3_K_M | UD-Q2_K_XL | UD-Q4_K_M |
| Clover-35B-A3B-Preview | Q3_K_M | APEX-I-NANOPLUS | Q4_K_M |
| Ornith 1.5 | APEX-I-COMPACT | APEX-I-MINI | APEX-I-QUALITY |
| Gemma 4 26B-A4B | UD-Q3_K_M | UD-Q2_K_XL | UD-Q4_K_M, QAT-UD-Q4_K_XL |
| Tiel Coder 35B-A3B | UD-Q3_K_XL | UD-IQ3_XXS | UD-Q4_K_XL |
| MiniCPM-V 4.7 35B-A3B | Q4_K_M | mix_q3gud_im | Q6_K |
| Kolibri 1 | RAM 約 48 GB から Q4_K_M | Q2_K | Q3_K_M |
各サイズの中身、ダウンロード量、ほかのカードでの必要 RAM、最大サイズとの差:各モデルのページ(「どのくらい速い?」の表のモデル名から)。
使い方
12 個のモデルの使い方は同じです。同じアプリ、同じ API です。
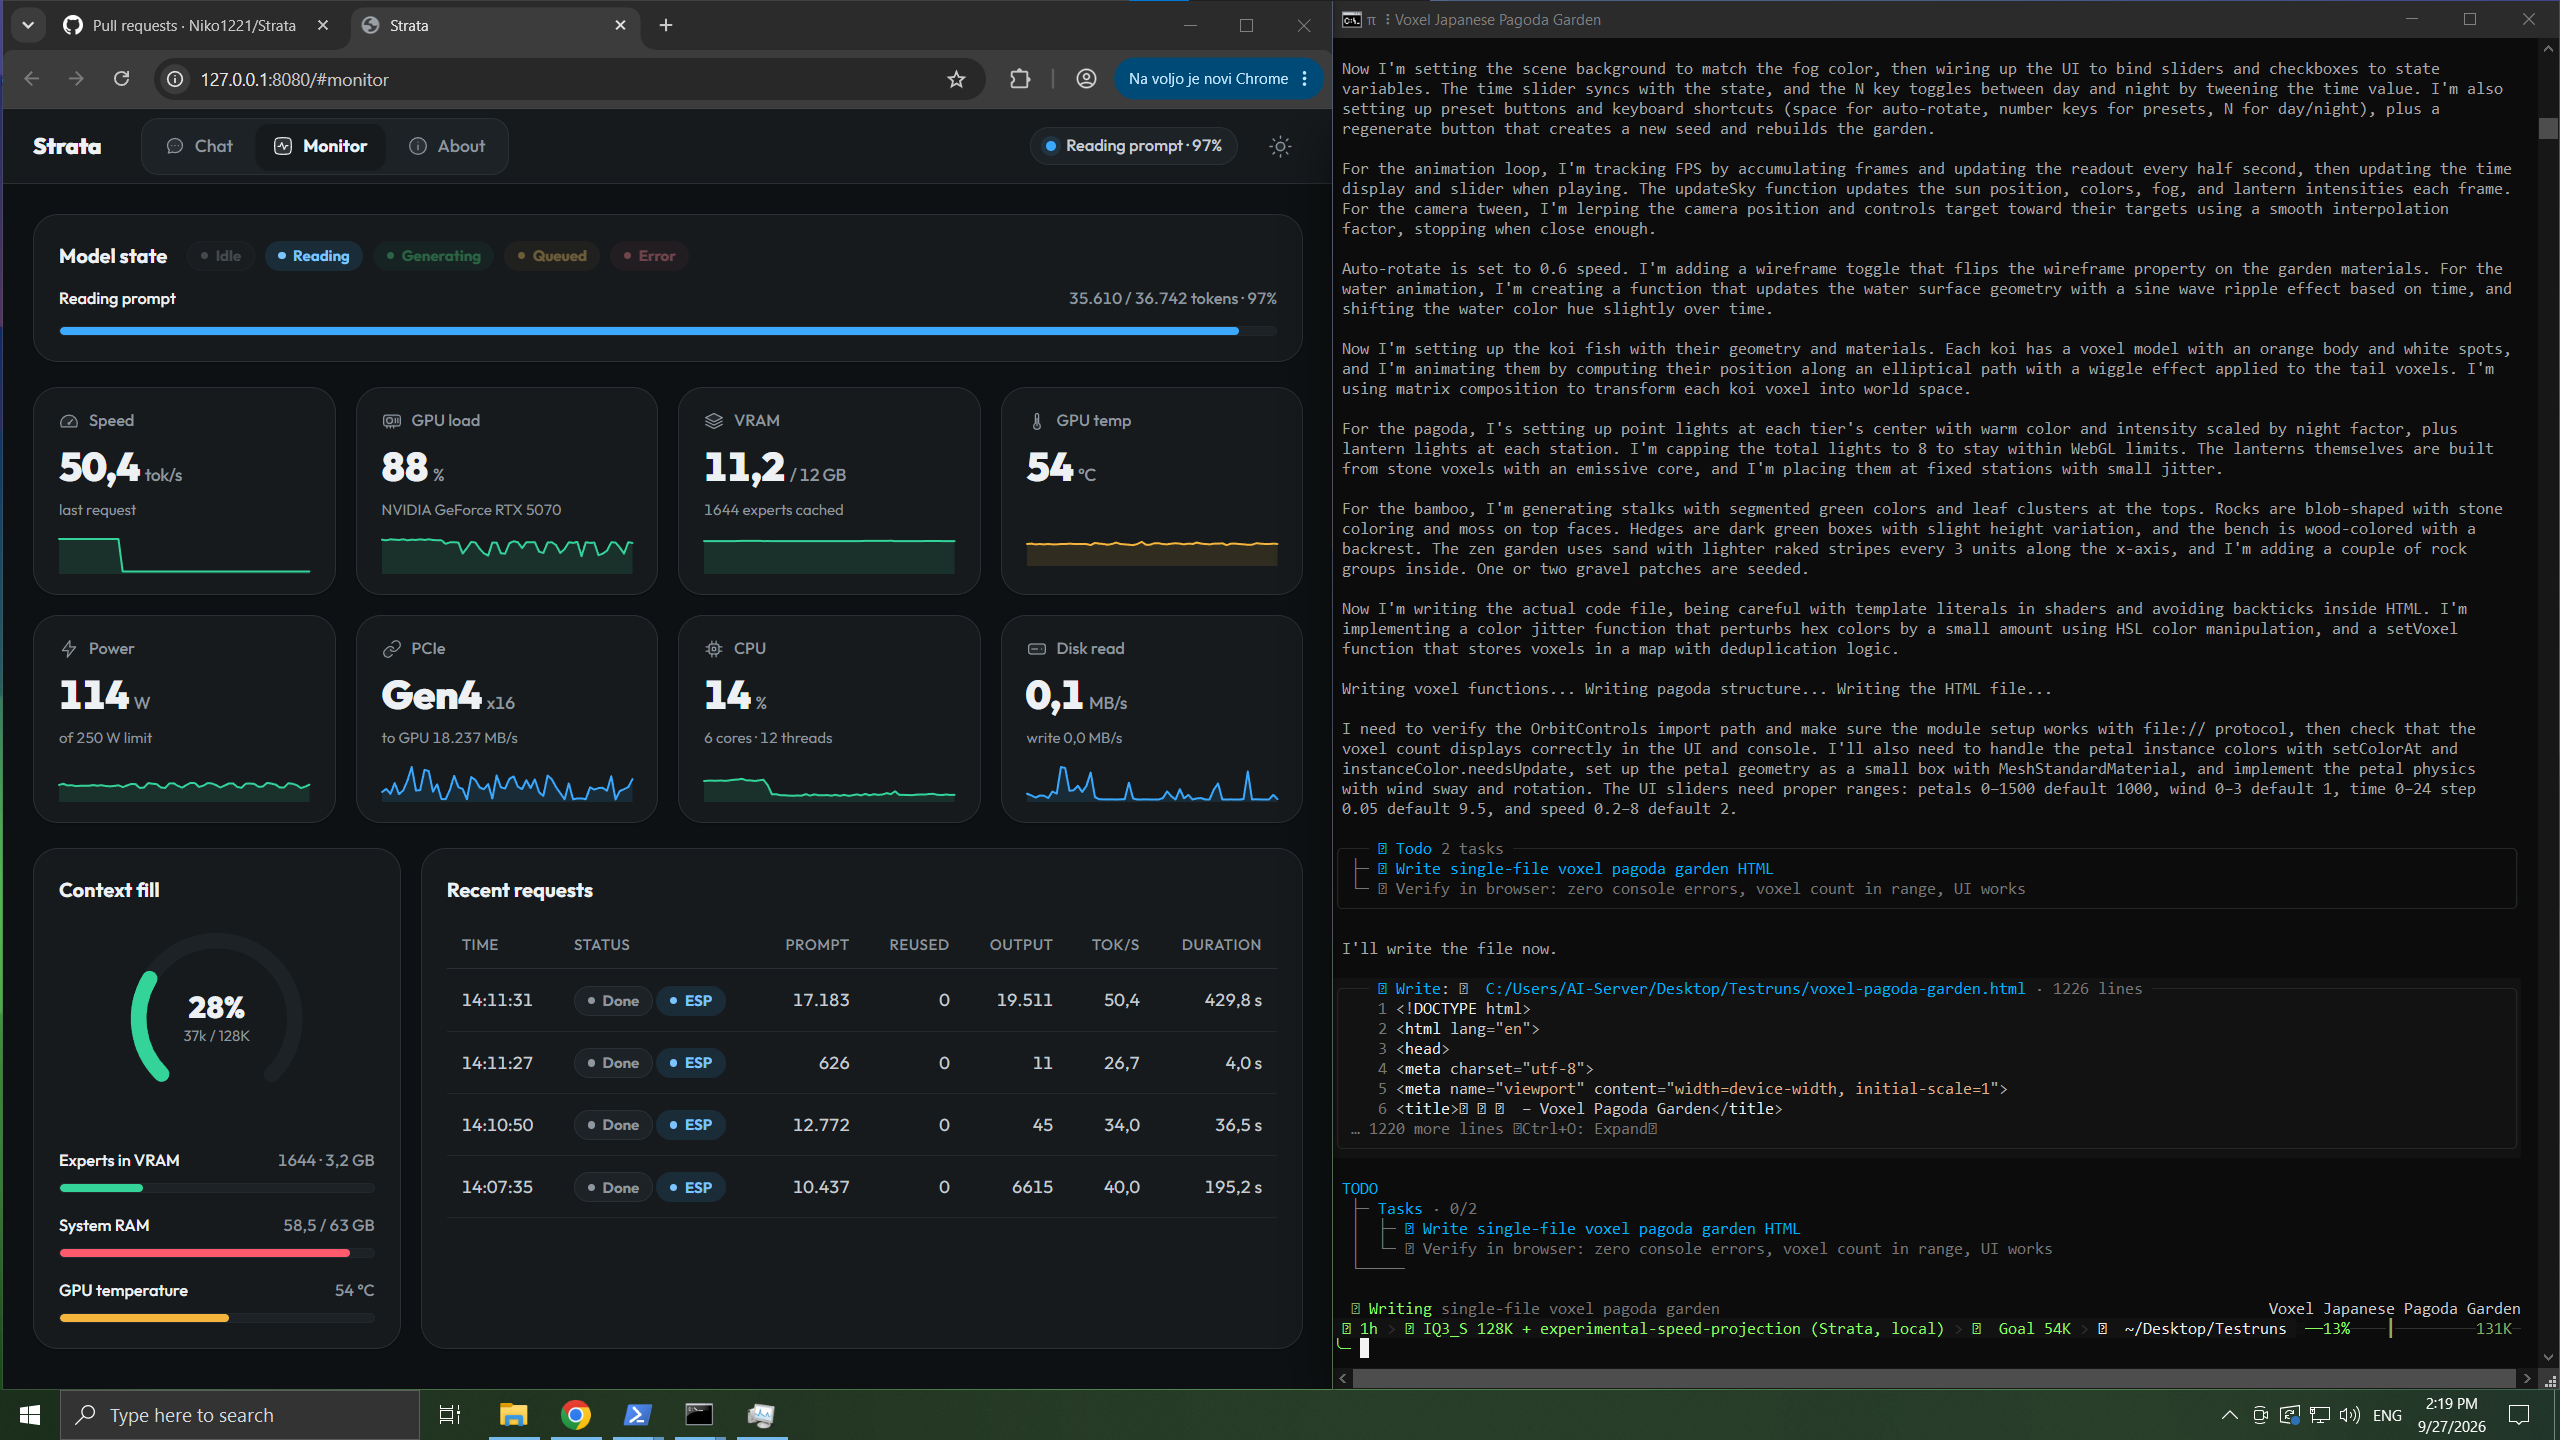
PolyStrata アプリの Monitor(左)。コーディングエージェントが動画の五重塔の庭を書いているところ(右)。Strata のスクリーンショットです。
- ブラウザーで:
http://127.0.0.1:8080を開きます。Chat、モデルと GPU/CPU/RAM の様子をリアルタイムで見る Monitor、 設定とアドレスが載った About があります。 - アプリやコーディングエージェントから: 「OpenAI-compatible」プロバイダーを追加し、ベース URL に
http://127.0.0.1:8080/v1を指定します。API キーとモデル名は何でもかまいません。 - 思考(Thinking): チャットのメニュー、またはアプリの「reasoning effort」で off、low、medium、high を選びます。 off がいちばん速く、high は難しい質問に向いています。
- スマートフォンや別の PC から:
START-HERE.bat --setup --host 0.0.0.0 --api-key <secret>。キーは必ず設定してください。
モデルによって違うところ:
| Qwen3.8-Flash-Next | GLM 5.3 Flash | DeepSeek V4 Flash | LFM2.5-24B-A2B | Flint 40B-A2.5B | Kolibri 1 | Qwen3.6-35B-A3B、Clover-35B-A3B-Preview、Ornith 1.5、Gemma 4 26B-A4B、Tiel Coder 35B-A3B、MiniCPM-V 4.7 35B-A3B | |
|---|---|---|---|---|---|---|---|
| 画像 | セットアップで「Images?」に yes と答えます。そのあとチャットで Picture をクリックするか、アプリで画像を添付します。AMD のカードは、Linux ではプロセッサーを使って画像を読みます。Windows ではまだ読めません。 | まだ読めません。 | テキストだけです。 | テキストだけです。 | テキストだけです。 | テキストだけです。 | セットアップで「Images?」に yes と答えます。あとは Qwen3.8-Flash-Next と同じです。16 GB 未満のカードでは画像エンコーダーがプロセッサーで動き、画像 1 枚に数秒かかります。Clover はテキストだけです。 |
| リクエストは 1 つずつ | 初期設定では PolyStrata は 1 つのリクエストに答え、ほかは待ちます。複数に同時に答えるには"parallel": 2 を設定します(BATCHING.md)。12 GB のカードでは、それぞれの回答が遅くなります。 |
1 つずつ答え、ほかは待ちます。 | 1 つずつ答え、ほかは待ちます。 | 1 つずつ答え、ほかは待ちます。 | 1 つずつ答え、ほかは待ちます。 | 1 つずつ答え、ほかは待ちます。 | 1 つずつ答え、ほかは待ちます。 |
| 複数の会話 | 直前の会話は保持されるので、2 通目以降は数秒で始まります。エンジンの引数を 2 つ足すと、複数の会話を RAM に保持できます(詳細)。 | 直前の会話は保持されます。セットアップで、複数の会話を RAM に保持するかどうかを尋ねます。保持すると、エージェントとサブエージェントが交互に使っても、プロンプトを読み直しません(仕組み)。 | GLM 5.3 Flash と同じです。 | GLM 5.3 Flash と同じです。 | GLM 5.3 Flash と同じです。 | GLM 5.3 Flash と同じです。 | GLM 5.3 Flash と同じです。 |
| 長いプロンプト | PolyStrata はチャットの最初のメッセージをすべて読みます。30,000 トークンあたり約 1 分かかります。2 通目以降のメッセージは数秒で始まります。 | 最初のメッセージはすべて読みます。30,000 トークンあたり約 40 秒かかります。 | 最初のメッセージはすべて読みます。30,000 トークンあたり約 29 秒かかります。 | 最初のメッセージはすべて読みます。30,000 トークンにワークステーションで 1.3〜1.5 秒、8 GB のノート PC で 8〜10 秒かかります。 | 最初のメッセージはすべて読みます。30,000 トークンにワークステーションで約 2.3 秒、8 GB のノート PC で 15〜22 秒かかります。 | 最初のメッセージはすべて読みます。30,000 トークンにワークステーションの Q2_K で約 6 秒かかります。 | 最初のメッセージは全部読みます。30,000 トークンで、ワークステーションは 4〜5 秒、8 GB のノート PC は 14〜27 秒です。 |
オプション:モデル全体が RAM に収まる場合、GPU 1 枚でさらに高速化
2 つのオプトイン設定です(RubenTorney 氏による #1904 と #1905)。GPU を 1 枚使い、RAM にすべてのエキスパートが収まる場合(PolyStrata の arena モード。例:64 GB の PC で Q2_0 や IQ3_XXS)に効果があります。PolyStrata のデータフォルダーにある設定ファイル strata-<model>.json(場所)を開き、次を追加します:
- 生成の高速化:
"args"リストに"--adapt-async", "1"。エキスパートキャッシュの更新が回答を止めずに補助スレッドで行われます。RTX 5070(Windows、Q2_0)での実測:生成 +4〜5%、コードや長文では +7〜10%。回答はデフォルトとわずかに異なる場合があります(実行ごとには同じです)。 - Windows でのプロンプト読み込みの高速化:
"env"ブロックに"STRATA_PIN_BY_NEED": "1"。Windows はGPU 用に RAM の約半分しか固定できないため、この設定で GPU が本当に必要とするエキスパートから先に固定します。RTX 5070 での実測:プロンプト読み込み +4.4%。
"args": [ ..., "--adapt-async", "1" ],
"env": { "STRATA_PIN_BY_NEED": "1" }
変更後は PolyStrata を再起動してください(START-HERE.bat または ./setup.sh)。元に戻すには、2 つの項目を削除します。
うまくいかないとき
- PolyStrata の初回起動で PC が固まった。 モデルの読み込み中はよくあることです。ウィンドウを閉じずに待ってください。 10 分たっても固まったまま? PC を再起動し、ほかのプログラムを閉じてもう一度試すか、小さいサイズを選んでください。
- ダウンロードやインストールの途中で止まった。
START-HERE.bat(または./setup.sh)をもう一度実行してください。 止まったところから続きます。 - とても遅く、ディスクのランプが点滅し続ける。または「the engine stopped unexpectedly」と表示される。 PC の空き RAM が 足りません。ほかのプログラムを閉じるか(ブラウザーは多く使います)、小さいサイズ(Q2_0 または IQ2_XS)を選んでください。
- ポート 8080 がすでに使われていると表示される。 PolyStrata はもう動いています。そのウィンドウを探してください。
ほかの問題と解決方法:docs/TROUBLESHOOTING.md。それでも解決しない場合は
issue を作成し、PolyStrata フォルダーにある strata-<model>.log を添付してください。
セキュリティの問題を見つけたら、非公開で報告してください:SECURITY.md。
しくみ
このようなモデルは、ふつう数百ギガバイトのグラフィックメモリを持つサーバーで動きます。あなたのグラフィックカードは 8-32 GB です。PolyStrata は PC 全体で作業を分担する ことで、モデルを収めています。台所を思い浮かべてください。 いつも使う道具は調理台に置き、残りは食料庫にしまっておきます。
各モデルの図と説明:docs/HOW_IT_WORKS_MODELS.ja.md。
クレジットとライセンス
Qwen3.8-Flash-Next は Qwen チーム のモデルです。圧縮は ISTA-DASLab、UkisAI(Swift 1.5)、Unsloth によるものです。 GLM 5.3 Flash は neuralll、Unsloth、 patrickbdevaney のファイルで動きます。Qwen3.6-35B-A3B は Qwen チーム、Gemma 4 は Google、DeepSeek V4 Flash は DeepSeek のモデルで、 3 つとも Unsloth の量子化を使っています。LFM2.5-24B-A2B は Liquid AI のモデルで、Unsloth の量子化と Liquid AI 自身の QAD-Q4_0 を使っています。Flint 40B-A2.5B は Recursive のモデルで、Unsloth の量子化を使っています。Kolibri 1 は Aleph Alpha のモデルで、Hob-forge による GGUF 変換を使っています。Clover-35B-A3B-Preview は DiffuSpace のモデルで、maternion の量子化と IsValorum の APEX を使っています。Ornith 1.5 は ornith-ai のモデルで、 mudler の APEX 量子化を使っています。Tiel Coder 35B-A3B は peculiar-ragdoll が量子化した Ornith 1.5 で、PolyStrata で動くことは u/Sensitive_Song4219 が見つけました。MiniCPM-V 4.7 35B-A3B は OpenBMB のモデルで、OpenBMB 自身の量子化を使っています。PolyStrata に組み込んだのは iMilnb です。PolyStrata は Niko1221 とコントリビューターによる Strata をもとにしており、 llama.cpp / ggml の一部を使っています。すべてのクレジット: docs/HOW_IT_WORKS.md。PolyStrata は MIT License のオープンソースです。一部のパーツと すべてのモデルには、それぞれ独自のライセンスがあります(どれか)。
関連プロジェクトを探す
affaan-m/ECC
エージェント実行・制御フレームワークの性能最適化システム。Claude Code、Codex、Opencode、Cursor などに向けたスキル、本能、メモリ、セキュリティ、研究優先の開発を備えています。
301,914 スターNousResearch/hermes-agent
あなたと共に成長するエージェント
262,937 スターmultica-ai/andrej-karpathy-skills
Claude Code の挙動を改善するための単一の CLAUDE.md ファイルで、Andrej Karpathy による LLM コーディングの落とし穴に関する観察に基づいています。
232,506 スターfirecrawl/firecrawl
ウェブをはじめとする幅広いデータで、AI エージェントを強化します。超知能のためのライブラリを構築しています。🔥
200,932 スター