
datascale-ai/data_engineering_book
datascale-ai/data_engineering_book has 1,386 GitHub stars and 138 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-07 07:13 UTC. Last push 2026-09-09.
大模型数据工程:架构、算法及项目实战
計測したスター増加
- 24時間
- 0
- 7日間
- 履歴を収集中
- 15日間
- 履歴を収集中
- 1か月
- 履歴を収集中
期間ごとの純増数です。期間は重複しており、日別の値ではありません。未計測の値は空欄です。スター数は注目度の指標であり、品質の保証ではありません。
README_ja.md
オリジナル大規模モデルのデータエンジニアリング:アーキテクチャ・アルゴリズム・実践プロジェクト

バージョン注記:中国語版は現在の 2026 Springer 出版主線で、14 部、48 章、15 件のプロジェクトケーススタディ、8 つの付録(A–H)に固定されています。英語版と日本語版は部分翻訳および対外紹介用ビューとして更新中で、ドキュメントサイトには翻訳状況ページを用意しています。
導入
「データは新しい石油ですが、それを精製する方法を知っている場合に限ります。」
大規模モデルの時代では、データ品質がモデルのパフォーマンスの上限を決定します。しかし、LLM データエンジニアリングに関する体系的なリソースは依然として非常に不足しており、ほとんどのチームはまだ試行錯誤によって学習しています。
本書はそのギャップを埋めるために企画されました。事前学習データのクリーニングからマルチモーダルアライメント、RAG 検索拡張から合成データ生成、さらには DataOps プラットフォーム構築とプライバシーコンプライアンスまで、完全な技術スタックを体系的にカバーしています。
- 🧹 事前学習データエンジニアリング: Common Crawl などの大規模ノイズデータから高品質コーパスを抽出する
- 🖼️ マルチモーダルデータ処理: 画像・テキストペア、動画、音声データの収集・クリーニング・アライメント
- 🎯 アライメントデータ構築: SFT 指示データ、RLHF 選好データ、CoT 推論データの自動生成
- 🤖 推論と Agent データ: 思考の連鎖、Tool-Use、多ターン対話・メモリデータエンジニアリング
- 🔍 RAG データパイプライン: エンタープライズグレードのドキュメント解析、セマンティックチャンキング、マルチモーダル検索
- ⚙️ DataOps とプラットフォーム構築: チーム組織、データバージョン管理、プラットフォーム可観測性
- 🔒 プライバシー・コンプライアンスとセキュリティ: データガバナンスフレームワーク、連合学習、プライバシー強化技術
詳細な理論的説明に加えて、中国語主線には 15 のエンドツーエンドプロジェクトケーススタディが含まれています。利用可能なコード、アーキテクチャ設計、エンジニアリング上の振り返りを通じて、実践的に学べる構成です。
オンラインで読む: https://datascale-ai.github.io/data_engineering_book/ja/
本のアーキテクチャ
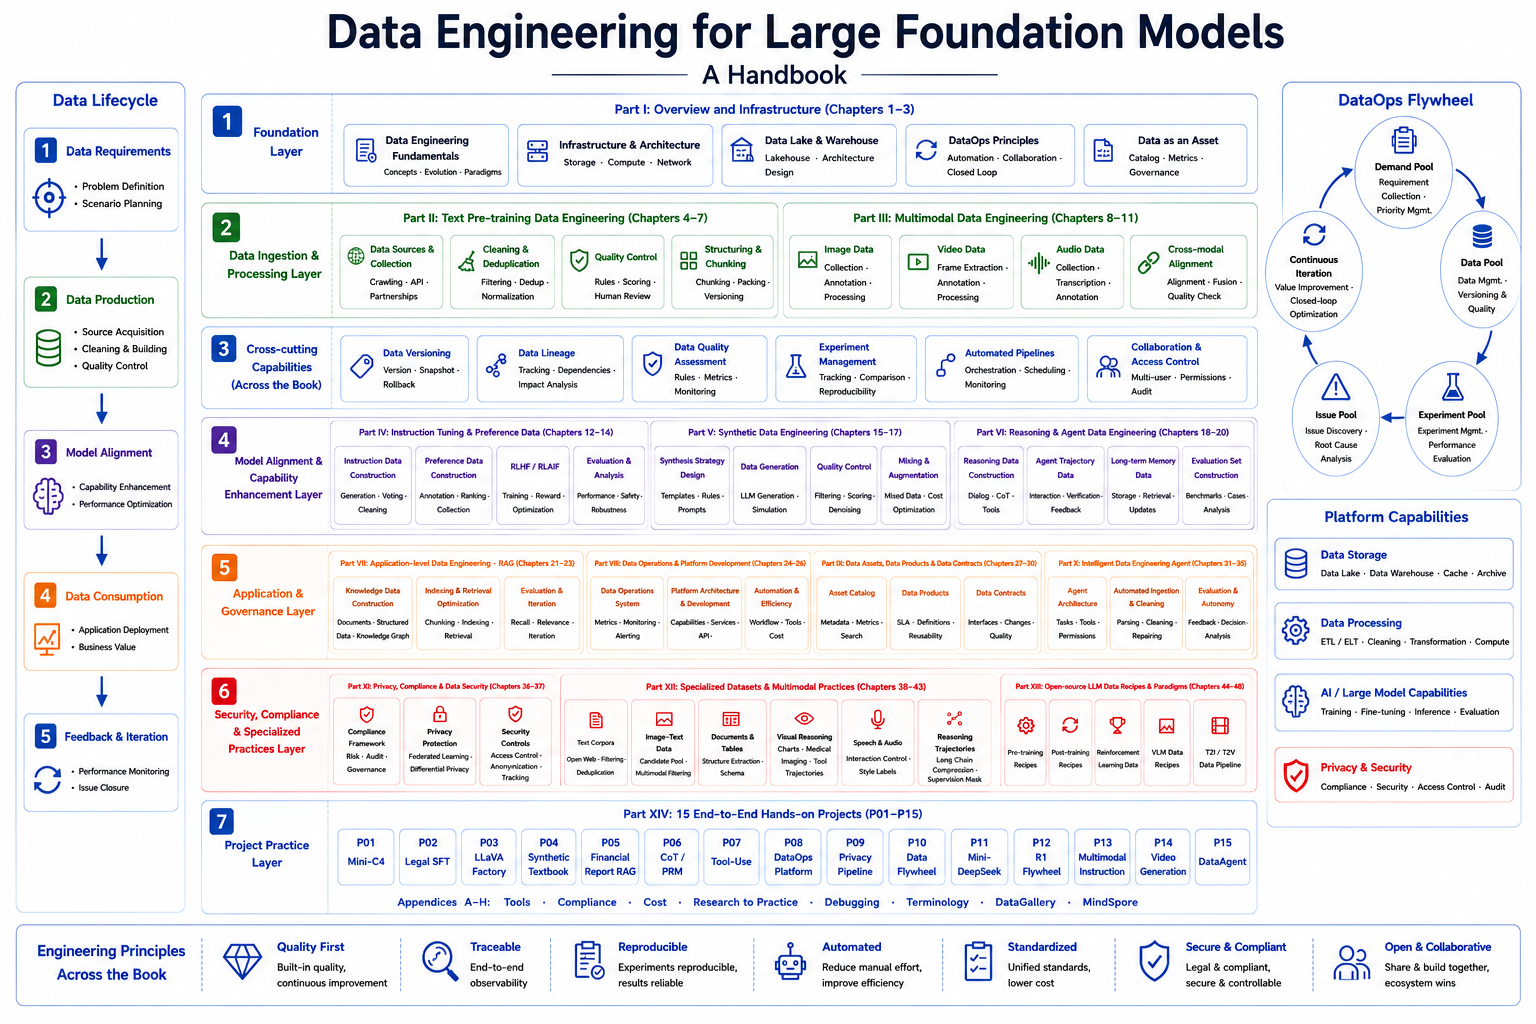
生データからエンドツーエンドのアプリケーションまでの完全なデータエンジニアリングパイプライン
目次
📖 全14部、48章 + 15件のプロジェクトケーススタディ + 8つの付録(A–H)
│
├── 第1部:総論とインフラ(第1-3章)
├── 第2部:テキスト事前学習データエンジニアリング(第4-7章)
├── 第3部:マルチモーダルデータエンジニアリング(第8-11章)
├── 第4部:指示ファインチューニングと嗜好データ(第12-14章)
├── 第5部:合成データエンジニアリング(第15-17章)
├── 第6部:推論と Agent データエンジニアリング(第18-20章)
├── 第7部:アプリケーション級データエンジニアリング(第21-23章)
├── 第8部:DataOps とプラットフォーム構築(第24-26章)
├── 第9部:データ資産・データプロダクト・データ契約(第27-30章)
├── 第10部:Agentic Data Engineering(第31-35章)
├── 第11部:プライバシーコンプライアンスとデータセキュリティ(第36-37章)
├── 第12部:専門データセットとマルチモーダルデータエンジニアリング実践(第38-43章)
├── 第13部:オープンソースモデルのデータレシピ(第44-48章)
└── 第14部:プロジェクトケーススタディ(P01-P15)
主要なハイライト
総合的な理論体系
- データ中心の AI 哲学が全体を貫く
- LLM データライフサイクル全体をカバー:事前学習 → ファインチューニング → RLHF → RAG → DataOps
- スケーリングの法則、データ品質評価、マルチモーダルアライメント、プライバシーコンプライアンスなどを詳しく解説
モダンな技術スタック
| ドメイン | テクノロジー |
|---|---|
| 分散コンピューティング | Ray Data, Spark, Dask |
| データストレージ | Parquet, WebDataset, ベクトルデータベース (Milvus/Qdrant) |
| テキスト処理 | Trafilatura, KenLM, MinHash LSH, fastText 品質スコアリング |
| マルチモーダル | CLIP, ColPali, img2dataset |
| データバージョン管理 | DVC, LakeFS, MLflow |
| プラットフォーム可観測性 | Great Expectations, Evidently AI, Apache Airflow |
| プライバシーとセキュリティ | 連合学習, 差分プライバシー, セキュア MPC |
豊富なキャップストーンプロジェクト
| プロジェクト | コア技術 | 出力 |
|---|---|---|
| Mini-C4 事前学習セット | Trafilatura + Ray + MinHash | 高品質テキストコーパス |
| 法律専門家 SFT | Self-Instruct + CoT | ドメイン指示データセット |
| LLaVA マルチモーダル指示 | Bbox アライメント + マルチ画像インターリーブ | 視覚的指示データセット |
| 合成数学教材 | Evol-Instruct + サンドボックス検証 | PoT 推論データセット |
| 財務レポート RAG | ColPali + Qwen-VL | マルチモーダル QA システム |
| CoT 推論 + PRM | プロセス報酬モデリング | 推論過程データセット |
| Agent Tool-Use ファクトリー | ツール呼び出しチェーン + 軌跡アノテーション | Agent 訓練データセット |
| DataOps プラットフォーム | Airflow + DVC + 品質監視 | エンタープライズデータ運用体系 |
| プライバシー保護パイプライン | 連合学習 + 差分プライバシー | コンプライアント訓練パイプライン |
| LLM データフライホイール | オンラインフィードバック + 継続的イテレーション | エンドツーエンドクローズドループシステム |
| Mini-DeepSeek 再現 | 多ソース混合 + 重複排除 + Tokenizer | オープンソース事前学習データレシピ |
| R1 推論フライホイール | 複数サンプリング + verifier + rejection sampling | 推論データ閉ループ |
| マルチモーダル指示工場 | VLM 生成 + Judge フィルタ + 多言語拡張 | マルチモーダル SFT データセット |
| 動画生成データセット | ショット分割 + モーションフィルタ + 複数フレーム caption | T2V 訓練データパイプライン |
| DataAgent セマンティック NL2SQL アシスタント | セマンティック層 + Text-to-SQL + 権限監査 | エンタープライズ問合せ Agent ケーススタディ |
ローカル開発
要件
- Python 3.8+
- MkDocs Material
- mkdocs-static-i18n (i18n サポート)
インストールとプレビュー
# リポジトリをクローン
git clone https://github.com/datascale-ai/data_engineering_book.git
cd data_engineering_book

# 依存関係をインストール
pip install mkdocs-material mkdocs-glightbox pymdown-extensions "mkdocs-static-i18n[material]"

# ローカルプレビュー
mkdocs serve
http://127.0.0.1:8000 にアクセスして書籍をプレビューしてください(中国語/英語/日本語の言語スイッチャー付き)。
静的サイトのビルド
mkdocs build
生成された静的ファイルは site/ ディレクトリにあります。
プロジェクト構造
data_engineering_book/
├── docs/
│   ├── zh/                    # 中国語コンテンツ
│   │   ├── index.md           # 中国語ホームページ
│   │   └── part1/ ~ part14/   # 中国語 Springer 主線
│   ├── en/                    # 英語コンテンツ
│   ├── ja/                    # 日本語コンテンツ
│   ├── images/                # 画像アセット(共有)
│   ├── stylesheets/           # カスタムスタイル
│   └── javascripts/           # JavaScript (MathJax など)
├── .github/workflows/         # GitHub Actions CI/CD
├── images/                    # プロジェクト画像アセット
├── mkdocs.yml                 # MkDocs 設定
├── LICENSE                    # ライセンス
├── README.md                  # 中文说明
├── README_en.md               # English README
└── README_ja.md               # 日本語 README(本ファイル)
対象読者
- LLM 研究開発エンジニア
- データエンジニア / MLOps / DataOps エンジニア
- AI プロダクトマネージャー(技術系)
- LLM データパイプラインに興味のある研究者
主要著者
於俊教授チーム
所属研究室:
中国科学技術大学 音声・言語情報処理国家工学研究センター
中国科学技術大学 自動化学科 マルチメディア計算・知能ロボティクス研究センター
中国科学技術大学 自動化学科 マルチモーダルインテリジェントエージェント共同研究センター
貢献する
貢献は大歓迎です!Issue やプルリクエストを遠慮なく送信してください。
- このリポジトリをフォークする
- 機能ブランチを作成する (
git checkout -b feature/AmazingFeature) - 変更をコミットする (
git commit -m 'Add some AmazingFeature') - ブランチにプッシュする (
git push origin feature/AmazingFeature) - プルリクエストを開く
ライセンス
このプロジェクトは MIT ライセンスに基づいてライセンスされています。詳細については LICENSE ファイルを参照してください。
連絡先
- GitHub Issues: 問題を送信する
- オンラインで読む: https://datascale-ai.github.io/data_engineering_book/ja/
この本が役に立ったと思われる場合は、ぜひ Star をつけてください! ⭐