
QwenAudio/SenseVoice has 9,726 GitHub stars and 846 forks. GitHot measured +47 in 7 days. Last checked 2026-11-10 03:39 UTC. Last push 2026-09-30.
オープンソースの SenseVoiceSmall モデルです。中国語(普通話)、広東語、英語、日本語、韓国語の音声認識、言語識別、感情認識、音声イベント検出に対応しています。
できること
- Research scope vs released checkpoint: The broader SenseVoice work reports training on more than 400,000 hours and support for more than 50 languages. The released SenseVoiceSmall checkpoint linked above supports Mandarin, Cantonese, English, Japanese, and Korean; the benchmark comparisons below are task- and language-specific.
- Possess excellent emotion recognition capabilities, achieving and surpassing the effectiveness of the current best emotion recognition models on test data.
- Offer sound event detection capabilities, supporting the detection of various common human-computer interaction events such as bgm, applause, laughter, crying, coughing, and sneezing.
- Efficient Inference: SenseVoiceSmall uses a non-autoregressive end-to-end framework for low-latency inference; see the benchmark setup and comparison below.
計測したスター増加
- 24時間
- 更新が遅れています
- 7日間
- +47
- 15日間
- 更新が遅れています
- 1か月
- 更新が遅れています
期間ごとの純増数です。期間は重複しており、日別の値ではありません。未計測の値は空欄です。スター数は注目度の指標であり、品質の保証ではありません。
README_ja.md
オリジナルSenseVoice
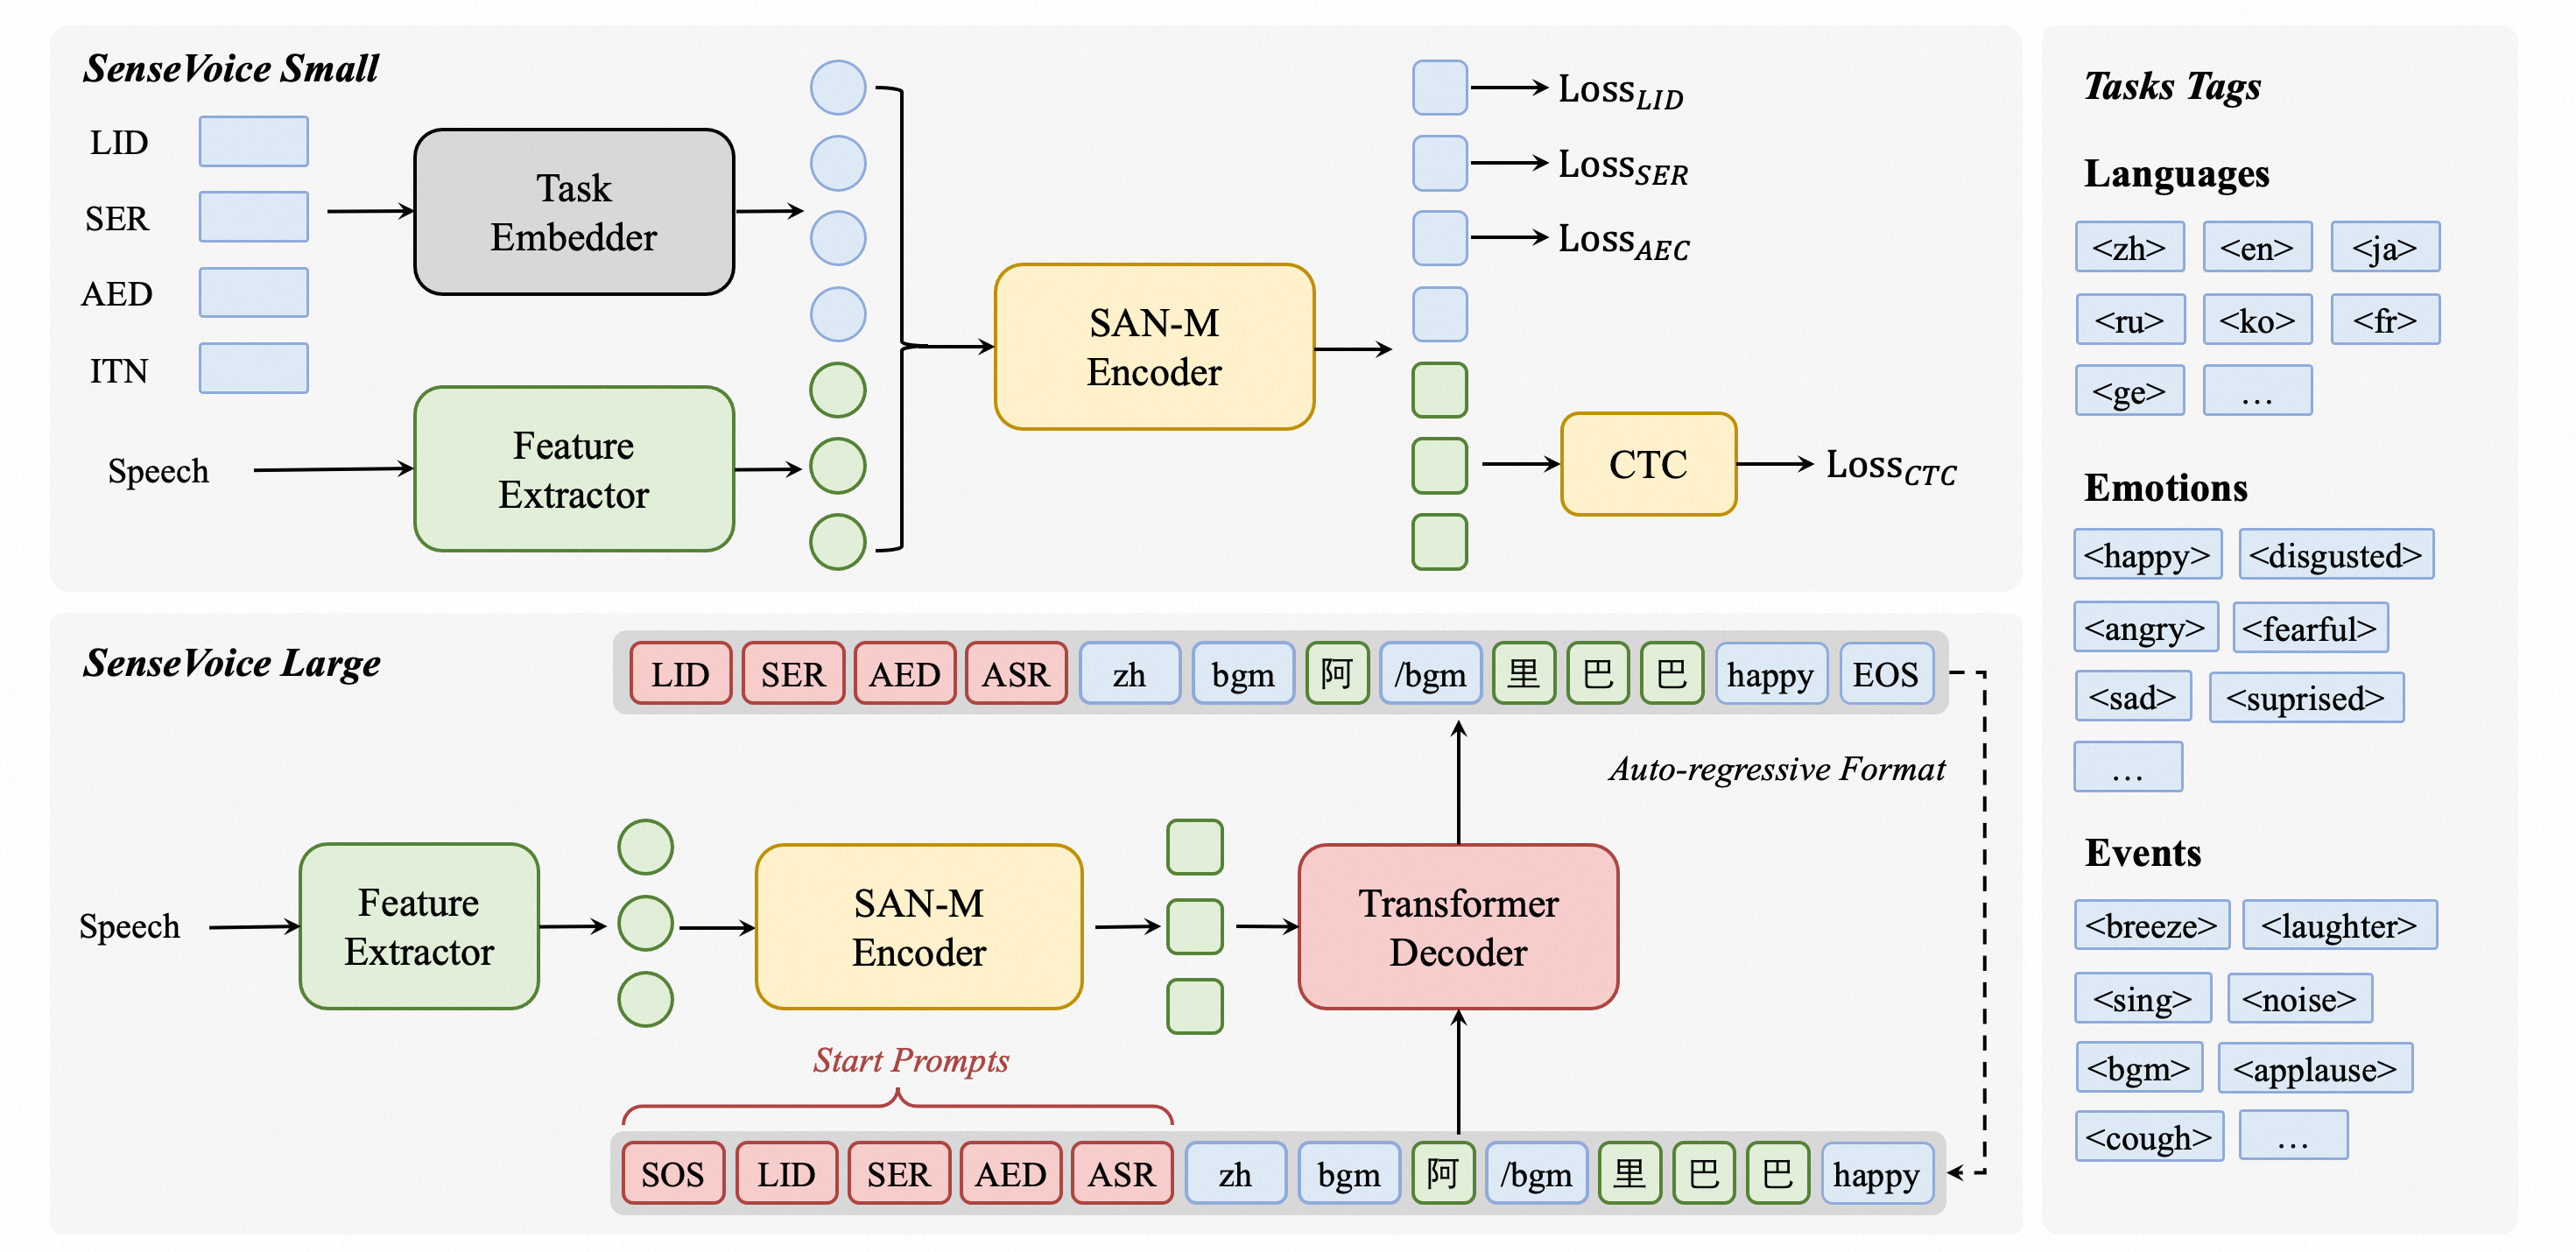
SenseVoiceは、音声認識(ASR)、言語識別(LID)、音声感情認識(SER)、および音響イベント分類(AEC)または音響イベント検出(AED)を含む音声理解能力を備えた音声基盤モデルです。本プロジェクトでは、SenseVoiceモデルの紹介と、複数のタスクテストセットでのベンチマーク、およびモデルの体験に必要な環境のインストールと推論方法を提供します。
ホームページ | 最新情報 | 性能評価 | 環境インストール | 使用方法チュートリアル | お問い合わせ
モデルリポジトリ:modelscope,huggingface,GGUF,llama.cpp ガイド
オンライン体験: modelscope demo, huggingface space
公開済みcheckpointの範囲: SenseVoiceSmallは中国語、広東語、英語、日本語、韓国語のASRと言語識別に対応し、感情・音声イベントタグも出力します。話者分離はFunASRが独立したFSMN-VADとCAM++を組み合わせるパイプライン機能であり、SenseVoiceSmall checkpoint自体の出力ではありません。
コア機能 🎯
SenseVoiceは、高精度な多言語音声認識、感情認識、および音声イベント検出に焦点を当てています。
- 研究範囲と公開済みcheckpoint: より広いSenseVoice研究では40万時間以上の学習データと50以上の言語対応が報告されています。公開済みのSenseVoiceSmall checkpointは中国語、広東語、英語、日本語、韓国語に対応し、下記のbenchmark比較は記載されたタスクと言語に限定されます。
- リッチテキスト認識:
- 優れた感情認識能力を持ち、テストデータで現在の最良の感情認識モデルの効果を達成および上回ります。
- 音声イベント検出能力を提供し、音楽、拍手、笑い声、泣き声、咳、くしゃみなどのさまざまな一般的な人間とコンピュータのインタラクションイベントを検出します。
- 効率的な推論: SenseVoiceSmallは非自己回帰エンドツーエンドフレームワークを採用し、低遅延で推論します。テスト条件と速度比較は下記のbenchmarkを参照してください。
- 簡単な微調整: 便利な微調整スクリプトと戦略を提供し、ユーザーがビジネスシナリオに応じてロングテールサンプルの問題を簡単に解決できるようにします。
- サービス展開: マルチコンカレントリクエストをサポートする完全なサービス展開パイプラインを提供し、クライアントサイドの言語にはPython、C++、HTML、Java、C#などがあります。
最新情報 🔥
- 現在のデプロイ経路:
funasr==1.4.14をインストールすると、SenseVoice の Python、OpenAI 互換サービス、コンテナ workflow を利用できます。リリースノート · SenseVoice Releases - VAD なしの長時間音声:
long_audio_no_vad.pyは有界の重複ウィンドウと raw chunk 出力を使うため、時間単位の録音を一度にモデルへ渡す必要がありません。スクリプト -> - 統合 diarization の選択肢: FunASR ecosystem は OpenMOSS/MOSS-Transcribe-Diarize をサポートし、オフラインで転写、タイムスタンプ、匿名話者ラベルを返します。デプロイガイド ->
完全なバージョン履歴は Releases を参照してください。
ベンチマーク 📝
多言語音声認識
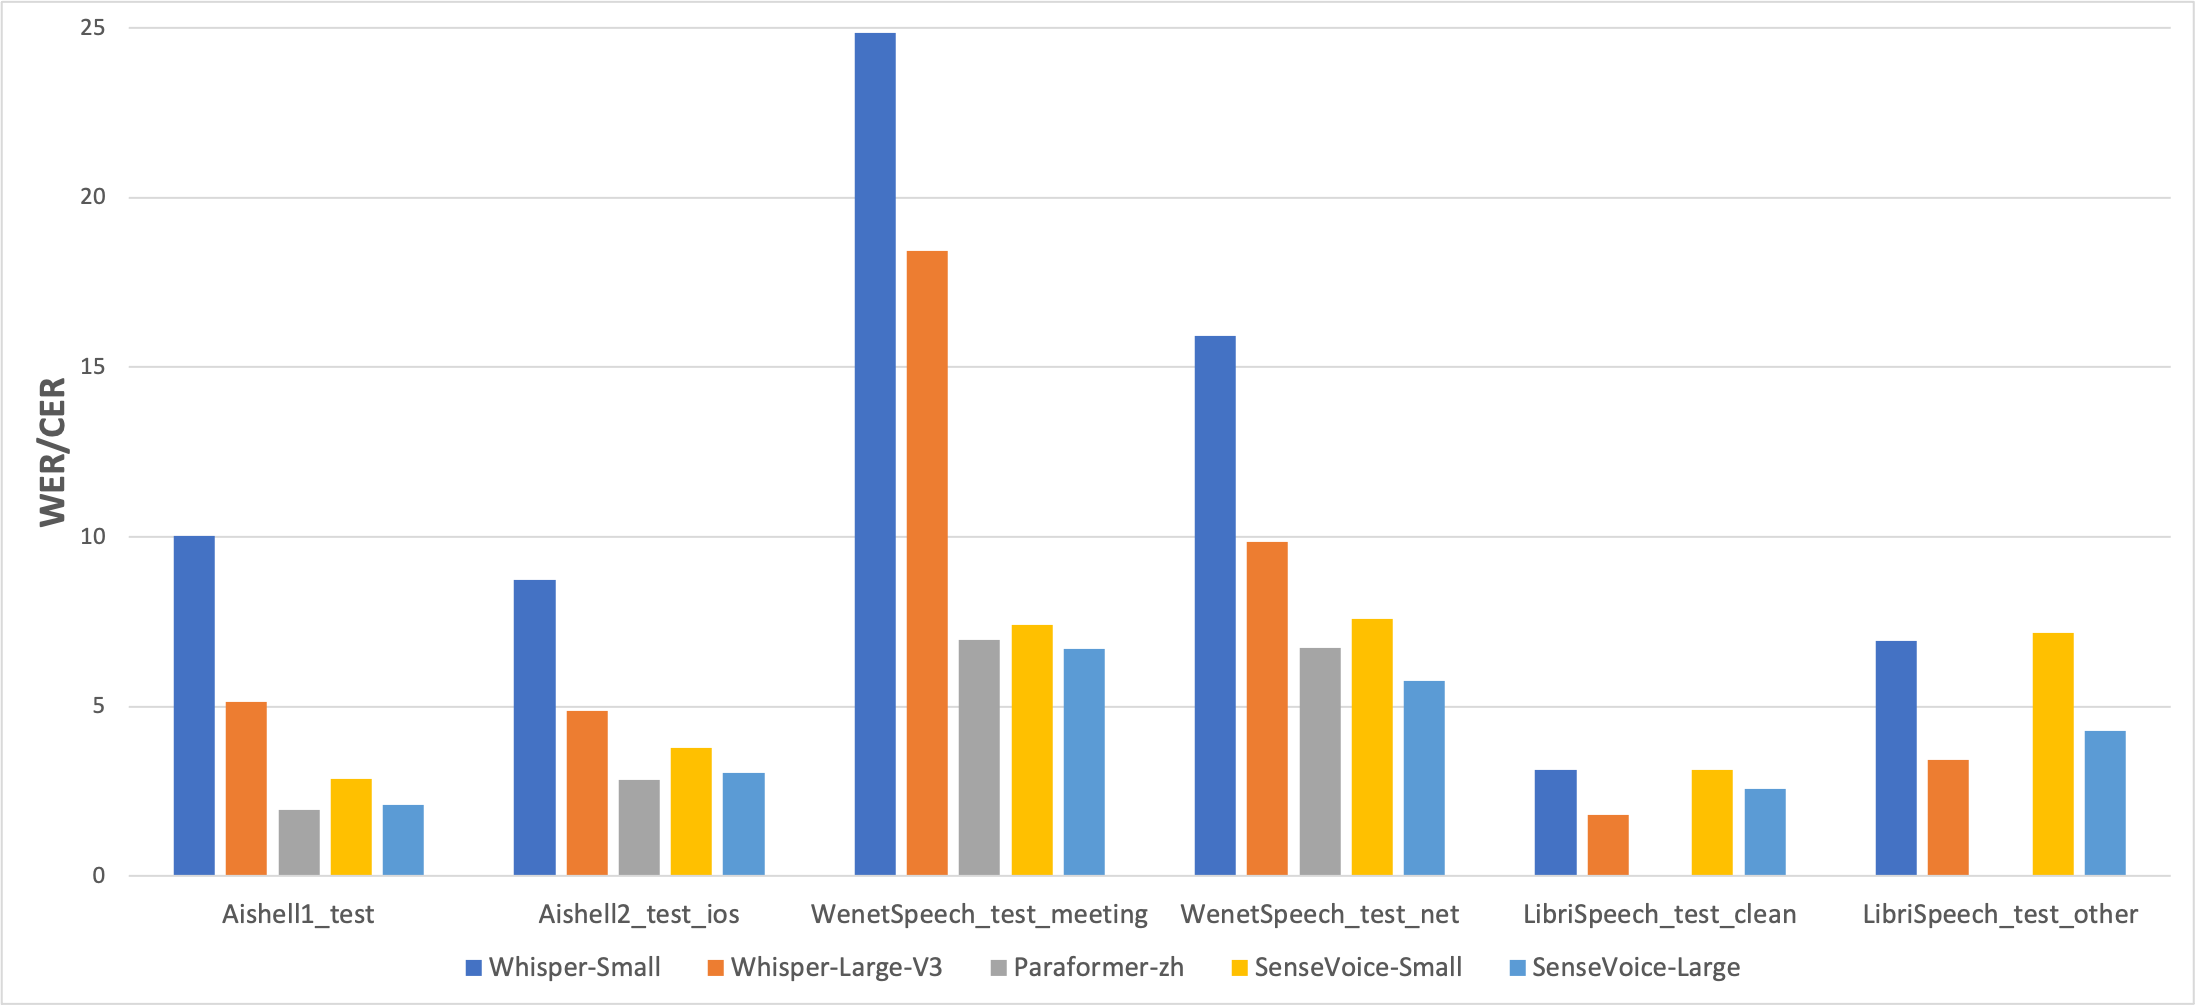
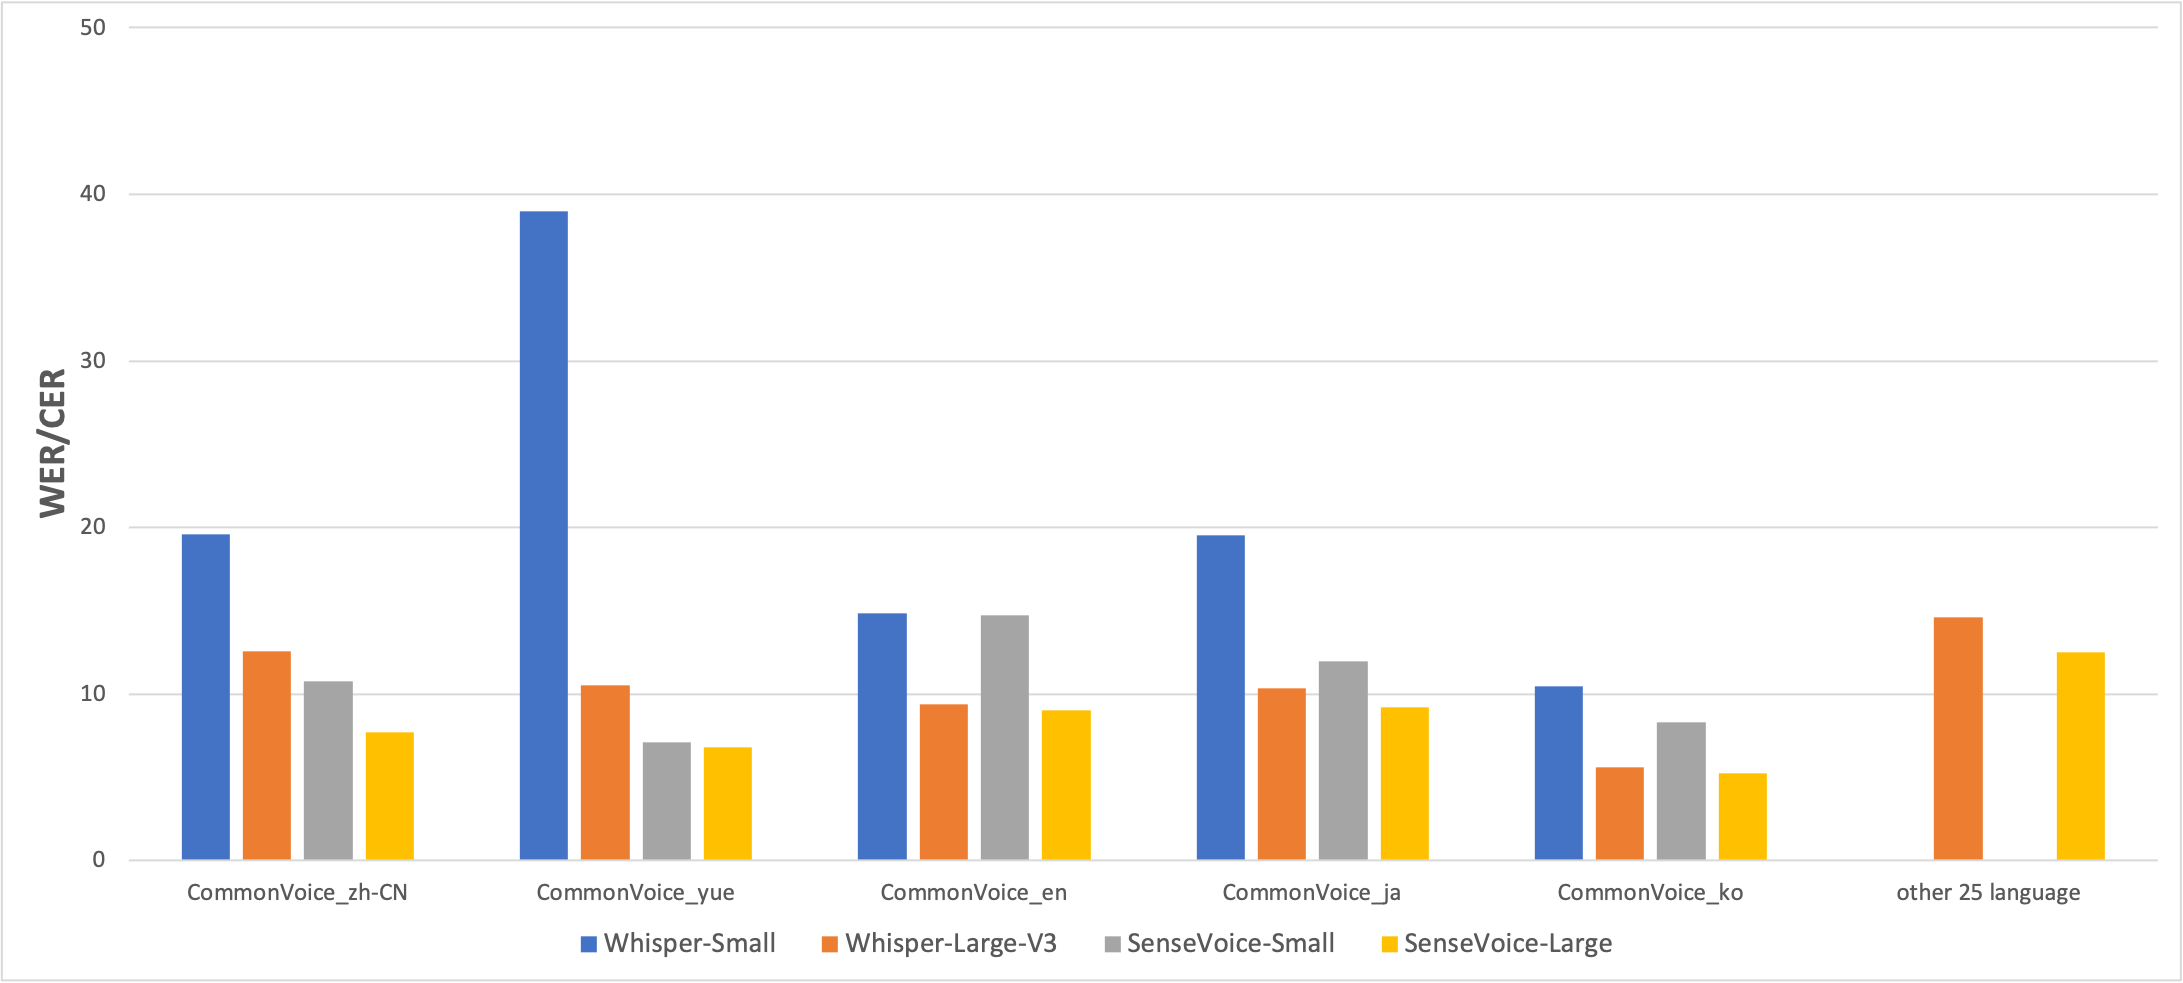
オープンソースのベンチマークデータセット(AISHELL-1、AISHELL-2、Wenetspeech、Librispeech、Common Voiceを含む)でSenseVoiceとWhisperの多言語音声認識性能と推論効率を比較しました。中国語と広東語の認識効果において、SenseVoice-Smallモデルは明らかな効果の優位性を持っています。
感情認識
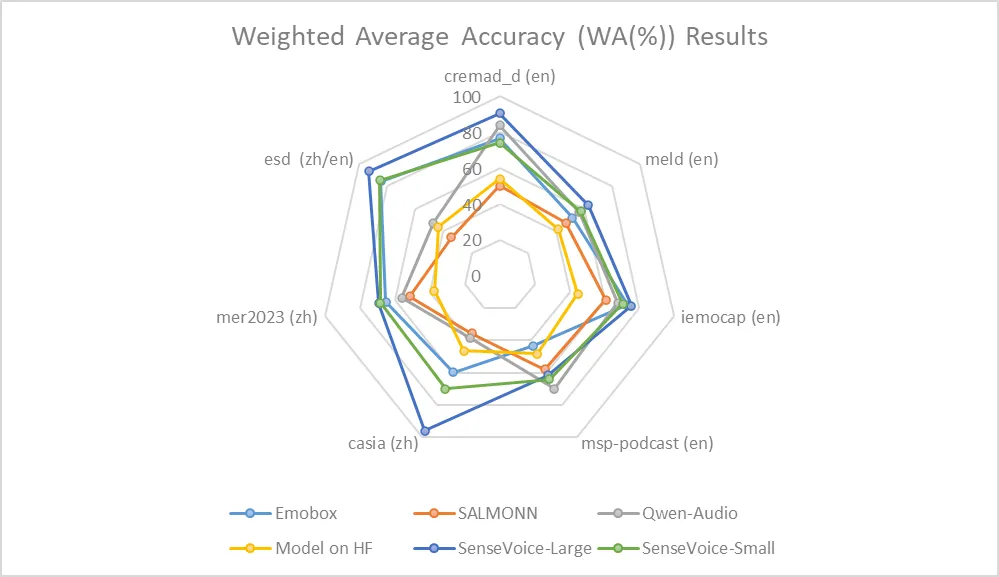
現在、広く使用されている感情認識のテスト指標と方法が不足しているため、複数のテストセットでさまざまな指標をテストし、最近のベンチマークの複数の結果と包括的に比較しました。選択されたテストセットには、中国語/英語の両方の言語と、パフォーマンス、映画、自然な会話などのさまざまなスタイルのデータが含まれています。ターゲットデータの微調整を行わない前提で、SenseVoiceはテストデータで現在の最良の感情認識モデルの効果を達成および上回ることができました。
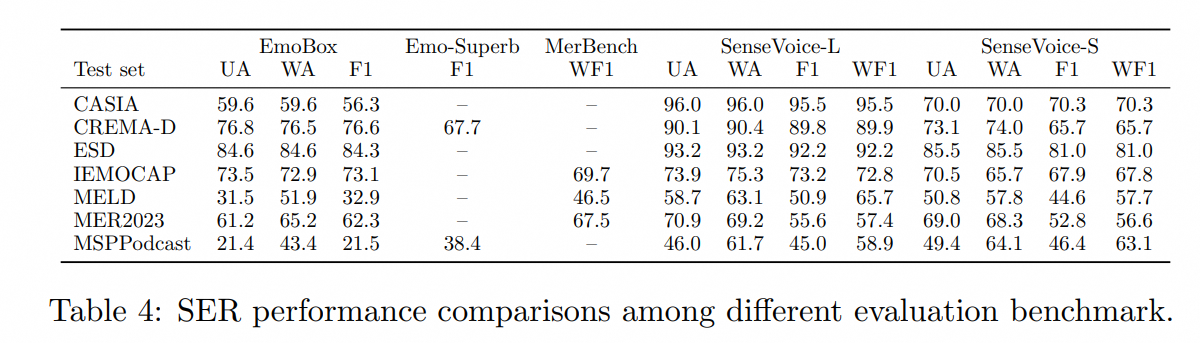
さらに、テストセットで複数のオープンソースの感情認識モデルを比較し、結果はSenseVoice-Largeモデルがほぼすべてのデータで最良の効果を達成し、SenseVoice-Smallモデルも多数のデータセットで他のオープンソースモデルを上回る効果を達成したことを示しています。
イベント検出
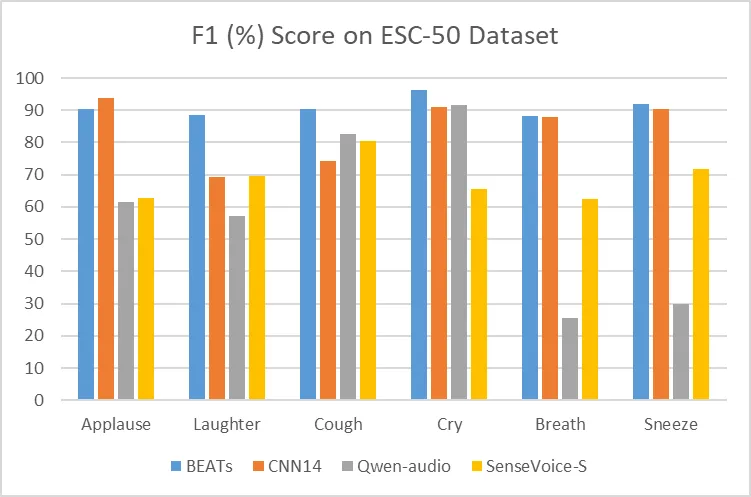
SenseVoiceは音声データのみでトレーニングされていますが、イベント検出モデルとして単独で使用することもできます。環境音分類ESC-50データセットで、現在業界で広く使用されているBEATSおよびPANNモデルの効果と比較しました。SenseVoiceモデルはこれらのタスクで良好な効果を達成しましたが、トレーニングデータとトレーニング方法の制約により、イベント分類の効果は専門のイベント検出モデルと比較してまだ一定の差があります。
推論効率
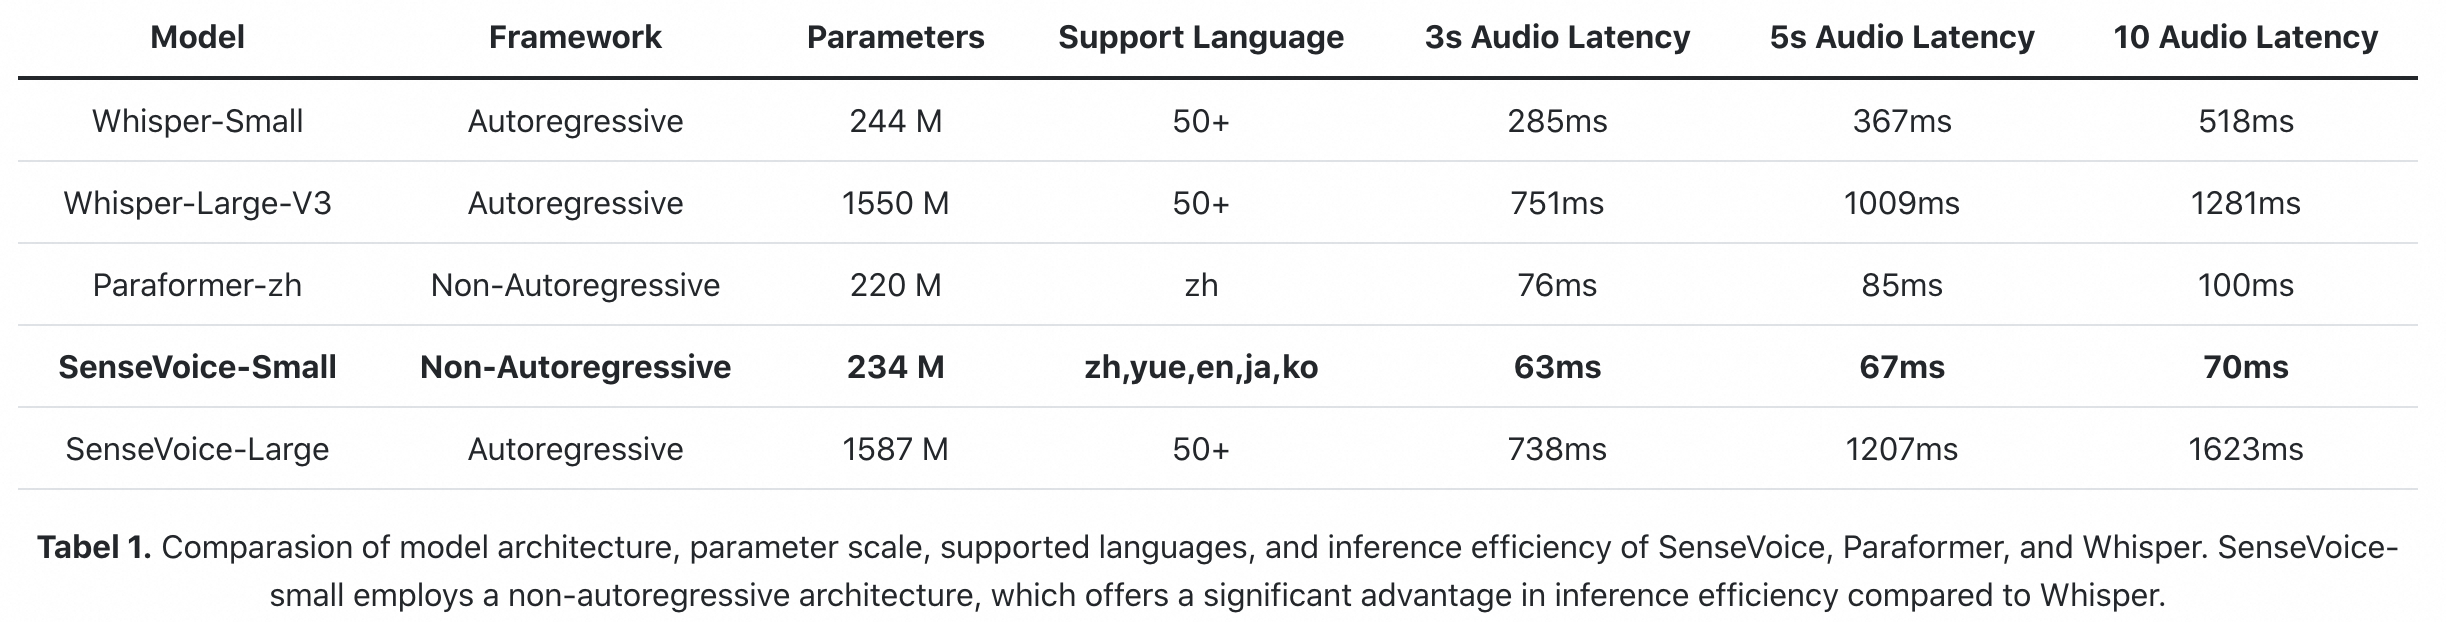
下図のbenchmark設定では、SenseVoiceSmallは非自己回帰エンドツーエンドアーキテクチャを採用し、同程度のパラメータ数でWhisper-Smallより5倍以上、Whisper-Largeより15倍高速です。
環境インストール 🐍
pip install -r requirements.txt
SenseVoiceSmall のサンプルと FunASR の話者分離パイプラインには funasr>=1.3.26 が必要です。以前にこのリポジトリをインストール済みの場合は、デモを再実行する前に pip install -U "funasr>=1.3.26" を実行してください。
使用方法 🛠️
推論
任意の形式の音声入力をサポートし、任意の長さの入力をサポートします。
from funasr import AutoModel
from funasr.utils.postprocess_utils import rich_transcription_postprocess

model_dir = "iic/SenseVoiceSmall"


model = AutoModel(
    model=model_dir,
    trust_remote_code=True,
    remote_code="./model.py",
    vad_model="fsmn-vad",
    vad_kwargs={"max_single_segment_time": 30000},
    device="cuda:0",
)

# en
res = model.generate(
    input=f"{model.model_path}/example/en.mp3",
    cache={},
    language="auto",  # "zh", "en", "yue", "ja", "ko", "nospeech"
    use_itn=True,
    batch_size_s=60,
    merge_vad=True,  #
    merge_length_s=15,
)
text = rich_transcription_postprocess(res[0]["text"])
print(text)
パラメータの説明(クリックして展開)
model_dir:モデル名、またはローカルディスク上のモデルパス。trust_remote_code:vad_model:VAD(音声活動検出)を有効にすることを示します。VADの目的は、長い音声を短いクリップに分割することです。この場合、推論時間にはVADとSenseVoiceの合計消費が含まれ、エンドツーエンドの遅延を表します。SenseVoiceモデルの推論時間を個別にテストする場合は、VADモデルを無効にできます。vad_kwargs:VADモデルの設定を指定します。max_single_segment_time:vad_modelによる音声セグメントの最大長を示し、単位はミリ秒(ms)です。use_itn:出力結果に句読点と逆テキスト正規化が含まれるかどうか。batch_size_s:動的バッチの使用を示し、バッチ内の音声の合計長を秒(s)で測定します。merge_vad:VADモデルによって分割された短い音声フラグメントをマージするかどうか。マージ後の長さはmerge_length_sで、単位は秒(s)です。ban_emo_unk:emo_unkラベルを無効にする。
すべての入力が短い音声(30秒未満)であり、バッチ推論が必要な場合、推論効率を向上させるためにVADモデルを削除し、batch_sizeを設定できます。
model = AutoModel(model=model_dir, trust_remote_code=True, device="cuda:0")

res = model.generate(
    input=f"{model.model_path}/example/en.mp3",
    cache={},
    language="auto", # "zh", "en", "yue", "ja", "ko", "nospeech"
    use_itn=True,
    batch_size=64,
)
詳細な使用方法については、ドキュメントを参照してください。
直接推論
任意の形式の音声入力をサポートし、入力音声の長さは30秒以下に制限されます。
from model import SenseVoiceSmall
from funasr.utils.postprocess_utils import rich_transcription_postprocess

model_dir = "iic/SenseVoiceSmall"
m, kwargs = SenseVoiceSmall.from_pretrained(model=model_dir, device="cuda:0")
m.eval()

res = m.inference(
    data_in=f"{kwargs['model_path']}/example/en.mp3",
    language="auto", # "zh", "en", "yue", "ja", "ko", "nospeech"
    use_itn=False,
    ban_emo_unk=False,
    **kwargs,
)

text = rich_transcription_postprocess(res[0][0]["text"])
print(text)
サービス展開
未完了
エクスポートとテスト
ONNXとLibtorchのエクスポート
ONNX
# pip3 install -U funasr funasr-onnx
from pathlib import Path
from funasr_onnx import SenseVoiceSmall
from funasr_onnx.utils.postprocess_utils import rich_transcription_postprocess


model_dir = "iic/SenseVoiceSmall"

model = SenseVoiceSmall(model_dir, batch_size=10, quantize=True)

# inference
wav_or_scp = ["{}/.cache/modelscope/hub/{}/example/en.mp3".format(Path.home(), model_dir)]

res = model(wav_or_scp, language="auto", use_itn=True)
print([rich_transcription_postprocess(i) for i in res])
備考:ONNXモデルは元のモデルディレクトリにエクスポートされます。
Libtorch
from pathlib import Path
from funasr_torch import SenseVoiceSmall
from funasr_torch.utils.postprocess_utils import rich_transcription_postprocess


model_dir = "iic/SenseVoiceSmall"

model = SenseVoiceSmall(model_dir, batch_size=10, device="cuda:0")

wav_or_scp = ["{}/.cache/modelscope/hub/{}/example/en.mp3".format(Path.home(), model_dir)]

res = model(wav_or_scp, language="auto", use_itn=True)
print([rich_transcription_postprocess(i) for i in res])
備考:Libtorchモデルは元のモデルディレクトリにエクスポートされます。
展開
FastAPIを使った展開
export SENSEVOICE_DEVICE=cuda:0
fastapi run --port 50000
Docker でビルド
docker build -t sensevoice .
ビルド workflow は
ghcr.io/qwenaudio/sensevoiceも公開しますが、現在この パッケージは private です。匿名 pull は HTTP 401 になるため、コンテナパッケージ が Public と表示されるまでは上記のローカルビルドを使用してください。
実行(GPU、デフォルト)
docker run --rm --gpus all -p 50000:50000 -v sensevoice-models:/models sensevoice
コンテナが healthy になったら http://127.0.0.1:50000/docs を開いてください。CPU モードでは -e SENSEVOICE_DEVICE=cpu を追加し、--gpus all を削除します。
微調整
トレーニング環境のインストール
git clone https://github.com/modelscope/FunASR.git && cd FunASR
pip3 install -e ./
データ準備
データ例
{"key": "YOU0000008470_S0000238_punc_itn", "text_language": "<|en|>", "emo_target": "<|NEUTRAL|>", "event_target": "<|Speech|>", "with_or_wo_itn": "<|withitn|>", "target": "Including legal due diligence, subscription agreement, negotiation.", "source": "/cpfs01/shared/Group-speech/beinian.lzr/data/industrial_data/english_all/audio/YOU0000008470_S0000238.wav", "target_len": 7, "source_len": 140}
{"key": "AUD0000001556_S0007580", "text_language": "<|en|>", "emo_target": "<|NEUTRAL|>", "event_target": "<|Speech|>", "with_or_wo_itn": "<|woitn|>", "target": "there is a tendency to identify the self or take interest in what one has got used to", "source": "/cpfs01/shared/Group-speech/beinian.lzr/data/industrial_data/english_all/audio/AUD0000001556_S0007580.wav", "target_len": 18, "source_len": 360}
詳細は data/train_example.jsonl を参照してください。
データ準備の詳細
説明:
key:音声ファイルのユニークIDsource:音声ファイルのパスsource_len:音声ファイルのfbankフレーム数target:文字起こし結果target_len:target(文字起こし)の長さtext_language:音声ファイルの言語IDemo_target:音声ファイルの感情ラベルevent_target:音声ファイルのイベントラベルwith_or_wo_itn:句読点と逆テキスト正規化を含むかどうか
train_text.txt
BAC009S0764W0121 甚至出现交易几乎停滞的情况
BAC009S0916W0489 湖北一公司以员工名义贷款数十员工负债千万
asr_example_cn_en 所有只要处理 data 不管你是做 machine learning 做 deep learning 做 data analytics 做 data science 也好 scientist 也好通通都要都做的基本功啊那 again 先先对有一些>也许对
ID0012W0014 he tried to think how it could be
train_wav.scp
BAC009S0764W0121 https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/test_audio/BAC009S0764W0121.wav
BAC009S0916W0489 https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/test_audio/BAC009S0916W0489.wav
asr_example_cn_en https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/test_audio/asr_example_cn_en.wav
ID0012W0014 https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/test_audio/asr_example_en.wav
train_text_language.txt
言語IDは <|zh|>、<|en|>、<|yue|>、<|ja|>、および <|ko|>を含みます。
BAC009S0764W0121 <|zh|>
BAC009S0916W0489 <|zh|>
asr_example_cn_en <|zh|>
ID0012W0014 <|en|>
train_emo.txt
感情ラベルは、<|HAPPY|>、<|SAD|>、<|ANGRY|>、<|NEUTRAL|>、<|FEARFUL|>、<|DISGUSTED|> および <|SURPRISED|>を含みます。
BAC009S0764W0121 <|NEUTRAL|>
BAC009S0916W0489 <|NEUTRAL|>
asr_example_cn_en <|NEUTRAL|>
ID0012W0014 <|NEUTRAL|>
train_event.txt
イベントラベルは、 <|BGM|>、<|Speech|>、<|Applause|>、<|Laughter|>、<|Cry|>、<|Sneeze|>、<|Breath|> および <|Cough|>を含みます。
BAC009S0764W0121 <|Speech|>
BAC009S0916W0489 <|Speech|>
asr_example_cn_en <|Speech|>
ID0012W0014 <|Speech|>
コマンド
# wav.scp、text.txt、text_language.txt、emo_target.txt、event_target.txt から train.jsonl と val.jsonl を生成します
sensevoice2jsonl \
++scp_file_list='["../../../data/list/train_wav.scp", "../../../data/list/train_text.txt", "../../../data/list/train_text_language.txt", "../../../data/list/train_emo.txt", "../../../data/list/train_event.txt"]' \
++data_type_list='["source", "target", "text_language", "emo_target", "event_target"]' \
++jsonl_file_out="../../../data/list/train.jsonl"
train_text_language.txt、train_emo_target.txt、train_event_target.txt がない場合、SenseVoice モデルを使用して言語、感情、およびイベントラベルが自動的に予測されます。
# wav.scp と text.txt から train.jsonl と val.jsonl を生成します
sensevoice2jsonl \
++scp_file_list='["../../../data/list/train_wav.scp", "../../../data/list/train_text.txt"]' \
++data_type_list='["source", "target"]' \
++jsonl_file_out="../../../data/list/train.jsonl"
トレーニングの開始
finetune.shのtrain_toolを、前述のFunASRパス内のfunasr/bin/train_ds.pyの絶対パスに変更することを忘れないでください。
bash finetune.sh
WebUI
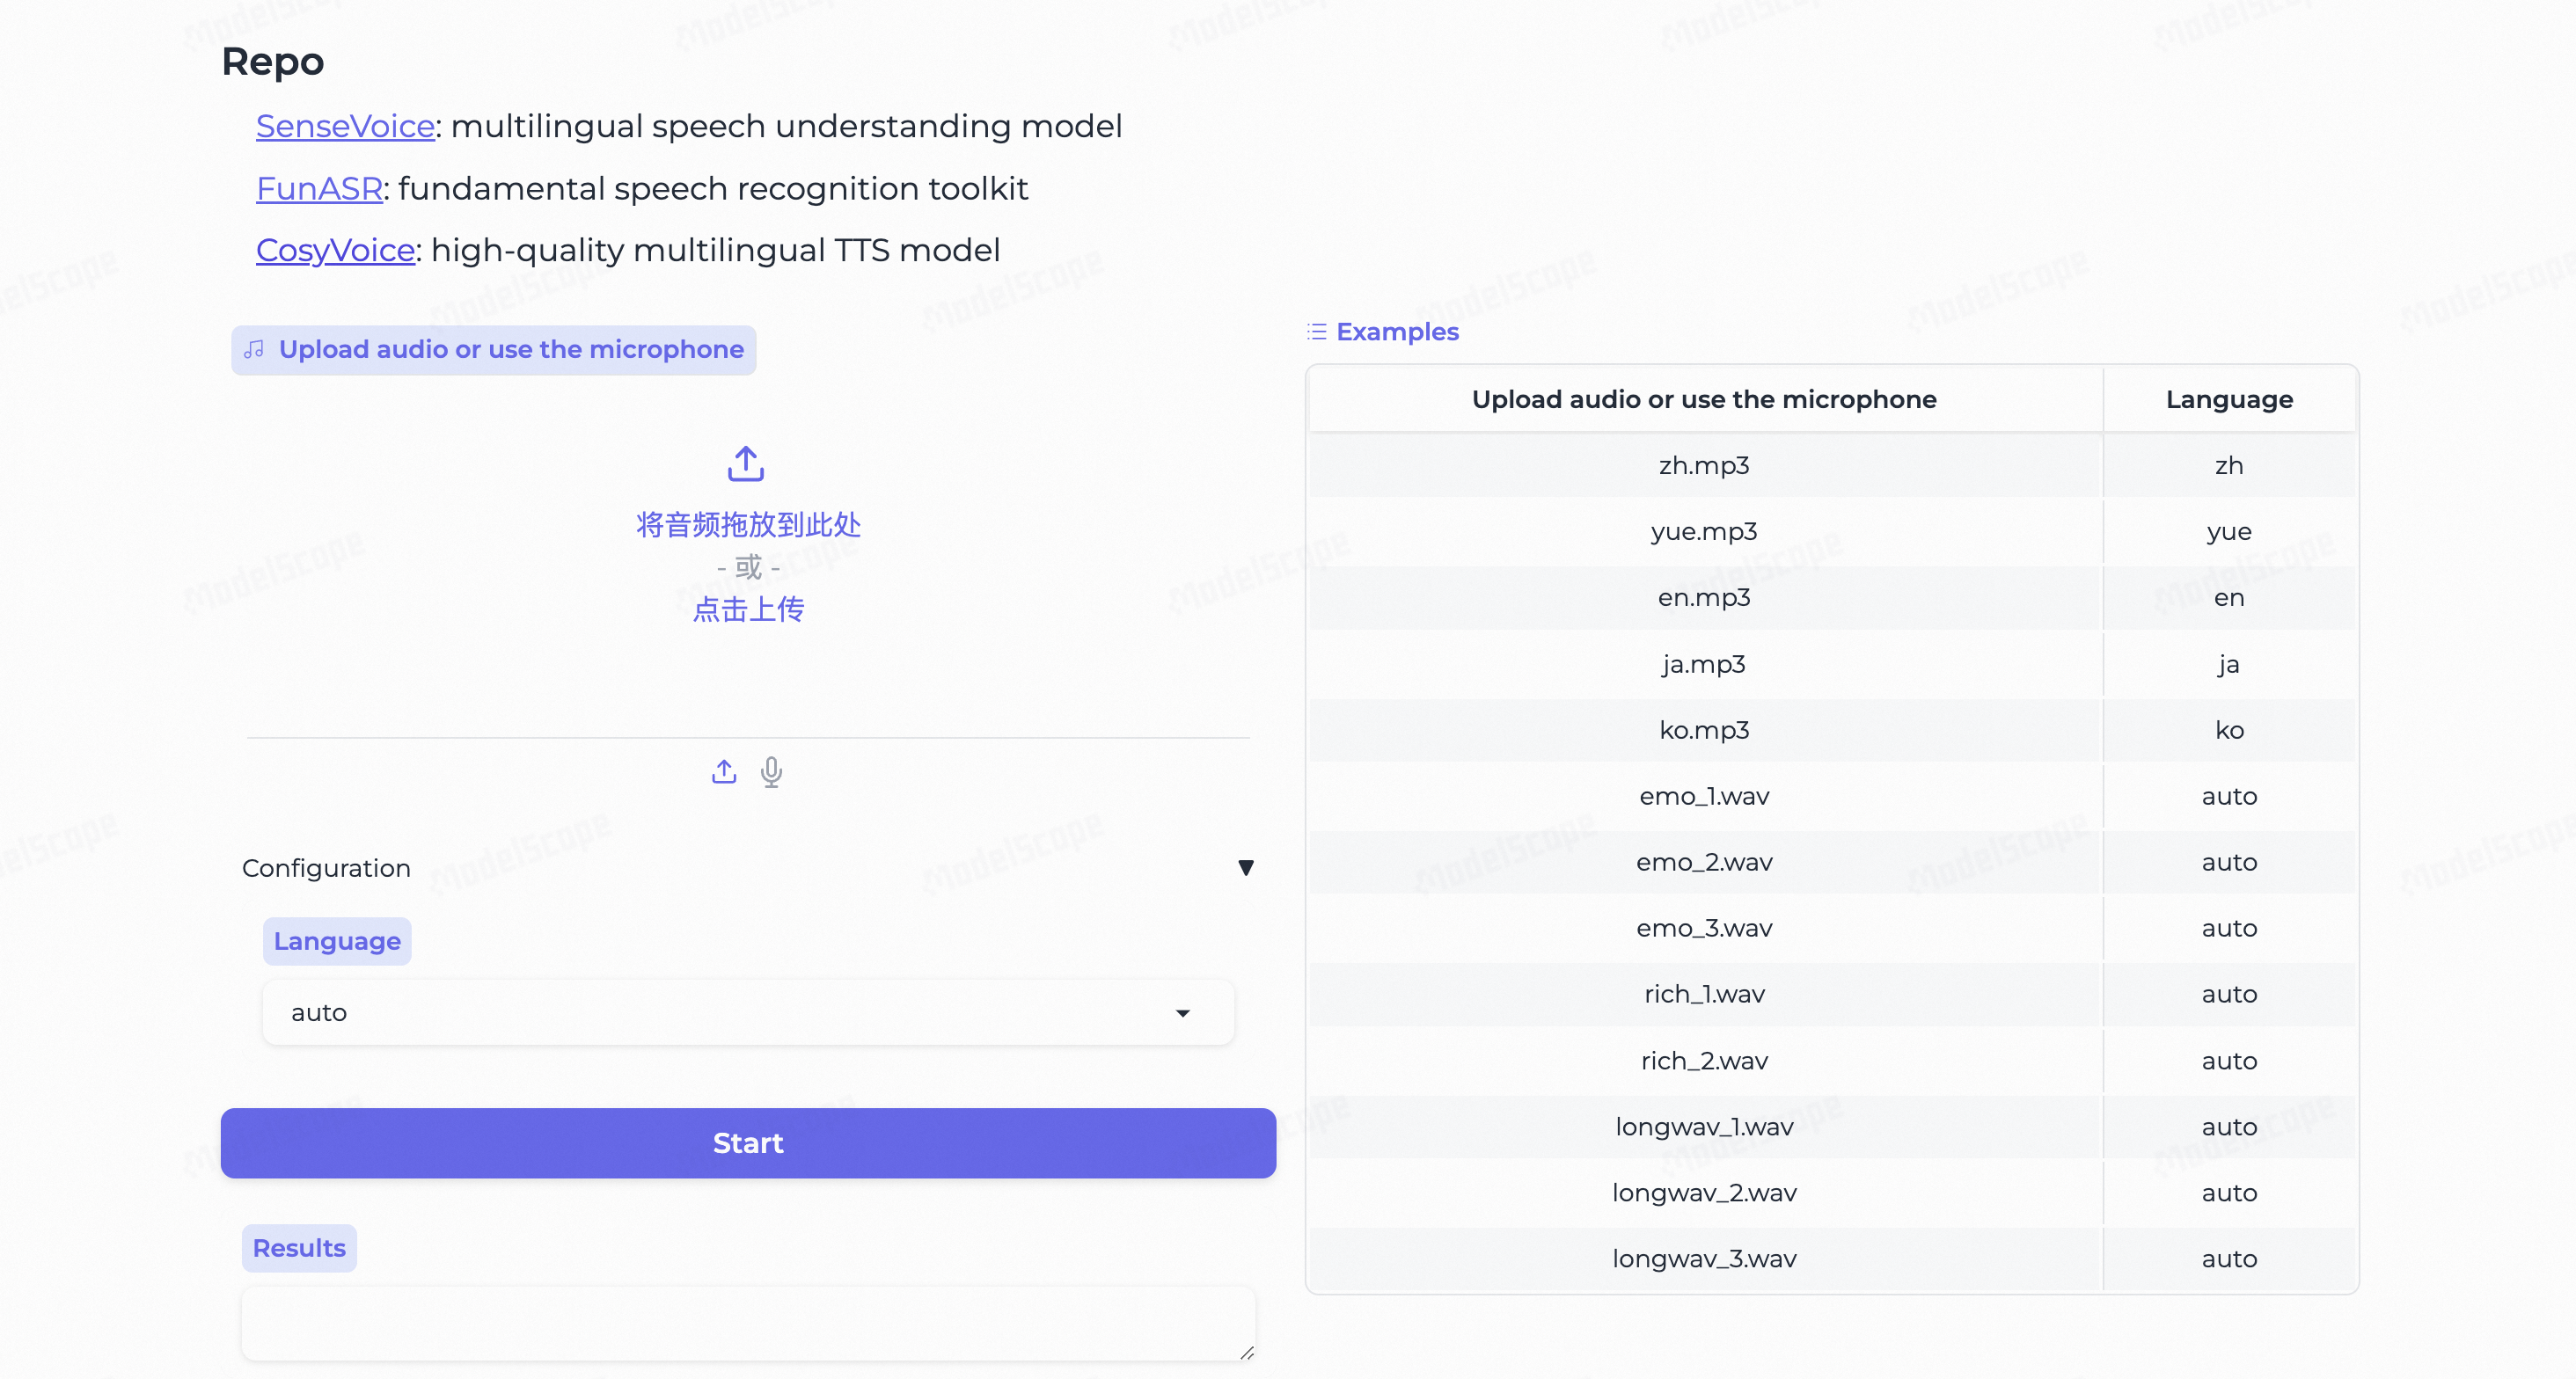
python webui.py
注目すべきサードパーティの取り組み
- Triton (GPU) デプロイメントのベストプラクティス:Triton + TensorRT を使用し、FP32 でテスト。V100 GPU で加速比 526 を達成。FP16 のサポートは進行中です。リポジトリ
- Sherpa-onnx デプロイメントのベストプラクティス:SenseVoice を10種類のプログラミング言語(C++, C, Python, C#, Go, Swift, Kotlin, Java, JavaScript, Dart)で使用可能。また、iOS, Android, Raspberry Pi などのプラットフォームでも SenseVoice をデプロイできます。リポジトリ
- Orca は sherpa-onnx を通じて SenseVoice のローカル・オフライン音声認識を統合し、macOS、Linux、Windows で中国語、英語、日本語、韓国語、広東語を自動検出します。この統合は #7436 でマージされ、現在は v1.4.159-rc.1 プレリリース で利用できます。Orca v1.4.158 安定版にはまだ含まれていません。
- SenseVoice.cpp GGMLに基づいて純粋なC/C++でSenseVoiceを推測し、3ビット、4ビット、5ビット、8ビット量子化などをサポートし、サードパーティの依存関係はありません。
- streaming-sensevoice ストリーム型SenseVoiceは、チャンク(chunk)方式で推論を行います。擬似ストリーミング処理を実現するために、一部の精度を犠牲にして切り捨て注意機構(truncated attention)を採用しています。さらに、この技術はCTCプレフィックスビームサーチ(CTC prefix beam search)とホットワード強化機能もサポートしています。
- OmniSenseVoice は、超高速推論とバッチ処理のために最適化されています。
- SenseVoice Hotword,ニューラルネットワークホットワード強化,WeNetにおけるCPPNベースのニューラルネットワークホットワード強化のオープンソース。
お問い合わせ
使用中に問題が発生した場合は、githubページで直接Issuesを提起できます。音声に興味のある方は、以下のDingTalkグループQRコードをスキャンしてコミュニティグループに参加し、交流と議論を行ってください。
| FunASR |
|---|
 |
関連プロジェクトを探す
tensorflow/tensorflow
すべての人のためのオープンソース機械学習フレームワーク
201,505 スターhuggingface/transformers
🤗 Transformers:テキスト、ビジョン、音声、マルチモーダルの最先端機械学習モデル向けモデル定義フレームワークで、推論と学習の両方に対応します。
168,815 スターAUTOMATIC1111/stable-diffusion-webui
Stable Diffusion の Web UI
165,289 スターComfy-Org/ComfyUI
グラフとノードによるインターフェースを備えた、最も強力でモジュール性の高い拡散モデル向け GUI、API、バックエンド。世界最速のローカル推論エンジン。
146,271 スター