
Mattbusel/Every-Other-Token has 27 GitHub stars and 1 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-16 04:16 UTC. Last push 2026-11-15.
計測したスター増加
- 24時間
- 0
- 7日間
- 更新が遅れています
- 15日間
- 更新が遅れています
- 1か月
- 更新が遅れています
期間ごとの純増数です。期間は重複しており、日別の値ではありません。未計測の値は空欄です。スター数は注目度の指標であり、品質の保証ではありません。
概要
See how sure an LLM is about each word.
AIREADME.ja.md
オリジナル
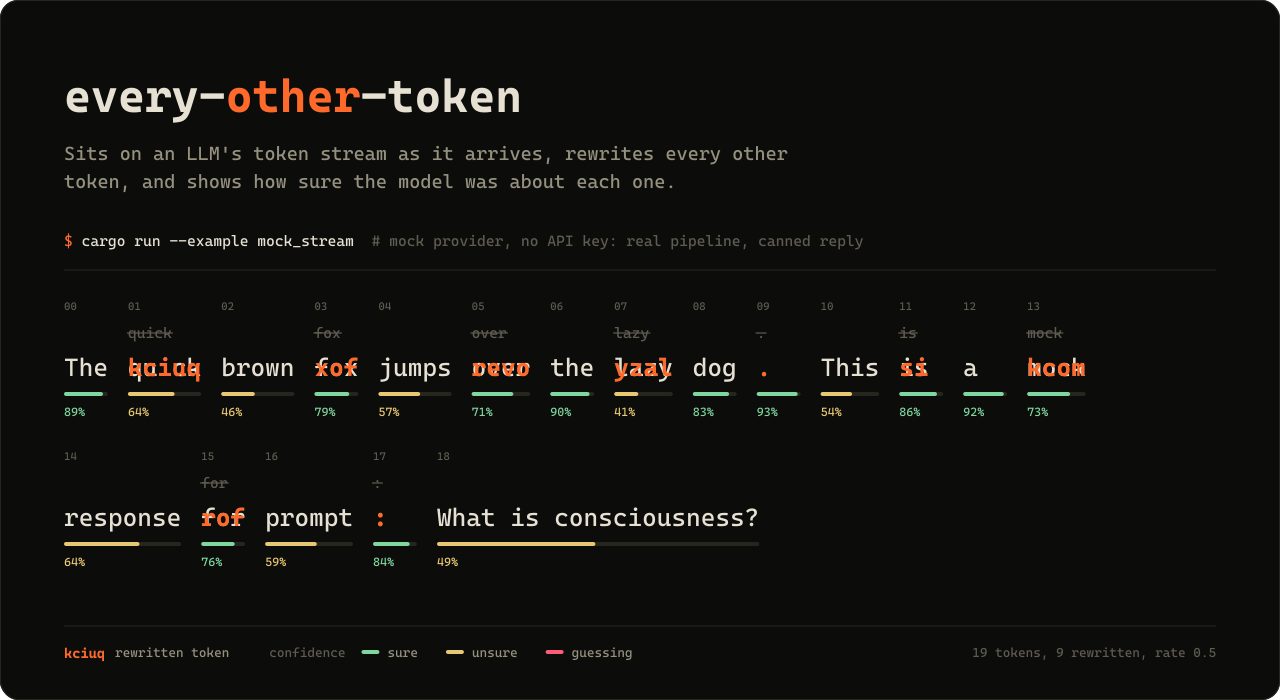
every-other-token
AI モデルが書く一語一語にどれだけ確信を持っているかを可視化し、書いている最中にその言葉を書き換える。
Windows 版をダウンロード (.exe) · Linux と macOS · プロジェクトサイト · ドキュメント


ブラウザですぐ試せます。インストールも API キーも不要:every-other-token.vercel.app/play。プロンプトを入力すると、1 つおきのトークンが反転されて出力される様子を見られます。
every-other-token は、コマンドラインとブラウザで使える無料の LLM トークンストリーム・ビューア兼インターセプタです。OpenAI、Anthropic、Gemini、OpenRouter、あるいは手元のマシンで動くモデル(Ollama、llama.cpp、vLLM、LM Studio)のストリーミング出力にリアルタイムで割り込み、logprobs から各トークンの確信度(confidence)とパープレキシティ(perplexity)を表示します。さらに、届いたそばから 1 つおきのトークン(または任意の割合)を書き換えることもできます。モックプロバイダを内蔵しているので、API キーなしで全機能を試せます。
こんな人に:言語モデルがどうやって言葉を選んでいるのか気になるすべての人。そして LLM の解釈可能性(interpretability)研究、レッドチーミング、プロンプトエンジニアリングに取り組む人。
仕組み
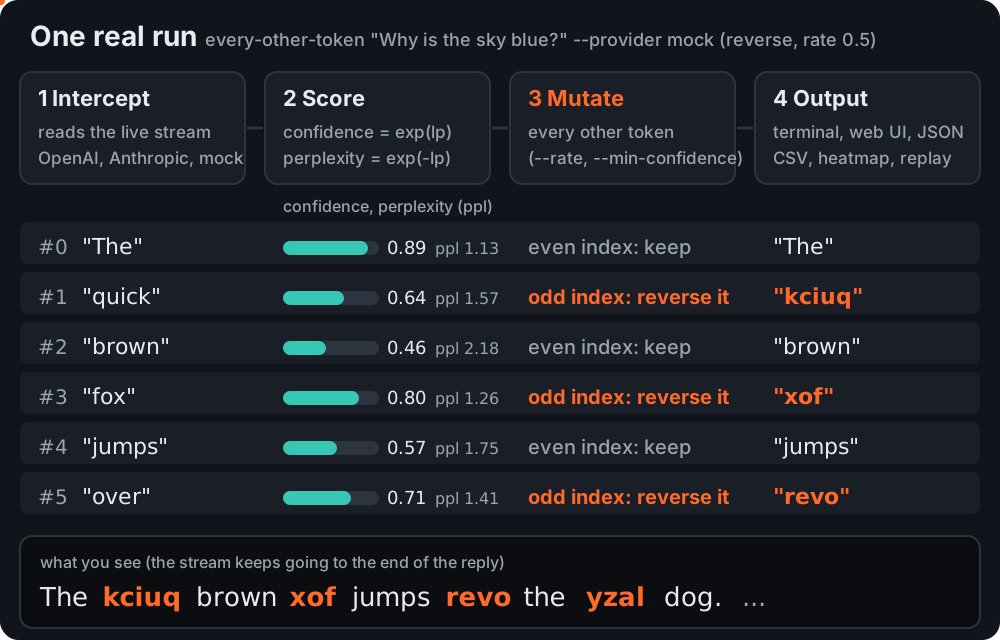
- 傍受(Intercept)。モデルとのストリーミング接続(SSE)を自前で開くので、チャンクが届いた瞬間にそれを捉えられます。
- スコア付け(Score)。各トークンに
confidence = exp(logprob)とperplexity = exp(-logprob)を付け、モデルが検討した上位の候補も添えます。 - 変換(Mutate)。選ばれたトークン(デフォルトでは 1 つおき、またはモデルが自信を持てなかったものだけ)に変換をかけます。反転、大文字化、ノイズ、削除、類義語置換などがあります。
- 出力(Output)。ターミナル(プレーン表示、または
--tuiによるフルスクリーン表示)や Web UI で眺めたり、JSON Lines、CSV、HTML ヒートマップとして保存したりできます。
インストール
Linux(x86_64、Ubuntu 20.04+ / Debian 11+)。依存関係なしのワンライナーで ~/.local/bin にインストールされます:
mkdir -p ~/.local/bin && curl -fsSL https://gitlab.com/mattbusel/Every-Other-Token/-/releases/permalink/latest/downloads/every-other-token-linux-x86_64.tar.gz | tar xz --strip-components=1 -C ~/.local/bin --wildcards '*/every-other-token'
| その他の OS | |
|---|---|
| Windows | every-other-token-windows-x86_64.exe をダウンロードして実行してください。(署名なしのため SmartScreen の確認が出ることがあります。詳細情報 を押してから 実行 を選んでください。) |
| macOS、またはソースから | cargo install --locked every-other-token |
Windows の .exe をダブルクリックすると、ブラウザで Web UI が開きます。SHA-256 チェックサム付きの全リリースはこちら:Releases。
使用例
以下はすべてモックプロバイダの実際の出力です(固定の返答と固定の logprobs を本物のパイプラインに通したもの)。API キーなしでそのまま再現できます。
1. 1 つおきのトークンを反転する(デフォルト)
$ every-other-token "Why is the sky blue?" --provider mock
The kciuq brown xof jumps revo the yzal dog. This si a kcom response rof prompt: Why si the yks blue?
24 tokens streamed, 12 transformed
2. モデルが自信を持てなかった単語だけを書き換える(確信度 0.6 以下)
$ every-other-token "Why is the sky blue?" uppercase --provider mock --rate 1 --min-confidence 0.6
The quick BROWN fox JUMPS over the LAZY dog. THIS is a mock response for PROMPT: WHY IS THE SKY BLUE?
24 tokens streamed, 11 transformed
"brown"(0.46)、"jumps"(0.57)、"lazy"(0.41)、"This"(0.54)、"prompt"(0.59)がしきい値を下回りました。末尾でエコーされるプロンプトはモックでは logprobs を持たないため、通常の割合(rate)による判定にフォールバックします。
3. 数値を JSON で取得する(1 トークンにつき 1 行)
$ every-other-token "Why is the sky blue?" uppercase --provider mock --json-stream
{"text":"The","original":"The","index":0,"transformed":false,"importance":0.8869204521179199,"confidence":0.88692045,"perplexity":1.1274968,"is_error":false,"arrival_ms":0}
{"text":" QUICK","original":" quick","index":1,"transformed":true,"importance":0.6376281380653381,"confidence":0.63762814,"perplexity":1.5683122,"is_error":false,"arrival_ms":0}
...
4. ターミナルでフルスクリーン表示するには every-other-token "Why is the sky blue?" --provider mock --tui を実行します。返答は確信度に応じて色分けされながらストリーミングされ(緑は確信あり、黄は不確か、赤は当て推量)、書き換えられたトークンには下線が付きます。サイドパネルには実行中の統計、確信度のスパークライン、そして直近のトークンについてモデルが検討した他の候補語が表示されます。q で終了しても、返答はターミナルに残ります。
5. 手元のマシンのモデルで動かす。Ollama を起動しておけば、every-other-token "Why is the sky blue?" --provider ollama で API キーなしに llama3.2 からストリーミングできます。OpenAI API 互換のサーバーならほかのものでも動きます:every-other-token "Why is the sky blue?" reverse my-model --base-url http://localhost:8080/v1。
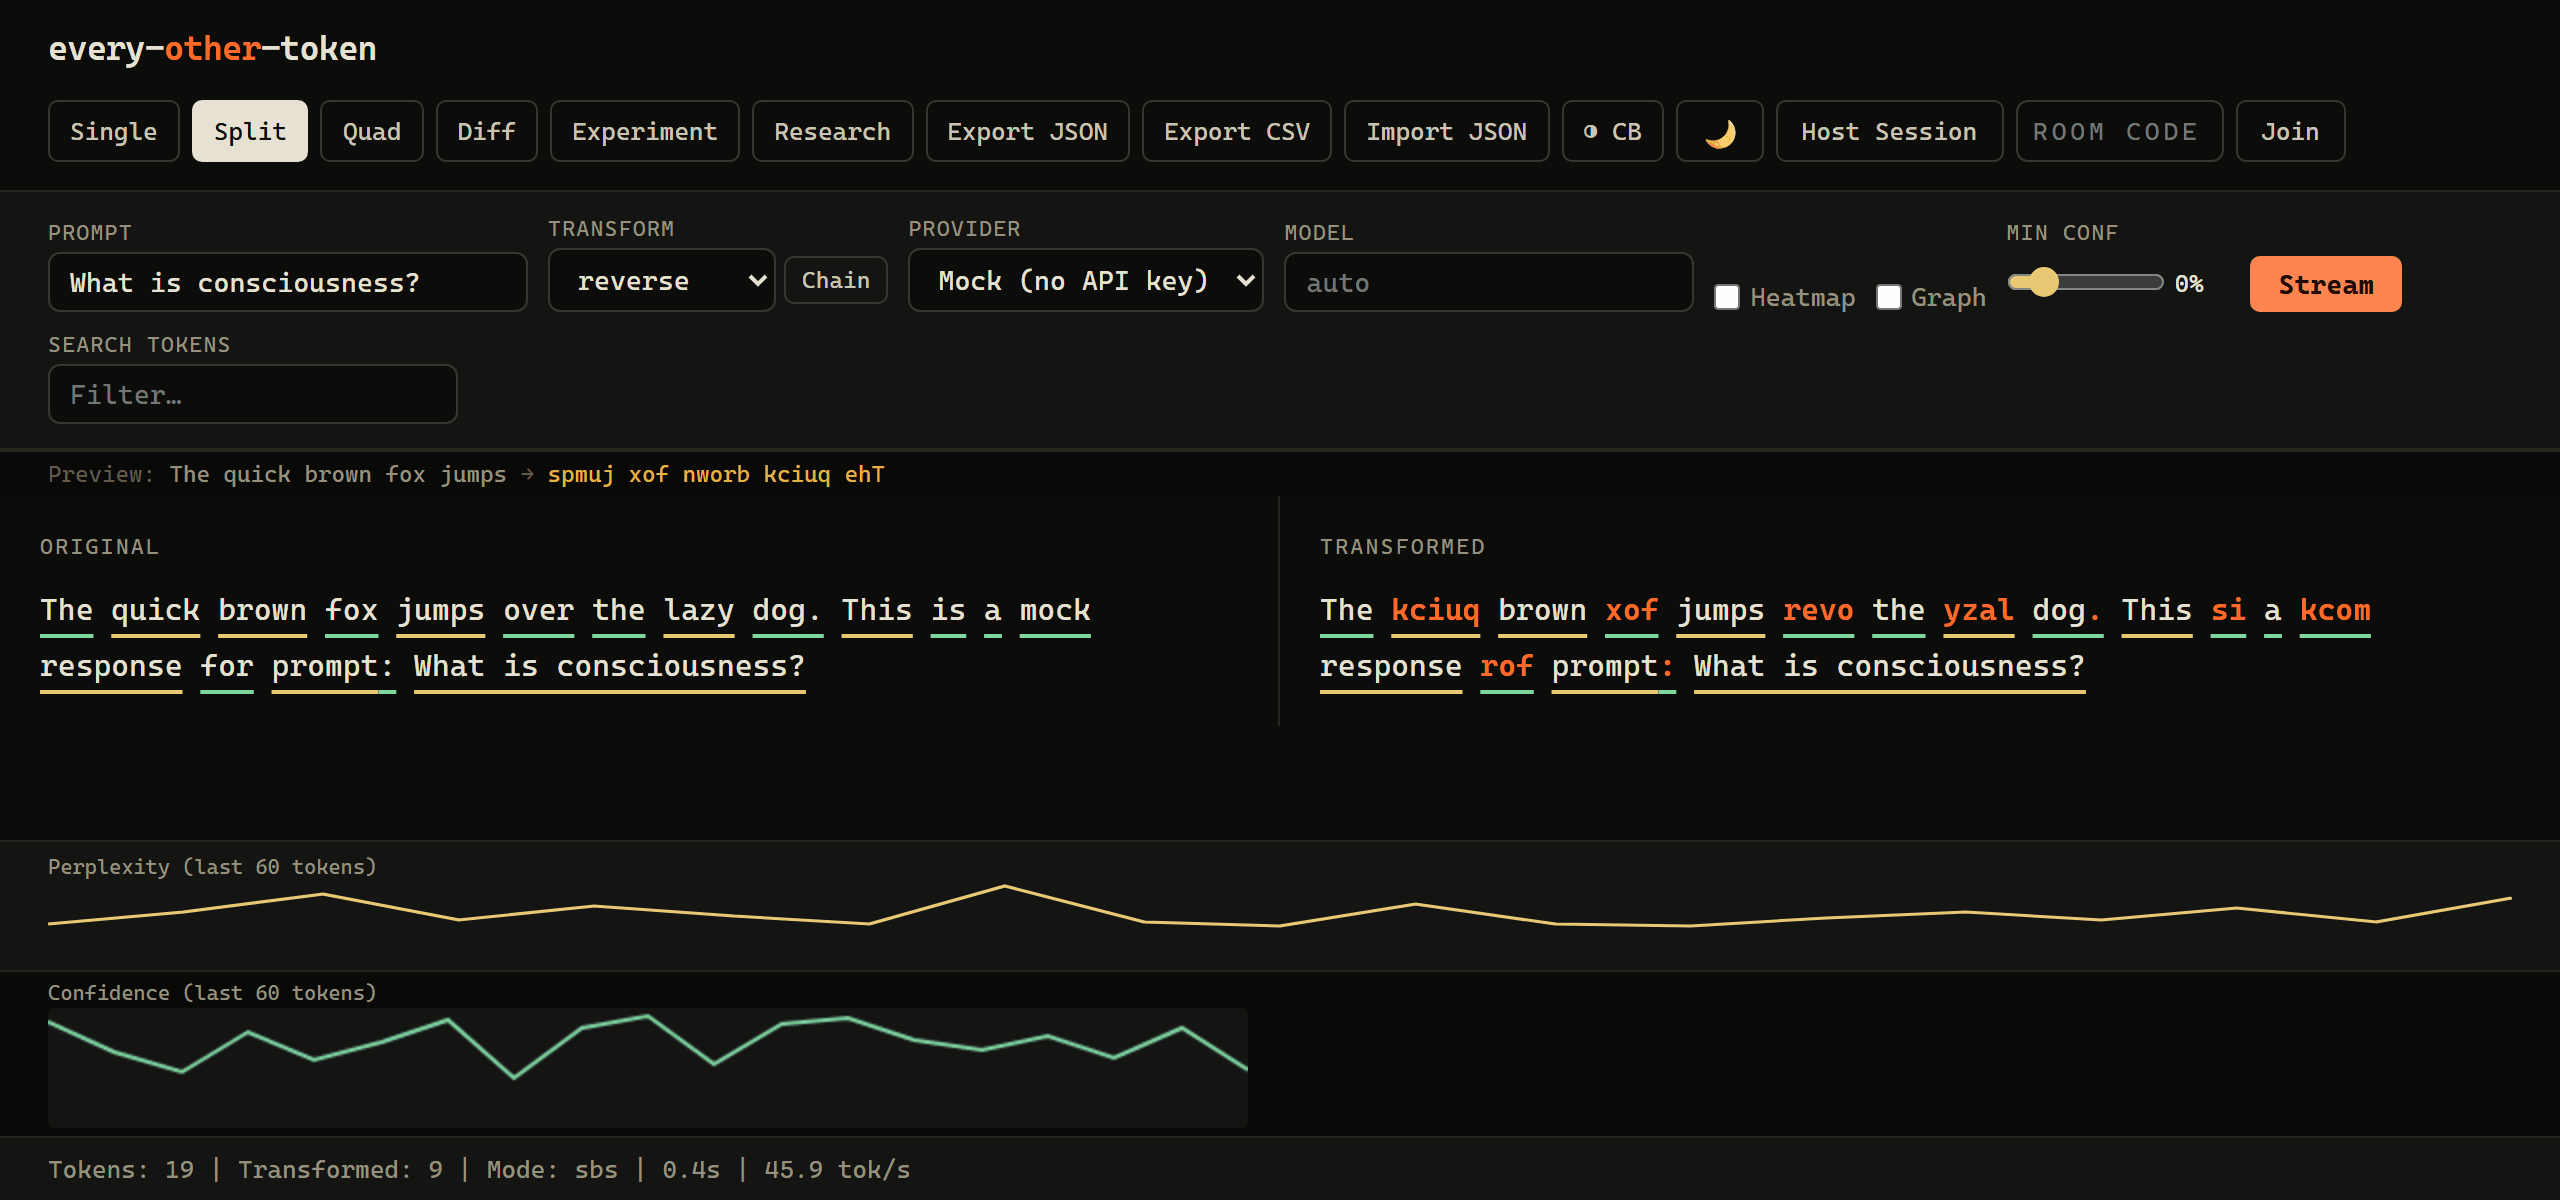
6. ブラウザで見るには every-other-token --web --provider mock を実行します(または .exe をダブルクリックするだけ)。分割ビューで、左に元のストリーム、右に書き換え後のストリームが並び、各トークンには確信度に応じた下線が引かれます。
API キーなしで正確な確率を得る:--provider local
ホスト型の API は、トークンの確率をまったく返さない(Anthropic、Gemini)か、プロンプトのどの単語が効いたのかを教えてくれないかのどちらかです。ツールの内部で動くモデルなら、その両方ができます。local フィーチャーを有効にしてビルドすると、SmolLM2-135M-Instruct を一度だけダウンロードし(269 MB、キャッシュフォルダに保存)、candle を使って CPU 上で実行します:
cargo install every-other-token --features local
every-other-token "Reply with only the city name. Capital of France?" --provider local --attribute
実際の出力:
The latipac of ecnarF is siraP.
How much the reply depended on each prompt word (drop in total log-probability when the word is removed):
    Reply   +1.432  #########
     with   +1.108  #######
     only   +1.875  ############
      the   +0.357  ##
     city   +3.499  ######################
    name.   +0.932  ######
  Capital   +3.229  #####################
       of   +0.857  #####
  France?   +4.689  ##############################
すべてのトークンが正確な対数確率(log-probability)とモデルの実際の上位 5 候補を持ち、ターミナル、--tui、Web UI、そしてすべてのエクスポートで確認できます。--attribute はプロンプトの単語を 1 つずつ取り除いて同じ返答を再スコアリングし、確率がどれだけ下がったかを報告します(オクルージョンによる寄与度分析、occlusion attribution)。--model で Hugging Face Hub 上の別の Llama アーキテクチャのモデルを指定でき、--seed N を付けると貪欲デコーディングの代わりにサンプリングを行います。
確率を返さないプロバイダ(Anthropic、Gemini、多くのローカルサーバー)では、でっち上げの確信度を出すのではなく、確信度を表示しません。
3 ステップで使う
- 入手する。上の Linux 用ワンライナーか Windows 用 .exe を使います(または
cargo install)。 - オフラインで試す。
every-other-token "Why is the sky blue?" --provider mockを実行するか、.exe をダブルクリックしてプロバイダのメニューから Mock (no API key) を選びます。 - 本物のモデルにつなぐ。
OPENAI_API_KEYまたはANTHROPIC_API_KEY(あるいはOPENROUTER_API_KEY、GEMINI_API_KEY)を設定し、every-other-token "Why is the sky blue?" --visual(ターミナル、確信度で色分け)を実行します。フルスクリーン表示なら--tuiを追加、ブラウザならevery-other-token --webを実行します。プロバイダは--provider openai|anthropic|ollama|openrouter|geminiで選びます。実際の確信度の値は logprobs から得られます(OpenAI、OpenRouter、最近の Ollama)。Anthropic や Gemini のように logprobs を返さないプロバイダでは、各トークンが届くまでの速さから推定値を出します。
すべてのフラグは every-other-token --help で確認できます。末尾に使用例も載っています。
ドキュメント
| ドキュメント | 内容 |
|---|---|
| 使い方ガイド | すべての変換、--rate と --min-confidence、システムプロンプトの A/B テスト、プロバイダ間の差分比較、リサーチモード、Web UI のビュー、設定ファイル、シェル補完、ソースからのビルド |
| ライブラリリファレンス | CLI を支える Rust モジュール(寄与度のエクスポート、ドリフト検出、ミューテーションラボ、因果マップなど)と使用例 |
| アーキテクチャ | ストリーム、変換、出力がどう組み合わさっているか |
| HTTP API と WebSocket ルーム | Web サーバーのエンドポイントと、共同でのトークン編集 |
| フィーチャーフラグ | オプションの Cargo フィーチャー |
| docs.rs | ライブラリとして使うための完全な API ドキュメント |
| 変更履歴 と コントリビューション | リリース履歴と、変更の送り方 |
ライセンス
MIT。LICENSE を参照してください。
作者に依頼する
あなたのプロダクトにもこうしたエンジニアリングが必要ですか? 少数のクライアント案件を固定価格でお受けしています:LLM 機能、iOS アプリ、パフォーマンス改善。サービスと料金 · メール · LinkedIn