
Lynpoint/CyberVerse has 1,866 GitHub stars and 298 forks. GitHot measured +13 stars in 24 hours. Last checked 2026-11-08 02:13 UTC. Last push 2026-10-21.
Self hosted, real-time digital human agent platform. Build voice-first AI agents with WebRTC, persona memory, tools, RAG, and optional digital-human video.
計測したスター増加
- 24時間
- +13
- 7日間
- 履歴を収集中
- 15日間
- 履歴を収集中
- 1か月
- 履歴を収集中
期間ごとの純増数です。期間は重複しており、日別の値ではありません。未計測の値は空欄です。スター数は注目度の指標であり、品質の保証ではありません。
README.ja.md
オリジナルCyberVerse
CyberVerse は、オープンソースのリアルタイムデジタルヒューマン Agent フレームワークです。WebRTC、ペルソナ記憶、ツール、RAG、任意のデジタルヒューマン映像機能を基盤に、音声インタラクションを中心とした AI Agent の構築を支援します。


スポンサー
クリックして折りたたむ
 |
CyberVerse をご支援いただいている Compshare(优云智算)に感謝します!Compshare は UCloud 傘下の AI クラウドプラットフォームで、オンデマンド GPU レンタルとモデル API サービスを提供しています。中核となる GPU レンタルサービスでは、モデル・アルゴリズム・アプリケーション開発者向けに、迅速に起動でき、使用量に応じて課金される GPU インスタンスを提供しています。また、国内外の主要モデルにワンストップでアクセスでき、Claude Code、Codex、API からの利用に対応しています。こちらの招待リンクから登録できます。 |
たった一枚の写真から、息づくデジタルヒューマンへ。
あなたを本当に見て、聞いて、リアルタイムで話しかけてくれる、自分だけの J.A.R.V.I.S. のような AI を夢見たことはありませんか?
もう会えない大切な人に再び会い、その声を聞き、笑顔を見ることができたらどうでしょうか。
あるいは、ずっと命を吹き込みたかったキャラクターがいるかもしれません。
必要なのはたった一枚の写真。CyberVerse がその存在を動き出させます。
デジタルヒューマン Agent とは?

デモ
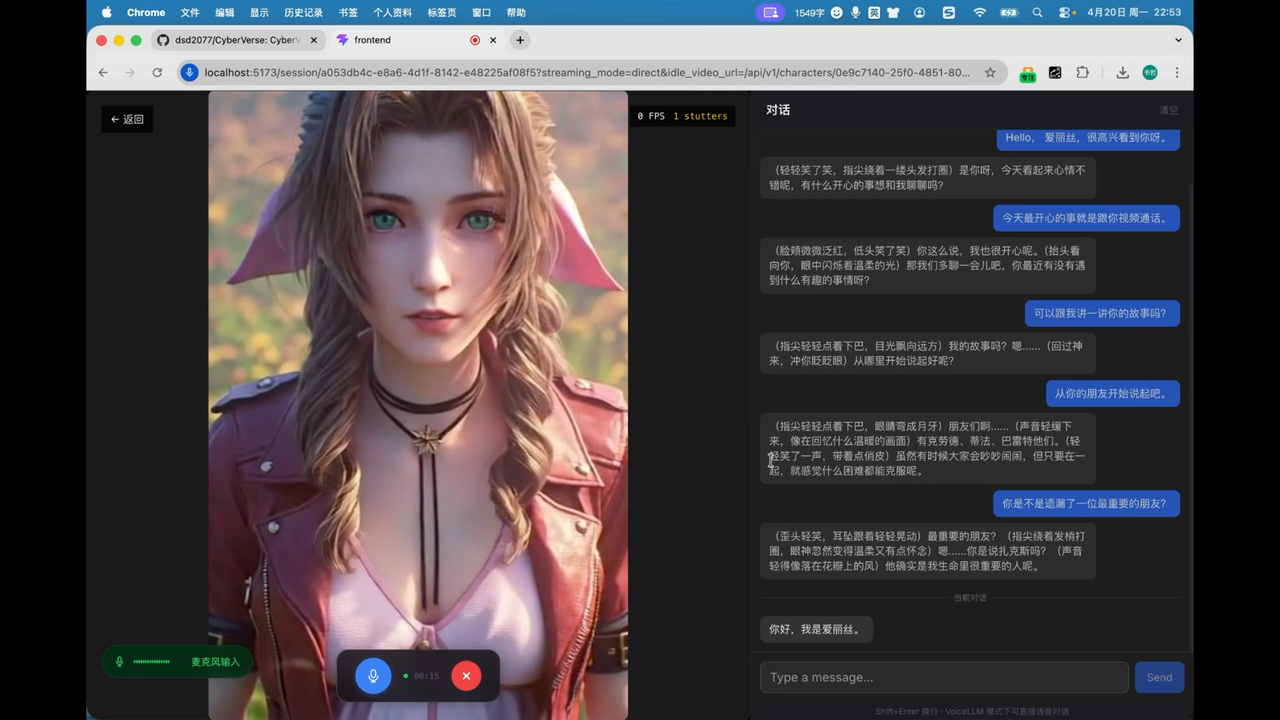
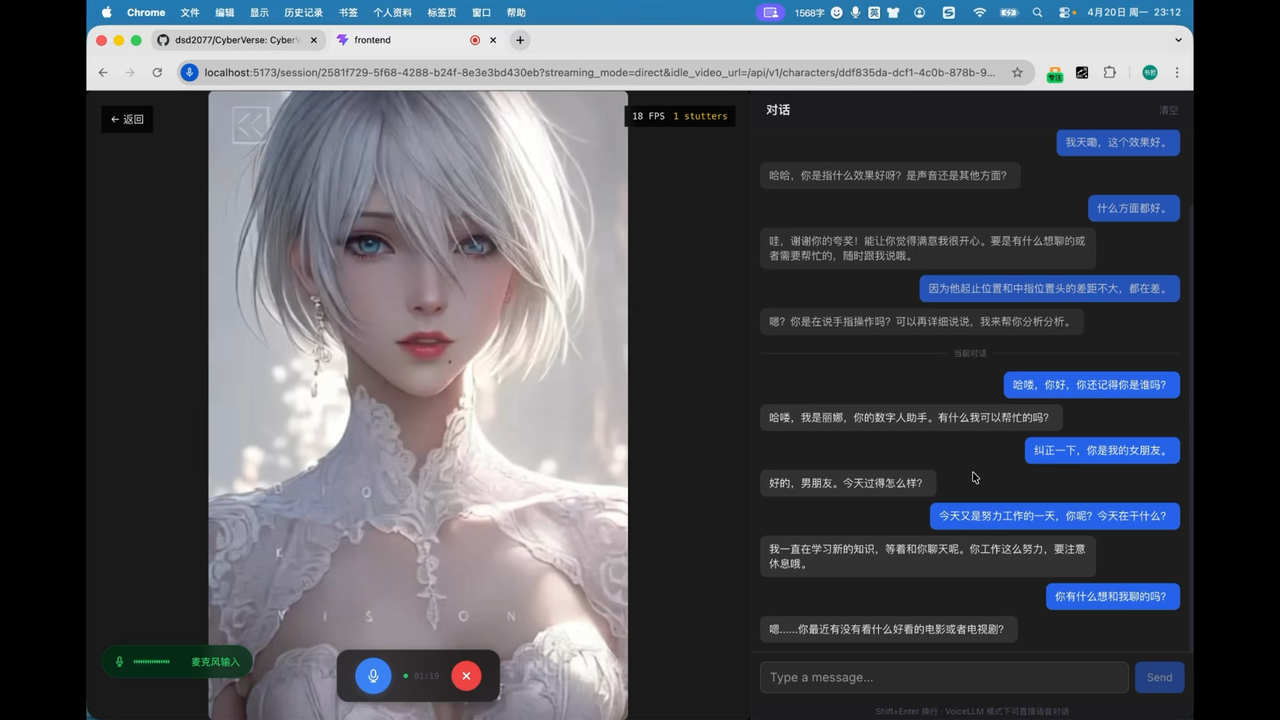
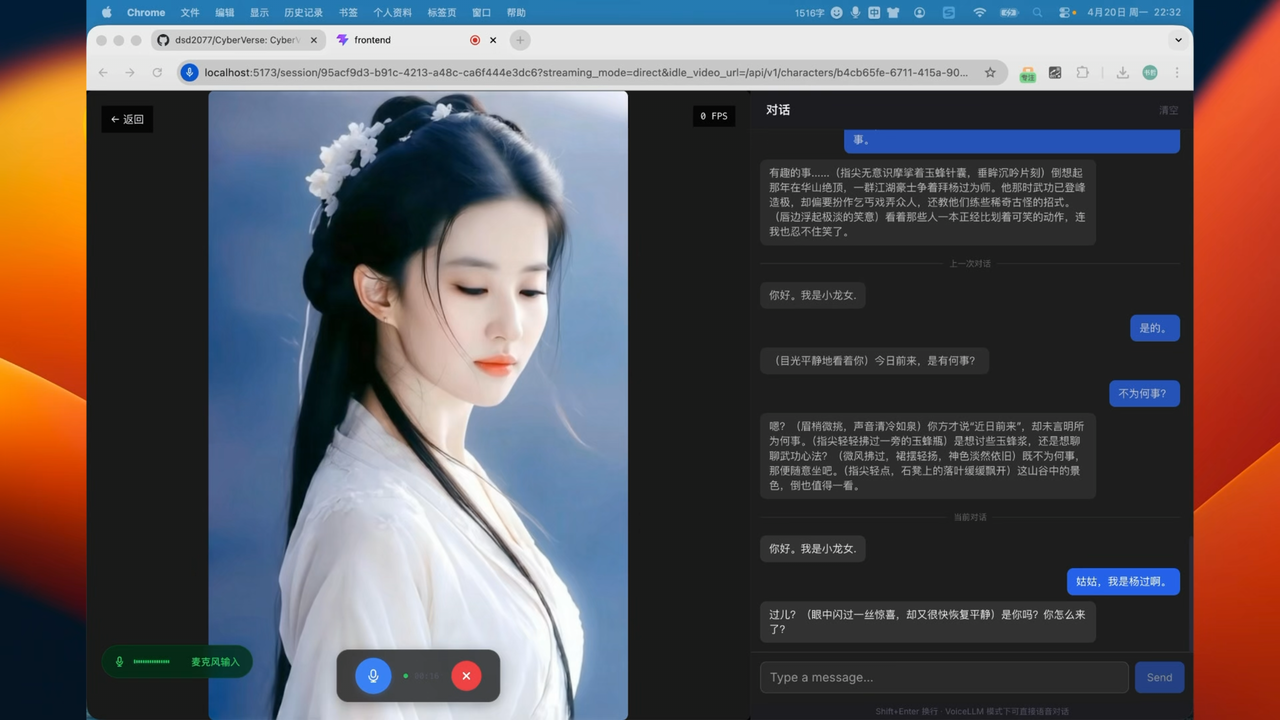
以下のキャラクターはデモ例です。CyberVerse に同梱されておらず、商用利用向けには提供されません。


特長
リアルタイムデジタルヒューマン映像インタラクション
写真 1 枚だけで、リアルタイムにビデオ通話できるデジタルヒューマンを作成できます。ユーザーは人間とのビデオ通話のように自然に会話でき、デジタルヒューマンの発話中でもいつでも割り込み、全二重のリアルタイム対話を体験できます。
CyberVerse は、ローカルのデジタルヒューマンモデルである FlashHead と LiveAct を統合し、Baidu Xiling、Xunfei Digital Human などのクラウド型デジタルヒューマンにも対応します。現在のオープンソースおよび商用デジタルヒューマンの中でも優れた選択肢をカバーしています。
| モデル | 品質 | GPU | 枚数 | 解像度 | FPS | リアルタイム可? |
|---|---|---|---|---|---|---|
| FlashHead 1.3B | Pro | RTX 5090 | 2 | 512×512 | 25+ | ✅ はい |
| FlashHead 1.3B | Pro | RTX 5090 | 1 | 464x464 | 20 | ✅ はい |
| LiveAct 18B | — | RTX PRO 6000 | 2 | 320×480 | 20 | ✅ はい |
| LiveAct 18B | — | RTX PRO 6000 | 1 | 256×417 | 20 | ✅ はい |
| Vidu S1 | クラウド API | ローカル GPU 不要 | — | 540P | 25 | ✅ はい |
| Baidu Xiling Digital Human | クラウド API | ローカル GPU 不要 | — | プラットフォーム/アバター設定による | プラットフォーム応答 | ✅ はい |
| Xunfei Digital Human | クラウド API | ローカル GPU 不要 | — | プラットフォーム/アバター設定による | プラットフォーム応答 | ✅ はい |
PersonaAgent + SubAgent タスク
CyberVerse は multi-agent アーキテクチャを採用しています。PersonaAgent は常に前面にいて、ユーザーとの滑らかな会話、割り込みへの素早い応答、文脈切り替えを担当します。検索、調査、資料整理、要約、HTML レポート生成などの時間がかかる作業は、バックグラウンド SubAgent が非同期で実行します。
これにより複雑なタスクが音声ターンを遅くしません。ユーザーは話し続けたり、追加で質問したり、方向性を調整したりでき、SubAgent の完了後に結果が前面の会話へ返されます。
キャラクター記憶と RAG
各キャラクターの会話履歴はローカルディスクに永続化され、会話へ戻ると自動的に読み込まれるため、セッションをまたいだ連続性を保てます。キャラクター用の知識ベース、文書、人物の経歴素材も取り込めます。システムはそれらをインデックス化し、検索拡張生成に利用することで、回答をキャラクターの背景や設定により近づけます。
プラグインベースのスタック
頭脳、声、聴覚、ツール、記憶、顔はすべて差し替え可能なモジュールです。実行時の挙動は引き続き config/cyberverse.yaml に置き、omni model、LLM、TTS、ASR、Embedding の provider 定義は内蔵の infra/config/*_models/ ディレクトリから自動的に読み込まれます。必要に応じて config/*_models/ にローカル上書きファイルを置くこともできます。Web UI の /settings で各ベンダーの API Key とサービスエンドポイントを設定し、用途に応じてプロバイダーやモデル構成を自由に切り替えられます。
クイックスタート
クラウドイメージ
CyberVerse をすばやく試し、環境依存関係を手動で設定する手間を避けたい場合は、クラウドイメージから起動できます:
ローカルにデプロイする場合は、以下の手順に進んでください。
前提条件
- Node 18+
- Go 1.25(必須:
protoc-gen-go,protoc-gen-go-grpc) - Conda
- Python 3.10+
- FFmpeg
- libopus-dev、libopusfile-dev、libsoxr-dev,pkg-config
純粋な音声セッションでは、ローカルの Avatar GPU は不要です。実行コストは、設定したリアルタイム音声 / omni / LLM / TTS / ASR プロバイダーに依存します。
確認には次を実行します:
node --version
go version
protoc --version
ffmpeg -version
conda --version
ステップ 1: クローンする
git clone https://github.com/dsd2077/CyberVerse.git
cd CyberVerse
ステップ 2: Python 環境を作成する
conda create -n cyberverse python=3.10
conda activate cyberverse
ステップ 3: 環境変数を設定する
cp -r infra/config config
config/env を編集し、対応する API Key を入力します。
Alibaba Cloud Qwen シリーズモデル:
DASHSCOPE_API_KEY=your_dashscope_api_key
または Volcengine Doubao シリーズモデル:
DOUBAO_ACCESS_TOKEN=your_doubao_access_token
DOUBAO_APP_ID=your_doubao_app_id
Doubao Voice: Volcengine クイックスタートに従って App ID / API Key を取得し、DOUBAO_APP_ID / DOUBAO_ACCESS_TOKEN に設定します。
スタック起動後は、API キーやサービスエンドポイントを config/env だけでなく Web UI の /settings から変更できます。
omni、LLM、Embedding、TTS、ASR のモデル定義は infra/config/*_models/ から自動検出されます。ローカルで上書きしたい場合だけ、同名のモデルファイルを config/*_models/ に置いてください。
ステップ 4: ローカル設定を作成して voice-only モードを有効にする
config/cyberverse.yaml を編集します。
inference:
  avatar:
    enabled: false
enabled: false の場合、CyberVerse は純粋な音声 Agent アシスタントとして動作します。
ステップ 5: プロジェクト依存関係をインストールする
make setup
これにより、基本の editable package([dev,inference])のインストール、gRPC stubs の生成、フロントエンド依存関係のインストールが行われます。
デフォルト設定で使う音声 Agent extras をインストールします。
# すべての optional グループを一括でインストール
pip install -e ".[all]"
ステップ 6: サービスを起動する(3 つのターミナル)
ターミナル 1 — Python 推論サーバー:
conda activate cyberverse
make inference
ターミナル 2 — Go API サーバー:
make server
ターミナル 3 — フロントエンド:
make frontend
ステップ 7: 確認する
# API ヘルスを確認
curl -s http://localhost:8080/api/v1/health
ブラウザで http://localhost:5173 を開いてください。
任意: 完全なデジタルヒューマン映像
FlashHead または LiveAct でリアルタイム Avatar 映像を駆動したい場合は、以下の手順を実行してください。
追加要件
- CUDA 12.8+ に対応した GPU
- PyTorch 2.8(CUDA 12.8)
libvpxを含む FFmpeg(動画エンコード用)- Avatar モデル重み
PyTorch(CUDA 12.8)をインストールします。
pip3 install torch==2.8.0 torchvision==0.23.0 torchaudio==2.8.0 --index-url https://download.pytorch.org/whl/cu128
LiveAct を使う場合は vllm をインストールします。
pip install vllm==0.11.0
モデル重みをダウンロードする
CyberVerse は現在 FlashHead と LiveAct に対応しています。必要なものだけダウンロードしてください。今後もさらにモデルを追加していきます。
pip install "huggingface_hub[cli]"
FlashHead(SoulX-FlashHead)
| モデルコンポーネント | 説明 | リンク |
|---|---|---|
SoulX-FlashHead-1_3B |
1.3B FlashHead 重み | Hugging Face, ModelScope |
wav2vec2-base-960h |
音声特徴抽出器 | Hugging Face, ModelScope |
# 中国本土から利用する場合は、先にミラーを設定できます:
# export HF_ENDPOINT=https://hf-mirror.com

hf download Soul-AILab/SoulX-FlashHead-1_3B \
  --local-dir ./checkpoints/SoulX-FlashHead-1_3B

hf download facebook/wav2vec2-base-960h \
  --local-dir ./checkpoints/wav2vec2-base-960h
LiveAct(SoulX-LiveAct)
| モデル名 | ダウンロード |
|---|---|
| SoulX-LiveAct | Hugging Face, ModelScope |
| chinese-wav2vec2-base | Hugging Face, ModelScope |
hf download Soul-AILab/LiveAct \
  --local-dir ./checkpoints/LiveAct

hf download TencentGameMate/chinese-wav2vec2-base \
  --local-dir ./checkpoints/chinese-wav2vec2-base
Avatar Inference を設定する
config/cyberverse.yaml で enabled を true にします。モデル固有の設定は
config/avatar_models/ 配下にモデルごとの YAML として置き、そこにローカル checkpoint
のパスを書きます。
inference:
  avatar:
    enabled: true
    default: "flash_head"
    idle_strategy: "silent_inference"
    runtime:
      cuda_visible_devices: 0      # 共有 GPU ID。マルチ GPU の場合は 0,1 など
      world_size: 1                # 共有 GPU 数。デュアル GPU なら 2
    model_config_dir: "avatar_models"
次に config/avatar_models/flash_head.yaml や config/avatar_models/live_act.yaml を編集します。
これらのモデルパラメータは Web UI からも調整でき、対応するモデル設定ファイルへ書き戻されます。
Baidu Xiling H5 デジタルヒューマン
Baidu Xiling を使用する場合は、認証情報を config/env に置きます:
BAIDU_XILING_APP_ID="your-app-id"
BAIDU_XILING_APP_KEY="your-app-key"
# Optional when the figure needs a fixed camera.
BAIDU_XILING_CAMERA_ID="0"
Baidu Xiling は Web UI でキャラクターごとに選択します。これはローカルの avatar inference モデルではないため、inference.avatar.default に設定しないでください。CyberVerse は引き続き orchestrator で ASR、LLM、TTS、履歴コンテキスト、キャラクター設定を処理し、16 kHz、16-bit、モノラル PCM 音声チャンクをブラウザへ送信します。フロントエンドは Baidu H5 iframe を埋め込み、公式の sendAudioData / AUDIO_STREAM_RENDER メッセージ形式でデジタルヒューマンを駆動します。
LiveAct FP4 GEMM(任意)
FP4 アクセラレーションには LightX2V から lightx2v_kernel をビルド・インストールする必要があります。ビルド環境では PyTorch 2.7+ と CUTLASS のソースを用意してください。
準備
pip install scikit_build_core uv
whl のビルド
git clone https://github.com/NVIDIA/cutlass.git
git clone https://github.com/ModelTC/LightX2V.git
cd LightX2V/lightx2v_kernel
# /path/to/cutlass をローカルの cutlass クローンの絶対パスに置き換えてください。
MAX_JOBS=$(nproc) && CMAKE_BUILD_PARALLEL_LEVEL=$(nproc) \
uv build --wheel \
    -Cbuild-dir=build . \
    -Ccmake.define.CUTLASS_PATH=/path/to/cutlass \
    --verbose \
    --color=always \
    --no-build-isolation
whl のインストール
pip install dist/*.whl --force-reinstall --no-deps
CyberVerse で有効化
config/avatar_models/live_act.yaml(または Web UI)の live_act で次を設定します:
fp8_gemm: false
fp4_gemm: true
これらのフラグを変更したあと、推論サービスを再起動してください。
SageAttention と FlashAttention(任意)
# SageAttention(ソースからビルド)
git clone https://github.com/thu-ml/SageAttention.git
cd SageAttention
export EXT_PARALLEL=4 NVCC_APPEND_FLAGS="--threads 8" MAX_JOBS=32 # Optional
python setup.py install
# FlashAttention (optional)
wget -O flash_attn-2.8.1+cu12torch2.8cxx11abiTRUE-cp312-cp312-linux_x86_64.whl \
  "https://github.com/Dao-AILab/flash-attention/releases/download/v2.8.1/flash_attn-2.8.1%2Bcu12torch2.8cxx11abiTRUE-cp312-cp312-linux_x86_64.whl"

pip install flash_attn-2.8.1+cu12torch2.8cxx11abiTRUE-cp312-cp312-linux_x86_64.whl
よくある質問 — 自己チェック(QA)
アバター映像がカクつく、止まる、音声より遅れるときは、まず推論が再生に追いついているかを確認してください。
推論ログで RTP を確認する
RTP(リアルタイム性能係数)は、チャンクの生成にかかった時間と、そのチャンクを設定 FPS で再生するのに必要な時間の比です。
RTP = elapsed / (frames / fps)
| RTP | 意味 |
|---|---|
| < 1 | 生成が再生より速い — リアルタイム配信に余裕あり |
| = 1 | ちょうどリアルタイム |
| > 1 | 生成が再生より遅い — 産出が消費に追いつかないため、遅延やカクつきが起きやすい |
キャラクターが話している間、推論ターミナル(make inference)のログで LiveAct または FlashHead の chunk 行を確認します。
LiveAct の例(RTP > 1 — リアルタイム不可):
INFO:inference.plugins.avatar.live_act_plugin:LiveAct chunk: idx=2 frames=32 320x480 fps=20 iter=2 elapsed=1.870s is_final=False
- この chunk の再生時間:
32 / 20 = 1.6秒 - RTP:
1.870 / 1.6 ≈ 1.17(> 1 — この GPU では 320×480 @ 20 fps に追いつかない)
FlashHead も同様に、elapsed と num_frames、fps から計算します。
INFO:...FlashHead video chunk generated: chunk_index=1 num_frames=33 512x512 fps=20 ... elapsed=2.100s
この例では RTP = 2.100 / (33/20) ≈ 1.27 で、リアルタイムを超えています。
RTP > 1 のときの対処
- 解像度または画質を下げる — 例:LiveAct の
infer_params.size、FlashHead のheight/width、または FlashHead をmodel_type: "lite"にする。 - 計算資源を増やす — GPU を増やす(
runtime.world_size、cuda_visible_devices)、対応環境では FP8/FP4 GEMM やコンパイル加速を有効化、より高速な GPU を使う。 - 上の対応表に合わせる — ローカル GPU モデルでは、リアルタイムデジタルヒューマン映像インタラクション の リアルタイム可? が「はい」の解像度・FPS・GPU の組み合わせを選ぶ。
純粋な音声モード(inference.avatar.enabled: false)では Avatar の RTP は関係しません。Baidu Xiling と Xunfei Digital Human はクラウド API のため、ローカル Avatar RTP も使用しません。音声のみでカクつく場合は、ネットワーク/WebRTC や上流の音声遅延を疑い、リモートアクセスメモ を参照してください。
リモートアクセスメモ
streaming_mode: direct で組み込み TURN を使う場合、ブラウザはサーバーの 8443/TCP に到達できる必要があります。ページは開けるのに音声・映像がいつまでも接続されない、またはサーバーログに ICE connection state: failed や publish timeout waiting for connection が出る場合は、まず手元の端末からサーバーの 8443 ポートに疎通できるか確認してください。
nc -vz <server-ip> 8443
8443 に到達できない場合、原因はクラウドのセキュリティグループ、ファイアウォール、または NAT 制限であることが一般的です。その場合は、SSH トンネルでローカルの 8443 をサーバーへ転送できます。
ssh -L 8443:127.0.0.1:8443 user@host -p port
トンネル確立後、ブラウザはローカルの 127.0.0.1:8443 経由でリモート TURN サービスへ接続します。
SSH トンネルではなくブラウザからリモートサーバーへ直接接続したい場合は、config/cyberverse.yaml の pipeline.ice_public_ip にサーバーのグローバル IP またはドメインを設定してください。SSH トンネルを使う場合は、デフォルト値(127.0.0.1)のままで構いません。
ロードマップ
ロードマップは Yuque に移行しました:CyberVerse 要件管理。
コミュニティ

QR コードをスキャンするか、メンテナーの WeChat wx_dsd2077 を追加し、申請時に CyberVerse と記載してください。CyberVerse デジタルヒューマン技術交流グループへ招待します。
Star History
ライセンス
GNU General Public License v3.0。詳細は LICENSE を参照してください。
謝辞
SoulX-FlashHead — Soul AI Lab によるアバターモデル
SoulX-LiveAct - Soul AI Lab によるアバターモデル
MuseTalk — TME Lyra Lab によるリアルタイムリップシンクモデル
Pion — Go の WebRTC 実装
関連プロジェクトを探す
affaan-m/ECC
エージェント実行・制御フレームワークの性能最適化システム。Claude Code、Codex、Opencode、Cursor などに向けたスキル、本能、メモリ、セキュリティ、研究優先の開発を備えています。
299,232 スターNousResearch/hermes-agent
あなたと共に成長するエージェント
261,544 スターmultica-ai/andrej-karpathy-skills
Claude Code の挙動を改善するための単一の CLAUDE.md ファイルで、Andrej Karpathy による LLM コーディングの落とし穴に関する観察に基づいています。
230,642 スターfirecrawl/firecrawl
ウェブをはじめとする幅広いデータで、AI エージェントを強化します。超知能のためのライブラリを構築しています。🔥
199,551 スター