
JuneYaooo/rea-video has 7,559 GitHub stars and 1,115 forks. GitHot measured +433 stars in 24 hours. Last checked 2026-11-13 03:23 UTC. Last push 2026-11-09.
Reverse-engineer any video, shot by shot: filmed, AI-generated or coded, and how to remake it. 逆向一切视频,逐个镜头看是拍的、AI 生成的还是代码做的,再告诉你怎么复刻。
できること
- Live footage - Talking-head, tabletop, handheld product demo, vlog, store visit - Setups and camera positions, framing, camera moves, lighting (12 setups with gear lists), color grade
- AI video - Text/image-to-video, AI short drama, AI music video - Evidence, a reverse-engineered prompt per shot, how to batch into generations and which model to use
- Avatar - A portrait driven by audio, lip-sync - Which shots are avatar shots, what portrait and audio you need
- 3D / animation - Blender / C4D explainers, product animation, 2D animation, stop-motion - Whether to generate with a video model or render from 3D code
計測したスター増加
- 24時間
- +433
- 7日間
- 履歴を収集中
- 15日間
- 履歴を収集中
- 1か月
- 履歴を収集中
期間ごとの純増数です。期間は重複しており、日別の値ではありません。未計測の値は空欄です。スター数は注目度の指標であり、品質の保証ではありません。
i18n/README_ja.md
オリジナル
どんな動画でも、どう作られたかを逆算します。
ショット単位で「実写か、AI 生成か、コードで作ったか」を見分けて、作り直し方まで出します。
公式サイト | 中文 | English | Русский | 日本語 | 한국어 | Español | Português | Français | Deutsch



⭐ 役に立ったら Star してもらえると、rea-video がもっと多くの人に届きます
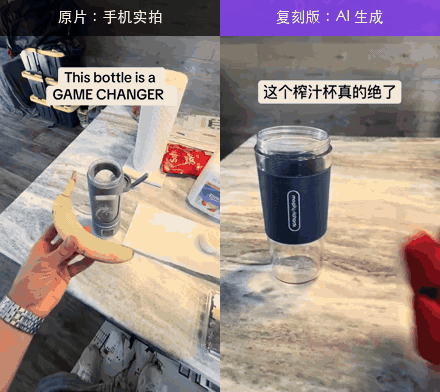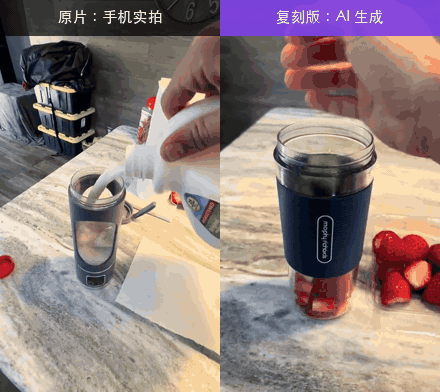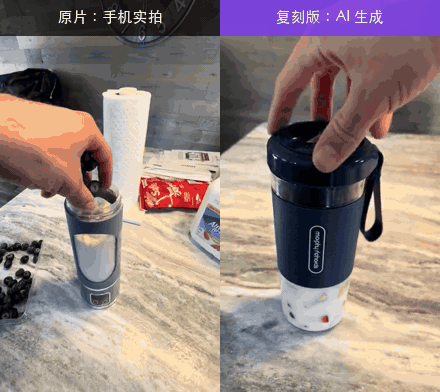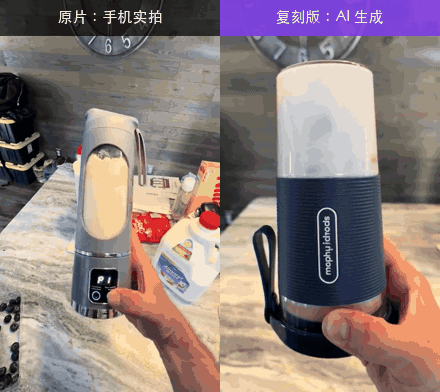
左はスマホで撮った TikTok 広告、右は商品を差し替えた AI リメイク。rea-video の判定は、左が全部実写(1 セット、カメラ位置 2 つ)、右が全部 AI(8 ショットを 3 回の生成で作成)。
クイックスタート
rea-video は AI エージェントから使う前提で作っています。Claude Code や Codex など、コマンドを実行できるエージェントにこう頼むだけです。
https://github.com/JuneYaooo/rea-video をインストールして、この動画を分解して:/path/to/video.mp4
CLI のインストールから使い方の把握、実行まで、エージェントが全部やってくれます。必要なのは ffmpeg と Python 3.10 以上です。
手動でインストールする場合
brew install ffmpeg            # sudo apt install ffmpeg
git clone https://github.com/JuneYaooo/rea-video && cd rea-video
bash scripts/install_skill.sh  # CLI をインストール(pip、ダメなら pipx / ローカル .venv)し、skill をリンク → ~/.claude, ~/.codex, ~/.agents
rea-video --help
出てくるもの:
- 1 行のサマリー。例:"41% AI video + 59% code UI, 8 s of real screen recording, library music at 122 BPM"
- 「撮るもの」「生成するもの」「コードで作るもの」に分けたリメイクプラン
report.html:ショットごとのフレーム、判定の根拠、プロンプト、カメラ・照明のメモ、音声の分析がひととおり入ったレポート
動画を読めるモデル(Gemini でも Doubao でも OK)を足すなら、エンドポイントとキーをエージェントに渡してください。実写 / AI / 3D の判定が正確になり、全ショット分の逆算プロンプトも書いてくれます。モデルなしでも動きますし、エージェントが画像を見られるなら、判定があやしいショットはエージェントが自分で確認します。
レポートは質問したときの言語(中国語か英語)で出ます。下の事例レポートは日本語訳です。
分解できる動画
| 動画の種類 | 例 | わかること |
|---|---|---|
| 実写 | トーク動画、卓上撮影、手持ちの商品紹介、Vlog、店舗訪問 | セットとカメラ位置、構図、カメラワーク、照明(機材リスト付きの 12 パターン)、カラーグレーディング |
| AI 動画 | テキスト / 画像からの動画生成、AI ショートドラマ、AI MV | 判定の根拠、ショットごとの逆算プロンプト、生成のまとめ方、使うべきモデル |
| アバター | 音声で動かす顔写真、リップシンク | どれがアバターのショットか、どんな顔写真と音声を用意すればいいか |
| 3D / アニメーション | Blender / C4D の解説動画、商品アニメーション、2D アニメ、ストップモーション | 動画モデルで生成するか、3D のコードからレンダリングするか |
| コード / テンプレート | モーションタイポグラフィ、UI デモ、グラフ、スライド風カード | テキスト、レイアウト、動きのタイミング。そのまま Remotion プロジェクトとして組み直せます |
| 画面録画 | ソフトのチュートリアル、Web のデモ | 自分で録画し直す必要がある実素材の部分 |
| 混合 / 編集もの | AI キャラ + コードの UI + 実際の画面キャプチャ、実写に AI 編集を加えたもの | ショットごとに別々に判定して、元のタイムラインに組み直します |
映像の作り方以外にも、どの動画でも次のことがわかります。
- 字幕・テロップ:各行の開始と終了(SRT / ASS に書き出し可)、色、縁取り、文字の出し方
- ステッカー、絵文字、ワイプ:どこに置かれて、どれくらい表示されるか
- 編集:どこでカットしているか、テンポ、ビートに合わせているか
- 音声:人の声か AI 音声か、AI 音楽かライブラリ音源か、その BPM、効果音がどこで鳴るか
- 自分で用意する素材:画面録画、スクリーンショット、商品写真
事例
docs/cases/videos/ のサンプル動画は、リポジトリを軽くするために再圧縮していて、TikTok / Douyin のプラットフォームタグが消えています。なので手元で回すと、下のレポートとは結果が変わります(画像を見られるモデルなしだと特に)。再現したいときは、プラットフォームから落とした元ファイルを使ってください。
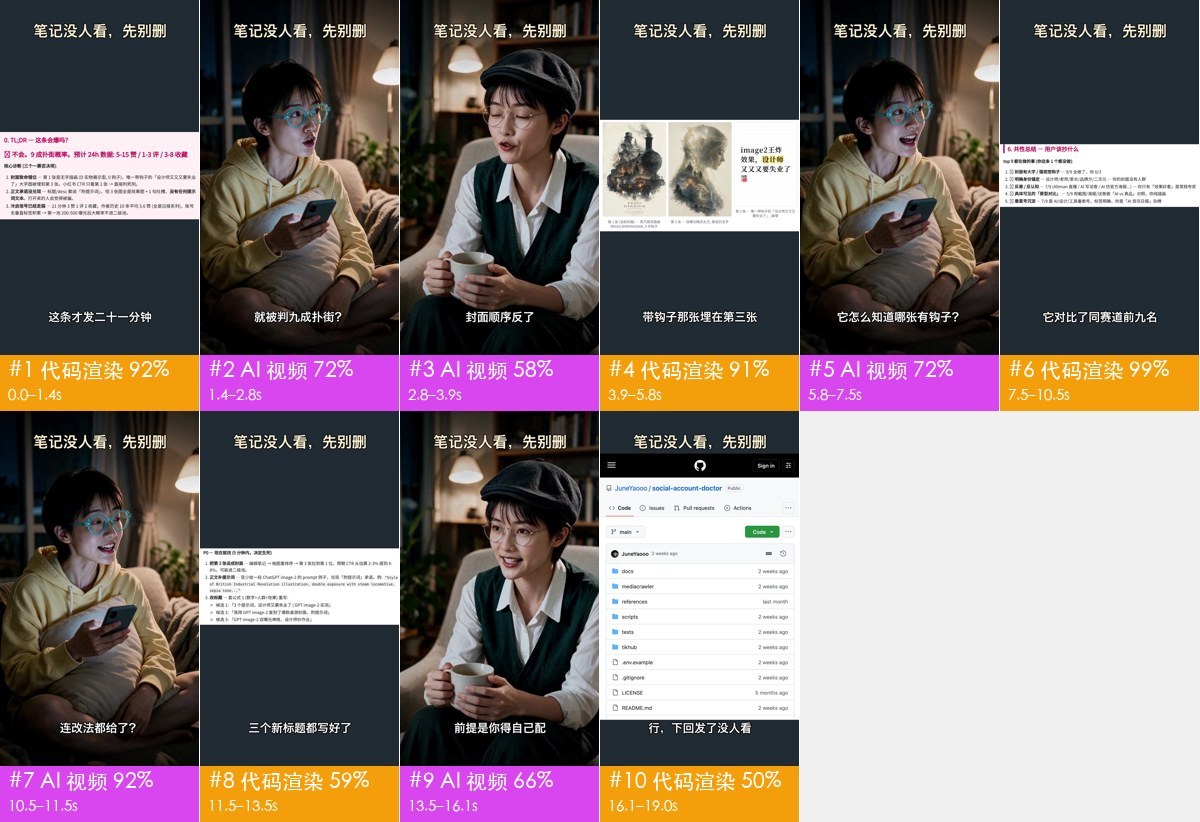 混合メディアのクリップ · 19 秒 · 10 ショット AI キャラの会話 + コードで作った UI + 8 秒の実際の画面録画。会話の 5 ショットは UI パートで途切れていますが、セットが同じなので 1 回の生成で済みます。 動画 · レポート |
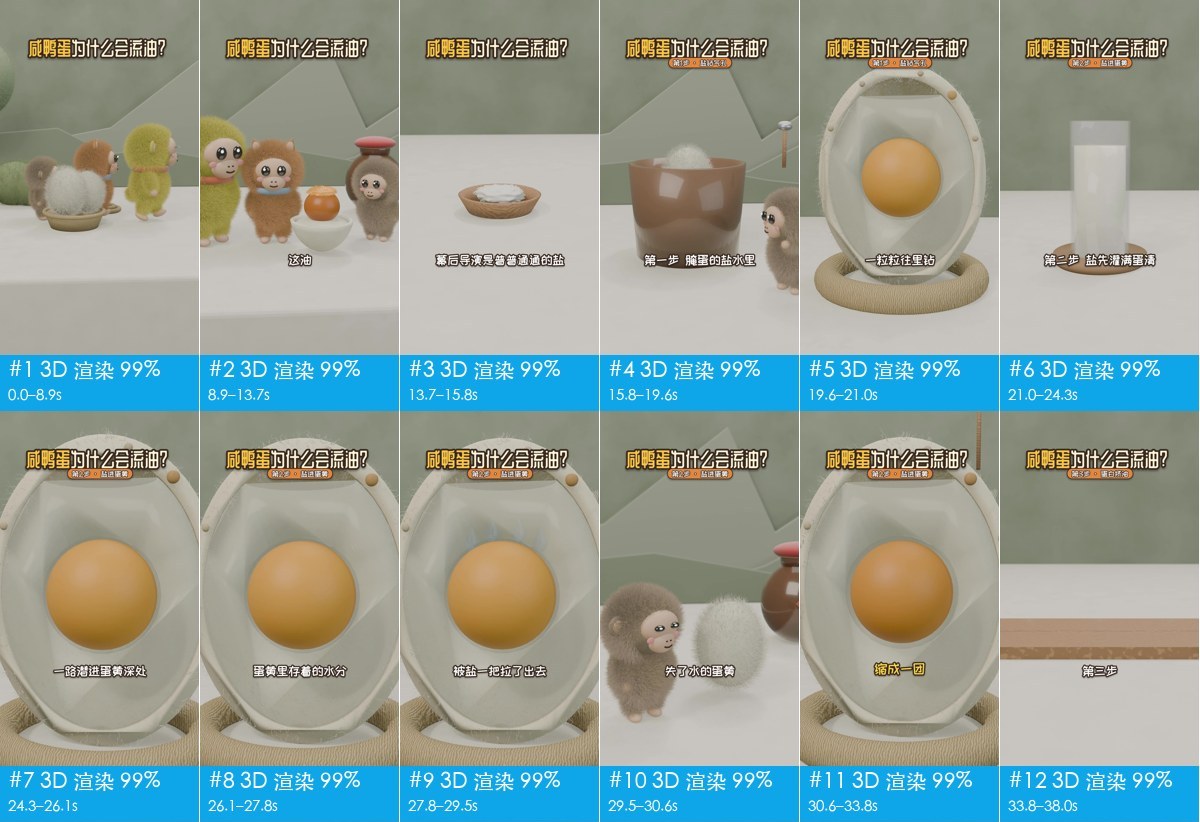 3D の解説動画 · 67 秒 · 21 ショット 全編 3D、ナレーションは AI。動画生成 10 回で作れますし、LLM に Blender / Three.js のコードを書かせる手もあります。 動画 · レポート |
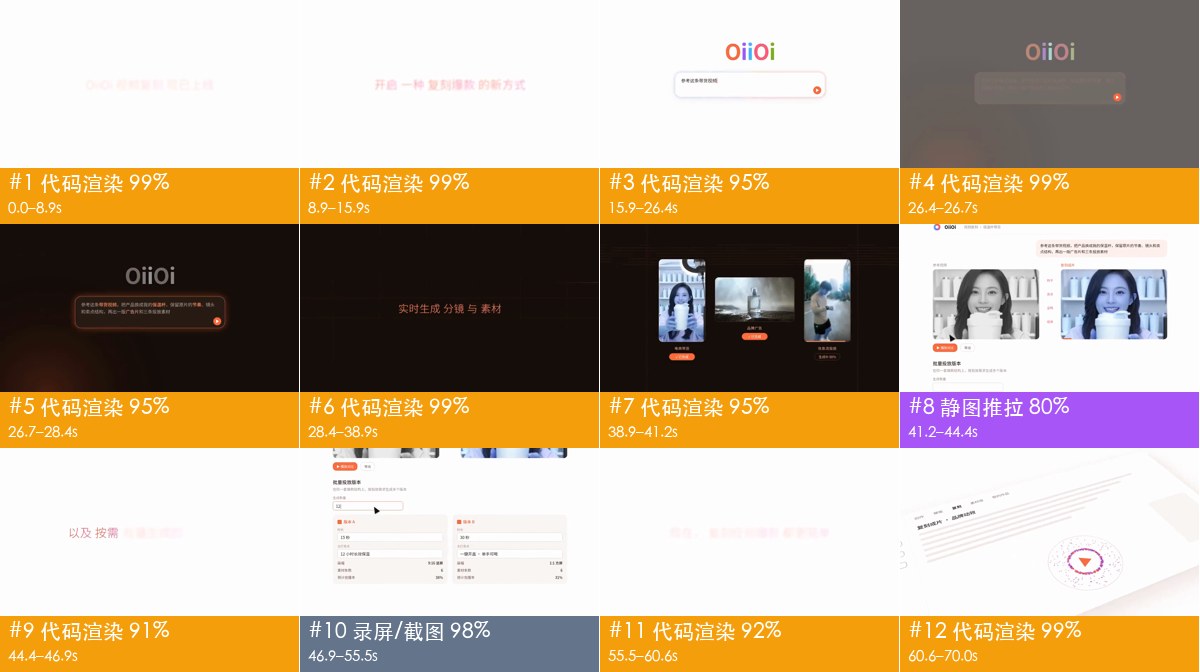 製品プロモーション動画 · 70 秒 · 12 ショット 83% がコードで動かすモーショングラフィックス、12% が画面録画。動画モデルは要らず、Remotion プロジェクト 1 つで作れます。 動画 · レポート |
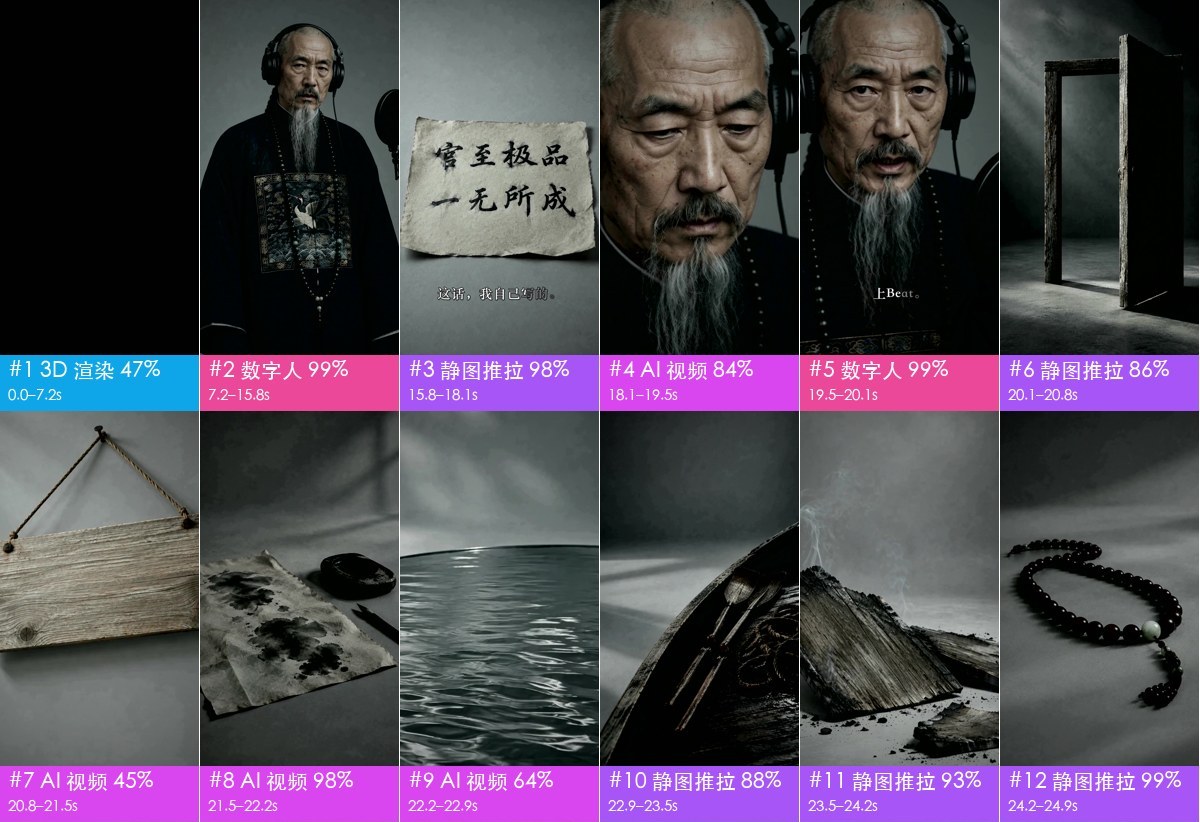 AI ミュージックビデオ · 165 秒 · 86 ショット 曲が AI 生成(実際 Suno 製)だと正しく判定。ビジョンモデルは一部のショットを「実写ドラマ」としましたが、巻物に書かれたデタラメな漢字にエージェントが気づき、AI と判定しました。 動画 · レポート |
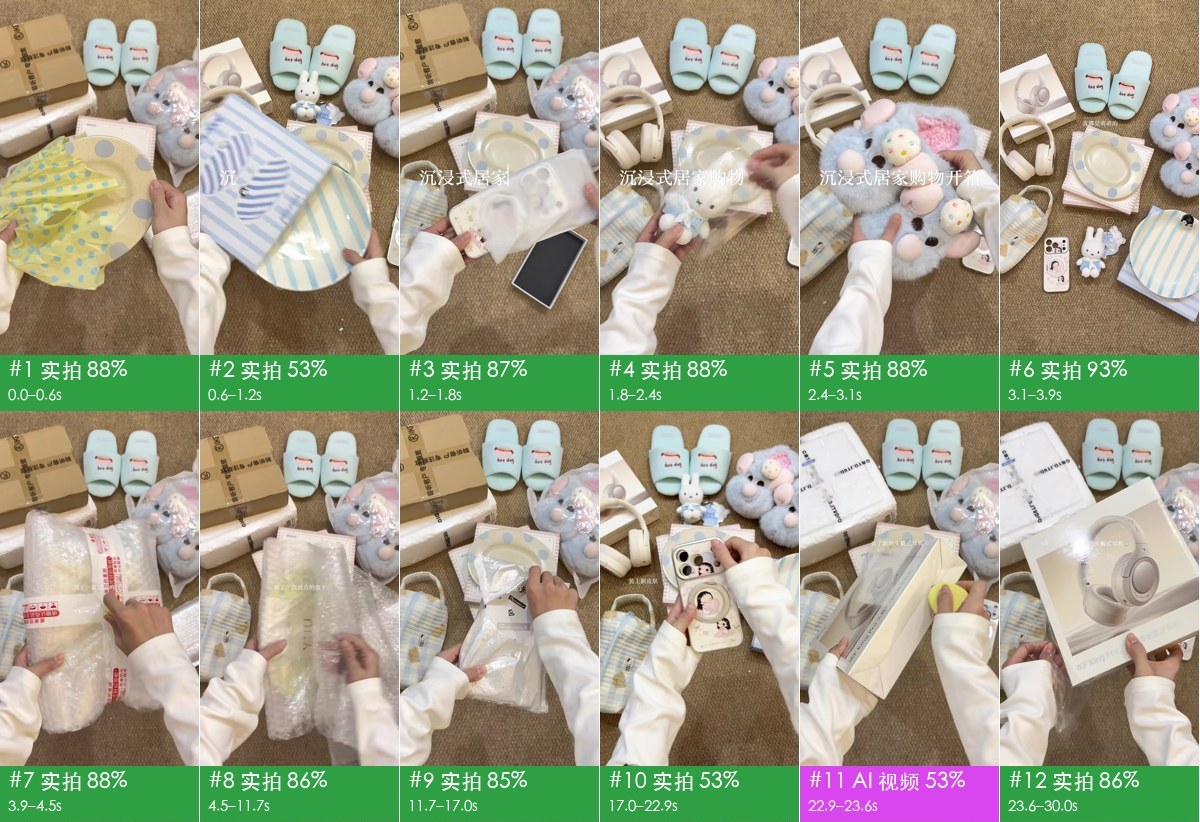 実写の開封動画 · 72 秒 · 29 ショット 全編実写。スマホを俯瞰スタンドに固定し、ラグ 1 枚・カメラ位置 1 つ、ナレーションなし、環境音 + ライブラリ BGM。プラットフォームの再エンコードのせいでツール単体では 35% を AI と誤判定しましたが、エージェントの目視確認で実写 97% まで戻りました。 動画 · レポート |
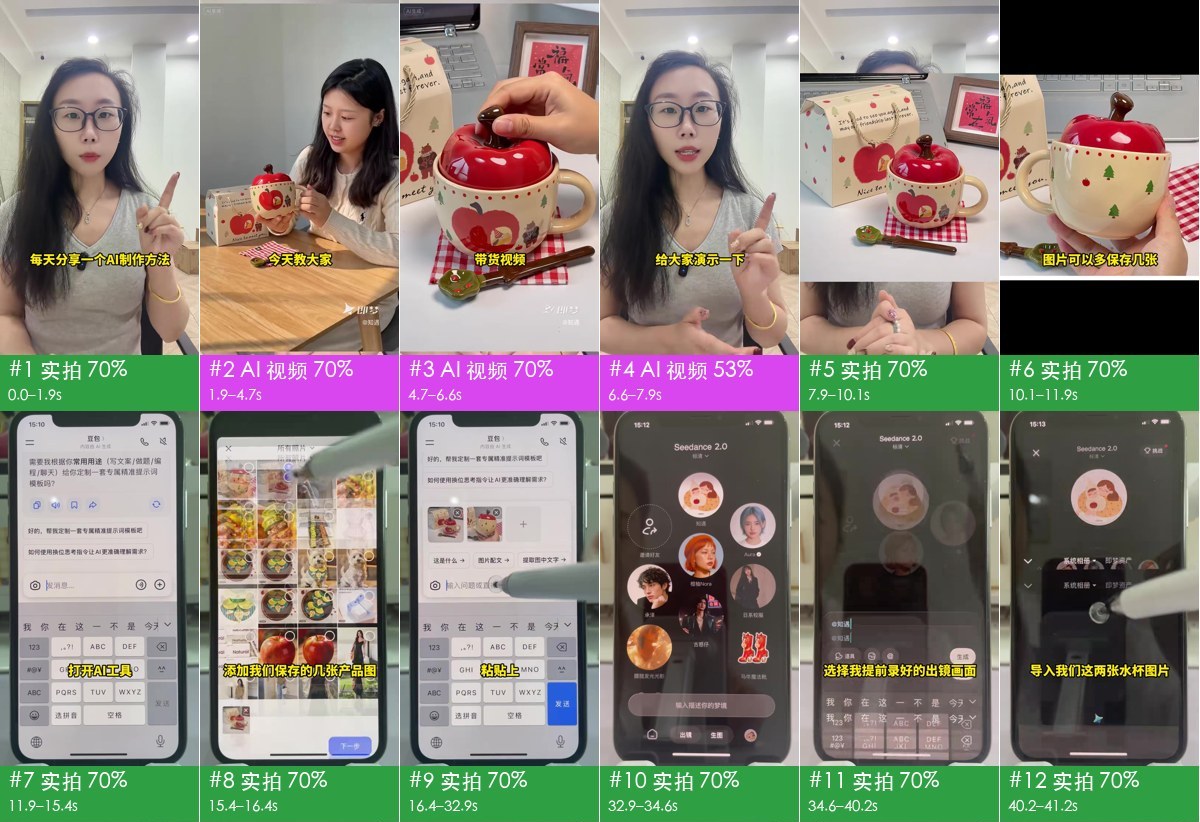 AI と実写のハイブリッド · 58 秒 · 21 ショット 実写 75%(トーク + スマホ画面の撮影)、AI 25%。投稿者が自分の出演クリップと商品写真 2 枚を即夢に渡して、「本人が商品を紹介している」AI 映像を作っています。即夢の透かしとギフトボックスの文字化けから AI 部分を特定しました。 動画 · レポート |
リメイク
rea-video で分解したあとは、capsule-cinema のリメイクレシピで新しいバージョンを作れます。カメラ、動き、テンポ、トランジションは元動画どおりで、選んだ要素だけを差し替えます。 ここに載せた結果は、セルフホストの MiniMax H3 で生成しました。元のショットを動きの参照にして、要素を差し替えたキーフレーム(gpt-image-2)で見た目を決めています。 題材は、OiiOii が WeChat の記事で紹介していた 3 本のリメイクです。それぞれ 2 バージョン作りました。OiiOii と同じ差し替えをしたものと、被写体・舞台・小道具までまとめて差し替えたものです。 各 GIF では、元動画、OiiOii のリメイク、こちらのリメイク、要素差し替え版の 4 つを同時に再生しています。
|
俯瞰での着替え · 12 秒 同じ差し替え:女性 → 男性、服 3 着 → それに対応する紳士服。要素差し替え:中国風の書斎で、歴史的な漢服 3 着を着る女の子。リモコンは丸い団扇に。 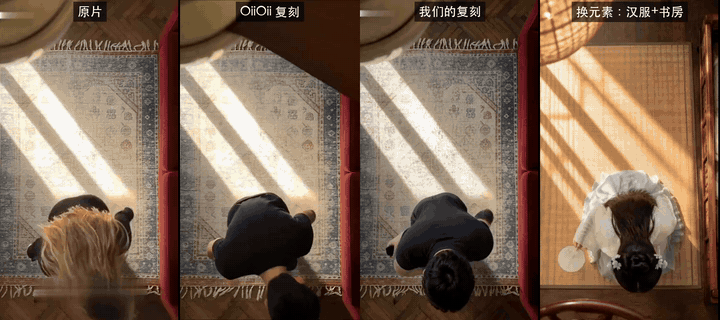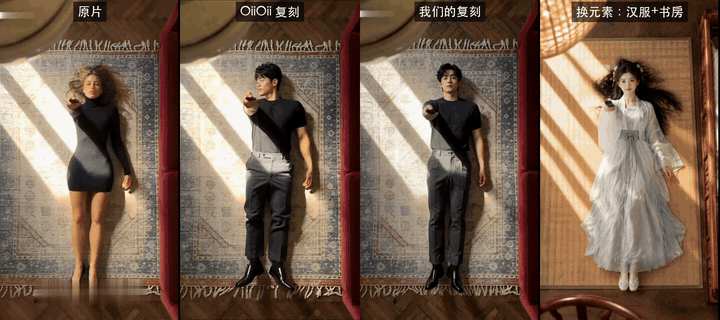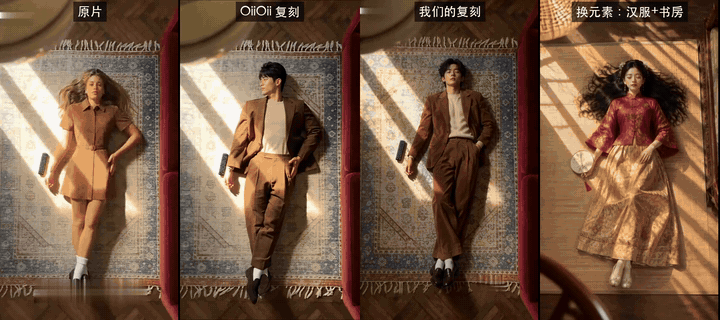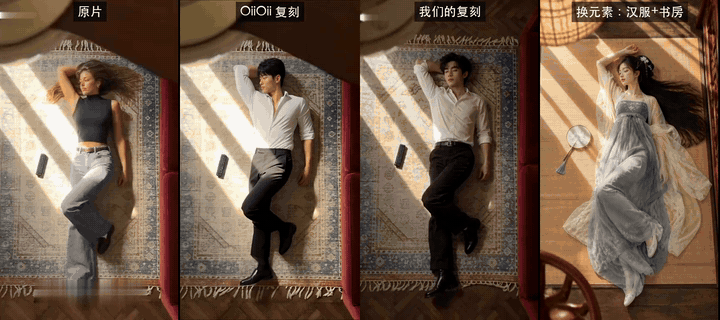 HD 比較動画(音声あり) · 同じ瞬間の静止画 |
|
ペーパークラフト / 水彩アニメ · 30 秒 同じ差し替え:主人公を新しい粘土の女の子に。要素差し替え:キツネに。森 → サンゴ礁、雲 → 星空、夕焼け → オーロラ。 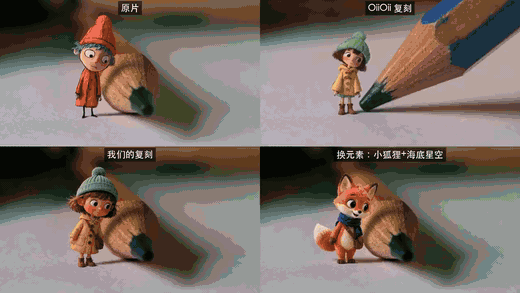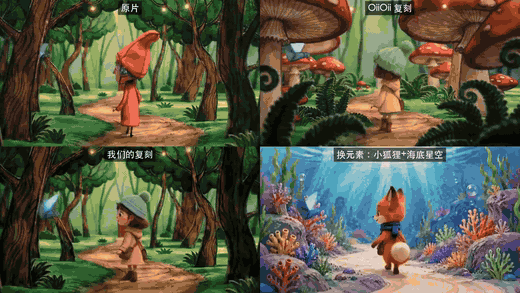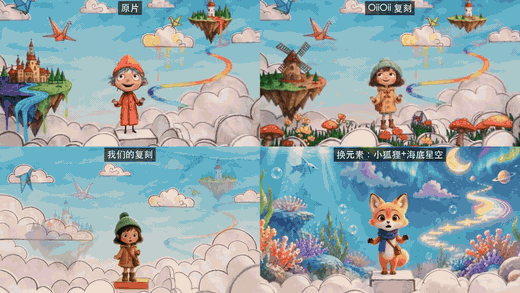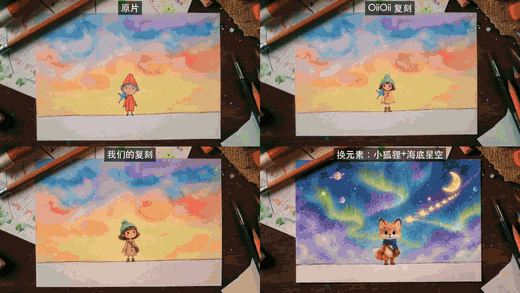 HD 比較動画(音声あり) · 同じ瞬間の静止画 |
|
手持ちの商品紹介動画 · 21 秒 · 11 ショット 同じ差し替え:オリジナルの新商品に、英語のステッカー → 中国語の字幕。要素差し替え:ピンクの商品、キッチン → キャンプのテーブル、食材も変更。 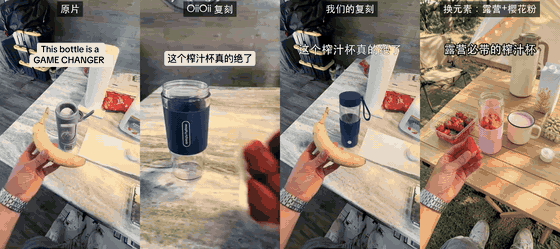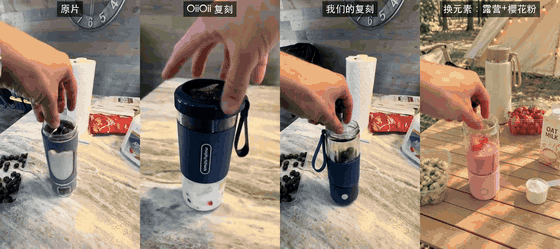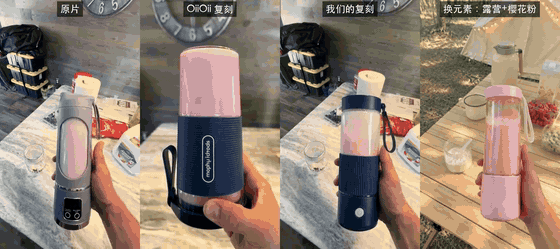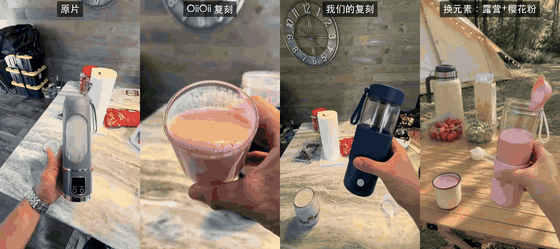 HD 比較動画(音声あり) · 同じ瞬間の静止画 |
HD 比較動画の音声は元動画のものです。元動画と OiiOii 版は記事から引用しており、比較のためだけに載せています。
精度
制作方法の判定精度(ショットの長さで重み付け):
| チューニングセット (15) | ホールドアウト (16) | 再エンコードされた WeChat の動画 (10) | |
|---|---|---|---|
| ツールのみ(オフライン、無料) | 98.3% | 99.6% / 98.9% | 88.6% |
| + ビジョンモデル (Gemini) | — | 99.6% / 99.8% | 99.6% |
| + エージェントによる目視確認 | — | 99.6% / 99.8% | 100% |
ホールドアウトの 2 つの数字は、holdout(9 本)と holdout2(7 本)のものです。
元ファイルなら、たいていはツールだけで足ります。プラットフォームから落とした動画は再圧縮でノイズの手がかりが消えているので、99% 超えに戻すには画像での確認が必要です。
実素材の検出精度は 97〜99% で、ショットの区切りはすべて正しく取れています。数字の詳細と再現手順は eval/RESULTS.md にあります。
仕組み
- 分割:動画をショットに切り分け、音声を声・音楽・効果音に分けます。
- 手がかり集め:フレームを測り(フレーム間隔、センサーノイズ、画面全体が 1 枚の平面としてパンしているか、メタデータの AIGC タグ)、画像を見て(手、文字、物理的なおかしさ)、音を聴きます(BPM、キー、歌か話し声か)。
- 判定:AIGC タグやフレーム間隔のような確かな手がかりを、「それっぽく見える」より優先します。食い違いがあればフラグを立てて、エージェントが目で確認します。
- リメイクの計画:1 クリップの最大長、マルチショット対応か、参照画像を何枚受け付けるかなど、使う動画モデルに実際にできることに合わせてショットをまとめます。
Star History
FAQ
Hypit みたいなワンクリックのリメイクツールとは何が違う?
Hypit は参考動画を渡すと新しい動画を作ってくれるツールです。エージェントがフレームのグリッドを読んで元動画を把握し、対応モデル(Seedance、PixVerse、MiniMax、Wan など)で映像を生成して、字幕やモーショングラフィックスは HTML でレンダリングします。
Hypit は元動画がどう作られたかを気にしません。実写の素材も同じパイプラインに流すので、カメラが何台だったか、照明をどう組んだかはわかりません。どんな AI 動画に寄せられるかも手持ちのモデル次第で、Kling や Veo はなく、アバターや 3D 専用のルートもなく、AI 音楽もないので自分で用意することになります。台本どおりに進むトーク動画、ポッドキャスト、インタビューには一番強く、音楽主導の編集、商品のモーショングラフィックス、映画的なショート動画は苦手です。
rea-video は動画をレンダリングしません。ショットごとに撮影か AI 生成かコードかを見極めて、それぞれの撮影プラン、プロンプト、コードでの作り方を出します。とりあえず似たものをさっと作りたいなら Hypit のほうが速いです。元動画がどう作られたかを理解して、安く作り直したいなら rea-video を使ってください。併用しても問題ありません。
動画を読めるモデルは必要?お金はかかる?
なくても大丈夫です。ツールのみのモードはオフラインで無料、元ファイルならこれだけで十分な精度が出ます。プラットフォームから落とした再圧縮済みの動画には、動画を読めるモデル(Gemini でも Doubao でも OK)を足すか、画像を見られるエージェントを使ってください。料金はそのサービス次第です。動画の自動生成(capsule-cinema)は、まず無料のドライランをして、確認が取れてから有料モデルを呼びます。
動画まるごと自動でリメイクできる?
一部はできます。capsule-cinema を入れておけば、AI のショットを生成して元のタイムラインに自動で戻してくれます。実写のショットは撮影プランを見ながら自分で撮り、コードのショットはエージェントが Remotion プロジェクトとして書きます。詳しくは docs/replicate.md を見てください。
他人の動画をそのまま転載してもいい?
ダメです。rea-video は、動画の構成やテンポ、テクニックを学んで、権利のある素材で作り直すためのものです。他人の映像、音楽、キャラクター、肖像を使い回さないでください。公開するときは、各プラットフォームのルールと、地域ごとの AI コンテンツ表示の決まりに従ってください。
ドキュメント
- docs/what-it-detects.md:検出できる項目の一覧(10 種類の映像タイプ、カメラ、照明、グレーディング、音声)
- docs/replicate.md:レポートからのリメイク
- docs/cases.md:事例の詳細
- docs/decompose.md:検出ルール
- docs/cli.md:CLI の使い方と capsule-cinema との連携
- rea_video/capabilities/:動画 / 画像 / 音声モデルの能力表。リメイクプランでモデルを選ぶときに使います
- eval/RESULTS.md:評価結果
ドキュメントは今のところ中国語だけです。
コミュニティ
質問や分解結果、リメイクのアイデアは GitHub Discussions へどうぞ。Discord でも気軽に声をかけてください。中国語が読める方は linux.do にもいます。
分解してほしい動画があれば、リンクを付けて issue を立ててください。結果は事例として公開します。
クレジット
REA (Reverse Engineer Anything) から着想を得ています。目に見えるものから作り方をさかのぼり、主張にはすべて根拠を付け、測って確かめる、という考え方です。