
HiMeditator/auto-caption
HiMeditator/auto-caption has 610 GitHub stars and 43 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-16 20:18 UTC. Last push 2026-10-14.
計測したスター増加
- 24時間
- 0
- 7日間
- 履歴を収集中
- 15日間
- 履歴を収集中
- 1か月
- 履歴を収集中
期間ごとの純増数です。期間は重複しており、日別の値ではありません。未計測の値は空欄です。スター数は注目度の指標であり、品質の保証ではありません。
概要
A cross-platform real-time subtitle display software. 一个跨平台的实时字幕显示软件。
開発ツールREADME_ja.md
オリジナル



📥 ダウンロード
ソフトウェアダウンロード: GitHub Releases
Vosk モデルダウンロード: Vosk Models
SOSV モデルダウンロード: Shepra-ONNX SenseVoice Model
📚 関連ドキュメント
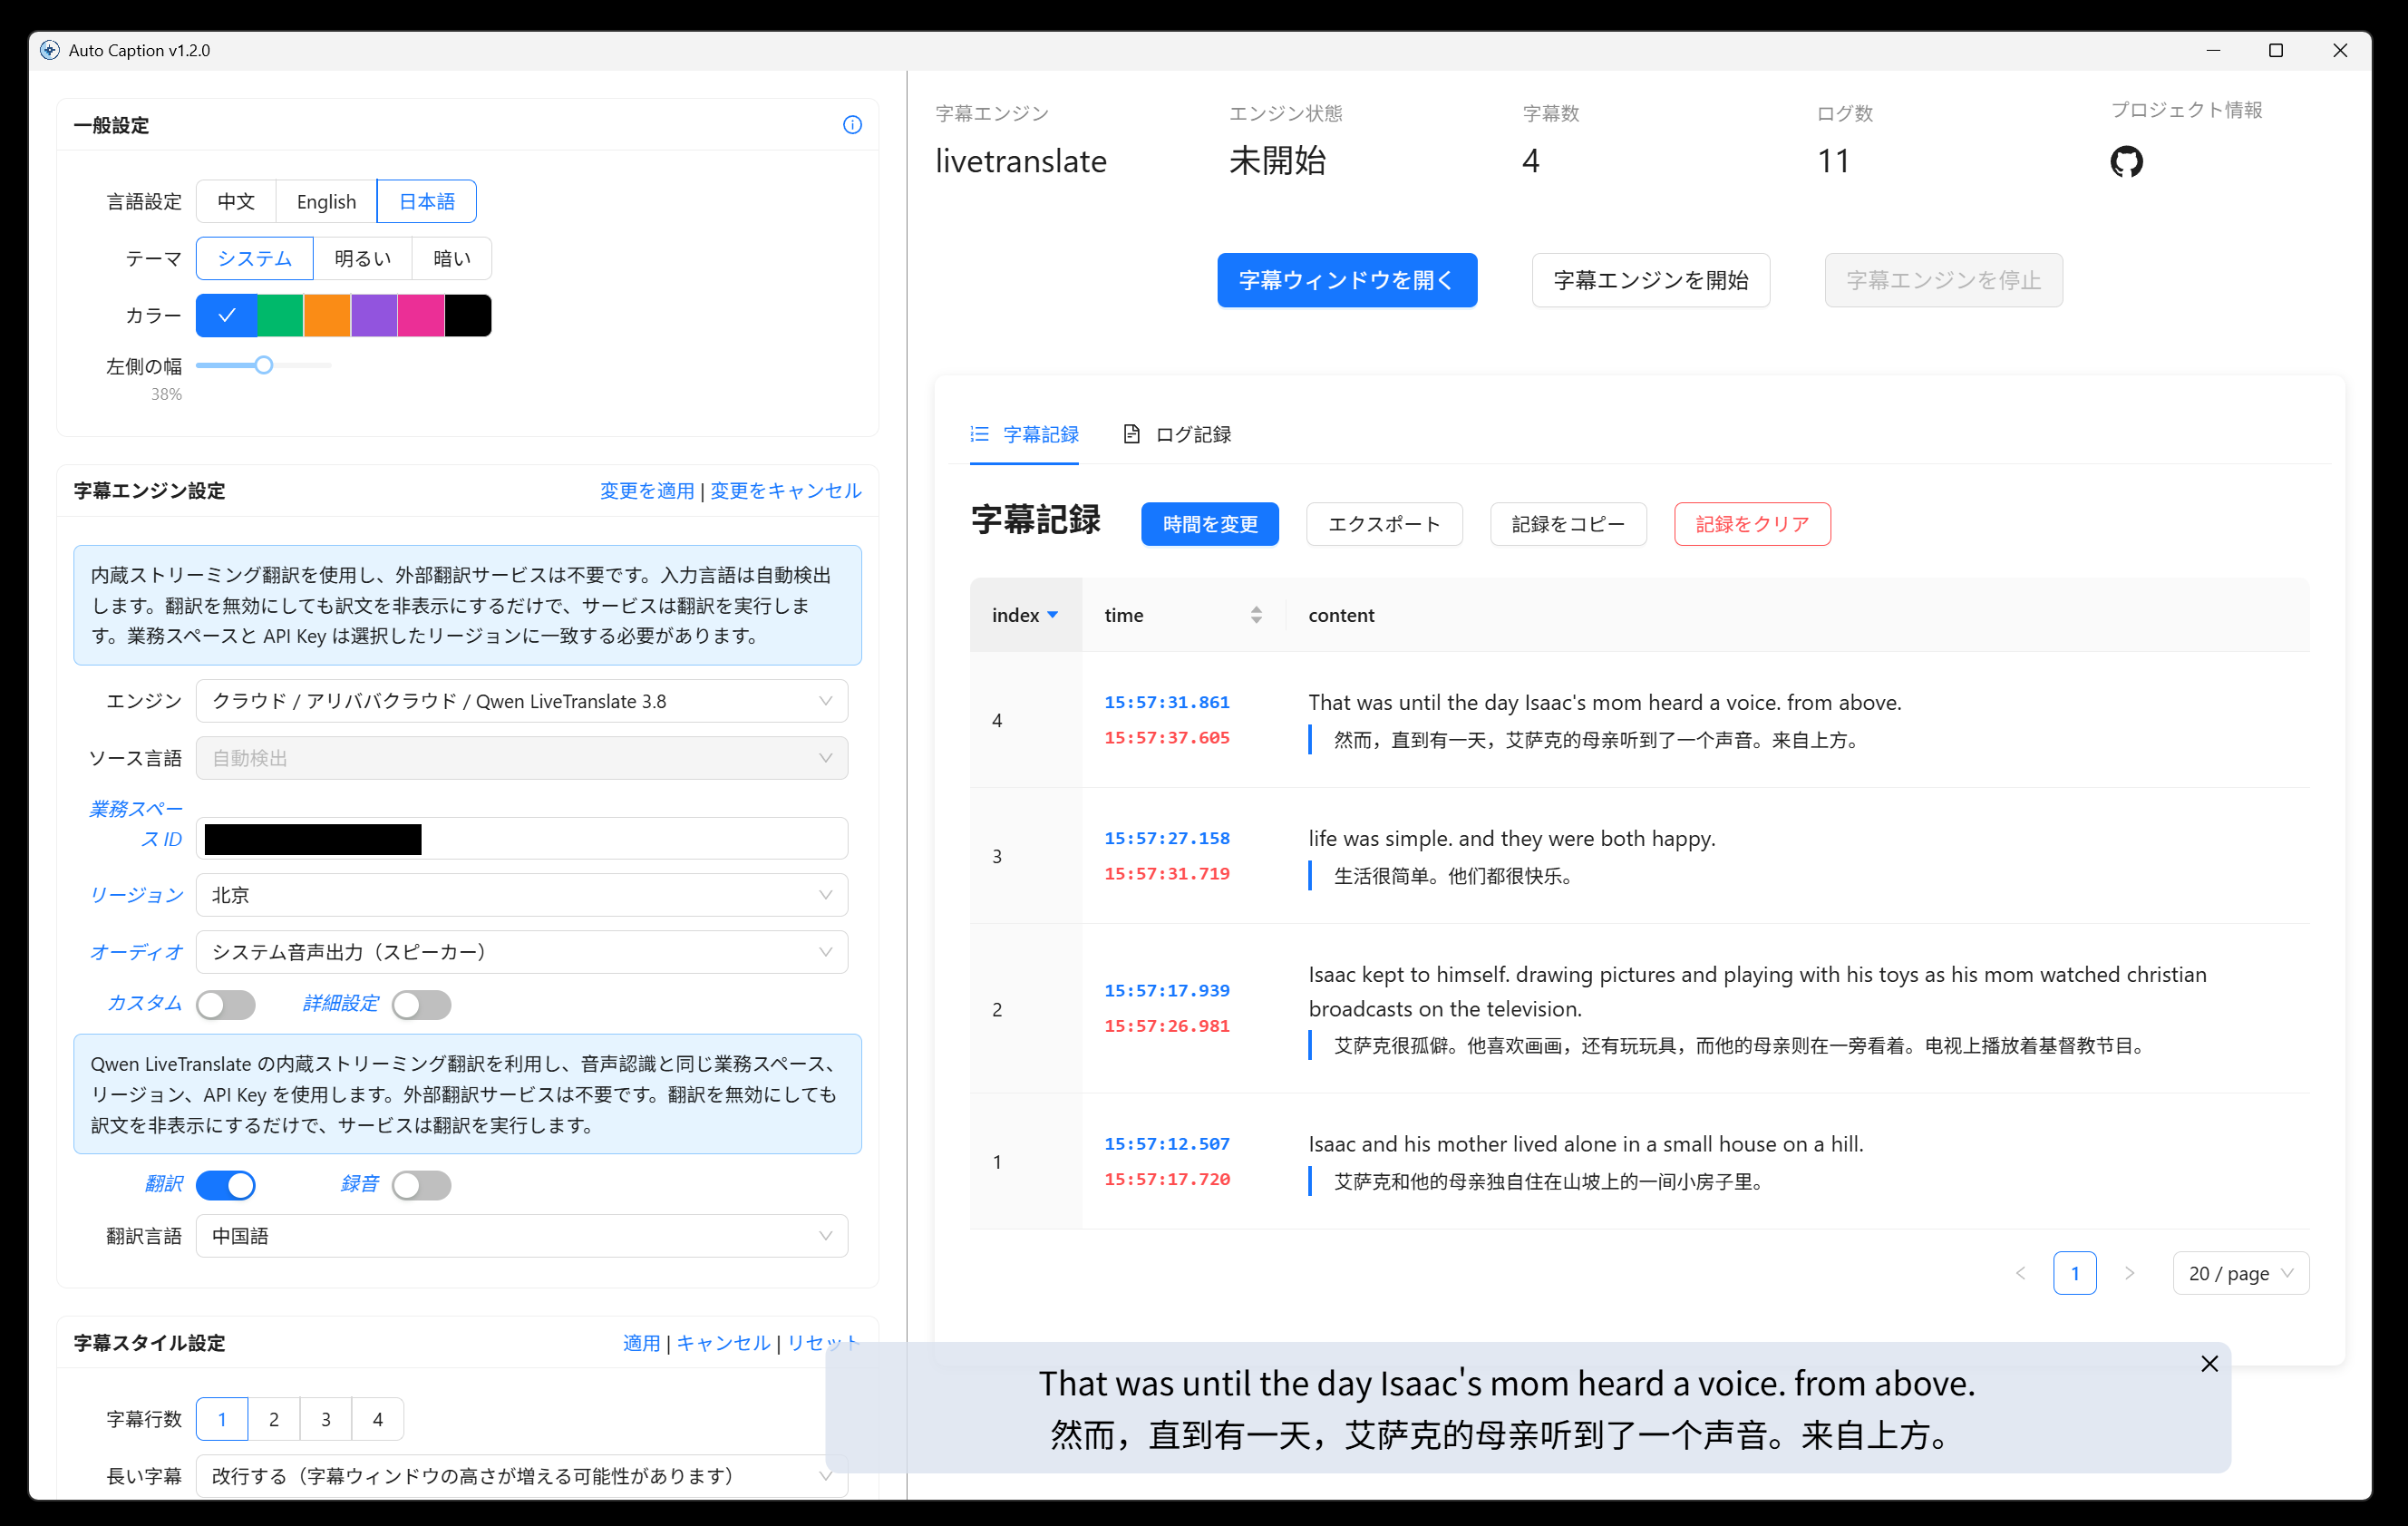
👁️🗨️ プレビュー
https://github.com/user-attachments/assets/9c188d78-9520-4397-bacf-4c8fdcc54874
✨ 特徴
- 音声出力またはマイク入力からの字幕生成
- ローカルのOllamaモデル、クラウド上のOpenAI互換モデル、またはクラウド上のGoogle翻訳APIを呼び出して翻訳を行うことをサポートしています
- クロスプラットフォーム(Windows、macOS、Linux)、多言語インターフェース(中国語、英語、日本語)対応
- 豊富な字幕スタイル設定(フォント、フォントサイズ、フォント太さ、フォント色、背景色など)
- 柔軟な字幕エンジン選択(阿里云Paraformerクラウドモデル、GLM-ASRクラウドモデル、ローカルVoskモデル、ローカルSOSVモデル、または独自にモデルを開発可能)
- 多言語認識と翻訳(下記「⚙️ 内蔵の音声認識モデル」参照)
- 字幕記録表示とエクスポート(
.srtおよび.json形式のエクスポートに対応)
📖 基本的な使い方
このソフトウェアは Windows、macOS、Linux プラットフォームに対応しています。テスト済みのプラットフォーム情報は以下の通りです:
| OS バージョン | アーキテクチャ | システムオーディオ入力 | システムオーディオ出力 |
|---|---|---|---|
| Windows 11 24H2 | x64 | ✅ | ✅ |
| macOS Sequoia 15.5 | arm64 | ✅ 追加設定が必要 | ✅ |
| Ubuntu 24.04.2 | x64 | ✅ | ✅ |
macOS および Linux プラットフォームでシステムオーディオ出力を取得するには追加設定が必要です。詳細はAuto Captionユーザーマニュアルをご覧ください。
ソフトウェアをダウンロードした後、自分のニーズに応じて対応するモデルを選択し、モデルを設定する必要があります。
| 正確性 | 実時間性 | デプロイタイプ | 対応言語 | 翻訳 | 備考 | |
|---|---|---|---|---|---|---|
| Qwen LiveTranslate 3.8 | とても良い😊 | とても良い😊 | クラウド / アリババクラウド | 自動検出 | 内蔵翻訳 | 有料、料金はモデルのリンクを参照 |
| Paraformer Realtime v2 | とても良い😊 | とても良い😊 | クラウド / アリババクラウド | 広東語を含む8言語 | 追加設定が必要 | 有料、約0.864 CNY/時間 |
| glm-asr-2512 | とても良い😊 | 悪い😞 | クラウド / Zhipu AI | 4言語 | 追加設定が必要 | 有料、約0.72 CNY/時間 |
| Vosk | 悪い😞 | とても良い😊 | ローカル / CPU | 30言語以上 | 追加設定が必要 | 多くの言語に対応 |
| SOSV | 普通😐 | 普通😐 | ローカル / CPU | 5言語 | 追加設定が必要 | 1つのモデルのみ |
| 自分で開発 | 🤔 | 🤔 | カスタム | カスタム | カスタム | ドキュメントに従ってPythonを使用して自分で開発 |
Qwen LiveTranslate は翻訳機能を内蔵しています。他の字幕エンジンで翻訳を有効にする場合は、翻訳サービスの設定が必要です。
翻訳モデルの設定
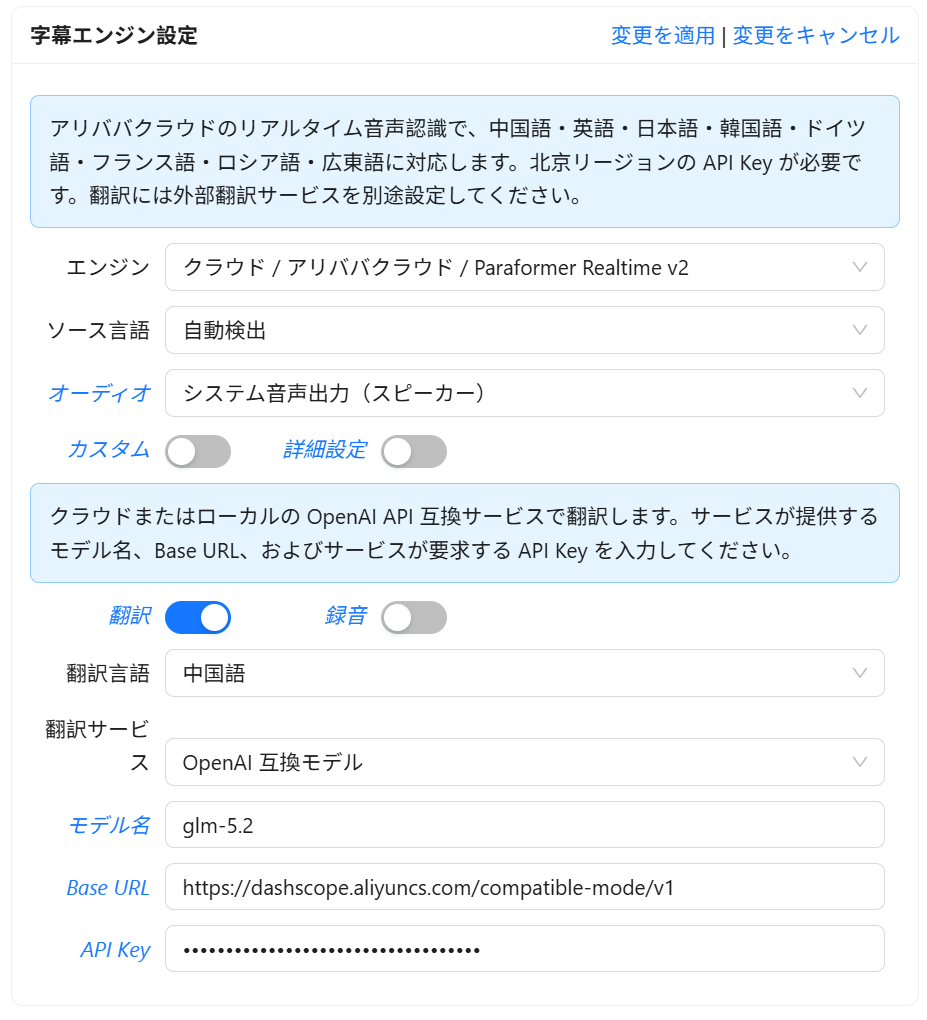
注意:翻訳はリアルタイムではありません。翻訳モデルは各文の認識が完了した後にのみ呼び出されます。
Ollama ローカルモデル
注意:パラメータ数が多すぎるモデルを使用すると、リソース消費と翻訳遅延が大きくなります。1B未満のパラメータ数のモデルを使用することを推奨します。例:
qwen2.5:0.5b、qwen3:0.6b。
このモデルを使用する前に、ローカルマシンに Ollama がインストールされ、必要なモデルがダウンロード済みであることを確認してください。翻訳サービスで「Ollama ローカルモデル」を選択し、モデル名を入力します。Ollama はデフォルトのローカルサービスアドレスを使用します。
OpenAI互換モデル
ローカルの Ollama モデルの翻訳品質に満足できない場合や、Ollama をローカルにインストールしたくない場合は、翻訳サービスで「OpenAI 互換モデル」を選択し、モデル名、Base URL、API Key を個別に入力します。
いくつかのモデルプロバイダの「Base URL」:
- OpenAI: https://api.openai.com/v1
- DeepSeek: https://api.deepseek.com
- アリババクラウド: https://dashscope.aliyuncs.com/compatible-mode/v1
API Keyは対応するモデルプロバイダから取得する必要があります。
Google翻訳API
注意:Google 翻訳 API は、国際インターネットにアクセスできない地域では使用できません。
設定不要で、ネット接続があれば使用できます。
⚙️ 内蔵の音声認識モデル
現在、ソフトウェアには5つの音声認識モデルが搭載されています。それぞれの使い方と説明は以下の通りです。
Qwen LiveTranslate の使用
Qwen LiveTranslate は qwen3.8-livetranslate-flash-realtime を使用し、1つの WebSocket セッションで原文と訳文をストリーミング出力します。外部翻訳サービスは不要です。デフォルトは Paraformer のままです。このエンジンを選択し、業務スペース ID とリージョン(北京・シンガポール)を設定し、詳細設定で同じ業務スペース・リージョンの API Key を入力してください。DASHSCOPE_WORKSPACE_ID と DASHSCOPE_API_KEY 環境変数も利用できます。入力言語は自動検出します。UI の翻訳先は中国語・英語・日本語・韓国語・ドイツ語・フランス語・ロシア語・スペイン語・イタリア語です。16kHz・16bit・モノラル PCM を送信し、文字のみを出力します。翻訳音声は再生しません。翻訳を無効にしても訳文を非表示にするだけで、サービスは翻訳を実行します。認識のみが必要な場合は Paraformer を選択してください。
Paraformer Realtime v2 の使用
デフォルトエンジンはアリババクラウドの paraformer-realtime-v2 です。DashScope Recognition SDK の双方向ストリーミング認識を使用し、16kHz・16bit・モノラル PCM を送信します。中国語、英語、日本語、韓国語、ドイツ語、フランス語、ロシア語、広東語に対応し、auto は言語ヒントを指定しません。内蔵翻訳はありません。翻訳を有効にする場合は Ollama、OpenAI 互換サービス、Google 翻訳を設定してください。確定した文を非同期で翻訳します。設定または全プラットフォームで利用できる DASHSCOPE_API_KEY 環境変数に API Key を指定します。CLI は --dashscope_api_key を使用します。現在は北京リージョンのデフォルト接続先を使用するため、同リージョンの API Key が必要です。旧 Gummy の選択と API Key は自動移行し、スペイン語・イタリア語の入力言語は自動検出に変更します。旧カスタムコマンドは手動で更新してください。公式 SDK ドキュメントを参照してください。
GLM-ASR モデルの使用
使用前に、Zhipu AI プラットフォームから API キーを取得し、それをソフトウェアの設定に追加する必要があります。
API キーの取得についてはこちらをご覧ください:クイックスタート。
Vosk モデルの使用
vosk-api をベースに開発されています。この字幕エンジンは選択可能な言語モデルが非常に多い(30言語以上)一方、認識精度が比較的低く、生成されるテキストに句読点が含まれません。
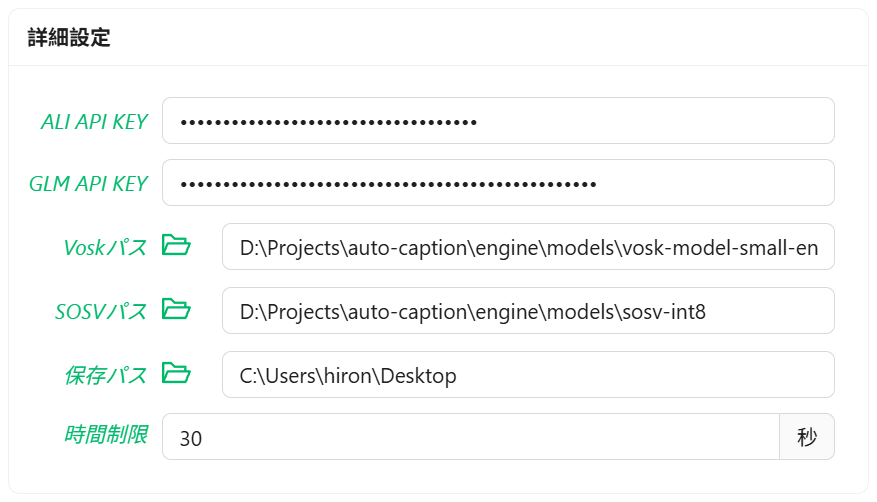
Voskローカル字幕エンジンを使用するには、まずVosk Modelsページから必要なモデルをダウンロードし、ローカルにモデルを解凍し、モデルフォルダのパスをソフトウェア設定に追加してください。
SOSV モデルの使用
SOSV は統合モデルパッケージで、主に Shepra-ONNX SenseVoice をベースに、エンドポイント検出モデルと句読点復元モデルを追加しています。英語、中国語、日本語、韓国語、広東語の認識に対応しています。
SOSVモデルの使用方法はVoskと同じで、ダウンロードアドレスは以下の通りです:https://github.com/HiMeditator/auto-caption/releases/tag/sosv-model
⌨️ ターミナルでの使用
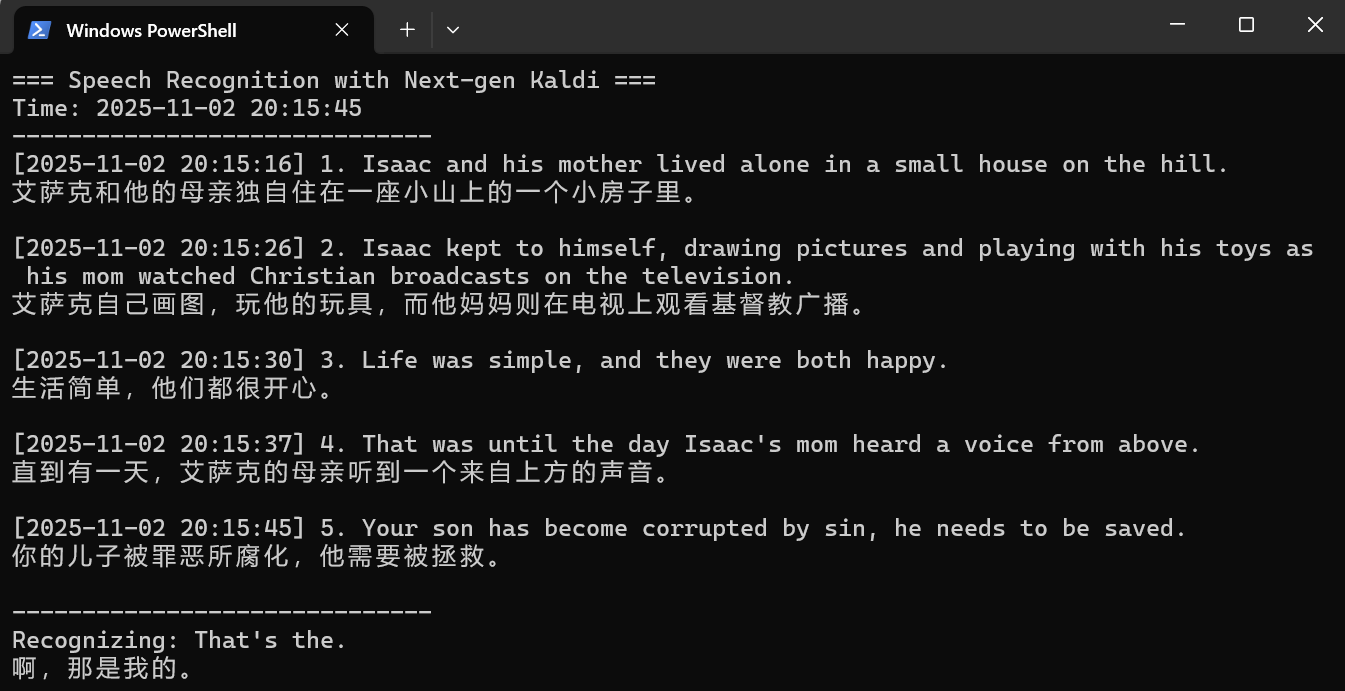
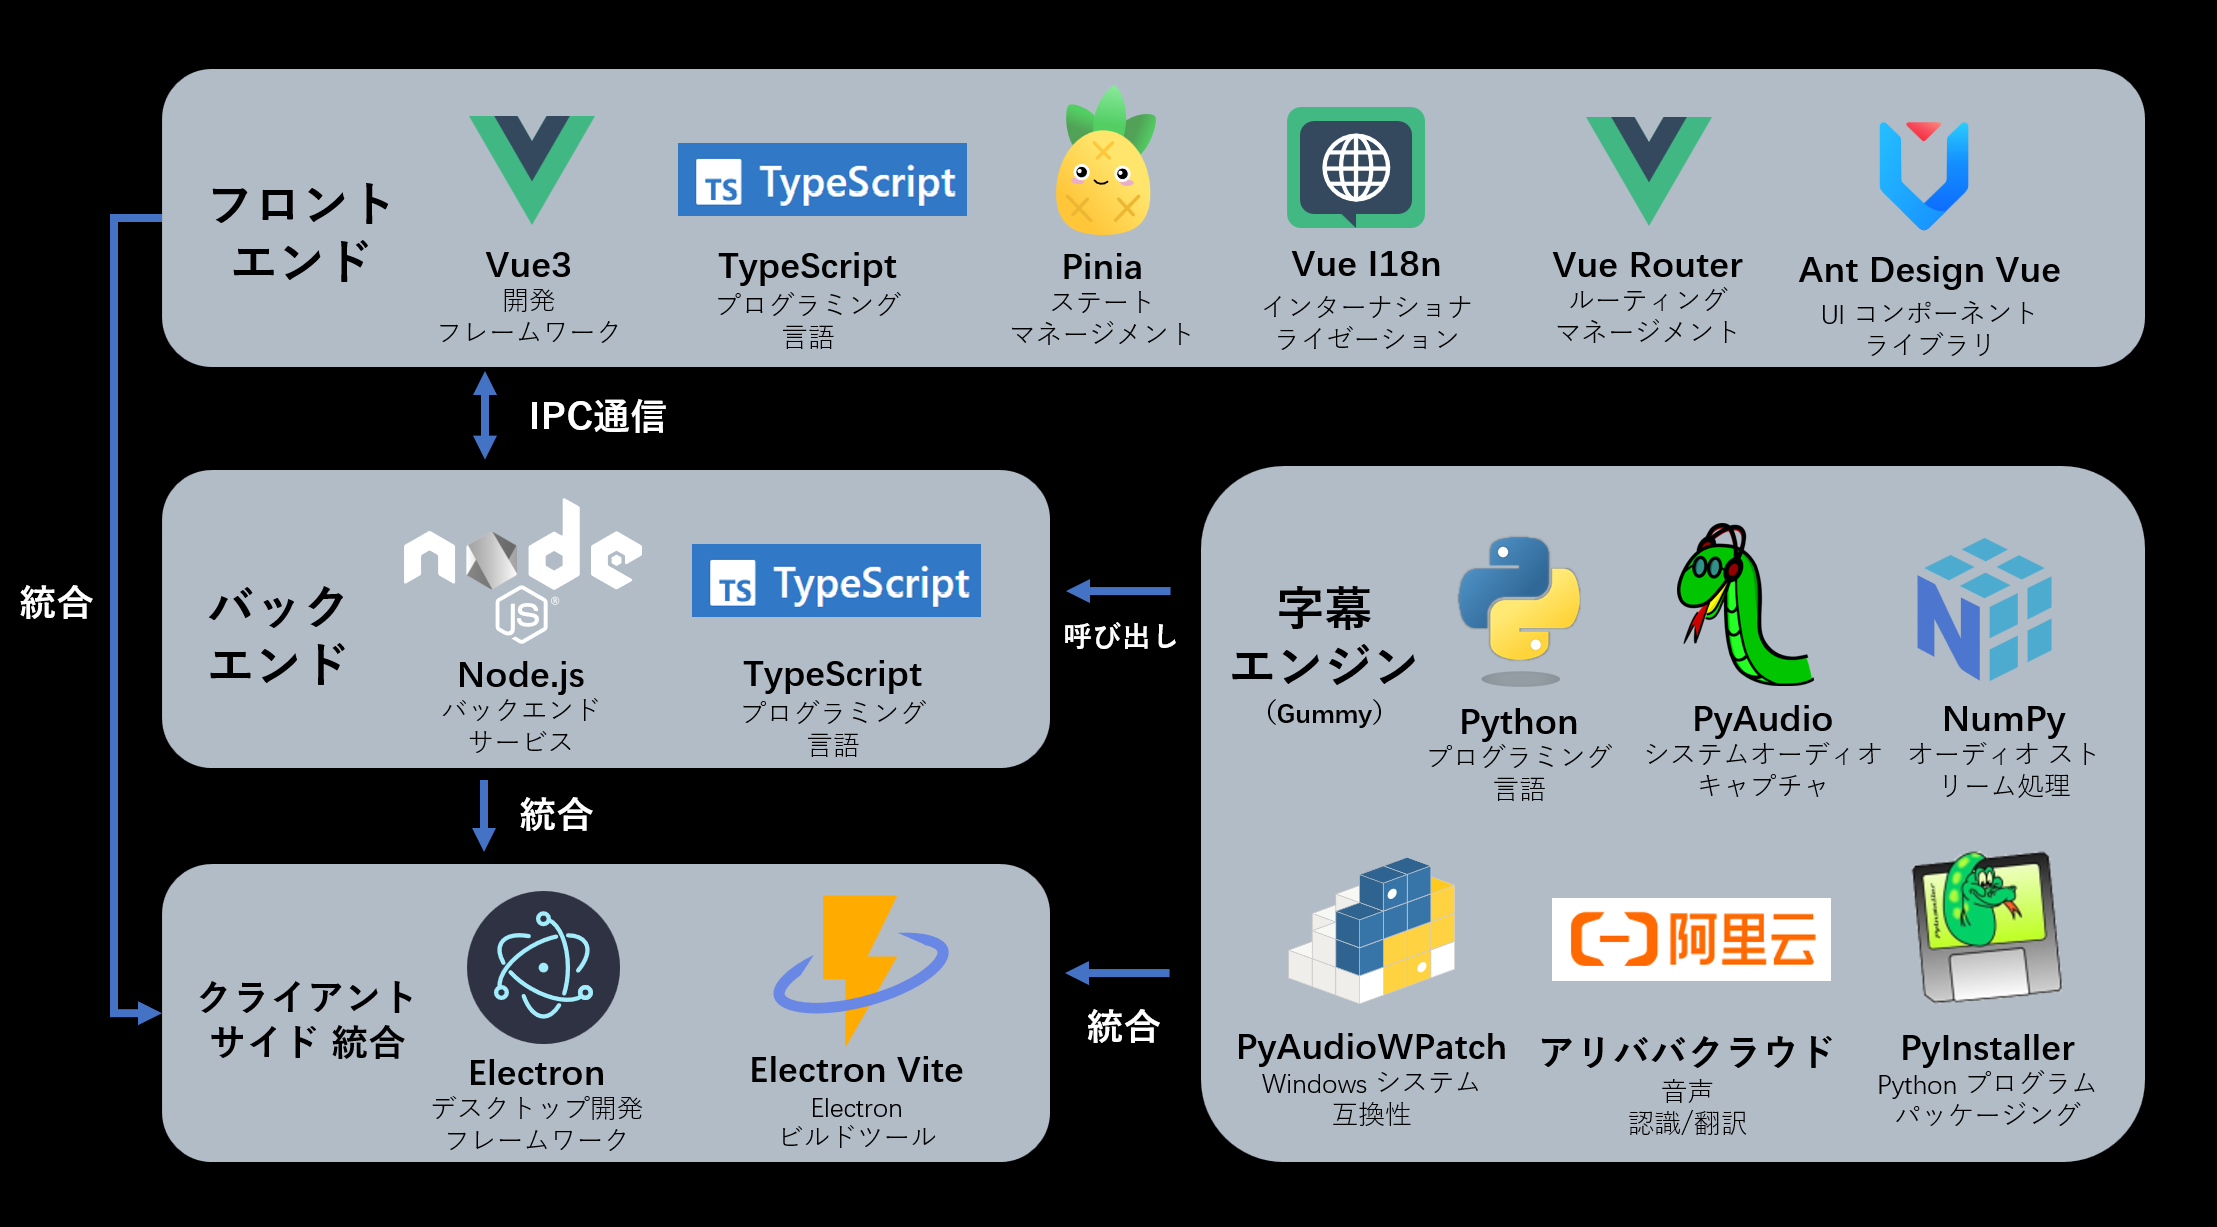
ソフトウェアはモジュール化設計を採用しており、ソフトウェア本体と字幕エンジンの2つの部分に分けることができます。ソフトウェア本体はグラフィカルインターフェースを通じて字幕エンジンを呼び出します。コアとなる音声取得および音声認識機能はすべて字幕エンジンに実装されており、字幕エンジンはソフトウェア本体から独立して単独で使用できます。
字幕エンジンはPythonを使用して開発され、PyInstallerによって実行可能ファイルとしてパッケージ化されます。したがって、字幕エンジンの使用方法は以下の2つがあります:
- プロジェクトの字幕エンジン部分のソースコードを使用し、必要なライブラリがインストールされたPython環境で実行する
- パッケージ化された字幕エンジンの実行可能ファイルをターミナルから実行する
ソースから実行する場合は uv をインストールし、engine ディレクトリで uv sync を実行してください。以下の例もこのディレクトリで実行します。配布用実行ファイルには uv は不要です。
実行引数および詳細な使用方法については、ユーザーマニュアルをご参照ください。
uv run python main.py \
-e paraformer \
--dashscope_api_key sk-******************************** \
--translation_provider ollama \
--translation_model qwen2.5:0.5b \
-a 0 \
-d 1 \
-s en \
-t zh
🚀 プロジェクト実行
依存関係のインストール
npm install
字幕エンジンの管理と構築
まず uv をインストールしてください。依存関係は engine/pyproject.toml で宣言します。engine/.python-version により既定の Python は 3.12 になります。新しくクローンした環境では依存関係を再解決するため、開発者やビルド間でバージョンが異なる場合があります。以下はリポジトリのルートで実行します:
# プロジェクトの依存関係を同期
npm run engine:sync
# テストを実行
npm run engine:test
# 実行可能ファイルを構築
npm run build:engine
Electron の開発版はこの環境の Python を直接実行します。配布版はパッケージ化されたエンジンを実行するため、ユーザーが uv や Python をインストールする必要はありません。
macOS の PyAudio には PortAudio が必要です(例:brew install portaudio)。Linux の音声取得には pactl と parec(Ubuntu では pulseaudio-utils)、および動作する PulseAudio または PipeWire の PulseAudio 互換サービスが必要です。その他の設定はユーザーマニュアルを参照してください。
build:engine は uv が管理する環境で PyInstaller を実行し、単一実行ファイルを生成します。Windows は engine/dist/main.exe、macOS/Linux は engine/dist/main です。配布アプリ内の配置先は Windows が resources/engine/main.exe、macOS/Linux が resources/engine/main です。
プロジェクト実行
npm run dev
コードチェック
リポジトリのルートで実行します:
npm run lint
npm run typecheck
ESLint はデスクトップ側の JavaScript、TypeScript、Vue のソースとビルド設定をチェックし、ビルド成果物、依存環境、モデル、実験用ディレクトリを除外します。Python エンジンは ESLint の対象外です。
プロジェクト構築
# Windows 用
npm run build:win
# macOS 用
npm run build:mac
# Linux 用
npm run build:linux
これらの配布用コマンドは字幕エンジンを先に構築してからデスクトップアプリを構築します。対象の OS 上で実行してください。PyInstaller は別の OS 向けのクロスコンパイルに対応していません。
現在の GitHub Actions は Windows/Linux x64 のみを検証・配布し、macOS の自動ビルドは一時的に無効にしています。main 向けの PR ではコード検証、デスクトップアプリのビルド、テストを実行します。main へのプッシュまたはマージで package.json のバージョンが変わると、検証成功後に Windows の NSIS インストーラー(.exe)と Linux のアーカイブ(.tar.gz)を作成し、両方のアップロード完了後に GitHub Release を公開します。