
nathaninline/ajean has 113 GitHub stars and 15 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-15 15:56 UTC. Last push 2026-11-13.
Progression mesurée des étoiles
- in 24h
- 0
- in 7 days
- Mise à jour retardée
- in 15 days
- Mise à jour retardée
- in 1 month
- Mise à jour retardée
Variations nettes sur des périodes qui se chevauchent, pas des totaux quotidiens. Les mesures absentes restent vides. Les étoiles indiquent l’intérêt, pas la qualité.
À propos
Run your AI models at home in one binary: chat, persistent memory, web access, browser control, MCP tools, encryption at rest and end-to-end encrypted remote access. Linux, macOS, Windows. FR/EN docs.
IAREADME.fr.md
OriginalAJEAN
English · Français
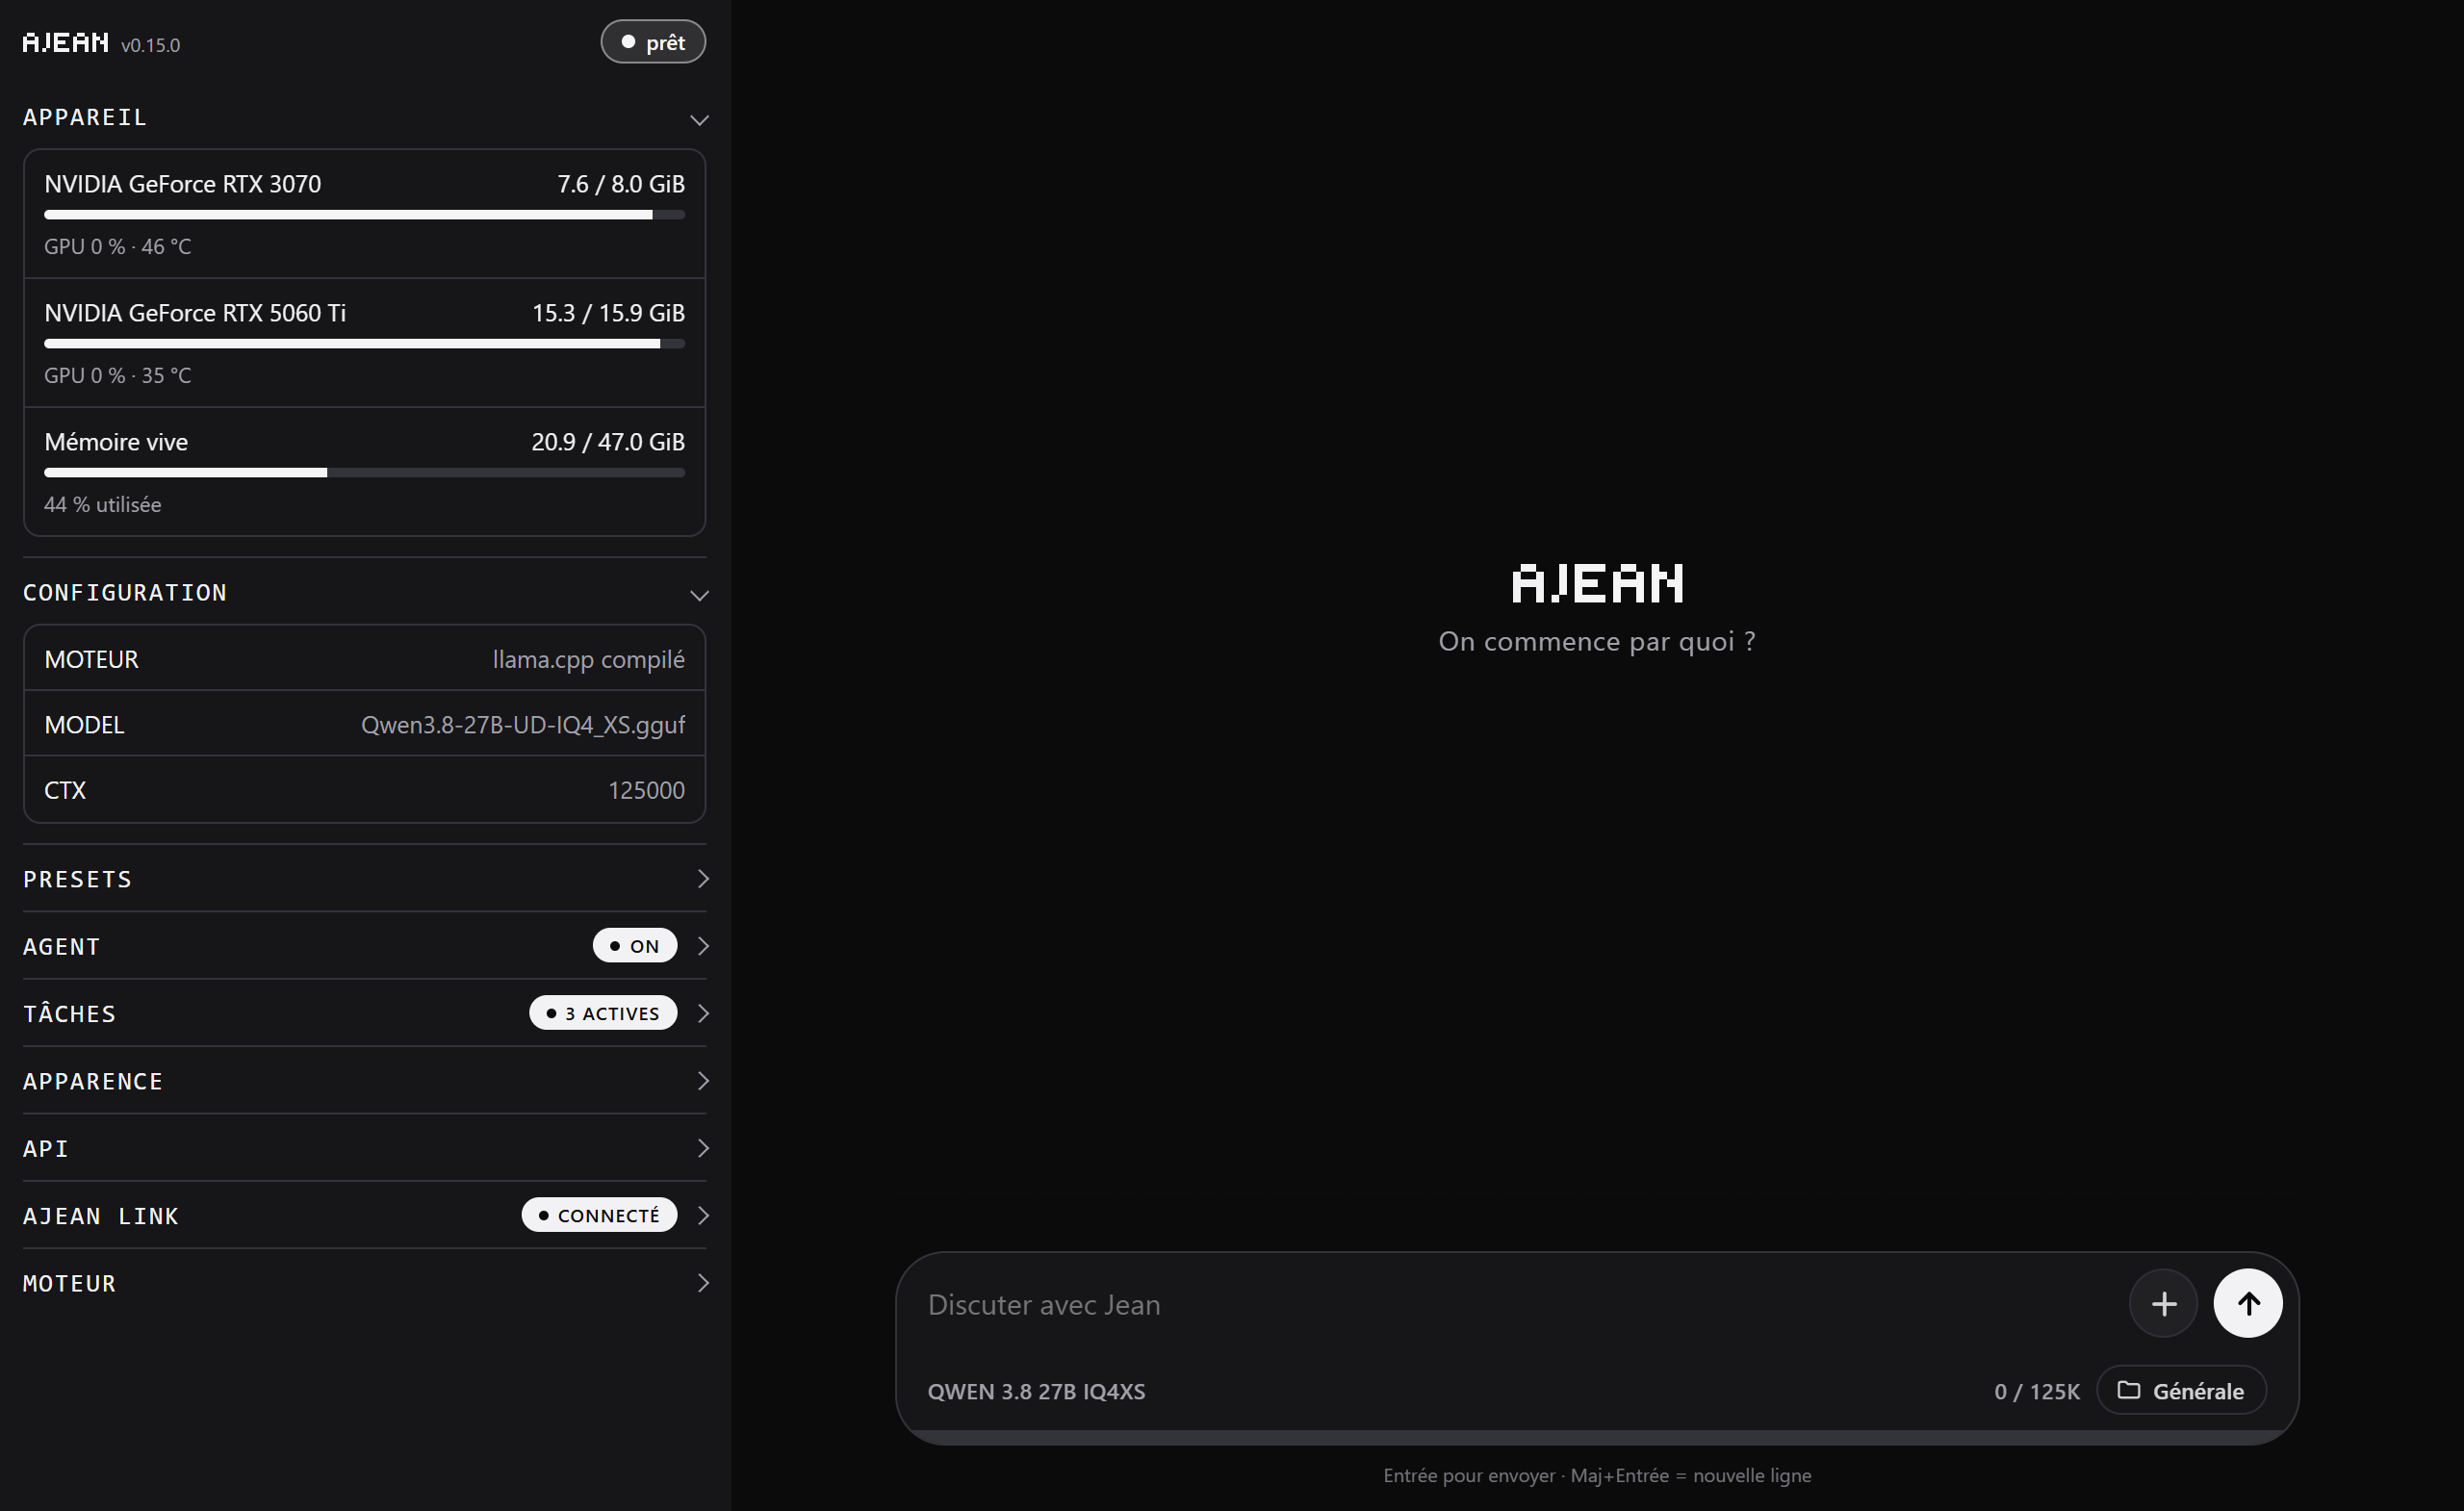
Votre propre IA, chez vous. AJEAN est un programme unique qui transforme un ordinateur équipé d'une carte graphique (ou d'un simple processeur) en assistant IA complet : une interface de discussion, une mémoire, des outils, l'accès au web, des tâches planifiées et l'accès depuis votre téléphone, sans que rien ne quitte votre machine.
AJEAN s'occupe de tout ce qui entoure le modèle. Le modèle lui-même tourne sur llama.cpp, qu'AJEAN installe et tient à jour pour vous.
- Un seul fichier, aucune dépendance. Ni Docker, ni Python, ni environnement à installer. Linux, Windows et macOS.
- Un assistant, pas seulement un modèle. Il se souvient, range le travail en projets, exécute des commandes, lit le web, pilote un navigateur et travaille seul selon un planning.
- Vos données restent chez vous. Tout tourne sur votre machine. La mémoire et les conversations peuvent être chiffrées sur le disque, et l'accès à distance est chiffré de bout en bout.
- Utilisable de partout. Les mêmes conversations sur l'ordinateur et le téléphone, en direct.
- Se branche sur vos outils. Un point d'accès compatible OpenAI pour n'importe quelle application tierce.
Sommaire
- Installation
- Utiliser AJEAN
- Ce que l'IA sait faire
- Modèles et moteur
- Accès de partout
- Vos données
- Référence
- Compiler depuis les sources
Installation
Téléchargez le fichier de votre système depuis la dernière version :
| Système | Fichier |
|---|---|
| Windows | ajean-windows.exe (ajean-windows-arm.exe pour ARM) |
| macOS | ajean-macos-arm.zip (Apple Silicon), ajean-macos.zip (Intel) |
| Linux | ajean-linux (ajean-linux-arm pour ARM) |
Windows
Double-cliquez sur ajean-windows.exe. AJEAN s'installe, crée ses raccourcis et s'ouvre dans sa propre fenêtre, avec une icône dans la zone de notification (Ouvrir AJEAN / Quitter). Lancer plus tard un fichier plus récent met à jour la copie installée.
Ensuite, dans l'interface :
- Le moteur llama.cpp s'installe tout seul au premier lancement (une à deux minutes selon la carte graphique) : il n'y a rien à choisir.
- Section Presets : créez un preset, choisissez ou téléchargez un modèle (n'importe quel lien direct vers un
.gguf, par exemple sur Hugging Face).
macOS
Décompressez, glissez AJEAN.app dans Applications, puis faites clic droit, Ouvrir la première fois (l'application n'a qu'une signature ad hoc). AJEAN s'ouvre dans sa propre fenêtre et vit dans la barre de menus. Le moteur s'installe tout seul ; ajoutez ensuite un modèle comme sous Windows.
Pour la ligne de commande, prenez plutôt le binaire nu ajean-macos-arm / ajean-macos.
Linux (serveur)
curl -L -o ajean https://github.com/nathaninline/ajean/releases/latest/download/ajean-linux
chmod +x ajean && sudo mv ajean /usr/local/bin/ajean

sudo ajean install        # services, droits, dossiers
ajean edit                # renseigner MODEL=/chemin/vers/modele.gguf
ajean start               # démarre le modèle
ajean ui start            # interface sur http://<hôte>:8090
Le moteur llama.cpp est téléchargé au premier démarrage, dans la variante adaptée à la machine : seul le pilote de la carte graphique est requis (ni git, ni cmake, ni toolkit CUDA). ajean engine montre ce qui est installé ; pour imposer une variante : ajean engine repair --variant=vulkan (ou cuda, rocm, cpu, auto).
Sous Linux, AJEAN tourne en deux services : ajean-engine fait tourner le modèle, ajean-ui sert l'interface, l'accès à distance et le point d'accès OpenAI. Redémarrer l'interface est instantané et ne recharge jamais le modèle.
Mettre à jour
ajean update
Ou le bouton de mise à jour dans l'interface. Chaque version est vérifiée avec ses sommes de contrôle publiées avant d'être installée.
Utiliser AJEAN
Deux modes de discussion
Choisissez le mode avec le bouton à gauche de la zone de saisie.
| Mode | Pour | Ce dont l'IA dispose |
|---|---|---|
| Projet | un vrai travail qui s'étale sur plusieurs conversations | mémoire, trackers, web, navigateur, MCP, tâches |
| Jean | un assistant personnel qui vous connaît | sa propre mémoire, des rappels, une conversation unique et continue |
Une conversation garde le mode dans lequel elle a commencé. Les outils reposent sur le mode agent, actif d'office ; ajean agent off le coupe (le modèle répond alors sans outils).
Dictée vocale. Le bouton micro à droite du sélecteur de mode enregistre la voix et insère le texte dans le champ. La transcription passe par une API Whisper compatible OpenAI (Groq par défaut), à régler dans Paramètres > Dictée vocale ; sans clé, la dictée du navigateur est utilisée.
Projets
Un projet est un espace de travail avec sa propre mémoire et ses propres conversations, cloisonnées des autres : un pour l'automatisation de votre boîte mail, un pour un logiciel, un pour vos notes. On change de projet depuis la bulle de la zone de saisie.
Chaque projet a :
- Une mémoire : des pages Markdown que l'IA lit et écrit d'une conversation à l'autre, avec un index tenu à jour automatiquement.
- Des trackers : des données datées qui s'accumulent (un nombre d'abonnés relevé chaque semaine, un poids, un chiffre d'affaires). L'IA les parcourt niveau par niveau au lieu de tout charger.
- Une description, fournie à l'IA au début de chaque conversation (contexte, contraintes, ton).
- Des options dans son menu ⋯ : nom et description, sa mémoire, ses trackers.
Jean, assistant personnel
Jean est un assistant qui se souvient de vous au fil du temps, dans une seule conversation qui ne se termine jamais. Ouvrez-le depuis le menu des modes : il s'affiche en plein écran avec son avatar.
- Sa propre mémoire : un profil court (prénom, proches, préférences, habitudes), des fiches (procédures, recettes, guides gardés en entier) et un journal où chaque échange est consigné et peut être recherché. La fenêtre Mémoire de Jean permet de tout consulter, corriger ou supprimer.
- Rappels et tâches : demandez à Jean de vous rappeler quelque chose, et le rappel arrive comme un message de sa part, avec une notification.
- Un espace de travail séparé : Jean ne peut pas modifier les scripts, fichiers ni la mémoire de vos projets. Il peut les lire, pour voir comment une chose a été faite, et refaire ce dont il a besoin dans son propre espace.
- Un nouveau départ après une pause : après 3 heures sans message, le contexte du modèle repart à vide. Le fil affiché et le journal restent. La clé
JEAN_IDLE_HOURSrègle ce délai (0= jamais).
Historique
L'icône horloge en haut du menu latéral affiche l'historique. Il suit ce que vous faites : les conversations du projet actif en mode Projet, celle de Jean en mode Jean. La recherche couvre toutes les conversations. Une conversation peut être renommée, mise en favori, déplacée vers un autre projet et exportée en Markdown ou en JSON.
Les conversations vivent sur le serveur : elles sont les mêmes sur tous les appareils, en direct. Posez une question sur l'ordinateur, lisez la réponse sur le téléphone. Fermer le navigateur n'arrête jamais une réponse.
Dans le terminal
ajean chat
Une discussion légère dans le terminal, indépendante de l'interface web, avec trois outils (bash, write, edit) qui agissent dans le dossier où vous la lancez. Pratique pour travailler sur un dossier de projet.
Ce que l'IA sait faire
Ces outils sont fournis au modèle tant que le mode agent est actif (il l'est d'office).
Terminal et fichiers. L'IA exécute des commandes (bash, ou cmd.exe sous Windows) et écrit ou modifie des fichiers. Elle travaille dans un dossier de travail jetable ; les scripts à conserver vont dans un dossier scripts séparé qu'aucun nettoyage ne touche.
Mémoire. Par projet, quatre réglages : injectée (l'index est chargé d'avance), recherche (l'IA cherche quand elle en a besoin, plus léger pour le contexte), sur demande (seulement si vous le demandez) ou désactivée.
Web. web_search, web_open, web_read et web_grep, avec le moteur intégré : rien à installer. Il lit les pages servies en HTML, sans exécuter leur JavaScript.
ajean internet on
Pilotage du navigateur. Avec ajean computer on, l'IA pilote un vrai Chrome, Chromium ou Edge sur la machine : ouvrir une page, cliquer, saisir, faire défiler. Elle cible les éléments par l'arbre d'accessibilité, ce qui marche même avec de petits modèles sans vision. Un aperçu en direct montre ce qu'elle fait.
Images. Joignez une image à un message : un modèle multimodal la voit et peut s'en servir. Les images sont redimensionnées avant l'envoi.
Fichiers. Envoyez des fichiers à l'IA depuis le chat (jusqu'à 1 Go chacun), et téléchargez d'un clic ceux qu'elle crée.
Serveurs MCP. Branchez n'importe quel serveur Model Context Protocol (fichiers, bases de données, mail, API) depuis l'interface, en stdio ou en HTTP. Le format est celui de Claude Desktop : une configuration existante se copie telle quelle. Serveurs et outils s'activent un par un.
Tâches planifiées. L'IA travaille seule, à la fréquence choisie (toutes les N minutes, heures ou jours, ou une expression cron) : surveiller une boîte mail, résumer l'actualité, suivre un chiffre. Une tâche peut aussi être un script seul, lancé sans charger le modèle. Chaque tâche choisit son projet, son preset, et si elle a droit à la mémoire et au web. Un interrupteur général met tout en pause.
Notifications. Soyez prévenu quand une réponse est prête, même application fermée ou téléphone verrouillé. Sur iPhone, ajoutez d'abord AJEAN à l'écran d'accueil.
Longues conversations. Quand le contexte se remplit, les anciens échanges sont résumés automatiquement. Les longs résultats d'outils sont archivés et l'IA peut les rappeler au besoin : rien n'est vraiment perdu.
Modèles et moteur
Presets
Un preset est une configuration complète de modèle : fichier du modèle, taille du contexte, couches sur le GPU, cache KV, échantillonnage, raisonnement, décodage spéculatif, vision. Changer de preset recharge le modèle, depuis l'interface ou avec ajean switch. Les presets se règlent dans l'interface ; les fichiers .gguf peuvent être sur n'importe quel disque.
Un preset tourne de l'une de ces trois façons :
| Exécution | Fonctionnement |
|---|---|
| Local | le llama.cpp livré avec AJEAN charge un .gguf sur vos GPU (au choix, par preset) |
| API | n'importe quel point d'accès compatible OpenAI |
| Service | une commande de votre choix (vLLM, un autre llama-server, TabbyAPI, un script…) qui expose une API OpenAI sur cette machine. AJEAN la lance dans son service moteur, à la place de llama.cpp (démarrage, arrêt, journal, relance en cas d'échec), et utilise son API. L'adresse est déduite du --port de la commande, le modèle est le premier annoncé par l'API. |
Télécharger un modèle. Dans l'éditeur de preset, le champ « Télécharger un modèle » cherche directement sur Hugging Face : tapez un nom (« qwen », « gemma »…), choisissez un dépôt puis une quantification, AJEAN la télécharge. Un lien direct vers un .gguf fonctionne toujours.
Moteur
AJEAN fait tourner llama.cpp, et fonctionne comme Ollama : chaque version d'AJEAN livre une version précise de llama.cpp, testée avec elle. Il n'y a ni moteur à choisir, ni mise à jour du moteur à lancer.
- Installation automatique : le
llama-serverofficiel de cette version est téléchargé au premier lancement, et vérifié par son empreinte SHA-256 inscrite dans AJEAN. - Variante choisie pour la machine : CUDA (NVIDIA), ROCm (AMD sous Linux), Vulkan (AMD, Intel), Metal (Mac) ou CPU. Chaque variante est essayée dans un processus à part ; si elle ne démarre pas ou ne voit aucune carte, AJEAN passe à la suivante, jusqu'au CPU. Les bibliothèques CUDA sont livrées avec le moteur : seul le pilote est requis.
- Mise à jour avec AJEAN : le moteur ne change que lorsqu'une mise à jour d'AJEAN apporte une nouvelle version de llama.cpp ; il est alors remplacé au démarrage suivant.
- Dépannage : la section Moteur montre la version et la variante, et propose de le réparer (le retélécharger) ou d'imposer une variante.
Les moteurs des versions précédentes (compilation locale, forks personnalisés, ExLlamaV3, AJEAN MoE) ont été retirés en 0.20. Voir docs/moteur.md.
Moteur tiers (Linux). Un preset API externe peut nommer une unité systemd avec EXTERNAL_SERVICE=ajean-<nom>. AJEAN la démarre quand on bascule sur ce preset, l'arrête quand on en change, et attend que les GPU soient libérés avant de charger le modèle suivant. Donnez à l'unité Conflicts=ajean-engine.service.
Accès de partout
ajean.link
ajean link <jeton> (ou le panneau Accès distant) relie votre serveur au relais ajean.link par une connexion sortante : aucun port à ouvrir, fonctionne derrière n'importe quelle box ou en CGNAT. Vous utilisez ensuite AJEAN depuis app.ajean.link, sur n'importe quel appareil.
C'est un service optionnel et payant (4,80 EUR/mois). Tout le reste d'AJEAN est et restera libre et gratuit.
Le relais est aveugle. Il transporte vos données sans pouvoir les lire :
- tout (discussion et réglages) est chiffré de bout en bout entre votre navigateur et votre serveur (X25519, AES-GCM) ;
- la clé est dérivée de votre mot de passe (OPAQUE) et ne quitte jamais le navigateur ;
- chaque navigateur est appairé une fois avec un code à usage unique (
ajean link code), et une requête ne peut être ni forgée ni rejouée ; - l'application web est servie depuis une origine indépendante (GitHub Pages) : le relais ne peut pas y injecter de code.
Le relais ne voit que des métadonnées techniques (machine en ligne, modèle chargé, VRAM), jamais vos conversations.
Sauvegardes (abonnés). La mémoire, les presets et les réglages peuvent être sauvegardés sur ajean.link, à la main ou chaque jour. Ils sont d'abord chiffrés sur votre serveur : le relais ne stocke qu'un bloc illisible.
Point d'accès compatible OpenAI
Tout outil qui parle l'API OpenAI peut utiliser votre modèle :
- sur votre réseau :
ajean network onrend le point d'accès joignable sur le réseau local ; - sur internet : une adresse publique optionnelle
https://<machine>.oai.ajean.link/v1, protégée par votre clé d'API. Le TLS se termine sur votre machine ; le relais ne fait passer que du trafic chiffré.
Vos données
Tout se trouve sous $AJEAN_HOME : /etc/ajean sous Linux, %ProgramData%\ajean sous Windows, /etc/ajean ou ~/Library/Application Support/ajean sous macOS. ajean where affiche les chemins exacts.
ajean.db |
réglages, conversations, clés (une seule base bbolt) |
presets/ |
un fichier .env par preset |
memory/ |
les pages de mémoire, un dossier par projet |
models/ |
les fichiers .gguf |
backends/ |
le moteur llama.cpp (backends/engine/) |
workspace/ |
le dossier de travail jetable de l'IA |
scripts/ |
les scripts que l'IA conserve |
Le chiffrement au repos (optionnel, un interrupteur dans les réglages) chiffre la mémoire et les conversations en AES-256. La clé est votre clé d'accès à l'interface : elle ne vit que dans vos navigateurs, le serveur n'en garde que l'empreinte. Une clé de secours est remise à l'activation. Un instantané est pris avant chaque bascule : rien ne peut se perdre.
Référence
Commandes
Moteur (ajean-engine)
  start | stop | restart        gérer le service
  status | logs                 état / journal en direct
  enable | disable              démarrage au boot
  edit                          éditer la configuration dans $EDITOR
  switch [N]                    changer de preset
  test | bench [N]              vérifier que le modèle répond / mesurer la vitesse
  vram | gpu [index...]         mémoire GPU / choisir les GPU (gpu all = tous)
  set-api-key [clé]             protéger l'API du modèle
  network [on|off|status]       point d'accès OpenAI sur le réseau local

Interface (ajean-ui)
  ui [start|stop|restart|status]
  web [PORT]                    sert l'interface au premier plan (défaut :8090)
  set-web-key [clé]             protéger l'API de pilotage

IA
  chat                          discussion en terminal (outils dans le dossier courant)
  export [options] [fichier]    exporter la conversation (--json, --last N...)
  agent [on|off|status]         donner ses outils à l'IA
  computer [on|off|status]      pilotage du navigateur
  memory [off|ondemand|always|search|status]
  internet [on|off|status]

Accès distant (ajean.link)
  link <jeton> | link code | link status | link logout | link newid

Moteur llama.cpp (livré avec AJEAN)
  engine                  version livrée, variante installée
  engine install | repair [--variant=auto|cuda|rocm|vulkan|cpu]

Installation
  install | uninstall | update [--check] | where | version
Clés de configuration
ajean edit ouvre la configuration active au format clé=valeur :
| Clé | Rôle | Défaut |
|---|---|---|
MODEL |
nom ou chemin du .gguf |
aucun |
HOST / PORT |
adresse et port du moteur | 0.0.0.0 / 8080 |
CTX |
taille du contexte | 32768 |
NGL |
couches sur le GPU | 999 |
BATCH / UBATCH |
tailles de lot | 2048 / 512 |
THREADS / THREADS_BATCH |
threads CPU | auto |
KV_TYPE (_K / _V) |
quantification du cache KV | aucune |
CUDA_VISIBLE_DEVICES |
GPU utilisés | tous |
REASONING |
on / off / auto / deepseek |
aucun |
REASONING_BUDGET |
plafond de tokens de réflexion (-1 = illimité) |
-1 |
REASONING_EFFORT |
low / medium / high, selon le modèle |
aucun |
COMPACT |
compactage automatique du contexte (off pour le couper) |
actif |
MEM_MODE |
mode mémoire par défaut (chaque projet peut le changer) | always |
JEAN_IDLE_HOURS |
heures de silence avant que Jean reparte d'un contexte vide (0 = jamais) |
3 |
EXTRA_ARGS |
ajouté tel quel à la ligne de commande de llama-server | aucun |
Variables d'environnement
| Variable | Rôle | Défaut |
|---|---|---|
AJEAN_HOME |
dossier des données | voir Vos données |
AJEAN_MODEL_DIRS |
dossiers de modèles en plus (séparés par :, ; sous Windows) |
aucun |
AJEAN_SERVICE |
nom de l'unité du moteur | ajean-engine |
AJEAN_CHROME |
navigateur utilisé pour le pilotage | détecté |
AJEAN_DL_CONNS |
connexions parallèles pour télécharger un modèle (16 au plus) | 8 |
HF_TOKEN |
jeton Hugging Face pour les modèles privés | aucun |
EDITOR |
éditeur pour ajean edit |
nano / notepad |
API de pilotage
Le service d'interface expose une API HTTP. Protégez-la avec ajean set-web-key, puis envoyez Authorization: Bearer <clé> avec chaque appel /api/*.
| Méthode | Point d'accès | Rôle |
|---|---|---|
| GET | /api/ping |
connexion et vérification de la clé |
| GET | /api/status · /api/vram |
état du service · GPU |
| GET | /api/presets |
presets, avec l'actif |
| POST | /api/start · /api/stop · /api/restart |
piloter le moteur |
| POST | /api/chat {"messages":[...]} |
discussion (flux SSE) |
La clé circule en clair en HTTP : pour une exposition publique, placez un HTTPS devant ou passez par ajean.link.
Compiler depuis les sources
Go 1.25 ou plus. AJEAN est écrit entièrement en Go ; l'interface est intégrée au binaire.
git clone https://github.com/nathaninline/ajean.git
cd ajean
CGO_ENABLED=0 go build -o ajean ./cmd/ajean   # Linux, Windows
go build -o ajean ./cmd/ajean                 # macOS (l'icône de la barre de menus exige CGO)
Organisation
cmd/ajean/: point d'entrée et ressources Windows.internal/ajean/: tout le code, fichiers regroupés par préfixe (web_*,chat_*,llm_*,backend_*,relay_*,sys_*,mcp_*,jean_*) ; une carte dansdoc.go.internal/ajean/ui/: l'interface web.index.htmlest généré : modifiezui/src/, puis lancezgo generate ./internal/ajean.tools/: outils de construction (assemble-ui,gen-icon,verify-i18n).
L'interface existe en anglais et en français ; voir docs/TRANSLATING.md pour ajouter une langue.
Licence
MIT. Le fichier intégré marked.min.js est Marked, lui aussi sous licence MIT.