
mk668a/GhostType
mk668a/GhostType has 38 GitHub stars and 2 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-15 04:52 UTC. Last push 2026-08-11.
Progression mesurée des étoiles
- in 24h
- 0
- in 7 days
- Historique en cours
- in 15 days
- Historique en cours
- in 1 month
- Historique en cours
Variations nettes sur des périodes qui se chevauchent, pas des totaux quotidiens. Les mesures absentes restent vides. Les étoiles indiquent l’intérêt, pas la qualité.
À propos
AI-powered keyboard completion engine for macOS
Outils de développementdocs/i18n/README.fr.md
Original
English · 日本語 · 简体中文 · 繁體中文 · 한국어 · Español · Français · Deutsch · Português
GhostType
L'autocomplétion au Tab dans tous les champs de texte de votre Mac, entièrement exécutée sur votre machine.


GhostType est une alternative gratuite et sous licence MIT à Cotypist, l'application d'autocomplétion pour Mac au code fermé.
La situation
Vous en êtes à la troisième phrase d'une réponse dans Gmail. Vous savez déjà comment la phrase se termine. Vous devez quand même la taper en entier.
Votre éditeur a réglé ce problème il y a des années : GitHub Copilot affiche la fin de la ligne en gris, et vous appuyez sur Tab. Rien ne fait cela pour Mail, Slack, Notes, ni pour le champ de texte du navigateur où vous passez réellement vos journées.
Ce que fait GhostType
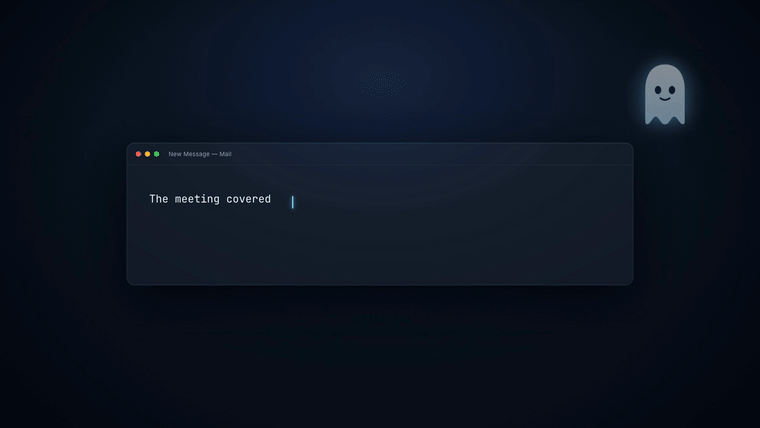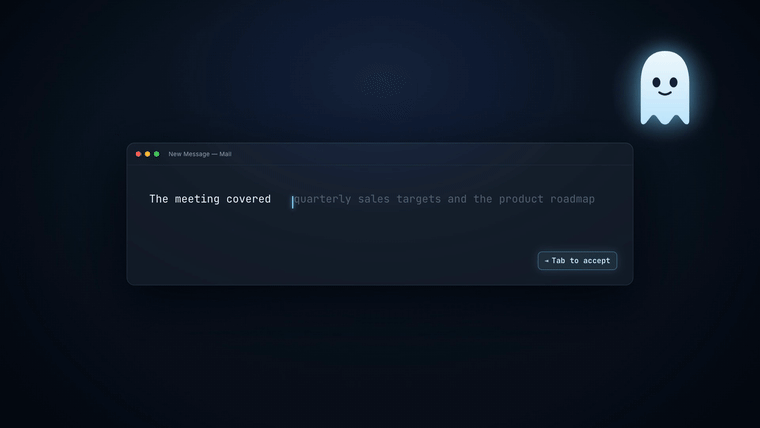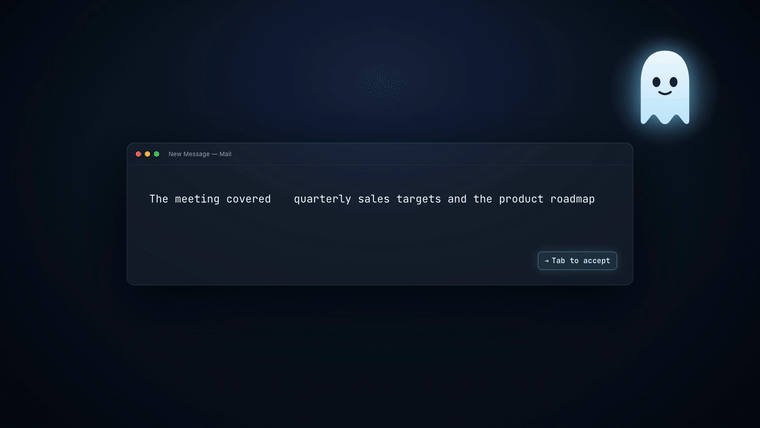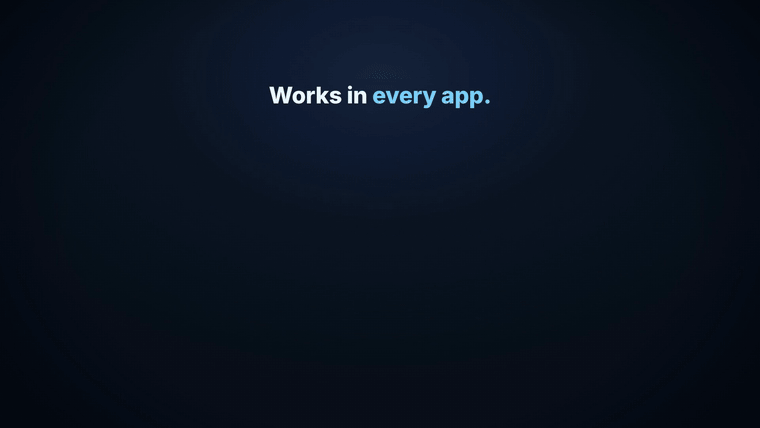
Vous arrêtez de taper. Du texte gris apparaît au curseur. Vous appuyez sur Tab.
Before:  Thanks for sending over the draft. I read through it this morning and I think▌

After:   Thanks for sending over the draft. I read through it this morning and I think
         it's great. I'm going to start working on it today.▌
                    └─ grey ghost text, Tab to accept, Esc to dismiss
C'est une vraie suggestion produite par l'un des modèles fournis. Le comportement est identique dans Safari, Notes, Mail, Slack et n'importe quel autre champ de texte macOS.
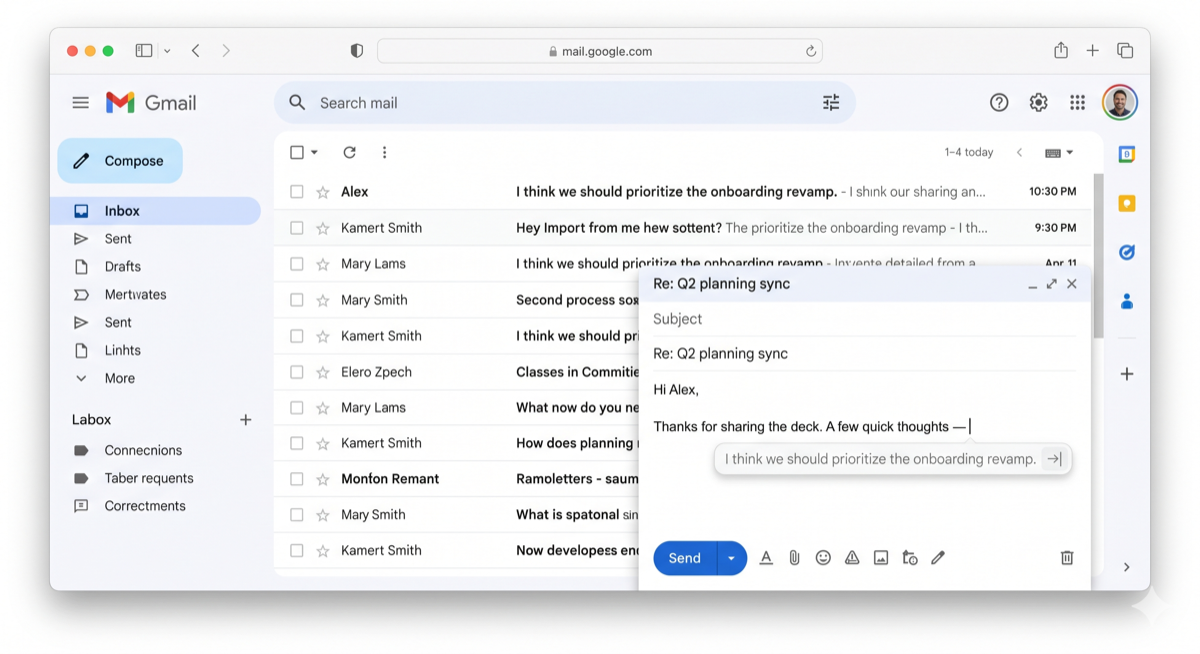
Rédaction d'une réponse dans Gmail
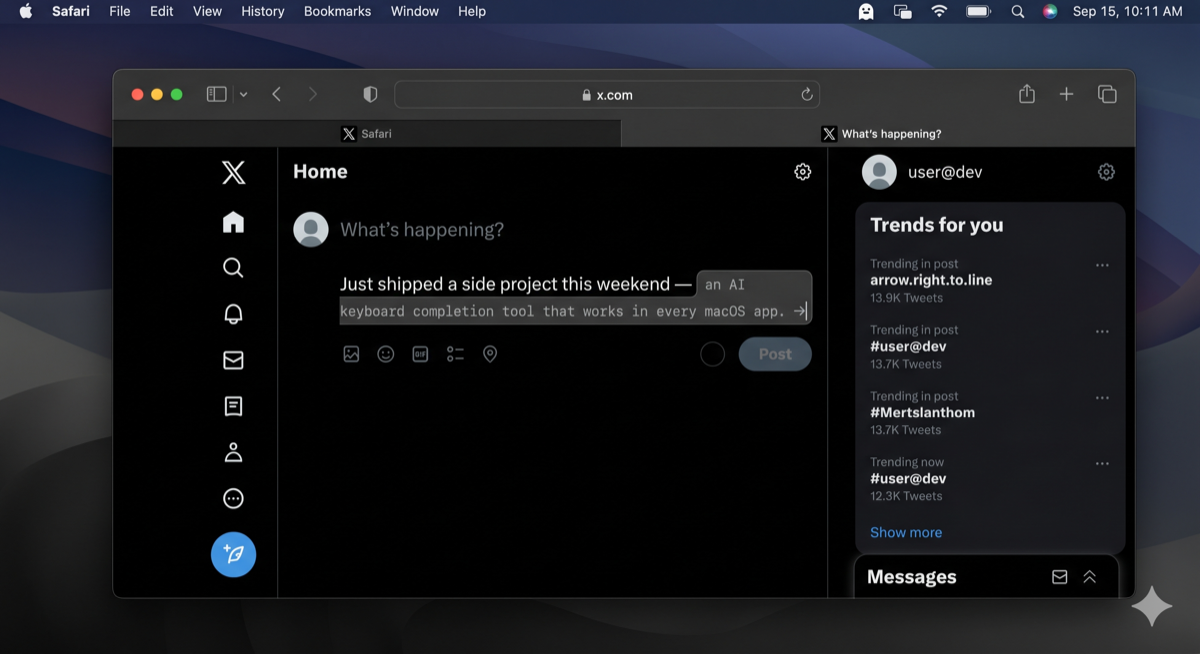
Rédaction d'un message sur X
Deux façons de le faire tourner
C'est le point que ratent la plupart des applications d'IA locale sur Mac. Elles embarquent un modèle et, si vous en faites déjà tourner un, vous vous retrouvez avec deux copies des mêmes poids en mémoire. GhostType vous laisse choisir.
| Intégré | Serveur externe | |
|---|---|---|
| Mise en place | Téléchargez un modèle depuis les Réglages. Rien d'autre à installer. | Indiquez à GhostType l'adresse du serveur que vous utilisez déjà. |
| Ce qui tourne | llama-server, fourni dans l'application |
LM Studio, Ollama, llama.cpp, vLLM, LocalAI |
| Modèle en mémoire | Une copie, chargée par GhostType | Aucune copie supplémentaire. Réutilise ce qui est déjà chargé. |
| Convient à | « Je veux juste que ça marche. » | « J'ai déjà un modèle 32B qui tourne, utilise celui-là. » |
Les deux chemins aboutissent au même point d'accès HTTP compatible OpenAI : ce ne sont pas deux produits différents assemblés à la va-vite. La seule différence est de savoir qui gère le processus serveur.
Si votre serveur externe se trouve être llama-server, GhostType le détecte automatiquement et emprunte le même chemin de suggestion de haute qualité que le moteur intégré. Voir Qualité des suggestions pour ce que cela implique.
Installation
Téléchargez le dernier .dmg depuis la page Releases, ouvrez-le et faites glisser GhostType dans Applications.
L'autoriser au premier lancement
GhostType n'est pas notarisé. La notarisation exige un compte Apple Developer payant, que ce projet n'a pas, donc macOS bloque le premier lancement et vous demande d'autoriser l'application à la main. C'est une étape unique.
- Ouvrez GhostType. macOS refuse et indique qu'il ne peut pas vérifier le développeur.
- Ouvrez Réglages Système > Confidentialité et sécurité et descendez jusqu'à Sécurité.
- À côté du message signalant que GhostType a été bloqué, cliquez sur Ouvrir quand même, puis sur Ouvrir pour confirmer.
Sur macOS 15 Sequoia et versions ultérieures, faire Contrôle-clic sur l'application et choisir Ouvrir ne fonctionne plus. Apple a supprimé ce raccourci : les Réglages Système sont le seul chemin.
Les mises à jour que GhostType installe ensuite lui-même ne repassent pas par là. Ce contrôle s'applique au premier lancement d'une application téléchargée, pas à une application mise à jour sur place.
Pour éviter tout cela, compilez-le vous-même. Une application que vous avez compilée n'a jamais été téléchargée : elle ne porte aucun indicateur de quarantaine et se lance sans la moindre alerte.
Configuration
Étape 1 : choisir un moteur
Le guide de configuration s'ouvre au premier lancement. Choisissez Intégré et téléchargez un modèle, ou choisissez Serveur externe et saisissez son adresse.
Modèles intégrés. Pour la rédaction, ce sont des modèles de base et non des modèles ajustés pour la conversation : demandez à un modèle de chat de finir une phrase et il aura tendance à y répondre plutôt qu'à la poursuivre.
| Modèle | Taille | Pour | Remarques |
|---|---|---|---|
| Qwen3.5 0.8B Base | ~0,6 Go | Rédaction | Le plus rapide. Convient aux Mac de 8 Go. |
| Qwen3.5 2B Base | ~1,3 Go | Rédaction | Recommandé. Meilleur équilibre latence/qualité. |
| Qwen3.5 4B Base | ~2,7 Go | Rédaction | Qualité maximale. Demande 16 Go ou plus. |
| Qwen2.5-Coder 0.5B | ~0,5 Go | Code | Léger, pour le code et l'écriture technique. |
| Qwen2.5-Coder 1.5B | ~1,6 Go | Code | Plus fort sur le code, plus faible en prose courante. |
Les modèles sont téléchargés dans ~/Library/Application Support/GhostType/models et ne quittent jamais votre Mac.
Étape 2 : accorder deux autorisations
Les deux sont nécessaires :
- Surveillance de la saisie pour détecter que vous avez cessé de taper
- Accessibilité pour lire le texte autour du curseur et insérer ce que vous acceptez
Activez GhostType dans Réglages Système > Confidentialité et sécurité pour chacune. L'icône de la barre des menus vous indique laquelle manque encore.
Étape 3 : tapez quelque chose
Ouvrez TextEdit, écrivez une demi-phrase et attendez. Du texte gris apparaît. Appuyez sur Tab.
Qualité des suggestions
Deux choses font la différence entre une suggestion que vous acceptez et une que vous supprimez.
Remplissage au milieu (fill-in-the-middle). La plupart des outils d'autocomplétion n'envoient au modèle que le texte situé avant le curseur. Ce modèle ignore que la phrase se poursuit déjà après vous, et il écrit donc une seconde fin par-dessus celle qui existe. GhostType envoie le texte des deux côtés via le point d'accès /infill de llama.cpp : la suggestion se glisse à l'intérieur de votre phrase au lieu d'en dupliquer la fin.
Génération sous contrainte. À un modèle chargé de compléter une phrase, il arrive de répondre par un bloc de code, une reformulation entre guillemets ou trois paragraphes d'explication. Nettoyer cela après coup relève de la devinette. GhostType compile plutôt une grammaire GBNF et la transmet à l'échantillonneur, ce qui rend ces jetons inatteignables dès le départ. Le modèle ne passe pas de temps à générer du texte destiné à être jeté.
| Réglage | Grammaire | À utiliser pour |
|---|---|---|
| Une seule ligne | Bloque les retours à la ligne et les blocs de code en tête | Courriel, messagerie, champs de navigateur (par défaut) |
| Jusqu'à quelques lignes | Autorise jusqu'à 4 lignes | Éditeurs, notes, champs multilignes |
| Sans contrainte | Aucune | Un modèle se comporte mal sous contrainte |
Ces deux fonctions exigent un serveur qui parle l'API de llama.cpp. C'est toujours le cas du moteur intégré, et c'est vrai aussi d'un llama-server externe. Face à un serveur simplement compatible OpenAI, GhostType se rabat sur les chat completions avec un marqueur de curseur : cela fonctionne encore, mais nettement plus grossièrement.
Raccourcis clavier
| Touche | Action |
|---|---|
Tab |
Accepter la suggestion |
Esc |
Rejeter la suggestion |
Cmd + Option + \ |
Déclencher une suggestion manuellement |
Cmd + Shift + G |
Activer ou désactiver GhostType |
Tous les raccourcis sont personnalisables dans les Réglages.
Compatibilité applicative
| Type d'application | Déclenchement automatique | Pourquoi |
|---|---|---|
| TextEdit, Notes, Pages | Oui | Prise en charge complète de l'API d'accessibilité |
| Champs web de Safari et Chrome | Oui | Repli sur le tampon de frappe |
| Mail, Slack, Discord | Manuel uniquement | Le déclenchement automatique entre en conflit avec leur gestion de la saisie |
| IDE, terminaux | Désactivé | Ils ont déjà leur propre complétion |
Le déclenchement automatique se met aussi en pause pendant qu'une méthode de saisie non ASCII (japonais, chinois, coréen) est en cours de composition, afin de ne jamais s'immiscer au milieu d'une conversion.
Ce qu'il ne fait pas
- Aucune inférence dans le cloud. Il n'y a pas de champ pour une clé d'API, parce qu'il n'y a aucune API à appeler.
- Aucune télémétrie, aucune analyse, aucun enregistrement de la frappe.
- Aucun compte, aucun abonnement, aucune limite d'usage.
- Il ne réécrit pas, ne traduit pas et ne restructure pas votre texte. Il termine la phrase que vous avez commencée.
Configuration requise
| Minimum | Recommandé | |
|---|---|---|
| macOS | 14.0 Sonoma | 15.0 Sequoia |
| Puce | Apple M1 | Apple M2 Pro ou mieux |
| Mémoire | 8 Go | 16 Go ou plus |
| Stockage | 1 Go plus le modèle | 5 Go |
Confidentialité
Chaque suggestion est générée sur votre Mac. Le moteur intégré dialogue avec un processus llama-server sur 127.0.0.1 ; le moteur externe dialogue avec l'adresse de bouclage que vous avez configurée. GhostType n'émet aucune autre requête réseau, hormis la vérification de ses propres mises à jour.
Dépannage
L'interrupteur est activé dans les Réglages Système, mais GhostType dit que l'autorisation manque. Cela touche toute personne qui met à jour depuis la 0.3.1 ou une version antérieure. macOS rattache chaque autorisation d'accessibilité à la signature de code de l'application qui l'a reçue, et toutes les versions jusqu'à la 0.3.1 étaient signées avec une empreinte de la compilation elle-même, qui changeait à chaque version. La 1.0.0 utilise un certificat stable, donc cela s'arrête ici, mais votre Mac conserve encore l'ancienne règle. Basculer l'interrupteur met à jour l'autorisation sans réécrire la règle qui lui est attachée : l'application continue d'être refusée alors que l'interrupteur paraît activé.
Éteindre puis rallumer l'interrupteur n'y change rien, et retirer GhostType de la liste avec le bouton moins non plus. Il faut supprimer l'entrée enregistrée :
sudo tccutil reset Accessibility com.ghosttype.app
sudo tccutil reset ListenEvent com.ghosttype.app
sudo killall tccd
Relancez ensuite GhostType et autorisez-le quand il le demande. Une fois suffit. Pour savoir si vous êtes dans ce cas, cherchez Failed to match existing code requirement ici :
log show --last 5m --predicate 'process == "tccd"' | grep -i ghosttype
Aucune suggestion n'apparaît dans les autres applications.
Regardez l'état dans la barre des menus. S'il indique qu'il faut accorder l'Accessibilité ou la Surveillance de la saisie, ouvrez le volet correspondant dans les Réglages Système et activez GhostType. Il redémarre tout seul en quelques secondes. Compiler depuis les sources resigne l'application et, si vous compilez sans identité de signature, la signature change à chaque fois : macOS redemande donc l'Accessibilité après chaque compilation. Exécutez scripts/make-signing-cert.sh une fois et compilez avec GHOSTTYPE_SIGN_IDENTITY défini pour conserver l'autorisation d'une compilation à l'autre.
Ça marche dans le champ de test des Réglages mais nulle part ailleurs. C'est précisément l'autorisation d'Accessibilité. Le champ de test se trouve à l'intérieur de GhostType et n'a donc besoin d'aucune autorisation système.
L'état affiche « Ready » mais aucun texte gris n'apparaît. Vérifiez qu'un modèle est téléchargé (intégré) ou que le serveur tourne (externe). Essayez le raccourci manuel. Vérifiez si l'application figure dans la liste des applications exclues.
Le moteur intégré signale que les binaires llama.cpp sont absents.
Vous utilisez une compilation faite sans eux. Exécutez scripts/fetch-llama.sh puis recompilez, ou passez à un serveur externe.
Compiler depuis les sources
git clone https://github.com/mk668a/GhostType.git
cd GhostType
open GhostType.xcodeproj
La compilation récupère les binaires llama.cpp épinglés lors de son premier passage et les installe dans le bundle de l'application : il n'y a donc pas d'étape de préparation séparée. Pour les récupérer à la main, ou pour compiler pour Intel :
./scripts/fetch-llama.sh                 # host architecture
LLAMA_ARCH=x64 ./scripts/fetch-llama.sh  # Intel
GHOSTTYPE_SKIP_LLAMA=1 xcodebuild ...    # skip, external backend only
Autres scripts :
./scripts/create-dmg.sh   # build the DMG installer
./scripts/install.sh      # build and install into /Applications
Nécessite Xcode et les Command Line Tools (xcode-select --install).
Architecture
GhostType/
├── App/
│   ├── GhostTypeApp.swift          # Entry point, AppSettings, backend enum
│   ├── AppDelegate.swift           # Menu bar, lifecycle, server teardown
│   ├── SettingsView.swift          # Preferences and setup guide
│   └── MenuBarView.swift           # Status menu
├── Core/
│   ├── AccessibilityManager.swift  # AX text read/write, permissions
│   ├── GlobalKeyMonitor.swift      # CGEventTap keystroke monitoring
│   ├── InputSourceMonitor.swift    # IME state, pauses auto-trigger
│   ├── CompletionController.swift  # Debounce, ghost text lifecycle
│   └── CompletionEngine.swift      # Backend selection, circuit breaker
├── LLM/
│   ├── LLMProvider.swift           # HTTP client, /infill and chat paths
│   ├── BundledLlamaServer.swift    # Supervises the bundled llama-server
│   ├── ModelCatalog.swift          # Downloadable models, on-disk layout
│   ├── ModelDownloader.swift       # Resumable downloads with progress
│   └── CompletionGrammar.swift     # GBNF construction
└── UI/
    ├── OverlayWindow.swift         # Ghost text overlay window
    └── CompletionPopup.swift       # Multi-suggestion popup
Remerciements
L'inférence repose sur llama.cpp (MIT). Les modèles de rédaction sont des conversions GGUF de Qwen3.5 Base réalisées par mradermacher, et les modèles de code sont les conversions de Qwen2.5-Coder réalisées par ggml-org. Les deux familles de modèles sont sous Apache-2.0.
Licence
MIT. Utilisez-le, forkez-le, vendez-le. Sans contrepartie.
GhostType Type less. Think more.