
loomax-labs/InferrLM
loomax-labs/InferrLM has 115 GitHub stars and 24 forks. GitHot measured +1 stars in 24 hours and +1 in 7 days. Last checked 2026-11-15 15:53 UTC. Last push 2026-09-26.
Progression mesurée des étoiles
- in 24h
- +1
- in 7 days
- +1
- in 15 days
- Mise à jour retardée
- in 1 month
- Mise à jour retardée
Variations nettes sur des périodes qui se chevauchent, pas des totaux quotidiens. Les mesures absentes restent vides. Les étoiles indiquent l’intérêt, pas la qualité.
À propos
InferrLM - On-device AI for iOS & Android
IAREADME.fr.md
OriginalEnglish | 简体中文 | 繁體中文 | 日本語 | 한국어 | Deutsch | Français | Nederlands
InferrLM (avant Inferra)


InferrLM est une application qui met de grands et de petits modèles directement sur ton téléphone Android ou iOS. Ton téléphone peut aussi servir de serveur sur ton réseau local. Les modèles cloud comme Claude, Gemini et ChatGPT sont pris en charge. Pour les modèles sur le téléphone, tu peux joindre des fichiers, avec RAG (l'app cherche les passages utiles dans tes fichiers, puis le modèle répond avec).


Sommaire
- Démo
- Fonctions
- REST API
- Ligne de commande
- Licence
- Contribuer
- Technique
- Remerciements
- Historique des étoiles
Démo
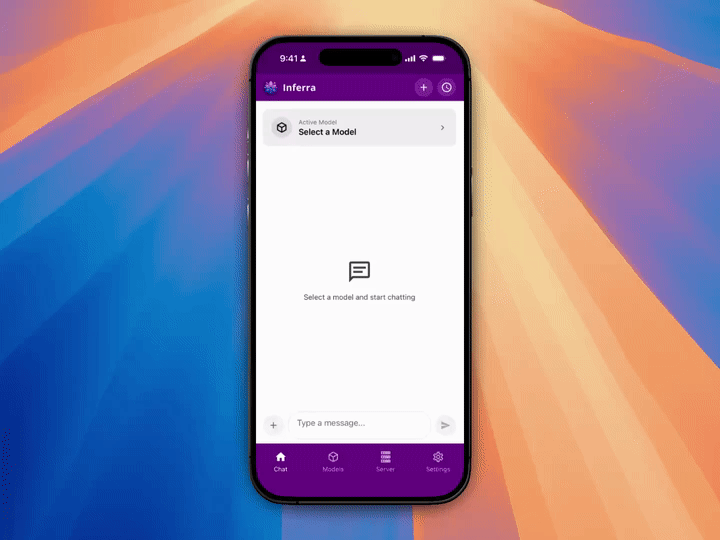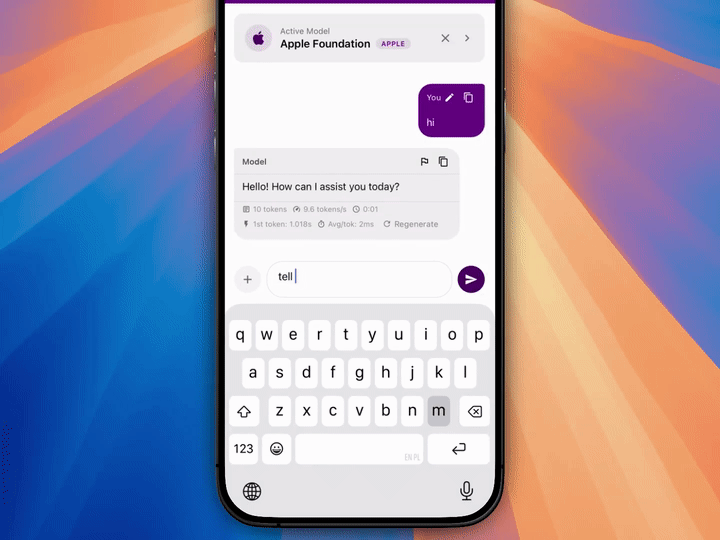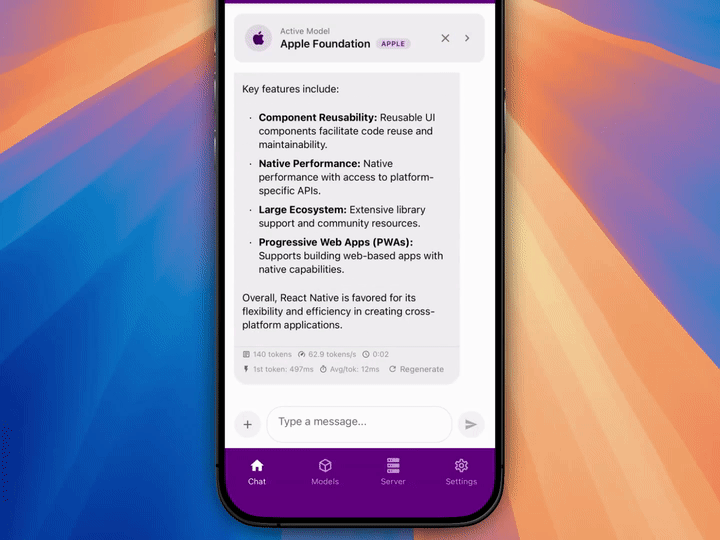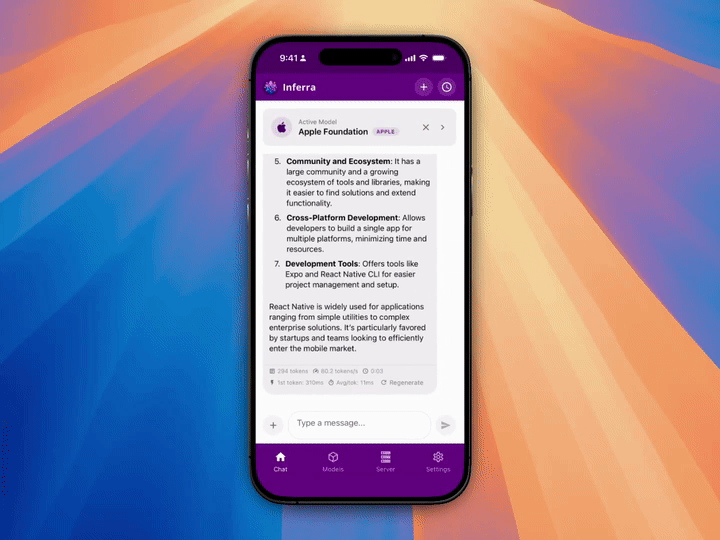
Les démos montrent l'Apple Foundation Model, et le téléchargement de modèles MLX depuis HuggingFace pour les faire tourner sur l'appareil.
Fonctions
Sur ce téléphone
- Exécution locale avec llama.cpp et des modèles GGUF sur Android et iOS.
- Exécution MLX locale sur les appareils Apple Silicon.
- Connexion aux modèles cloud d'OpenAI, Gemini et Anthropic. Pour les modèles distants, il te faut tes propres clés d'API et un compte InferrLM. Les modèles distants restent facultatifs.
- Tu peux changer l'adresse de base des services compatibles OpenAI, comme OpenRouter, Groq, Ollama, LM Studio et Together AI. Tu accèdes ainsi à d'autres points d'accès dans l'app.
- Prise en charge du modèle Apple Foundation sur les appareils avec Apple Intelligence.
Images et texte
- Les modèles qui lisent le texte et les images peuvent voir des photos avec le fichier projecteur (mmproj) qui va avec. Plus de détails ici.
- L'appareil photo intégré prend des photos dans l'app et les envoie aux modèles.
Documents et RAG
- RAG aide le modèle à mieux lire tes documents et à répondre avec le bon passage.
- Tu peux joindre des fichiers. L'extracteur lit le texte en local, page par page, par OCR, puis l'envoie au modèle sur le téléphone.
- Les documents sont traités et indexés pour les retrouver plus vite pendant la discussion.
- Les modèles distants acceptent aussi l'envoi direct de fichiers.
Serveur local
- Un serveur HTTP intégré expose des API REST pour que les appareils du même réseau accèdent à tes modèles. Tu le démarres dans l'onglet Serveur. Une URL partage l'interface de discussion InferrLM avec un ordinateur, une tablette ou un autre téléphone.
- La documentation complète de l'API est ici et sur la page d'accueil du serveur.
- Un outil en ligne de commande sur github.com/sbhjt-gr/InferrLM-CLI montre comment construire des applications avec cette API.
Gestion des modèles
- Le téléchargement récupère les modèles directement depuis HuggingFace. Une liste choisie pour les téléphones est dans Modèles, onglet « Télécharger des modèles ».
- Les modèles téléchargés apparaissent dans le sélecteur du chat et dans l'onglet « Modèles enregistrés ».
- Tu peux importer depuis le stockage du téléphone ou télécharger depuis une URL.
Discussion
- Tu peux modifier un message, le régénérer, le copier, et l'afficher en Markdown.
- Affichage Markdown rapide, avec les formules, grâce à
react-native-nitro-markdown, un moteur C++ sur le pont Nitro Modules. - Chaque bulle peut ouvrir une branche. Le fil d'origine reste, tu peux essayer une autre direction.
- Le code produit par le modèle s'affiche dans des blocs, avec copie dans le presse-papiers.
- Tu peux gérer l'historique et épingler des conversations.
Si tu veux contribuer ou lancer l'app en local, suis le guide ci-dessous. Tes modifications doivent respecter la LICENSE.
Prérequis
- Node.js (>= 16.0.0, < 23.0.0)
- npm ou yarn
- Expo CLI
- Android Studio (pour Android)
- Xcode (pour iOS)
Installation
Cloner le dépôt
git clone https://github.com/sbhjt-gr/InferrLM
cd InferrLM
Installer les dépendances
yarn installRégler les variables d'environnement Indique tes clés d'API et les réglages du backend. La liste est dans app.config.json.
Lancer sur un appareil ou un émulateur
# For Android
npx expo run:android

# For iOS
npx expo run:ios
REST API
InferrLM inclut un serveur HTTP qui expose les modèles avec l'API OpenAI. Les appareils du même réseau peuvent ainsi utiliser les modèles de ton téléphone. Tu peux relier InferrLM à d'autres applications, scripts ou services.
Démarrer le serveur
- Ouvre l'application InferrLM
- Va dans l'onglet Serveur
- Active l'interrupteur du serveur
- L'adresse du serveur s'affiche (en général
http://YOUR_DEVICE_IP:8889)
Ligne de commande
InferrLM-CLI est un client de terminal. Il se connecte à ton serveur InferrLM et discute depuis la ligne de commande. C'est un outil, et aussi un exemple pour les développeurs qui veulent utiliser l'API REST.
La CLI est faite avec React et Ink : réponses au fil de l'eau, historique, et une mise en route interactive. Le code et l'installation sont sur github.com/sbhjt-gr/InferrLM-CLI.
Pour commencer, lance le serveur InferrLM sur ton téléphone, installe l'outil, puis suis les instructions de son dépôt.
Documentation de l'API
Une fois le serveur lancé, ouvre son adresse dans un navigateur. La documentation comprend :
- les points d'accès de discussion et de complétion
- la gestion des modèles
- les API RAG et d'embeddings
- la configuration et l'état du serveur
Le détail est dans la documentation REST API.
Licence
Ce projet est distribué sous la licence AGPL-3.0. Lis-la ici. Toute modification doit suivre les règles de cette LICENSE.
Contribuer
Les contributions sont les bienvenues. Tu trouves des sujets dans l'onglet issues, ou tu en ouvres de nouveaux et tu commences.
Lis le guide de contribution pour le déroulement, les règles de code et les usages.
Technique
- Cadre : React Native 0.81 avec Expo 54 (nouvelle architecture)
- Langage de l'app : TypeScript, JavaScript
- Modules natifs iOS : Swift
- Modules natifs Android : Kotlin
- Moteur : C, C++
- Navigation : React Navigation
- Base de données : OP-SQLite, Expo SQLite
Remerciements
- llama.cpp - Le moteur qui fait tourner les modèles GGUF locaux sur Android et iOS.
- mlx-swift-lm - Bibliothèque Swift pour les modèles MLX sur Apple Silicon. Elle alimente le backend MLX sur iOS.
- inferrlm-llama.rn - L'adaptateur React Native ajusté pour llama.cpp. Fork de llama.rn, pour mettre llama.cpp à jour plus souvent.
- @inferrlm/react-native-mlx - Moteur MLX Apple Silicon pour iOS, via le pont Nitro Modules. Fork maintenu de react-native-nitro-mlx.
- react-native-nitro-markdown - Moteur Markdown C++ natif pour React Native, pour afficher vite les messages.
- react-native-rag + @langchain/textsplitters - RAG pour React Native. Il retrouve et prépare les documents avec LangChain.
- react-native-ai - L'adaptateur qui ouvre le modèle Apple Foundation via son API Swift.
- Si tu penses que ton nom devrait aussi figurer ici, dis-le.
Historique des étoiles
Ajoute une étoile au dépôt si tu le trouves utile.