
linogaliana/python-datascientist
linogaliana/python-datascientist has 187 GitHub stars and 59 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-20 08:04 UTC. Last push 2026-11-07.
Progression mesurée des étoiles
- in 24h
- 0
- in 7 days
- 0
- in 15 days
- Historique en cours
- in 1 month
- Historique en cours
Variations nettes sur des périodes qui se chevauchent, pas des totaux quotidiens. Les mesures absentes restent vides. Les étoiles indiquent l’intérêt, pas la qualité.
À propos
Dépôt associé au cours Python pour data scientists (ENSAE 2e année)
Apprentissage automatiquedoc/README-fr.md
OriginalData Science avec Python 


Lino Galiana • Data scientist, Insee (Institut national de la statistique et des études économiques)
Cours enseigné dans deux grandes écoles françaises d’ingénieurs (ENSAE et ENSAI) et disponible en autonomie (self-paced learning).
[!NOTE]
Ceci est la version française 🇫🇷 duREADME. Pour voir la version anglaise 🇬🇧🇺🇸, cliquez ici :

À propos
Ce dépôt 
Python
Il est enseigné en 2e année (Master 1) dans deux écoles d’ingénieurs françaises :
- ENSAE depuis 2021
- ENSAI à partir de 2026
Le support combine explications, exemples et exercices, avec une attention particulière portée à la reproductibilité et à l’usage de jeux de données réels.
L’ensemble des chapitres (notes, exemples et exercices disponibles en notebooks Jupyter) est accessible sur https://pythonds.linogaliana.fr/.
📌 Licence et citation
Ce cours est diffusé sous licence Creative Commons CC BY-NC-SA 
Si vous utilisez ce support, merci de le citer :
Galiana, Lino. 2025. Python pour la data science. https://doi.org/10.5281/zenodo.8229676
@book{galiana2025,
  author = {Galiana, Lino},
  title = {Python pour la data science},
  date = {2025},
  url = {https://pythonds.linogaliana.fr/},
  doi = {10.5281/zenodo.8229676},
  langid = {fr}
}
🎨 Galerie
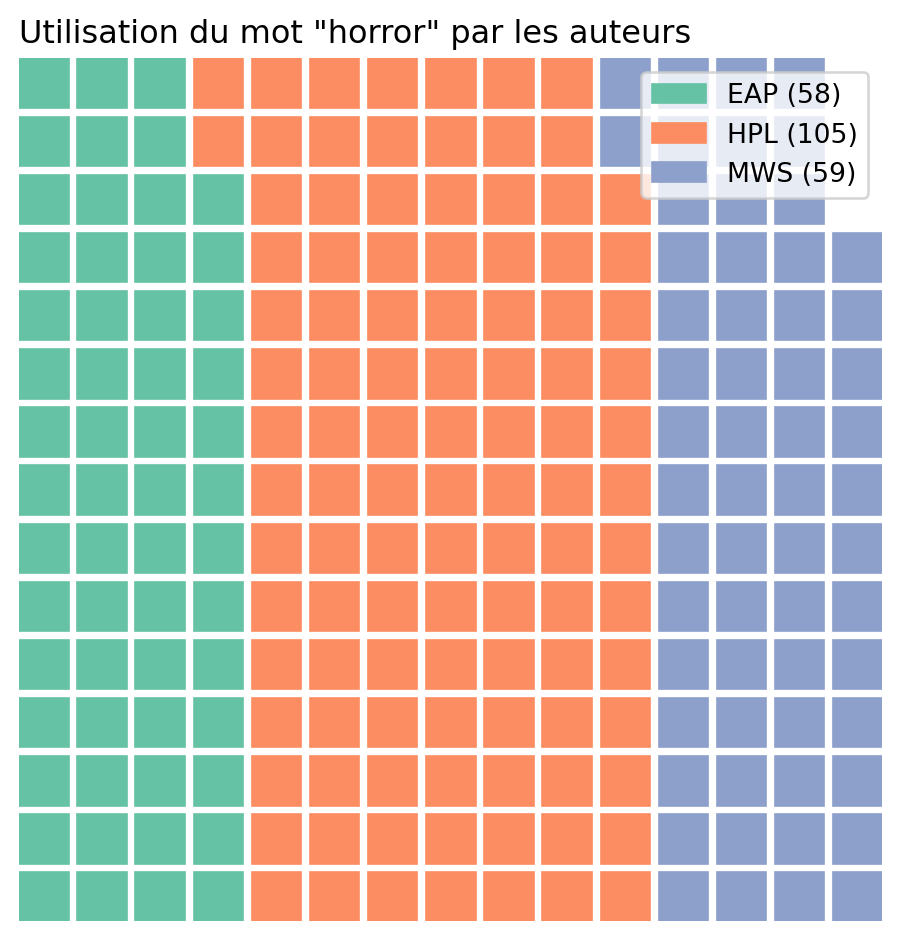
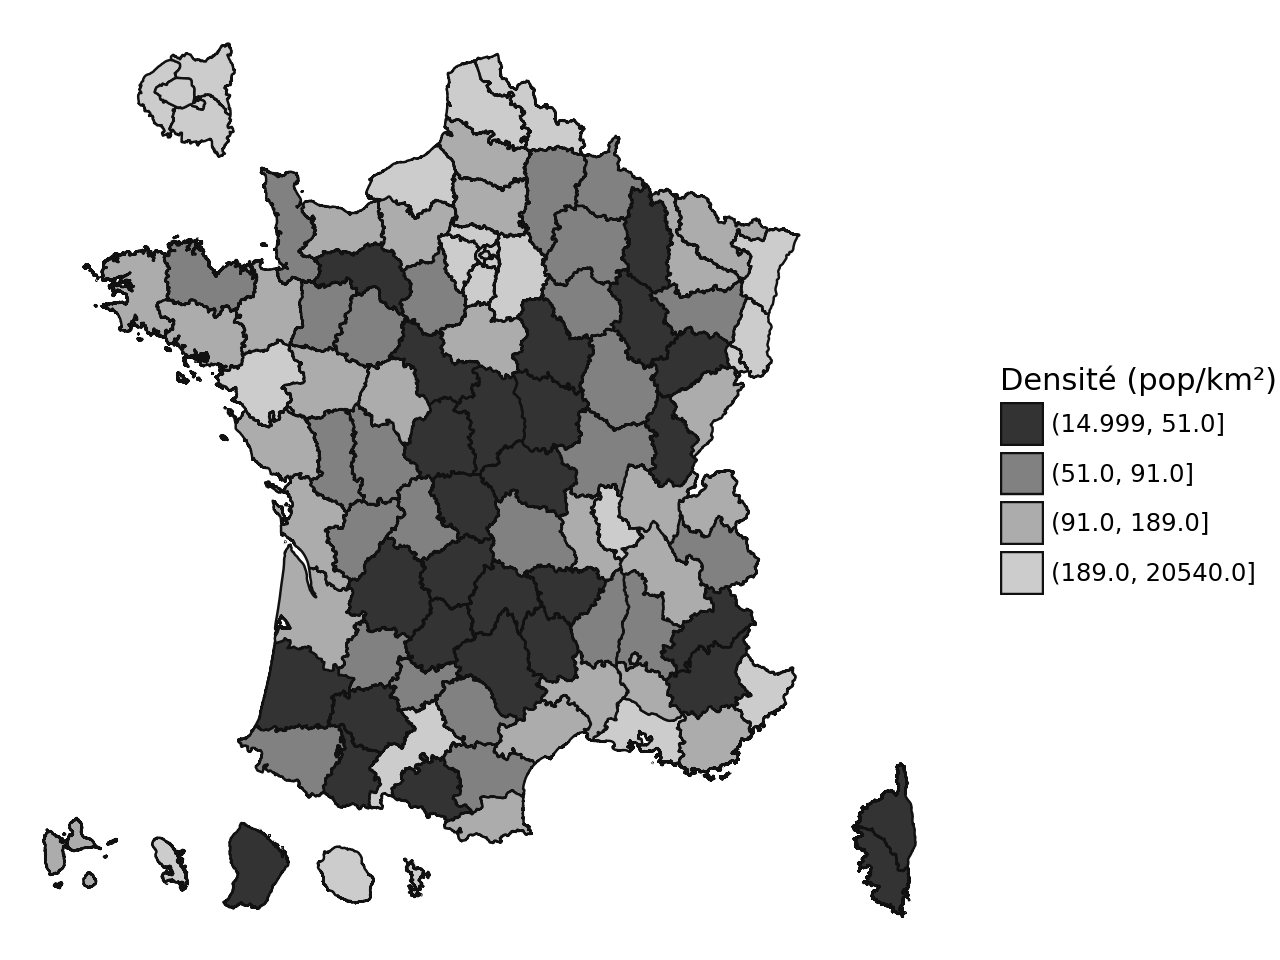
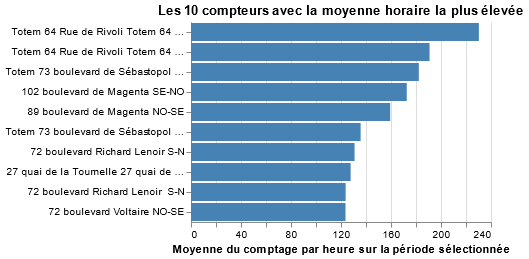
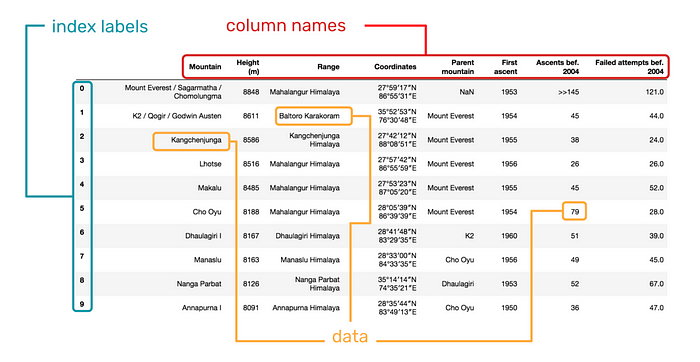
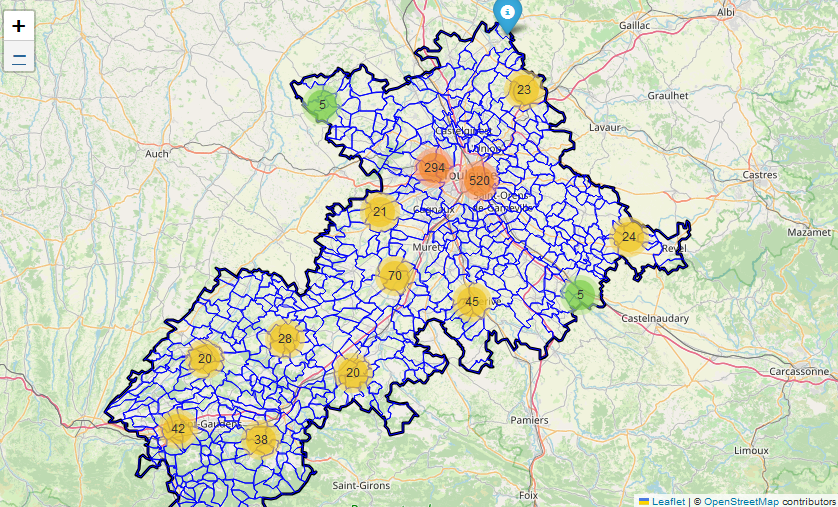
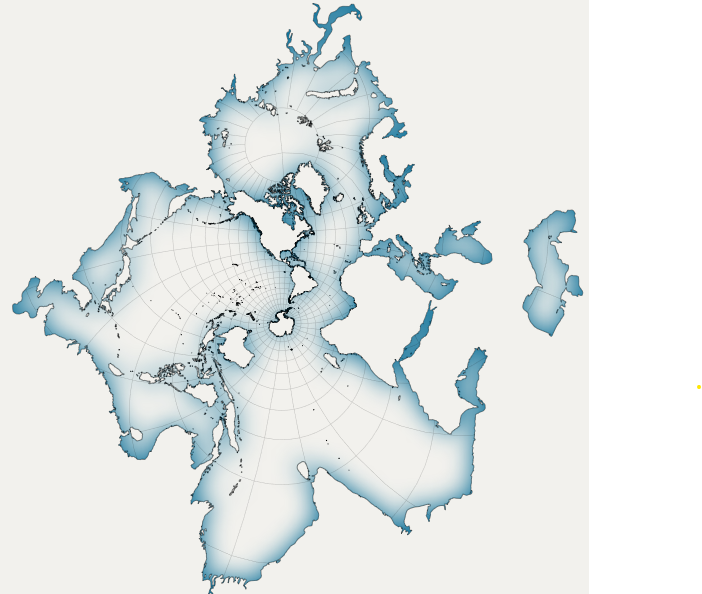
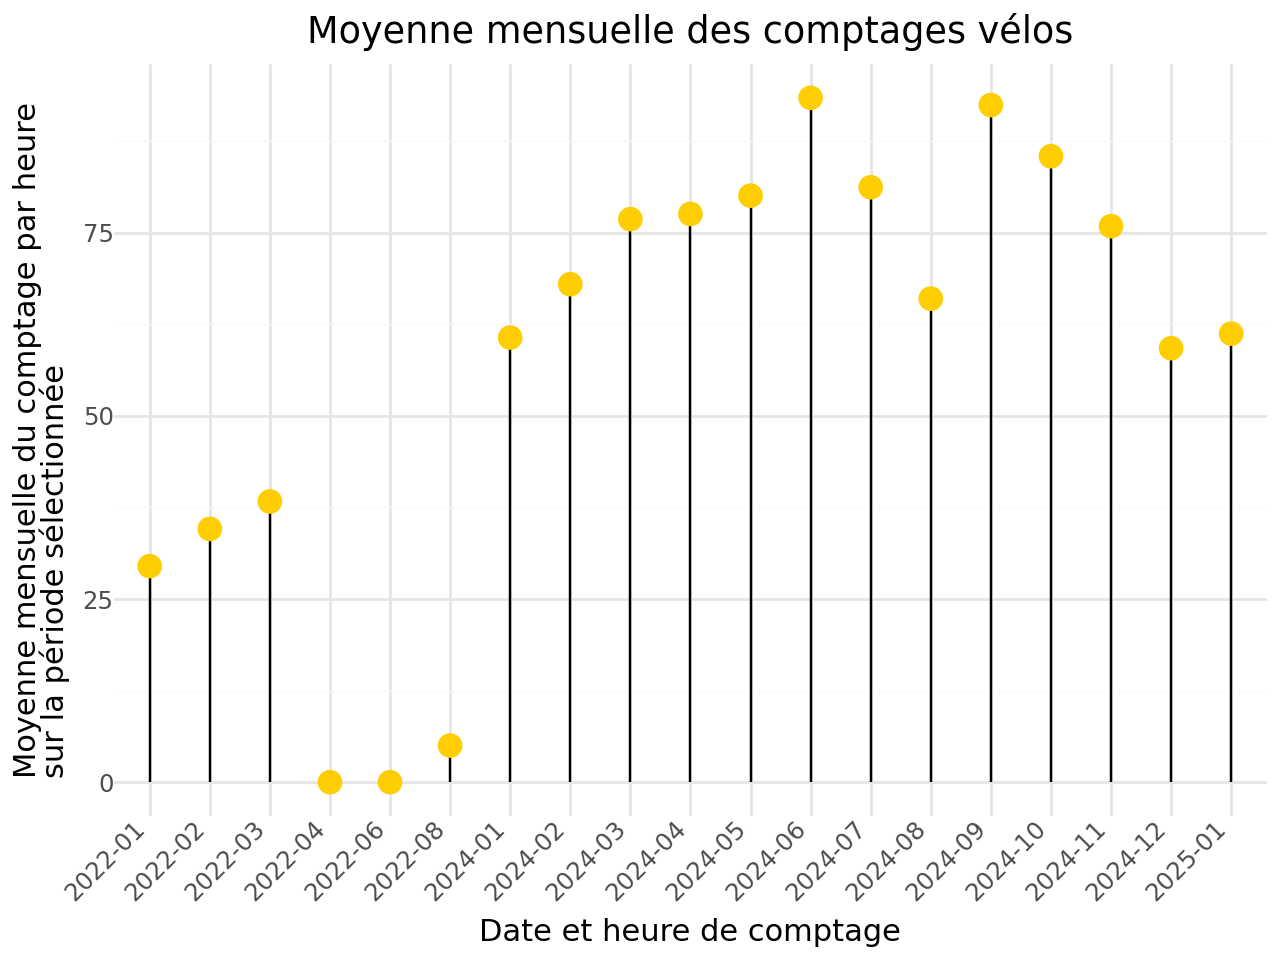
Quelques exemples de figures produites pendant le cours (cliquer pour ouvrir le site du cours) :
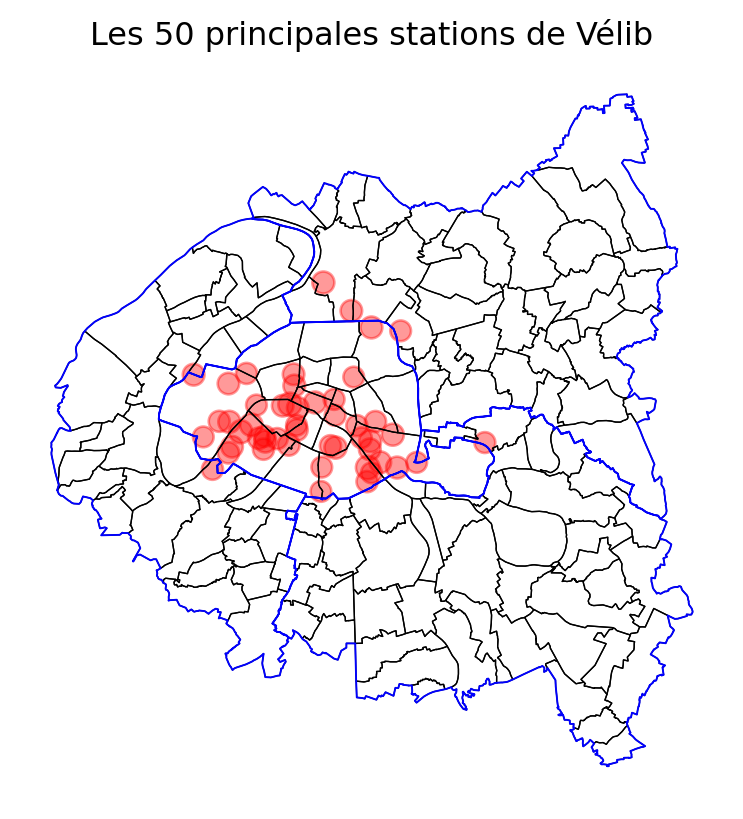
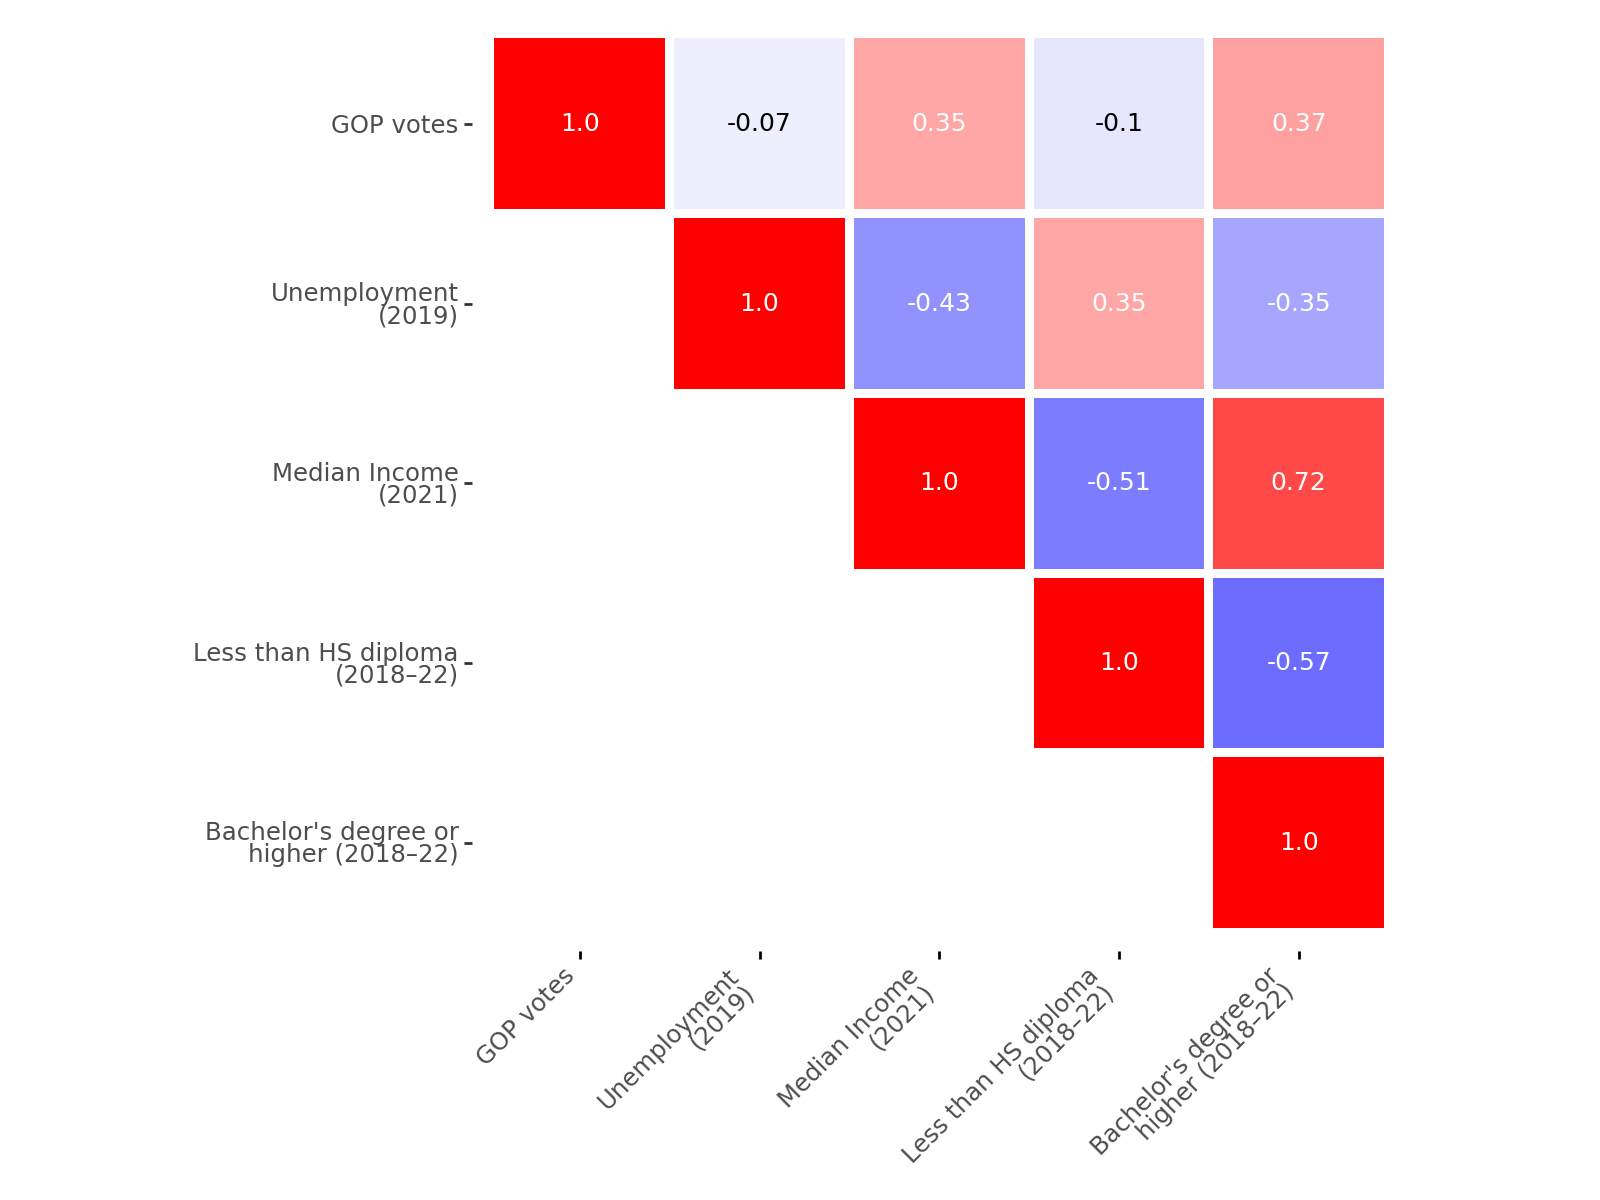
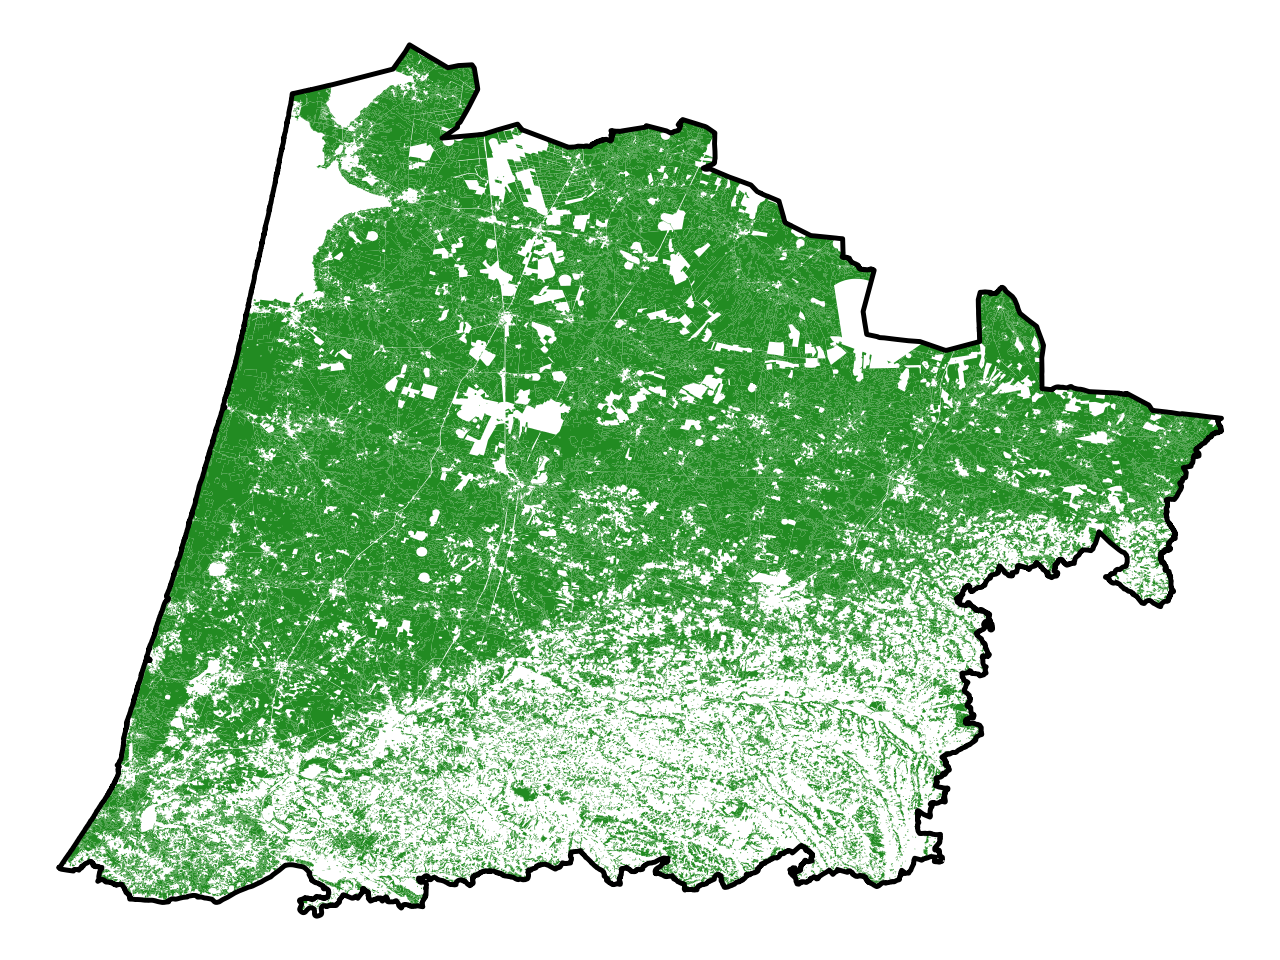
Plus d’exemples
📖 Contenu du cours
Ce cours s’adresse à la fois aux débutants et aux personnes plus avancées.
Le plan ci-dessous est entièrement cliquable et repliable.
1. Bien démarrer : pourquoi Python pour la data science ?
🔗 https://pythonds.linogaliana.fr/fr/content/getting-started/
- Mettre en place un environnement Python fonctionnel pour la data science
- Prendre en main un jeu de données
- Les bases de Python
2. Manipulation des données
🔗 https://pythonds.linogaliana.fr/fr/content/manipulation/
- Numpy, la fondation de la data science
- Introduction à Pandas
- Manipuler des données avec Pandas
- Données spatiales avec GeoPandas
- Webscraping avec Python
- Récupérer des données via des API
- Maîtriser les expressions régulières
- Importer des données depuis Parquet et S3
3. Visualisation et communication
🔗 https://pythonds.linogaliana.fr/fr/content/visualisation/
- Construire des graphiques avec Python
- Introduction à la cartographie
4. Modélisation
🔗 https://pythonds.linogaliana.fr/fr/content/modelisation/
- Pourquoi le prétraitement est crucial
- Évaluer la qualité d’un modèle
- Introduction à la classification
- Introduction à la régression
- Sélection de variables (feature selection)
- Clustering
5. Traitement automatique du langage (NLP)
🔗 https://pythonds.linogaliana.fr/fr/content/nlp/
- Nettoyer et structurer des textes
- Approche sac-de-mots (bag-of-words)
- Plongements de texte (embeddings)
🔗 Ressources
Le contenu du cours s’appuie largement sur des données ouvertes, notamment des jeux de données français (provenant de data.gouv et de l’Insee) ainsi que des jeux de données américains.
Cours complémentaire avec Romain Avouac (@avouacr) :
https://ensae-reproductibilite.github.io/website/
🚀 Accéder au cours en ligne
[!TIP]
Exécutez les exemples instantanément sur SSP Cloud ou Google Colab. Voici un exemple pour le chapitrePandas:

🤝 Contribuer
Les contributions sont les bienvenues !
[!NOTE]
Voir le guide pour les contributeurs :
