
dagster-io/dagster
dagster-io/dagster has 16,386 GitHub stars and 2,410 forks. GitHot measured +4 stars in 24 hours, +17 in 7 days, and +52 in 15 days. Last checked 2026-11-11 04:29 UTC. Last push 2026-11-04.
Comment ces chiffres sont mesurés
Une plateforme d’orchestration pour développer, mettre en production et observer des actifs de données.
Progression mesurée des étoiles
- in 24h
- +4
- in 7 days
- +17
- in 15 days
- +52
- in 1 month
- Mise à jour retardée
Variations nettes sur des périodes qui se chevauchent, pas des totaux quotidiens. Les mesures absentes restent vides. Les étoiles indiquent l’intérêt, pas la qualité.
README.md
Original


Dagster is a cloud-native data pipeline orchestrator for the whole development lifecycle, with integrated lineage and observability, a declarative programming model, and best-in-class testability.
It is designed for developing and maintaining data assets, such as tables, data sets, machine learning models, and reports.
With Dagster, you declare—as Python functions—the data assets that you want to build. Dagster then helps you run your functions at the right time and keep your assets up-to-date.
Here is an example of a graph of three assets defined in Python:
import dagster as dg
import pandas as pd

from sklearn.linear_model import LinearRegression


@dg.asset
def country_populations() -> pd.DataFrame:
    df = pd.read_html("https://tinyurl.com/mry64ebh")[0]
    df.columns = ["country", "pop2022", "pop2023", "change", "continent", "region"]
    df["change"] = df["change"].str.rstrip("%").astype("float")
    return df


@dg.asset
def continent_change_model(country_populations: pd.DataFrame) -> LinearRegression:
    data = country_populations.dropna(subset=["change"])
    return LinearRegression().fit(pd.get_dummies(data[["continent"]]), data["change"])


@dg.asset
def continent_stats(
    country_populations: pd.DataFrame, continent_change_model: LinearRegression
) -> pd.DataFrame:
    result = country_populations.groupby("continent").sum()
    result["pop_change_factor"] = continent_change_model.coef_
    return result
The graph loaded into Dagster's web UI:
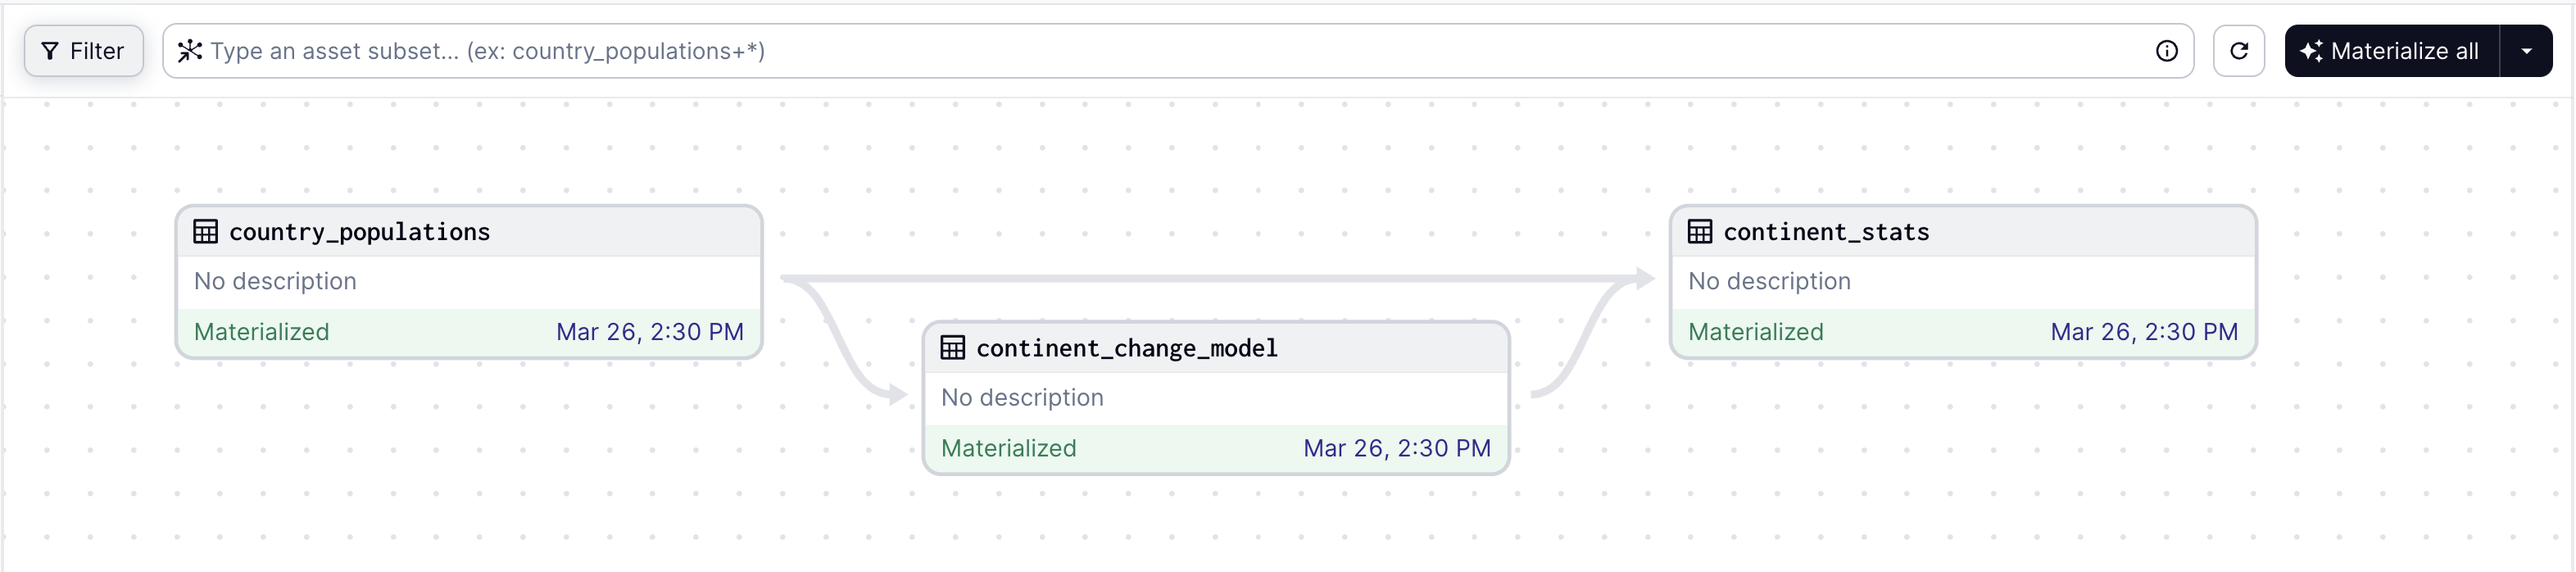
Dagster is built to be used at every stage of the data development lifecycle - local development, unit tests, integration tests, staging environments, all the way up to production.
Quick Start:
If you're new to Dagster, we recommend checking out the docs or following the hands-on tutorial.
Dagster is available on PyPI and officially supports Python 3.9 through Python 3.14.
uv add dagster dagster-webserver dagster-dg-cli
Documentation
You can find the full Dagster documentation here, including the Quickstart guide.
Key Features:

Dagster as a productivity platform
Identify the key assets you need to create using a declarative approach, or you can focus on running basic tasks. Embrace CI/CD best practices from the get-go: build reusable components, spot data quality issues, and flag bugs early.
Dagster as a robust orchestration engine
Put your pipelines into production with a robust multi-tenant, multi-tool engine that scales technically and organizationally.
Dagster as a unified control plane
Maintain control over your data as the complexity scales. Centralize your metadata in one tool with built-in observability, diagnostics, cataloging, and lineage. Spot any issues and identify performance improvement opportunities.
Master the Modern Data Stack with integrations
Dagster provides a growing library of integrations for today’s most popular data tools. Integrate with the tools you already use, and deploy to your infrastructure.
Community
Connect with thousands of other data practitioners building with Dagster. Share knowledge, get help, and contribute to the open-source project. To see featured material and upcoming events, check out our Dagster Community page.
Join our community here:
- 🌟 Star us on GitHub
- 📥 Subscribe to our Newsletter
- 🐦 Follow us on Twitter
- 🕴️ Follow us on LinkedIn
- 📺 Subscribe to our YouTube channel
- 📚 Read our blog posts
- 👋 Join us on Slack
- 🗃 Browse Slack archives
- ✏️ Start a GitHub Discussion
Contributing
For details on contributing or running the project for development, check out our contributing guide.
License
Dagster is Apache 2.0 licensed.
Explorer des projets similaires
Asabeneh/30-Days-Of-Python
Le défi de programmation 30 Days of Python est un guide pas à pas pour apprendre le langage de programmation Python en 30 jours. Ce défi peut prendre plus de 100 jours. Avancez à votre rythme. Ces vidéos peuvent aussi vous aider : https://www.youtube.com/channel/UC7PNRuno1rzYPb1xLa4yktw
78,560 étoilesgrafana/grafana
Plateforme ouverte et composable d’observabilité et de visualisation de données. Visualise les métriques, les journaux et les traces issus de plusieurs sources, comme Prometheus, Loki, Elasticsearch, InfluxDB, Postgres et bien d’autres.
77,830 étoilesredis/redis
Pour les développeurs qui créent des applications en temps réel pilotées par les données, Redis est le cache, le serveur de structures de données et le moteur de requêtes documentaires et vectorielles préféré, le plus rapide et le plus riche en fonctionnalités.
77,395 étoilesapache/superset
Apache Superset est une plateforme de visualisation et d'exploration de données.
75,473 étoiles