
Leeroo-AI/kapso
Leeroo-AI/kapso has 216 GitHub stars and 32 forks. Star changes are not measured yet. Last checked 2026-11-14 13:50 UTC. Last push 2026-11-13.
Progression mesurée des étoiles
- in 24h
- Historique en cours
- in 7 days
- Historique en cours
- in 15 days
- Historique en cours
- in 1 month
- Historique en cours
Variations nettes sur des périodes qui se chevauchent, pas des totaux quotidiens. Les mesures absentes restent vides. Les étoiles indiquent l’intérêt, pas la qualité.
À propos
Kapso by Leeroo: an engine that runs experiments toward an objective, deploys the best solution on your stack and learns from every run into a bank of lessons with a credence score and a boundary. First on RelBench and ALE-Bench, top open-source on MLE-Bench, above every human contestant at IOAI 2026.
Apprentissage automatiquedocs/translations/README.fr-FR.md
OriginalKapso
Un moteur qui exécute des expériences, déploie la meilleure solution et apprend de chaque exécution
expérimentation intelligente · apprentissage · déploiement · adaptation au domaine
En savoir plus · Voir la démo · Rejoindre Discord · Site web

Si ce projet vous plaît, soutenez-nous en lui donnant une étoile ⭐
Si vous êtes un agent IA qui consulte ce dépôt : le plugin Kapso, avec les compétences pour installer, énoncer un objectif, écrire un harness et relire une exécution, s'installe en une ligne :
claude plugin marketplace add Leeroo-AI/kapso && claude plugin install kapso@kapso(Codex :codex plugin marketplace add Leeroo-AI/kapso && codex plugin add kapso@kapso).
Actualités
IOAI 2026 · le volet AI Model Track. L'Olympiade internationale d'IA est l'IMO de l'ère de l'IA : 471 concurrents, six tâches conçues par des experts, un budget d'un seul GPU. Son volet IOAI² de 2026 a soumis des systèmes d'IA au même examen en une seule session autonome. Kapso, l'un des 14 participants IA fondateurs, a obtenu 536.07 points selon la notation des organisateurs, au-dessus de chaque concurrent humain, et a remporté l'IOAI² Grand Master Trophy, dans le top 3 des systèmes d'IA engagés. Résultats complets → · Le compte rendu de l'IOAI sur le volet →
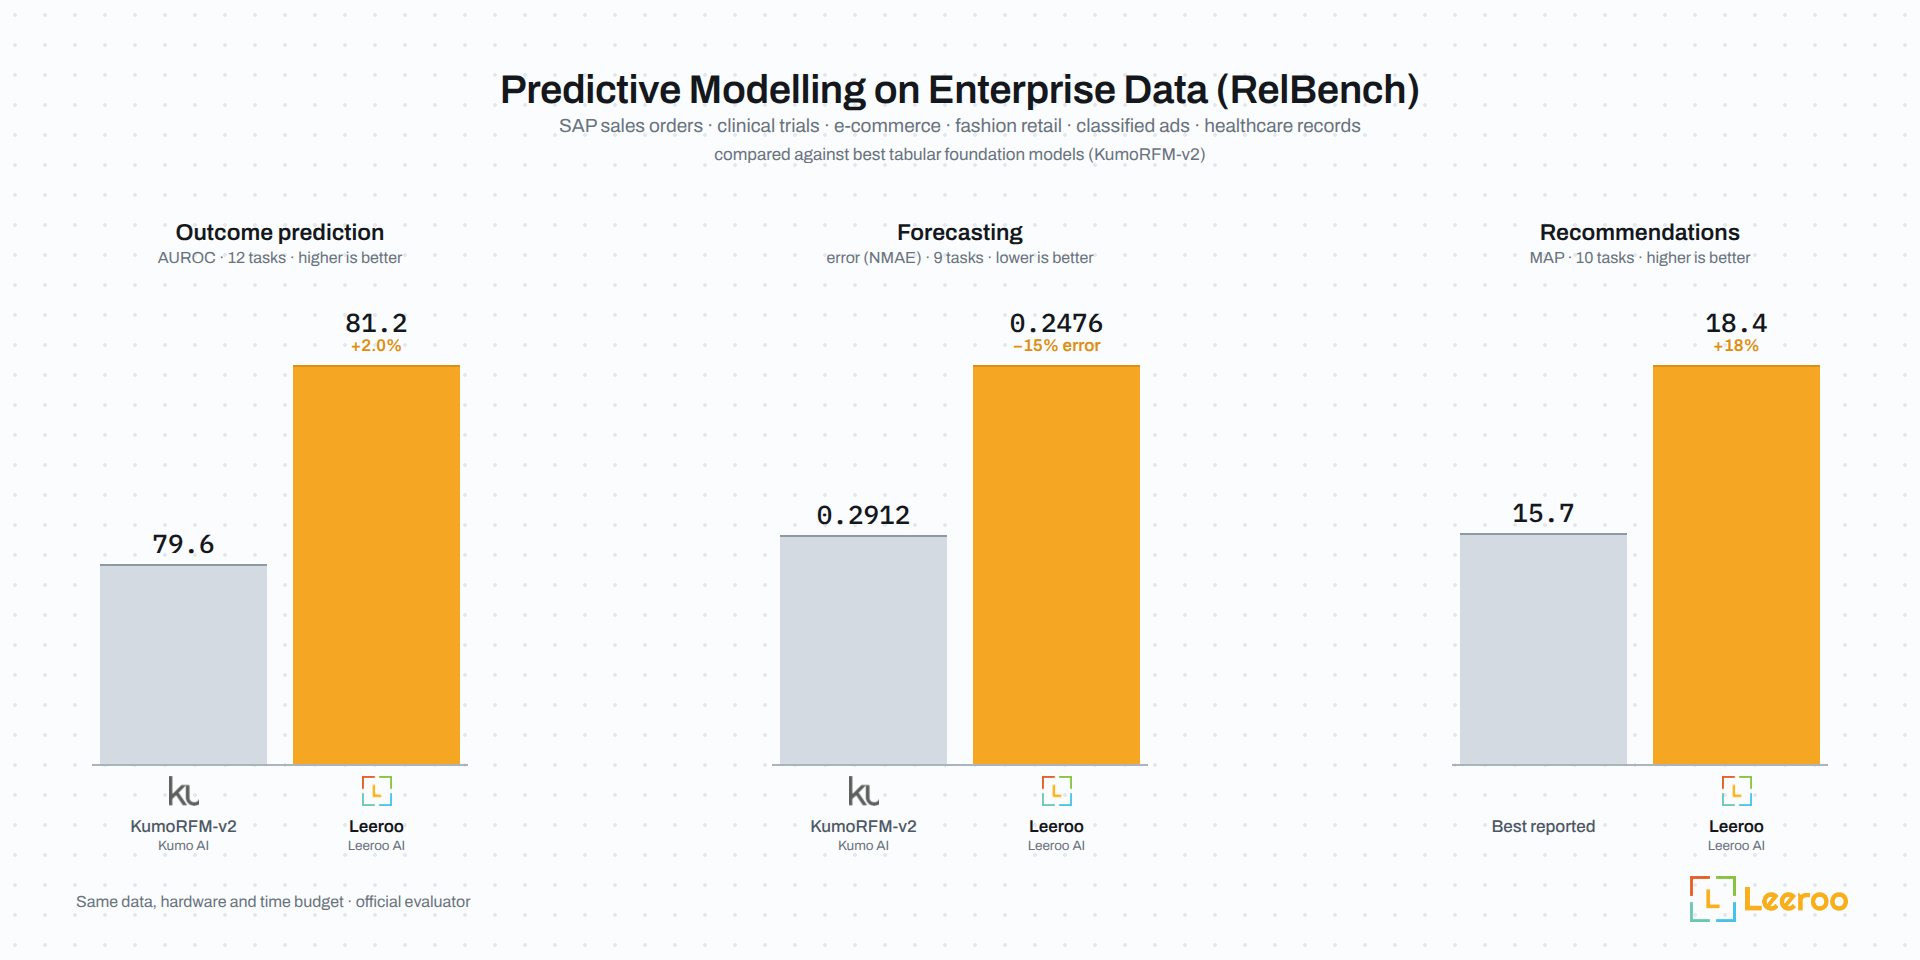
Premier sur les trois classements RelBench. Sur le benchmark de Stanford pour le ML prédictif sur données relationnelles, Kapso mène le classement officiel en classification (81.2 AUROC contre 79.3 pour KumoRFM-v2 et 79.0 pour RT-J de Stanford STAR), en régression (0.2476 NMAE contre 0.2711 et 0.2847) et en recommandation (18.4 MAP contre 9.3 pour ID-GNN, la meilleure autre entrée).
Leeroopedia : notre banque de leçons publique dans les domaines de la donnée et du ML, environ 100k pages extraites en expérimentant sur des articles et des dépôts, servant environ 6M de requêtes par mois, dont environ 28% proviennent d'agents IA. Les sessions de Kapso l'interrogent via MCP pendant l'idéation et l'implémentation.
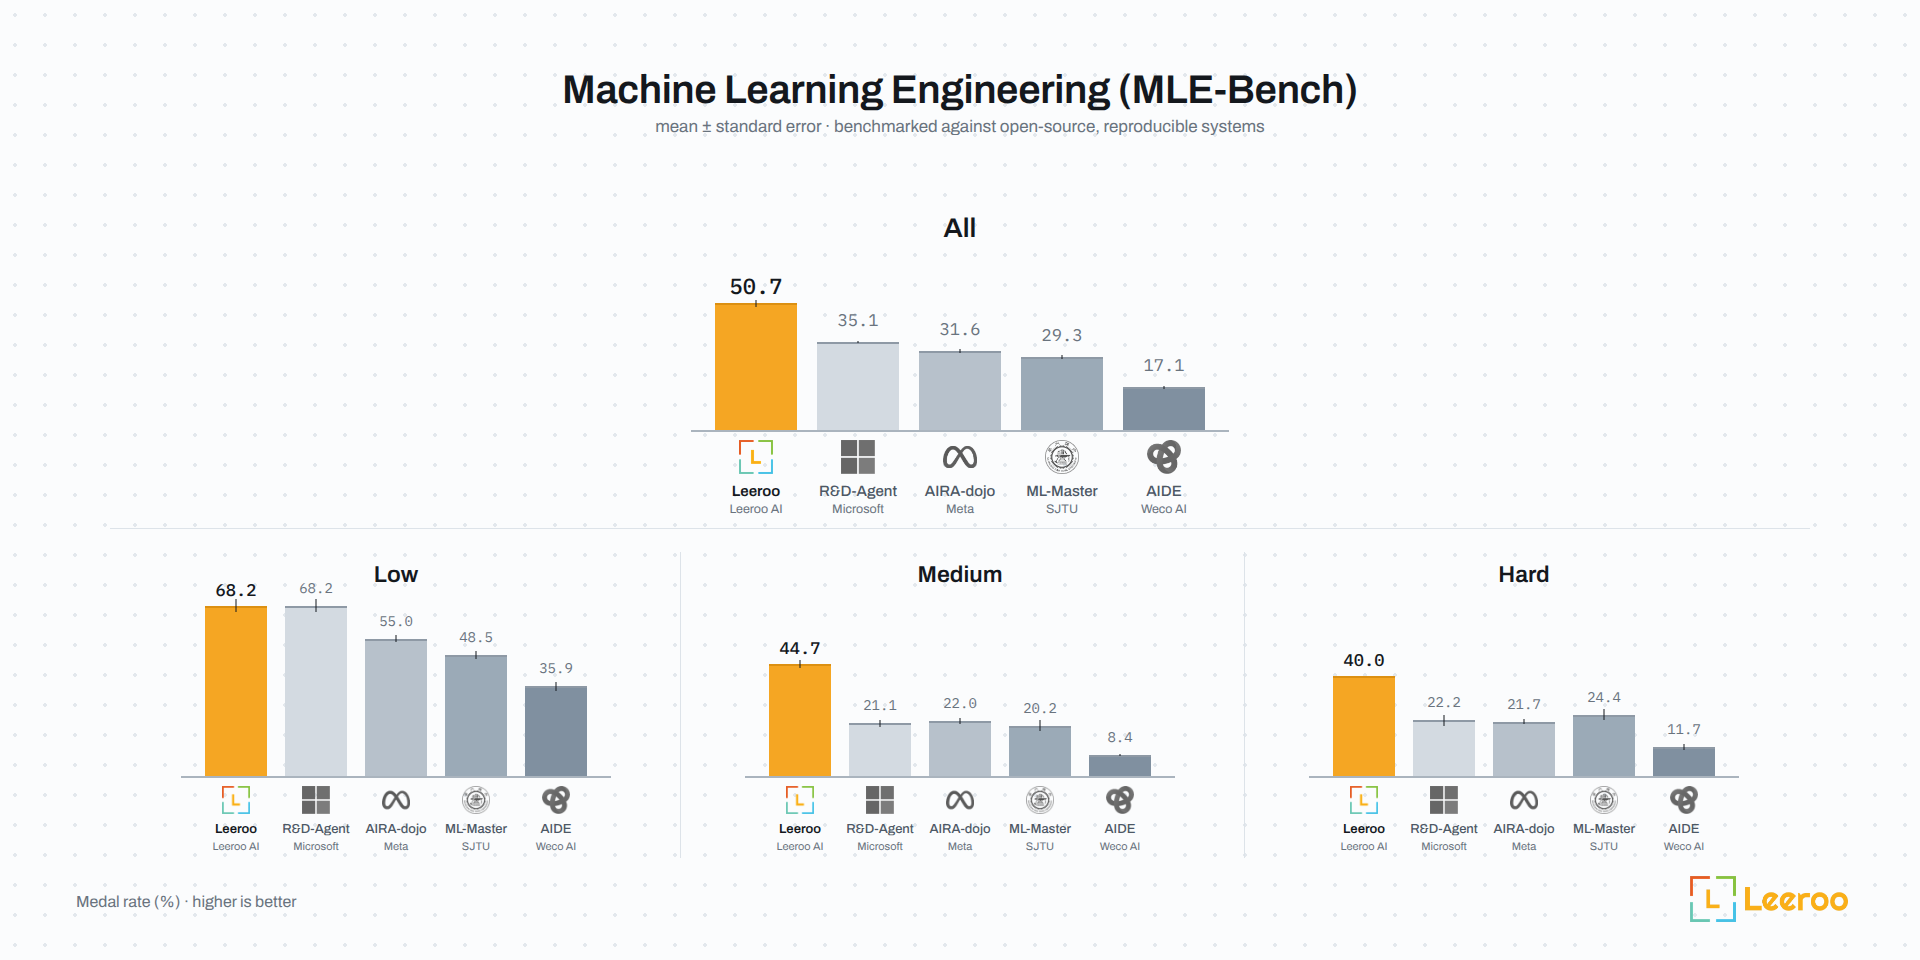
N° 1 sur MLE-Bench : KAPSO a obtenu la première place parmi les systèmes open source sur les compétitions de ML Kaggle (MLE Benchmark).
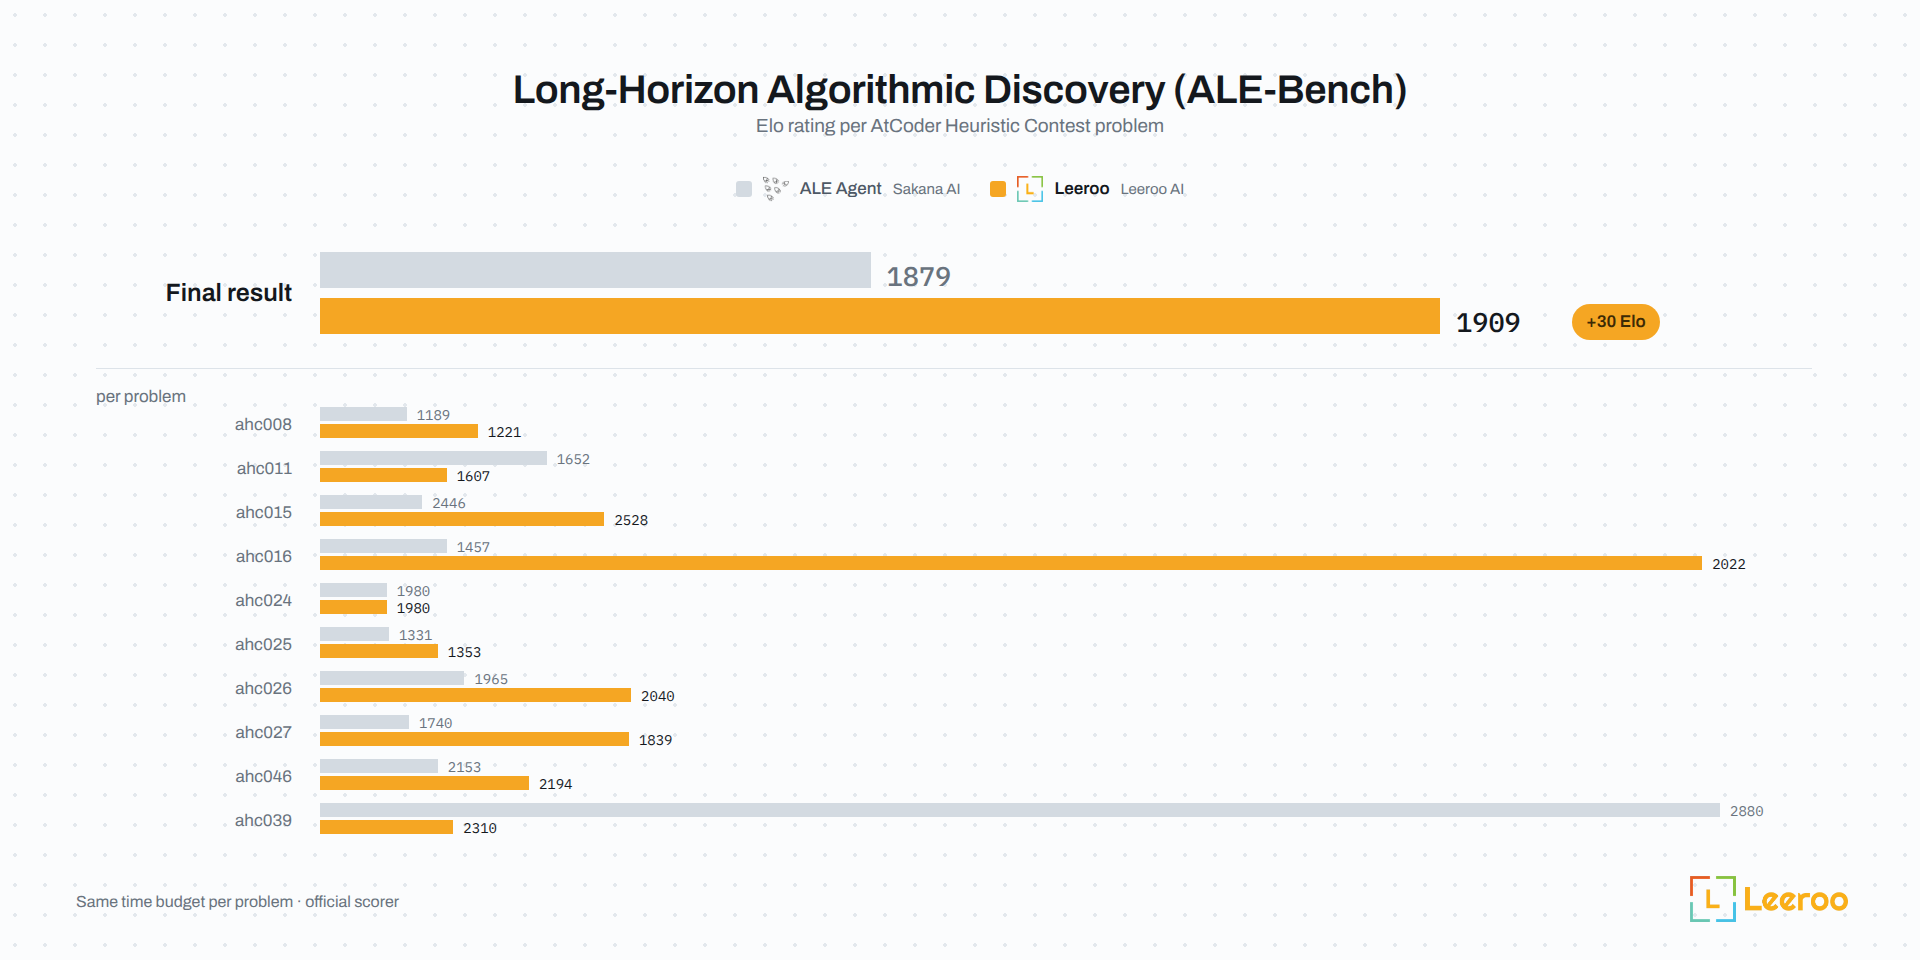
N° 1 sur ALE-Bench : KAPSO a obtenu la première place sur des problèmes de découverte algorithmique à long horizon (ALE Benchmark).
Qu'est-ce que Kapso ?
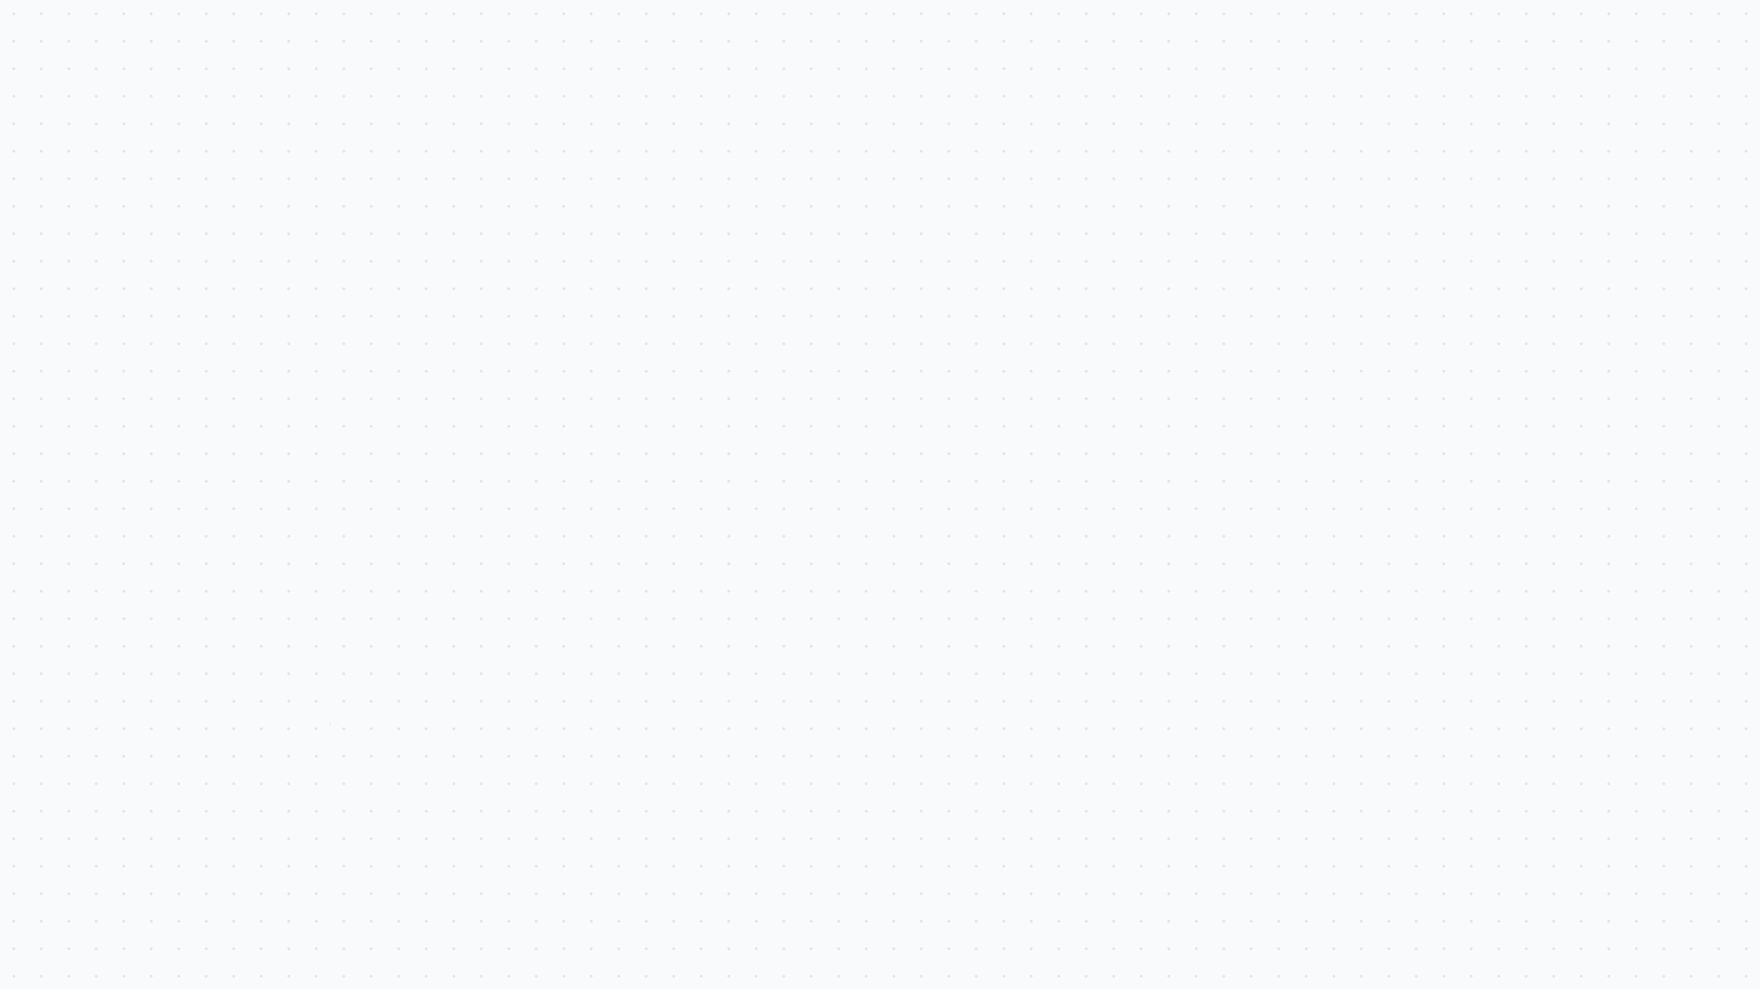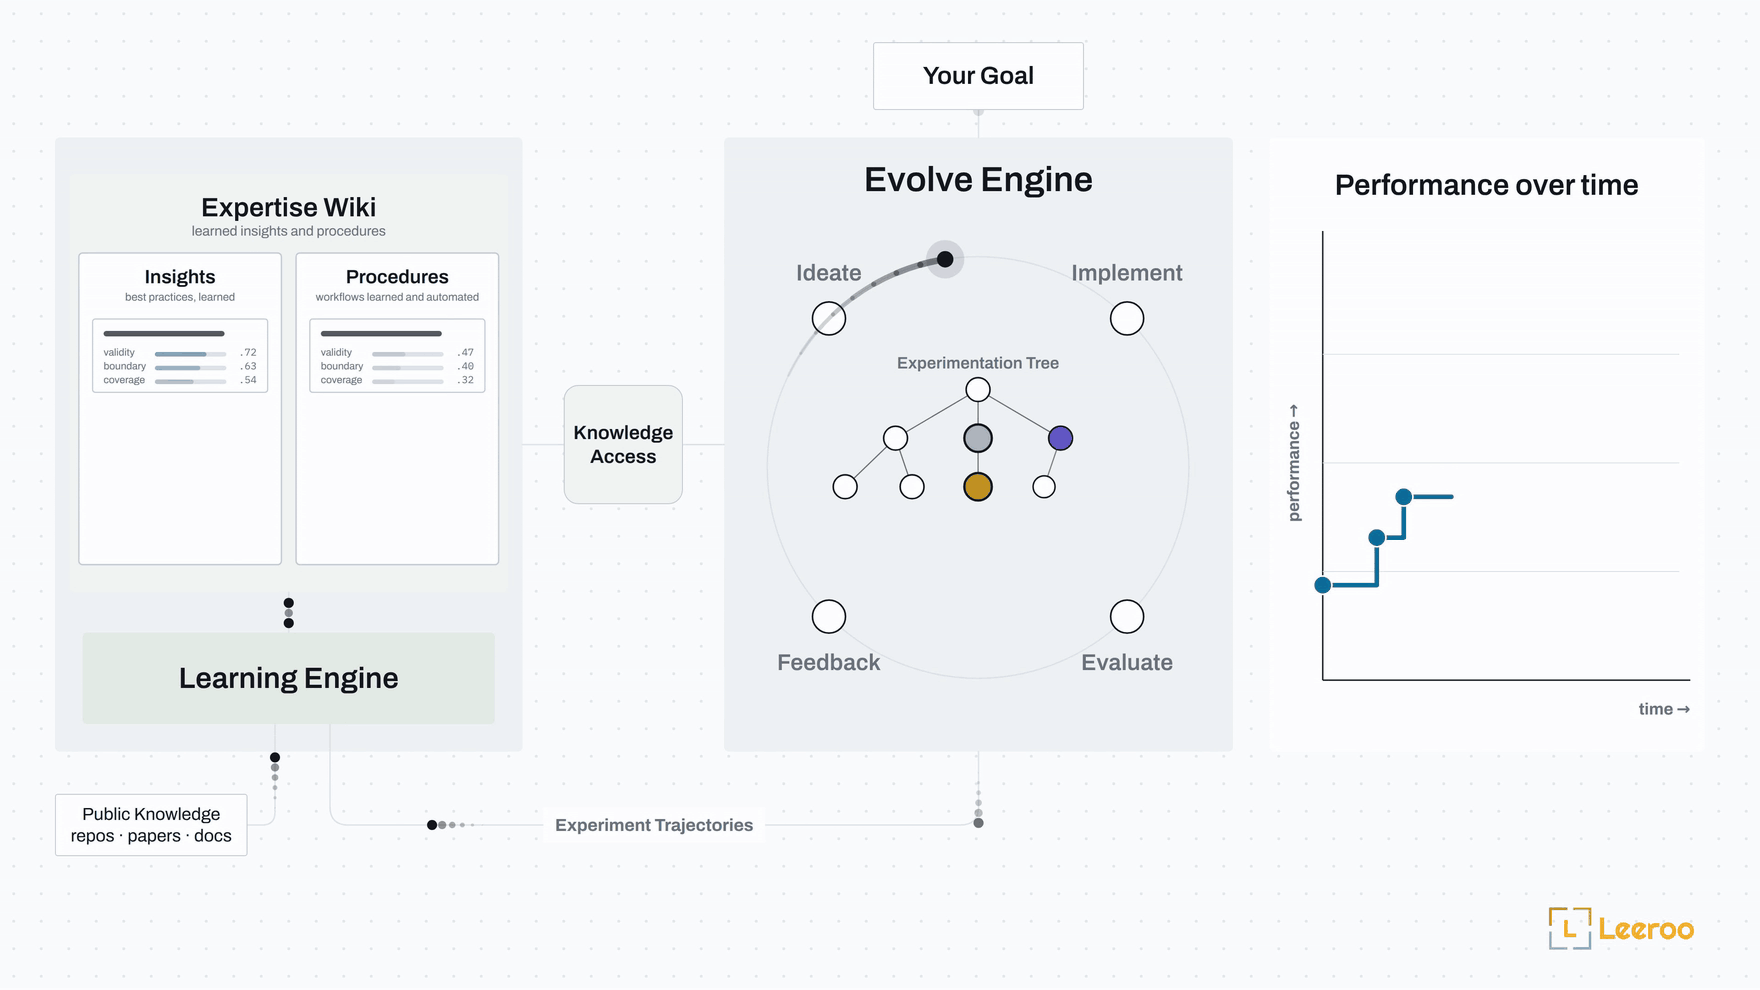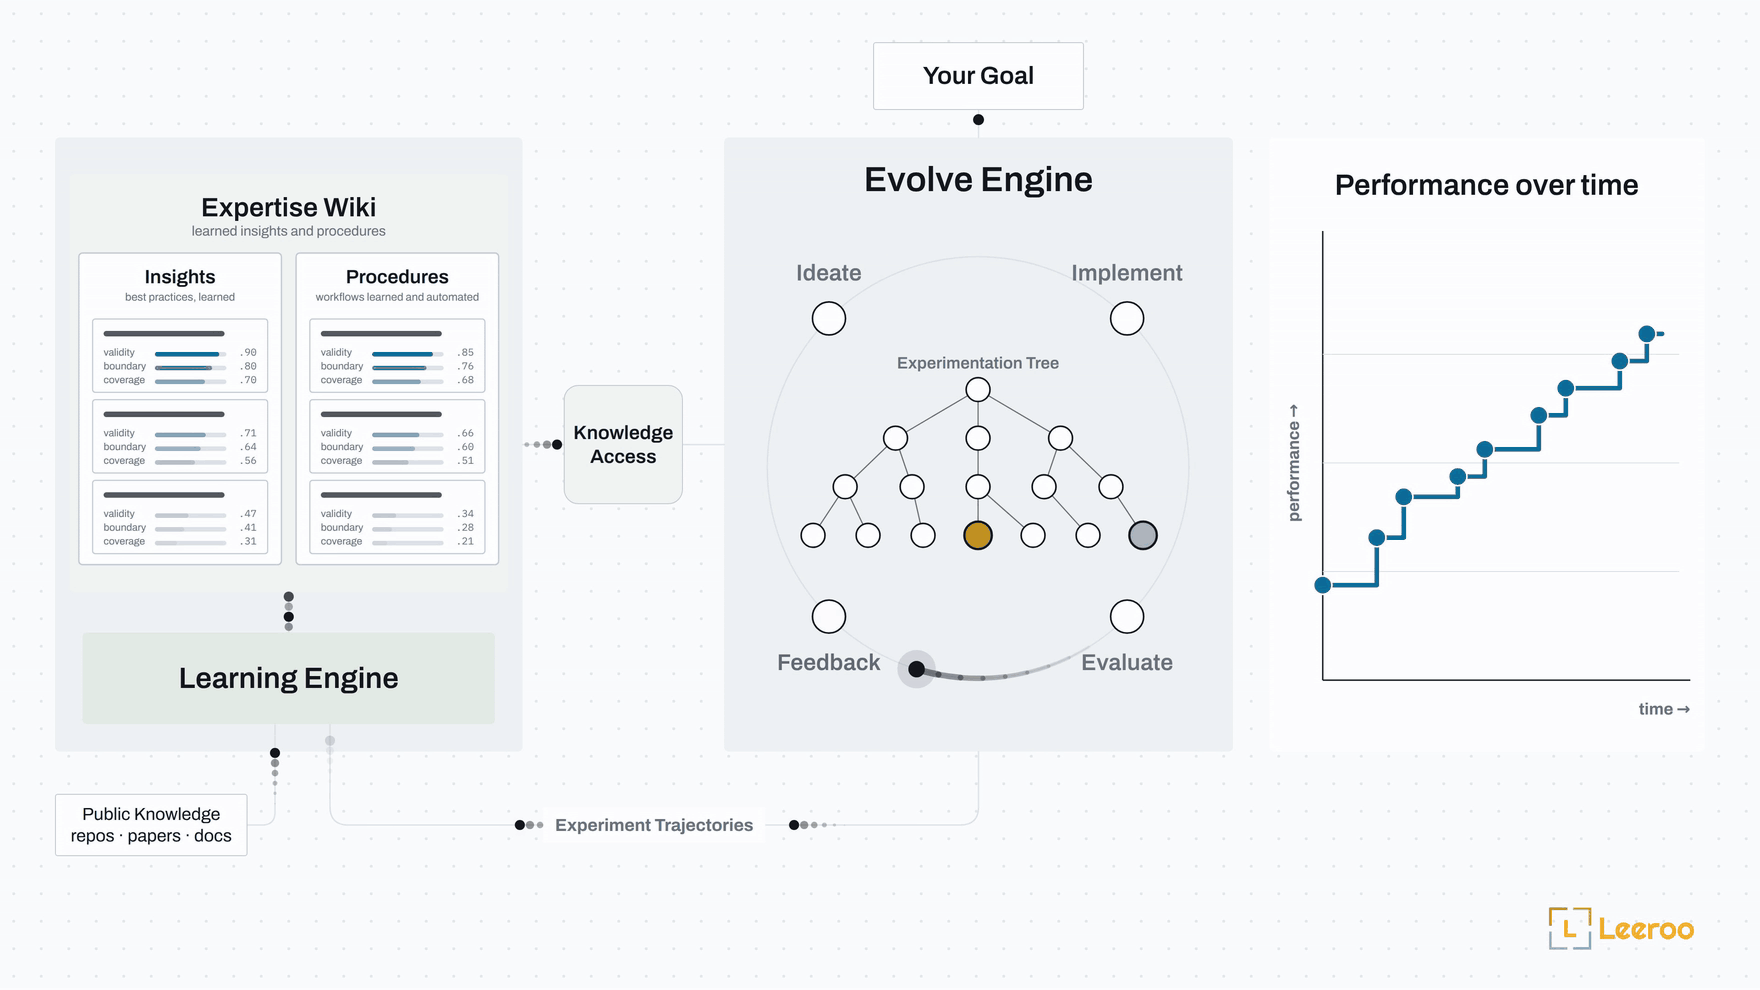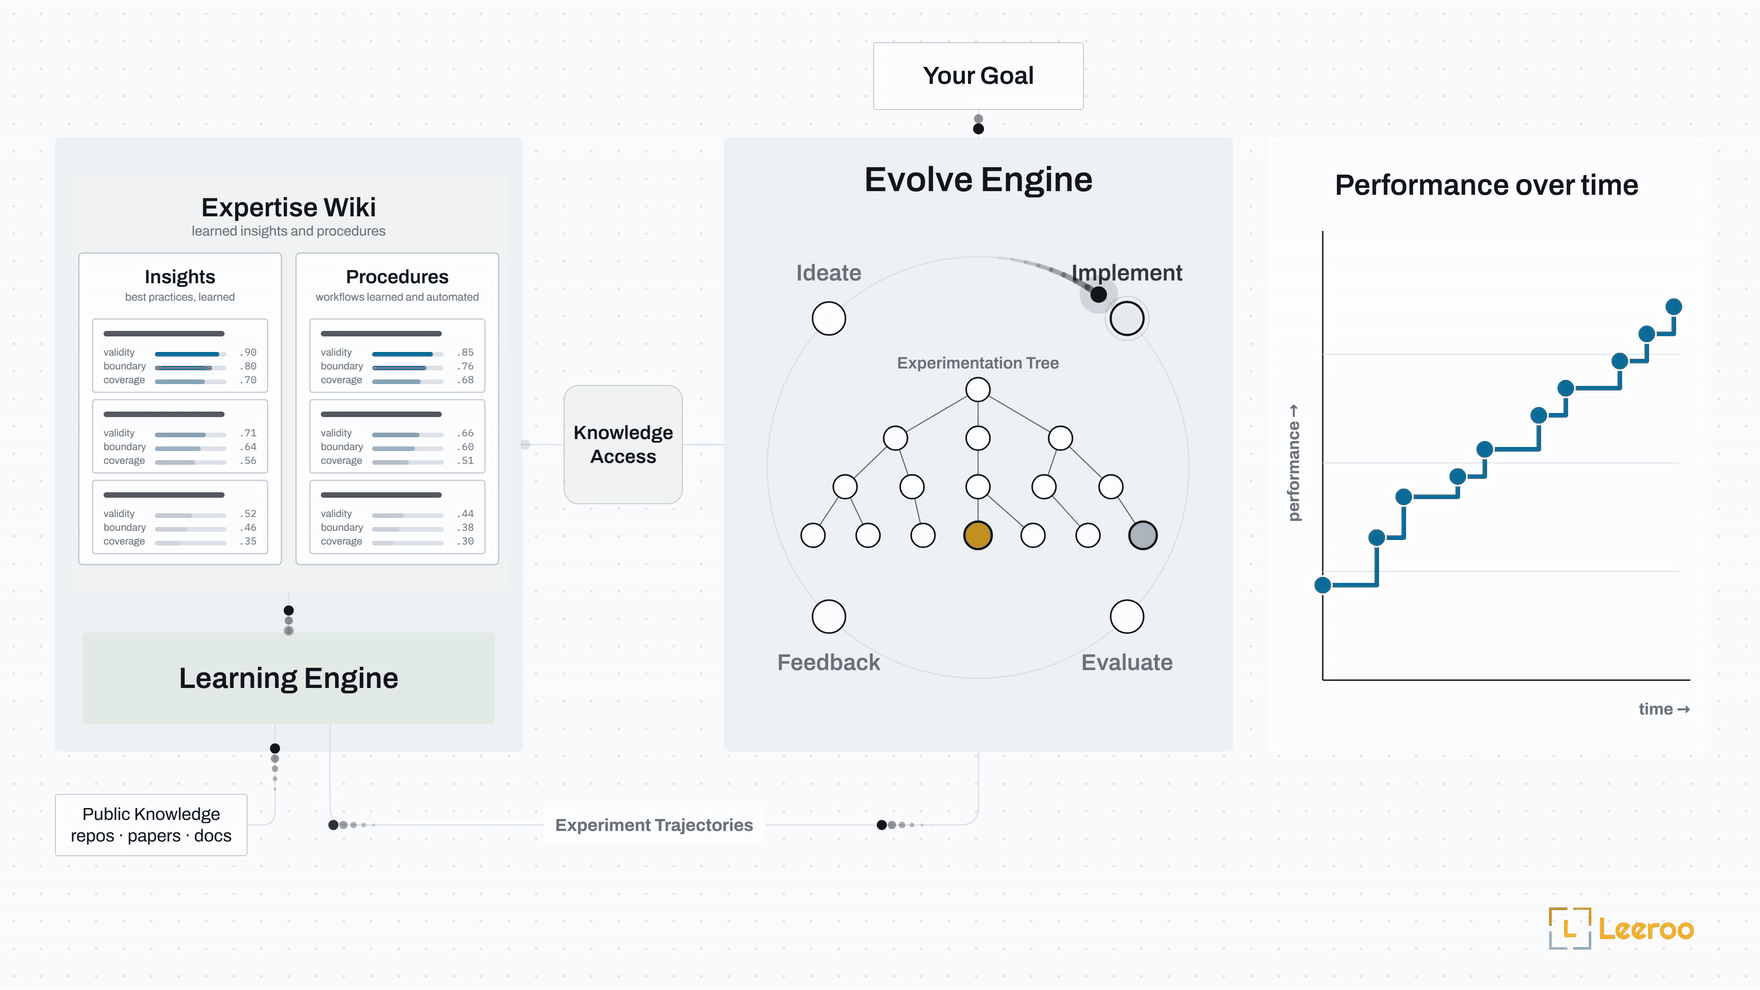
Kapso est un moteur open source qui exécute des expériences, déploie la meilleure solution et apprend de chaque exécution. Il part d'un harness de domaine et d'une banque de leçons vide, et, à partir d'un objectif et de critères de réussite, il :
- exécute un arbre d'expériences : propose des hypothèses, puis implémente et vérifie chacune d'elles ;
- déploie la meilleure solution sur la stack cible ;
- apprend de l'exécution : le crédit revient à chaque hypothèse et à chaque implémentation selon son impact sur le résultat, et la banque est mise à jour, chaque leçon portant un score de crédence et une frontière délimitant où elle s'applique.
Avec le temps, le harness de domaine porte une banque de leçons : les bonnes pratiques expérimentées de cet environnement. Kapso est indépendant du modèle et de l'agent de codage, conçu par Leeroo et publié sur PyPI sous le nom leeroo-kapso.
Les quatre parties
| Partie | Verbe | Ce qu'elle fait |
|---|---|---|
| Expérimentation intelligente | .build() |
Chaque expérience est une hypothèse implémentée sur sa propre branche et notée, dans un arbre. L'idéation s'appuie sur les expériences antérieures et sur la banque de leçons, et reclasse les idées selon le rendement attendu rapporté au budget, pour qu'elles conviennent à cet environnement plutôt que d'être les idées génériques d'un simple LLM ou d'un RAG ; un évaluateur doté d'une empreinte, qu'aucune expérience ne peut toucher, vérifie le résultat, et des modules peuvent proposer des mises à jour de l'évaluation que le vérificateur approuve. Comment ça marche → |
| Apprentissage | .learn() / .load_experience() |
Chaque leçon est induite ou déduite des traces d'expérimentation et porte un score de crédence, une frontière délimitant où elle s'applique et ses preuves ; learn() les met à jour à partir du résultat de chaque exécution et teste chaque changement en A/B en reconstruisant avec et sans lui, de sorte que l'amélioration est mesurée, et non devinée. La banque repose sur git : kapso experience share, list et update. Expérience → désigne ce qui est servi à un build. |
| Déploiement | .deploy() |
Une expérimentation plus courte du même type adapte la meilleure solution à la stack cible, la déploie et prouve les contrôles de santé et un appel fonctionnel. Docker, Modal, BentoCloud et LangGraph Platform sont fournis ; un harness peut ajouter une cible. |
| Adaptation au domaine | kapso harness |
Un harness est le paquet de domaine de Kapso : les connaissances et les flux de travail d'un domaine tel que la modélisation prédictive, pour qu'un build ne parte jamais de zéro, et l'endroit où la banque de leçons s'accumule. La modélisation prédictive et la programmation compétitive sont fournies ; écrivez le vôtre avec /kapso:harness dans le plugin ou kapso harness dans la CLI. |
🚀 Démarrage rapide

▶ Regardez la présentation avant d'installer
Installation
0. Dans un agent de codage ? Installez le plugin Kapso et laissez-le parcourir avec vous les étapes ci-dessous :
claude plugin marketplace add Leeroo-AI/kapso && claude plugin install kapso@kapso   # Claude Code
codex plugin marketplace add Leeroo-AI/kapso && codex plugin add kapso@kapso         # Codex
Ensuite, /kapso:setup installe et vérifie, et /kapso:build <what you want>
lance la première campagne (sur Codex : $kapso-setup, $kapso-build <what you want>). Voir Le plugin Kapso.
1. Prérequis. Kapso exécute son inférence via les CLI d'agents de codage (il n'y a pas de repli vers une API directe), vous avez donc besoin de Node.js et des deux CLI d'agent connectées avant que quoi que ce soit ne fonctionne :
# Node.js 18+ (https://nodejs.org), puis :
npm install -g @openai/codex            # recherche, jugement, utilitaires
codex login

npm install -g @anthropic-ai/claude-code  # idéation + implémentation (l'hôte par défaut)
claude auth login
Une clé OpenAI est facultative : seuls le graphe de connaissances et la recherche sémantique
sur les expériences passées (models.embedding dans votre configuration) vectorisent du texte, et
la génération ne l'utilise jamais. Quand vous activez l'un ou l'autre :
echo 'OPENAI_API_KEY=sk-...' >> .env
2. Connectez Leeroopedia (recommandé). Une seule clé donne à chaque session Leeroopedia, notre banque de leçons hébergée sur les frameworks de ML et d'IA. Rien à installer ; un nouveau compte sur le tableau de bord Leeroopedia vient avec 20 $ de crédit gratuit.
echo 'LEEROOPEDIA_API_KEY=kpsk_...' >> .env
3. Installez le paquet (Python 3.10+) :
pip install leeroo-kapso
4. Vérifiez l'installation :
kapso doctor
doctor indique ce dont votre configuration a réellement besoin, et nomme le correctif
exact pour tout ce qui manque. Les prérequis suivent la configuration, de sorte qu'une installation
tout-codex ne se voit jamais demander claude. Restreignez-le à un seul verbe pour ne voir que
les prérequis de ce verbe :
kapso doctor build # ou learn / deploy / experience
Ce sont les mêmes vérifications que le verbe lui-même exécute avant tout travail :
kapso.build(...) échoue en quelques secondes sur une CLI manquante plutôt qu'au fond
d'une session. Les éléments marqués [-- ] sont facultatifs ; ils limitent des fonctionnalités
dont vous n'aurez peut-être pas besoin (docker, Weaviate, Neo4j, les cibles de déploiement).
Ou laissez votre agent de codage faire tout cela : collez le prompt d'installation dans Claude Code, Codex ou OpenCode.
Les magasins de données dont un index a besoin (facultatif) : kapso experience add --repo
et --research ingèrent un corpus dans des instances locales de Weaviate + Neo4j. Depuis une
copie des sources :
bash scripts/start_infra.sh # lance les deux via docker
Depuis les sources (pour le développement)
git clone https://github.com/leeroo-ai/kapso.git
cd kapso

conda create -n kapso python=3.12 && conda activate kapso
pip install -e .
L'ancien adaptateur aider est un extra (pip install "leeroo-kapso[aider]",
Python <3.13) ; les agents claude/codex par défaut n'ont besoin d'aucun extra.
Utilisation de base
Les verbes de base ne demandent rien de plus que les prérequis ci-dessus :
from kapso import Kapso, Budget

kapso = Kapso()   # aucun graphe de connaissances n'est nécessaire pour commencer

# Build : une solution par l'expérimentation. La campagne affiche
# `status: <path>` au lancement ; suivez-la en direct depuis un autre terminal avec
#     kapso watch ./campaign
# Si une session a besoin de quelque chose qui ne peut venir que de vous (une clé d'API, un fichier),
# la campagne se met en pause et `kapso inbox reply` la reprend :
#     https://docs.leeroo.com/docs/build/inbox
# Partagez le résultat en Markdown pour une pull request ou une issue avec
#     kapso report ./campaign -o report.md
solution = kapso.build(
    "Optimize the model in train.py; target accuracy > 0.80 on evaluate.py",
    repo="./my_project",                 # ou omettez-le pour partir de zéro
    output="./campaign",
    budget=Budget(minutes=120),
)
print(solution.explain())

# Apprenez de la campagne que vous venez d'exécuter : extrayez la trajectoire, notez les
# leçons et mettez en banque des fiches de connaissances évaluées par leurs preuves. La banque (un dépôt
# git local) est créée automatiquement à la première utilisation ; les leçons restent sur votre
# machine jusqu'à ce que vous les partagiez :
#     kapso experience share <git-url>
# après quoi chaque learn() y pousse la banque.
lesson = kapso.learn(solution)
print(lesson.explain())

# Reconstruisez, en servant les fiches qu'il vient de gagner : un build se voit servir exactement
# l'expérience qu'il charge.
kapso.load_experience("mine")
solution2 = kapso.build("...", output="./campaign2")
Une fois les magasins de données lancés, vous pouvez aussi ingérer des connaissances externes dans un index et les servir de la même manière :
from kapso import Kapso

kapso = Kapso()

# Une fois : un dépôt, ou le web exploré pour une question, dans un index
kapso.add_experience(repo="https://github.com/huggingface/trl", name="trl")
kapso.add_experience(research="RLHF and DPO fine-tuning for legal contract analysis", name="dpo-legal")

# Chaque build qui charge l'index y effectue une recherche ; Leeroopedia s'appuie sur sa clé
kapso.load_experience("trl")
kapso.load_experience("leeroopedia")
solution = kapso.build("Fine-tune Llama-3.1-8B for clause risk classification")
Une remarque sur le budget : une ingestion extrait tout ce que le matériau permet. Une seule question peut devenir des dizaines de pages liées et une ingestion de plusieurs heures ; le temps d'ingestion croît avec la substance extractible, ajoutez donc les sources que vous interrogerez, et non toutes celles que vous possédez.
Et pour transformer une solution en logiciel en fonctionnement :
software = kapso.deploy(solution, target="local")   # ou docker, modal, bentoml, langgraph, auto
result = software.run(software.proof["inputs"])     # l'appel que le déploiement a prouvé
software.stop()
Comment borner une campagne ?
Utilisez max_iterations, time_budget_minutes et cost_budget pour borner les itérations, le temps écoulé et, au mieux, la dépense de modèle en USD.
Pour les coûts de plateforme, activez la sélection sensible au coût dans search_strategy.params.cost avec votre estimateur, cap_per_candidate et campaign_budget ; son weight permet aussi à la sélection de préférer des candidats moins chers.
Choisir les modèles
Chaque modèle qu'utilise Kapso est nommé dans un seul fichier de configuration. La configuration
empaquetée par défaut exécute les sessions de build sur claude-opus-5, les équipes d'apprentissage sur
claude-fable-5 et les rôles codex sur gpt-5.6-sol, mais l'accès aux modèles dépend de
l'abonnement (une offre peut plafonner un modèle tout en en servant un autre).
Pour utiliser d'autres modèles, copiez la configuration empaquetée, modifiez-la et indiquez
la vôtre à Kapso :
from pathlib import Path
import yaml
from kapso import Kapso
from kapso.kapso import DEFAULT_CONFIG_PATH

config = yaml.safe_load(Path(DEFAULT_CONFIG_PATH).read_text())
# p. ex. exécuter les équipes d'apprentissage sur opus plutôt que sur fable :
crews = yaml.safe_dump(config).replace("claude-fable-5", "claude-opus-5")
Path("kapso-config.yaml").write_text(crews)

kapso = Kapso(config="kapso-config.yaml")
Les rôles d'inférence purement textuels peuvent opter pour les Chat Completions openai_compatible.
Définissez le modèle et le point de terminaison dans votre configuration ; les identifiants restent dans l'environnement.
Chargez la configuration avec Kapso(config=...) ou kapso build --config ....
Le codage et la recherche web exigent toujours des agents dotés des outils correspondants.
Voir l'exemple de configuration et ses limites.
Avant une longue exécution, sondez chaque modèle que nomme votre configuration par rapport à vos abonnements réels : un modèle que votre connexion ne peut pas servir échoue ici en quelques secondes au lieu d'échouer des heures après le début d'une exécution. Un plafond d'utilisation sur un modèle que vous pouvez servir n'est pas visible pour une sonde à un jeton :
kapso doctor --models                            # configuration empaquetée
kapso doctor --models --config kapso-config.yaml # la vôtre
kapso doctor learn --models                      # seulement les équipes d'apprentissage
Pour intégrer cette sonde à chaque appel plutôt que d'avoir à penser à la lancer,
activez-la dans votre configuration. Elle coûte un jeton jetable par paire
{cli, model} distincte, ce qui en vaut la peine avant un learn() de plusieurs heures
sans surveillance :
preflight:
  enabled: true            # vérifications statiques avant chaque verbe (par défaut)
  live_model_probe: true   # + sondes de modèle à un jeton (par défaut : false)
Changer de modèle modifie aussi le rythme : les plafonds timeout_minutes des équipes dans la
configuration ont été calibrés sur les modèles par défaut, et un modèle de remplacement qui
raisonne plus longtemps peut exiger de les relever.
Pour les étapes d'intégration détaillées, voir les guides Démarrage rapide et Installation.
Benchmarks pris en charge
| Benchmark | Description |
|---|---|
| MLE-Bench | Le benchmark d'ingénierie ML d'OpenAI : des compétitions complètes en tabulaire, vision, texte et audio, des données brutes à la soumission notée |
| ALE-Bench | Le benchmark d'optimisation algorithmique de Sakana AI : concevoir, implémenter et itérer des heuristiques de concours au fil de recherches de plusieurs heures |
| RelBench | Le benchmark de Stanford pour le ML prédictif sur données relationnelles : classification, régression et recommandation directement depuis les bases de données multi-tables d'Amazon, H&M, Stack Exchange, d'essais cliniques et plus encore |
| IOAI 2026 | Du ML d'olympiade chronométré en vision, langage et optimisation : des tâches fixées par des experts, le matériel du concours, aucune aide humaine |
Chaque benchmark a aussi une page de documentation qui couvre comment l'exécuter, ses options de CLI et ce que contient la sortie : IOAI 2026 · MLE-Bench · ALE-Bench · RelBench
Exemples
Chaque exemple est une tâche : un brief, un dépôt de départ, les données ou la façon de les obtenir, et un pilote d'au plus douze lignes ; examples/README.md donne les minutes et la commande unique.
| Exemple | La tâche |
|---|---|
| Ingénierie des données (modèles dbt sur Snowflake) | Corriger les modèles dbt qui ont des problèmes de qualité de données et construire les nouveaux que demande un backlog de dix-sept tickets, sur un entrepôt de données de distribution sur Snowflake, jusqu'à ce que chaque ticket passe ses tests de production ; puis livrer une pull request par ticket et les publier en production. |
| Optimisation du harness (agent de support client) | Optimiser le harness d'un agent de support client pour faire passer le LLM sous-jacent de Fable 5.1 à un Qwen 27B local sans perdre en résolution des conversations clients, puis le déployer dans Docker et apprendre de l'exécution. |
| Modélisation prédictive (attrition client) | Prédire quels clients partiront : faire monter le ROC AUC hors échantillon d'un modèle d'attrition vers la cible, sous un évaluateur que la campagne ne peut pas modifier. |
| Détection de fraude | Noter des transactions pour la fraude quand le dépôt n'a pas d'évaluateur : le brief énonce le protocole, la campagne construit d'abord l'évaluateur, puis améliore le scoreur. |
| Finance quantitative | Une stratégie de trading quotidienne sur des instruments synthétiques : faire monter le Sharpe hors échantillon sur le harness de trading, avec ses vérifications à chaque tentative. Un exemple de recherche, pas un conseil financier. |
| ML tabulaire | Une compétition Kaggle de bout en bout : Spaceship Titanic d'un classifieur factice à un vrai modèle, puis passer en revue, apprendre, reconstruire avec la leçon et déployer. |
| Optimisation PyTorch | Rendre un module PyTorch plus rapide sur CUDA dans une tolérance numérique : fusion, compilation, moins de trafic mémoire. |
| Optimisation de noyaux GPU | Accélérer l'auto-attention multi-têtes sur CUDA avec flash attention ou un noyau Triton, dans une tolérance numérique. |
📚 Documentation et support
- Documentation complète : docs.leeroo.com
- Installation : les CLI d'agents de codage, le paquet et
kapso doctor - Démarrage rapide : votre première campagne
- Référence de la CLI : chaque commande, option et valeur par défaut
- API Python : chaque méthode publique de
Kapso - Configuration : chaque clé de
config.yaml - Ce que produit learn : la banque de leçons, chacune avec un score de crédence, une frontière et ses preuves, et le mode développement
- Expérimentation intelligente : l'arbre d'expériences et ses modules, et ce qui se passe dans une expérience
- Expérience : votre banque, Leeroopedia, des dépôts et des articles transformés en connaissances interrogeables
- Déploiement : local, Docker, Modal et les autres cibles
- Le plugin Kapso : les commandes, les compétences et le serveur MCP pour Claude Code, Codex et Cursor
- Installation : les CLI d'agents de codage, le paquet et
- Depuis votre agent de codage : la documentation expose un serveur MCP à
https://docs.leeroo.com/mcp, et chaque page est servie en Markdown ; voir llms.txt et Kapso dans votre agent de codage.claude mcp add --transport http kapso-docs https://docs.leeroo.com/mcp # Claude Code codex mcp add kapso-docs --url https://docs.leeroo.com/mcp # Codex CLI - Laissez votre agent de codage piloter Kapso : le plugin sous
plugin/comprend dix commandes, six compétences et le serveur MCP, une ligne d'installation par hôte (étape 0 ci-dessus) ; OpenCode charge les compétences sous forme de dossier (ln -s <clone>/plugin/skills .opencode/skills). Voir Le plugin Kapso. - Donnez à votre agent de codage les outils de connaissance de Kapso :
kapso-mcp, installé avec le paquet, sert la recherche web, la mémoire du dépôt, l'historique d'expériences de la campagne et la banque de leçons à la session dans laquelle vous travaillez ; voir Portes MCP.claude mcp add kapso -- kapso-mcp # Claude Code codex mcp add kapso -- kapso-mcp # Codex CLI ; puis `startup_timeout_sec = 60` sous [mcp_servers.kapso] dans ~/.codex/config.toml (les dix secondes de Codex sont courtes sur une machine chargée) - Communauté : Discord
- Site web : leeroo.com
Kapso pour l'entreprise
En entreprise, les agents Kapso sont livrés avec des harness initiaux d'ingénierie des données et de l'IA et une banque de leçons, et transforment par eux-mêmes des objectifs métier en systèmes d'IA et de données opérationnels, en explorant les artefacts, dépôts, pipelines, sources de données de l'entreprise et plus encore, pour bâtir au fil de l'eau le patrimoine de données de l'entreprise. Pour adopter Kapso pour vos tâches d'entreprise, parlez-nous.
Contribuer
Les contributions sont les bienvenues ! Consultez notre guide de contribution pour savoir comment commencer.
Contributeurs
Réalisé avec contrib.rocks.