
HKUDS/DeepTutor
HKUDS/DeepTutor has 55,382 GitHub stars and 6,788 forks. GitHot measured +351 stars in 24 hours and +5,393 in 7 days. Last checked 2026-11-05 19:09 UTC. Last push 2026-10-31.
Comment ces chiffres sont mesurés
DeepTutor : tutorat personnalisé tout au long de la vie. https://deeptutor.info/.
What you can do
- One runtime, many learning modes — Chat, Quiz, Research, Visualize, Solve, Mastery Path, Reading, and more share session context while retaining purpose-built workflows.
- A connected learning workspace — Home, Learning, and Resources connect Chat, Books, Reading, Practice, Task Board, Calendar, and Learning notebook with shared materials, progress, and learning context.
- Grounded knowledge and reading — Build versioned libraries with LlamaIndex, PageIndex, GraphRAG, or LightRAG, connect external knowledge sources, and learn beside documents, video, and audio with source-linked citations.
- Partners and subagents — Consult live agents such as Claude Code, Codex, and Grok CLI, import past conversations, or run persistent Partners with their own memory, resources, and IM channels.
Progression mesurée des étoiles
- in 24h
- +351
- in 7 days
- +5 393
- in 15 days
- Mise à jour retardée
- in 1 month
- Mise à jour retardée
Variations nettes sur des périodes qui se chevauchent, pas des totaux quotidiens. Les mesures absentes restent vides. Les étoiles indiquent l’intérêt, pas la qualité.
assets/README/README_FR.md
Original
DeepTutor : Tutorat Personnalisé à Vie






Fonctionnalités · Démarrage · Explorer · CLI · Écosystème · Communauté
🤝 Nous accueillons toutes les formes de contribution ! Votez sur les éléments de la feuille de route ou proposez-en de nouveaux sur
Roadmap, et consultez notre Guide de contribution pour la stratégie de branches, les normes de code et comment démarrer.
📰 Actualités
- 2026-10-28 🚀 DeepTutor v1.7.0 est arrivé ! Un nouveau look, une navigation plus fluide et des outils d'apprentissage qui fonctionnent mieux ensemble.
- 2026-05-22 🌐 Site de documentation officiel en ligne sur deeptutor.info — guides, références et présentations des capacités en un seul endroit.
- 2026-04-10 📄 Notre article est en ligne sur arXiv — lisez le preprint pour découvrir la conception et les idées derrière DeepTutor.
- 2026-01-01 🎊 Bonne Année ! Rejoignez notre Discord, WeChat ou les Discussions — façonnons DeepTutor ensemble.
- 2025-12-29 🎓 DeepTutor est officiellement lancé !
✨ Fonctionnalités Clés
DeepTutor est un espace de travail d'apprentissage natif à l'agent qui relie le tutorat, la recherche, la création et la pratique dans un système extensible.
- Un runtime, de nombreux modes d'apprentissage — Chat, Quiz, Research, Visualize, Solve, Mastery Path, Reading et bien d'autres partagent le contexte de session tout en conservant des flux de travail conçus pour chaque usage.
- Un espace de travail d'apprentissage connecté — Accueil, Apprentissage et Ressources relient Chat, Books, Reading, Practice, Task Board, Calendar et le carnet d'apprentissage avec des supports, une progression et un contexte d'apprentissage partagés.
- Connaissances et lecture ancrées dans les sources — Créez des bibliothèques versionnées avec LlamaIndex, PageIndex, GraphRAG ou LightRAG, connectez des sources de connaissances externes et apprenez aux côtés de documents, de vidéos et d'audio avec des citations liées aux sources.
- Partners et sous-agents — Consultez des agents en direct tels que Claude Code, Codex et Grok CLI, importez des conversations passées ou exécutez des Partners persistants dotés de leur propre mémoire, de leurs ressources et de leurs canaux IM.
- Mémoire inspectable — Les traces L1, les faits L2 et la synthèse L3 rendent la personnalisation visible et modifiable, avec des liens vers les preuves que vous pouvez auditer dans le Memory Graph.
- Extensible par conception — Ajoutez des personas, des compétences intégrées ou communautaires, des services MCP, des applications CLI et des modèles de génération via un runtime natif à l'agent unique.
🚀 Démarrage
Choisissez le chemin d'installation qui correspond à votre façon d'utiliser DeepTutor. Les installations depuis un terminal partagent un même répertoire d'exécution : les paramètres privés résident dans data/user/settings/ sous le répertoire de lancement, ou sous DEEPTUTOR_HOME / deeptutor start --home lorsqu'ils sont définis explicitement. Après avoir démarré l'application, configurez un fournisseur et un modèle dans Paramètres → Fournisseurs et Modèles de langage.
Desktop — macOS et Windows (préversion)
Open DeepTutor regroupe Python, Node.js et l'espace de travail d'apprentissage complet : aucun terminal ni installation de runtime séparé n'est nécessaire. Les préversions Desktop sont disponibles sur dev ; la version v1.7.0 n'inclut pas d'installateurs Desktop.
Ouvrez une exécution réussie du workflow Desktop Release, faites défiler jusqu'à Artifacts et téléchargez la cible correspondante. Une connexion à GitHub est requise et les artefacts expirent après sept jours.
| Votre ordinateur | Cible à télécharger | Installateur |
|---|---|---|
| Mac avec Apple Silicon | macos-arm64 |
Ouvrez le DMG et faites glisser Open DeepTutor dans Applications. |
| Mac avec Intel | macos-x64 |
Ouvrez le DMG et faites glisser Open DeepTutor dans Applications. |
| Windows x64 | windows-x64 |
Exécutez le programme d'installation .exe, ou extrayez le ZIP portable et lancez Open DeepTutor.exe. |
Les builds de préversion Windows ne sont pas signés et peuvent afficher un avertissement SmartScreen. Consultez le guide Desktop pour la signature, les données locales et les builds depuis les sources.
Docker — Essai le plus rapide de l'application complète
Exécutez l'application Web complète sans installer Python ni Node.js :
docker run --rm --name deeptutor \
  -p 127.0.0.1:3782:3782 \
  -v deeptutor-data:/app/data \
  ghcr.io/hkuds/deeptutor:latest
Ouvrez http://127.0.0.1:3782. Le volume nommé conserve les paramètres et les données locales ; seul le port 3782 est requis pour l'application Web. Consultez le guide Docker pour les espaces de travail hôtes, les services de modèles locaux, les proxys inverses et le déploiement en production.
PyPI — Application Web complète et CLI
Utilisez Python 3.11–3.14 et Node.js 20.9+. Dans la version modulaire 1.7.0, deeptutor[full] installe l'application Web et la CLI ; deeptutor seul installe le chat de base et le SDK.
mkdir -p my-deeptutor && cd my-deeptutor
python -m pip install -U "deeptutor[full]"
deeptutor init     # ports + LLM provider + optional embedding/search
deeptutor start    # starts backend + frontend
Ouvrez l'URL affichée dans le terminal, par défaut http://127.0.0.1:3782. Appuyez sur Ctrl+C pour arrêter les deux services.
Mise à niveau depuis 1.6.15 ou une version antérieure : arrêtez DeepTutor, sauvegardez le répertoire d'exécution et désinstallez l'ancien paquet deeptutor-cli avant d'installer la nouvelle famille. Conservez le même DEEPTUTOR_HOME, puis exécutez python -m pip check et deeptutor module list. Consultez le guide PyPI et de migration pour les commandes de mise à niveau exactes.
Sources — Branche dev actuelle et contributeurs
Utilisez Python 3.11–3.14 et Node.js 22 LTS pour correspondre à la CI et à Docker.
git clone --branch dev https://github.com/HKUDS/DeepTutor.git
cd DeepTutor
python3 -m venv .venv && source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -r requirements/full.txt
python -m pip install -e . --no-deps
( cd web && npm ci --legacy-peer-deps )
deeptutor init
deeptutor start --dev
Utilisez deeptutor start sans --dev pour un build de production. Les dépendances optionnelles s'installent depuis la racine du dépôt, par exemple python scripts/install_extras.py dev,partners,math-animator. Consultez le guide d'installation depuis les sources pour Conda, les extras et le dépannage, ou le guide de configuration par un agent pour laisser un agent capable d'utiliser un terminal effectuer et vérifier la configuration.
CLI — Utilisation dans le terminal et par un agent
Pour une installation minimale dans le terminal, utilisez le wheel du cœur ; Node.js et le frontend Web ne sont pas requis :
mkdir -p my-deeptutor && cd my-deeptutor
python -m pip install -U deeptutor
deeptutor init --cli
deeptutor chat
Le cœur inclut Chat, Ask Questions, la CLI et le SDK ; les autres capacités et commandes de gestion nécessitent leurs modules fonctionnels correspondants. Pour l'installation actuelle depuis les sources dev et les dépendances optionnelles, consultez le guide CLI uniquement. La référence de la CLI ci-dessous présente les exécutions ponctuelles et la sortie lisible par machine.
Espaces de travail et configuration avancée : consultez Content Workspaces, Persistance des données locales, Conteneurisation et déploiement en sandbox, la référence de configuration et le dépannage.
📖 Explorer DeepTutor
Commencez par un espace de travail pour chaque matière ou projet. Accueil, Apprentissage et Ressources changent avec l'espace de travail actif ; Partners et Personnalisation restent disponibles dans tous les espaces de travail.
| Zone | Portée | Contenu |
|---|---|---|
| Accueil | Espace de travail | Chat, Task Board, Calendar et carnet d'apprentissage |
| Apprentissage | Espace de travail | Books, Mastery Path, Immersive Reading et Practice |
| Ressources | Espace de travail | Historique des chats, Favoris, Journal d'apprentissage, Banque de questions et Knowledge Center |
| Partners | Compte | Compagnons persistants, Partner Groups, accès aux ressources et canaux IM |
| Personnalisation | Compte | My Agents, Personas, compétences, Services MCP, Applications CLI, Memory et Paramètres |
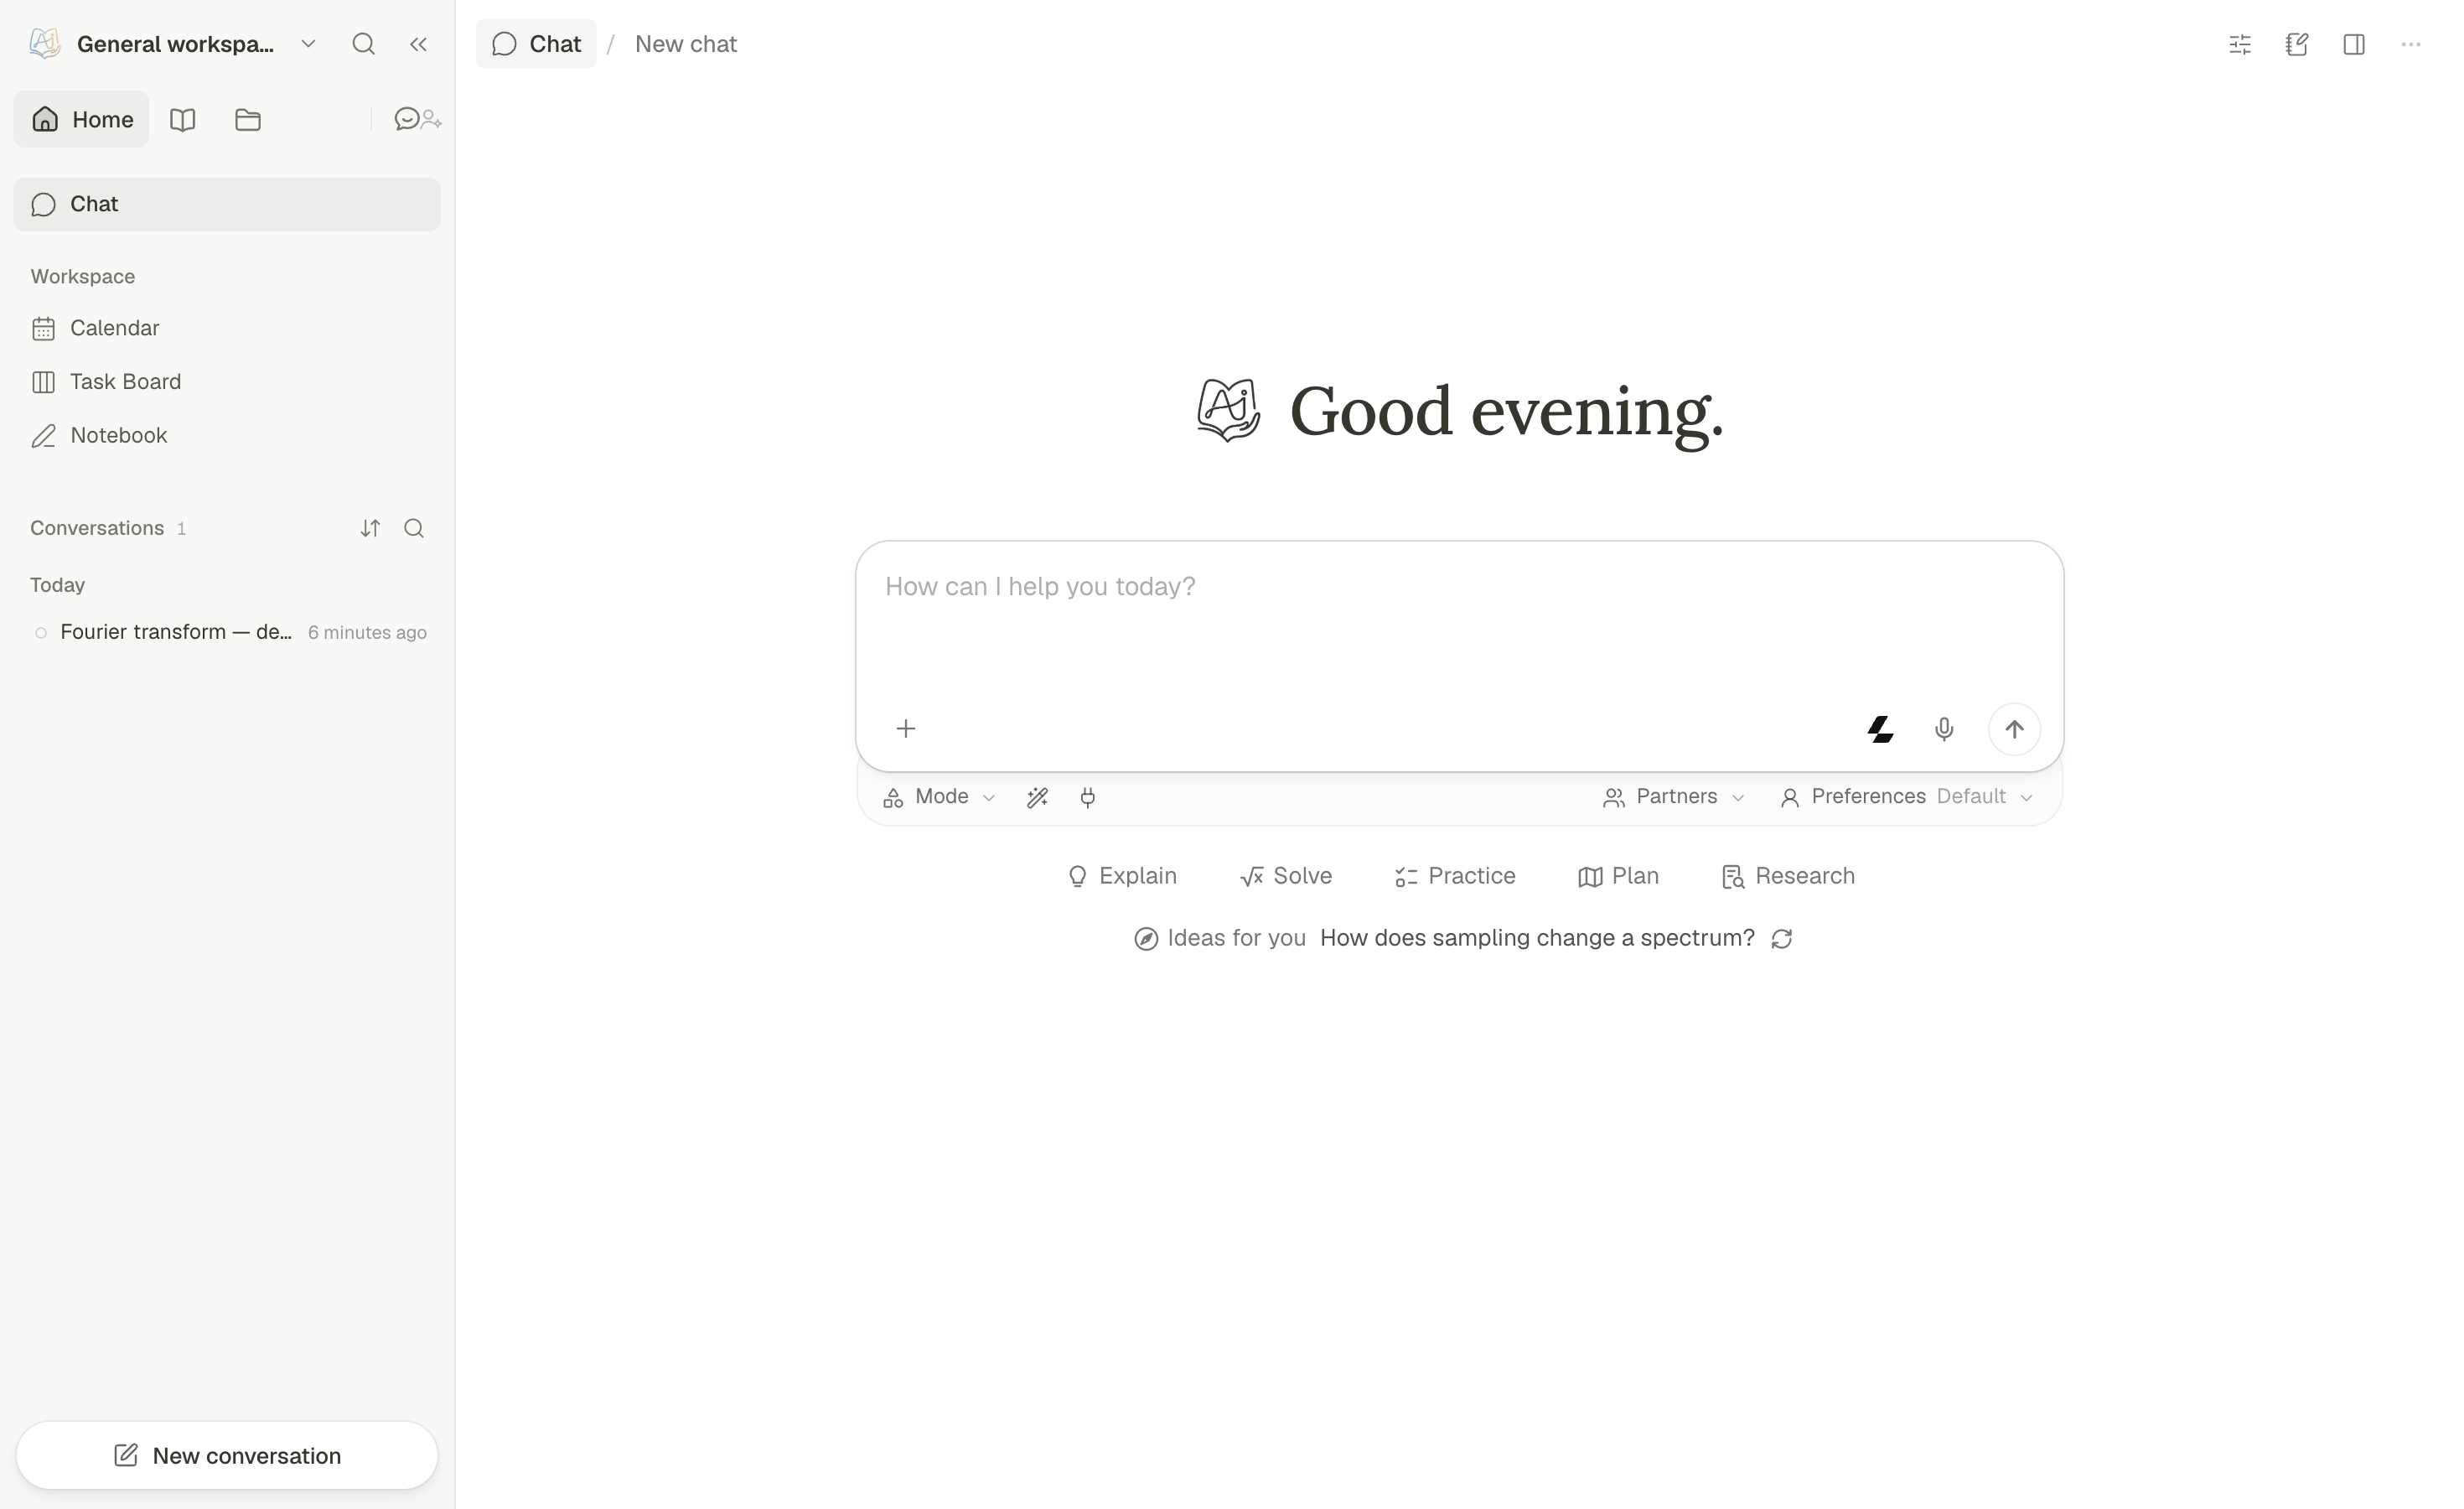
🏗️ Architecture du système
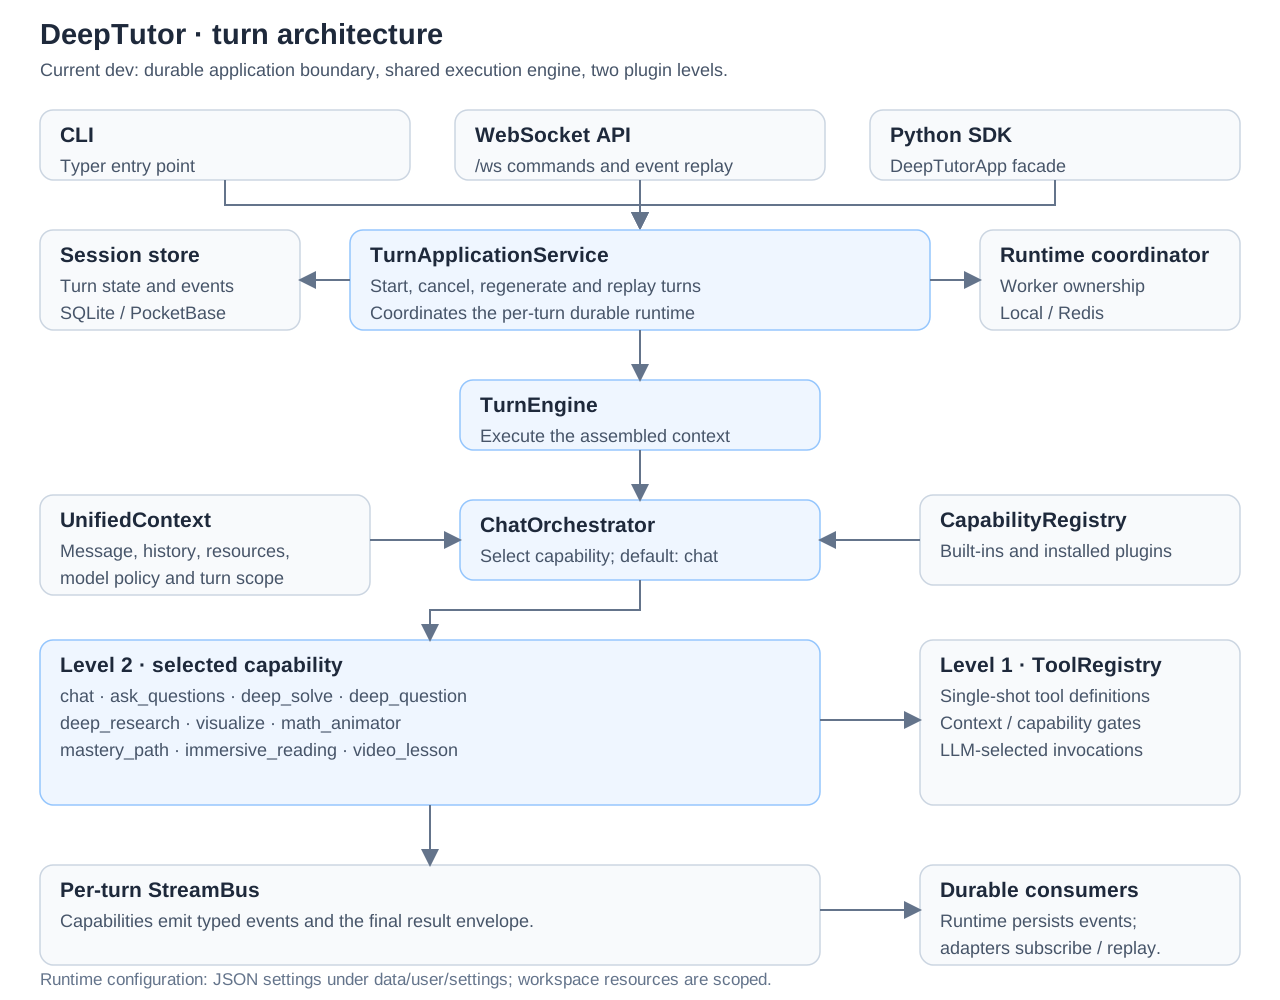
🏠 Accueil — Conversations, tâches, notes et calendrier
L'accueil est le point de départ du travail quotidien : parlez au tuteur, organisez les prochaines actions et développez vos propres notes dans l'espace de travail actuel. Calendar offre une vue à l'échelle du compte tout en conservant l'espace de travail source des événements d'étude.
💬 Chat — La Boucle d'Agent que Vous Utilisez Vraiment
Chat est la capacité par défaut et là où commence la plupart du travail. Un seul fil peut discuter normalement, appeler des outils, s'ancrer dans des bases de connaissances sélectionnées, lire des pièces jointes, générer des images, consulter des sous-agents, écrire des enregistrements dans le carnet et continuer avec le même contexte à travers les tours.
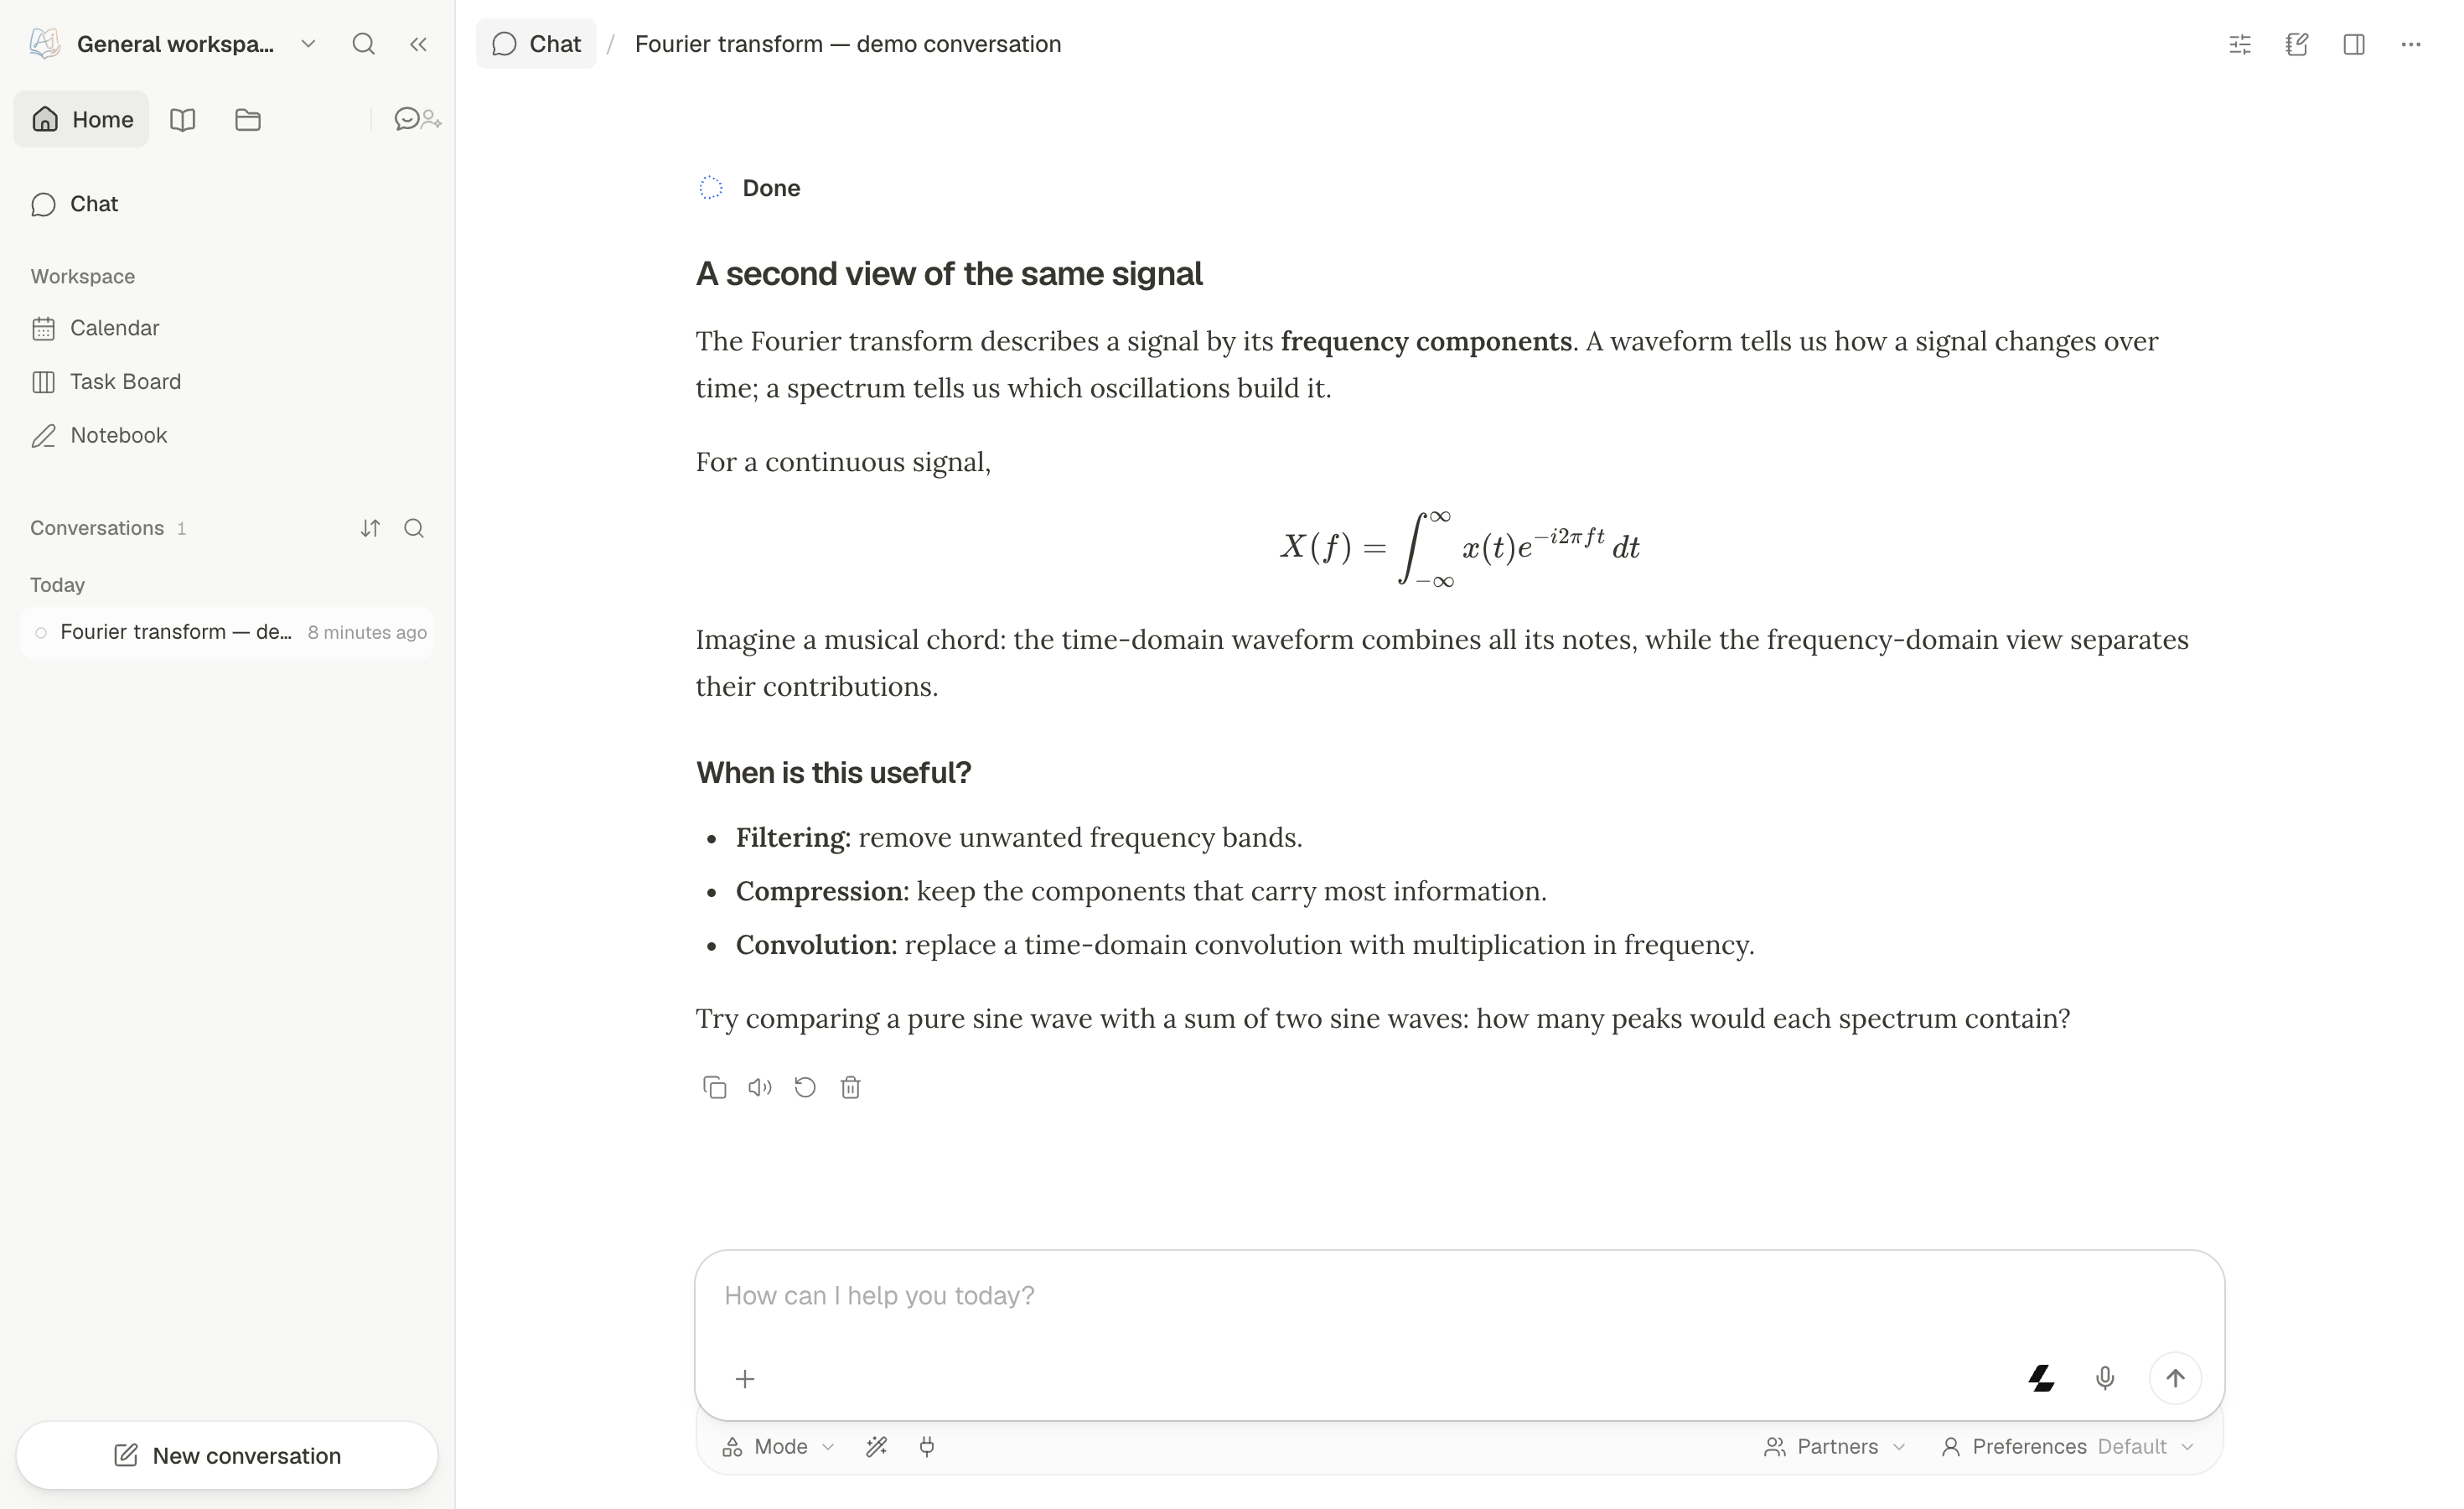
Le tuteur appelle les outils selon les besoins et peut s'interrompre pour poser des questions de clarification. Personnaliser la page, en haut à droite, permet de choisir les modes visibles et les commandes Compétences, MCP, Partners, Préférences et saisie vocale. Sous Consignes de démarrage, ajoutez, modifiez ou supprimez les titres et consignes des catégories Expliquer, Résoudre, Pratiquer, Planifier et Rechercher. Enregistrer applique les préférences de votre compte ; Annuler abandonne les modifications et Restaurer les valeurs par défaut rétablit les choix initiaux.
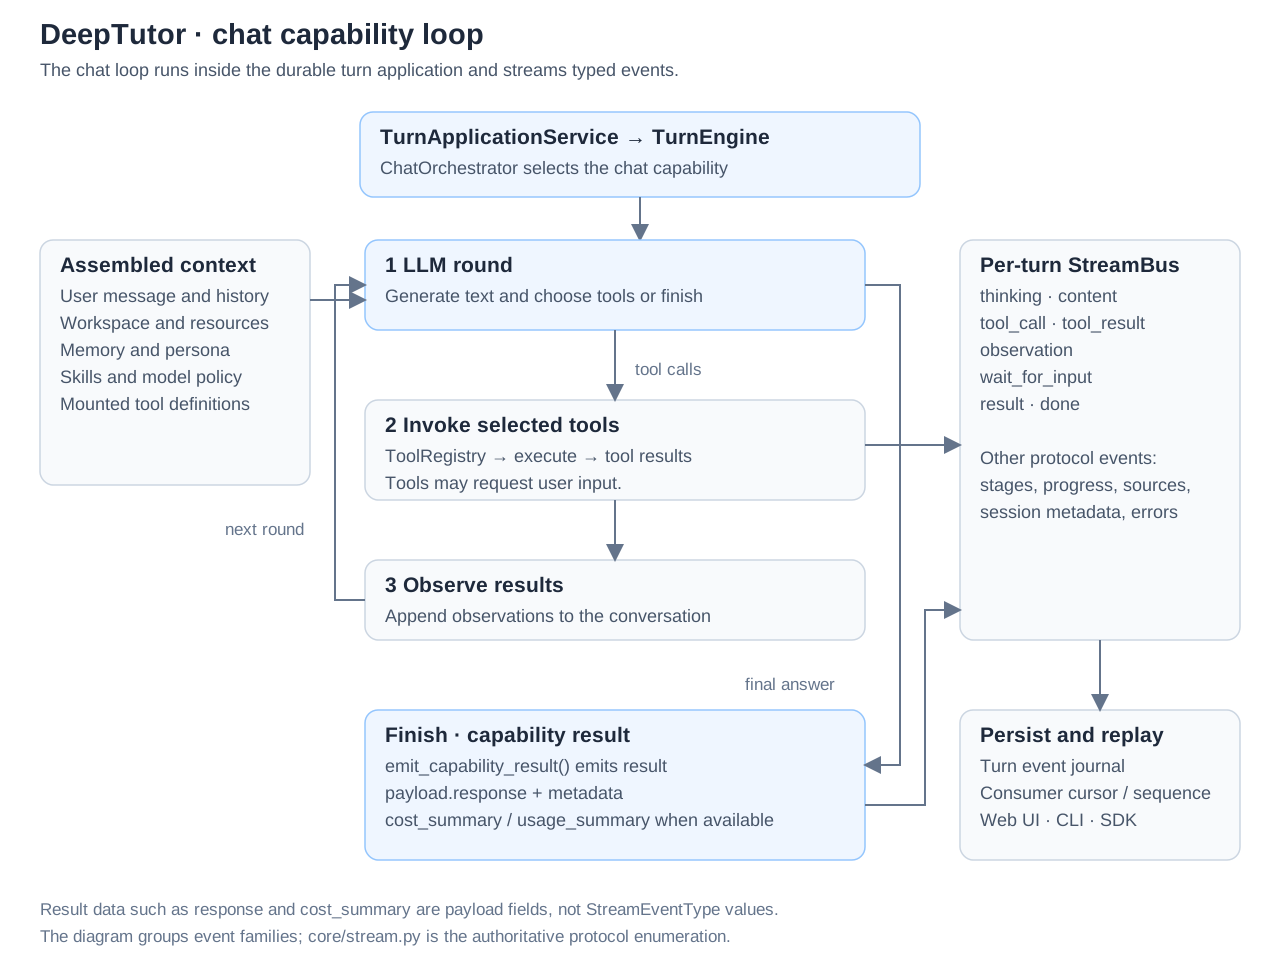
Les outils basculables par l'utilisateur sont brainstorm, web_search, paper_search, zotero_search, reason et geogebra_analysis — plus imagegen et videogen une fois que vous avez configuré le modèle de génération correspondant. Les outils contextuels tels que rag, kb_files, knowledge_frontier, read_source, read_memory, write_memory, read_skill, load_tools, exec, web_fetch, ask_user, list_favorites, save_favorite, write_note, search_notes, question_bank, github, consult_subagent, workspace_list, workspace_read, workspace_search, workspace_present et workspace_export se montent automatiquement quand le tour dispose du bon contexte.
Le contexte se présente en deux types : le contexte de session persistant (capacité, espace de travail ou cours, outils, bases de connaissances, persona, modèle et état Reading / Mastery) persiste entre les tours ; les références (fichiers, historique de chat, livres, sections de lecture, carnets, entrées sélectionnées de la banque de questions, agents importés) proviennent du menu + pour un seul tour par défaut, ou pour chaque tour lorsqu'elles sont épinglées. Le bouton vocal ne transcrit que le message en cours.
Avec le profil complet, l'accueil garde Chat, Ask Questions, Quiz, Visualize et Video Lesson accessibles en un clic ; Research pour les rapports cités et Solve pour le raisonnement détaillé se trouvent sous Plus de capacités. Sélectionnez du texte dans une réponse pour ouvrir Little Tutor, un fil latéral ciblé qui reste imbriqué sous la conversation source. Avec au moins trois messages envoyés, la marge gauche affiche une coche pour chaque question lorsque l'espace le permet ; survolez-la pour un aperçu, cliquez pour revenir à la question ou utilisez Alt/Option + ↑/↓ pour passer d'une question à l'autre.
✅ Task Board & Calendar — Organiser l'apprentissage quotidien
Task Board suit les tâches d'étude dans les colonnes À faire, En cours et Terminé, avec des notes, un déplacement par glisser-déposer ou au moyen de commandes accessibles au clavier, et une archive depuis laquelle vous pouvez les restaurer. Les tâches restent dans l'espace de travail actuel et ne nécessitent aucune configuration de modèle.
Calendar regroupe les sessions d'étude personnelles, les événements récurrents et les rappels, avec un export .ics pour Apple Calendar, Google Calendar, Outlook et Thunderbird. Les superpositions de l'espace de travail, comme les dates d'échéance des tâches et les révisions, restent liées à leur espace de travail source.
✍️ Carnet d’apprentissage — Pages, sources et Dito
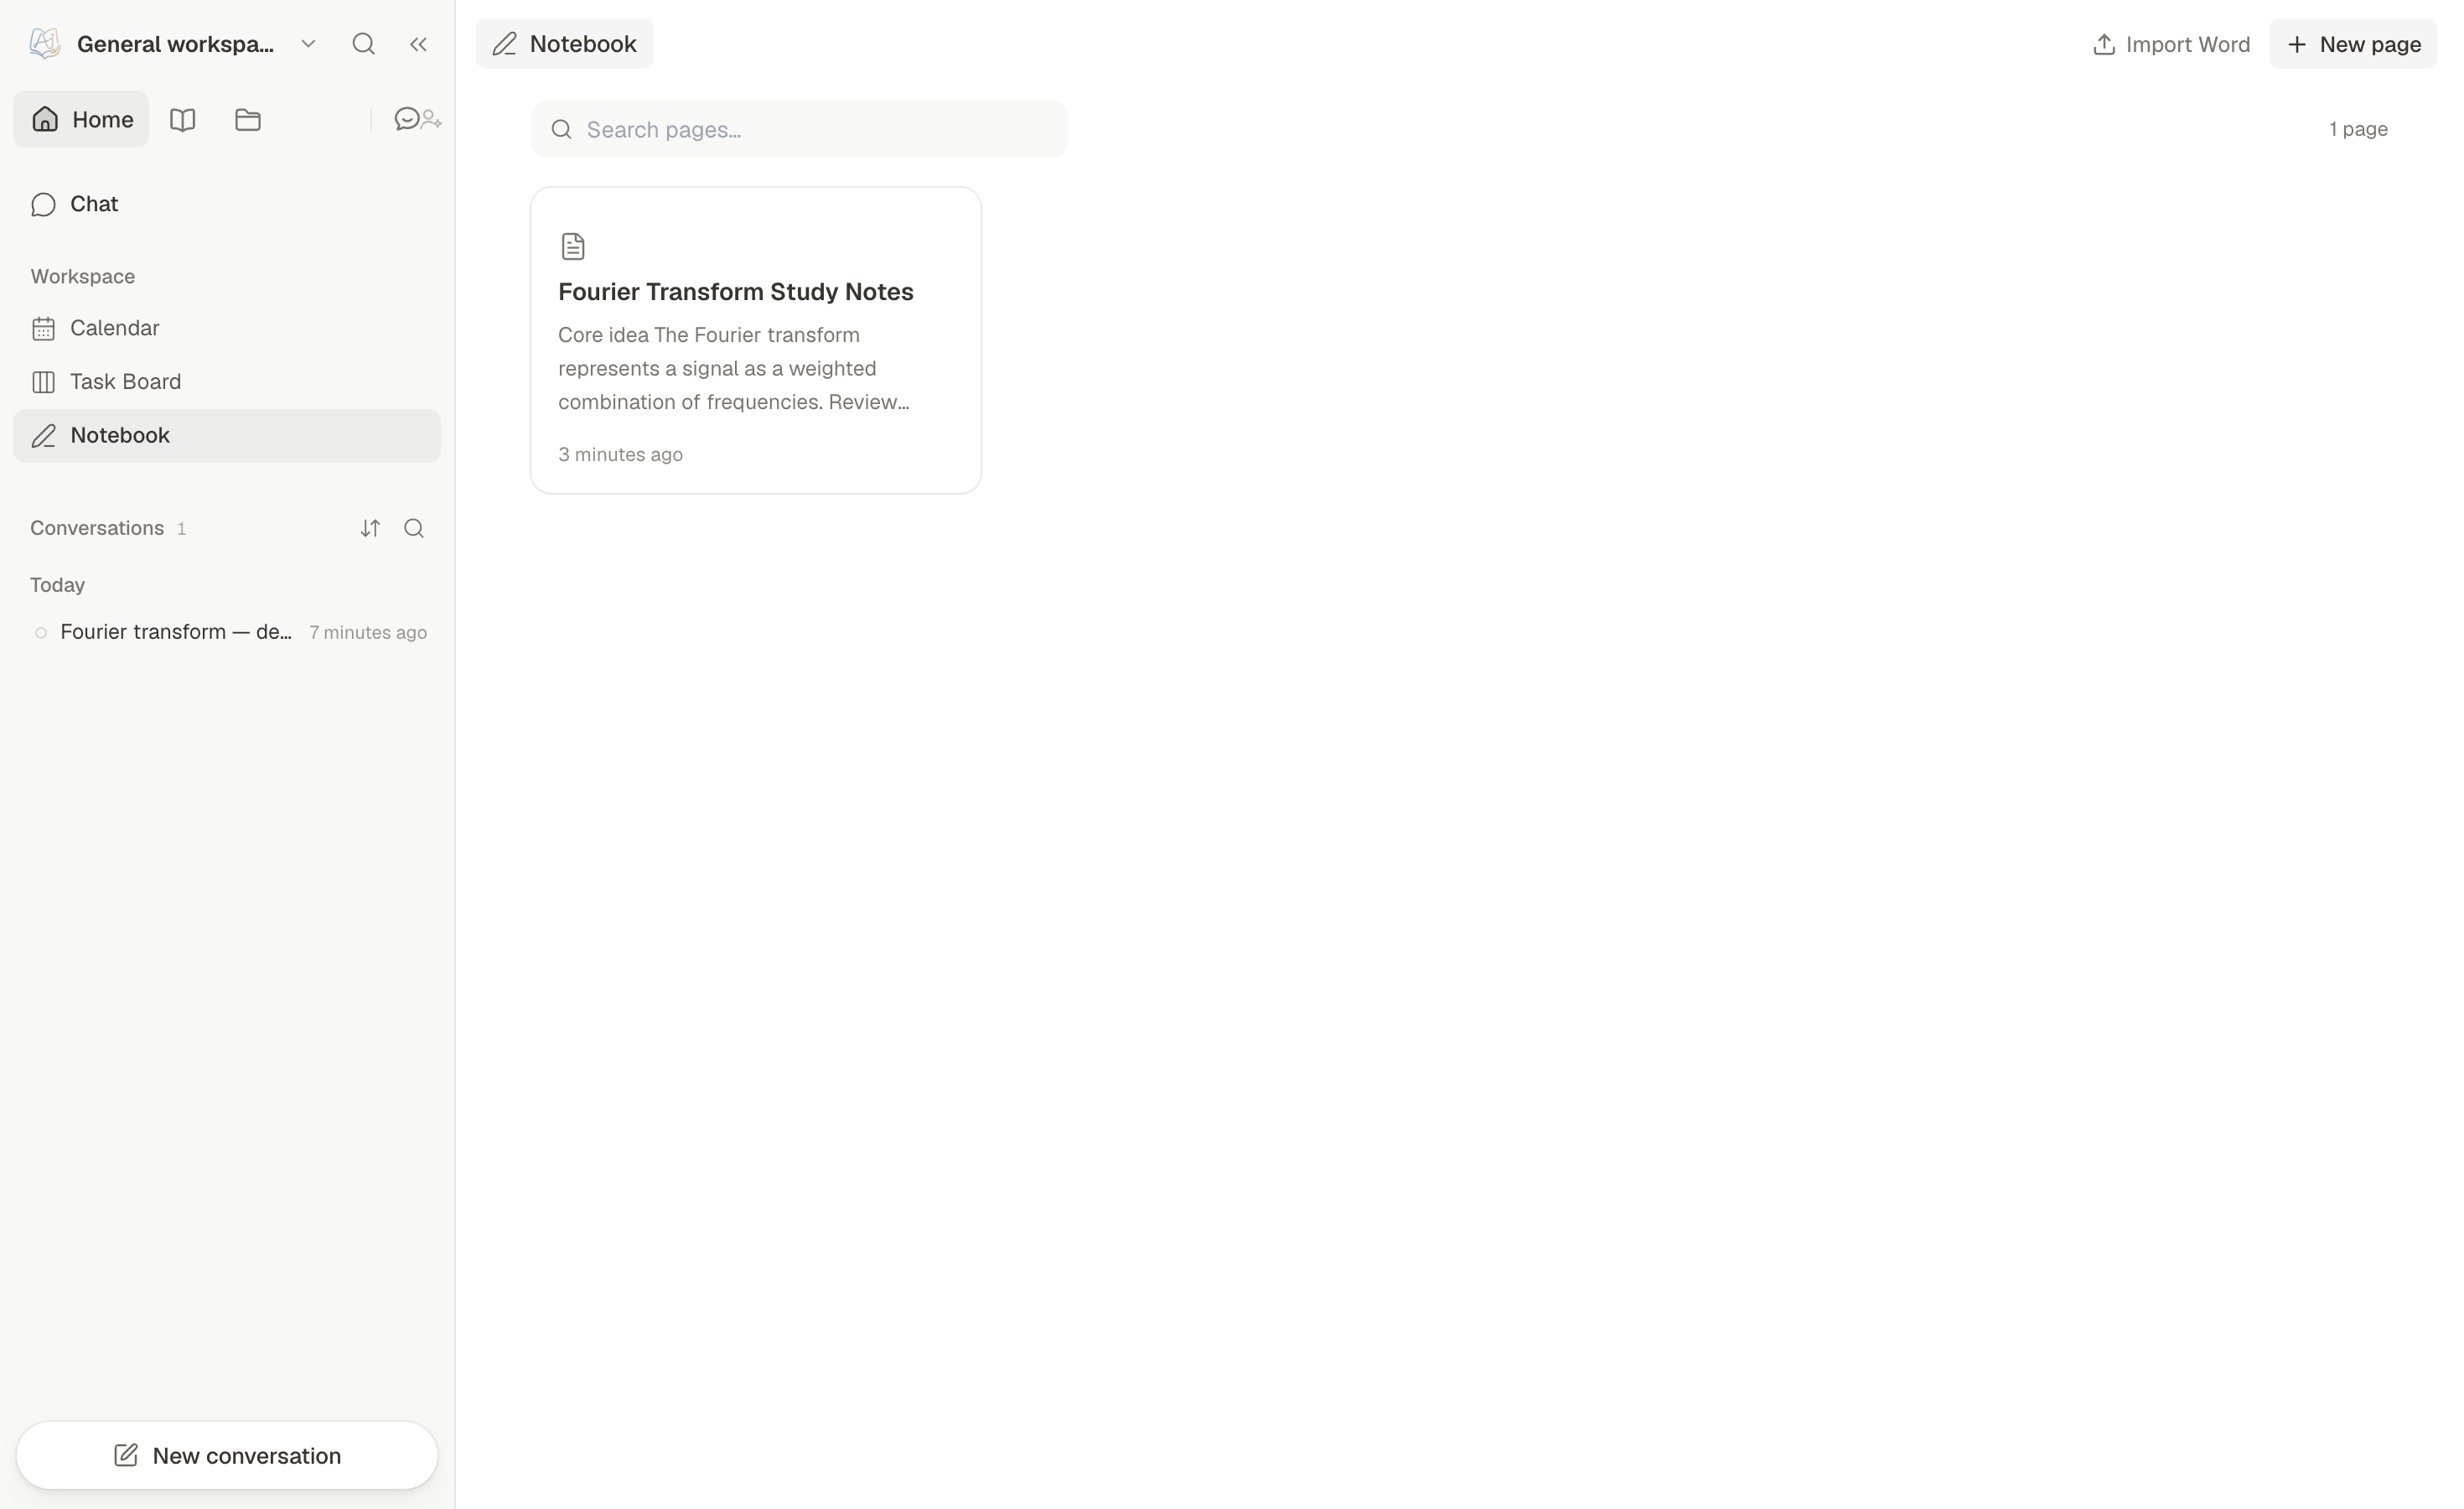
Le carnet d'apprentissage, anciennement Co-Writer, organise vos propres écrits en pages, sous-pages et blocs dans l'espace de travail actif. Importez des documents Word, organisez une arborescence de pages et insérez des enregistrements originaux des Favoris comme preuves. Les pages affichent leur état d'enregistrement et s'exportent en Markdown ou en Word ; le contenu interactif devient statique dans Word.
Exporter les cartes mémoire vers Anki. Les pages du carnet peuvent contenir des Flash Cards. Sur une page qui en contient, ouvrez le menu de la page et choisissez Exporter les cartes mémoire (Anki). Dans la file de révision du carnet, choisissez Tout exporter pour Anki. Dans Anki, utilisez Fichier → Importer et sélectionnez le fichier .txt téléchargé. Les cartes arrivent dans un paquet nommé DeepTutor::<note title> avec les champs recto/verso, les tags et les formules mathématiques préservés. Réimporter le même fichier met à jour les cartes existantes au lieu de les dupliquer. Le calendrier de révision propre à DeepTutor n'est pas inclus.
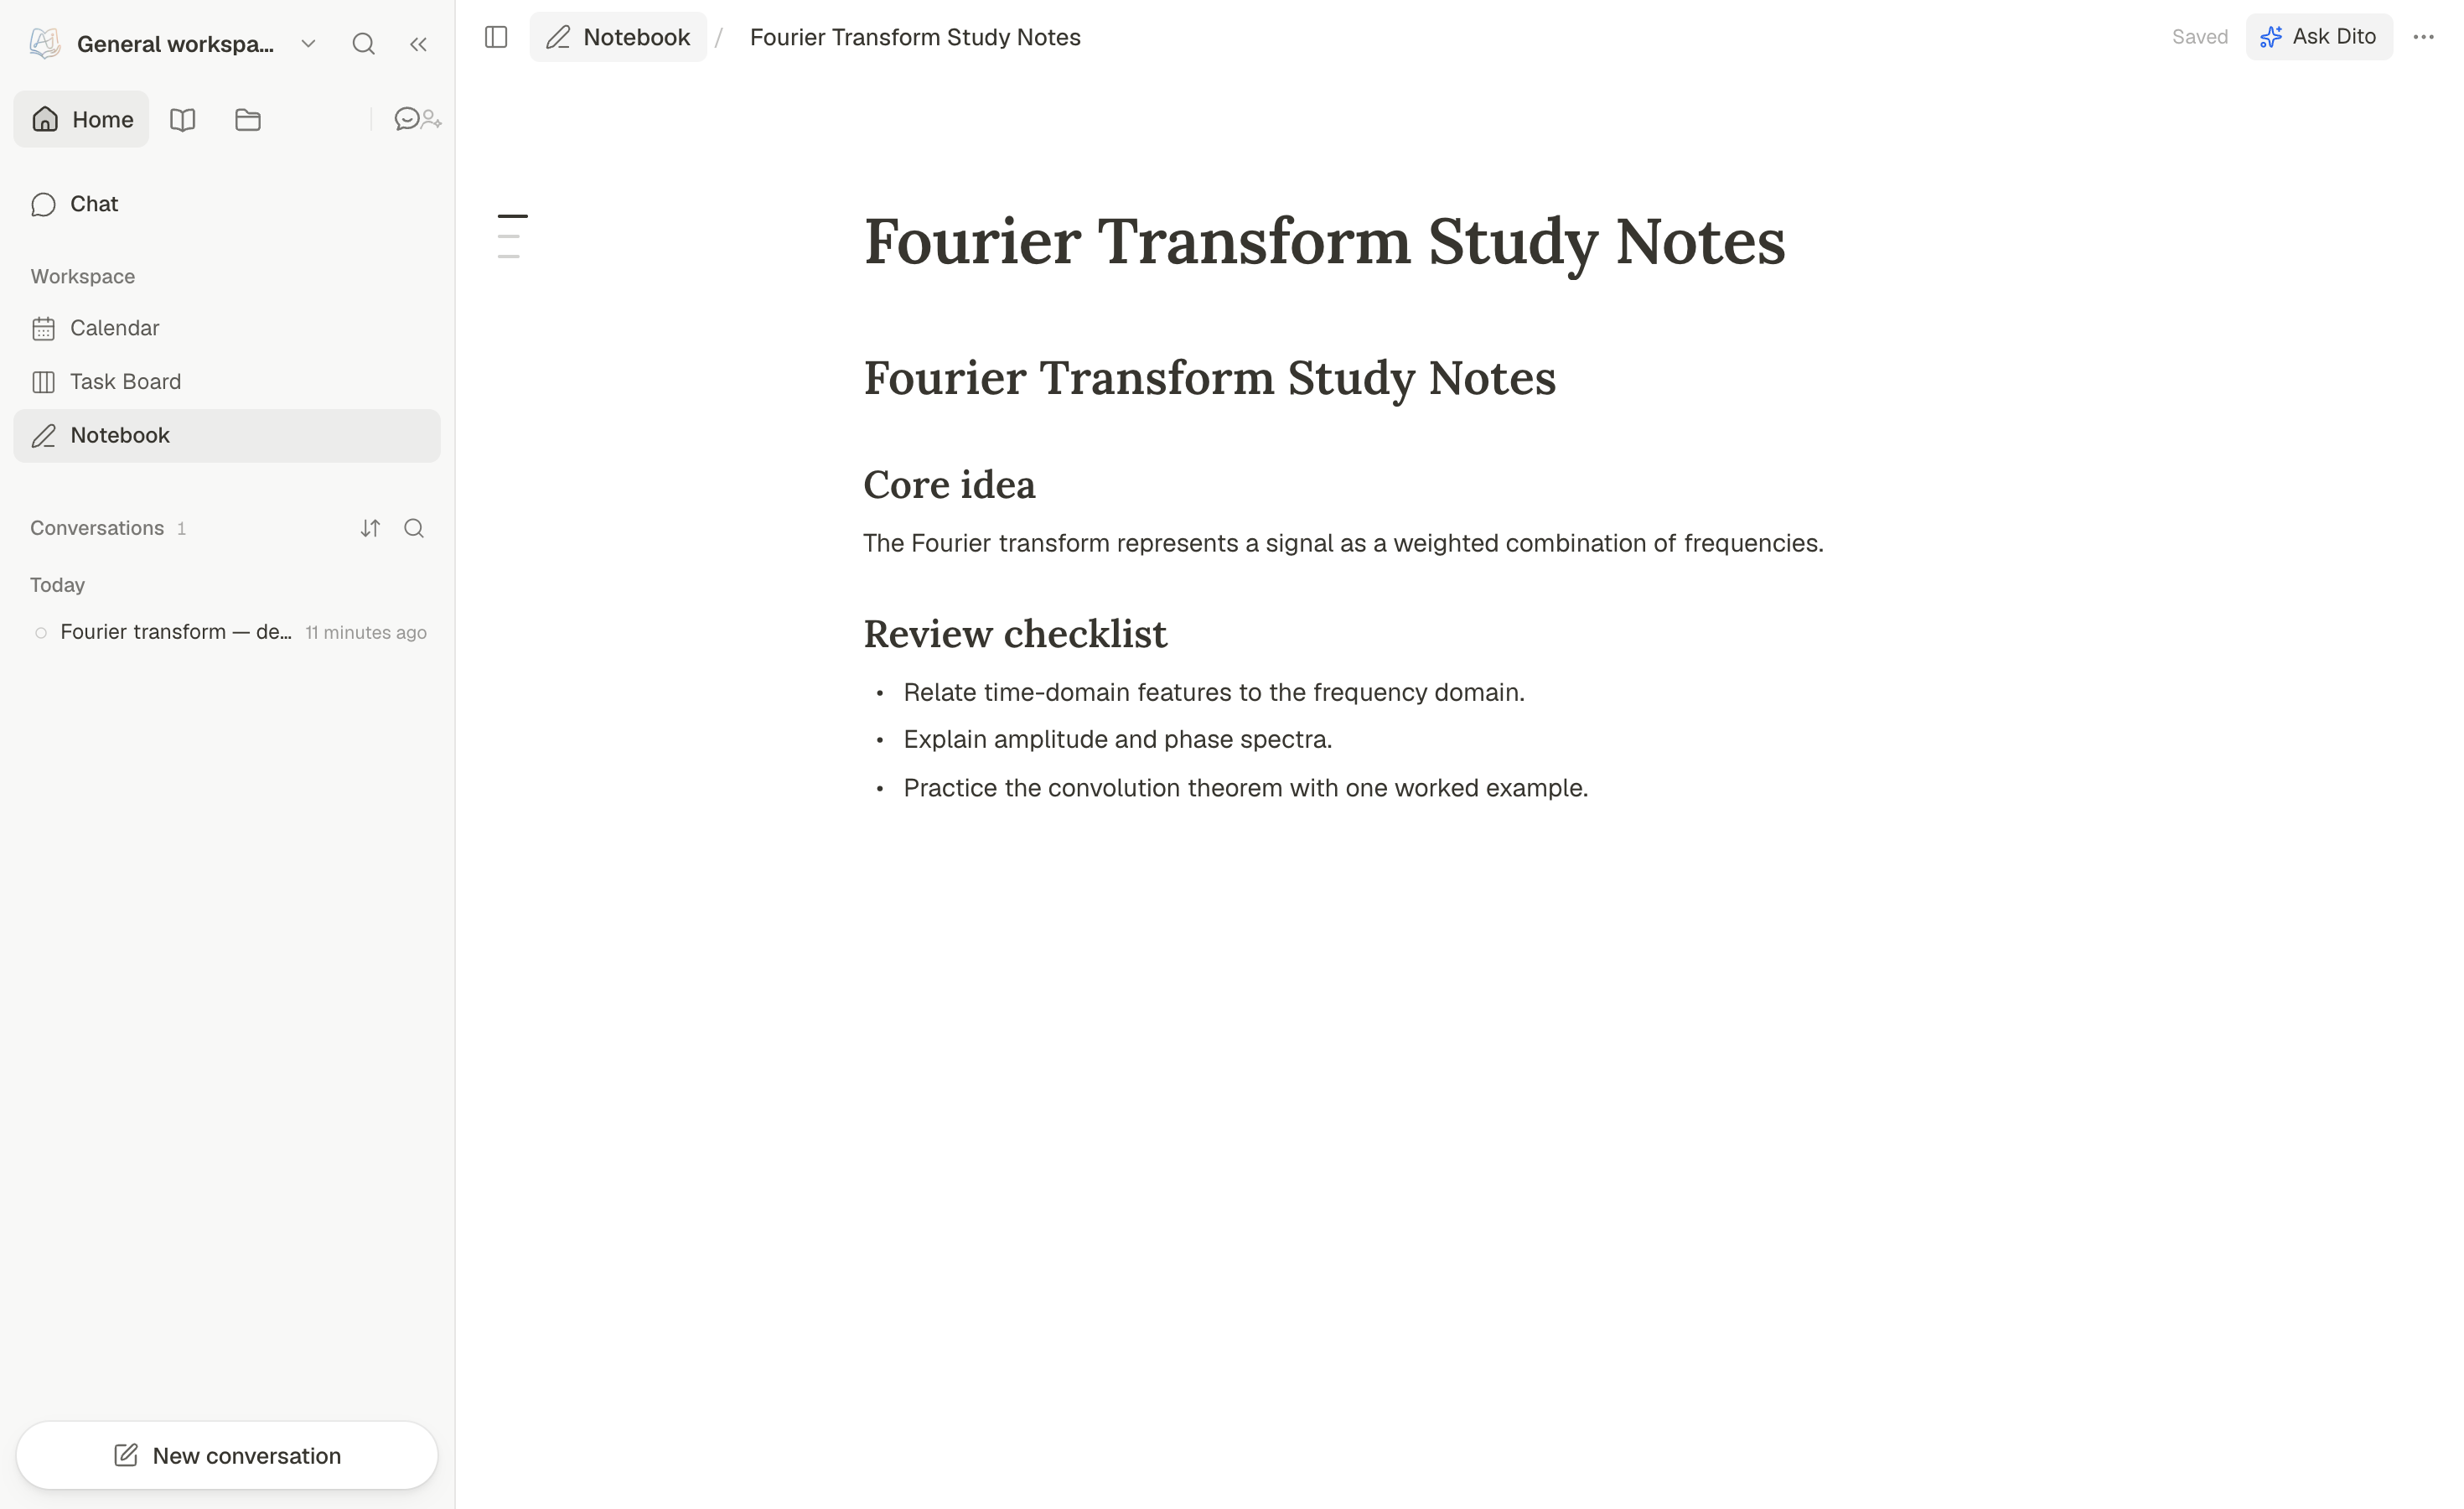
Discutez d'un passage ou d'un bloc avec Dito : demandez une explication, un exemple, une réécriture ou une question d'entraînement. Les conversations restent attachées à la page et à la ligne concernées. Examinez les modifications proposées avant de les accepter, ou insérez une réponse sous la ligne et poursuivez votre travail. Les Favoris préservent les enregistrements sources ; le carnet est l'endroit où vous construisez votre propre compréhension.
🎓 Apprentissage — Livres, parcours, lecture et pratique
Apprentissage est la zone d'étude de l'espace de travail actuel. Créez une activité depuis Apprentissage → Nouvel apprentissage, puis rouvrez-la depuis Tous les apprentissages avec sa progression, ses conversations et son contexte source intacts.
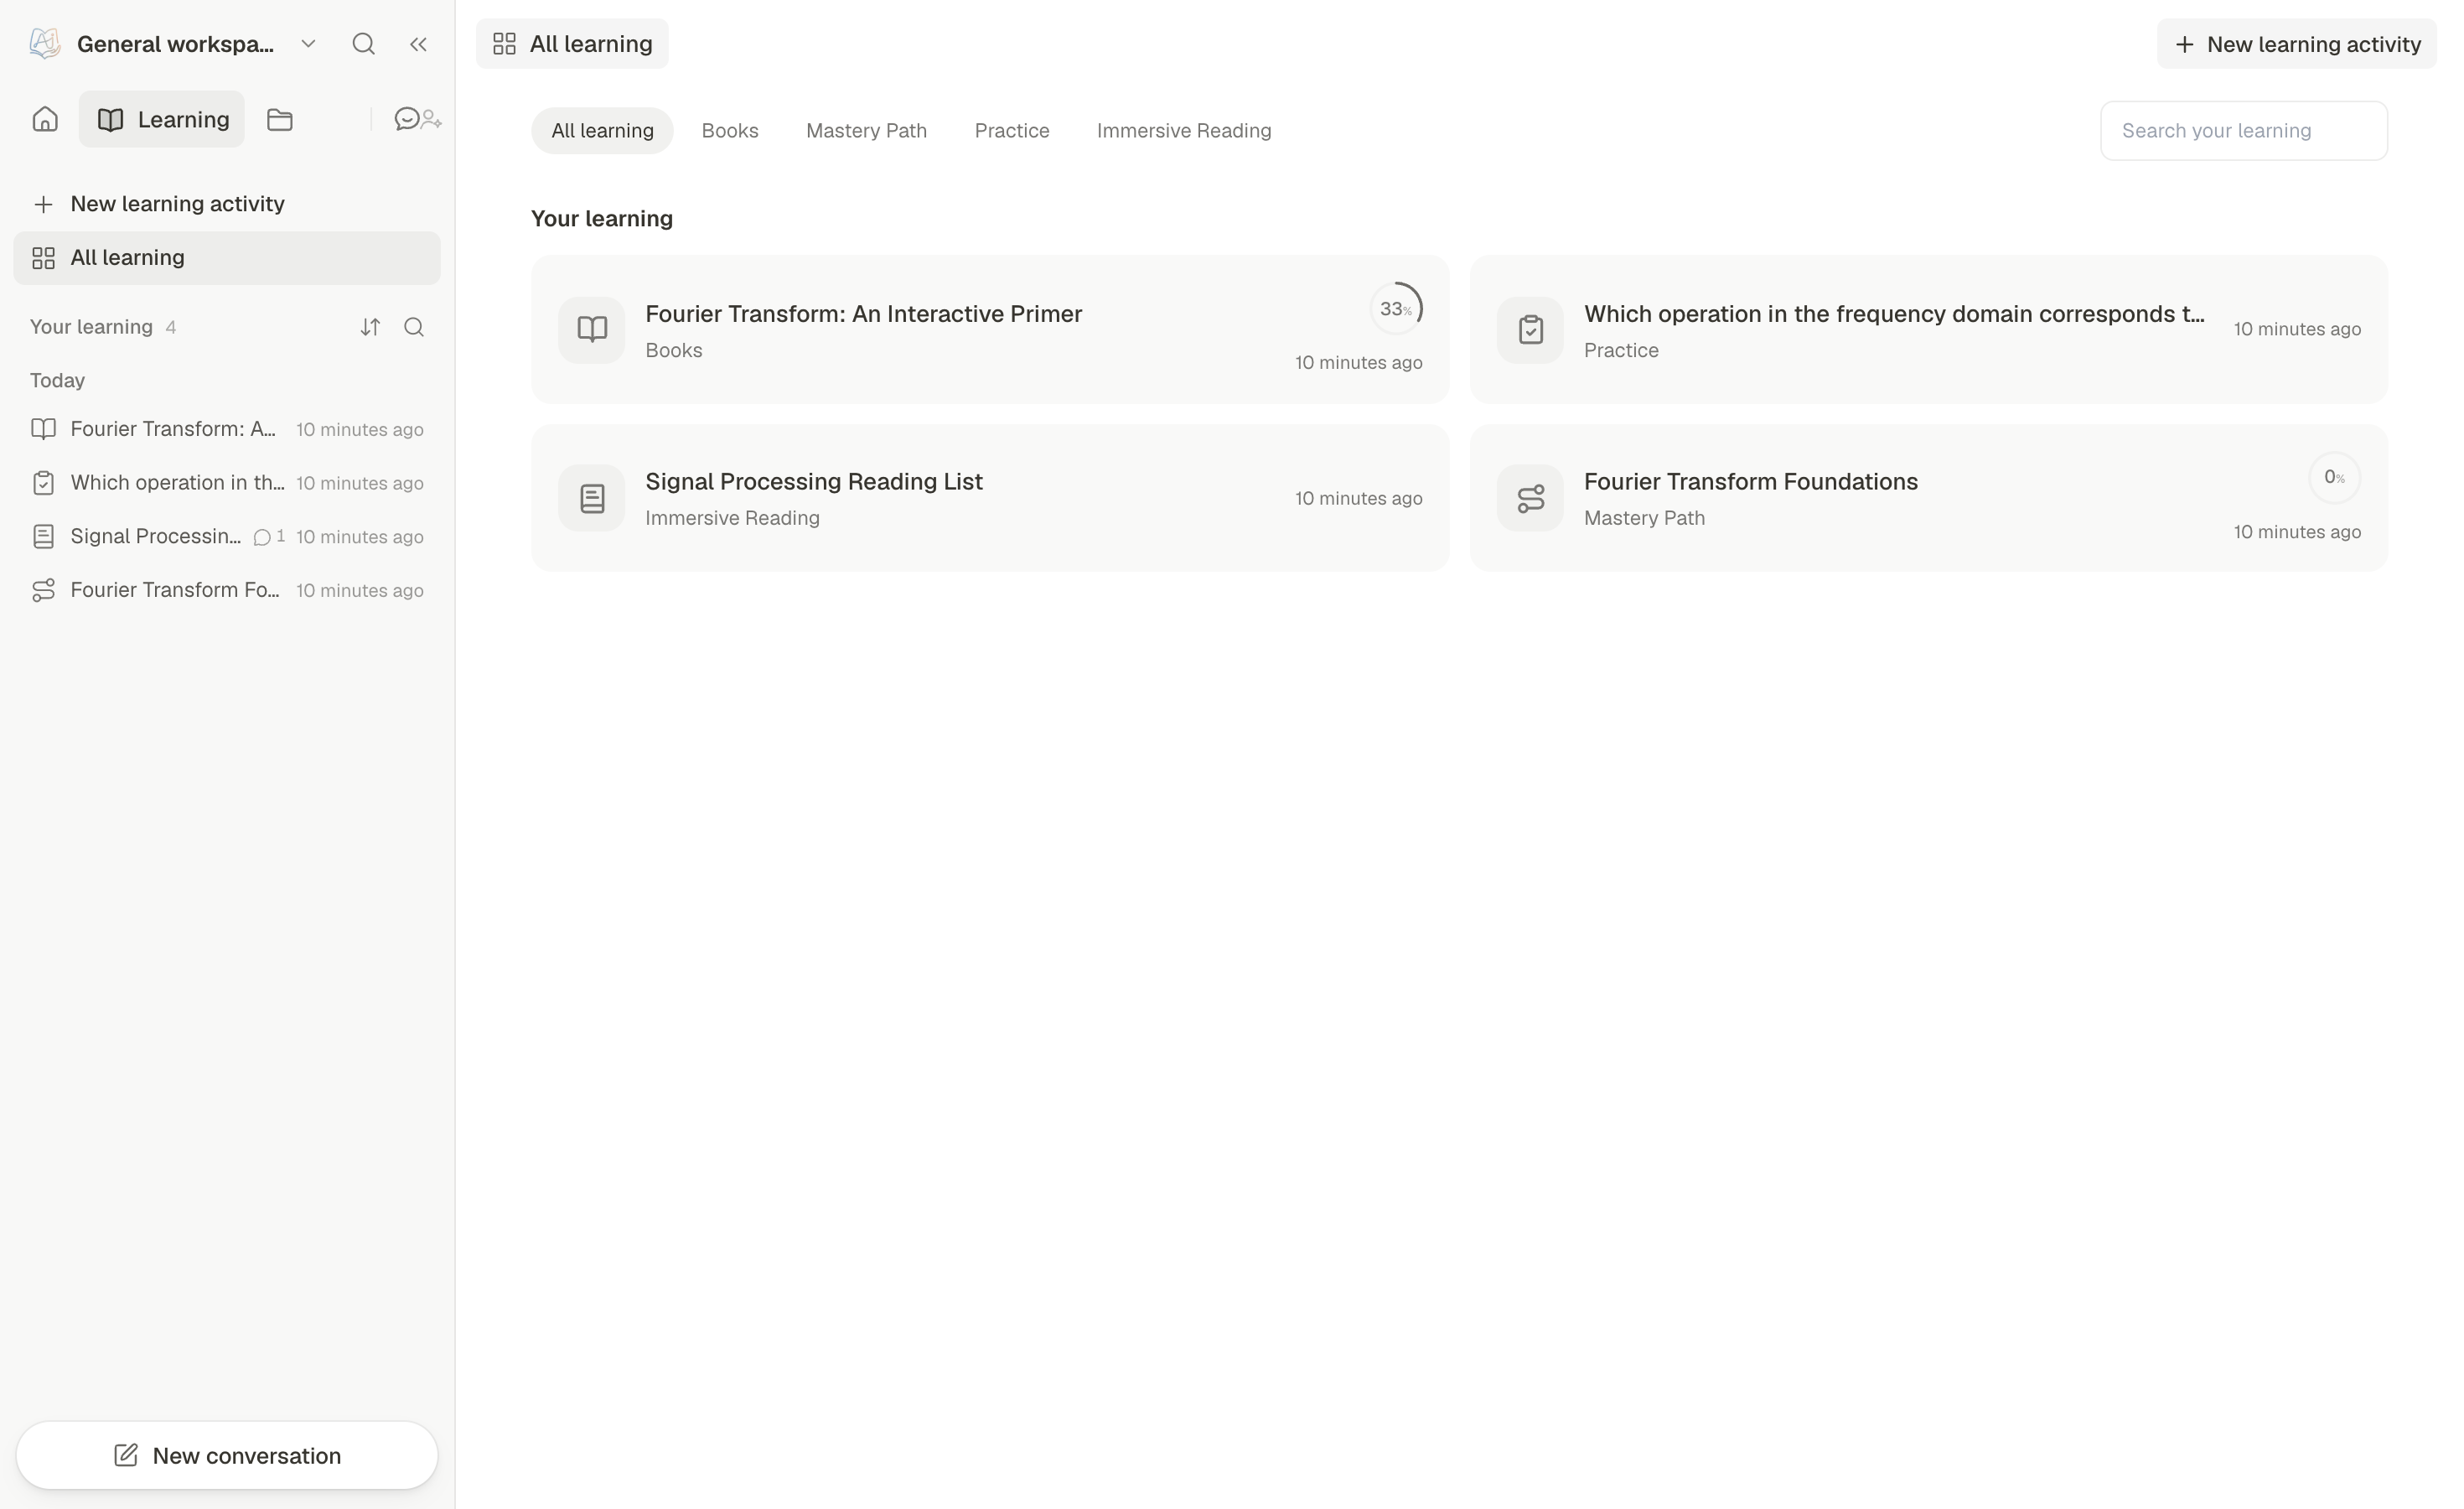
| Activité | Utilisation | Ce que vous conservez |
|---|---|---|
| Book | Créer un livre structuré et interactif à partir de sources sélectionnées | Chapitres modifiables, blocs typés, progression de lecture et Chat de Page |
| Mastery Path | Décomposer un objectif d'apprentissage en sujets et en étude guidée | Carte des points de connaissance, conversations par sujet et preuves de maîtrise |
| Immersive Reading | Travailler aux côtés d'un document, d'une page Web, d'une vidéo ou d'une source audio | Conversations liées aux sources, citations vérifiées, surlignages, notes et progression |
| Practice | Réviser des questions collectées ou importées | Réponses, erreurs, évaluations de rappel et prochaine date de révision |
📖 Book — Livres Vivants depuis Vos Matériaux
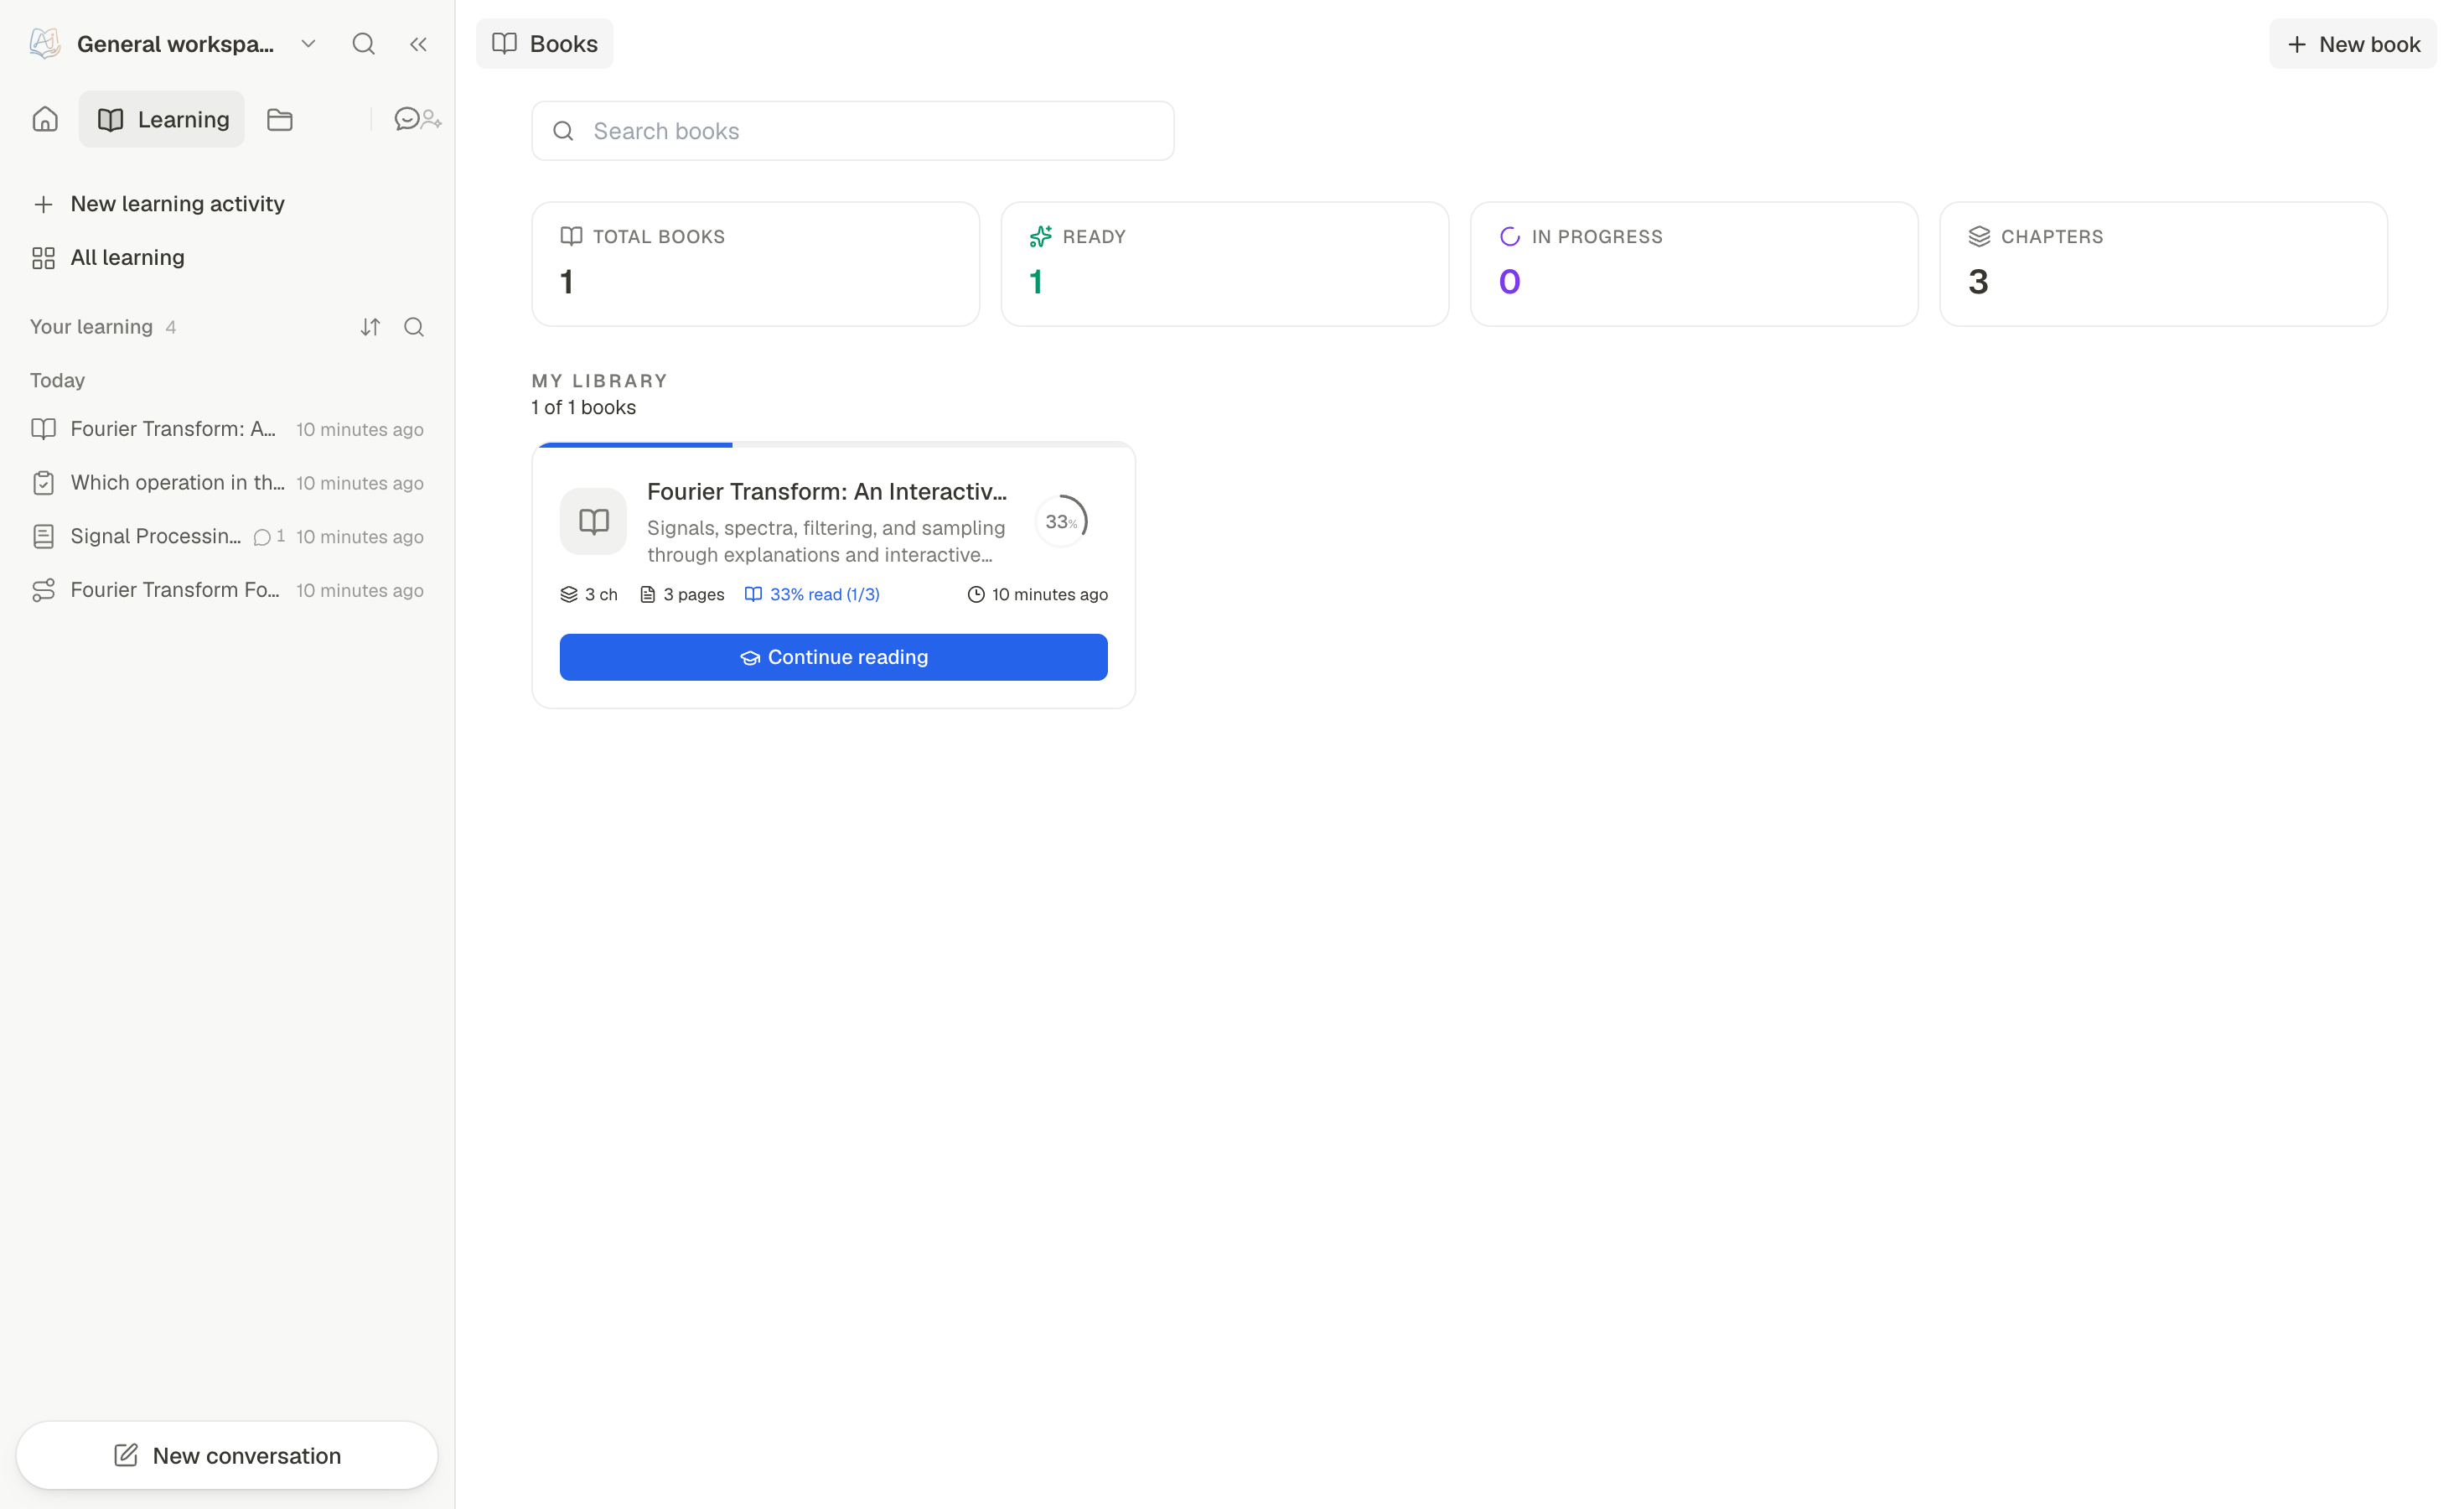
Book transforme des sources sélectionnées en un livre vivant interactif — pas un PDF statique, mais un environnement de lecture construit à partir de blocs typés. Un livre peut démarrer depuis des bases de connaissances, des Favoris, des banques de questions ou l'historique de chat ; le flux de création propose un plan de chapitre avant que le contenu soit généré, vous pouvez donc revoir la forme au lieu d'accepter une sortie en un seul coup aveugle.
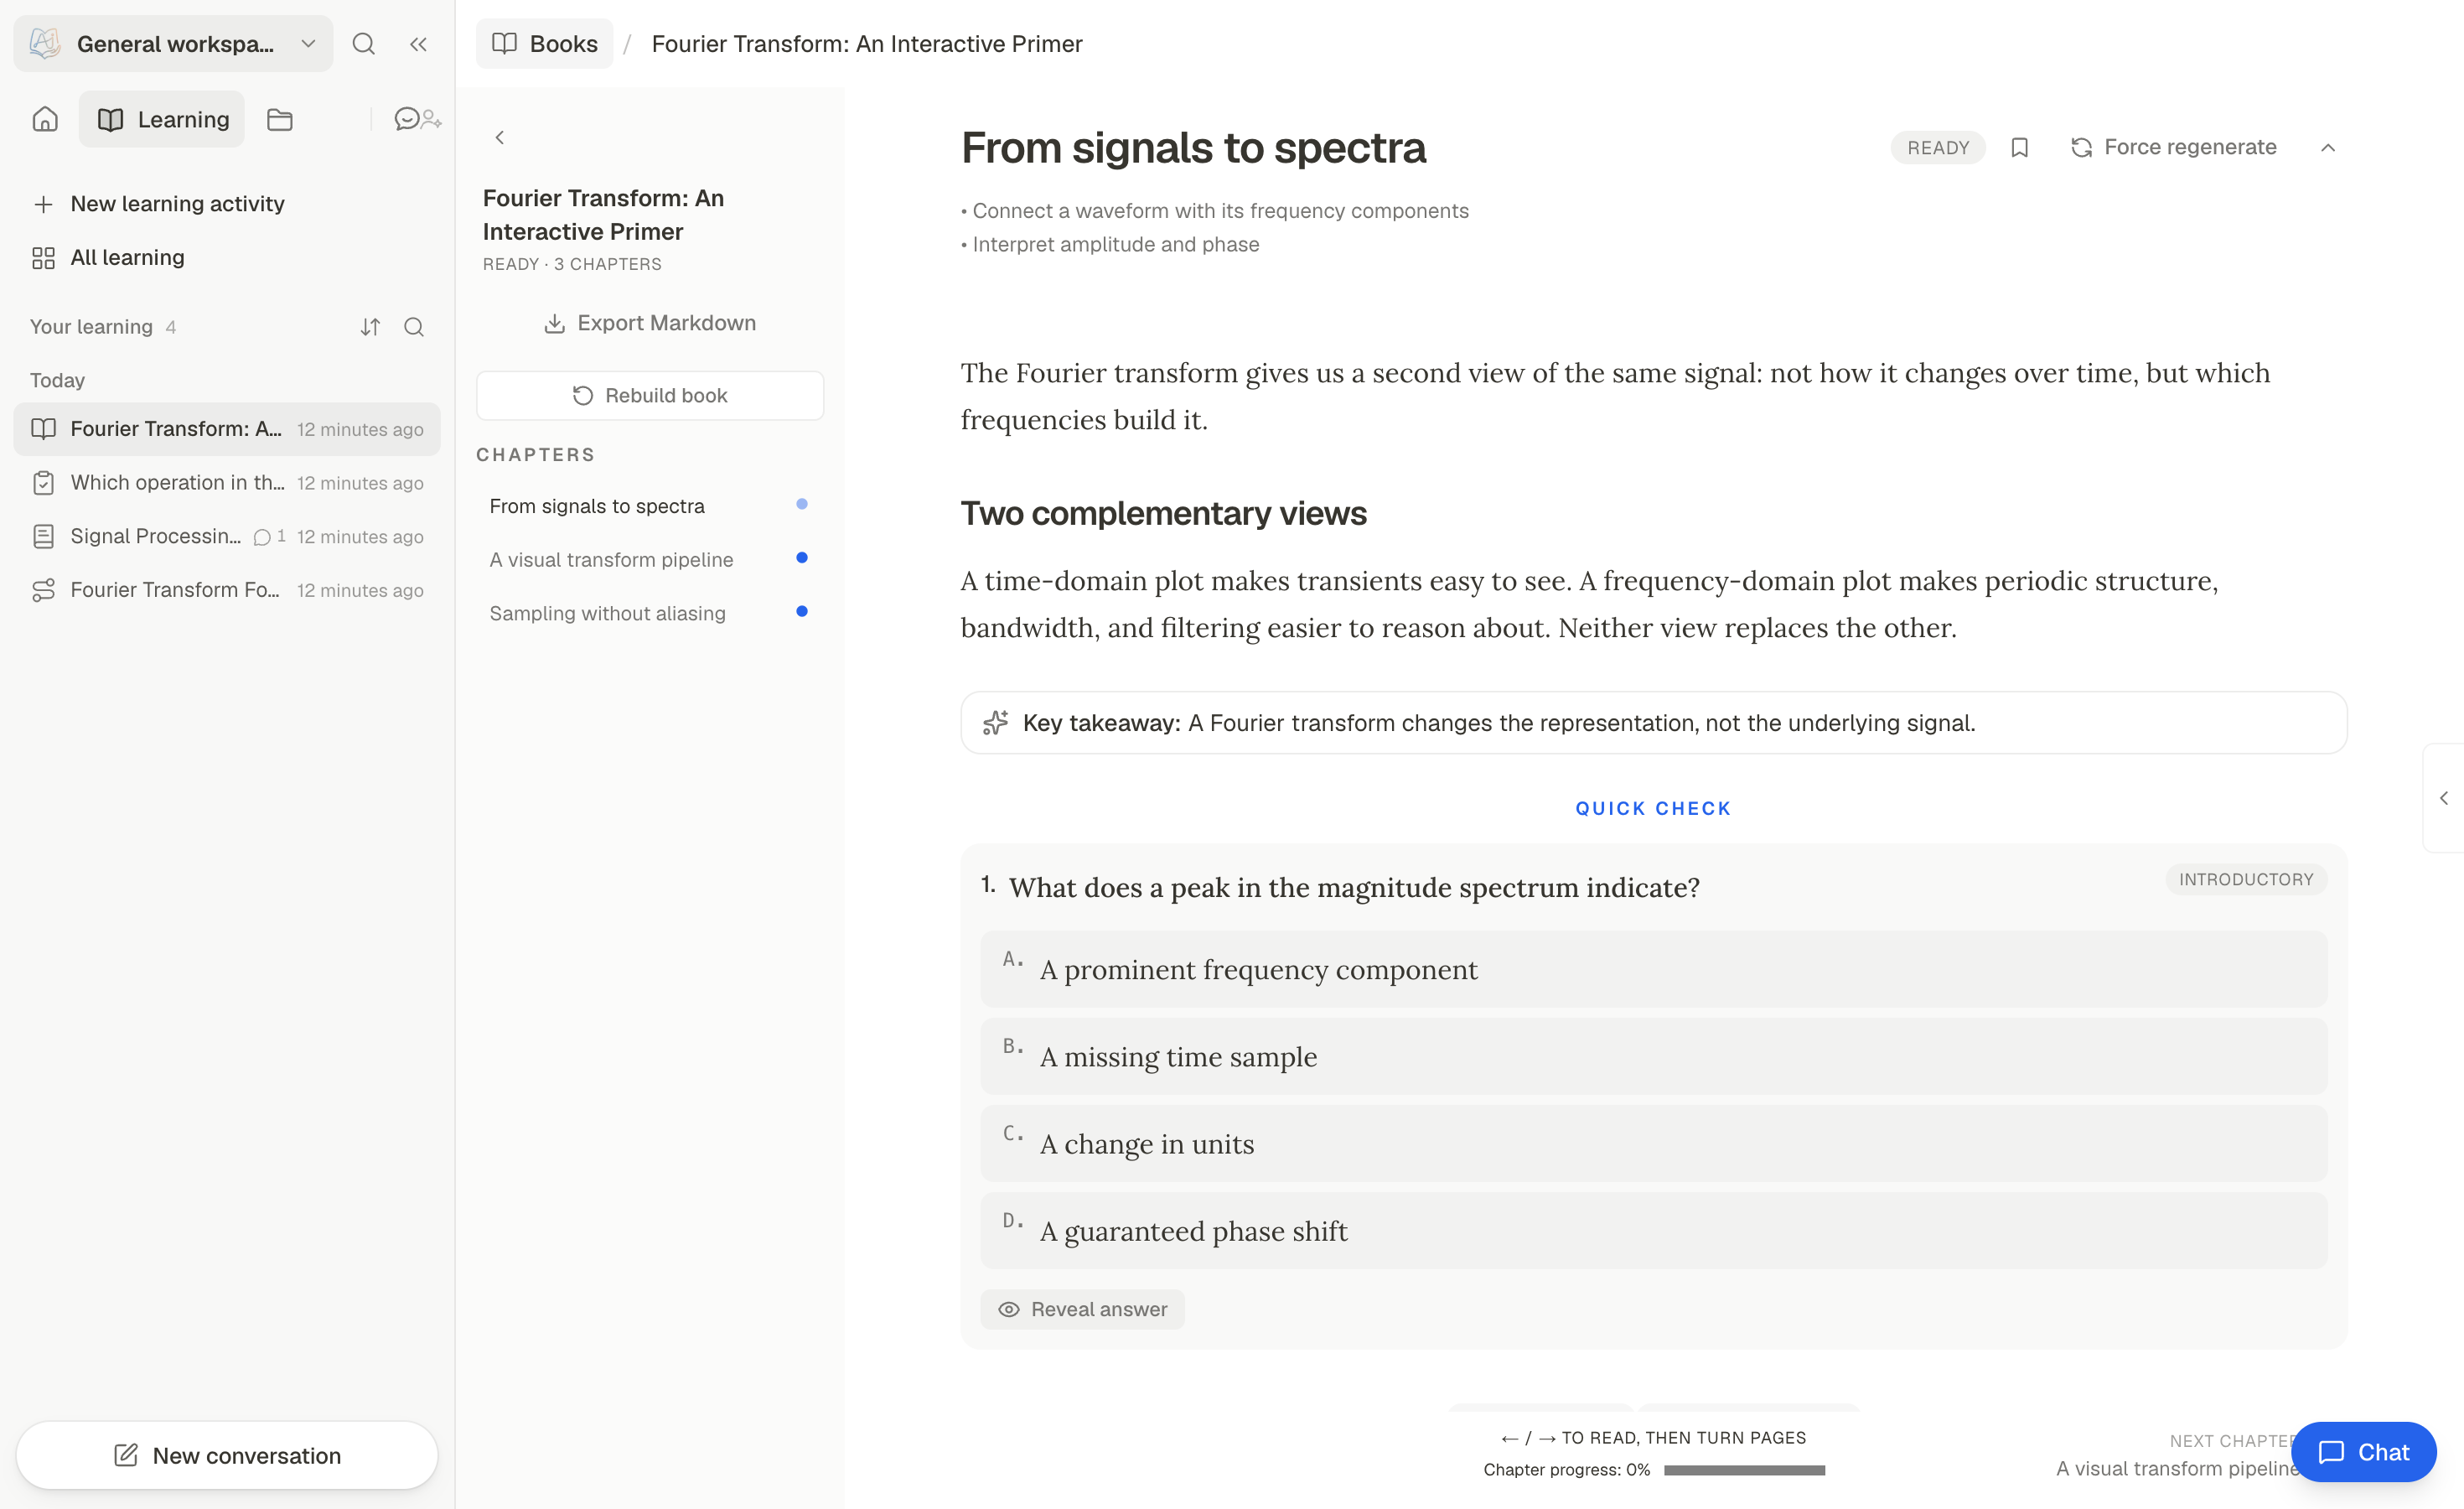
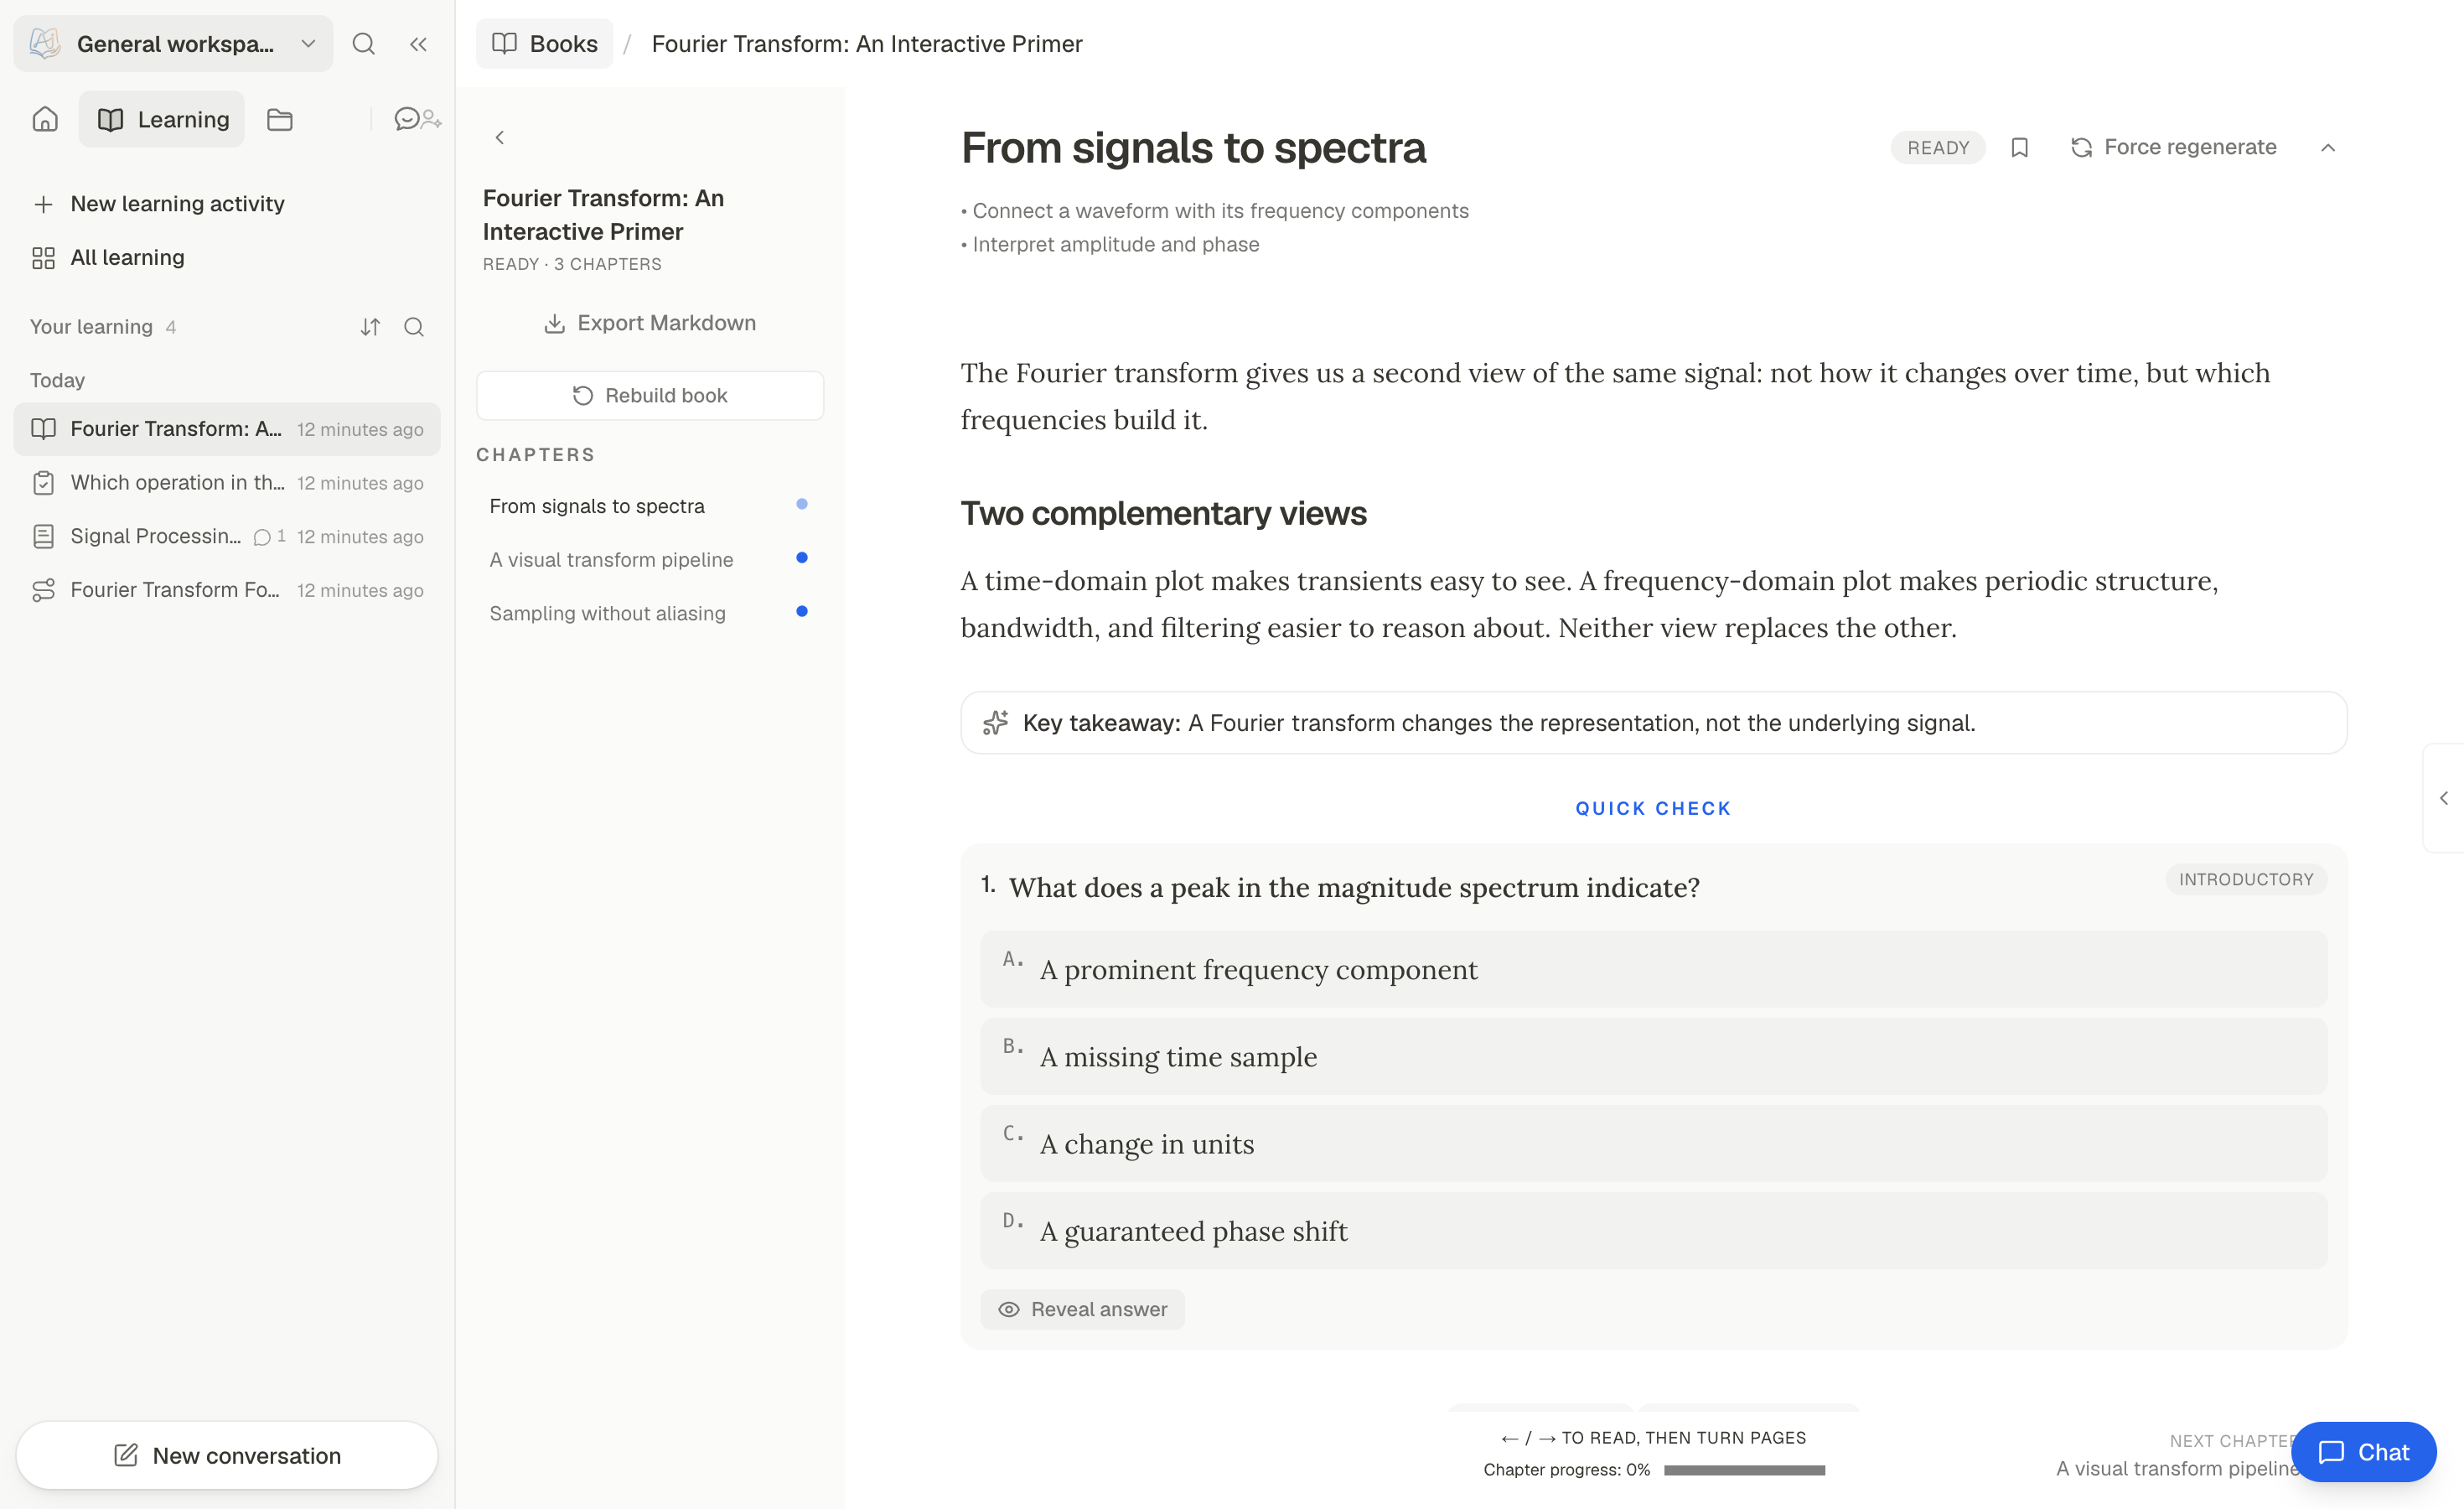
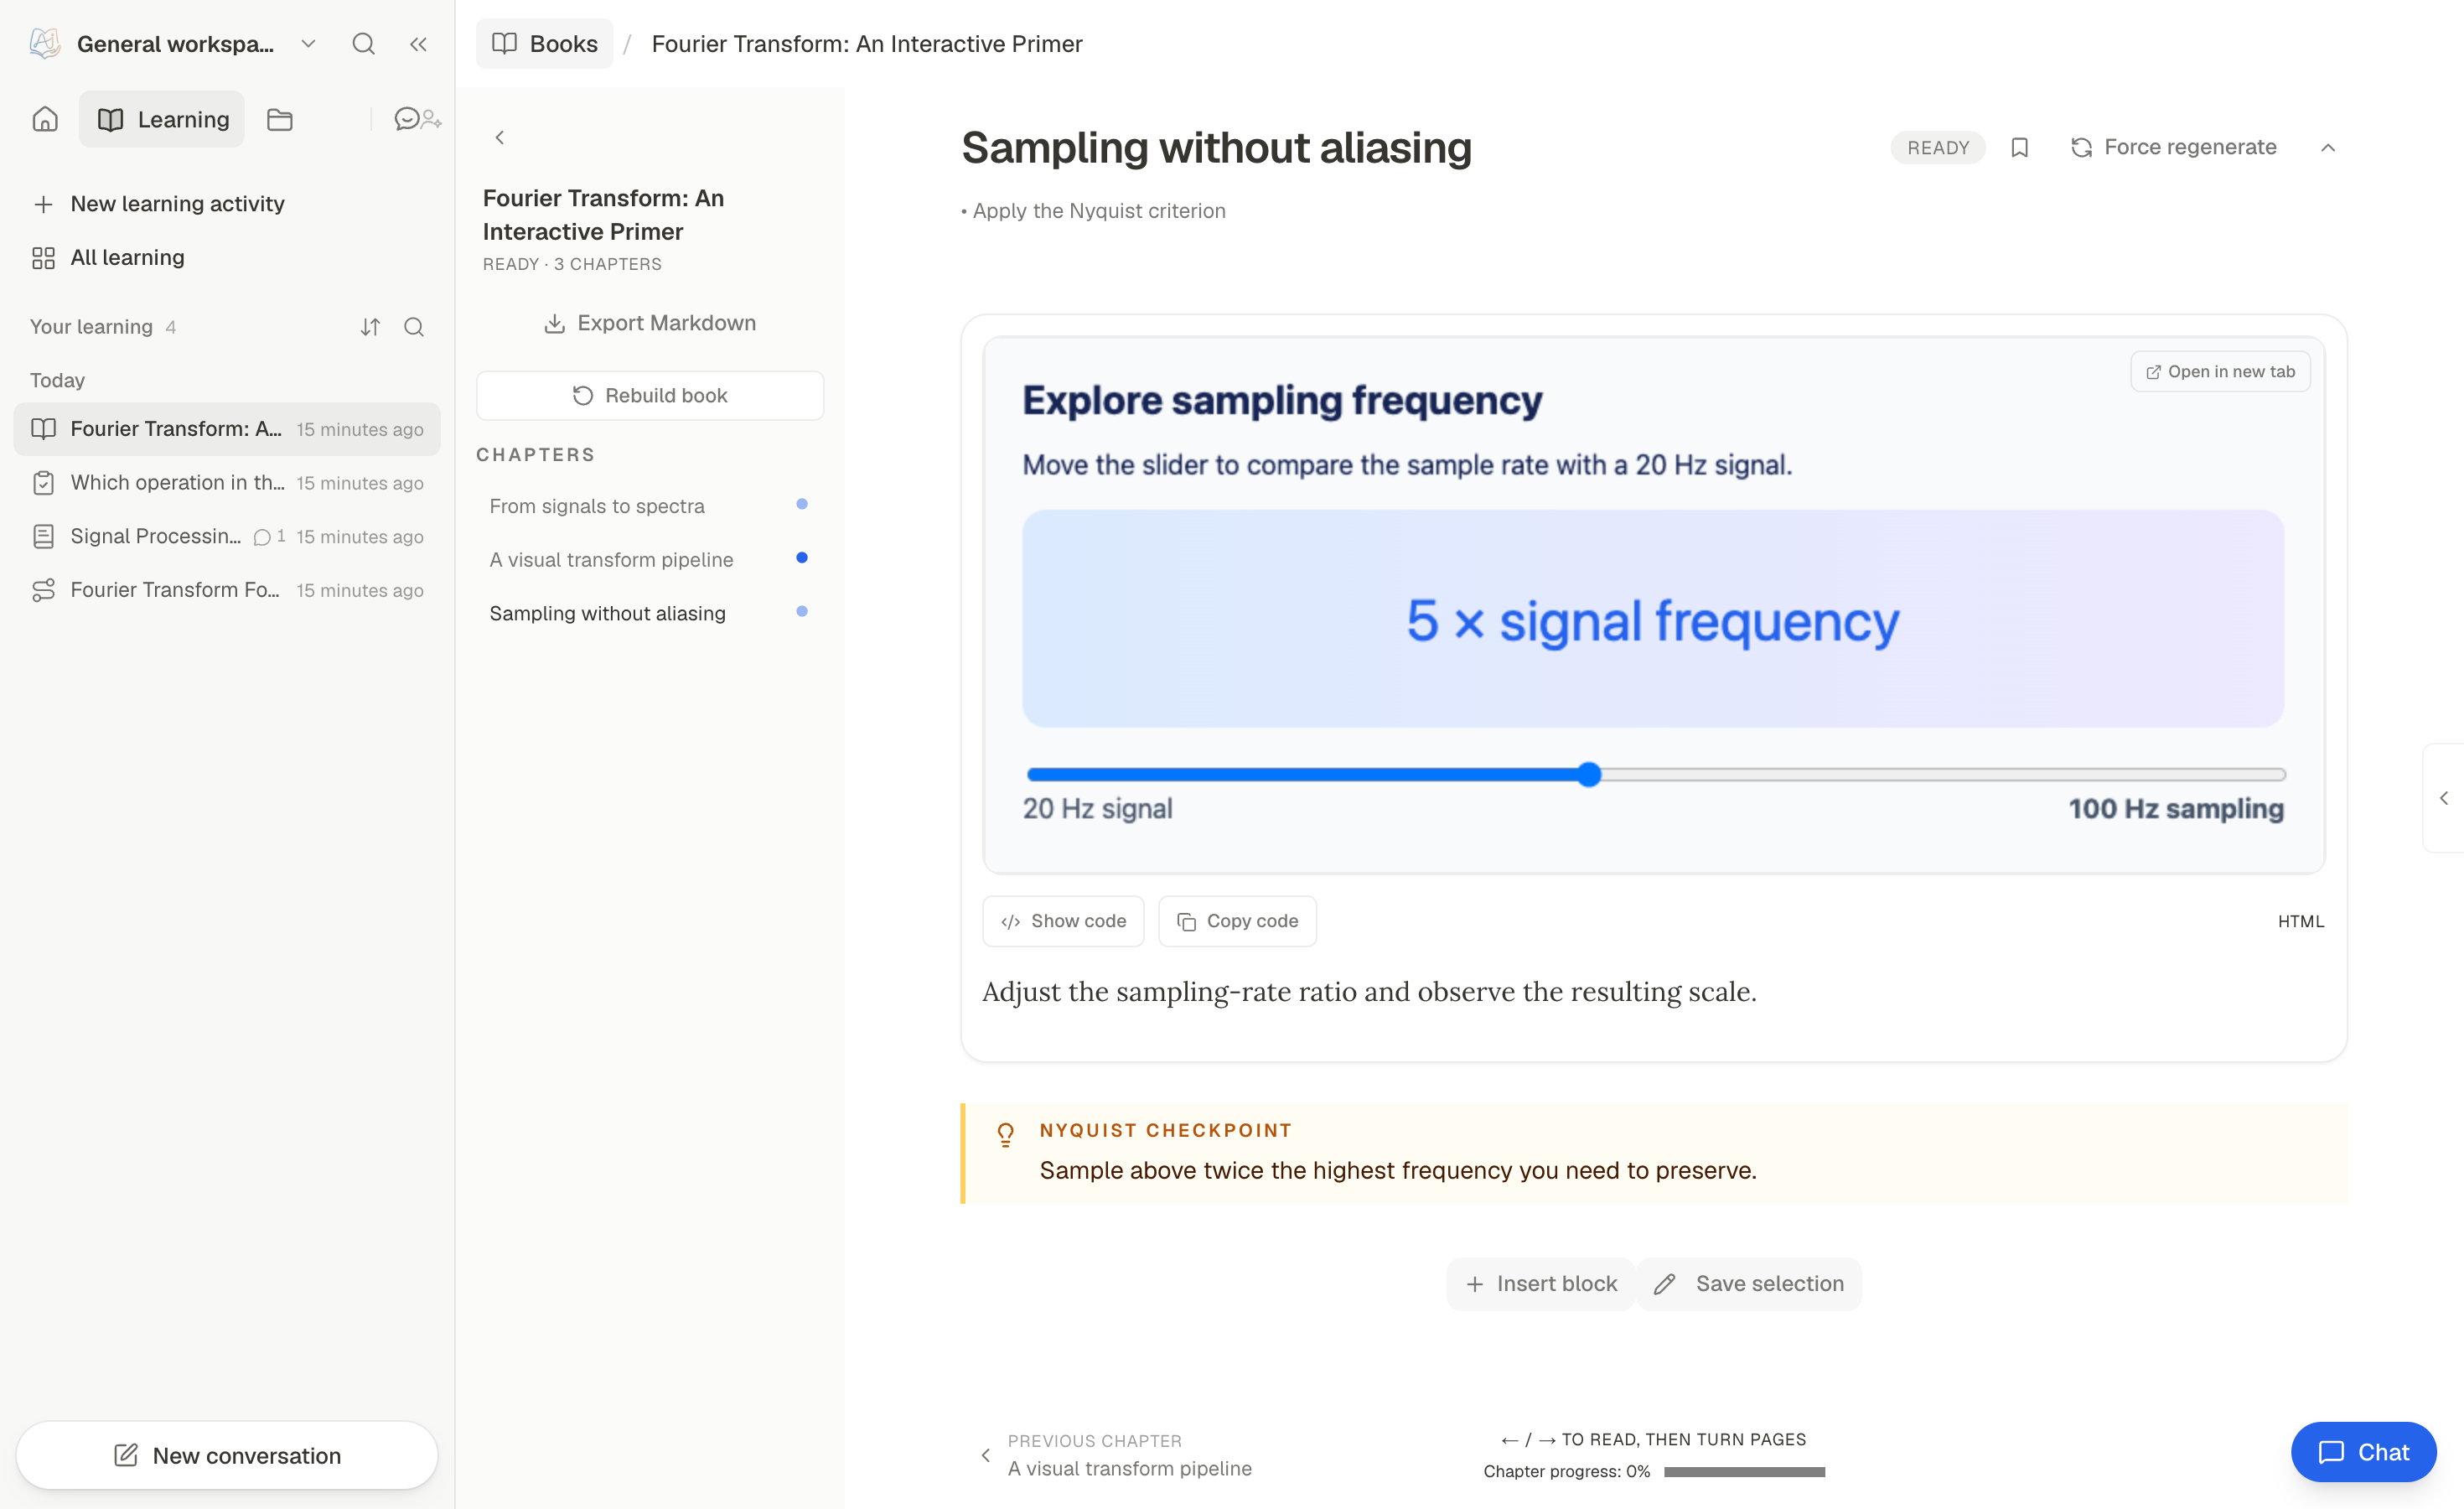
Chaque chapitre se compile en blocs typés modifiables — texte, encadrés, quiz, fiches, chronologies, code, figures, HTML interactif, animations, graphes de concepts, approfondissements et notes utilisateur — avec son propre Chat de Page. Insérez, déplacez, régénérez, réécrivez ou changez le type d'un bloc ; les passages sélectionnés alimentent une boîte de réception de captures d'apprentissage à valider. La progression, les signets, les tentatives de quiz, les captures et le Chat de Page restent privés pour chaque lecteur, même lorsqu'un livre administrateur est partagé en lecture seule ou en édition collaborative ; la suppression d'un livre partagé reste réservée à l'administrateur. Tout livre s'exporte en Markdown, les compilations longues se mettent en pause et reprennent, deeptutor book health signale les sources qui ont divergé et deeptutor book refresh-fingerprints actualise la référence des sources.
🗂️ Ressources — Supports et enregistrements d'apprentissage sauvegardés
Ressources est la bibliothèque réutilisable de l'espace de travail actuel. Conservez-y les supports originaux, les résultats enregistrés et les enregistrements d'apprentissage afin de pouvoir les joindre à de nouvelles conversations et activités sans mélanger les projets.
📚 Knowledge Center — Bibliothèques RAG Multi-Moteur
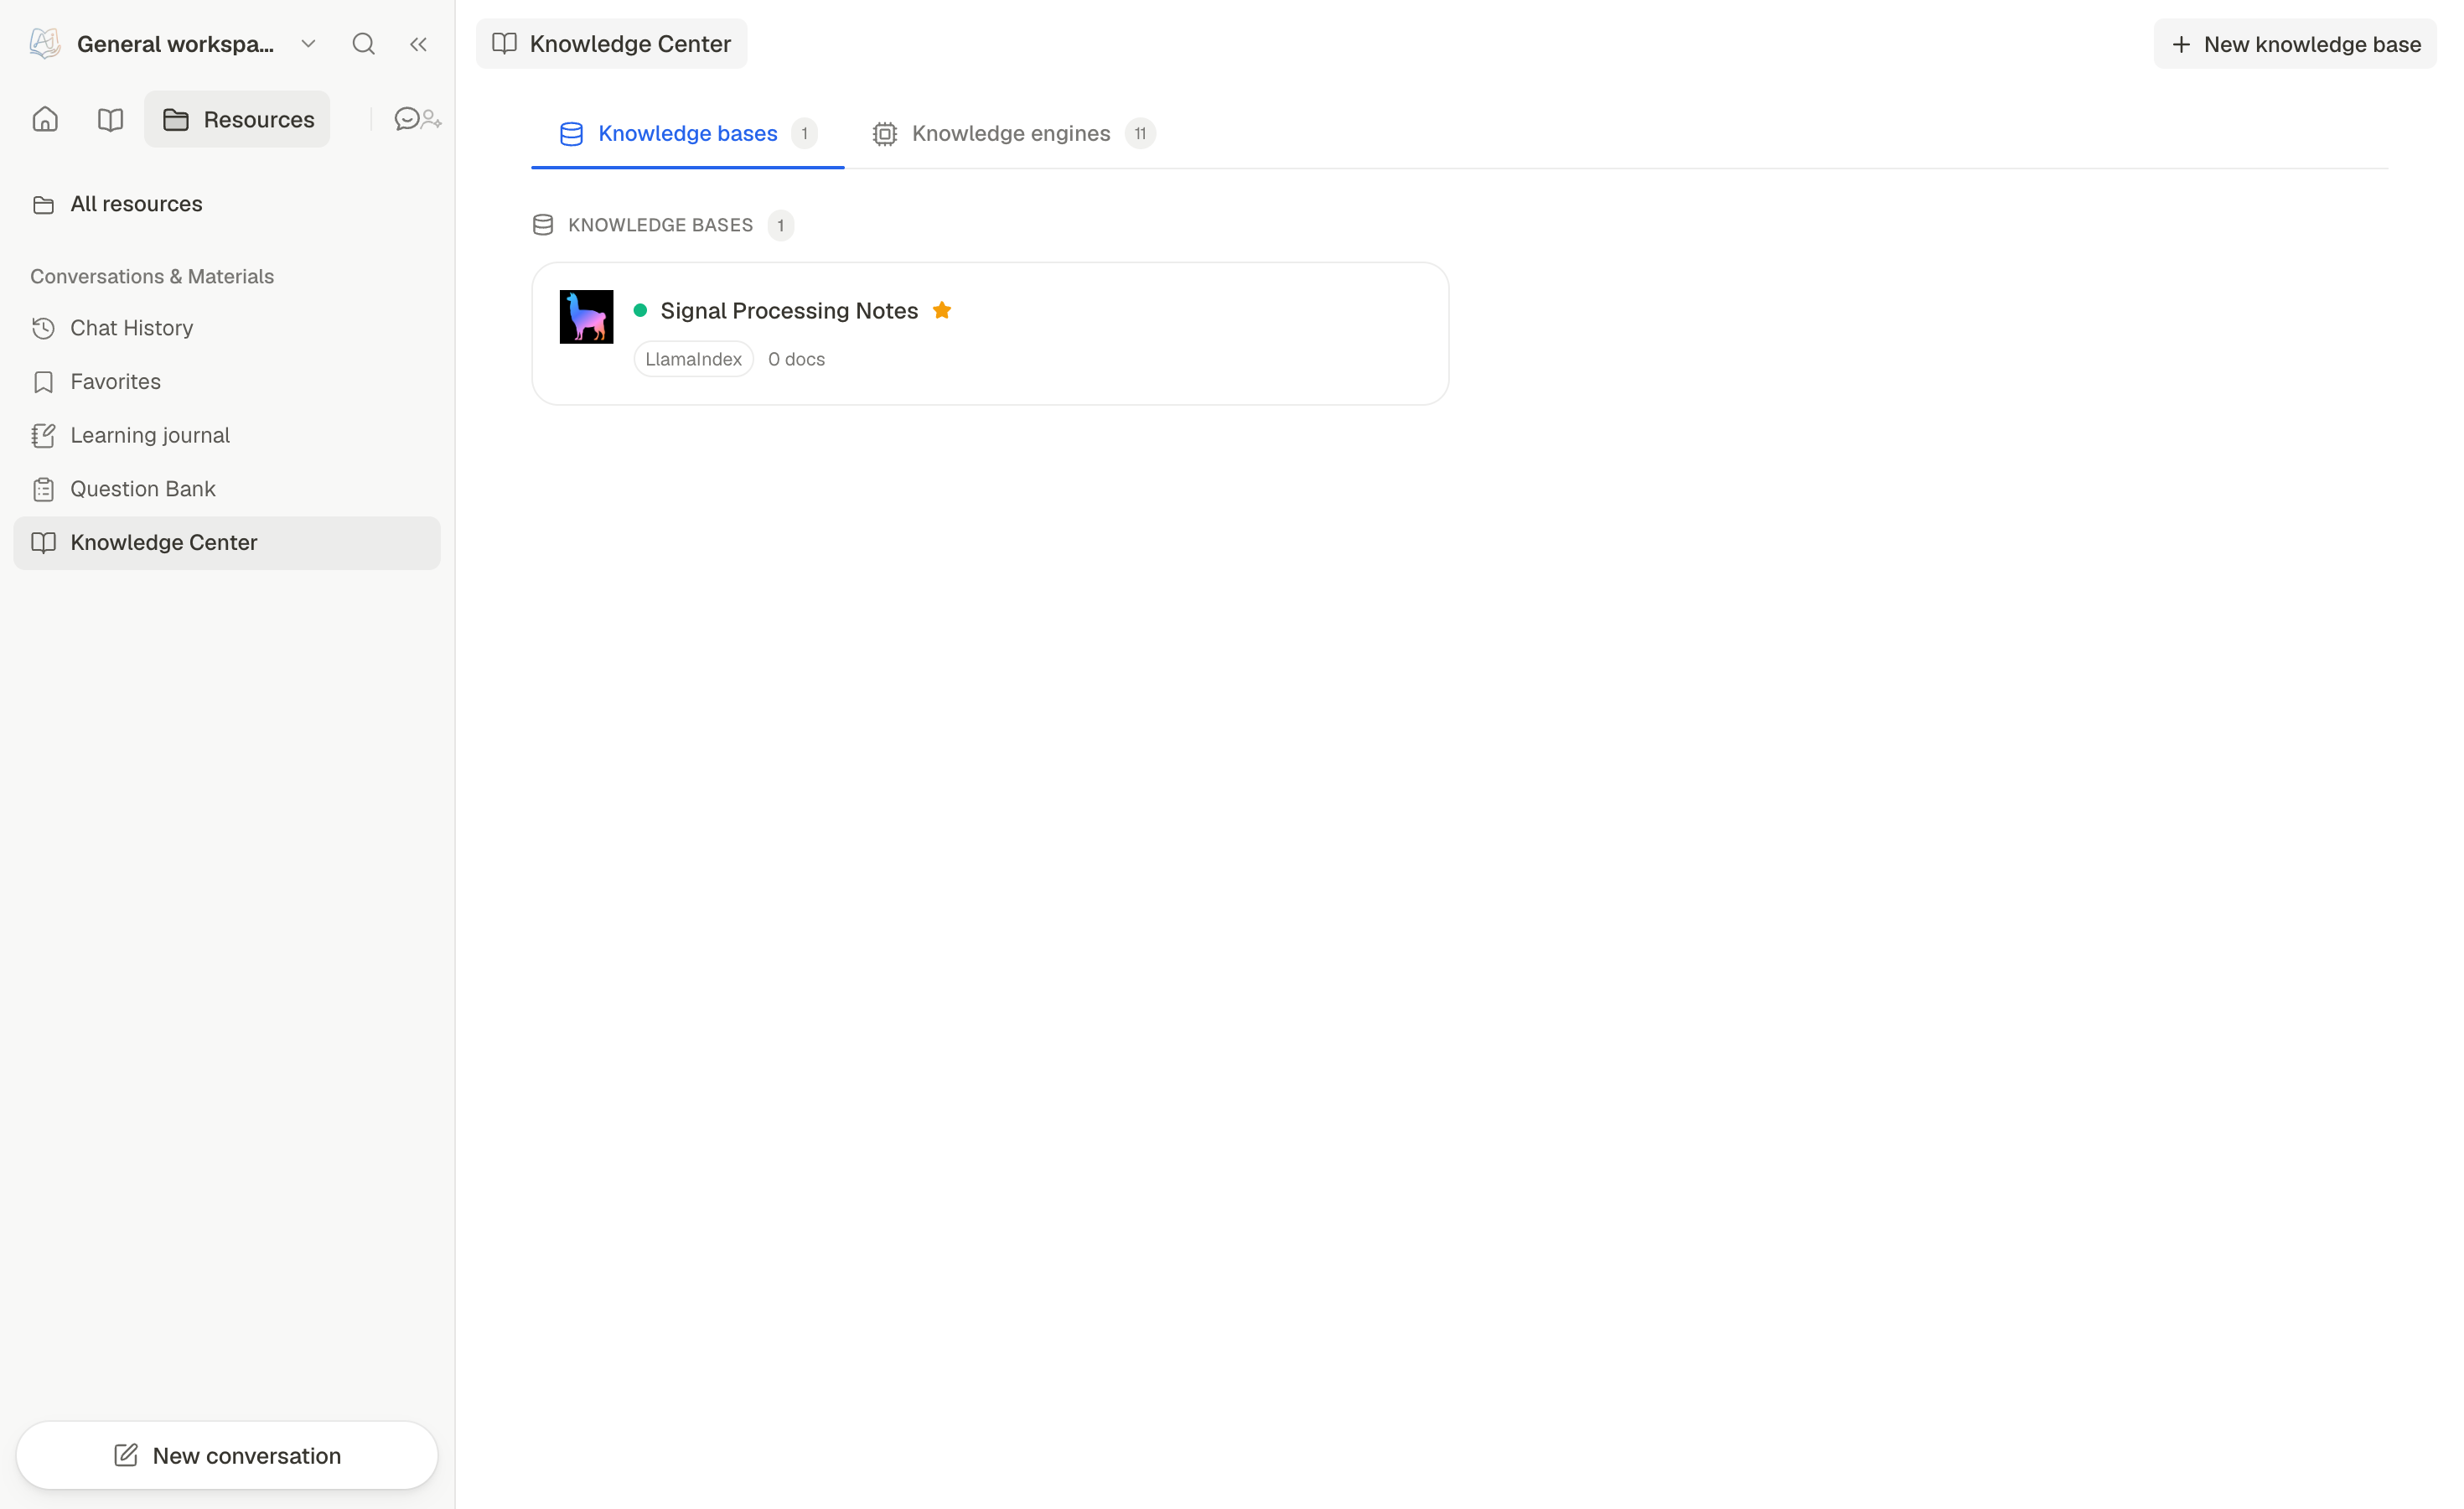
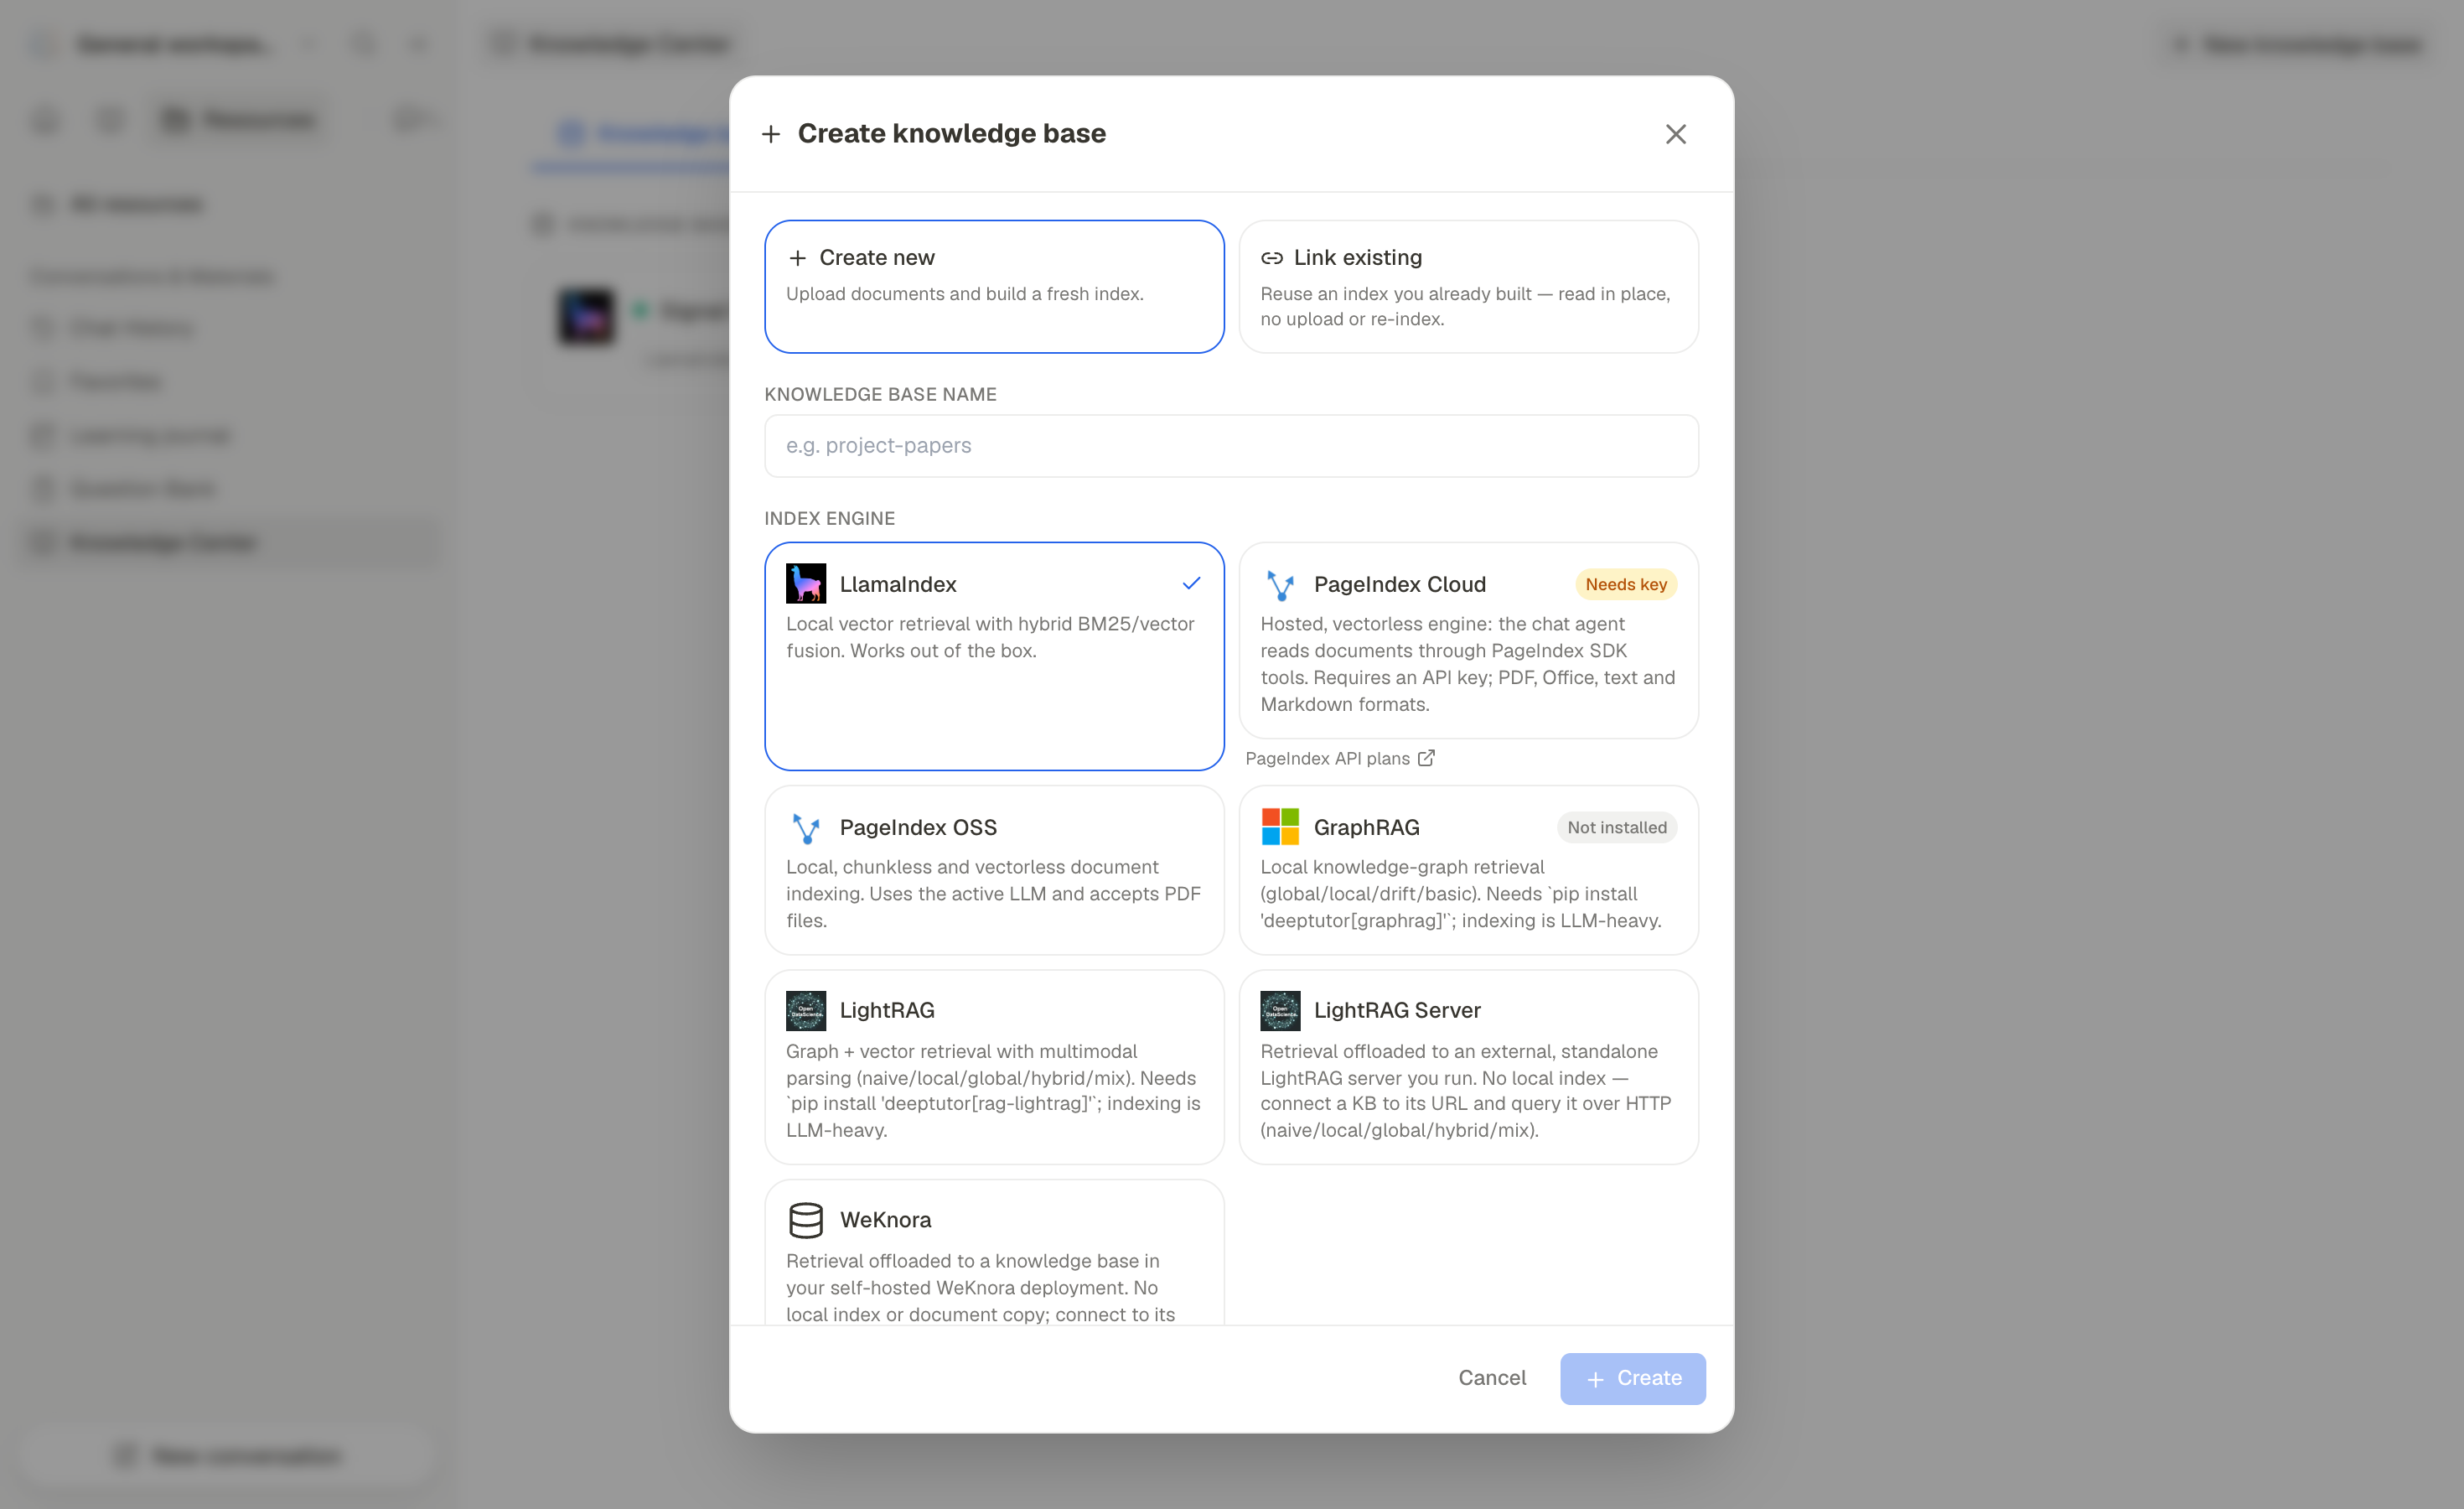
Les bases de connaissances sont les collections de documents derrière le RAG — elles ancrent les tours de Chat, les modifications du carnet d’apprentissage, la génération de Book et les conversations Partner. Ce qui est distinctif est un choix de moteurs de récupération : LlamaIndex (par défaut, vecteur hybride + BM25 avec reranking optionnel par cross-encoder et index FAISS exact-flat ou HNSW), PageIndex (récupération par raisonnement avec citations au niveau de la page, hébergé ou OSS auto-hébergé), GraphRAG et LightRAG (récupération par graphe de connaissances), LightRAG Server (récupération déléguée à une instance LightRAG externe connectée via HTTP), WeKnora (récupération depuis une base de connaissances de votre déploiement auto-hébergé, sans index local ni copie des documents), Tencent IMA (une bibliothèque que vous constituez dans IMA — interrogée, parcourue et mise à jour via son OpenAPI), MarginNote 4 (vos données d'étude MN4 — documents, extraits, fiches de carte mentale et les liens entre eux — poussées par l'Add-on de l'application et parcourues avec des outils dédiés), Kiwix (une archive ZIM interrogeable servie par HTTP sans indexation locale), ou un vault Obsidian lié que le tuteur lit et écrit en place. Chaque KB est liée à un moteur.
Vous migrez une bibliothèque Obsidian, Hermes ou Markdown existante ? Consultez le guide de migration des connaissances pour les parcours de vault connecté et de copie indexée.
Lors de la création d'une KB, vous pouvez en créer une nouvelle (téléverser et indexer des documents), en lier une existante (réutiliser un index sur place) ou connecter Kiwix (interroger à la demande une archive ZIM servie). Choisissez son espace de travail de stockage lors de la création ; une KB existante peut être déplacée entre espaces de travail après un aperçu, tout en conservant ses attributions et ses références enregistrées. Une KB peut aussi suivre des dépôts GitHub (dépôt, branche, glob) ou des URL de sites de documentation (profondeur d'exploration et nombre de pages limités, resynchronisés toutes les 24 h par défaut) ; la synchronisation compare les empreintes pour détecter les contenus ajoutés, modifiés ou supprimés, afin que la documentation suivie reste à jour sans nouveau téléversement, et les dossiers liés récupèrent les fichiers locaux nouveaux ou modifiés lors de la synchronisation. La re-indexation écrit un nouveau répertoire plat version-N et conserve les précédents, donc un index fonctionnel n'est jamais détruit en milieu de reconstruction. Un seul document peut être supprimé même d'une base en état d'erreur — retirer un fichier dont l'analyse a échoué sans devoir tout supprimer et reconstruire. L'analyse de documents — Text-only, MinerU, Docling, Tika, markitdown, PyMuPDF4LLM ou LiteParse — et un modèle optionnel de description d'images sont choisis dans Paramètres → Connaissances & documents, avec les téléchargements de modèles locaux désactivés par défaut. Docling peut aussi fonctionner en mode distant contre un serveur Docling Serve (aucune installation ni modèle local nécessaire), configuré sur cette page (mode=remote, une URL de base de serveur, et une clé API optionnelle) ou les variables d'environnement DOCLING_MODE / DOCLING_API_BASE_URL / DOCLING_API_TOKEN. Tika est distant uniquement et pointe vers le serveur Apache Tika configuré sur cette page. La CLI reprend le cycle de vie avec list/info/create/connect-kiwix/add/search/eval/eval-diff/set-default/delete, les commandes d'ajout et de suppression de sources, list-sources et sync.
Le moteur LightRAG intégré s'installe avec pip install 'deeptutor[rag-lightrag]'. Cet extra contient le SDK LightRAG pris en charge mais n'installe pas MinerU. Choisissez MinerU indépendamment dans Analyse de Documents et configurez son mode cloud ou installez sa CLI locale actuelle pour l'analyse structurée. MinerU accepte les PDF, les images raster courantes, les fichiers DOCX, PPTX et XLSX ; l'ancienne commande magic-pdf reste limitée aux PDF. Le mode texte seul et les autres moteurs d'analyse n'ont pas besoin de MinerU.
Les requêtes LightRAG natives et l'indexation incrémentielle nécessitent la configuration d'embedding enregistrée par l'index publié, incluant le modèle, la dimension et l'identité du point de terminaison. Si elle change, restaurez la configuration d'origine ou reconstruisez avec l'embedding actuel ; les index sans identité d'embedding enregistrée nécessitent une reconstruction. Les vues de détail de la base de connaissances et de version d'index affichent des conseils de récupération, tandis que les fichiers restent disponibles pour la consultation et le téléchargement.
Évaluer une base de connaissances. Avec plusieurs moteurs disponibles, « lequel récupère le mieux les informations ici ? » est une question empirique — à laquelle deeptutor kb eval apporte une réponse. Rédigez un jeu de questions-réponses (un objet JSON par ligne : une query et les passages gold qu'une récupération idéale devrait renvoyer), puis évaluez la KB avec deeptutor kb eval <name> --dataset qa.jsonl --top-k 5 [--mode hybrid] [--save baseline.json]. Chaque cas est interrogé par le même chemin qu'un tour de chat ; ses citations classées sont comparées aux passages de référence par correspondance exacte du texte ou recouvrement lexical (les seuils sont réglables avec --min-ratio ; l'équivalence sémantique n'est pas évaluée), et l'exécution affiche Recall@k / Precision@k / nDCG@k / MRR / MAP / Hit@k. Les métriques sont des fonctions pures du classement ; aucun modèle ne juge la sortie. Comparez les rapports enregistrés avec deeptutor kb eval-diff baseline.json candidate.json pour connaître les changements par métrique et par cas. Utilisez --rewrite off ou --rewrite standalone avec kb eval pour comparer les requêtes originales et réécrites ; les rapports conservent la provenance de la réécriture. Les cas dont la recherche a échoué (index manquant, identifiants incorrects) n'ont pas de score et sont signalés séparément au lieu de faire baisser les moyennes. PageIndex utilise le raisonnement pour la récupération et ne renvoie pas de fragments classés ; il est donc exclu.
{"query": "Why do transformers scale attention?", "gold": ["Scaling keeps the dot products from growing with the dimension."]}
🗃️ Historique, Favoris, Journal et Banque de questions
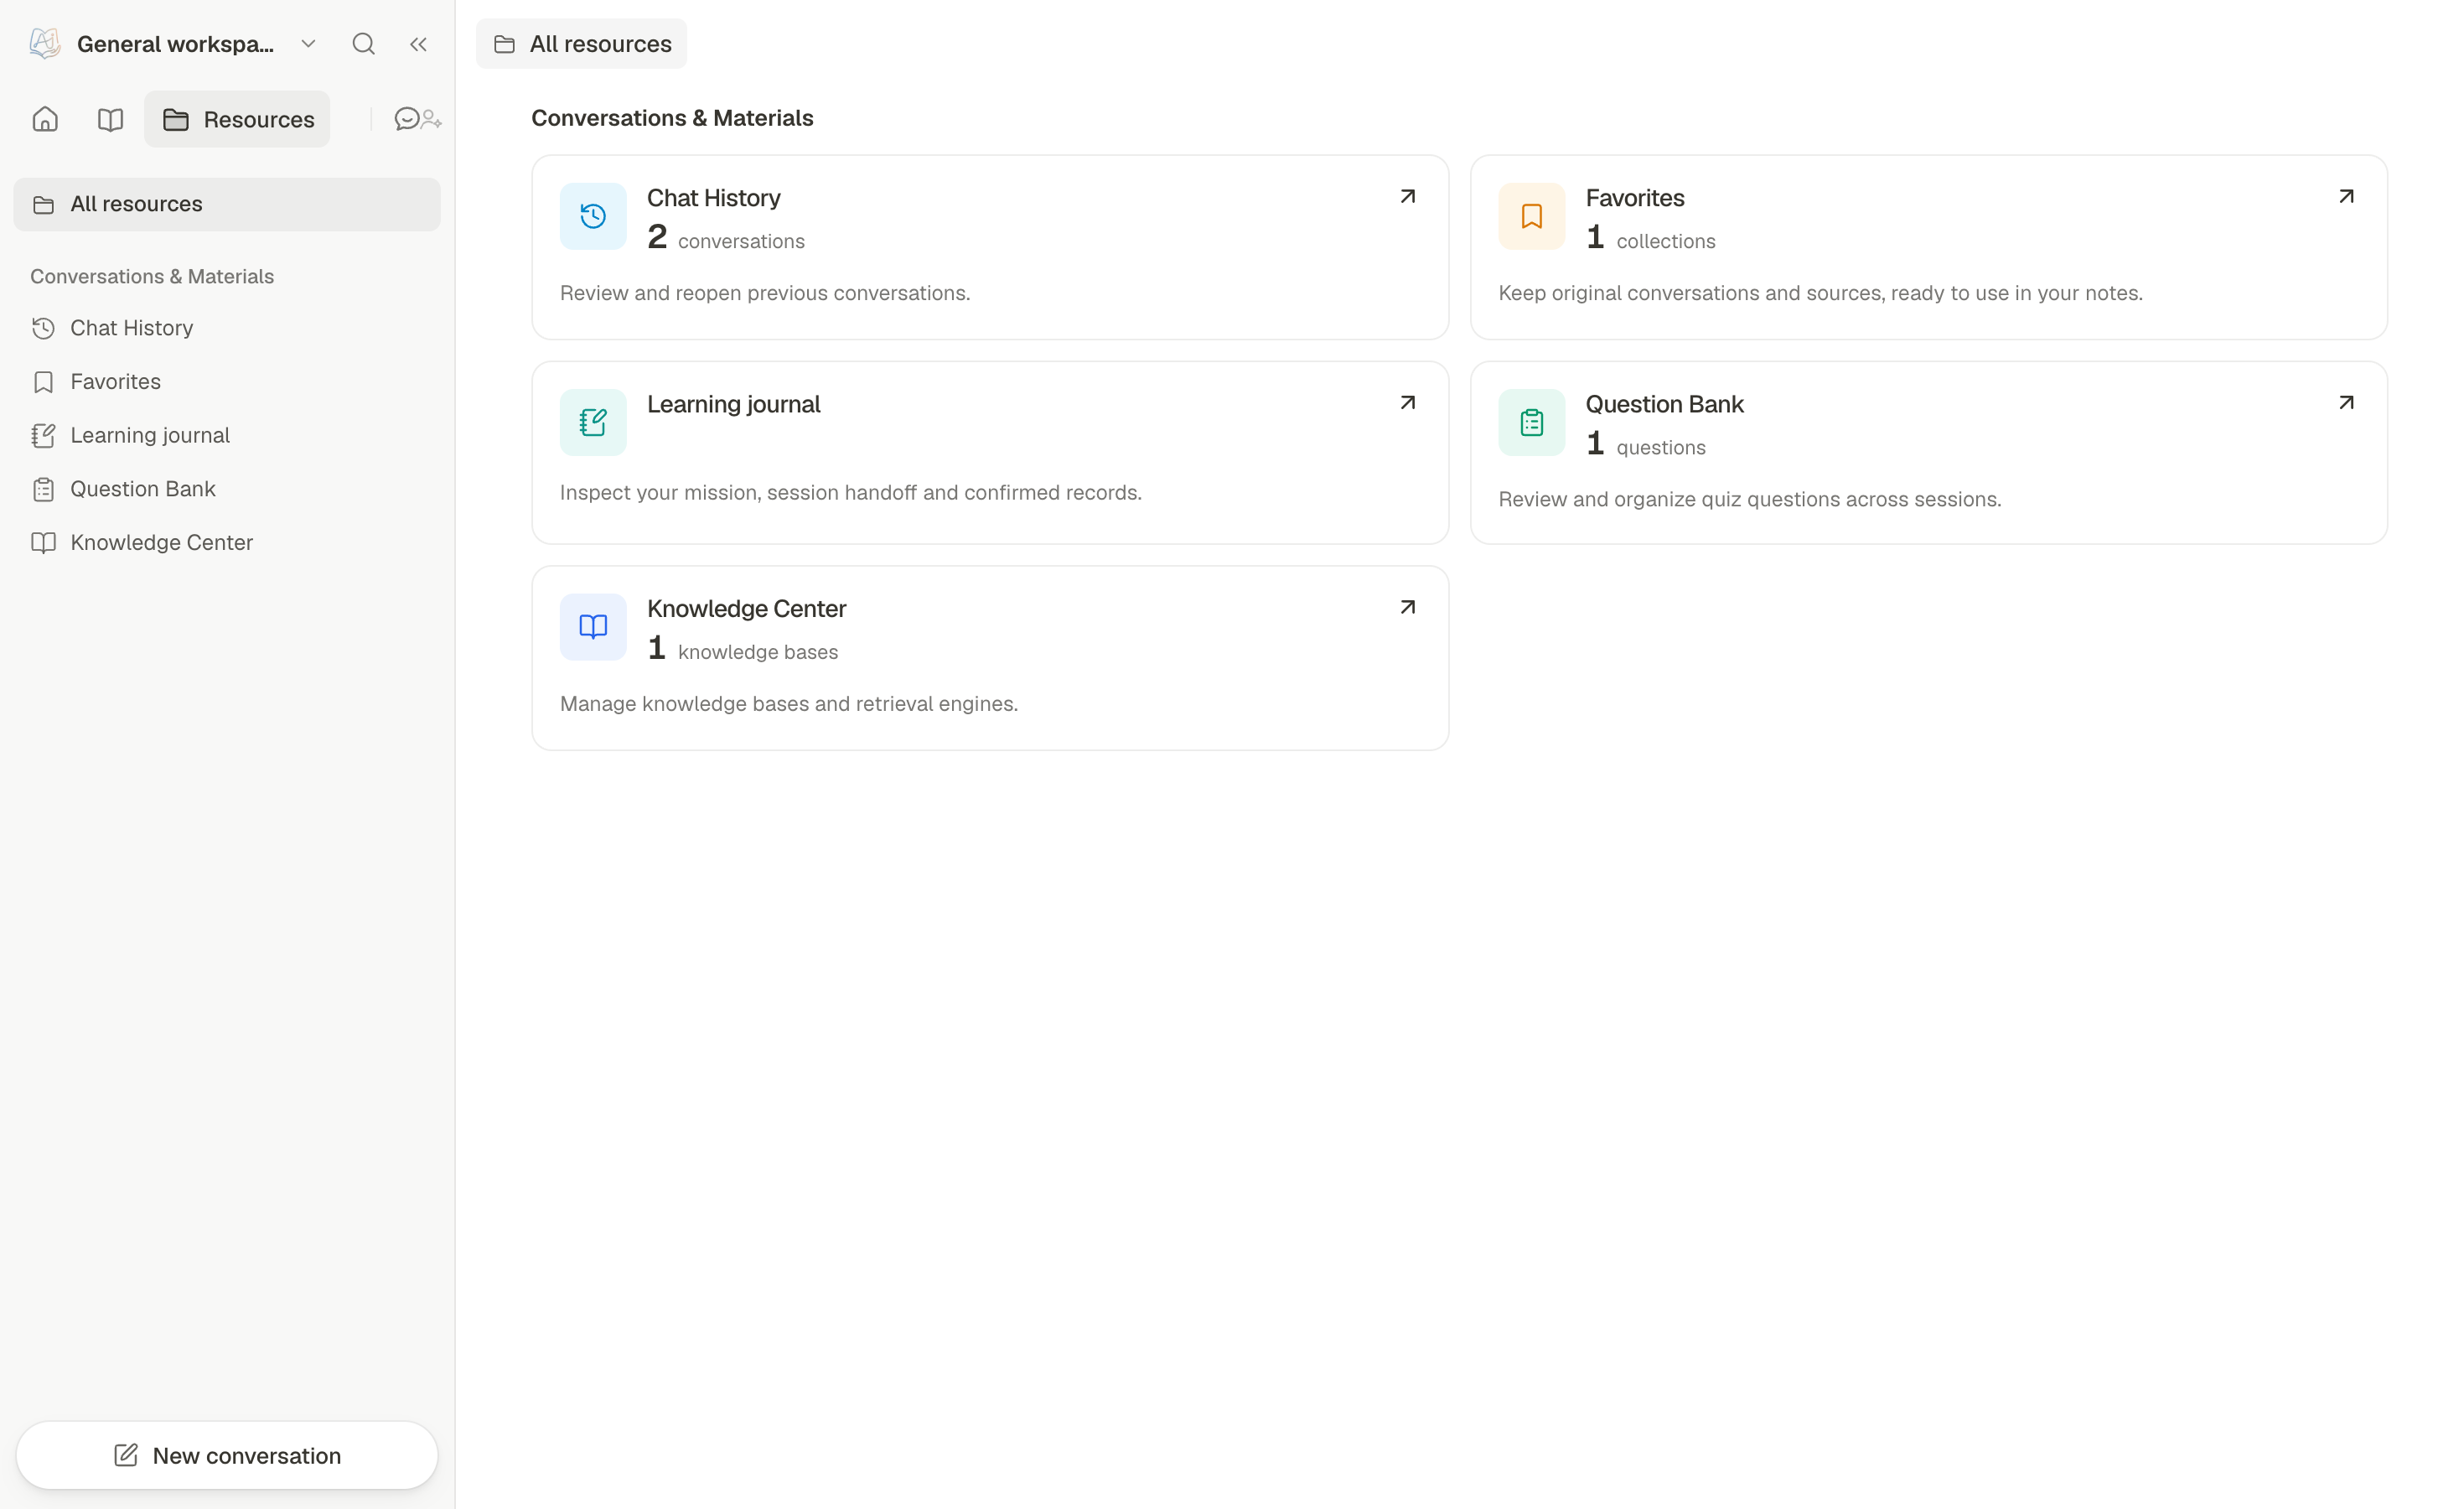
L'Historique des chats rouvre les conversations avec leur contexte d'apprentissage d'origine. Les Favoris conservent les conversations et résultats originaux utiles dans des collections déplaçables avec export Markdown, prêts à être insérés dans un carnet d'apprentissage. Le Journal d'apprentissage enregistre la mission actuelle, la passation de session et les enregistrements d'apprentissage confirmés. La Banque de questions organise les questions, réponses, explications et erreurs ; sélectionnez un ensemble pour Apprentissage → Practice afin de réviser les points faibles et de programmer les répétitions.
🤝 Partners — Compagnons persistants dans tous les espaces de travail
Les Partners appartiennent au compte plutôt qu'à un espace de travail consacré à une matière. Chaque compagnon conserve sa propre identité, ses instructions, sa politique de modèle, ses relations et ses canaux, tout en utilisant soit une bibliothèque privée, soit les ressources d'un espace de travail existant.
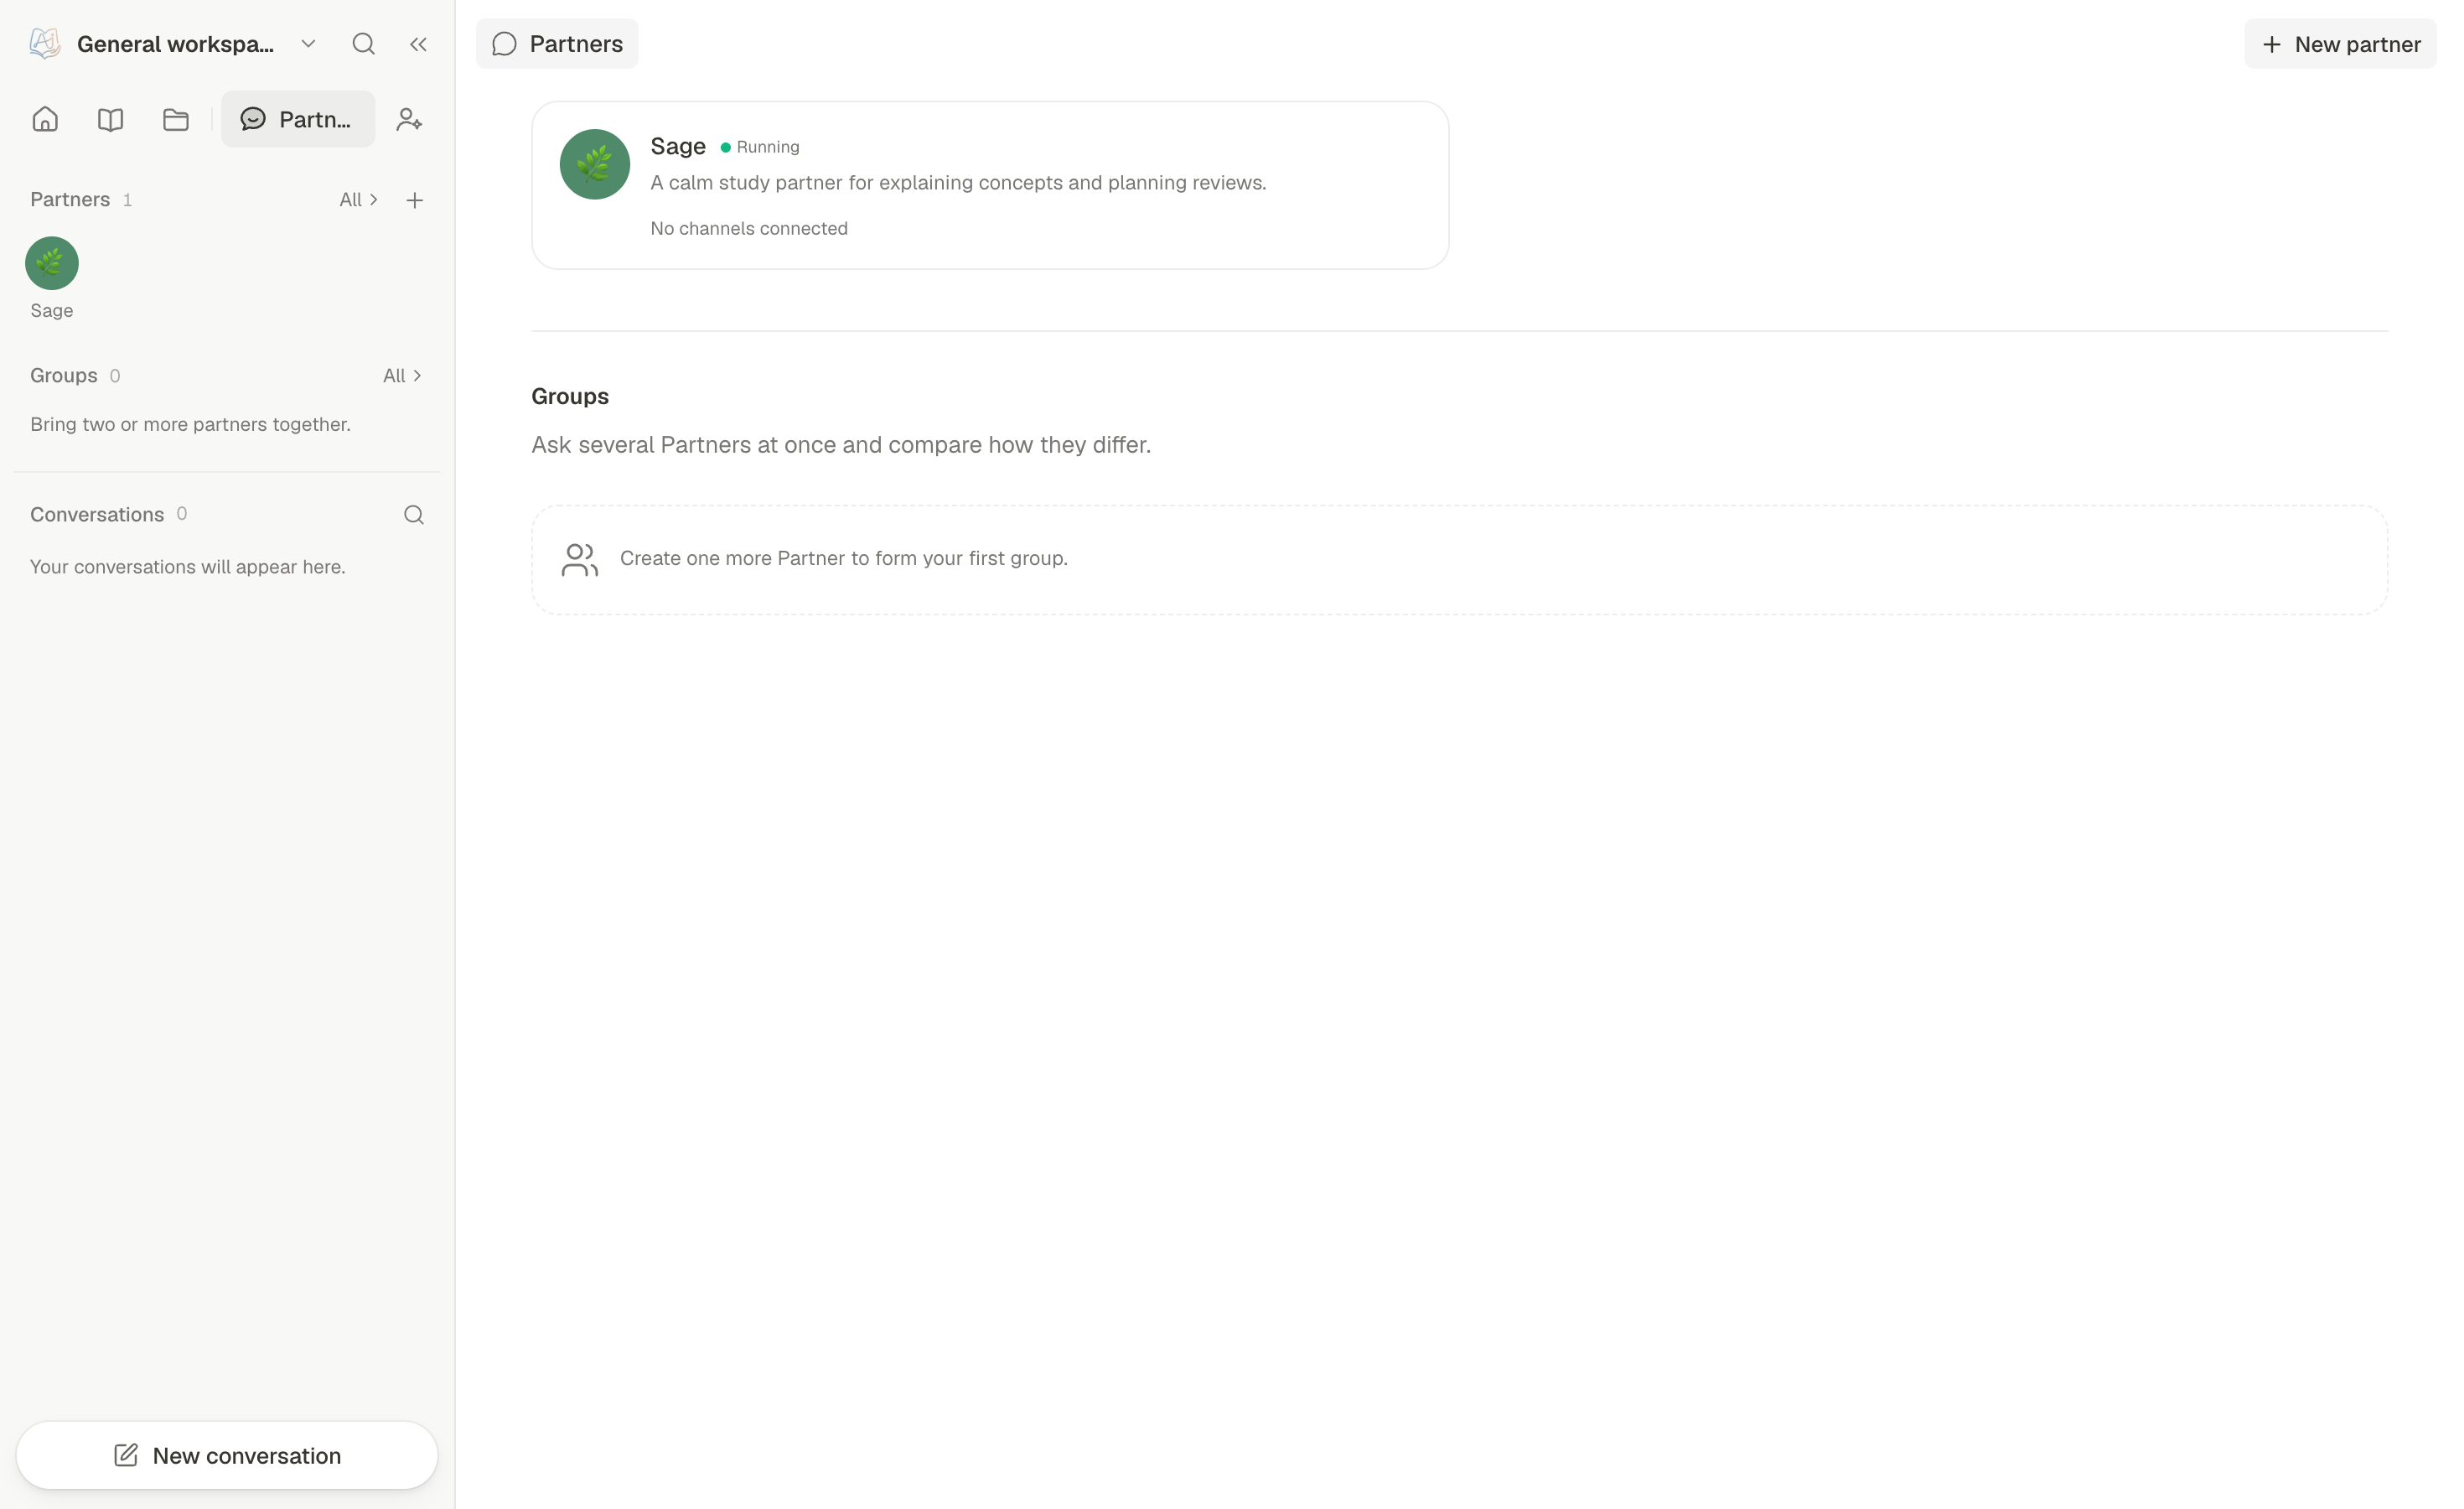
Identité, ressources de l'espace de travail, groupes et canaux
Chaque message Web ou IM entrant devient un tour normal de ChatOrchestrator — un Partner est « un chat qui a une personnalité et un numéro de téléphone ». Son SOUL.md, sa sélection de modèle, sa politique d'outils et sa bibliothèque restent modifiables après sa création. Un espace de travail Partner privé copie les bases de connaissances, les compétences et les collections de Favoris attribuées ; un espace de travail lié partage plutôt ses fichiers et ressources actuels. Soul, les conversations et la mémoire relationnelle restent séparés dans les deux modes.
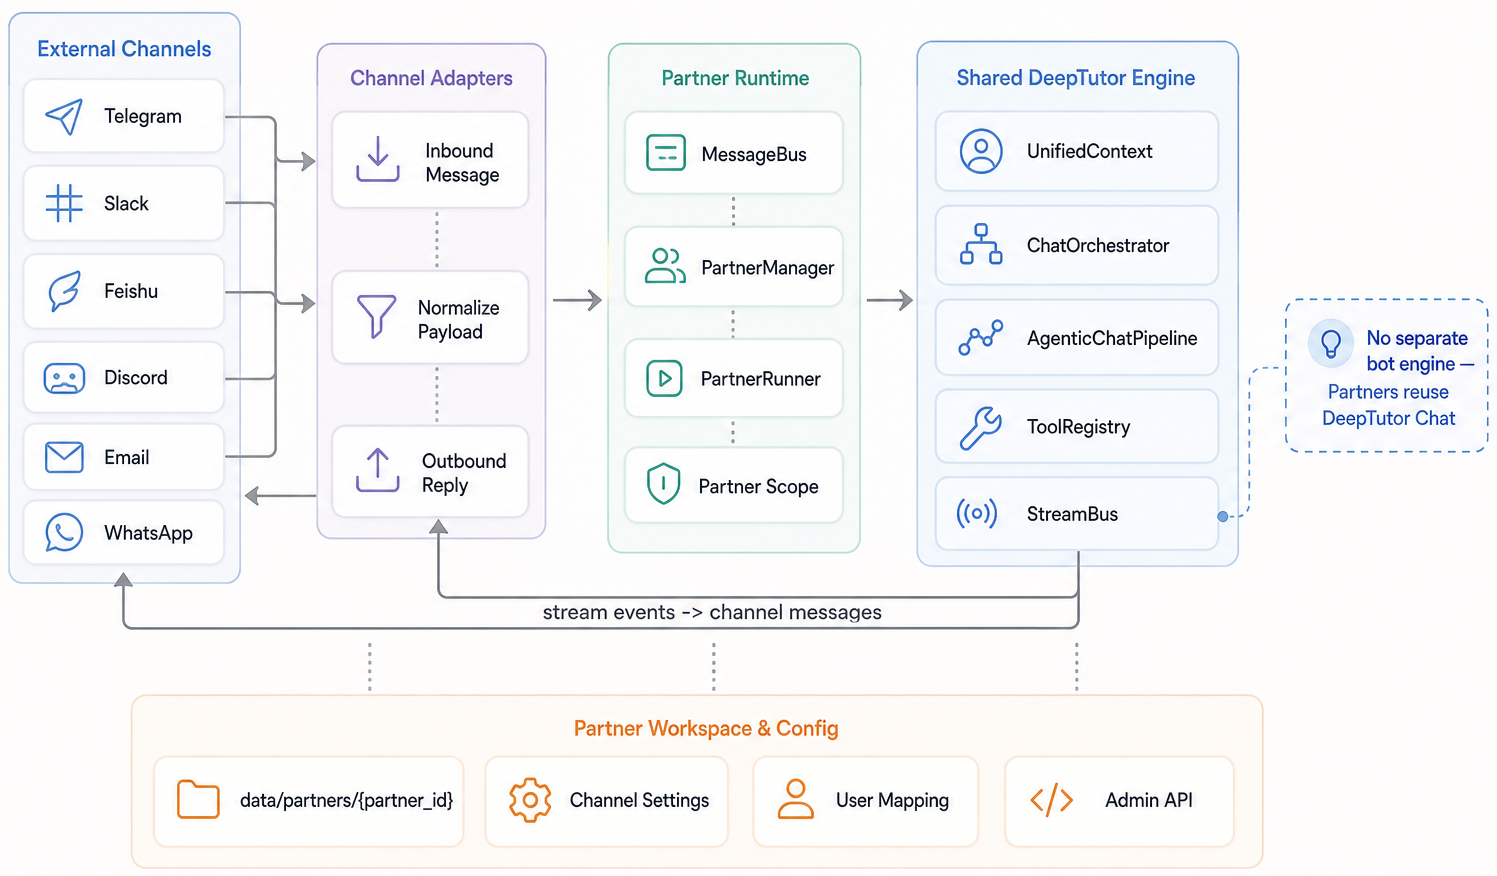
Les Partner Groups réunissent deux Partners ou plus dans une conversation partagée avec des places distinctes, des modes de discussion et de mémoire partagée sélectionnables, et un historique durable. Les utilisateurs authentifiés conservent des sessions Partner et une mémoire relationnelle privées même lorsqu'un compagnon est partagé.
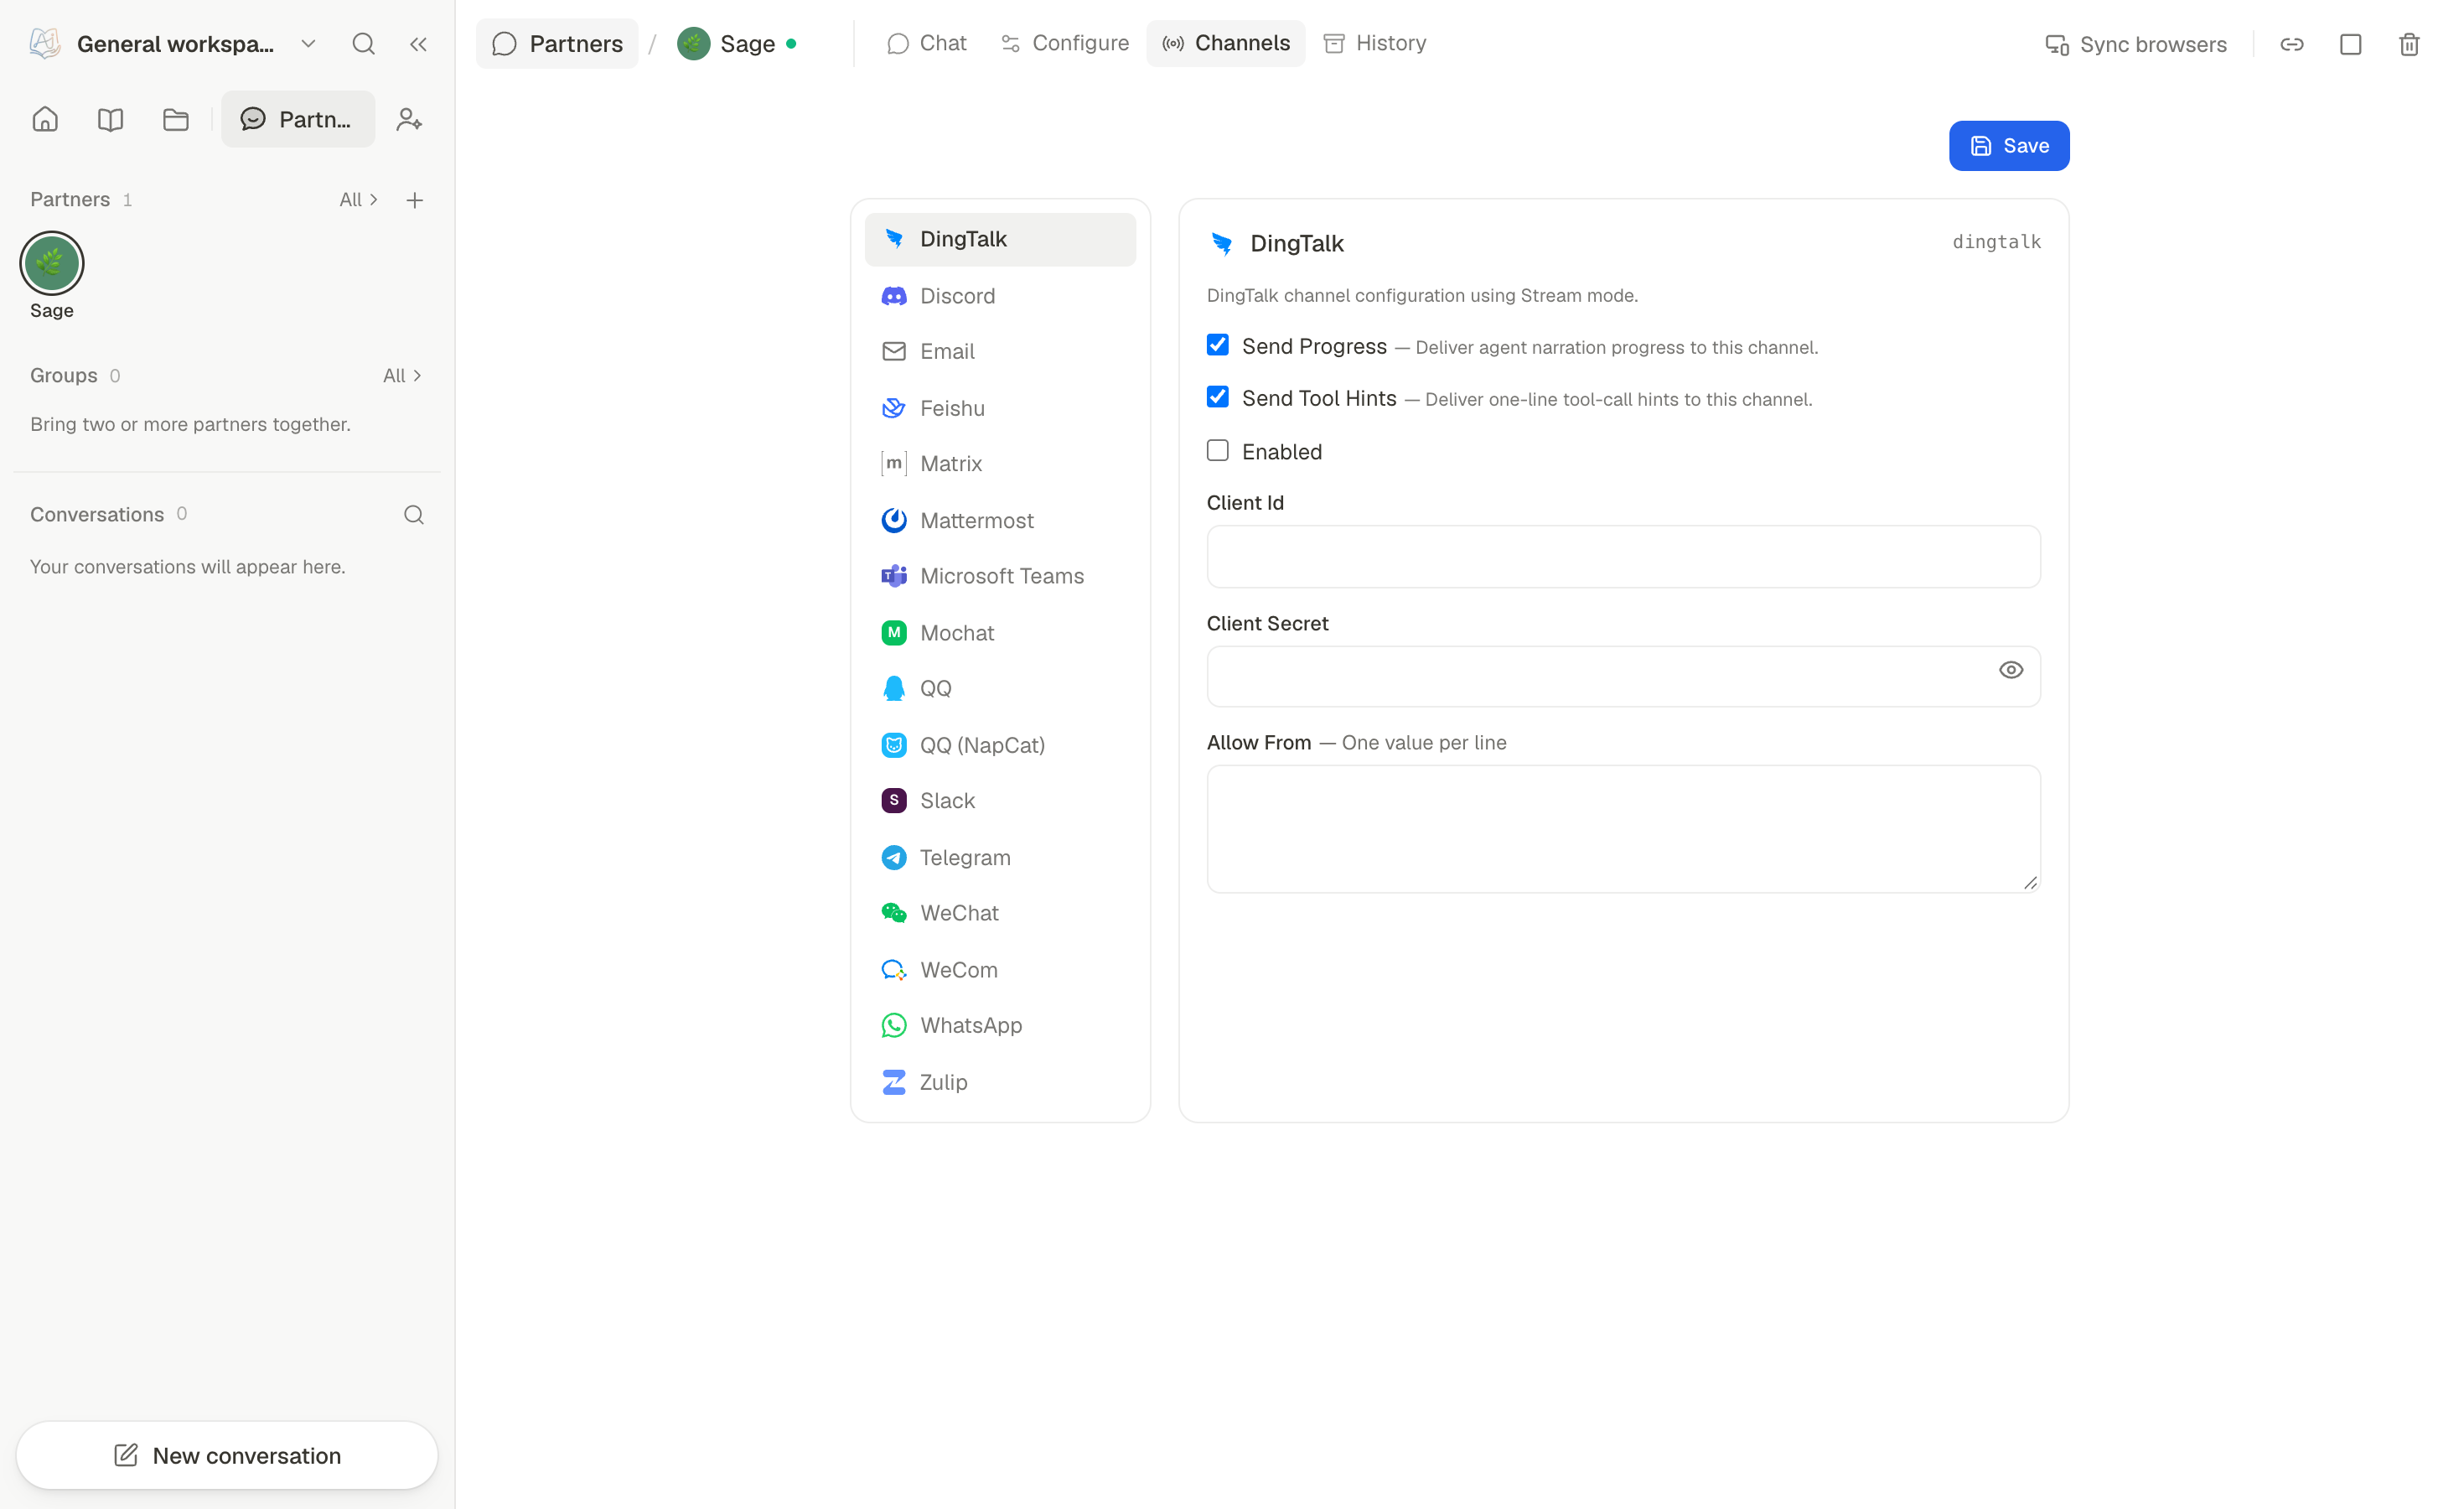
Les canaux pilotés par schéma connectent les compagnons à Feishu, Telegram, Slack, Discord, DingTalk, QQ/NapCat, WeCom, WhatsApp, Zulip, Mattermost, Matrix, Mochat et Microsoft Teams, selon les extras installés et les identifiants configurés. La configuration dans le navigateur prend en charge l'intégration par QR code pour certains canaux. Un Partner peut également être connecté via Personnalisation → My Agents et consulté depuis un tour de Chat normal.
🧭 Personnalisation — Comportements et connexions réutilisables
La personnalisation suit le compte dans tous les espaces de travail. Choisissez comment le tuteur doit se comporter et quels agents, compétences, services, applications et mémoires il peut réutiliser ; les sélections de l'espace de travail et de la conversation peuvent restreindre davantage cet accès.
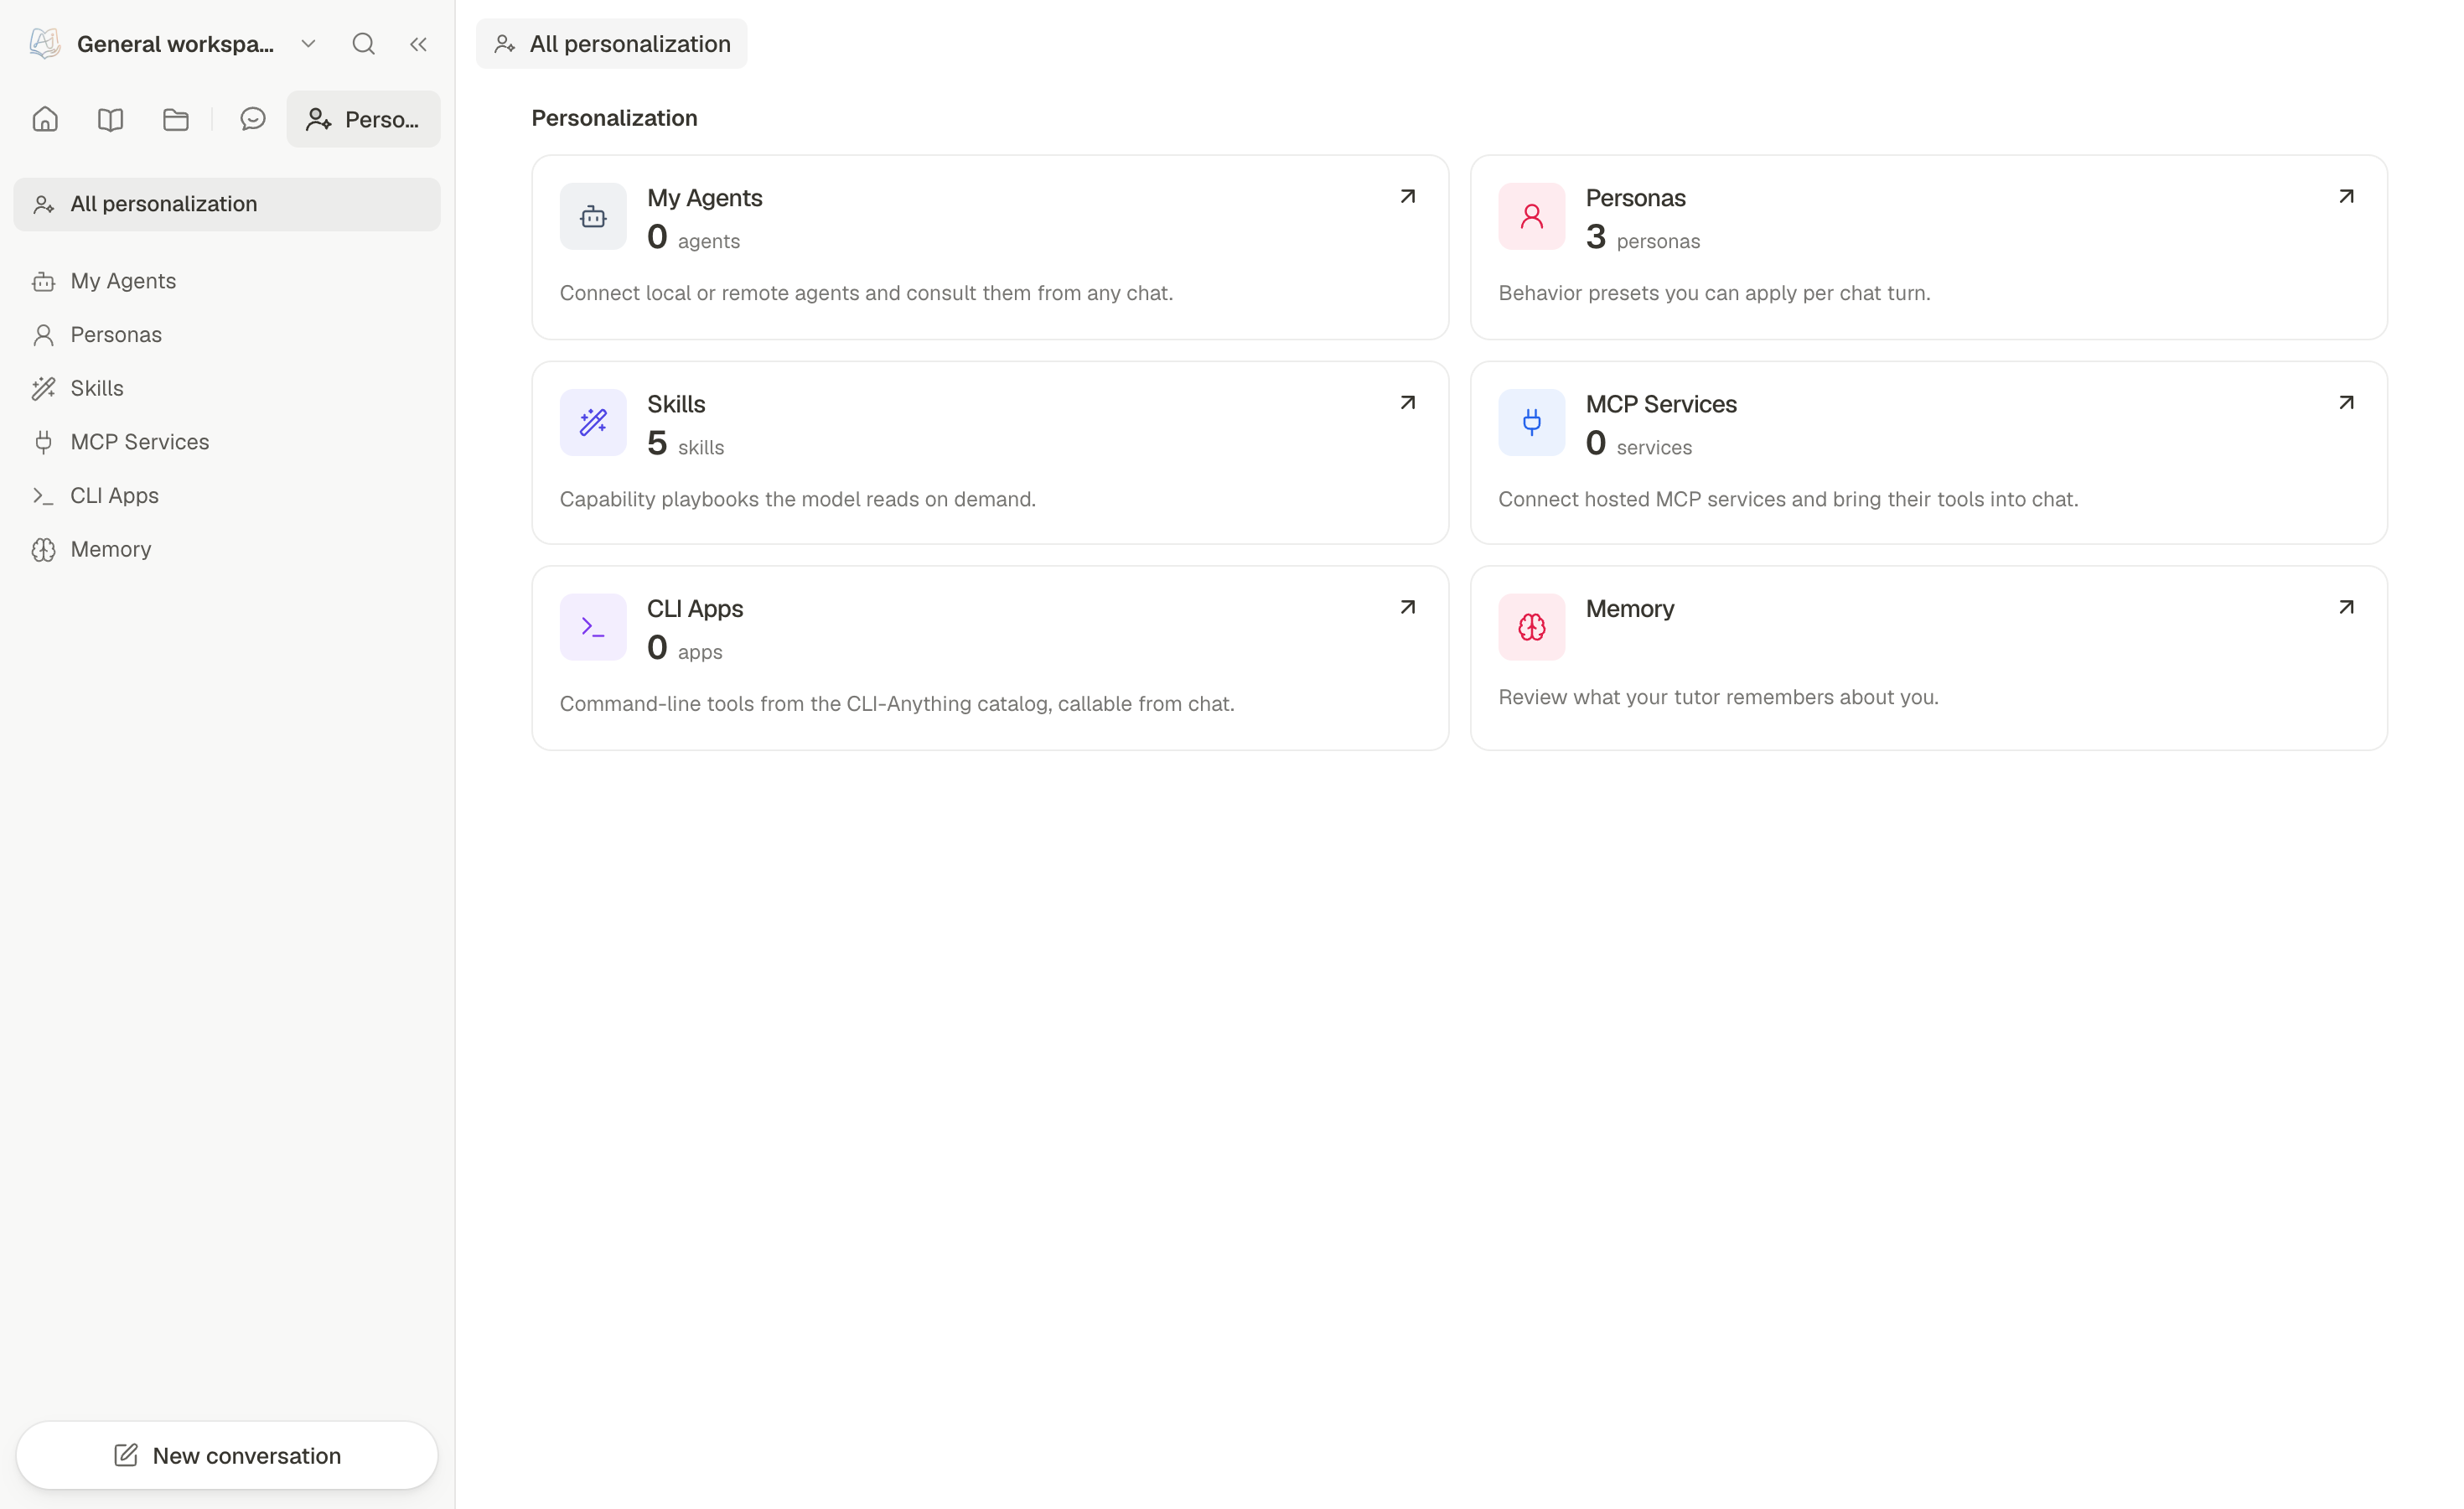
🧑🚀 My Agents — Consulter des agents en direct et importer un historique
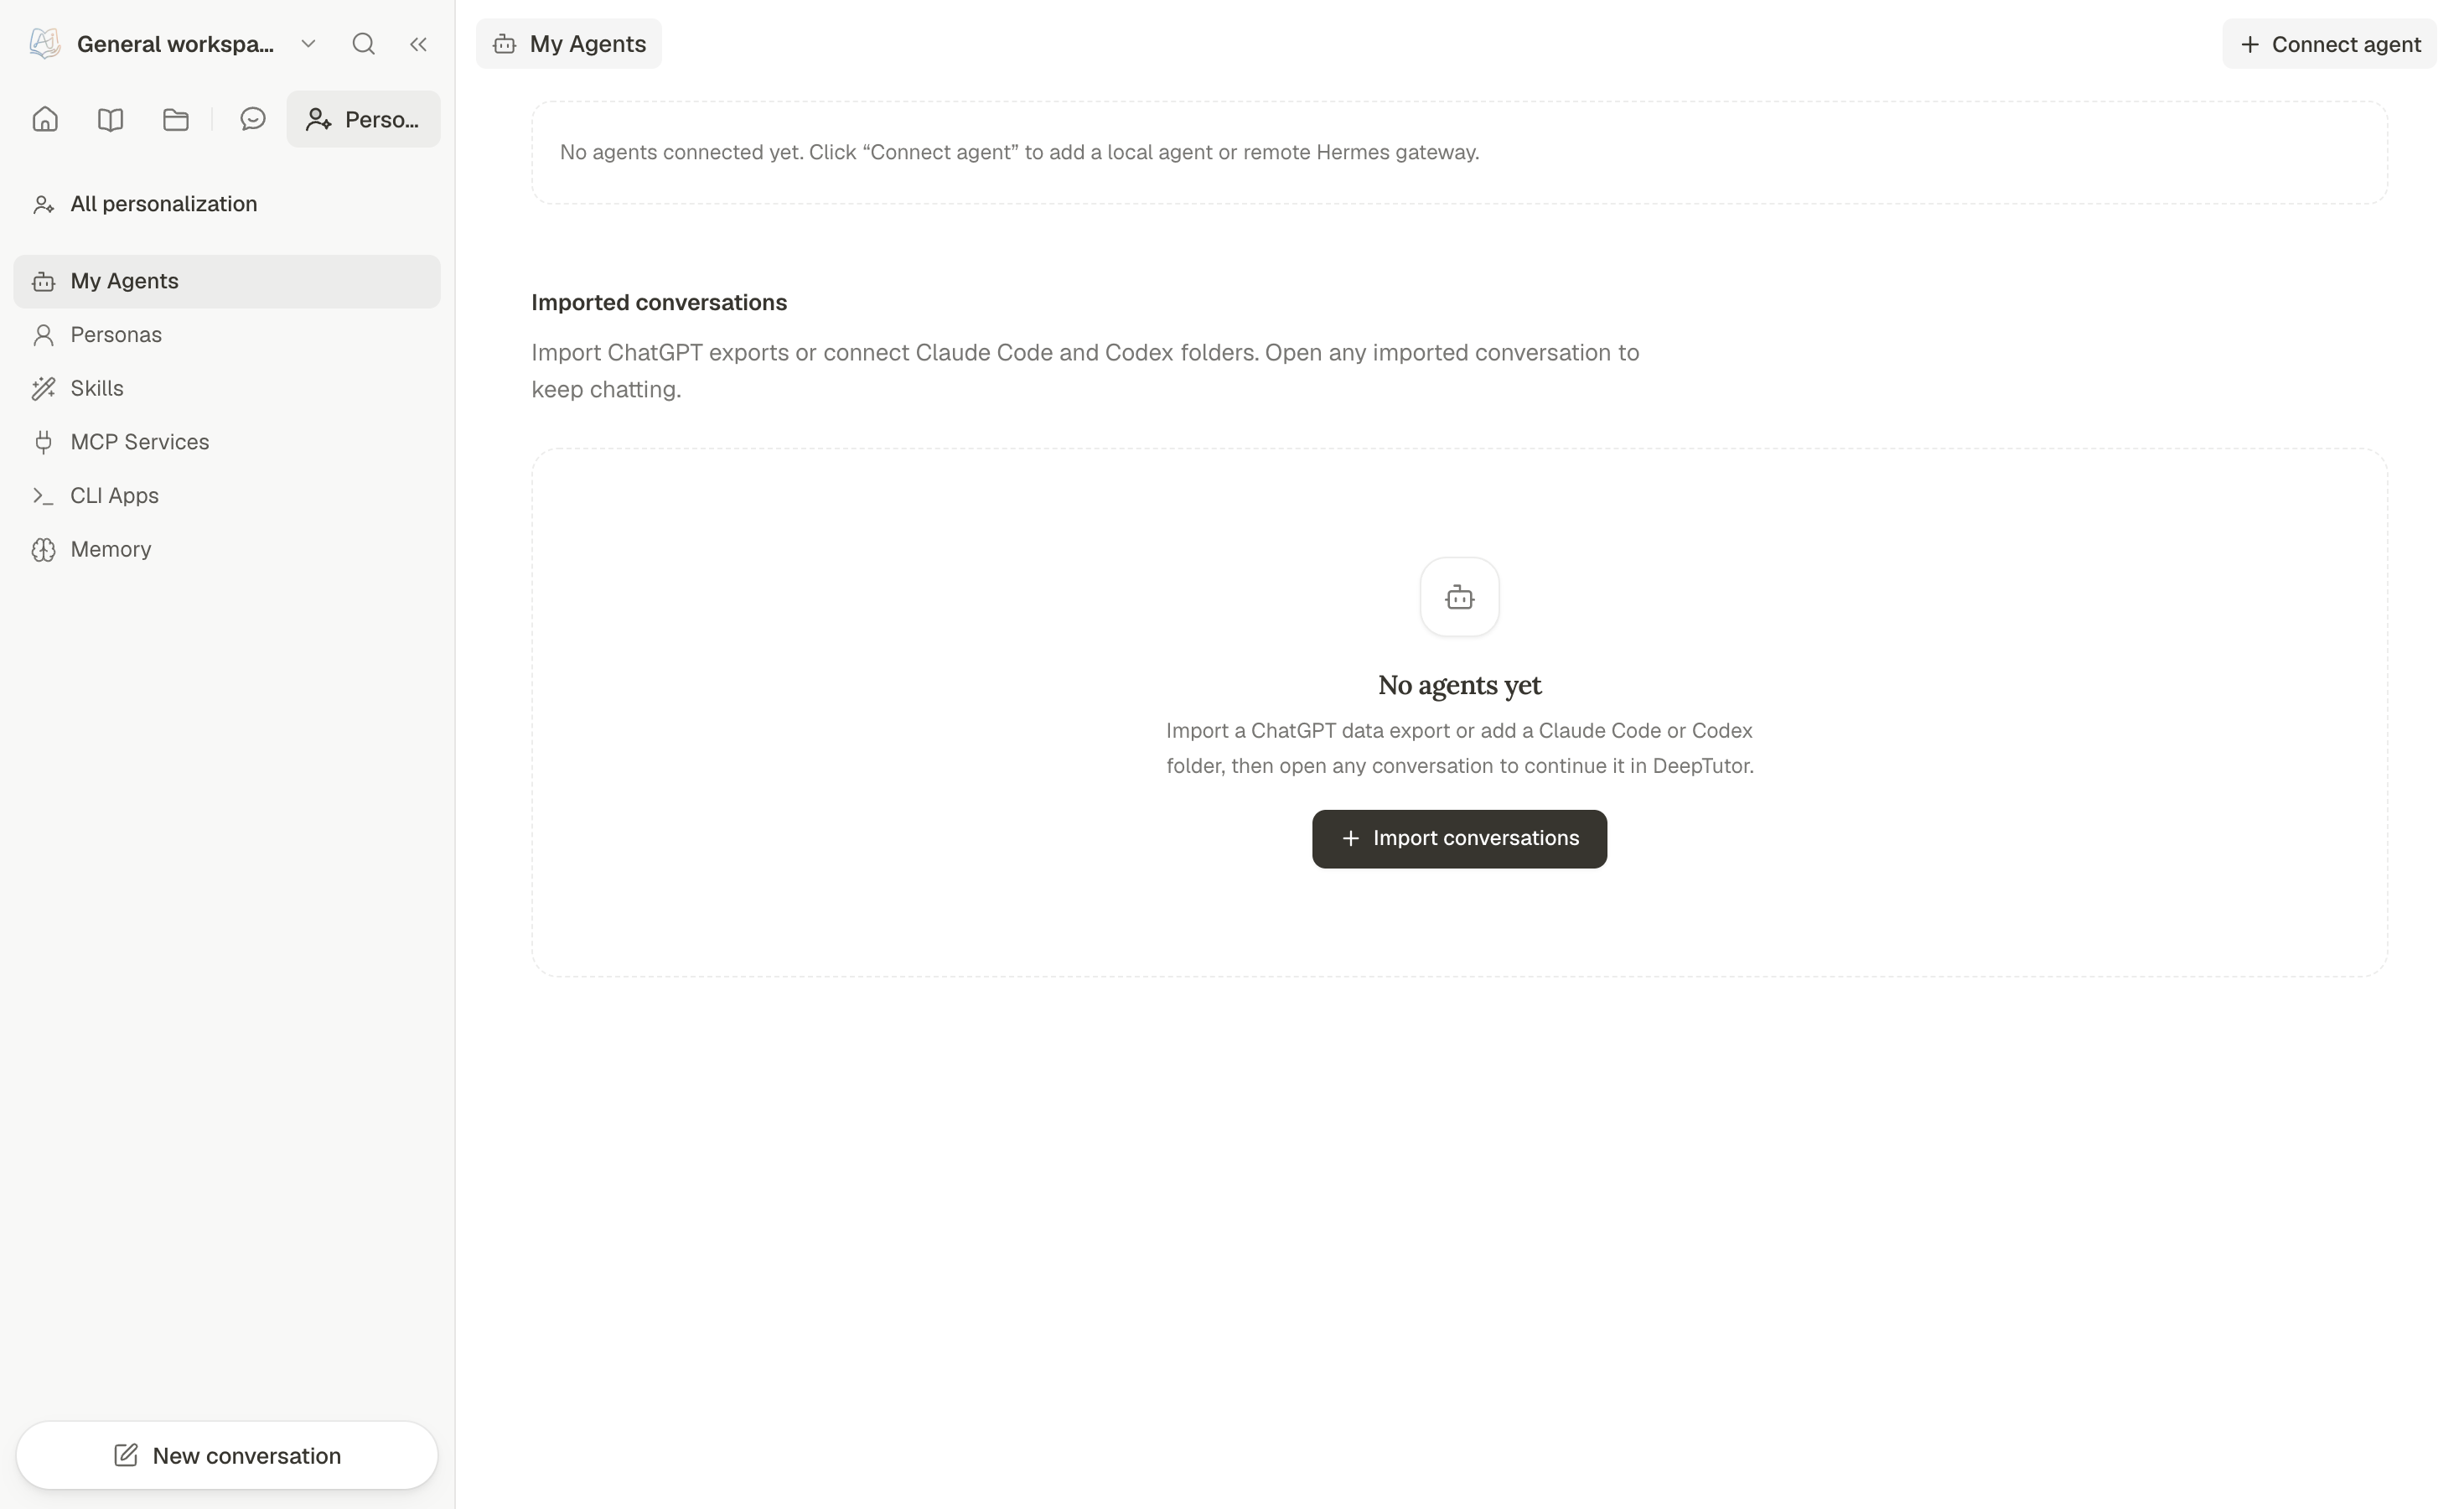
Connectez un agent en direct — Claude Code, Codex, Grok CLI, Antigravity, Kimi, opencode, MiMo Code, Hermes Agent, OpenClaw, DeepSeek Harness ou un Partner — et consultez-le depuis un tour de Chat. DeepTutor exécute l'agent sélectionné et diffuse son travail dans le panneau Activité via consult_subagent ; la puce Agent ou @ maintient la connexion associée à la session. Les harnesses locaux utilisent leur propre authentification, leur répertoire de travail et leur stockage de session.
Importez des conversations passées depuis ChatGPT, Claude Code et Codex comme références consultables et reprenables. ChatGPT utilise un export officiel conversations.json ; l'historique Claude est sélectionné par projet ou répertoire de travail, et l'historique Codex par date. Référencez une conversation importée via + → My Agents sans la transformer en voix propre de DeepTutor.
🎭 Personas, compétences, Services MCP et Applications CLI
Les Personas réutilisent une voix, un style pédagogique ou une politique de réponse et peuvent également servir de point de départ au soul d'un Partner. Les compétences regroupent des flux de travail reproductibles dans des livrets de jeu SKILL.md, avec des bibliothèques partagées au niveau du compte et locales à l'espace de travail. Importer depuis EduHub parcourt les compétences communautaires et les installe via une porte de sécurité (voir Écosystème).
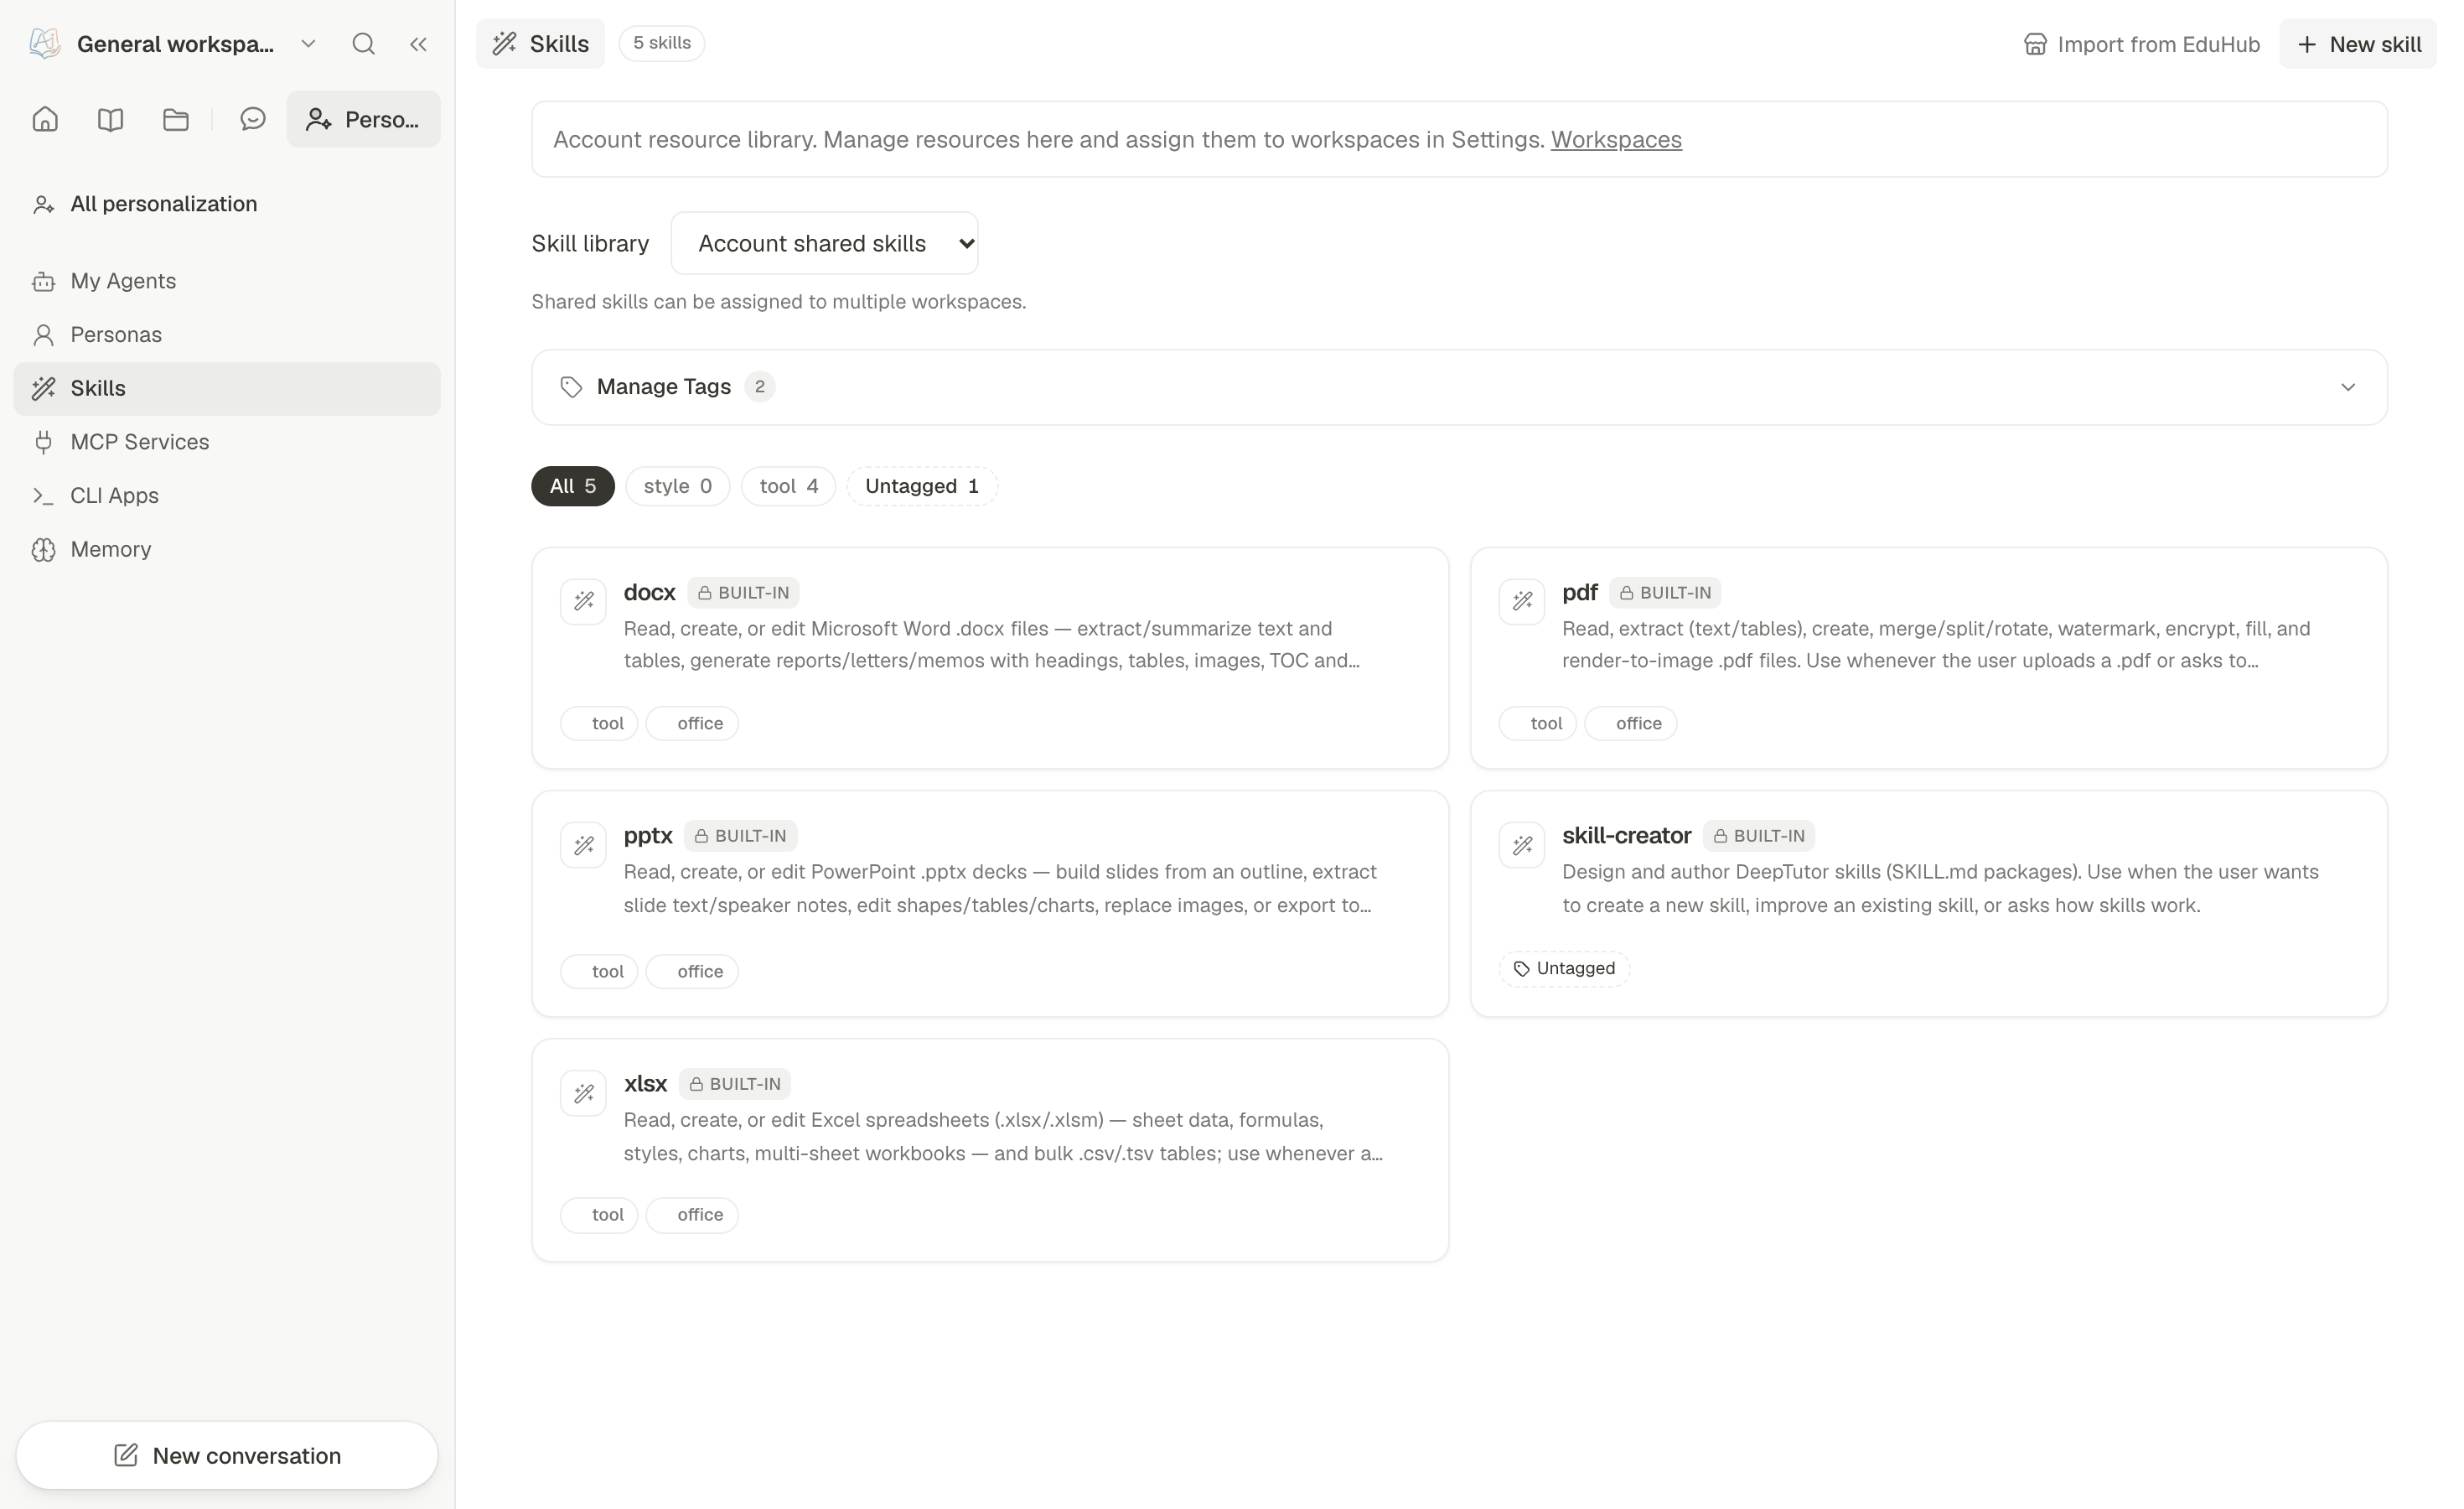
Les Services MCP autorisent des outils externes, tandis que les Applications CLI exposent les programmes installés du catalogue CLI-Anything via la sandbox d'exécution. Les attributions à l'espace de travail et les autorisations utilisateur déterminent les ressources que chaque tour peut utiliser.
🧠 Memory — Personnalisation Inspectable
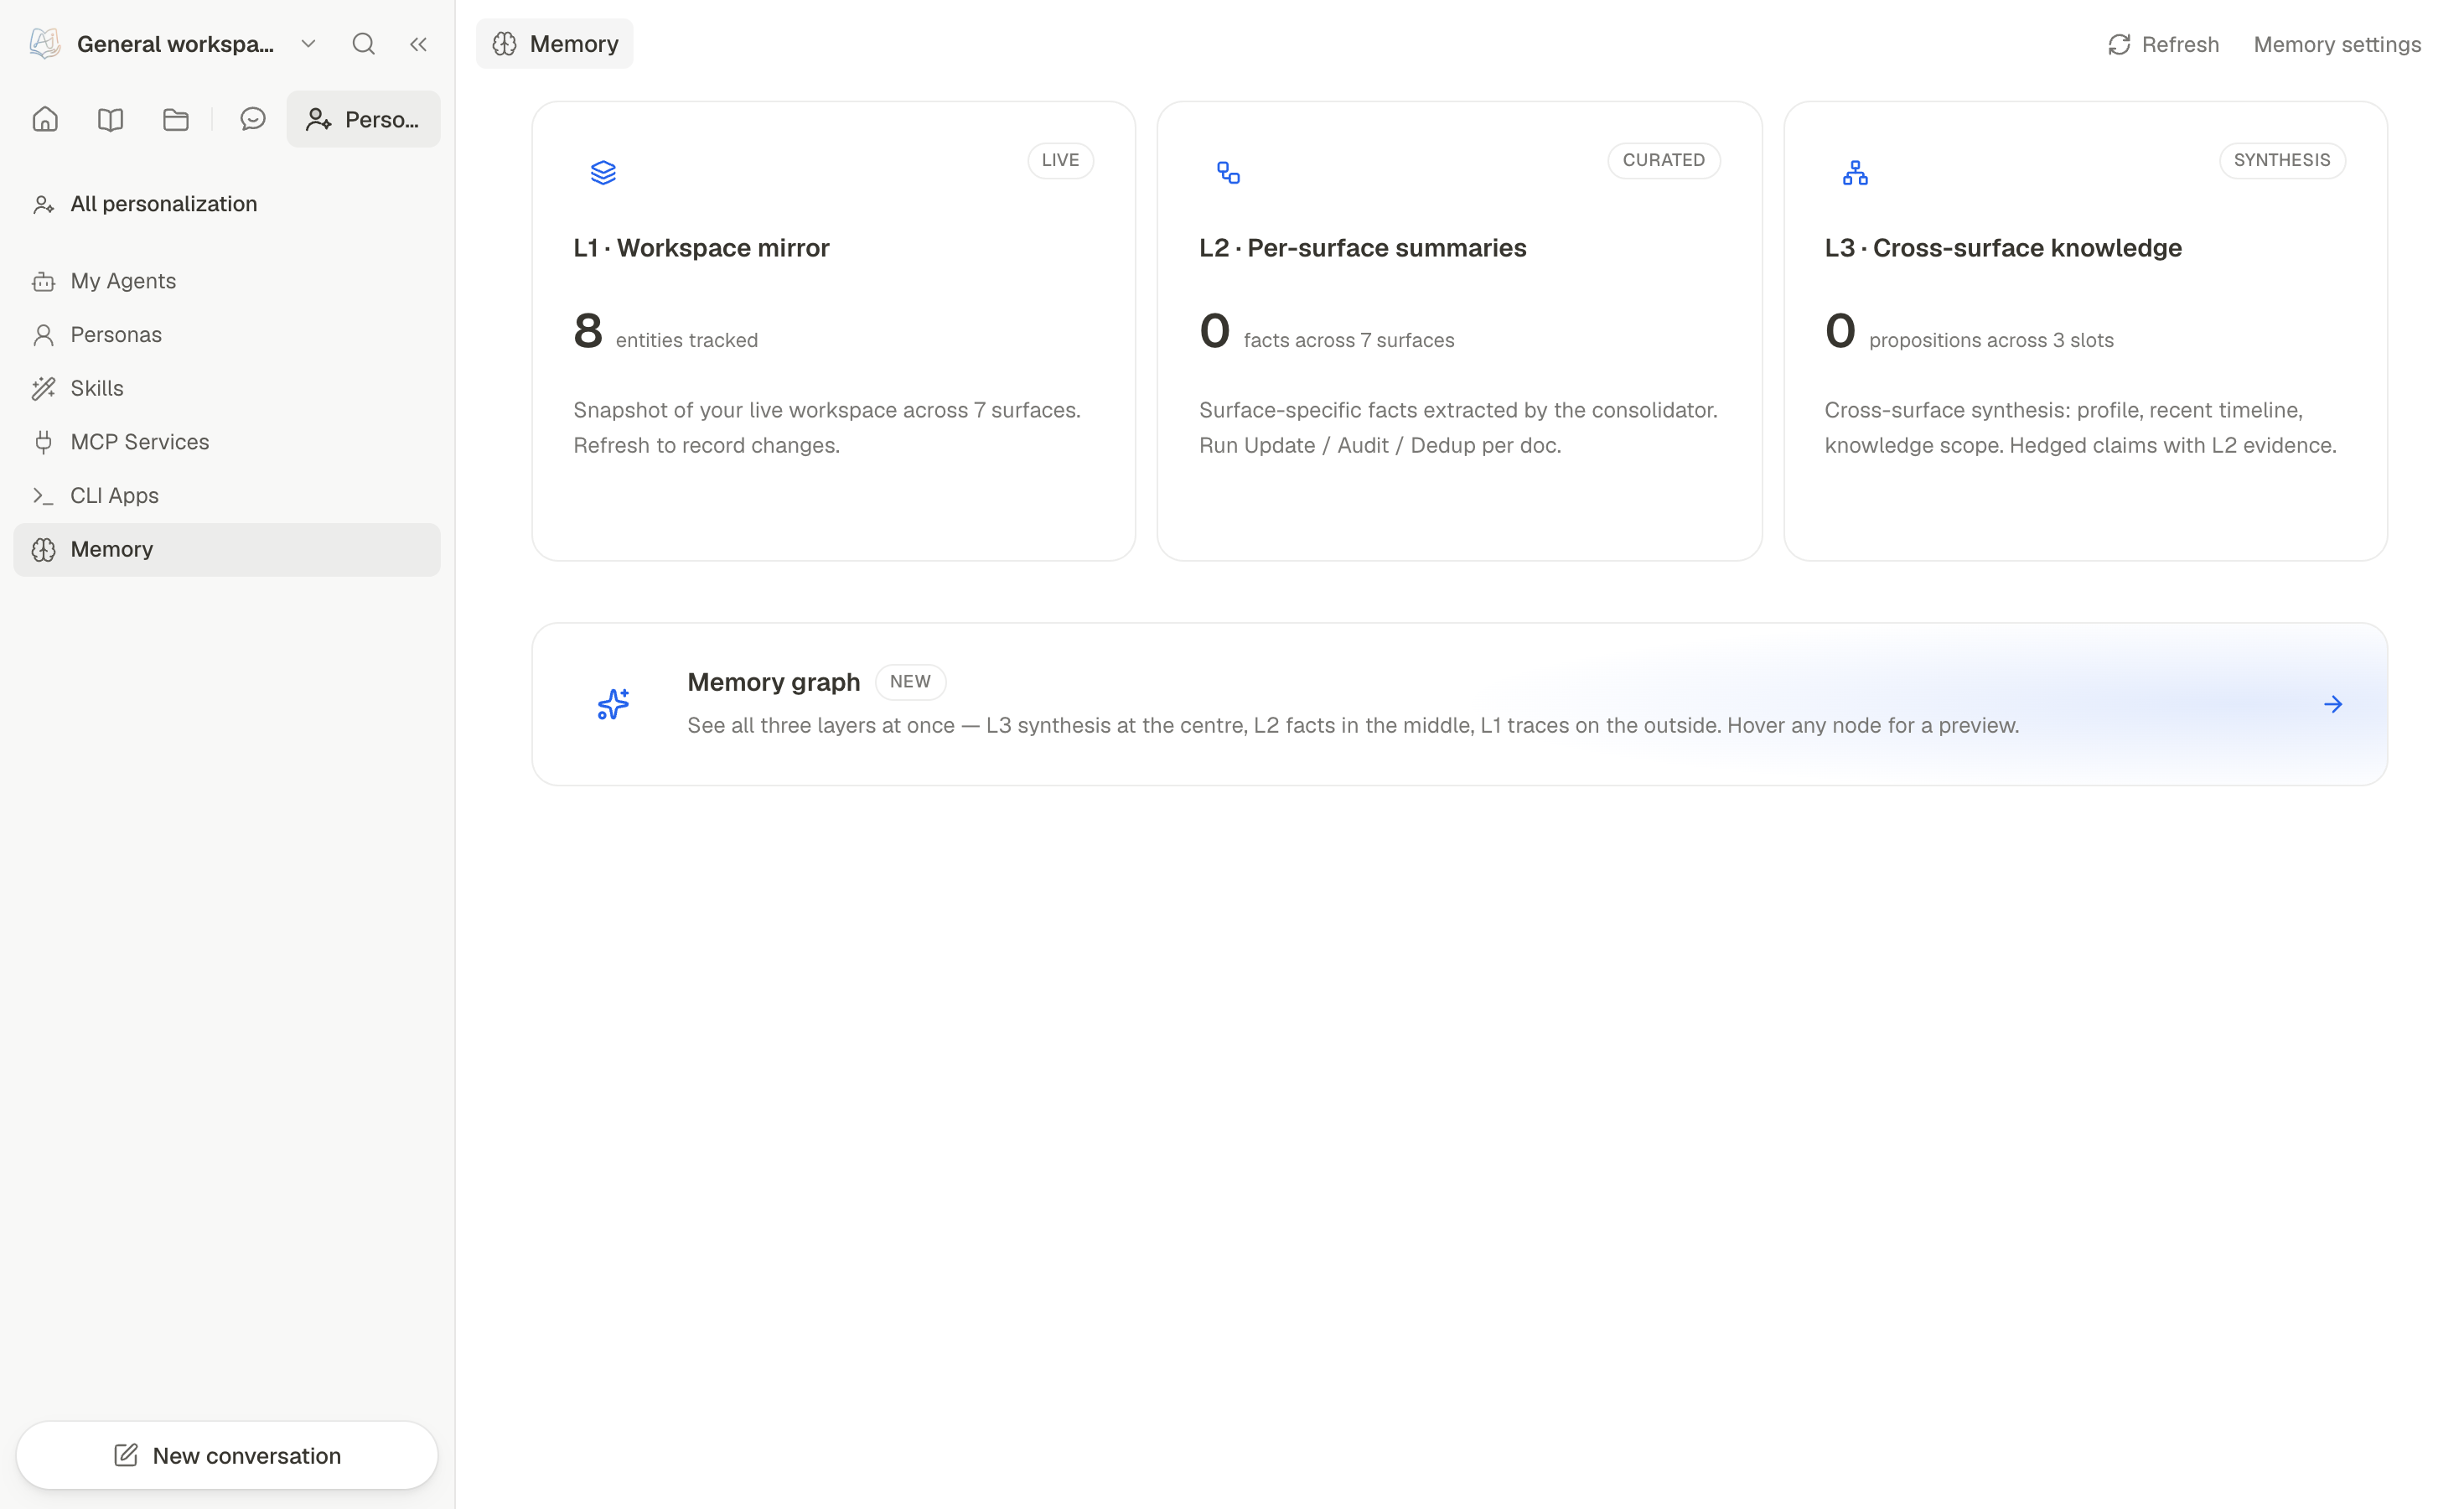
Memory est un système en trois couches sauvegardé sur fichier que vous pouvez lire, organiser et auditer — délibérément pas un store vectoriel caché. L1 est le miroir de l'espace de travail plus une trace d'événements en ajout seul (trace/<surface>/<date>.jsonl) ; L2 contient des faits organisés par surface (L2/<surface>.md) avec des références aux entités L1 ; L3 est la synthèse inter-surfaces (L3/<profile|recent|scope|preferences>.md) qui consigne les surfaces L2 contributrices.
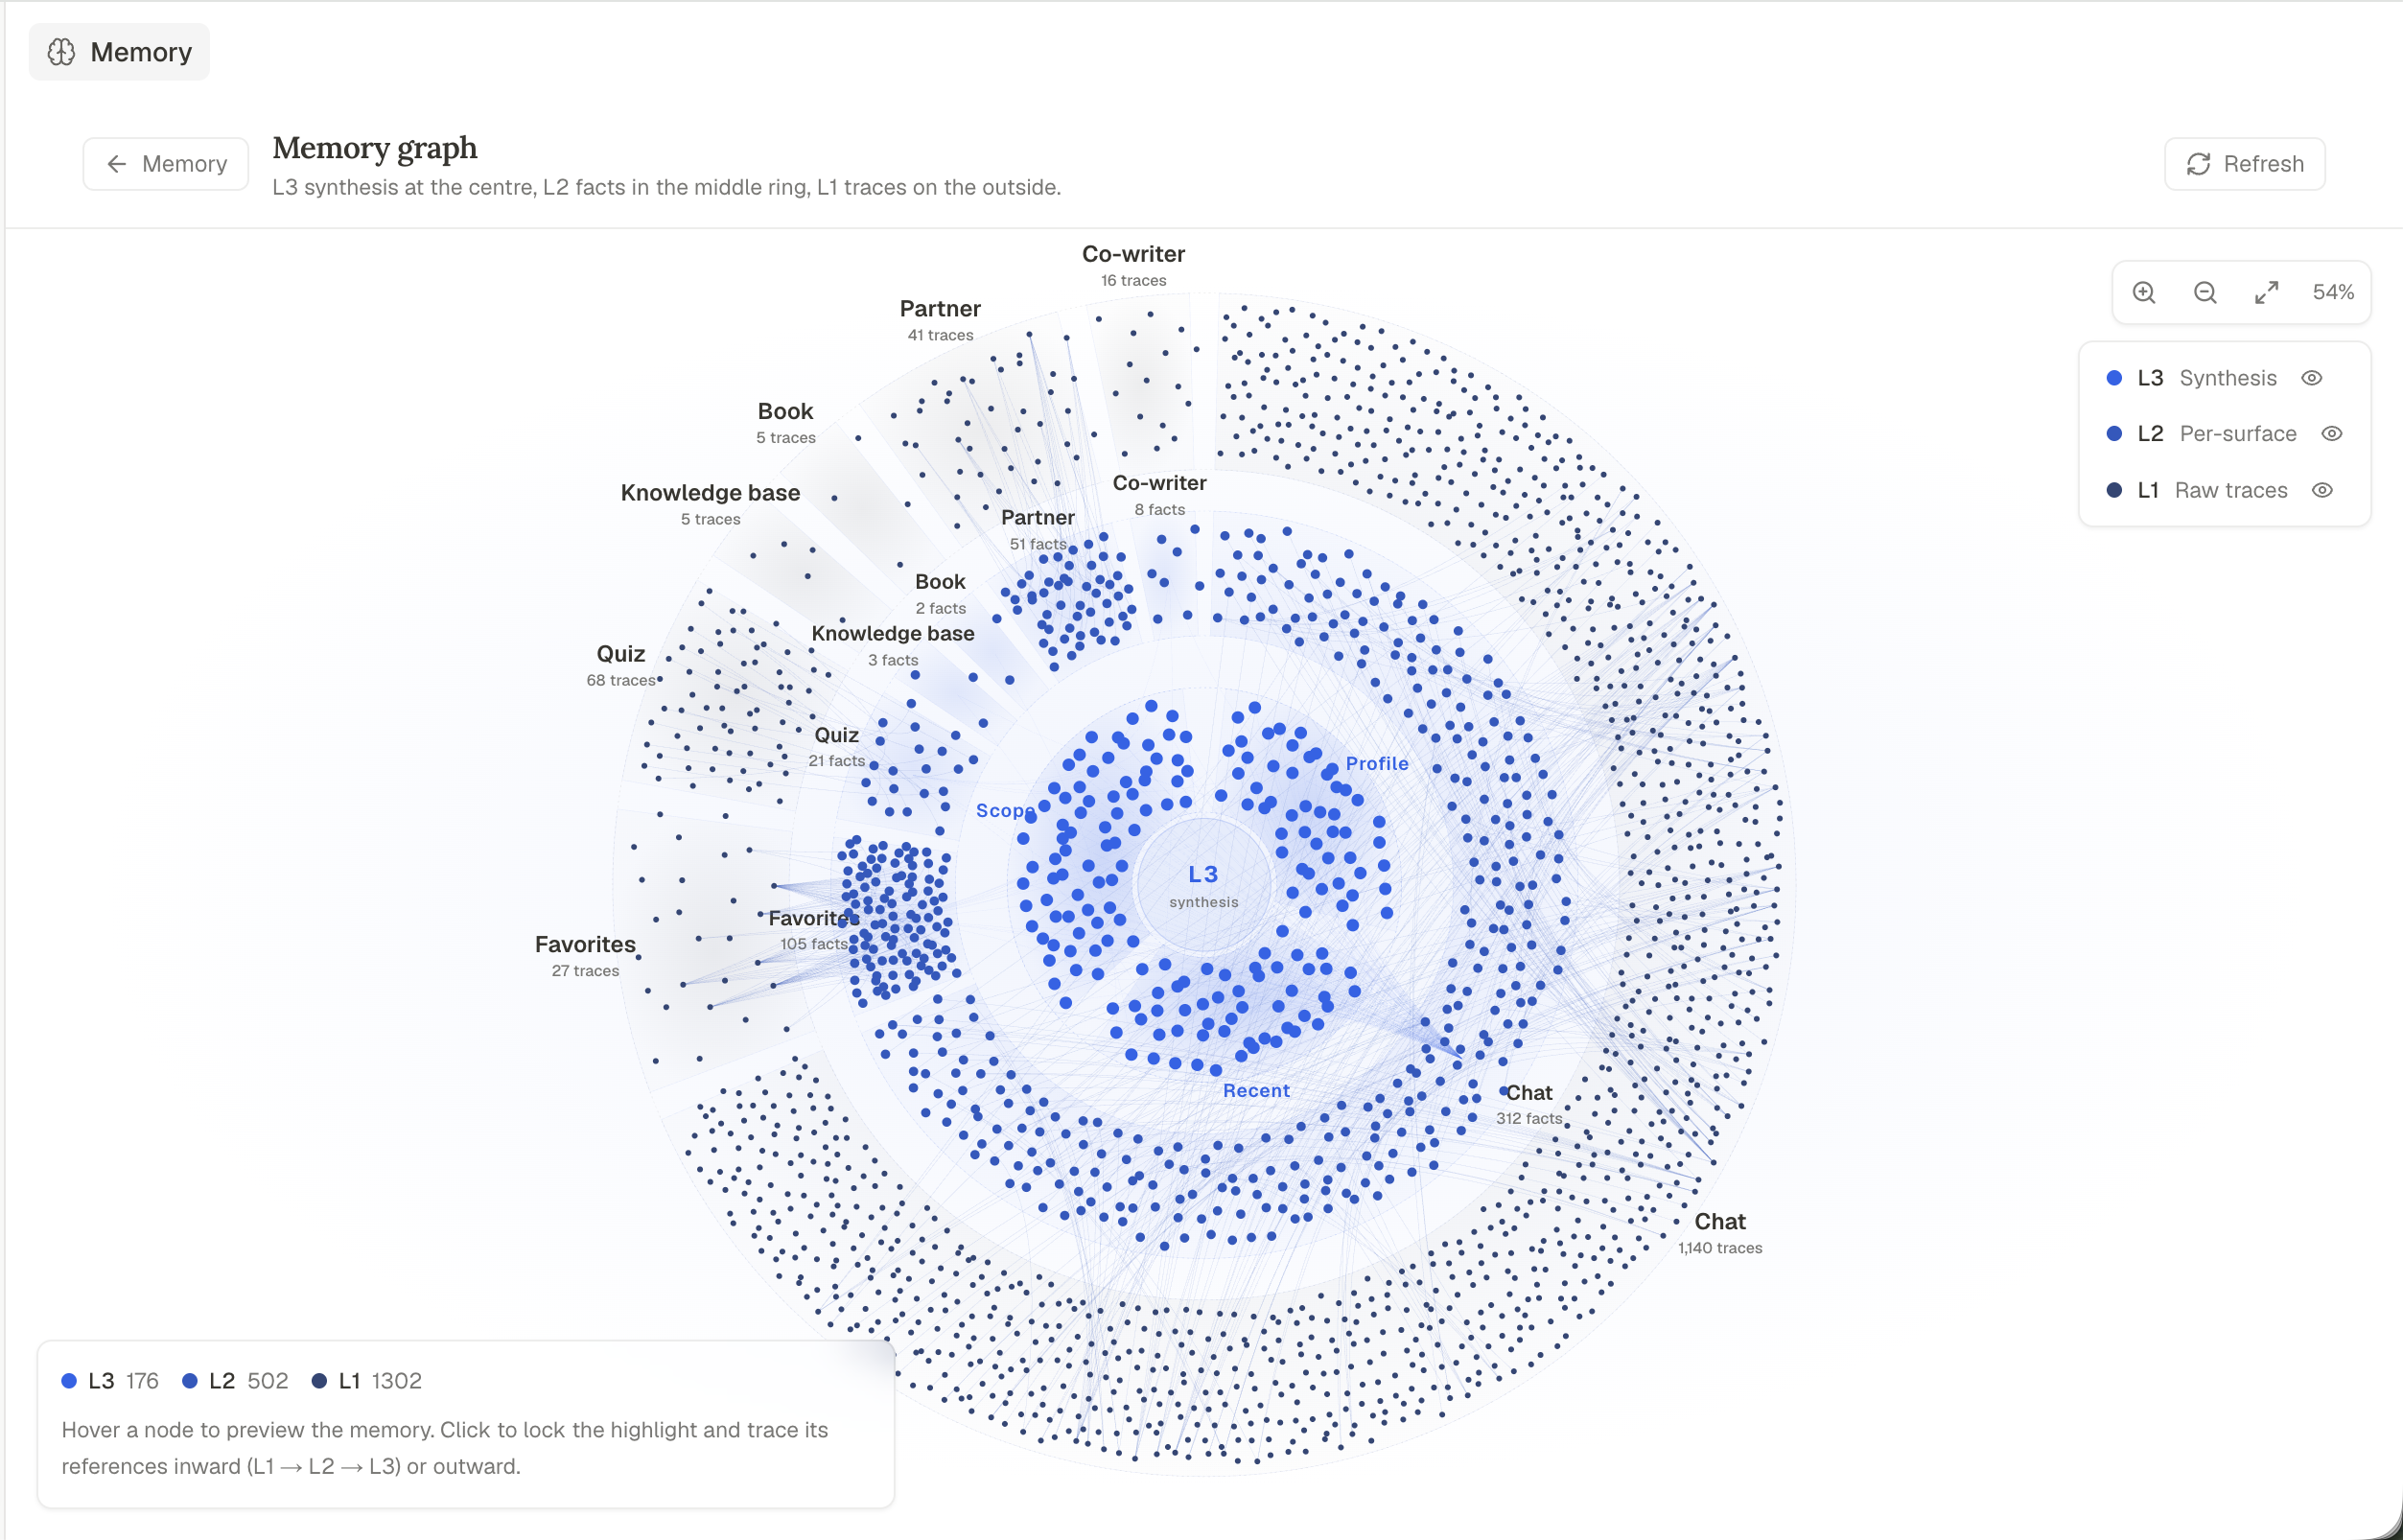
Le Memory Graph montre toute la pyramide — la synthèse L3 au centre, L2 dans l'anneau du milieu, les traces L1 à l'extérieur — avec des arêtes de preuve L2 → L1 exactes et des liens L3 → surfaces contributrices. La Memory est suivie sur les surfaces chat, notebook, quiz, kb, book, partner et cowriter ; les budgets Mise à jour / Audit / Déduplication du consolidateur sont réglés dans Paramètres → Memory.
⚙️ Settings — Un Seul Plan de Contrôle
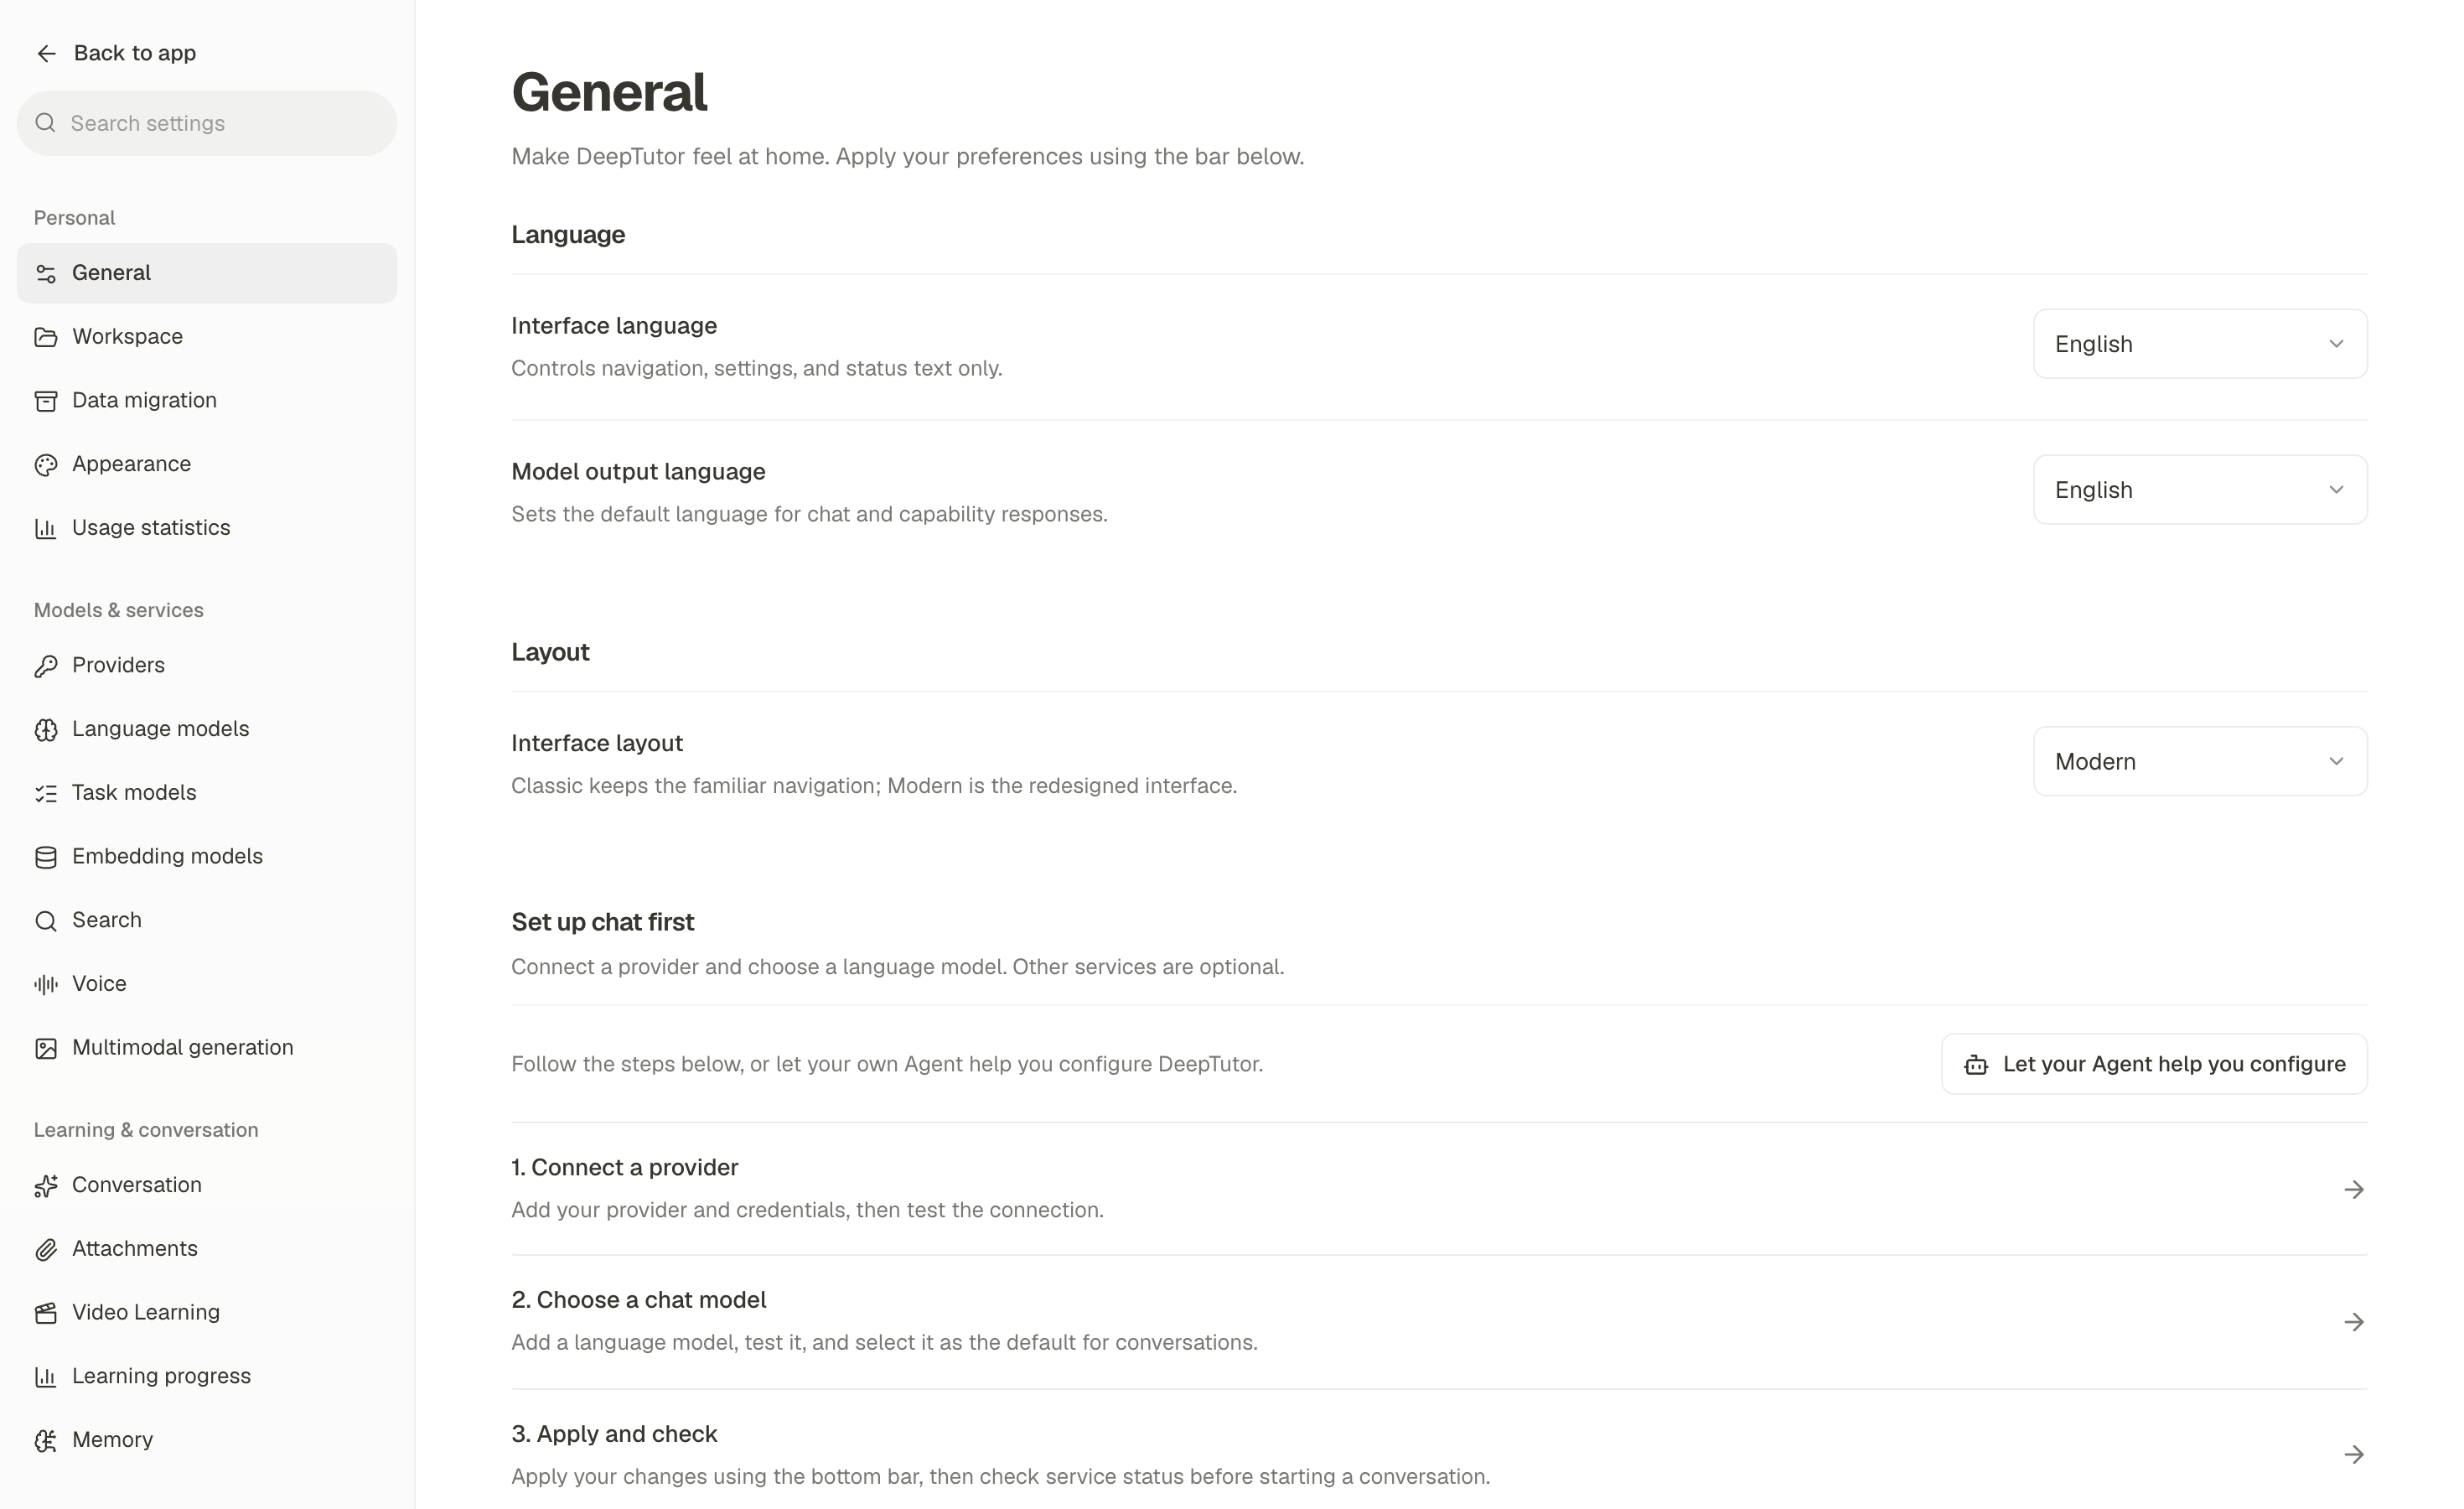
Settings est le plan de contrôle opérationnel et s'ouvre sur Général, pour la langue de l'interface et de sortie du modèle. Sa navigation avec recherche mène à des pages indépendantes : Personnel couvre les espaces de travail, la migration des données, l'apparence et les statistiques d'utilisation ; Apprentissage & conversation couvre les suggestions de démarrage, les pièces jointes, Video Learning, les contrôles des apprenants et des responsables, Progression d'apprentissage, ainsi que Memory ; Modèles & services couvre les fournisseurs, les modèles de langage, les modèles de tâche, Embedding, la recherche, la voix et la génération multimodale ; Fonctionnalités & intégrations couvre les outils, les paramètres des capacités, Partners & agents et Connaissances & documents. Système contient Réseau, État d'exécution et À propos ; Conversations archivées permet de rechercher, restaurer ou supprimer définitivement les conversations archivées. État d'exécution contient la santé du backend, la mémoire résidente et la matrice Readiness, qui évalue les blocages, avertissements et suggestions pour les capacités. Les espaces de travail séparent les fichiers thématiques et l'état d'apprentissage ; Migration des données propose une migration vérifiée et un export. Un fournisseur conserve l'adresse et les identifiants d'un prestataire pour ses modèles de service ; les pages des modèles sélectionnent des fournisseurs enregistrés et configurent les noms et capacités des modèles. Les modèles de tâche réservent un petit modèle rapide au travail automatique — du nommage des conversations et de la rédaction des suggestions de démarrage aux réparations de Math Animator et de Video Lesson — et utilisent le modèle actif par défaut si le champ est vide. Voix regroupe la synthèse vocale et la transcription ; Génération multimodale regroupe les modèles d'image et de vidéo. Partners & agents configure les harnesses locaux et une passerelle Hermes distante.
Vietnamien : dans Paramètres → Général, choisissez Tiếng Việt pour la langue de l'interface et sélectionnez Appliquer les modifications. La langue de sortie du modèle est indépendante : choisissez-y Tiếng Việt pour des réponses en vietnamien, ou conservez une autre langue de réponse tout en utilisant l'interface vietnamienne. La qualité des réponses dépend de la prise en charge du vietnamien par le modèle sélectionné.
Synthèse vocale Xiaomi MiMo. Ajoutez un fournisseur Xiaomi MiMo avec https://api.xiaomimimo.com/v1 et sa clé API, puis ajoutez mimo-v2.5-tts dans Paramètres → Voix. Choisissez un préréglage tel que mimo_default, 冰糖 ou 苏打, utilisez une sortie wav ou pcm16, puis écoutez un aperçu avant de l'appliquer. Les instructions vocales contrôlent le style et la vitesse de parole. Cet adaptateur ne prend en charge que les voix prédéfinies ; la conception et le clonage de voix nécessitent des modèles distincts et ne sont pas pris en charge. Si un ancien modèle vocal MiMo était configuré via l'adaptateur générique compatible OpenAI, recréez son entrée vocale avec le fournisseur Xiaomi MiMo afin qu'elle utilise le protocole chat-completions. Consultez le guide officiel de synthèse vocale MiMo.
Synthèse vocale MiniMax — dans Paramètres → Voix, choisissez MiniMax pour la synthèse vocale et sélectionnez speech-2.8-hd. Configurez une clé API MiniMax et sélectionnez explicitement une voix système ou saisissez un identifiant de voix personnalisé. L'URL de base de l'API est https://api.minimax.io/v1 par défaut ; pour la région Chine, utilisez https://api.minimaxi.com/v1. La lecture à voix haute et les aperçus vocaux utilisent le point de terminaison vocal natif, avec une sortie MP3, WAV, FLAC ou PCM et des contrôles de fréquence d'échantillonnage, de vitesse et de langue. Consultez l'API de synthèse vocale MiniMax pour les identifiants de voix et la disponibilité selon le compte.
Video Learning sous Paramètres → Apprentissage & conversation configure les sous-titres YouTube et l’accès à Invidious pour Reading. Pour utiliser Invidious, définissez son origine d’API backend gérée par l’administrateur (par exemple http://127.0.0.1:3000) et son origine publique accessible au navigateur, testez la connexion, sélectionnez Invidious, puis enregistrez. Parcourir Invidious, dans la boîte de dialogue d’ajout de supports de Reading, permet de rechercher des vidéos et d’accéder aux abonnements et listes de lecture connectés. La lecture YouTube utilise le lecteur officiel avec protection renforcée de la confidentialité ; l’absence de sous-titres reste visible et limite les éléments dont dispose le tuteur sans bloquer la lecture native. Dans un checkout des sources, exécutez python scripts/install_extras.py video-learning pour le chargeur de sous-titres YouTube par défaut. Les liens Watching existants migrent vers Reading en conservant l’historique des conversations, les transcriptions compatibles, les notes et la progression ; les nouvelles notes horodatées sont des annotations Reading. Bilibili utilise son propre parcours de lecture et de sous-titres.
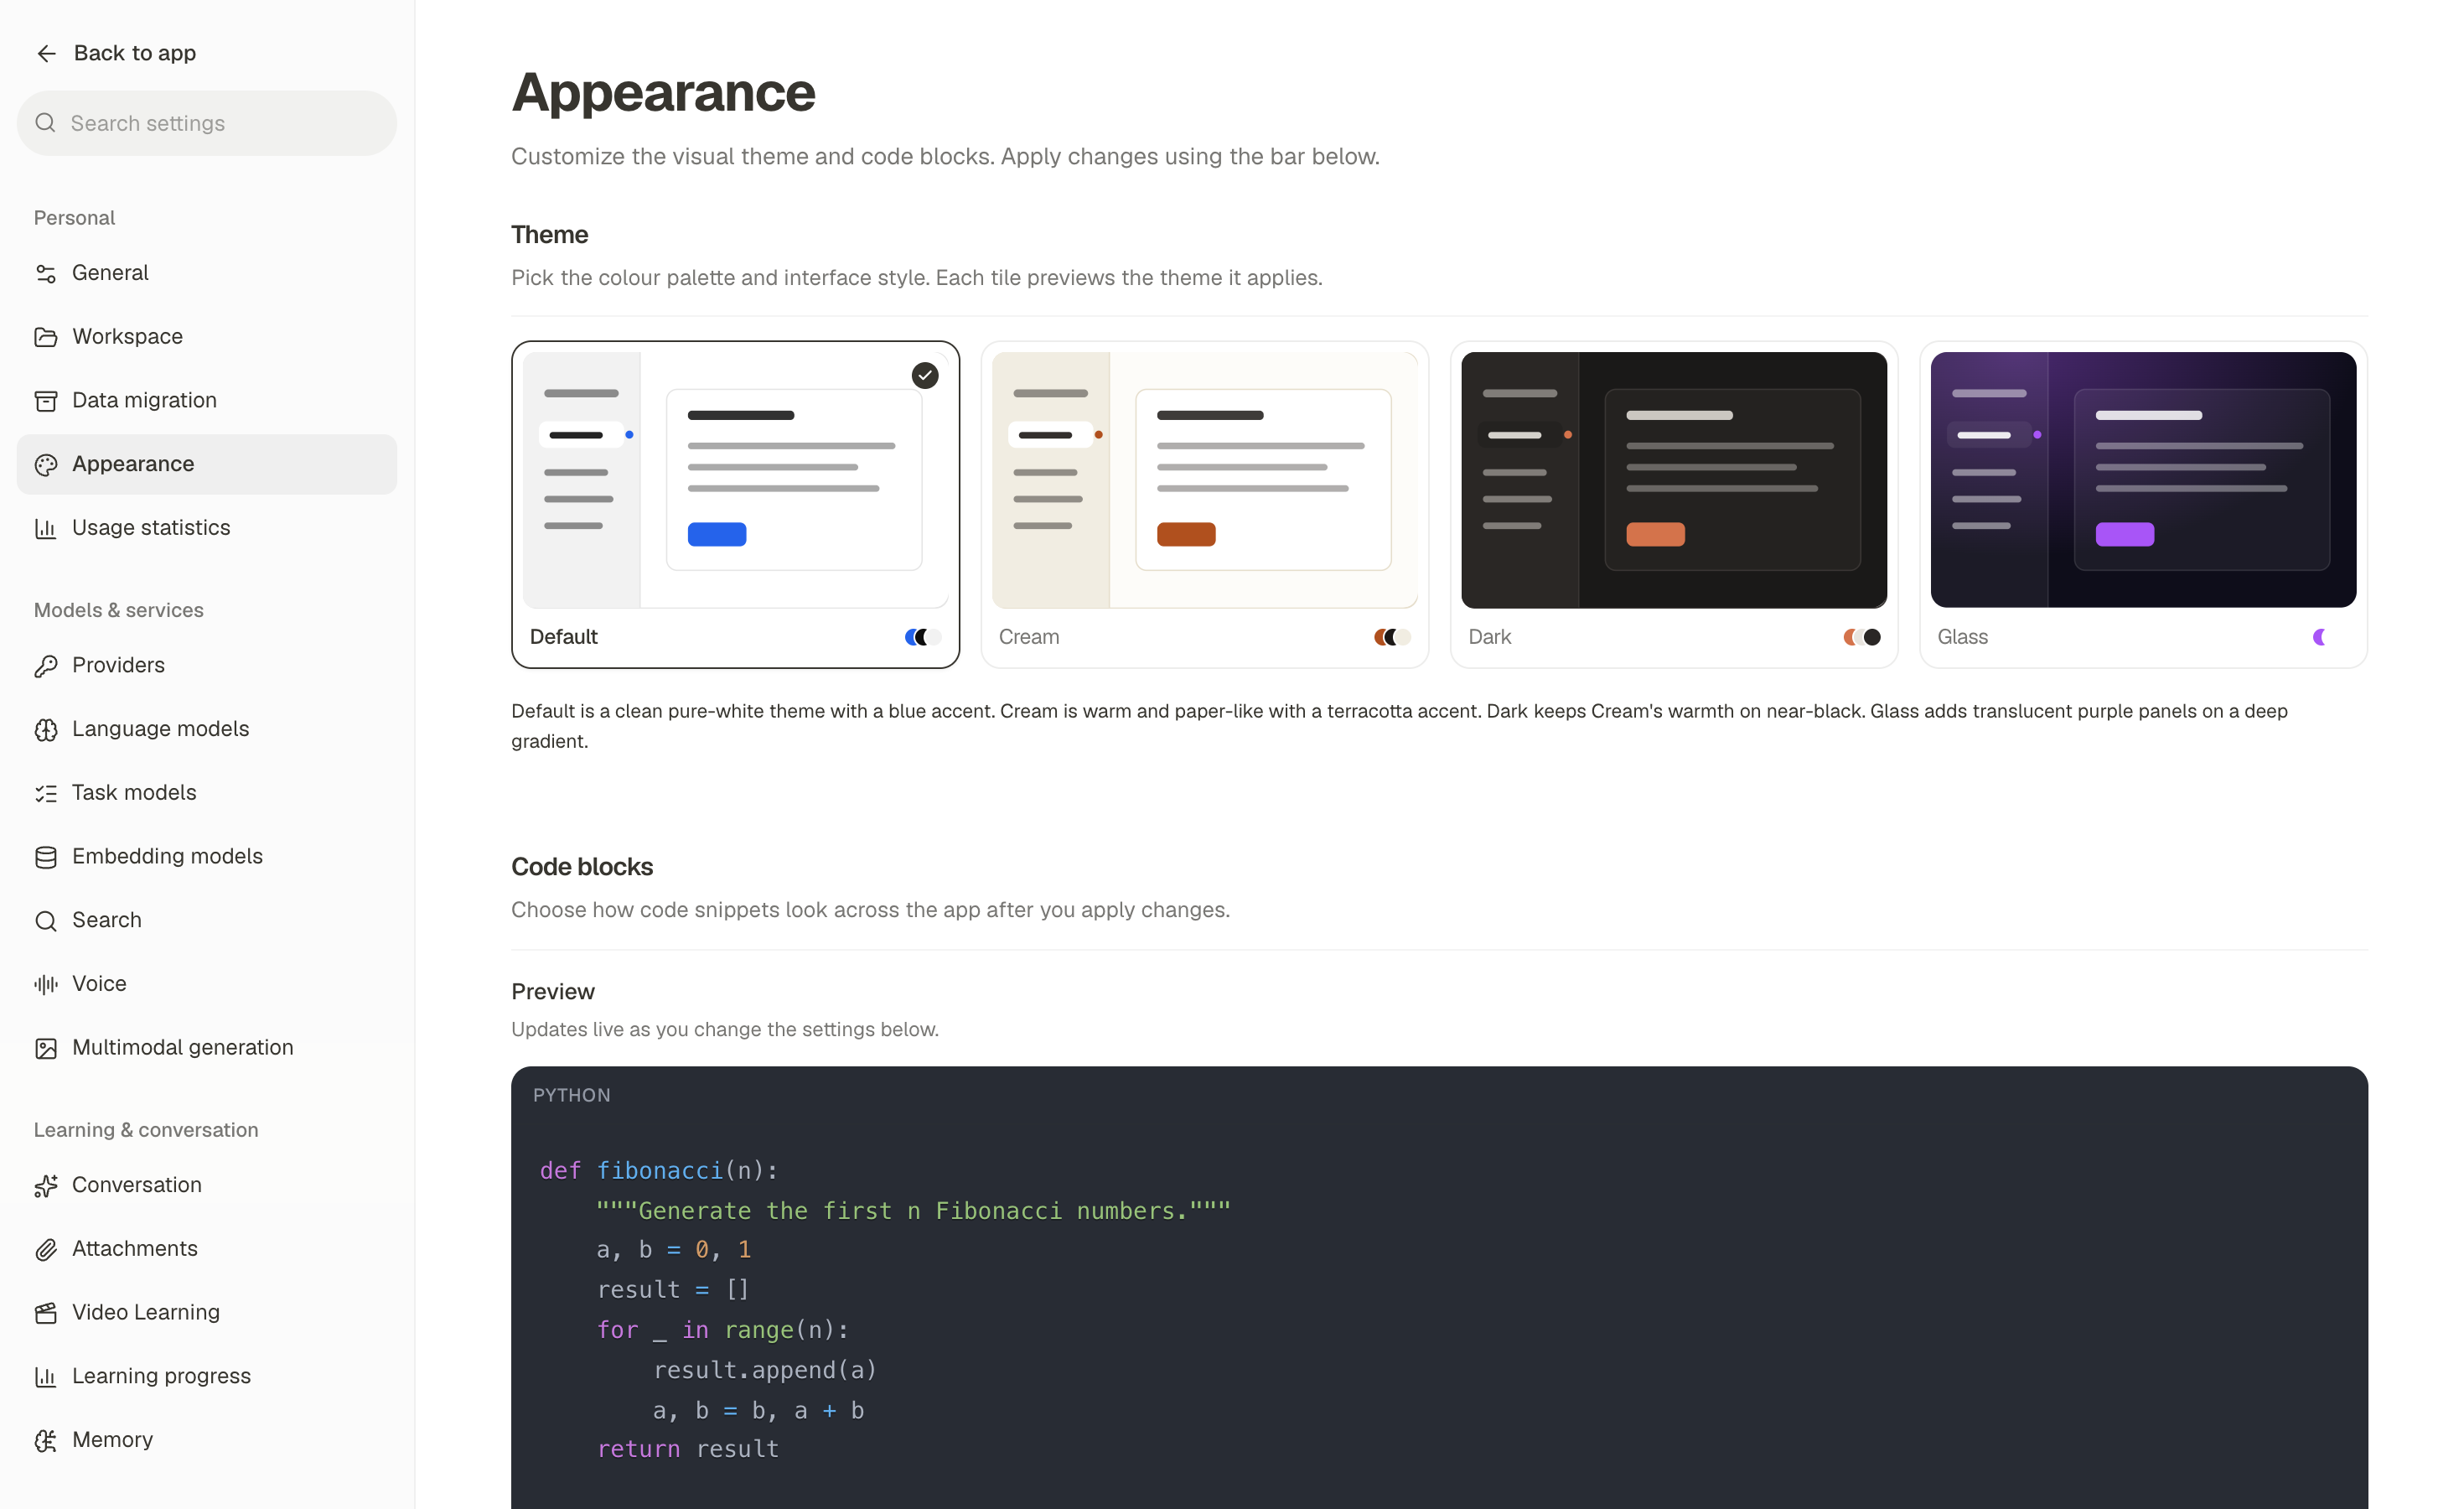
La plupart des sections utilisent un flux brouillon-et-application, vous pouvez donc tester un fournisseur avant de vous y engager. Vous pouvez aussi simplement demander dans Chat : l'assistant lit la configuration actuelle, applique un changement, et indique s'il nécessite un redémarrage ou une réindexation — sondant un nouveau modèle avant de s'y engager, afin qu'il ne puisse jamais se basculer lui-même vers quelque chose d'inaccessible. Les clés API ne transitent jamais par le modèle, qui ouvre à la place le formulaire correspondant pour vous. Quatre thèmes sont livrés dans la boîte — Default, Cream, Dark et Glass. Les fichiers .env à la racine du projet sont intentionnellement ignorés ; la configuration d'exécution vit sous data/user/settings/*.json sauf si DEEPTUTOR_HOME ou deeptutor start --home pointe l'application ailleurs.
OAuth OpenAI Codex (expérimental). Ajouter OpenAI Codex sous Paramètres → Fournisseurs ouvre une connexion dans le navigateur utilisant votre propre forfait ChatGPT, donc aucune OPENAI_API_KEY n'est nécessaire. Les jetons résident uniquement dans data/system/user-secrets/<owner>/private/openai-codex/ — dans le déploiement Compose multi-conteneurs, en dehors de tout arbre accessible au sandbox d'exécution — et DeepTutor ne lit ni ne modifie jamais votre connexion CLI ~/.codex. La liste des modèles provient du catalogue en direct de ce compte ; la connexion publie le profil, mais celui-ci ne devient le modèle actif que si aucun LLM n'est encore configuré. Comme un jeton autorise le forfait d'une seule personne, le profil n'est pas partageable par les attributions utilisateur : chaque compte se connecte pour lui-même, utilisateurs ordinaires compris. Leur carte de connexion se trouve sous Fournisseurs, et les modèles, le catalogue et la déconnexion qui en résultent restent privés à ce compte.
À la connexion et lors d'un Actualiser les modèles, DeepTutor lit la dernière version stable de @openai/codex depuis le registre npm officiel et l'utilise comme client_version de la requête de catalogue. Il s'agit uniquement de métadonnées : cela n'installe, ne télécharge ni ne met à jour le CLI Codex, et la requête npm ne transporte aucun identifiant OAuth. La découverte dispose d'un délai de trois secondes et d'une limite de réponse de 64 Kio. En cas d'échec, DeepTutor utilise la dernière version réussie pour ce compte, ou son repli intégré si aucune n'est mise en cache. Seul un catalogue en direct correctement analysé enregistre une nouvelle version ; les validateurs ne sont jamais réutilisés entre versions ou générations d'identifiants. Un rejet de version ou une structure de catalogue incompatible autorise une nouvelle tentative avec la version précédente ; les échecs d'authentification, de limitation de débit et TLS ne sont pas retentés comme des problèmes de version. Une actualisation manuelle en échec signale une erreur plutôt que de présenter un ancien catalogue mis en cache comme actualisé.
L'historique des versions réussies survit au renouvellement de jeton du même compte et aux erreurs d'authentification du catalogue, sans rendre à nouveau utilisables les données de modèle ou les ETags invalidés. La déconnexion efface le cache local de ce compte, y compris l'historique des versions. Les lectures d'état ordinaires et l'inférence n'interrogent pas npm. Les nouvelles entrées du catalogue ne remplacent pas un modèle déjà sélectionné ni ne redémarrent les sessions d'apprentissage ; figurer dans le catalogue n'établit pas une compatibilité complète du protocole d'inférence. Il n'existe pas de mise à jour de version en arrière-plan ni de paramètre de version utilisateur.
Les déploiements locaux par défaut Docker et Podman utilisent des réseaux loopback séparés et nécessitent un pont temporaire pendant la connexion. Suivez le guide du pont OAuth Codex local temporaire pour les commandes exactes de Docker, Compose, Podman et d'arrêt.
Pour un déploiement distant, le localhost du navigateur et le localhost du serveur sont deux machines différentes, donc un simple proxy inverse ne peut pas à lui seul acheminer le callback localhost du navigateur jusqu'au serveur. Utilisez un tunnel SSH comme pont de callback. Le tunnel atteint le port Web déjà publié ; Next.js ne réécrit que le chemin de callback exact vers le courtier de callback public, et ce courtier valide state avant de router vers l'opération OAuth d'origine. L'écouteur de callback reste sur le loopback du backend, les ports 1455 et 1457 ne sont pas publiés, et ce chemin prend en charge le réseau bridge Docker par défaut.
ssh -N -L 1455:127.0.0.1:3782 <ssh-user>@<server-host>
Si DeepTutor signale le port de callback de repli 1457, utilisez :
ssh -N -L 1457:127.0.0.1:3782 <ssh-user>@<server-host>
N'exécutez que la seule commande correspondant au port de callback réel ; n'exécutez jamais les deux. 3782 n'est que le port Web d'exemple : c'est le port frontend/conteneur configuré, rapporté comme callback_forward_port. Cette valeur ne garantit pas que ce même port écoute sur le 127.0.0.1 de l'hôte SSH. Si Docker ou Podman publie un port hôte différent, ou si un proxy inverse écoute sur un port différent, remplacez uniquement le port cible de droite (3782 ci-dessus) par le port Web réellement à l'écoute sur le 127.0.0.1 de l'hôte SSH ; conservez le port de callback de gauche à 1455 ou 1457. <server-host> est l'hôte SSH dont le loopback possède ce port à l'écoute. Si l'URL du navigateur nomme un proxy inverse ou un répartiteur de charge, remplacez-la par l'hôte frontend SSH correct.
La CLI affiche la commande de tunnel puis tente immédiatement d'ouvrir le navigateur. Sur un déploiement distant, laissez la page d'autorisation ouverte sans la terminer, établissez le tunnel affiché dans un autre terminal, et ne poursuivez l'autorisation qu'ensuite.
La détection de topologie distante a une limite liée à localhost. Si l'application Web elle-même est atteinte via un transfert localhost SSH ou IDE, le navigateur ne peut pas savoir que le serveur est distant. Pour l'opération Web en cours, laissez sa page d'autorisation inachevée, lisez redirect_uri dans l'URL d'autorisation de cette opération pour identifier le port de callback 1455 ou 1457, puis créez le second tunnel de ce port local vers le port Web réel. Autre possibilité : annulez cette opération Web et démarrez-en une nouvelle avec la CLI ; la sortie de la CLI appartient à la nouvelle opération et ne doit pas être utilisée pour l'opération Web existante. Les erreurs de quota et les échecs de catalogue sont rapportés tels quels et ne basculent jamais vers un fournisseur payant. Ce chemin de compatibilité est expérimental : l'interface en amont peut changer.
🛠️ Administration et déploiements partagés
Les cinq zones ci-dessus décrivent l'espace de travail destiné à l'apprenant. Les contrôles de déploiement suivants s'adressent aux administrateurs qui hébergent DeepTutor pour plusieurs utilisateurs.
👥 Multi-Utilisateur — Déploiements Partagés · authentification optionnelle, espaces de travail isolés par utilisateur
L'authentification est désactivée par défaut — DeepTutor fonctionne en mode mono-utilisateur. Activez-la et un seul arbre data/ héberge un espace de travail admin, des espaces de travail per-utilisateur isolés et des espaces de travail partner côte à côte :
data/
├── user/                    # Admin workspace + global settings
├── users/<uid>/             # Per-user scope: chat history, memory, notebooks, KBs
├── partners/<id>/workspace/ # Partner (synthetic-user) scope
├── cli-apps/                # Installed CLI apps, mounted read-only into the sandbox
└── system/                  # auth · grants · audit · user-secrets/<owner> (OAuth tokens)
Le premier utilisateur enregistré devient admin et possède les catalogues de modèles, les identifiants de fournisseur, les bases de connaissances partagées, les compétences, les livres partagés de référence et les attributions per-utilisateur. Les utilisateurs locaux créés par l'administrateur choisissent Standard, Learner ou Custom. Learner verrouille les capacités d'apprentissage et la politique des supports, ajoute un profil adaptatif et prend en charge des identifiants d'appareil révocables avec expiration et limites quotidiennes ; les guardians autorisés peuvent consulter les rapports, approuver des supports et réinitialiser les identifiants. Les autres utilisateurs obtiennent des espaces de travail isolés ainsi qu'un accès à portée limitée aux modèles, KB, compétences, Partners et livres partagés sans recevoir de clés API brutes. Si auth.json contient déjà un username + password_hash, ce compte est l'admin : /register reste fermé et les comptes créés depuis /admin/users ont toujours role=user jusqu'à leur promotion.
Activer : activez l'auth dans data/user/settings/auth.json, redémarrez deeptutor start, enregistrez le premier admin sur /register, puis ajoutez des utilisateurs depuis /admin/users et assignez des modèles, KB, compétences, Partners, politique d'outils/MCP/applications CLI et accès à l'exécution de code via des attributions ; configurez les livres partagés dans le panneau Book access de chaque utilisateur.
Pour des origines privées/publiques séparées, définissez auth.private_login_hosts (ou AUTH_PRIVATE_LOGIN_HOSTS) avec les hôtes frontend privés autorisés à afficher la connexion par mot de passe et l'inscription. Le frontend transmet le Host HTTP entrant au backend comme son assertion d'hôte frontend. Préservez le Host du navigateur à travers votre proxy inverse, et faites en sorte que l'entrée publique rejette les requêtes désignant un hôte privé ; n'exposez pas un port Next.js brut qui accepte des valeurs Host arbitraires. Le Host HTTP peut être forgé par un client direct, donc l'autorisation des hôtes privés dépend de cette frontière d'entrée. Le backend n'accepte les assertions d'hôte frontend que depuis le loopback par défaut. Si le frontend Web se connecte depuis un autre conteneur ou un autre hôte, définissez AUTH_TRUSTED_FRONTEND_PROXY_IPS avec l'adresse IP exacte de ce proxy frontend sur le processus backend (séparées par des virgules s'il y en a plusieurs). Cela remplace les valeurs par défaut ; incluez 127.0.0.1,::1 si des connexions frontend locales sont également nécessaires. Gardez l'API backend privée au proxy frontend et n'incluez pas de réseaux clients généraux dans cette liste. Lorsque private_login_hosts n'est pas vide, un utilisateur authentifié sur une origine privée peut ouvrir Profil → Connexion d'appareil public et créer un lien d'appairage à courte durée de vie, lié à l'hôte, pour une origine publique HTTPS. La page publique /handoff échange le code à usage unique contre un ticket JWE tout aussi court dans un corps POST, consomme le ticket une seule fois, et reçoit le cookie de session HttpOnly normal.
PocketBase reste une intégration mono-utilisateur — gardez
integrations.pocketbase_urlvide pour les déploiements multi-utilisateur sauf si vous avez configuré un store utilisateur externe.
⌨️ DeepTutor CLI — Interface Native à l'Agent
Un seul binaire deeptutor, deux façons d'accéder : un REPL interactif pour ceux qui vivent dans le terminal, et du JSON structuré pour d'autres agents qui pilotent DeepTutor comme un outil. Les mêmes capacités, outils et bases de connaissances dans les deux cas.
Piloter vous-même
deeptutor chat ouvre un REPL interactif et sélectionne un mode avec --capability ; deeptutor run <capability> "<message>" prend cette capacité comme premier argument positionnel et quitte après un tour. Les deux acceptent --tool, --kb, --config et --workspace pour sélectionner un espace de travail enregistré.
deeptutor chat                                              # interactive REPL
deeptutor chat --capability deep_solve --kb my-kb
deeptutor run chat "Explain the Fourier transform" --kb textbook
deeptutor run chat "Find recent work beyond this material" --kb textbook
deeptutor run deep_research "Survey 2026 papers on RAG" \
  --config mode=report --config depth=standard
--kb fournit le contexte aux outils automatiques RAG et Knowledge Frontier ; Frontier nécessite les modules knowledge et research. --tool sélectionne les outils basculables par l'utilisateur. Les modules activés fournissent également les commandes de gestion des KB, sessions, Partners, compétences, carnets, mémoire et configuration.
Laisser un agent piloter
DeepTutor est conçu pour être opéré par un autre agent. Ajoutez --format json à n'importe quel run et chaque tour diffuse du NDJSON — un événement par ligne (content, tool_call, tool_result, done, …), chaque ligne étant taguée avec son session_id. Les exécutions sont headless-safe : une pause ask_user sans TTY se résout automatiquement avec une réponse vide au lieu de bloquer.
# One shot, machine-readable
deeptutor run deep_solve "Find d/dx[sin(x^2)]" --tool reason --format json

# Chain turns in one stateful session — capture the id, reuse it
SID=$(deeptutor run deep_research "Survey 2026 papers on RAG" \
  --config mode=report --config depth=standard --format json \
  | jq -r 'select(.type=="done").session_id')
deeptutor run deep_question "Quiz me on that survey" --session "$SID" --format json
Le dépôt inclut un SKILL.md racine — un document de passation concis pour la CLI. Demandez explicitement à votre agent de le lire ; son guide de configuration par un agent couvre l’installation et la configuration. Vous pouvez aussi envelopper deeptutor run comme un outil dans une boucle LangChain / AutoGen. Recettes complètes : Agent Handoff.
Révision visuelle optionnelle pour les animations Manim
Définissez enable_visual_review=true pour inspecter les images rendues afin de détecter les chevauchements, les problèmes de lisibilité et de cadrage, puis réinjectez les problèmes détectés dans la boucle de réparation du code existante :
deeptutor run math_animator "Animate a sine wave" --config enable_visual_review=true
deeptutor run visualize "Animate a sine wave" \
  --config render_mode=manim_video --config enable_visual_review=true
Cette option vaut false par défaut. Elle fonctionne également avec output_mode=image pour math_animator et render_mode=manim_image pour visualize. Les autres visualiseurs, y compris la boucle générale auto, l'ignorent. Les dépendances optionnelles de Manim restent requises.
Pour les tours SDK, transmettez config={"enable_visual_review": True} dans la TurnRequest envoyée à DeepTutorApp.start_turn(). Les clients API utilisent le même objet config avec la valeur JSON true. Pour les blocs d'animation des livres, définissez params={"enable_visual_review": True} sur le Block d'animation.
La révision ajoute des appels au modèle de vision et peut ajouter des appels de réparation et de nouveaux rendus, ce qui augmente le coût et la latence. Elle utilise la limite existante de quatre tentatives, avec un délai de 120 secondes pour la révision et de 180 secondes pour la réparation. Si aucune image n'est disponible ou si le modèle de révision configuré ne peut pas inspecter les images, la révision est ignorée avec un résumé. Une révision infructueuse après toutes les tentatives renvoie le meilleur rendu disponible et son résultat de révision en échec ; un dépassement de délai de révision suit le chemin existant d'erreur et de nouvelle tentative de rendu. Les résultats de capacité exposent render.visual_review ; les blocs de livre conservent les mêmes données de révision dans metadata.visual_review (null lorsque la révision n'a pas été exécutée).
Référence des commandes
Le tableau couvre l’installation complète et les extensions optionnelles ; les commandes et capacités nécessitent l’activation de leurs modules. Le cœur fournit chat et ask_questions.
| Commande | Description |
|---|---|
deeptutor init [--non-interactive] [--home PATH] |
Exécuter l’assistant de configuration, ou créer les valeurs par défaut manquantes sans invite |
deeptutor doctor [--online] |
Vérifier si l'environnement d'exécution est prêt à démarrer une session ; --online sonde aussi le fournisseur de modèle configuré, --format json affiche le rapport |
deeptutor start [--home PATH] [--dev] [--detach] [--no-browser] |
Lancer le backend + frontend ensemble ; éventuellement détacher le processus ou empêcher l'ouverture du navigateur |
deeptutor stop [--home PATH] |
Arrêter un lanceur démarré avec --detach |
deeptutor serve [--port PORT] |
Démarrer uniquement le backend FastAPI |
deeptutor module list/install/uninstall/enable/disable |
Inspecter et modifier les modules lorsque DeepTutor est arrêté ; les checkouts des sources prennent en charge enable/disable |
deeptutor workspace show/set/reset |
Inspecter, sélectionner ou restaurer le Content Workspace par utilisateur |
deeptutor run <capability> <message> |
Exécuter un seul tour de capacité (chat, ask_questions, deep_solve, deep_question, deep_research, visualize, math_animator, video_lesson, mastery_path, immersive_reading, audio_overview) ; ajoutez --format json pour la sortie NDJSON |
deeptutor chat |
REPL interactif avec contrôles de capacité, outil, KB, carnet et historique |
deeptutor partner list/create/start/stop |
Gérer les partners connectés à IM |
deeptutor kb list/info/create/connect-kiwix/add/search/eval/eval-diff/set-default/delete/list-sources/sync |
Gérer les bases de connaissances, connecter des archives Kiwix, évaluer et comparer les exécutions de récupération et synchroniser les sources GitHub/web enregistrées (avec les commandes d'ajout et de suppression de sources) |
deeptutor skill search/install/list/remove/login/logout/publish/update |
Gérer les compétences, installer depuis les hubs et publier les siennes (eduhub:<slug> par défaut, voir Écosystème) |
deeptutor memory show/clear |
Inspecter les documents de mémoire L2/L3 ou effacer la mémoire L1/toute |
deeptutor session list/show/open/rename/delete |
Gérer les sessions partagées |
deeptutor notebook list/create/show/add-md/replace-md/remove-record |
Gérer les carnets depuis des fichiers Markdown |
deeptutor book list/health/refresh-fingerprints |
Inspecter les livres et actualiser les empreintes des sources |
deeptutor plugin list/info/state/search/show/install/approve/enable/disable/rollback/uninstall |
Inspecter les outils et les capacités ; gérer les paquets de plugins examinés et l’approbation de leurs permissions |
deeptutor config show [--home PATH] |
Afficher la configuration d’exécution résolue en masquant les identifiants |
deeptutor config providers |
Lister les fournisseurs pris en charge pour la configuration et leurs valeurs par défaut en JSON |
deeptutor config apply FILE [--check] [--home PATH] |
Appliquer une configuration JSON sans invite, ou la valider sans écrire de paramètres |
deeptutor provider login <provider> |
Authentification du fournisseur (openai-codex via OAuth ; github-copilot via la connexion d’appareil GitHub ; codebuddy valide l'authentification du SDK CodeBuddy et lance la connexion si nécessaire) |
Les identifiants GitHub Copilot appartiennent au propriétaire DeepTutor connecté et résident uniquement dans
<runtime-home>/data/system/user-secrets/<owner-id>/private/github-copilot/credentials.v1.json,
en dehors des espaces de travail du sandbox. Les Partners CLI/administrateur utilisent les identifiants de l’administrateur ;
les autres utilisateurs se connectent séparément et les profils Copilot ne peuvent pas être partagés via les attributions de modèles.
Les fichiers de jetons nanobot/Copilot externes ne sont jamais importés : après une mise à niveau, exécutez de nouveau
deeptutor provider login github-copilot.
La connexion valide l’inférence avec un modèle actuellement découvert ; init valide le modèle sélectionné
et s’interrompt en cas d’échec sans enregistrer le brouillon de configuration. Une authentification GitHub réussie
ne suffit pas à établir l’accès aux modèles Copilot (la connexion enregistrée est conservée si la validation échoue).
Les requêtes d’exécution suivent le point de terminaison API renvoyé par l’échange de jetons,
y compris lors des renouvellements, et respectent les métadonnées des points de terminaison Responses/Chat Completions de chaque modèle.
La compatibilité Responses propre à Copilot s’applique à l’envoi des requêtes sans réécrire l’historique enregistré.
Distribution CLI uniquement
Le wheel du cœur fournit la CLI et le SDK ; deeptutor-cli est un métapaquet de compatibilité. Les sources exposent tous les modules inclus : installez leurs dépendances Python et omettez la configuration du frontend pour utiliser la CLI :
python -m pip install -r requirements/full.txt
python -m pip install -e . --no-deps
Pour une installation minimale, utilisez le wheel du cœur. Les distributions optionnelles fournissent des outils, capacités, routes API, services en arrière-plan et éléments de navigation. Les modules partagent un environnement Python et doivent avoir la même version que le cœur. deeptutor[full] sélectionne les modules courants de l'application à l'installation ; les fonctionnalités individuelles peuvent toujours être supprimées ensuite.
Arrêtez DeepTutor (Ctrl+C dans son terminal), puis utilisez le même environnement Python et le même DEEPTUTOR_HOME :
deeptutor module list                       # installed / enabled / ready
deeptutor module disable research           # hide and deactivate; keep code
deeptutor module enable research            # restore it and required modules

# Package installations only; source checkouts use enable / disable:
deeptutor module install solve              # install the matching module and dependencies
deeptutor module uninstall solve --dry-run  # inspect the plan and dependency blockers
deeptutor module uninstall solve            # remove only this module's distribution
deeptutor chat                              # restart the CLI; use start for an installed Web app
Exemples : solve, research, questions, knowledge, parsing, reading, mastery, books, memory, notebook et partners. Les modules dépendants bloquent la suppression ; le cœur ne peut pas être supprimé par la commande module. La désactivation ou la désinstallation préserve les paramètres, conversations, bases de connaissances et fichiers générés. Les dépendances tierces partagées sont conservées.
Dans le navigateur : Paramètres → État d'exécution → Modules affiche l'état des modules et les commandes de terminal correspondantes. Les changements de paquets nécessitent un environnement arrêté et s'effectuent dans la CLI. Chat → Personnaliser la page et Apprentissage → Nouvelle activité d'apprentissage → Personnaliser la page modifient immédiatement vos choix personnels de pages ; masquer une entrée ne désinstalle pas son module et ne révoque pas l'accès.
La famille de paquets 1.7.0 utilise des versions identiques pour les wheels du cœur et des fonctionnalités. Pour installer des wheels locaux, passez --wheelhouse /path/to/wheels à module install. Consultez l'installation des modules et le développement depuis les sources pour construire les wheels et connaître les détails du déploiement.
🧩 Écosystème — EduHub & la Communauté de Compétences
Les compétences DeepTutor utilisent le format ouvert Agent-Skills — un dossier avec un livret de jeu SKILL.md (frontmatter YAML + Markdown) et des fichiers de référence optionnels. Rien dans ce format n'est spécifique à DeepTutor, donc tout registre qui parle le format devient une source pour votre bibliothèque. DeepTutor inclut EduHub — notre propre registre de compétences axé sur l'éducation — configuré comme hub par défaut.
EduHub — l'écosystème de compétences de DeepTutor
EduHub est le hub communautaire que DeepTutor a lancé pour partager des compétences d'agent orientées enseignement — tuteurs socratiques, constructeurs de fiches, retours sur les essais, plans d'examen, explicateurs de concepts, et plus encore. Il est intégré à DeepTutor, il n'y a donc rien à configurer : un slug nu ou un préfixe eduhub: le résout.
Trouver et installer — dans le navigateur, ouvrez Personnalisation → Compétences → Importer depuis EduHub pour parcourir le catalogue et télécharger une compétence directement dans votre bibliothèque. Depuis le terminal :
deeptutor skill search "socratic tutor"               # search EduHub (the default hub)
deeptutor skill install socratic-tutor                # fetch → verify → register
deeptutor skill install eduhub:[email protected]   # pin a hub and a version
deeptutor skill list                                  # local skills with their hub provenance
Publiez la vôtre — emballez un SKILL.md et partagez-le avec la communauté :
deeptutor skill login                                 # browser sign-in to EduHub
deeptutor skill publish ./my-skill                    # interactive: pick a track + tags, then upload
deeptutor skill update                                # roll back or release a new version
EduHub est également un registre autonome compatible ClawHub, de sorte que les agents qui ne sont pas DeepTutor (Claude Code, Codex, …) peuvent l'utiliser directement via le CLI eduhub — npx eduhub install socratic-tutor.
La porte de sécurité d'importation
Quelle que soit la source, chaque importation passe la même porte de sécurité avant que quoi que ce soit ne touche votre espace de travail :
- le verdict de sécurité du registre est vérifié en premier — les paquets signalés sont refusés sauf si vous passez
--allow-unverified; - les archives sont extraites de manière défensive avec des contrôles de traversée de chemin, de nombre d'entrées, de taille, de taux de compression, de suffixe et de lien symbolique ; les bits exécutables sont supprimés, tandis que les fichiers sans extension restent autorisés ;
- le frontmatter est normalisé selon le schéma de DeepTutor et
always:est supprimé, donc une compétence téléchargée ne peut jamais se forcer dans chaque prompt système ; - la provenance — hub, version, verdict et heure d'installation — est écrite dans
.hub-lock.jsonpour les audits et les mises à jour.
Dans les déploiements multi-utilisateur, les importations depuis le navigateur arrivent dans la couche de compétences de l'appelant authentifié, tandis que les installations via la CLI et la console d'administration ciblent l'espace de travail du propriétaire/administrateur ; les compétences administrateur restent masquées et en lecture seule pour les utilisateurs ordinaires jusqu'à leur attribution.
Également compatible avec ClawHub
Parce que DeepTutor parle le format ouvert Agent-Skills, ClawHub fonctionne aussi comme une source de première classe — il est intégré aux côtés d'EduHub. Choisissez-le avec le préfixe hub :
deeptutor skill search "git release notes" --hub clawhub
deeptutor skill install clawhub:[email protected]
deeptutor skill install clawhub:udiedrichsen/stock-analysis
Quand plusieurs éditeurs partagent le même slug, la recherche affiche chaque éditeur et une référence d'installation entièrement qualifiée (clawhub:<ownerHandle>/<slug>).
Ajoutez d'autres registres dans data/user/settings/skill_hubs.json : une entrée type: "clawhub" pointe vers n'importe quelle API HTTP compatible (EduHub et ClawHub parlent tous deux ce protocole), type: "command" enveloppe n'importe quelle CLI de récupération qu'un registre fournit, et "default" choisit le hub utilisé pour les slugs nus. Tous alimentent la même porte d'importation.
🤝 Partenaires Open Source

Avec le code : DEEPTUTOR20 — obtenez 20 $ de réduction sur votre premier abonnement PageIndex !
🌐 Communauté
🔗 Mainteneurs
 Bingxi Zhao |
 Xingyu Hou |
 Jiahao Zhang |
📮 Contact
DeepTutor est un projet open-source dirigé par Bingxi Zhao au sein du groupe HKUDS, et il itère sous une forme entièrement open-source, construit ensemble avec la communauté. Jusqu'à présent, nous N'AVONS PAS de produits en ligne payants sous quelque forme que ce soit. N'hésitez pas à nous contacter à [email protected] pour des discussions, des idées ou des collaborations.
🙏 Remerciements
Nos plus sincères remerciements à Chao Huang, directeur du Data Intelligence Lab @ HKU, et à nos collègues du laboratoire HKUDS pour leur soutien chaleureux — en particulier Jiahao Zhang, Zirui Guo et Xubin Ren. Nous sommes également profondément reconnaissants envers la communauté open-source : vos étoiles, issues, pull requests et discussions façonnent DeepTutor chaque jour.
DeepTutor se tient également sur les épaules de remarquables projets open-source qui nous ont fourni à la fois des outils et de l'inspiration :
| Projet | Rôle / Inspiration |
|---|---|
| LlamaIndex | Pipeline RAG et colonne vertébrale d'indexation de documents |
| nanobot | Moteur d'agent ultra-léger qui a propulsé le TutorBot original (HKUDS) |
| LightRAG | RAG simple & rapide (HKUDS) |
| AutoAgent | Framework d'agent sans code (HKUDS) |
| AI-Researcher | Pipeline de recherche automatisée (HKUDS) |
| OpenClaw | Passerelle d'agent ouverte et écosystème de compétences derrière ClawHub |
| Codex | CLI de codage natif à l'agent qui a inspiré notre flux de travail CLI |
| Claude Code | CLI de codage agentique qui a inspiré la boucle d'agent DeepTutor |
| ManimCat | Génération d'animations mathématiques pilotée par IA pour Math Animator |
🗺️ Feuille de Route & Contribution
Nous voulons que DeepTutor continue d'itérer et de s'améliorer — et finalement de devenir un cadeau que nous offrons en retour à la communauté open-source. Notre feuille de route est mise à jour en continu ; votez sur les éléments ou proposez-en de nouveaux. Si vous souhaitez contribuer, consultez le Guide de contribution pour la stratégie de branches, les normes de code et comment démarrer.
Nous espérons que DeepTutor deviendra un cadeau pour la communauté. 🎁
Consultez la liste des contributeurs de la branche de développement pour découvrir les contributions récemment intégrées.
Sous licence Apache License 2.0.
Explorer des projets similaires
affaan-m/ECC
Système d'optimisation des performances du framework d'exécution et de contrôle des agents. Il couvre les skills, les instincts, la mémoire, la sécurité et le développement qui privilégie la recherche, pour Claude Code, Codex, Opencode, Cursor et au-delà.
298,179 étoilesNousResearch/hermes-agent
L'agent qui grandit avec vous
261,025 étoilesmultica-ai/andrej-karpathy-skills
Un seul fichier CLAUDE.md pour améliorer le comportement de Claude Code, dérivé des observations d'Andrej Karpathy sur les pièges du codage avec les LLM.
230,066 étoilesfirecrawl/firecrawl
Boostez vos agents d'IA avec des données issues du web et au-delà. Nous construisons la bibliothèque pour la superintelligence. 🔥
199,027 étoiles