
tocreator/tostore
tocreator/tostore has 67 GitHub stars and 11 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-15 13:36 UTC. Last push 2026-11-05.
What you can do
- Declarative schema changes—automatic refactoring, no manual versioning
- Key rotation, schema migration, massive refactoring—all online, business-transparent
- Built-in status spec for automated O&M and Agent recognition
- Supports autonomous evolution and continuous iteration without interrupting service
Crecimiento de estrellas medido
- in 24h
- 0
- in 7 days
- 0
- in 15 days
- Actualización retrasada
- in 1 month
- Actualización retrasada
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
Acerca de
Data engine: AI vector & SQL/NoSQL database. Key-value/KV, embeddings, BM25 full-text, hybrid & semantic search for RAG/LLM. Local storage, TTL/LRU cache, offline encrypted.
IAdoc/translations/es/README.md
Original


English | 简体中文 | 日本語 | 한국어 | Español | Português (Brasil) | Русский | Deutsch | Français | Italiano | Türkçe
Navegación rápida
- Por qué almacenar | Características clave | Guía de instalación | Modo KV | Modo tabla | Modo de memoria
- Definición de esquema | Arquitectura distribuida | Claves externas en cascada | Móvil/Escritorio | Servidor/Agente | Algoritmos de clave primaria
- Consultas avanzadas (UNIRSE) | Agregación y estadísticas | Lógica compleja (Condición de consulta) | Consulta reactiva (ver) | Consulta de transmisión
- KV avanzado | Operaciones por lotes | Garantía de recuperación | Recuperación híbrida (denso / disperso / texto) | TTL a nivel de tabla | Evicción por capacidad | Paginación eficiente | Sonda de memoria y recuperación sincrónica (peek) | Caché de consultas | Expresiones atómicas | Transacciones
- Administración | Configuración de seguridad | Manejo de errores | Rendimiento y diagnóstico | Contribuir | Asistentes de IA
¿Por qué elegir ToStore?
ToStore es un motor de datos moderno diseñado para la era de la AGI y escenarios de inteligencia perimetral. Basado en una arquitectura de nodos de autorruta (Self-Routing), otorga a los nodos alta autonomía y escalabilidad horizontal elástica, desacoplando lógicamente el rendimiento de la escala de datos: en borde y nube, el mononodo está diseñado para tablas estructuradas a escala de billones, y la recuperación vectorial / de texto disperso también apunta a 10B+.
El modelado en tiempo de ejecución y las rutas de ejecución sin bloqueo mantienen la evolución de la arquitectura siempre en línea y totalmente transparente para las operaciones del negocio: los cambios declarativos de esquema, la rotación de claves de codificación de datos y la refactorización masiva de datos se realizan sin interrupciones. Soporta Agentes y O&M automatizado con creación de tablas en tiempo de ejecución, evolución dinámica de memoria y su evolución autónoma e iteración continua—sin interrumpir el servicio.
Unifica datos estructurados relacionales, vectores densos, vectores neuronales dispersos y texto no estructurado en un solo motor, con recuperación léxica de texto, recuperación de vectores densos, recuperación neuronal dispersa y fusión de recall multi-vía integradas. Incluye capacidades de nivel empresarial: transacciones ACID, consultas relacionales complejas (JOINs, claves externas en cascada), TTL a nivel de tabla, agregaciones, así como algoritmos de clave primaria distribuida, expresiones atómicas, cifrado, aislamiento multi-espacio y recuperación automática.
A medida que la computación continúa desplazándose hacia la inteligencia perimetral, los dispositivos ya no son simplemente "pantallas de contenido", sino nodos inteligentes responsables de la generación local, la percepción del entorno, la toma de decisiones en tiempo real y la coordinación de datos. ToStore otorga al borde capacidades distribuidas para conjuntos de datos masivos y generación compleja de IA local. La profunda colaboración inteligente entre nodos de borde y nube proporciona una base de datos confiable para interacción multimodal, memoria a largo plazo, RAG y bases de conocimiento locales, recuperación híbrida, modelado espacial, colaboración autónoma en el borde y escenarios similares.
Características clave
🤖 Evolución en tiempo de ejecución y O&M inteligente
- Cambios de esquema declarativos—refactorización automática, sin versionado manual
- Rotación de claves, migración de esquema, refactorización masiva—todo en línea, transparente al negocio
- Especificación de estado integrada para O&M automatizado y reconocimiento de Agentes
- Soporta evolución autónoma e iteración continua sin interrumpir el servicio
🧠 Arquitectura distribuida de autorruta
- Arquitectura de nodos de autorruta que desacopla el direccionamiento físico de la escala de datos
- Nodos altamente autónomos colaboran para construir una topología de datos flexible
- Escalabilidad horizontal elástica; mononodo: tablas a escala de billones, vectores 10B+
🌐 Motor de datos unificado multiplataforma
- API unificada en entornos móviles, de escritorio, web y servidor
- Cubre datos relacionales, vectores densos / neuronales dispersos y recuperación de texto
- Canal de datos completo desde el almacenamiento local hasta la colaboración borde-nube
🔍 Consultas estructuradas y recuperación híbrida
- Predicados complejos, JOINs, agregaciones, TTL a nivel de tabla y evicción por capacidad (FIFO / LRU)
- Texto léxico, vectores densos y recuperación neuronal dispersa en la misma cadena de consulta
- Ranking por fusión de recall multi-vía, con puntuaciones y diagnósticos de canal en el resultado
⚡ Ejecución paralela y planificación de recursos
- Arranque en frío constante ~35 ms, independiente de la escala de datos
- Planificación de carga con reconocimiento de recursos; descomposición paralela multinodo
- División temporal que mantiene las animaciones de UI fluidas incluso bajo carga pesada
🔐 Offline-First y privacidad
- Mantenga los datos en el dispositivo y utilizables sin conexión, reduciendo la dependencia de la nube y la superficie de exposición
- Aislamiento multi-espacio con compartición global opcional—listo para multiusuario / multitenant
- Cifrado ChaCha20-Poly1305 y AES-256-GCM integrado
- Verificado mediante múltiples escenarios complejos de recuperación ante desastres
Instalación
[!IMPORTANT] ¿Actualizando desde v2.x? Lea la Guía de actualización de v3.x para conocer los pasos críticos de migración y los cambios importantes.
Añade tostore a tu pubspec.yaml:
dependencies:
  tostore: any # Please use the latest version
For AI Coding Assistants
Al generar código cliente de ToStore con un asistente de IA, proporcione el corpus de un solo archivo llms-full.txt: por ejemplo @llms-full.txt en el IDE, suba/pegue el archivo, o indexe su raw URL en la documentación del asistente. Incluye firmas de API, restricciones y antipatrones para alinear al modelo con la superficie pública real. Índice: llms.txt.
Inicio rápido
[!TIP] ¿Cómo elegir un modo de almacenamiento?
- Modo clave-valor (KV): Lo mejor para acceso a la configuración, administración de estados dispersos o almacenamiento de datos JSON. Es la forma más rápida de empezar.
- Modo de tabla estructurada: Lo mejor para datos comerciales centrales que necesitan consultas complejas, validación de restricciones o gobernanza de datos a gran escala. Al introducir la lógica de integridad en el motor, puede reducir significativamente los costos de desarrollo y mantenimiento de la capa de aplicaciones.
- Modo de memoria: Ideal para cálculo temporal, pruebas unitarias, cachés en memoria acotadas (TTL y evicción por capacidad FIFO / LRU) o administración de estado global ultrarrápida. Con consultas globales y oyentes
watch, puede remodelar la interacción de la aplicación sin mantener un montón de variables globales.
Almacenamiento de valores clave (KV)
Este modo es adecuado cuando no necesita tablas estructuradas predefinidas. Es simple, práctico y está respaldado por un motor de almacenamiento de alto rendimiento. Su arquitectura de indexación eficiente mantiene el rendimiento de las consultas altamente estable y extremadamente receptivo incluso en dispositivos móviles comunes a escalas de datos muy grandes. Los datos en diferentes espacios están naturalmente aislados, mientras que también se admite el intercambio global.
// Initialize the database
final db = await ToStore.open();

// Set key-value pairs (supports String, int, bool, double, Map, List, Json, and more)
await db.setValue('user_profile', {
  'name': 'John',
  'age': 25,
});

// Switch space - isolate data for different users
await db.switchSpace(spaceName: 'user_123');

// Set a globally shared variable (isGlobal: true enables cross-space sharing, such as login state)
await db.setValue('current_user', 'John', isGlobal: true);

// Automatic expiration cleanup (TTL)
// Supports either a relative lifetime (ttl) or an absolute expiration time (expiresAt)
await db.setValue('temp_config', 'value', ttl: Duration(hours: 2));
await db.setValue('session_token', 'abc', expiresAt: DateTime(2026, 2, 31));

// Read data
final profile = await db.getValue('user_profile'); // Map<String, dynamic>

// Listen for real-time value changes (useful for refreshing local UI without extra state frameworks)
db.watchValue('current_user', isGlobal: true).listen((value) {
  print('Logged-in user changed to: $value');
});

// Listen to multiple keys at once
db.watchValues(['current_user', 'login_status']).listen((map) {
  print('Multiple config values were updated: $map');
});

// Remove data
await db.removeValue('current_user');
[!TIP] ¿Necesita más funciones de clave-valor? Para operaciones avanzadas como lectura segura de tipos (
getInt,getBool), incremento atómico, búsqueda por prefijo, consultas encadenadas paginadas de registros (db.kv.query()) y exploración de espacio de claves, consulte Operaciones avanzadas de clave-valor (db.kv).
Ejemplo de actualización automática de la interfaz de usuario de Flutter
En Flutter, StreamBuilder más watchValue te brinda un flujo de actualización reactiva muy conciso:
StreamBuilder(
  // When listening to a global variable, remember to set isGlobal: true
  stream: db.watchValue('current_user', isGlobal: true),
  builder: (context, snapshot) {
    // snapshot.data is the latest value of 'current_user' in KV storage
    final user = snapshot.data ?? 'Not logged in';
    return Text('Current user: $user');
  },
)
Modo de tabla estructurada
CRUD en tablas estructuradas requiere que el esquema se cree con anticipación (consulte Definición de esquema). Enfoques de integración recomendados para diferentes escenarios:
- Móvil/Escritorio: para escenarios de inicio frecuentes, se recomienda pasar
schemasdurante la inicialización. - Servidor/Agente: Para escenarios de larga duración, se recomienda crear tablas dinámicamente a través de
createTables.
// 1. Initialize the database
final db = await ToStore.open();

// 2. Insert data (prepare some base records)
final result = await db.insert('users', {
  'username': 'John',
  'email': '[email protected]',
  'age': 25,
});

// Unified operation result model: DbResult
// It is recommended to check hasErrors
if (!result.hasErrors) {
  print('Insert succeeded, generated primary key ID: ${result.firstPrimaryKey}');
} else {
  print('Insert failed: ${result.message}');
}

// Chained query (see [Query Operators](#query-operators); supports =, !=, >, <, LIKE, IN, and more)
final users = await db.query('users')
    .where('age', '>', 20)
    .where('username', 'like', '%John%')
    .orderByDesc('age')
    .limit(20);

// Update and delete
await db.update('users', {'age': 26}).where('username', '=', 'John');
await db.delete('users').where('username', '=', 'John');

// Real-time listening (see [Reactive Query](#reactive-query) for more details)
db.query('users').where('age', '>', 18).watch().listen((users) {
  print('Users matching the condition have changed: $users');
});

// Pair with Flutter StreamBuilder for automatic local UI refresh
StreamBuilder(
  stream: db.query('users').where('age', '>', 18).watch(),
  builder: (context, snapshot) {
    final users = snapshot.data ?? [];
    return ListView.builder(
      itemCount: users.length,
      itemBuilder: (context, index) => Text(users[index]['username']),
    );
  },
);
Modo de memoria
Para escenarios como almacenamiento en caché, cálculo temporal o cargas de trabajo que no necesitan persistencia en el disco, puede inicializar una base de datos pura en memoria a través de ToStore.memory(). En este modo, todos los datos, incluidos esquemas, índices y pares clave-valor, residen completamente en la memoria para lograr el máximo rendimiento de lectura/escritura.
El modo memoria admite varias estrategias de evicción: TTL a nivel de tabla / TTL de KV por tiempo, y Evicción por capacidad (FIFO / LRU) por cantidad o tamaño—por separado o combinadas, para que los datos calientes caduquen a tiempo o queden acotados. Ideal para cachés de sesión, pools de resultados y rutas sensibles a la memoria.
💡 También funciona como Gestión del Estado Global
No necesita un montón de variables globales ni un marco de gestión estatal pesado. Al combinar el modo de memoria con watchValue o watch(), puede lograr una actualización de la interfaz de usuario completamente automática en todos los widgets y páginas. Mantiene las poderosas capacidades de recuperación de una base de datos y al mismo tiempo le brinda una experiencia reactiva mucho más allá de las variables ordinarias, lo que lo hace ideal para el estado de inicio de sesión, la configuración en vivo o los contadores de mensajes globales.
[!CAUTION] Nota: Los datos creados en el modo de memoria pura se pierden por completo después de cerrar o reiniciar la aplicación. No lo utilice para datos comerciales principales.
// Pure in-memory DB — TTL and/or FIFO/LRU capacity eviction as needed
final memDb = await ToStore.memory(
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
  ),
);

// Set a global state value (for example: unread message count)
await memDb.setValue('unread_count', 5, isGlobal: true);

// Listen from anywhere in the UI without passing parameters around
memDb.watchValue<int>('unread_count', isGlobal: true).listen((count) {
  print('UI automatically sensed the message count change: $count');
});

// All CRUD, KV access, and vector search run at in-memory speed
await memDb.insert('active_users', {'name': 'Marley', 'status': 'online'});
Definición del esquema
Defina una vez y deje que el motor maneje la gobernanza automatizada de extremo a extremo para que su aplicación ya no requiera un mantenimiento de validación pesado.
Los siguientes ejemplos de dispositivos móviles, del lado del servidor y de agentes reutilizan appSchemas definido aquí.
Descripción general del esquema de tabla
const userSchema = TableSchema(
  name: 'users', // Table name, required
  tableId: 'users', // Unique identifier of the table, optional
  primaryKeyConfig: PrimaryKeyConfig(
    name: 'id', // Primary key field name, defaults to id
    type: PrimaryKeyType.sequential, // Primary key auto-generation strategy
    sequentialConfig: SequentialIdConfig(
      initialValue: 1000, // Initial value for sequential IDs
      increment: 1, // Step size
      useRandomIncrement: false, // Whether to use random step sizes
    ),
  ),
  fields: [
    FieldSchema(
      name: 'username', // Field name, required
      type: DataType.text, // Field data type, required
      nullable: false, // Whether null is allowed
      minLength: 3, // Minimum length
      maxLength: 32, // Maximum length
      unique: true, // Whether it must be unique
      fieldId: 'username', // Stable field identifier, optional, used to detect field renames
      comment: 'Login name', // Optional comment
    ),
    FieldSchema(
      name: 'status',
      type: DataType.integer,
      minValue: 0, // Minimum numeric value
      maxValue: 150, // Maximum numeric value
      defaultValue: 0, // Static default value
      createIndex: true, // Shortcut for creating an index
    ),
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      defaultValueType: DefaultValueType.currentTimestamp, // Automatically fill with current time
      createIndex: true,
    ),
  ],
  indexes: const [
    IndexSchema(
      indexName: 'idx_users_status_created_at', // Optional index name
      fields: ['status', 'created_at'], // Composite index fields
      unique: false, // Whether it is a unique index
      type: IndexType.btree, // Index type: btree/vector
    ),
  ],
  foreignKeys: const [], // Optional foreign-key constraints; see "Foreign Keys & Cascading"
  isGlobal: false, // Whether this is a global table; true means it can be shared across spaces
  ttlConfig: null, // Optional table-level TTL; see "Table-level TTL"
  capacityConfig: null, // Optional capacity eviction; see "Capacity Eviction"
);

const appSchemas = [userSchema];
Asignaciones
DataTypecomunes:Tipo Tipo de dardo correspondiente Descripción integerintEntero estándar, adecuado para ID, contadores y datos similares bigIntBigInt/StringEnteros grandes; recomendado cuando los números superan los 18 dígitos para evitar pérdida de precisión doubledoubleNúmero de coma flotante, adecuado para precios, coordenadas y datos similares textStringCadena de texto con restricciones de longitud opcionales blobUint8ListDatos binarios sin procesar booleanboolValor booleano datetimeDateTime/StringFecha/hora; almacenado internamente como ISO8601 arrayListTipo de lista o matriz jsonMap<String, dynamic>Objeto JSON, adecuado para datos estructurados dinámicos vectorVectorData/List<num>Vectores densos para recuperación semántica de vecinos cercanos (embeddings) sparseSparseVectorDataVectores neuronales dispersos para recuperación dispersa PrimaryKeyTypeestrategias de generación automática:Estrategia Descripción Características noneSin generación automática Debe proporcionar manualmente la clave principal durante la inserción sequentialIncremento secuencial Bueno para identificaciones amigables para humanos, pero menos adecuado para rendimiento distribuido timestampBasedBasado en marca de tiempo Recomendado para entornos distribuidos datePrefixedCon prefijo de fecha Útil cuando la legibilidad de la fecha es importante para el negocio shortCodeClave primaria de código corto Compacto y adecuado para pantalla externa
Todas las claves principales se almacenan como
text(String) de forma predeterminada.
Restricciones y validación automática
Puede escribir reglas de validación comunes directamente en FieldSchema, evitando la lógica duplicada en el código de la aplicación:
nullable: false: restricción no nulaminLength/maxLength: restricciones de longitud del textominValue/maxValue: restricciones de rango de números enteros o de punto flotantedefaultValue/defaultValueType: valores predeterminados estáticos y valores predeterminados dinámicosunique: restricción únicacreateIndex: crea índices para filtrado, clasificación o relaciones de alta frecuenciafieldId/tableId: ayuda a la detección de cambio de nombre para campos y tablas durante la migración
Además, unique: true crea automáticamente un índice único de un solo campo. createIndex: true y las claves externas crean automáticamente índices normales de un solo campo. Utilice indexes cuando necesite índices compuestos, índices con nombre o índices de recuperación de texto / dispersos / vectoriales.
Evolución del esquema (Schema Evolution)
El motor detecta automáticamente los cambios estructurales (alta, baja o renombrado de tablas/campos, ajustes de atributos, cambios de índices, etc.) y completa la migración de datos: no hace falta versionar la base manualmente ni escribir scripts. Los schemas declarativos evolucionan en ToStore.open(); en tiempo de ejecución también puede usar updateSchema—transparente para el negocio, sin interrumpir lecturas ni escrituras.
Promover un campo único a clave primaria
Puede promover un campo existente único y no nulo a clave primaria (renombrado opcional; con datos existentes; transparente para el negocio). No combine con setPrimaryKeyConfig.
- Móvil (
schemasdeclarativos): Se detecta automáticamente enToStore.open(). La clave primaria de destino debe serPrimaryKeyType.none(los valores vienen del campo único de origen; no se admiten otros tipos auto-generados). Si el nombre coincide, basta con el nombre; para renombrar, indique elfieldIdde origen enfromFieldId. - Servidor (tiempo de ejecución): Llame a
updateSchema(...).promoteFieldToPrimaryKey(sourceFieldName: ..., targetPrimaryKeyName: ...).targetPrimaryKeyNamees opcional; omítalo para conservar el nombre del campo de origen.
Elegir un método de integración
- Móvil/Escritorio: mejor cuando se pasa
appSchemasdirectamente aToStore.open(...) - Servidor/Agente: mejor cuando se crean esquemas dinámicamente en tiempo de ejecución a través de
createTables(appSchemas)
Integración para dispositivos móviles, de escritorio y otros escenarios de inicio frecuentes
📱 Ejemplo: mobile_quickstart.dart
import 'package:path/path.dart' as p;
import 'package:path_provider/path_provider.dart';

// On Android/iOS, resolve the app's writable directory first, then pass dbPath explicitly
final docDir = await getApplicationDocumentsDirectory();
final dbRoot = p.join(docDir.path, 'common');

// Reuse the appSchemas defined above
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
);

// Multi-space architecture - isolate data for different users
await db.switchSpace(spaceName: 'user_123');
Seguimiento del progreso de inicio
Los cambios de esquema normales son transparentes para la lógica de negocio y no bloquean el inicio. Solo en casos excepcionales raros específicos de aplicaciones móviles que se cierran forzosamente con frecuencia (por ejemplo, una breve validación de datos y recuperación de fallas tras una salida anormal) la inicialización puede tardar un tiempo perceptible — use onStartupProgress para mostrar una pantalla de bienvenida o un indicador de progreso:
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
  onStartupProgress: (progress, stage) {
    // progress: 0.0 – 1.0  |  stage: opening → recovering → optimizing → ready
    print('Progreso de inicio ${(progress * 100).toStringAsFixed(0)}% [$stage]');
    // Actualizar pantalla de bienvenida / barra de progreso
  },
);
// Base de datos completamente lista
Etapas:
opening— Cargando configuración, preparando el motor baserecovering— Comprobaciones de seguridad y recuperación tras fallooptimizing— Ajuste interno del motor y optimización estructuralready— Inicialización completa, listo para usar
Mantener el estado de inicio de sesión y cierre de sesión (espacio activo)
El espacio múltiple es ideal para aislar datos de usuario: un espacio por usuario, activado al iniciar sesión. Con Active Space y las opciones de cierre, puedes mantener al usuario actual durante los reinicios de la aplicación y admitir un comportamiento de cierre de sesión limpio.
- Mantener estado de inicio de sesión: después de cambiar a un usuario a su propio espacio, marque ese espacio como activo. El próximo lanzamiento puede ingresar a ese espacio directamente al abrir la instancia predeterminada, sin un paso de "predeterminado primero, luego cambiar".
- Cerrar sesión: Cuando el usuario cierre sesión, cierre la base de datos con
keepActiveSpace: false. El próximo lanzamiento no ingresará automáticamente al espacio del usuario anterior.
// After login: switch to the user's space and mark it active
await db.switchSpace(spaceName: 'user_$userId', keepActive: true);

// Optional: strictly stay in default when needed (for example, login screen only)
// final db = await ToStore.open(..., applyActiveSpaceOnDefault: false);

// On logout: close and clear the active space so the next launch starts from default
await db.close(keepActiveSpace: false);
Integración del lado del servidor/agente (escenarios de larga duración)
🖥️ Ejemplo: server_quickstart.dart
final db = await ToStore.open();

// Create table structures while the process is running
await db.createTables(appSchemas);

// Online schema updates
final result = await db.updateSchema('users')
  .renameTable('users_new')                // Rename table
  .modifyField(
    'username',
    minLength: 5,
    maxLength: 20,
    unique: true
  )                                        // Modify field attributes
  .renameField('old_name', 'new_name')     // Rename field
  .removeField('deprecated_field')         // Remove field
  .addField('created_at', type: DataType.datetime)  // Add field
  .removeIndex(fields: ['age'])            // Remove index
  .setPrimaryKeyConfig(                    // Change auto-generated PK strategy; avoid when the table already has data
    const PrimaryKeyConfig(type: PrimaryKeyType.shortCode)
  );
// Promote a unique field to PK (see promote-primary-key section; do not chain with the above):
// await db.updateSchema('users').promoteFieldToPrimaryKey(
//   sourceFieldName: 'user_id',
//   targetPrimaryKeyName: 'uid', // optional; omit to keep the source field name
// );

// Monitor migration progress
final taskId = result.taskId;
if (taskId != null) {
  // Inspect migration metadata
  print('Estimated duration: ${result.estimateDuration?.inMilliseconds} ms');
  print('Migration write mode: ${result.writeMode}'); // e.g. MigrationWriteMode.indexOnly

  final status = await db.queryMigrationTaskStatus(taskId);
  print('Migration progress: ${status?.progressPercentage}%');
}


// Optional performance tuning for pure server workloads
// yieldDurationMs controls how often long-running work yields time slices.
// The default is tuned to 8ms to keep frontend UI animations smooth.
// In environments without UI, 50ms is recommended for higher throughput.
final dbServer = await ToStore.open(
  config: DataStoreConfig(yieldDurationMs: 50),
);
Uso avanzado
ToStore proporciona un amplio conjunto de capacidades avanzadas para escenarios empresariales complejos:
Operaciones avanzadas de clave-valor (db.kv)
Para escenarios de clave-valor más complejos, se recomienda utilizar el espacio de nombres db.kv. Proporciona un conjunto completo de API con aislamiento de espacio, uso compartido global, múltiples tipos de datos, así como consultas y filtros complejos encadenados (p. ej. db.kv.query().prefix(...).orderBy...().limit(...) para paginación, ordenación, filtrado por caducidad, etc.).
Acceso básico (Basic Access)
// Establecer valor (admite String, int, bool, double, Map, List, etc.)
await db.kv.set('key', 'value', ttl: Duration(hours: 1));

// Obtener valor dinámico sin procesar
dynamic val = await db.kv.get('key');

// Eliminar una sola clave
await db.kv.remove('key');
Obtenedores con seguridad de tipos (Type-Safe Getters) Recupere datos directamente en el formato de destino sin conversión manual:
String? name = await db.kv.getString('user_name');
int? age = await db.kv.getInt('user_age');
bool? isVip = await db.kv.getBool('is_vip');
Map<String, dynamic>? profile = await db.kv.getMap('profile');
List<String>? tags = await db.kv.getList<String>('tags');
Operaciones por lotes (Bulk Operations) Procese de manera eficiente múltiples pares clave-valor en una sola operación:
// Establecer por lotes
await db.kv.setMany({
  'theme': 'dark',
  'language': 'es_ES',
});

// Eliminar por lotes
await db.kv.removeKeys(['temp_1', 'temp_2']);
Contadores atómicos (Atomic Increment) Incremente o decremente valores numéricos de forma segura en escenarios de alta concurrencia:
// Incrementar en 1 (predeterminado)
await db.kv.setIncrement('view_count');
// Decrementar en 5 (pasar un valor negativo)
await db.kv.setIncrement('stock_count', amount: -5);
Consultas encadenadas de registros (db.kv.query) API encadenada similar a
db.query()para consultar registros clave-valor (convaluedecodificado) y con paginación. A diferencia degetKeys(solo nombres de clave), esto devuelve registros completos.// Primera página: filtrar por prefijo, ordenar por updated_at descendente, 20 por página final page = await db.kv.query() .prefix('setting_') .orderByUpdatedAtDesc() // o orderByKeyAsc / orderByKeyDesc / orderByUpdatedAtAsc .limit(20); for (final record in page.data) { // record contiene: key, value, updated_at, expires_at print('${record['key']} = ${record['value']}'); } // Recomendado: paginar con next() / prev() (igual que consultas de tabla, lo más sencillo) if (page.hasMore) { final page2 = await page.next(); print('Página siguiente: ${page2.data.length}'); if (page2.hasPrev) { final back = await page2.prev(); print('Página anterior: ${back.data.length}'); } } // Paginación por offset (excluyente con cursor; para páginas profundas preferir next() arriba) final byOffset = await db.kv.query() .orderByKeyAsc() .limit(20) .offset(20); // Total de registros coincidentes (sin prefix: estadística de metadatos O(1)) final total = await db.kv.query().prefix('setting_').count(); // Obtener el primer registro coincidente final first = await db.kv.query().prefix('setting_').orderByKeyAsc().first(); // Espacio KV global final globalPage = await db.kv.query(isGlobal: true).limit(50); // Por defecto se filtran los caducados; para incluir no depurados aún: final withExpired = await db.kv.query() .includeExpired() .limit(20);Métodos encadenados habituales:
Método Descripción prefix(String)Filtrar por prefijo de key orderByKeyAsc/orderByKeyDescOrdenar por key (clave primaria) orderByUpdatedAtAsc/orderByUpdatedAtDescOrdenar por updated_atlimit(n)Máximo de filas por página (se recomienda especificarlo siempre) offset(n)Paginación por desplazamiento (borra cursor) cursor(token)Solo casos especiales: Token de paginación entre procesos/red includeExpired([true])Incluir registros caducados aún no depurados count()Contar coincidencias first()Devolver el primer registro (no altera el limit del builder) Resultado
QueryResult: en el uso cotidiano, paginar conhasMore/hasPrev+next()/prev();nextCursorToken/prevCursorTokensolo para transmisión entre extremos, etc. (igual que consultas de tabla).Descubrimiento y gestión (Discovery & Management)
// Solo enumerar nombres de clave (sin value); opcional prefix / limit / offset
final keys = await db.kv.getKeys(prefix: 'setting_');
final pageKeys = await db.kv.getKeys(
  prefix: 'setting_',
  limit: 100,
  offset: 0,
);

// Contar el total de claves en el espacio actual
final count = await db.kv.count();

// Verificar si una clave existe y no ha expirado
final exists = await db.kv.exists('config_cache');

// Sonda de memoria (sincrona, solo en caché — ver [Sonda de memoria y recuperación sincrónica (peek)](#query-peek))
final theme = db.kv.peekGet('theme') ?? await db.kv.get('theme');
if (db.kv.peekExists('config_cache')) { /* ... */ }

// Limpiar todos los datos KV en el espacio actual
await db.kv.clear();
Gestión del ciclo de vida (TTL) Inspeccione o actualice la configuración de expiración para claves existentes:
// Obtener la duración restante
Duration? ttl = await db.kv.getTtl('token');

// Actualizar TTL para una clave existente (expira en 7 días)
await db.kv.setTtl('token', Duration(days: 7));
Monitoreo reactivo (Reactive Watch)
// Monitorear una sola clave
db.kv.watch<int>('unread_count').listen((count) => print(count));

// Monitorear una instantánea de múltiples claves
db.kv.watchValues(['theme', 'font_size']).listen((map) => print(map));
Uso compartido global (isGlobal) Todos los métodos anteriores admiten el parámetro opcional
isGlobal:truepara el espacio global (compartido entre todos los espacios),false(predeterminado) para el espacio aislado actual.
Operaciones por lotes (Bulk Operations)
ToStore proporciona interfaces de procesamiento por lotes especializadas optimizadas para el rendimiento de datos a gran escala. Estas interfaces utilizan la distribución de tareas en paralelo y el fraccionamiento de tiempo para garantizar la capacidad de respuesta de la interfaz de usuario durante las operaciones de escritura intensivas.
| Método | Propósito principal | Requisitos de datos | Características |
|---|---|---|---|
batchInsert |
Insertar registros por lotes | Debe contener todos los campos no nulos | Inserción pura, máximo rendimiento |
batchUpsert |
Sincronización inteligente (Upsert) | Debe contener todos los campos no nulos | Sincronización completa, identificado por clave primaria o campo único |
batchUpdate |
Actualizar registros por lotes | Clave primaria o campo único + Campos a actualizar | Actualizaciones parciales para registros existentes |
Inserción por lotes (batchInsert)
await db.batchInsert('users', [
  {'username': 'user1', 'email': '[email protected]'},
  {'username': 'user2', 'email': '[email protected]'},
]);
Sincronización inteligente por lotes (batchUpsert) Identifica automáticamente "Insertar" o "Actualizar" según la clave primaria o los campos únicos. Común para la sincronización completa de datos.
[!IMPORTANT] Requisitos de datos: Debido a que se puede activar una inserción,
batchUpsertrequiere que cada registro contenga todos los campos no nulos (nullable: false).Actualización por lotes de alto rendimiento (batchUpdate) Específicamente para actualizar registros existentes. Cada registro debe incluir una clave primaria o un campo único como identificador, junto con los campos que se van a modificar.
[!TIP] Actualizaciones parciales:
batchUpdatesolo modifica los campos proporcionados y no requiere todos los campos no nulos, lo que lo hace ideal para actualizaciones incrementales.await db.batchUpdate('users', [ {'username': 'john', 'age': 27}, // Identificar por campo único 'username' y actualizar 'age' {'id': '1002', 'status': 'active'}, // También puede usar la clave primaria directamente ]);
[!TIP] Puede establecer
allowPartialErrors: truepara asegurarse de que los fallos en registros individuales (por ejemplo, una violación de restricción única) no rechacen toda la operación por lotes.
Garantía de recuperación de escritura (Recovery Durability)
ToStore permite controlar con flexibilidad el nivel de autorreparación al retornar el resultado de la operación de escritura (finalización del await):
| Nivel | Garantía de recuperación en respuesta | Casos de uso y características |
|---|---|---|
RecoveryDurability.standard(Recomendado por defecto) |
A prueba de fallos antes de responder | Protección contra bloqueos de la aplicación, excepciones no detectadas y finalizaciones de procesos por OOM. Combina un rendimiento muy alto con seguridad diaria. |
RecoveryDurability.durable |
A prueba de cortes de energía antes de responder | Persistencia física forzada antes del retorno. Garantiza recuperación autorreparable completa incluso ante cortes de energía repentinos o fallos del kernel. Ideal para transacciones financieras y auditorías críticas. |
RecoveryDurability.async |
Rendimiento máximo (guardado asíncrono) | Encola en memoria y retorna de inmediato; tras retornar la respuesta, con volúmenes de datos pequeños generalmente solo existe una ventana de pérdida extremadamente breve de unos pocos milisegundos. Ideal para registros masivos y métricas. |
1. Configuración global predeterminada
Configure el nivel de recuperación predeterminado para toda la instancia en DataStoreConfig:
final db = await ToStore.open(
  config: DataStoreConfig(
    defaultRecoveryDurability: RecoveryDurability.standard, // Predeterminado: seguro contra fallos antes de responder
  ),
);
2. Anulación por operación
Todas las operaciones en tablas estructuradas, operaciones por lotes, actualizaciones/eliminaciones encadenadas y el almacenamiento Clave-Valor (KV) admiten la especificación individual mediante el parámetro opcional durability:
// 1. Operaciones en tablas estructuradas
await db.insert('orders', orderData, durability: RecoveryDurability.durable); // Pedido crítico: a prueba de cortes de energía
await db.batchInsert('logs', logList, durability: RecoveryDurability.async); // Registros masivos: asíncrono ultrarrápido

// 2. Actualizaciones y eliminaciones encadenadas
await db.update('users', {'status': 'active'})
  .where('id', '=', userId)
  .durability(RecoveryDurability.durable);

// 3. Almacenamiento Clave-Valor (KV)
await db.setValue('token', tokenVal, durability: RecoveryDurability.standard);
await db.kv.set('session_id', 'xyz', durability: RecoveryDurability.async);
await db.kv.setMany(settingsMap, durability: RecoveryDurability.durable);
Vectores, texto y recuperación híbrida
La recuperación léxica de texto, de vectores densos y neuronal dispersa comparten una misma cadena de consulta (matchText / matchVector / matchSparse): combínelas con predicados estructurados en la misma cadena, o fusione varias ramas de recall. Las puntuaciones y los diagnósticos de canal se devuelven en QueryResult.retrieval, alineados 1:1 con las filas de data. Si solo necesita claves primarias y puntuaciones, prefiera .select(['id']) (o el nombre de su campo PK) para que el motor omita hidratar filas completas; de lo contrario, la recuperación híbrida materializa registros completos (incluidas incrustaciones grandes) y el rendimiento puede caer bruscamente. Para ANN dedicado sin filtros ni fusión, db.vectorSearch(...) devuelve List<VectorSearchResult> (clave primaria + puntuación) con la misma ruta de búsqueda central.
Visibilidad de búsqueda: Tras un insert/update exitoso, los índices normales, de texto y dispersos son buscables de inmediato; los índices vectoriales no se construyen en la ruta de escritura (para no afectar el rendimiento) y no son buscables al instante. Cuando necesite incluirlos en la búsqueda, ejecute await db.flush() al final del lote de negocio (conveniencia opcional); solo entonces participan en matchVector / vectorSearch.
await db.createTables([
  const TableSchema(
    name: 'documents',
    primaryKeyConfig: PrimaryKeyConfig(
      name: 'id',
      type: PrimaryKeyType.timestampBased,
    ),
    fields: [
      FieldSchema(name: 'content', type: DataType.text, nullable: false),
      FieldSchema(
        name: 'category',
        type: DataType.text,
        nullable: false,
        createIndex: true,
      ),
      FieldSchema(
        name: 'features',
        type: DataType.sparse, // Neural sparse vector
        nullable: false,
      ),
      FieldSchema(
        name: 'embedding',
        type: DataType.vector, // Dense vector
        nullable: false,
        vectorConfig: VectorFieldConfig(
          dimensions: 128, // Written and queried vectors must match this width
        ),
      ),
    ],
    indexes: [
      IndexSchema(fields: ['content'], type: IndexType.text), // Lexical text index
      IndexSchema(fields: ['features'], type: IndexType.sparse), // Neural sparse index
      IndexSchema(
        fields: ['embedding'],
        type: IndexType.vector, // Dense vector index
        vectorConfig: VectorIndexConfig(
          indexType: VectorIndexType.ngh, // NGH: ToStore built-in dense index
          distanceMetric: VectorDistanceMetric.cosine,
        ),
      ),
    ],
  ),
]);

final queryVector =
    VectorData.fromList(List.generate(128, (i) => i * 0.01));
final querySparse = SparseVectorData.fromMap({12: 0.8, 45: 0.6, 90: 0.3});

// 1) Lexical text retrieval (engine tokenizes TextQuery.text;
//    or use pre-tokenized TextQuery.terms / termsWeighted)
final textHits = await db
    .query('documents')
    .select(['id'])
    .matchText('content', TextQuery.text('distributed kernel storage'))
    .limit(5);

// 2) Neural sparse retrieval
final sparseHits = await db
    .query('documents')
    .select(['id'])
    .matchSparse('features', querySparse, minScore: 0.30)
    .limit(5);

// 3) Dense vector ANN (default searchDepth = 50)
final result = await db
    .query('documents')
    .select(['id'])
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

for (var i = 0; i < result.data.length; i++) {
  final record = result.data[i];
  final entry = result.retrieval?.entries[i];
  print('pk=${record['id']}, score=${entry?.score}, '
      'rawScore=${entry?.rawScore}, distance=${entry?.meta?['distance']}');
}

// 4) Structured filter + vector (AND)
final filtered = await db
    .query('documents')
    .whereEqual('category', 'tech')
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

// 5) Multi-way fusion: text + sparse + vector (default weightedScore)
final fused = await db
    .query('documents')
    .matchText('content', TextQuery.text('distributed storage'), weight: 0.4)
    .matchSparse('features', querySparse, weight: 0.3, minScore: 0.20)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .limit(10);
print('fusion=${fused.retrieval?.fusionMethod}'); // weightedScore

// Opt into rank-only fusion (relative scores — not absolute relevance bands)
final fusedRrf = await db
    .query('documents')
    .matchText('content', TextQuery.text('distributed storage'), weight: 0.4)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .fusionMethod(RetrievalFusionMethod.rrf)
    .limit(10);
print('fusion=${fusedRrf.retrieval?.fusionMethod}'); // rrf

// Dedicated ANN (PK + score only; no query chain / fusion)
final ann = await db.vectorSearch(
  'documents',
  fieldName: 'embedding',
  queryVector: queryVector,
  topK: 5,
  minScore: 0.40,
);
Mapeo canal / esquema:
| Canal | Tipo de campo | Índice | API de consulta | Valor de consulta |
|---|---|---|---|---|
| Texto léxico | DataType.text |
IndexType.text |
matchText / orMatchText |
TextQuery.text / terms / termsWeighted |
| Neuronal disperso | DataType.sparse |
IndexType.sparse |
matchSparse / orMatchSparse |
SparseVectorData |
| Vector denso | DataType.vector |
IndexType.vector |
matchVector / orMatchVector |
VectorData, etc. |
Configuración de vectores densos (VectorFieldConfig, VectorIndexConfig):
dimensions: debe coincidir con el ancho real de la incrustación que escribeindexType: identificador opaco del algoritmo denso; actualmentenghdistanceMetric: métrica de similitud del lado del índice (construcción y búsqueda);cosinees habitual para incrustaciones semánticas,l2se adapta a la distancia euclidiana einnerProducta la búsqueda por producto escalar. Tras escribir datos, cambiarla suele requerir reconstruir el índice vectorial.
Parámetros de recuperación encadenada (cada match* / orMatch*, más limit en la cadena):
- Texto
TextQuery.text: tokenizado por el motorTextQuery.terms/termsWeighted: pre-tokenizado; sin segunda pasada; los términos latinos deben coincidir con el índice (normalmente minúsculas)operator:or(predeterminado; ranking por unión) oand(todo término de peso positivo debe coincidir, luego se ordena)- No se admite coincidencia de frases
- Disperso
SparseVectorData/SparseVectorData.fromMap(...): vector de consulta disperso- Los pesos del lado del documento conviene que caigan en
(0, 1]
- Vector
field/vector: campo de destino y vector de consultasearchDepth:>= 1, predeterminado50; valores mayores suelen subir el recall y la latencia; vecino más cercano aproximado — no es un recall@K garantizadodistanceThreshold: techo de distancia
- Compartidos
weight: peso de fusión multi-vía; predeterminado1.0minScore: umbral inferior de relevancialimit: número de resultados (topK).fusionMethod(...): multi-vía predeterminadoweightedScore; conmutable arrf
Notas de resultado y puntuación (QueryResult / VectorSearchResult):
- Los registros de negocio están en
data; puntuaciones e info de canal enretrieval.entries, alineadas 1:1 condata. Si solo necesita claves primarias y puntuaciones, prefiera.select(['id']). score(puntuación de relevancia normalizada,0.0 ~ 1.0): relevancia unificada para texto, disperso y vector (mayor= más relevante). La coincidencia exacta de vector alcanza1.0. UseminScorepara conservar aciertos fuertes y descartar débiles. La fusión multi-vía predeterminadaweightedScoreconserva un acierto fuerte de un solo canal; texto y disperso permanecen en[0.0, 1.0).rawScore: métrica física no normalizada — coseno / producto escalar / L2 / impacto de texto. UserawScore/distancecuando necesite la métrica subyacente.entry.meta['distance']: distancia ANN en canales vectoriales (menor= más cercano).retrieval.fusionMethod:nullen recall de un solo canal; multi-vía predeterminadoweightedScore(conmutable con.fusionMethod(RetrievalFusionMethod.rrf)).- El
db.vectorSearch(...)de nivel superior devuelveList<VectorSearchResult>(primaryKey/score/rawScore/distance) para ANN dedicado. ElminScoreopcional usa el mismo umbral de relevancia quematchVector(puede devolver menos detopK).
Puntuación de relevancia (score) y línea base de umbrales (canal único y multi-vía weightedScore; no para rrf). Para embeddings típicos (dimensiones ≥ 128); en dimensiones menores los vecinos débiles pueden puntuar alto — suba minScore o use rawScore si hace falta:
Puntuación de relevancia (score) |
Significado base y escenarios típicos |
|---|---|
>= 0.85 |
Misma entidad (verificación facial, biometría, deduplicación exacta) |
>= 0.70 |
Coincidencia semántica de alta confianza (hechos centrales, Q&A precisa) |
>= 0.40 |
Relevancia semántica básica (RAG general, anti-alucinación en bases de conocimiento) |
>= 0.30 |
Recall inicial amplio (descubrimiento difuso, pool pre-rerank) |
< 0.30 |
Asociación débil o ruido de fondo |
Configure el minScore del canal según necesite descartar aciertos de baja relevancia.
TTL a nivel de tabla (vencimiento automático basado en tiempo)
Para registros, telemetría, eventos y otros datos que deberían caducar con el tiempo, puede definir TTL a nivel de tabla a través de ttlConfig. El motor limpiará automáticamente los registros caducados en segundo plano:
const TableSchema(
  name: 'event_logs',
  fields: [
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      createIndex: true,
      defaultValueType: DefaultValueType.currentTimestamp,
    ),
  ],
  ttlConfig: TableTtlConfig(
    ttlMs: 7 * 24 * 60 * 60 * 1000, // Conservar 7 días
    // Obligatorio en tablas nuevas / al activar TTL por primera vez:
    // 1) DataType.datetime  2) nullable: false
    // 3) DefaultValueType.currentTimestamp
    sourceField: 'created_at',
  ),
);
Evicción por capacidad (FIFO / LRU)
Limita cuántos registros conserva una tabla por cantidad y/o tamaño aproximado. Independiente del TTL—pueden combinarse. El excedente se elimina automáticamente en segundo plano.
// FIFO (predeterminado): expulsar los más antiguos por clave primaria.
// No establezca sourceField (salvo PrimaryKeyType.none).
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  // maxBytes: 50 * 1024 * 1024, // límite de tamaño opcional
  policy: CapacityEvictionPolicy.fifo,
),

// LRU: sourceField obligatorio (datetime, non-null, currentTimestamp).
// Actualícelo cuando el registro deba contar como usado recientemente.
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  policy: CapacityEvictionPolicy.lru,
  sourceField: 'last_active_at',
),
- Configure al menos uno de
maxEntries/maxBytes. - FIFO +
PrimaryKeyType.nonetambién requieresourceField(mismas reglas datetime).
También puede activar, cambiar o desactivar la evicción por capacidad en una tabla existente en tiempo de ejecución (sin reabrir la base):
// Activar / actualizar
await db.updateSchema('recent_events').setCapacityConfig(
  CapacityConfig(
    maxEntries: 10000,
    policy: CapacityEvictionPolicy.lru,
    sourceField: 'last_active_at',
  ),
);

// Desactivar (conserva las filas; deja de borrar por capacidad)
await db.updateSchema('recent_events').disableCapacity();
La capacidad KV se configura al abrir la base con DataStoreConfig (no en cada kv.set):
kvCapacityConfig: límite de claves del espacio actualglobalKvCapacityConfig: límite de KV global- Misma forma que el
CapacityConfigde tabla, pero sinsourceField
final db = await ToStore.open(
  dbPath: '...',
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
    globalKvCapacityConfig: CapacityConfig(
      maxEntries: 2000,
      policy: CapacityEvictionPolicy.fifo,
    ),
  ),
);
Almacenamiento inteligente (Upsert)
ToStore decide si actualizar o insertar en función de la clave primaria o el campo único incluido en data. where no se admite aquí; el objetivo del conflicto se determina por los propios datos.
// Por clave primaria
final result = await db.upsert('users', {
  'id': 1,
  'username': 'john',
  'email': '[email protected]',
});

// Por clave única (el registro debe contener todos los campos que participan en una restricción única más los campos obligatorios)
await db.upsert('users', {
  'username': 'john',
  'email': '[email protected]',
  'age': 26,
});

// Batch upsert (admite modo atómico o modo de éxito parcial)
// allowPartialErrors: true significa que algunas filas pueden fallar mientras que otras aún tienen éxito
final batchResult = await db.batchUpsert('users', [
  {'username': 'a', 'email': '[email protected]'},
  {'username': 'b', 'email': '[email protected]'},
], allowPartialErrors: true);
Consultas avanzadas
ToStore proporciona una API de consulta declarativa encadenable con manejo de campos flexible y relaciones complejas entre tablas múltiples.
1. Selección de campo (select)
El método select especifica qué campos se devuelven. Si no lo llama, todos los campos se devuelven de forma predeterminada.
- Aliases: admite la sintaxis
field as alias(no distingue entre mayúsculas y minúsculas) para cambiar el nombre de las claves en el conjunto de resultados. - Campos calificados para tabla: en combinaciones de varias tablas,
table.fieldevita conflictos de nombres - Mezcla de agregación: los objetos
Aggse pueden colocar directamente dentro de la listaselect
final results = await db.query('orders')
    .select([
      'orders.id',
      'users.name as customer_name',
      'orders.amount',
      Agg.count('id', alias: 'total_items')
    ])
    .join('users', 'orders.user_id', '=', 'users.id')
    .where('orders.amount', '>', 1000)
    .limit(20);
2. Se une (join)
Admite join estándar (unión interna), leftJoin y rightJoin.
3. Uniones inteligentes basadas en claves externas (recomendado)
Si foreignKeys está definido correctamente en TableSchema, no es necesario escribir a mano las condiciones de unión. El motor puede resolver relaciones de referencia y generar automáticamente la ruta JOIN óptima.
joinReferencedTable(tableName): se une automáticamente a la tabla principal a la que hace referencia la tabla actualjoinReferencingTable(tableName): une automáticamente tablas secundarias que hacen referencia a la tabla actual
// Assume posts defines a foreign key to users
final posts = await db.query('posts')
    .joinReferencedTable('users') // Automatically resolves to ON posts.user_id = users.id
    .select(['posts.title', 'users.username'])
    .limit(20);
Agregación, agrupación y estadísticas (Agg y GroupBy)
1. Agregación (Agg fábrica)
Las funciones agregadas calculan estadísticas sobre un conjunto de datos. Con el parámetro alias, puede personalizar los nombres de los campos de resultados.
| Método | Propósito | Ejemplo |
|---|---|---|
Agg.count(field) |
Contar registros no nulos | Agg.count('id', alias: 'total') |
Agg.sum(field) |
Valores de suma | Agg.sum('amount', alias: 'total_price') |
Agg.avg(field) |
Valor medio | Agg.avg('score', alias: 'average_score') |
Agg.max(field) |
Valor máximo | Agg.max('age') |
Agg.min(field) |
Valor mínimo | Agg.min('price') |
[!TIP] Dos estilos de agregación comunes
- Métodos de acceso directo (recomendados para métricas individuales): llame directamente a la cadena y obtenga el valor calculado inmediatamente.
num? totalAge = await db.query('users').sum('age');- Incrustado en
select(para múltiples métricas o agrupaciones): pase objetosAgga la listaselect.final stats = await db.query('orders').select(['status', Agg.sum('amount')]).groupBy(['status']);
2. Agrupación y filtrado (groupBy / having)
Utilice groupBy para categorizar registros, luego having para filtrar resultados agregados, similar al comportamiento HAVING de SQL.
final stats = await db.query('orders')
    .select([
      'status',
      Agg.sum('amount', alias: 'sum_amount'),
      Agg.count('id', alias: 'order_count')
    ])
    .groupBy(['status'])
    // having accepts a QueryCondition used to filter aggregated results
    .having(QueryCondition().where(Agg.sum('amount'), '>', 5000))
    .limit(10);
3. Métodos de consulta auxiliar
exists()(alto rendimiento): comprueba si algún registro coincide. A diferencia decount() > 0, produce un cortocircuito tan pronto como se encuentra una coincidencia, lo cual es excelente para conjuntos de datos muy grandes.count(): devuelve eficientemente el número de registros coincidentes.first(): un método conveniente equivalente alimit(1)y que devuelve la primera fila directamente comoMap.distinct([fields]): deduplica resultados. Si se proporcionafields, la unicidad se calcula en función de esos campos.
// Efficient existence check
if (await db.query('users').whereEqual('email', '[email protected]').exists()) {
  print('Email is already registered');
}

// Get a deduplicated city list
final cities = await db.query('users').distinct(['city']);
4. Lógica compleja con QueryCondition
QueryCondition es la herramienta principal de ToStore para la lógica anidada y la construcción de consultas entre paréntesis. Cuando las simples llamadas where encadenadas no son suficientes para expresiones como (A AND B) OR (C AND D), esta es la herramienta a utilizar.
condition(QueryCondition sub): abre un grupo anidadoANDorCondition(QueryCondition sub): abre un grupo anidadoORor(): cambia el siguiente conector aOR(el valor predeterminado esAND)
Ejemplo 1: Condiciones O mixtas
SQL equivalente: WHERE is_active = true AND (role = 'admin' OR fans >= 1000)
final subGroup = QueryCondition()
    .whereEqual('role', 'admin')
    .or()
    .whereGreaterThanOrEqualTo('fans', 1000);

final results = await db.query('users')
    .whereEqual('is_active', true)
    .condition(subGroup);
Ejemplo 2: Fragmentos de condición reutilizables
Puede definir fragmentos de lógica empresarial reutilizables una vez y combinarlos en diferentes consultas:
final hotUser = QueryCondition().whereGreaterThan('fans', 5000);
final recentLogin = QueryCondition().whereGreaterThan('last_login', '2024-01-01');

final targetUsers = await db.query('users')
    .condition(hotUser)
    .condition(recentLogin);
5. Consulta de transmisión
Adecuado para conjuntos de datos muy grandes cuando no desea cargar todo en la memoria a la vez. Los resultados se pueden procesar a medida que se leen.
db.streamQuery('users').listen((data) {
  print('Processing one record: $data');
});
6. Consulta reactiva
El método watch() le permite monitorear los resultados de la consulta en tiempo real. Devuelve un Stream y vuelve a ejecutar automáticamente la consulta cada vez que los datos coincidentes cambian en la tabla de destino.
- Antirrebote automático: el antirrebote inteligente integrado evita ráfagas redundantes de consultas
- Sincronización de UI: funciona naturalmente con Flutter
StreamBuilderpara listas de actualización en vivo
// Simple listener
db.query('users').whereEqual('is_online', true).watch().listen((users) {
  print('Online user count changed: ${users.length}');
});

// Flutter StreamBuilder integration example
// Local UI refreshes automatically when data changes
StreamBuilder<List<Map<String, dynamic>>>(
  stream: db.query('messages').orderByDesc('id').limit(50).watch(),
  builder: (context, snapshot) {
    if (snapshot.hasData) {
      return ListView.builder(
        itemCount: snapshot.data!.length,
        itemBuilder: (context, index) => MessageTile(snapshot.data![index]),
      );
    }
    return CircularProgressIndicator();
  },
)
Almacenamiento en caché de resultados de consultas manuales (opcional)
[!IMPORTANT] ToStore ya incluye internamente un eficiente caché LRU inteligente de múltiples niveles. No se recomienda la administración de caché manual de rutina. Considérelo solo en casos especiales:
- Análisis completos costosos de datos no indexados que rara vez cambian
- Requisitos persistentes de latencia ultrabaja incluso para consultas no activas
useQueryCache([Duration? expiry]): habilita el caché y opcionalmente establece una caducidadnoQueryCache(): deshabilita explícitamente el caché para esta consultaclearQueryCache(): invalida manualmente el caché para este patrón de consulta
final results = await db.query('heavy_table')
    .where('non_indexed_field', '=', 'value')
    .useQueryCache(const Duration(minutes: 10)); // Manual acceleration for a heavy query only
Consulta y paginación eficiente
[!TIP] Especifique siempre
limitcomo tamaño de página: Se recomienda encarecidamente especificar siemprelimiten sus consultas. Si se omite, el motor limita por defecto a 1000 registros para evitar consultar demasiados datos a la vez.
ToStore ofrece soporte de paginación de doble modo. Para el desplazamiento de listas o la carga infinita, se recomienda encarecidamente utilizar la paginación por cursor integrada y sin fisuras; para saltar a páginas específicas, la paginación básica es suficiente:
1. Paginación básica (Modo Offset)
Adecuado para escenarios donde el volumen de datos es pequeño (por ejemplo, menos de 10k) o cuando necesita saltar a una página específica con precisión.
final result = await db.query('users')
    .orderByDesc('created_at')
    .offset(40) // Omitir las primeras 40 filas
    .limit(20); // Tomar 20 filas
[!TIP] Cuando
offsetse vuelve muy grande, la base de datos debe escanear y descartar una gran cantidad de registros, y el rendimiento se degrada linealmente. Para una paginación profunda o conjuntos de datos más grandes, se recomienda utilizar el Modo Cursor.
2. Paginación por cursor (Modo Cursor - Recomendado)
Ideal para conjuntos de datos masivos y desplazamiento infinito. Al registrar la posición inicial del flujo de datos de la página actual, se posiciona directamente en esa ubicación durante la paginación (seek), evitando escanear y descartar datos históricos, y manteniendo constante la velocidad de la paginación profunda.
- Gestión automática: Establezca un límite para el tamaño de la página y simplemente llame a
next()oprev()para las páginas siguientes para obtener un rendimiento de paginación excelente de forma sencilla y rápida. - Desplazamiento del punto de partida: Admite la combinación con
.offset(N)en la consulta inicial para ubicar la ventana de inicio, después de lo cual al llamar anext()directamente se obtienen las páginas siguientes.
// 1. Iniciar consulta inicial
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

// 2. Obtener la siguiente página
if (page1.hasMore) {
  final page2 = await page1.next();
  print('Cantidad de elementos en la siguiente página: ${page2.data.length}');

  // 3. Obtener la página anterior
  if (page2.hasPrev) {
    final prevPage = await page2.prev();
    print('Datos de la página anterior: ${prevPage.data}');
  }
}
Escenario avanzado: Paginación por tokens sin estado (Token-based Cursor)
Para la paginación cotidiana en la app, prefiera next() / prev() arriba. Use tokens de cursor solo en APIs cliente-servidor o al serializar el estado de paginación entre procesos/redes:
- La consulta inicial devuelve las cadenas
nextCursorTokenyprevCursorToken. - La consulta siguiente pasa el token a través de
.cursor(token)para posicionarse (seek). - Nota:
cursoryoffsetson mutuamente excluyentes; establecer uno borra el otro.
// Consulta inicial (por ejemplo, en el lado del servidor API)
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

final String? nextToken = page1.nextCursorToken; // Serializar y devolver este token al cliente

// Cuando el cliente solicita la siguiente página con el token:
if (nextToken != null) {
  final page2 = await db.query('users')
      .orderByDesc('id')
      .limit(20)
      .cursor(nextToken); // Pasar el token para posicionarse y leer con precisión
}
| Característica | Modo Offset | Modo Cursor |
|---|---|---|
| Rendimiento de la consulta | Se degrada a medida que aumentan las páginas | Velocidad constante para paginación profunda |
| Ideal para | Conjuntos de datos pequeños, saltos de página exactos | Conjuntos de datos masivos, desplazamiento infinito |
| Consistencia bajo cambios | Los cambios en los datos pueden causar saltos o duplicados de filas | Evita duplicaciones y omisiones causadas por cambios en los datos |
Sonda de memoria y recuperación sincrónica (peek)
Para escenarios con requisitos extremos de rendimiento y latencia, ToStore ofrece la serie peek de recuperación sincrónica puramente en memoria, absorbiendo lecturas calientes en ráfaga directamente en el proceso: dispositivos edge pueden sostener millones de lecturas por segundo; servidores con hardware más potente pueden alcanzar decenas de millones por máquina (consulte Benchmarks).
[!NOTE] Solo caché en memoria:
peekes un bypass puro en memoria sin programación. En caso de fallo de caché devuelve vacío/nullde inmediato; el motor no realiza E/S de archivos sincrónica (evitando bloquear el bucle de eventos bajo alta concurrencia). Para resultados persistentes completos, useawait query()en la aplicación.
Métodos peek
| Método | Tipo de retorno | Descripción |
|---|---|---|
peekFirst() |
Map<String, dynamic>? |
Registro único; devuelve null si no hay caché |
peek() |
QueryResult<T> |
QueryResult con lista data y metadatos de paginación (hasMore, cursores, etc.); datos solo con acierto de caché |
peekExists() |
bool |
Comprueba sincrónicamente si existe un registro coincidente en caché |
peekCount() |
int |
Cuenta sincrónicamente registros coincidentes en caché |
result.peekNext() |
QueryResult<T> |
Página siguiente sincrónica cuando el resultado paginado está en caché |
result.peekPrev() |
QueryResult<T> |
Página anterior sincrónica cuando el resultado paginado está en caché |
Mejor práctica: sonda de memoria primero (Peek-Through)
// Registro único: sonda de memoria primero, consulta asíncrona estándar si falla
final q = db.query('users').where('id', '=', userId);
final user = q.peekFirst() ?? await q.first();

// Consulta paginada con sonda
final listQ = db.query('users').orderByDesc('id').limit(20);
var page = listQ.peek();
if (page.data.isEmpty) page = await listQ;

if (page.hasMore) {
  final next = page.peekNext(); // acierto de caché: cambio de página sincrónico
  if (next.data.isEmpty) await page.next();
}
Sonda KV (db.kv)
| Método | Equivalente async | Descripción |
|---|---|---|
peekGet(key) |
get(key) |
Sondeo puntual en memoria; claves expiradas → null |
peekExists(key) |
exists(key) |
Verificación de existencia en memoria |
db.kv.query().peek() |
await db.kv.query() |
Sondeo paginado (prefijo / orden / limit) |
db.kv.query().peekFirst() |
await db.kv.query().first() |
Sondeo del primer registro |
// Punto: sondea primero, async si falla
final theme = db.kv.peekGet('theme', isGlobal: true) ?? await db.kv.get('theme', isGlobal: true);

// Sonda KV paginada
var page = db.kv.query().prefix('setting_').limit(20).peek();
if (page.data.isEmpty) page = await db.kv.query().prefix('setting_').limit(20);
[!TIP] Recomendación: Las consultas asíncronas estándar (
await query()) usan programación de eventos para estabilidad a largo plazo y equidad multitarea; 100k+ QPS es suficiente para la mayoría de cargas. La seriepeekestá diseñada para absorber picos extremos de lectura caliente a millones/decenas de millones de QPS por máquina.
Claves externas y cascada
Las claves externas garantizan la integridad referencial y le permiten configurar actualizaciones y eliminaciones en cascada. Las relaciones se validan al escribir y actualizar. Si las políticas en cascada están habilitadas, los datos relacionados se actualizan automáticamente, lo que reduce el trabajo de coherencia en el código de la aplicación.
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(name: 'id'),
    fields: [
      FieldSchema(name: 'username', type: DataType.text, nullable: false),
    ],
  ),
  TableSchema(
    name: 'posts',
    primaryKeyConfig: const PrimaryKeyConfig(name: 'id'),
    fields: [
      const FieldSchema(name: 'title', type: DataType.text, nullable: false),
      const FieldSchema(name: 'user_id', type: DataType.integer, nullable: false),
      const FieldSchema(name: 'content', type: DataType.text),
    ],
    foreignKeys: [
        ForeignKeySchema(
          name: 'fk_posts_user',
          fields: ['user_id'],              // Field in the current table
          referencedTable: 'users',         // Referenced table
          referencedFields: ['id'],         // Referenced field
          onDelete: ForeignKeyCascadeAction.cascade,  // Delete posts automatically when the user is deleted
          onUpdate: ForeignKeyCascadeAction.cascade,  // Cascade updates
        ),
    ],
  ),
]);
Operadores de consulta
Todas las condiciones where(field, operator, value) admiten los siguientes operadores (no distingue entre mayúsculas y minúsculas):
| Operador | Descripción | Ejemplo / Rendimiento |
|---|---|---|
= |
Igual | where('status', '=', 'val') — [Recomendado] Búsqueda por índice (Seek) |
!=, <> |
No es igual | where('role', '!=', 'val') — [Precaución] Escaneo completo de tabla |
> , >=, <, <= |
Comparación de rango | where('age', '>', 18) — [Recomendado] Escaneo por índice |
IN |
Incluido en | where('id', 'IN', [...]) — [Recomendado] Búsqueda por índice (Seek) |
NOT IN |
No incluido en | where('status', 'NOT IN', [...]) — [Precaución] Escaneo completo de tabla |
BETWEEN |
Rango | where('age', 'BETWEEN', [18, 65]) — [Recomendado] Escaneo por índice |
LIKE |
Coincidencia de patrón (% = cualquier carácter, _ = un solo carácter) |
where('name', 'LIKE', 'John%') — [Precaución] Ver nota abajo |
NOT LIKE |
Patrón no coincidente | where('email', 'NOT LIKE', '...') — [Precaución] Escaneo completo de tabla |
IS |
Es null | where('deleted_at', 'IS', null) — [Recomendado] Búsqueda por índice (Seek) |
IS NOT |
No es null | where('email', 'IS NOT', null) — [Precaución] Escaneo completo de tabla |
Métodos de consulta semántica (recomendados)
Recomendado para evitar cadenas de operadores escritas a mano y para obtener una mejor asistencia IDE.
1. Comparación
Se utiliza para comparaciones directas numéricas o de cadenas.
db.query('users').whereEqual('username', 'John');           // Equal
db.query('users').whereNotEqual('role', 'guest');          // Not equal
db.query('users').whereGreaterThan('age', 18);             // Greater than
db.query('users').whereGreaterThanOrEqualTo('score', 60);  // Greater than or equal
db.query('users').whereLessThan('price', 100);             // Less than
db.query('users').whereLessThanOrEqualTo('quantity', 10);  // Less than or equal
db.query('users').whereTrue('is_active');                  // Is true
db.query('users').whereFalse('is_banned');                 // Is false
2. Colección y gama
Se utiliza para probar si un campo se encuentra dentro de un conjunto o rango.
db.query('users').whereIn('id', ['id1', 'id2']);                 // In list
db.query('users').whereNotIn('status', ['banned', 'pending']);   // Not in list
db.query('users').whereBetween('age', 18, 65);                   // In range (inclusive)
3. Verificación nula
Se utiliza para probar si un campo tiene un valor.
db.query('users').whereNull('deleted_at');    // Is null
db.query('users').whereNotNull('email');      // Is not null
db.query('users').whereEmpty('nickname');     // Is null or empty string
db.query('users').whereNotEmpty('bio');       // Is not null and not empty
4. Coincidencia de patrones
Admite búsqueda con comodines de estilo SQL (% coincide con cualquier número de caracteres, _ coincide con un solo carácter).
db.query('users').whereLike('name', 'John%');                        // SQL-style pattern match
db.query('users').whereContains('bio', 'flutter');                   // Contains match (LIKE '%value%')
db.query('users').whereStartsWith('name', 'Admin');                  // Prefix match (LIKE 'value%')
db.query('users').whereEndsWith('email', '.com');                    // Suffix match (LIKE '%value')
db.query('users').whereContainsAny('tags', ['dart', 'flutter']);     // Fuzzy match against any item in the list
// Equivalent to: .where('age', '>', 18).where('name', 'like', '%John%')
final users = await db.query('users')
    .whereGreaterThan('age', 18)
    .whereLike('username', '%John%')
    .orderByDesc('age')
    .limit(20);
[!CAUTION] Guía de Rendimiento de Consultas (Índice vs Escaneo Completo)
En escenarios de datos a gran escala (millones de filas o más), siga estos principios para evitar retrasos en el hilo principal y tiempos de espera de consulta:
Optimizado por índice - [Recomendado]:
- Métodos semánticos:
whereEqual,whereGreaterThan,whereLessThan,whereIn,whereBetween,whereNull,whereTrue,whereFalseywhereStartsWith(coincidencia de prefijo).- Operadores:
=,>,<,>=,<=,IN,BETWEEN,IS null,LIKE 'prefix%'.- Explicación: Estas operaciones logran un posicionamiento ultrarrápido a través de índices. Para
whereStartsWith/LIKE 'abc%', el índice aún puede realizar un escaneo de rango de prefijo.Riesgos de escaneo completo - [Precaución]:
- Coincidencia difusa:
whereContains(LIKE '%val%'),whereEndsWith(LIKE '%val'),whereContainsAny.- Consultas de negación:
whereNotEqual(!=,<>),whereNotIn(NOT IN),whereNotNull(IS NOT null/whereNotEmpty).- Patrón no coincidente:
NOT LIKE.- Explicación: Las operaciones anteriores generalmente requieren recorrer toda el área de almacenamiento de datos incluso si se ha creado un índice. Si bien el impacto es mínimo en dispositivos móviles o conjuntos de datos pequeños, en escenarios de análisis de datos distribuidos o de tamaño ultra grande, deben usarse con precaución, combinadas con otras condiciones de índice (por ejemplo, filtrar por ID o rango de tiempo) y la cláusula
limit.
Arquitectura distribuida
// Configure distributed nodes
final db = await ToStore.open(
  config: DataStoreConfig(
    distributedNodeConfig: const DistributedNodeConfig(
      enableDistributed: true,            // Enable distributed mode
      clusterId: 1,                       // Cluster ID
      centralServerUrl: 'https://127.0.0.1:8080',
      accessToken: 'b7628a4f9b4d269b98649129'
    )
  )
);

// Batch insert
await db.batchInsert('vector_data', [
  {'vector_name': 'face_2365', 'timestamp': DateTime.now()},
  {'vector_name': 'face_2366', 'timestamp': DateTime.now()},
  // ... efficient one-shot insertion of vector records
]);

// Stream and process large datasets
await for (final record in db.streamQuery('vector_data')
  .where('vector_name', '=', 'face_2366')
  .where('timestamp', '>=', DateTime.now().subtract(Duration(days: 30)))
  .stream) {
  // Process each result incrementally to avoid loading everything at once
  print(record);
}
Ejemplos de clave primaria
ToStore proporciona múltiples algoritmos de clave primaria distribuidos para diferentes escenarios comerciales:
- Clave primaria secuencial (
PrimaryKeyType.sequential):238978991 - Clave principal basada en marca de tiempo (
PrimaryKeyType.timestampBased):1306866018836946 - Clave principal con prefijo de fecha (
PrimaryKeyType.datePrefixed):20250530182215887631 - Clave principal de código corto (
PrimaryKeyType.shortCode):9eXrF0qeXZ
// Sequential primary key configuration example
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(
      type: PrimaryKeyType.sequential,
      sequentialConfig: SequentialIdConfig(
        initialValue: 10000,      // Starting value
        increment: 50,            // Step size
        useRandomIncrement: true, // Random step size to hide business volume
      ),
    ),
    fields: [/* field definitions */]
  ),
]);
Expresiones atómicas
El sistema de expresión proporciona actualizaciones de campos atómicos con seguridad de tipos. Todos los cálculos se ejecutan de forma atómica en la capa de la base de datos, evitando conflictos concurrentes:
// Simple increment: balance = balance + 100
await db.update('accounts', {
  'balance': Expr.field('balance') + Expr.value(100),
}).where('id', '=', accountId);

// Complex calculation: total = price * quantity + tax
await db.update('orders', {
  'total': Expr.field('price') * Expr.field('quantity') + Expr.field('tax'),
}).where('id', '=', orderId);

// Multi-layer parentheses: finalPrice = ((price * quantity) + tax) * (1 - discount)
await db.update('orders', {
  'finalPrice': ((Expr.field('price') * Expr.field('quantity')) + Expr.field('tax')) *
                 (Expr.value(1) - Expr.field('discount')),
}).where('id', '=', orderId);

// Use functions: price = min(price, maxPrice)
await db.update('products', {
  'price': Expr.min(Expr.field('price'), Expr.field('maxPrice')),
}).where('id', '=', productId);

// Timestamp: updatedAt = now()
await db.update('users', {
  'updatedAt': Expr.now(),
}).where('id', '=', userId);
Expresiones condicionales (por ejemplo, diferenciar actualización versus inserción en un upsert): use Expr.isUpdate() / Expr.isInsert() junto con Expr.ifElse o Expr.when para que la expresión se evalúe solo al actualizar o solo al insertar.
// Upsert: increment on update, set to 1 on insert
// The insert branch can use a plain literal; expressions are only evaluated on the update path
await db.upsert('counters', {
  'key': 'visits',
  'count': Expr.ifElse(
    Expr.isUpdate(),
    Expr.field('count') + Expr.value(1),
    1,
  ),
});

// Use Expr.when (single branch, otherwise null)
await db.upsert('orders', {
  'id': orderId,
  'updatedAt': Expr.when(Expr.isUpdate(), Expr.now(), otherwise: Expr.now()),
});
Transacciones
Las transacciones garantizan la atomicidad en múltiples operaciones: o todo tiene éxito o todo se revierte, preservando la coherencia de los datos.
Características de la transacción
- múltiples operaciones, todas exitosas o todas revertidas
- el trabajo inacabado se recupera automáticamente después de fallas
- las operaciones exitosas persisten de manera segura
// Basic transaction - atomically commit multiple operations
final txResult = await db.transaction(() async {
  // Insert a user
  await db.insert('users', {
    'username': 'john',
    'email': '[email protected]',
    'fans': 100,
  });

  // Atomic update using an expression
  await db.update('users', {
    'fans': Expr.field('fans') + Expr.value(50),
  }).where('username', '=', 'john');

  // If any operation fails, all changes are rolled back automatically
});

if (!txResult.hasErrors) {
  print('Transacción confirmada con éxito');
} else {
  print('Transacción revertida debido a:');
  for (final status in txResult.statuses) {
    if (status.type != ResultType.success) {
      print(' - [$status.codeKey}] $status.message}');
    }
  }
}

// Automatic rollback on error
final txResult2 = await db.transaction(() async {
  await db.insert('users', {
    'username': 'jane',
    'email': '[email protected]',
  });
  throw Exception('Business logic error'); // Trigger rollback
}, rollbackOnError: true);
Administración y mantenimiento
Las siguientes API cubren la administración, el diagnóstico y el mantenimiento de bases de datos para el desarrollo de complementos, paneles de administración y escenarios operativos:
- Gestión de mesa
createTable(schema): crea una única tabla manualmente; útil para la carga de módulos o la creación de tablas de tiempo de ejecución bajo demandagetTableSchema(tableName): recupera la información del esquema definido; útil para la validación automatizada o la generación de modelos de UIgetTableNames({isGlobal}): lista nombres de tablas del inventario de schema global (tablas de usuario). OpcionalisGlobal:truesolo globales,falsesolo no globales, omitir = ambas. Los schemas no globales se comparten entre espacios; solo los datos se aíslan.getTableInfo(tableName): estadísticas en tiempo de ejecución (totalRecordCount,totalTableDataSizeBytes,totalIndexDataSizeBytes,indexCount, creación, si es global)clear(tableName): borre todos los datos de la tabla mientras conserva de forma segura el esquema, los índices y las restricciones de claves internas/externas.dropTable(tableName): destruir completamente una tabla y su esquema; no reversible
- Gestión del espacio
currentSpaceName: obtiene el espacio activo actual en tiempo reallistSpaces(): enumera todos los espacios asignados en la instancia de base de datos actualgetSpaceInfo(useCache: true): agregados locales del espacio (totalRecordCount, tamaño de datos de tabla/índice). UseuseCache: falsepara reconciliar desde meta.deleteSpace(spaceName): elimina un espacio específico y todos sus datos, exceptodefaulty el espacio activo actual
- Descubrimiento de instancia
config: inspecciona la instantáneaDataStoreConfigfinal efectiva de la instancia.instancePath: localiza el directorio de almacenamiento físico con precisióngetVersion()/setVersion(version): control de versiones definido por el negocio para decisiones de migración a nivel de aplicación (no la versión del motor)
- Mantenimiento
flush(mode: FlushMode.full): fuerza las escrituras pendientes al almacenamiento. Modos:recovery(más rápido; registro de recuperación solo a búferes del SO; sobrevive a fallos de la app, no a cortes de energía),recoveryDurable(registro de recuperación a almacenamiento estable; busca sobrevivir a cortes de energía),full(predeterminado; registro de recuperación + datos de tabla e índices a almacenamiento estable).deleteDatabase(): elimina todos los archivos físicos y metadatos de la instancia actual; utilizar con cuidado
- Diagnóstico
db.status.memory(): inspecciona las tasas de aciertos de la caché, el uso de la página de índice y la asignación general del montóndb.status.space()/db.status.table(tableName): inspeccionar estadísticas en vivo e información de salud para espacios y tablasdb.status.config(): inspecciona la instantánea de configuración del tiempo de ejecución actualdb.status.migration(taskId): realiza un seguimiento del progreso de la migración asincrónica en tiempo real
final spaces = await db.listSpaces();
final tableNames = await db.getTableNames();
final spaceInfo = await db.getSpaceInfo(useCache: false);
final tableSchema = await db.getTableSchema('users');
final tableInfo = await db.getTableInfo('users');

print('spaces: $spaces');
print('tables: $tableNames');
print(spaceInfo.toJson());
print(tableSchema?.toJson());
print(tableInfo?.toJson());

await db.flush();

final memoryInfo = await db.status.memory();
final configInfo = await db.status.config();
print(memoryInfo.toJson());
print(configInfo.toJson());
Copia de seguridad y restauración
Especialmente útil para la importación/exportación local de un solo usuario, grandes migraciones de datos fuera de línea y reversión del sistema después de una falla:
- Copia de seguridad (
backup)compress: si se habilita la compresión; recomendado y habilitado por defectoscope: controla el rango de respaldoBackupScope.database: realiza una copia de seguridad de instancia de base de datos completa, incluidos todos los espacios y tablas globalesBackupScope.currentSpace: realiza una copia de seguridad solo del espacio activo actual, excluyendo las tablas globalesBackupScope.currentSpaceWithGlobal: realiza una copia de seguridad del espacio actual más sus tablas globales relacionadas, ideal para migración de un solo inquilino o de un solo usuario.
- Restaurar (
restore)backupPath: ruta física al paquete de respaldocleanupBeforeRestore: si se deben borrar silenciosamente los datos actuales relacionados antes de la restauración; Se recomiendatruepara evitar estados lógicos mixtos.deleteAfterRestore: elimina automáticamente el archivo fuente de la copia de seguridad después de una restauración exitosa
// Example: export the full data package for the current user
final backupPath = await db.backup(
  compress: true,
  scope: BackupScope.currentSpaceWithGlobal,
);

// Example: restore from a backup package and clean up the source file automatically
final restored = await db.restore(
  backupPath,
  cleanupBeforeRestore: true,
  deleteAfterRestore: true,
);
Códigos de estado y manejo de errores
Hay dos canales para la retroalimentación de errores y excepciones en ToStore:
[!NOTE] Base de diagnóstico unificada: Ya sea que se devuelvan a través del modelo de resultado de respuesta (
statusesenDbResult/QueryResult) o se lancen a través de excepciones fatales (statusesenDbException), todos los estados de diagnóstico se basan uniformemente en el sistema estructuradoResultStatusy comparten los mesmos códigos de estado, lo que garantiza la coherencia.
- Modelo de resultado de respuesta (Result-based Response)
Para operaciones cotidianas como inserción, actualización, eliminación, consulta, transacciones y modificaciones del esquema de tabla en tiempo de ejecución. Estas operaciones no lanzarán excepciones cuando ocurran violaciones de restricciones, fallos de validación o argumentos no válidos. En su lugar, ToStore envuelve los resultados usando
DbResultoQueryResult, registrando toda la información de diagnóstico en la lista de estados. Esto garantiza que los errores ordinarios de lógica empresarial no interrumpan la base de datos.
hasErrors: Indica si hay errores en la operación actual. En operaciones por lotes o transacciones, si hay al menos un error, esta propiedad estrue.statuses: Una lista detallada de todos los diagnósticosResultStatusde la operación. Admite una coincidencia de orden 1:1, lo cual es muy útil para operaciones por lotes.firstPrimaryKey: Lee la clave primaria generada físicamente de forma directa durante una única operación de inserción/escritura sin necesidad de analizarstatusesmanualmente.ResultType: Enumeración para la categoría de estado, conveniente para el manejo de bifurcaciones y comprobaciones (por ejemplo,isBusinessError,isDeveloperError).
- Lanzamiento de excepciones (Exception-based Throwing)
Para errores fatales causados por descuidos del desarrollador o fallos de diseño (por ejemplo, fallo en la verificación del esquema durante
ToStore.open, incompatibilidad de la versión del motor, corrupción fatal en la migración de datos, etc.). En estos casos, ToStore lanzaDbExceptionpara detener la ejecución, instando al desarrollador a rectificarla.
[!WARNING] Pautas de desarrollo: Los errores comerciales ordinarios no deben lanzar excepciones; deben devolverse en el modelo de resultado de respuesta para evitar interrumpir el tiempo de ejecución de la aplicación.
Ejemplos de errores y excepciones
1. Manejo de respuesta para una sola escritura
final result = await db.insert('users', {
  'username': 'john',
  'email': '[email protected]',
});

if (result.hasErrors) {
  // Obtener el primer tipo de error y descripción
  print('Operation failed: [\${result.firstType.codeKey}] \${result.message}');
} else {
  print('Escritura exitosa, la clave primaria es: \${result.firstPrimaryKey}');
}
2. Diagnóstico detallado en escritura por lotes
final batchResult = await db.batchInsert('users', [
  {'username': 'alice', 'email': '[email protected]'},
  {'username': 'bob', 'email': 'invalid-email-format'}, // Validation fails
]);

if (batchResult.hasErrors) {
  print('Operación por lotes fallida parcialmente: exitosos \${batchResult.successCount}, fallidos \${batchResult.failedCount}');

  for (final status in batchResult.statuses) {
    final int idx = status.index;

    if (status is ConstraintStatus) {
      print('Index [\$idx] Violación de restricción! Tabla! Tabla: \${status.tableName}, campos: \${status.fields}');
    } else if (status is InvalidArgumentStatus) {
      print('Index [\$idx] Error de argumento! Parámetro! Parameter: \${status.parameterName}, valor pasado: \${status.passedValue}');
    } else if (status.type != ResultType.success) {
      print('Index [\$idx] Ocurrió un error: [\${status.codeKey}] \${status.message}');
    }
  }
}
3. Error fatal y captura de excepción de inicialización (DbException)
try {
  // Initialize database with schemas that might have validation issues
  final db = await ToStore.open(schemas: appSchemas);
} on DbException catch (e) {
  print('❌ Excepción fatal de base de datos! Mensaje de error: \n\${e.message}');

  // Iterate through the detailed status list in the exception
  for (final status in e.statuses) {
    if (status is SchemaValidationStatus) {
      print('Fallo en la validación del esquema! Tabla! Tabla: \${status.tableName}, campo: \${status.field}, configuración no válida: \${status.wrongValue}');
    } else {
      print('Información de diagnóstico: [\${status.codeKey}] \${status.message}');
    }
  }
}
Para obtener la lista completa de tipos de errores, códigos de estado hoja, formatos de serialización JSON y asignaciones de campos, consulte la especificación completa: Especificación de diagnóstico automático y resolución de estado de ToStore ResultStatus.
Registrar devolución de llamada y diagnóstico de base de datos
ToStore puede enrutar los registros del ciclo de vida de la base de datos a la capa empresarial a través de ToStore.setLogConfig(...).
- La devolución de llamada
onLogrecibe todos los registros de registroLogRecordque pasan los filtros actualesenableLogylogLevel.- LogLevel.error: Ocurrió un error local, no afecta el funcionamiento normal.
- LogLevel.critical: Error global a nivel de desastre (como disco lleno, memoria insuficiente, falla grave de migración, etc.) que requiere intervención manual. Se recomienda activar notificaciones de alarma en este nivel.
- Llame a
ToStore.setLogConfig(...)antes de la inicialización para que también se capturen los registros generados durante la inicialización y la dinámica migración.
  // Configurar parámetros de registro o devolución de llamada
  ToStore.setLogConfig(
    enableLog: true,
    logLevel: debugMode ? LogLevel.debug : LogLevel.warn,
    logLabel: 'my_app_db', // Título gris claro en la parte superior del registro para distinguir aplicaciones o instancias de bases de datos,
    onLog: (log) {
      // En producción, se puede reportar warn/error/critical al backend o plataforma de registro
      // log.level corresponde al nivel de registro (LogLevel.debug, info, warn, error, critical)
      // log.message corresponde al texto del registro procesado
      // log.status corresponde al estado de diagnóstico ResultStatus subyacente (contiene code y codeKey)
      if (!debugMode && (log.level == LogLevel.warn || log.level == LogLevel.error || log.level == LogLevel.critical)) {
        developer.log(log.message, name: 'my_app_db', time: log.timestamp);
      }
    },
  );

  final db = await ToStore.open();
Configuración de seguridad
[!WARNING] Administración de claves
Clave Función Cómo cambiar ¿Reescritura completa de datos? encodingKeyClave de cifrado de datos Establecer nuevo valor y volver a openSí (lento) encryptionKeyClave de seguridad; protege encodingKeyLlamar db.rotateEncryptionKeyen tiempo de ejecuciónNo (rápido) Nunca codifique claves sensibles. Para vincularlas al dispositivo, guarde
encryptionKeyen el Keychain / Keystore / enclave seguro del SO y páselo al motor.
final db = await ToStore.open(
  config: DataStoreConfig(
    encryptionConfig: EncryptionConfig(
      // Supported: none, xorObfuscation, chacha20Poly1305, aes256Gcm
      encryptionType: EncryptionType.chacha20Poly1305,

      // Data encryption key: encrypts table/index/log data; changing it triggers a background rewrite
      encodingKey: 'Your-Encoding-Key...',

      // Security key: protects encodingKey; rotate online via db.rotateEncryptionKey
      encryptionKey: 'Your-Secure-Encryption-Key...',

      // standard: critical table data, B-tree indexes, and log payloads
      // full: encrypts the entire engine files
      encryptionScope: EncryptionScope.standard,
    ),
    // Enable crash recovery logging (Write-Ahead Logging), enabled by default
    enableJournal: true,
    // Whether transactions force data to disk on commit; set false to reduce sync overhead
    persistRecoveryOnCommit: true,
  ),
);
Cambiar encodingKey: establezca el nuevo valor en EncryptionConfig y vuelva a open. El motor detecta el cambio y migra los datos automáticamente en segundo plano, sin intervención de la aplicación.
Rotar encryptionKey (rotación periódica por seguridad/cumplimiento): sin reescritura de datos; se ejecuta en línea.
// If encryptionKey was never set explicitly, oldKey can be omitted
final result = await db.rotateEncryptionKey(newKey: 'new-secure-key');
// Or: await db.rotateEncryptionKey(oldKey: 'old-key', newKey: 'new-key');
if (result.hasErrors) {
  // Manejar error (oldKey incorrecto, migración de encodingKey en curso, etc.)
  return;
}
// Éxito: configuración en memoria actualizada; pase el encryptionKey más reciente en el próximo ToStore.open
Cifrado de nivel de valor (ToCrypto)
El cifrado de base de datos completa protege todos los datos de tablas e índices, pero puede afectar el rendimiento general. Si solo necesita proteger algunos valores confidenciales, utilice ToCrypto en su lugar. Está desacoplado de la base de datos, no requiere ninguna instancia db y permite que su aplicación codifique/decodifique valores antes de escribir o después de leer. La salida es Base64, que encaja naturalmente en columnas JSON o TEXTO.
key(obligatorio):StringoUint8List. Si no son 32 bytes, se utiliza SHA-256 para derivar una clave de 32 bytes.type(opcional): tipo de cifrado deToCryptoType, comoToCryptoType.chacha20Poly1305oToCryptoType.aes256Gcm. El valor predeterminado esToCryptoType.chacha20Poly1305.aad(opcional): datos adicionales autenticados de tipoUint8List. Si se proporcionan durante la codificación, también se deben proporcionar exactamente los mismos bytes durante la decodificación.
const key = 'my-secret-key';
// Encode: plaintext -> Base64 ciphertext (can be stored in DB or JSON)
final cipher = ToCrypto.encode('sensitive data', key: key);
// Decode when reading
final plain = ToCrypto.decode(cipher, key: key);

// Optional: bind contextual data with aad (must match during decode)
final aad = Uint8List.fromList(utf8.encode('users:id_number'));
final cipher2 = ToCrypto.encode('secret', key: key, aad: aad);
final plain2 = ToCrypto.decode(cipher2, key: key, aad: aad);
Configuración avanzada explicada (DataStoreConfig)
[!TIP] Inteligencia de configuración cero ToStore detecta automáticamente la plataforma, las características de rendimiento, la memoria disponible y el comportamiento de E/S para optimizar parámetros como la simultaneidad, el tamaño del fragmento y el presupuesto de caché. En el 99% de los escenarios empresariales comunes, no es necesario ajustar
DataStoreConfigmanualmente. Los valores predeterminados ya proporcionan un rendimiento excelente para la plataforma actual.
| Parámetro | Predeterminado | Propósito y recomendación |
|---|---|---|
yieldDurationMs |
8ms | Recomendación principal. El intervalo de tiempo utilizado cuando las tareas largas dan resultados. 8ms se alinea bien con el renderizado de 120 fps/60 fps y ayuda a mantener la interfaz de usuario fluida durante consultas o migraciones grandes. |
maxQueryOffset |
10000 | Protección de consultas. Cuando offset supera este umbral, se genera un error. Esto evita E/S patológicas debido a una paginación con desplazamiento profundo. |
defaultQueryLimit |
1000 | Guarda de recursos. Se aplica cuando una consulta no especifica limit, lo que evita la carga accidental de conjuntos de resultados masivos y posibles problemas de OOM. |
cacheMemoryBudgetMB |
(automático) | Gestión de memoria detallada. Presupuesto total de memoria caché. El motor lo utiliza para impulsar la recuperación de LRU automáticamente. |
enableJournal |
verdadero | Autorreparación de accidentes. Cuando está habilitado, el motor puede recuperarse automáticamente después de accidentes o cortes de energía. |
defaultRecoveryDurability |
standard |
Garantía de recuperación en respuesta. Define el nivel de autorreparación antes de que las operaciones de escritura retornen el resultado: • standard (Predeterminado): A prueba de fallos antes de responder. Protege contra bloqueos de app, excepciones no detectadas y terminación OOM.• durable: A prueba de cortes de energía antes de responder. Persistencia física forzada antes del retorno; recuperación completa ante cortes de energía.• async: Rendimiento máximo. Retorna inmediatamente y guarda en segundo plano; tras responder, en datos pequeños suele existir una ventana de solo unos pocos milisegundos. |
persistRecoveryOnCommit |
verdadero | Sólida garantía de durabilidad. Cuando es cierto, las transacciones confirmadas se sincronizan con el almacenamiento físico. Cuando es falso, el vaciado se realiza de forma asíncrona en segundo plano para mejorar la velocidad, con un pequeño riesgo de perder una pequeña cantidad de datos en caso de fallos extremos. |
ttlCleanupIntervalMs |
300000 | Encuesta TTL global. El intervalo en segundo plano para escanear datos caducados cuando el motor no está inactivo. Los valores más bajos eliminan los datos caducados antes pero cuestan más gastos generales. |
kvCapacityConfig |
null | Capacidad KV del espacio. Límite FIFO/LRU para claves del espacio; no configure sourceField. Véase Evicción por capacidad. |
globalKvCapacityConfig |
null | Capacidad KV global. Misma forma que kvCapacityConfig. |
maxConcurrency |
(automático) | Control de simultaneidad de cálculo. Establece el recuento máximo de trabajadores paralelos para tareas intensivas como el cálculo de vectores y el cifrado/descifrado. Generalmente es mejor mantenerlo automático. |
final db = await ToStore.open(
  config: DataStoreConfig(
    yieldDurationMs: 8, // Excellent for frontend UI smoothness; for servers, 50ms is often better
    defaultQueryLimit: 50, // Force a maximum result-set size
    enableJournal: true, // Ensure crash self-healing
    defaultRecoveryDurability: RecoveryDurability.standard, // A prueba de fallos antes de responder
  ),
);
Rendimiento y experiencia
Puntos de referencia
Destacados del suite 100K y validación edge a escala de mil millones (3 rondas, standard durability, 2026-10-08):
| Metric | Result |
|---|---|
| Cold start | ~35 ms (stable vs data scale) |
| PK Read (Hot Cache) | 4.5M ops/s |
| Batch Insert | 588K ops/s |
| Pagination (Hot Cache) | 579K ops/s |
| ANN @ depth 1 (~91%) | 36K ops/s |
Gráficos completos y todas las operaciones: Benchmarks.
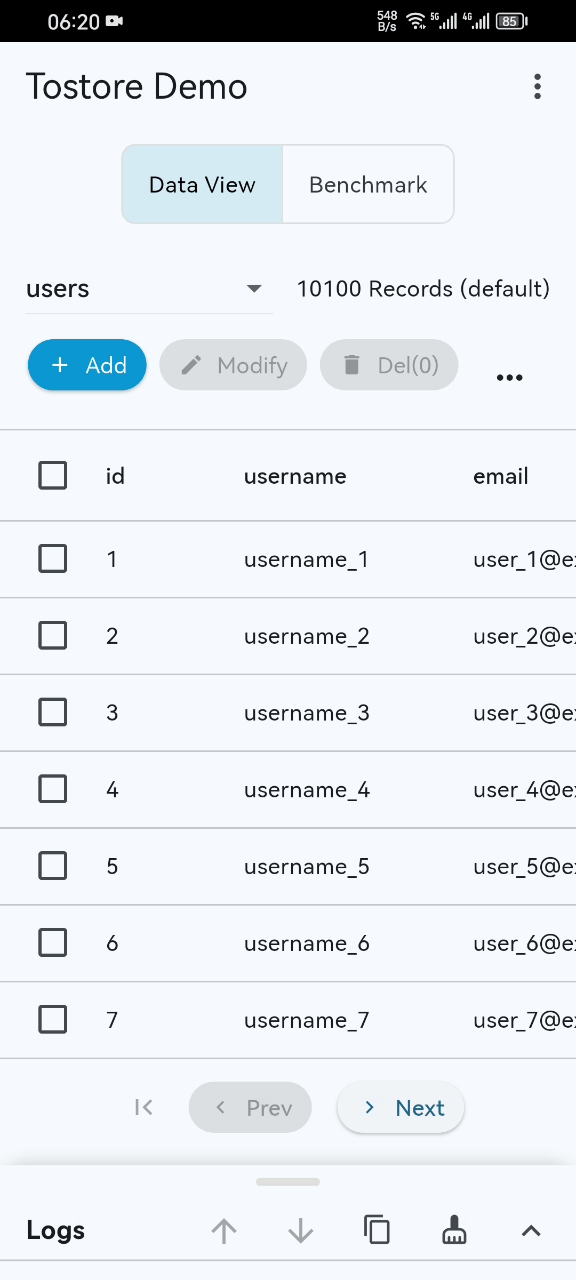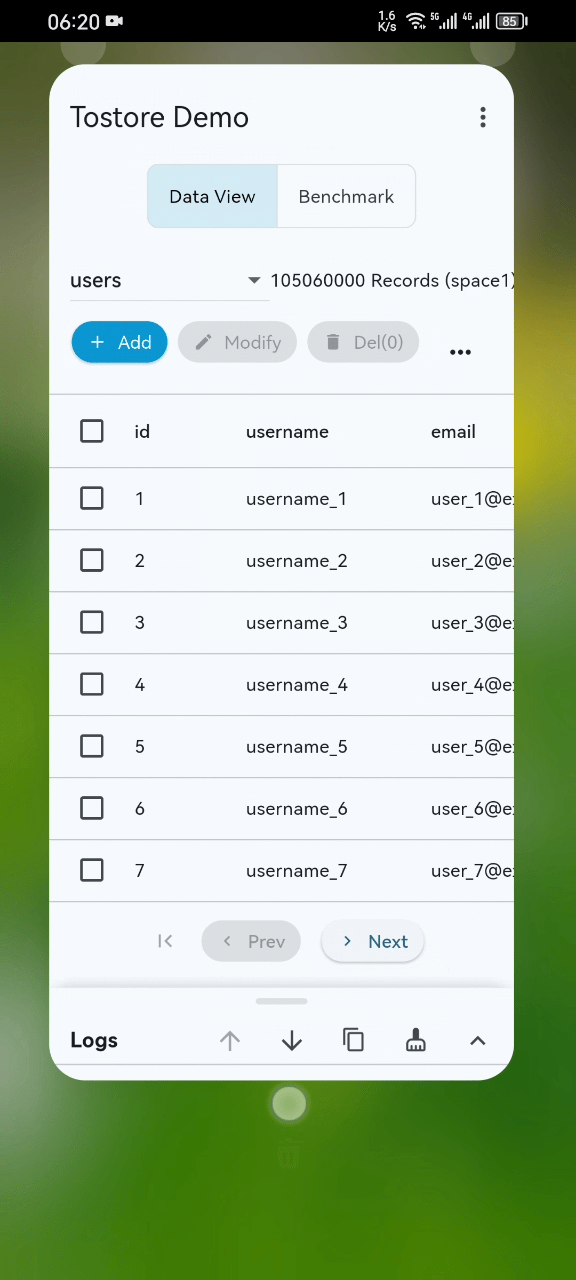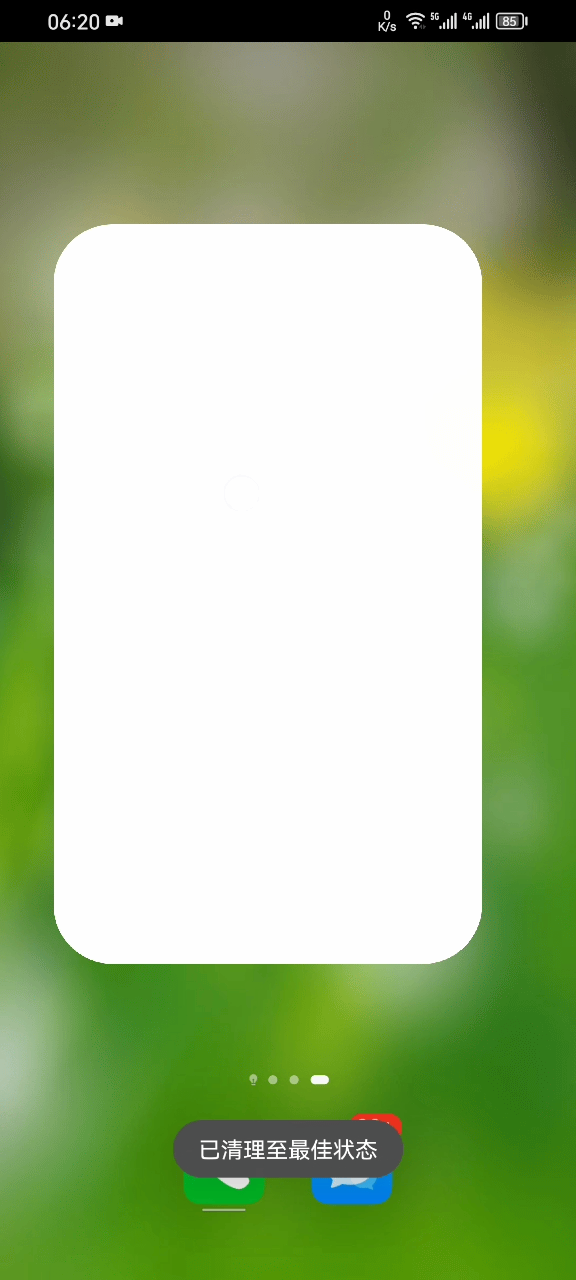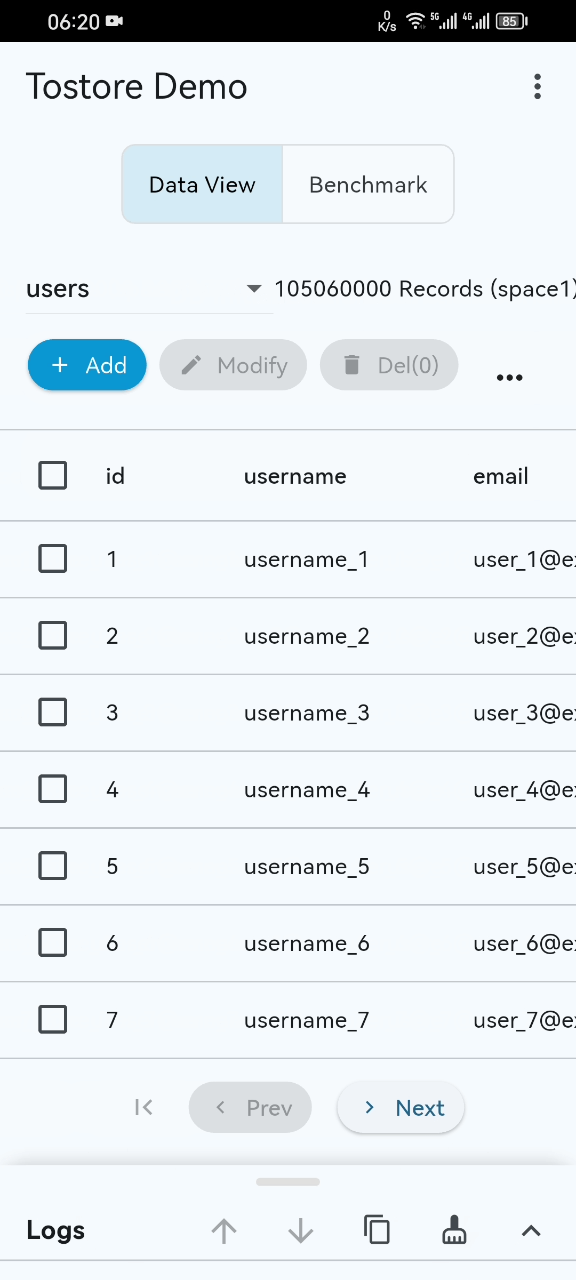
- Demostración de rendimiento básico (basic-demo.mp4): es posible que la vista previa del GIF no muestre todo. Abra el vídeo para ver la demostración completa. Incluso en dispositivos móviles comunes, el inicio, la paginación y la recuperación permanecen estables y fluidos incluso cuando el conjunto de datos supera los 100 millones de registros.
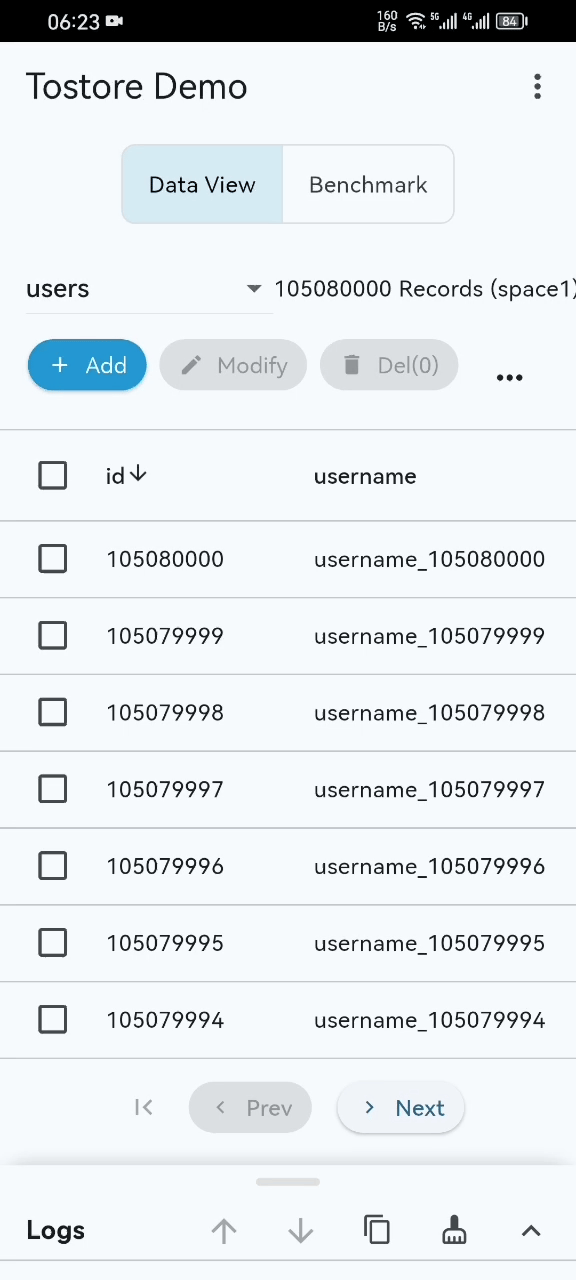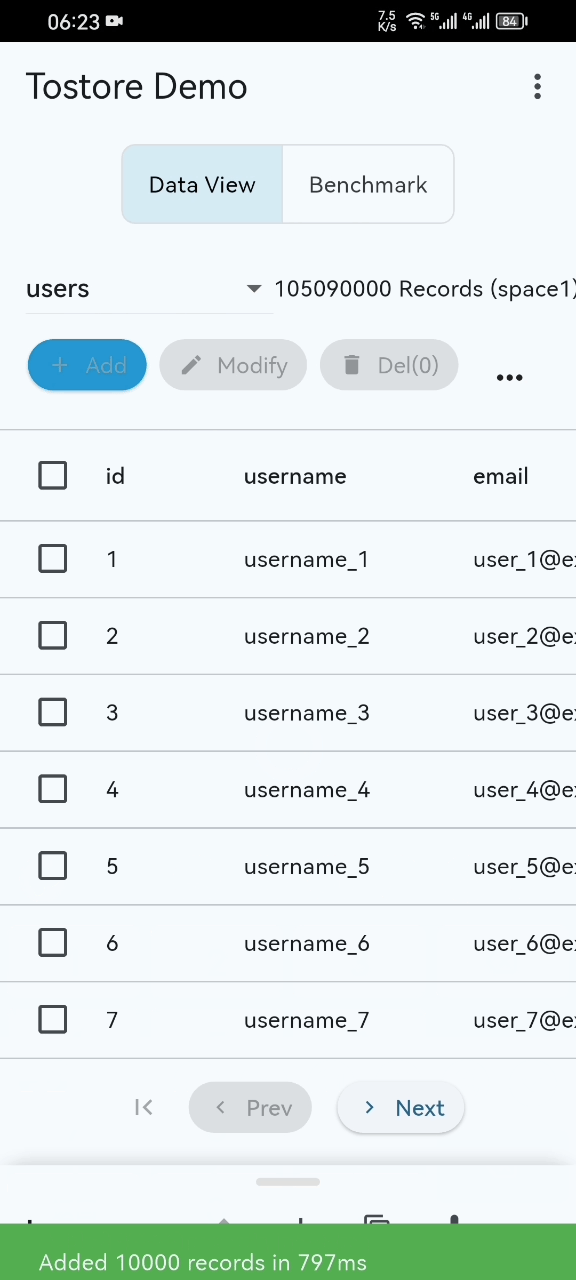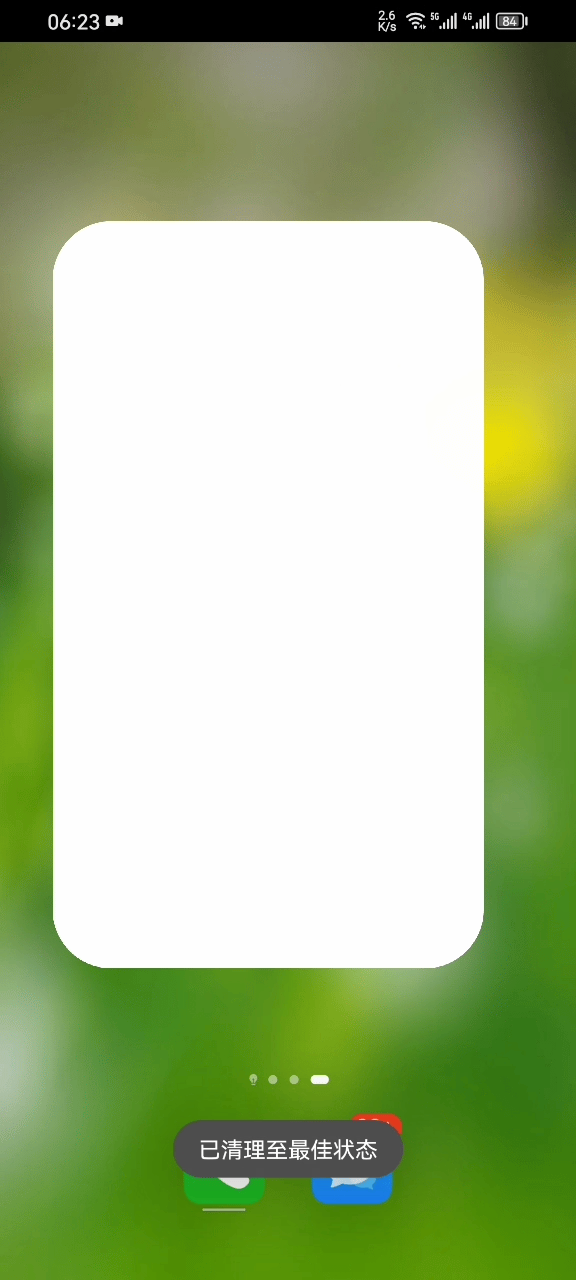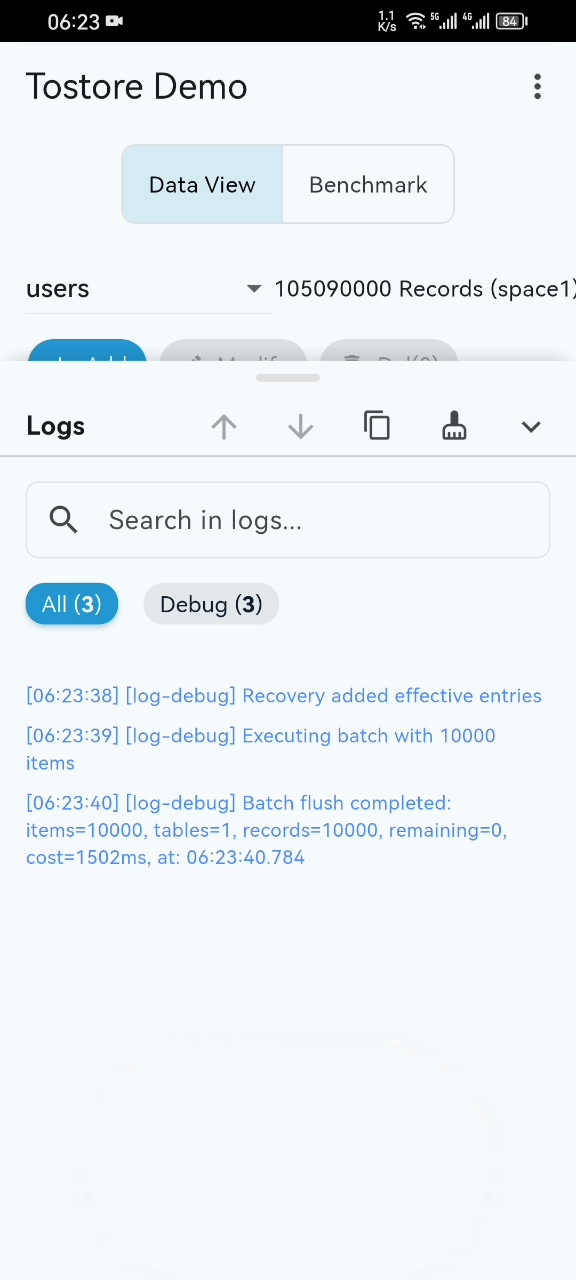
- Prueba de estrés de recuperación ante desastres (disaster-recovery.mp4): durante las escrituras de alta frecuencia, el proceso se interrumpe intencionalmente una y otra vez para simular fallas y cortes de energía. ToStore puede recuperarse rápidamente.
Consejos de experiencia
- 📱 Proyecto de ejemplo: el directorio
exampleincluye una aplicación Flutter completa - 🚀 Compilaciones de producción: empaquetar y probar en modo de lanzamiento; el rendimiento de la versión va mucho más allá del modo de depuración
- ✅ Pruebas estándar: las capacidades principales están cubiertas por pruebas estandarizadas
Si ToStore te ayuda, danos un ⭐️, ¡es una de las mejores formas de apoyar el proyecto. Muchas gracias!
🤝 Contribuir
ToStore es un motor de datos moderno en continua evolución, y agradecemos mucho las contribuciones de la comunidad. Ya sea corrigiendo errores, mejorando la documentación, refinando la arquitectura o proponiendo nuevas ideas, puedes participar a través de PR:
- 🔗 Enviar PR: Pull Requests
- 📖 Documentación: Wiki
- 📢 Informe de problemas: GitHub Issues
- 💬 Discusión técnica: GitHub Discussions