
pablocaeg/sloptotal
pablocaeg/sloptotal has 121 GitHub stars and 44 forks. GitHot measured +2 stars in 24 hours, +17 in 7 days, and +36 in 15 days. Last checked 2026-11-17 02:29 UTC. Last push 2026-11-03.
What you can do
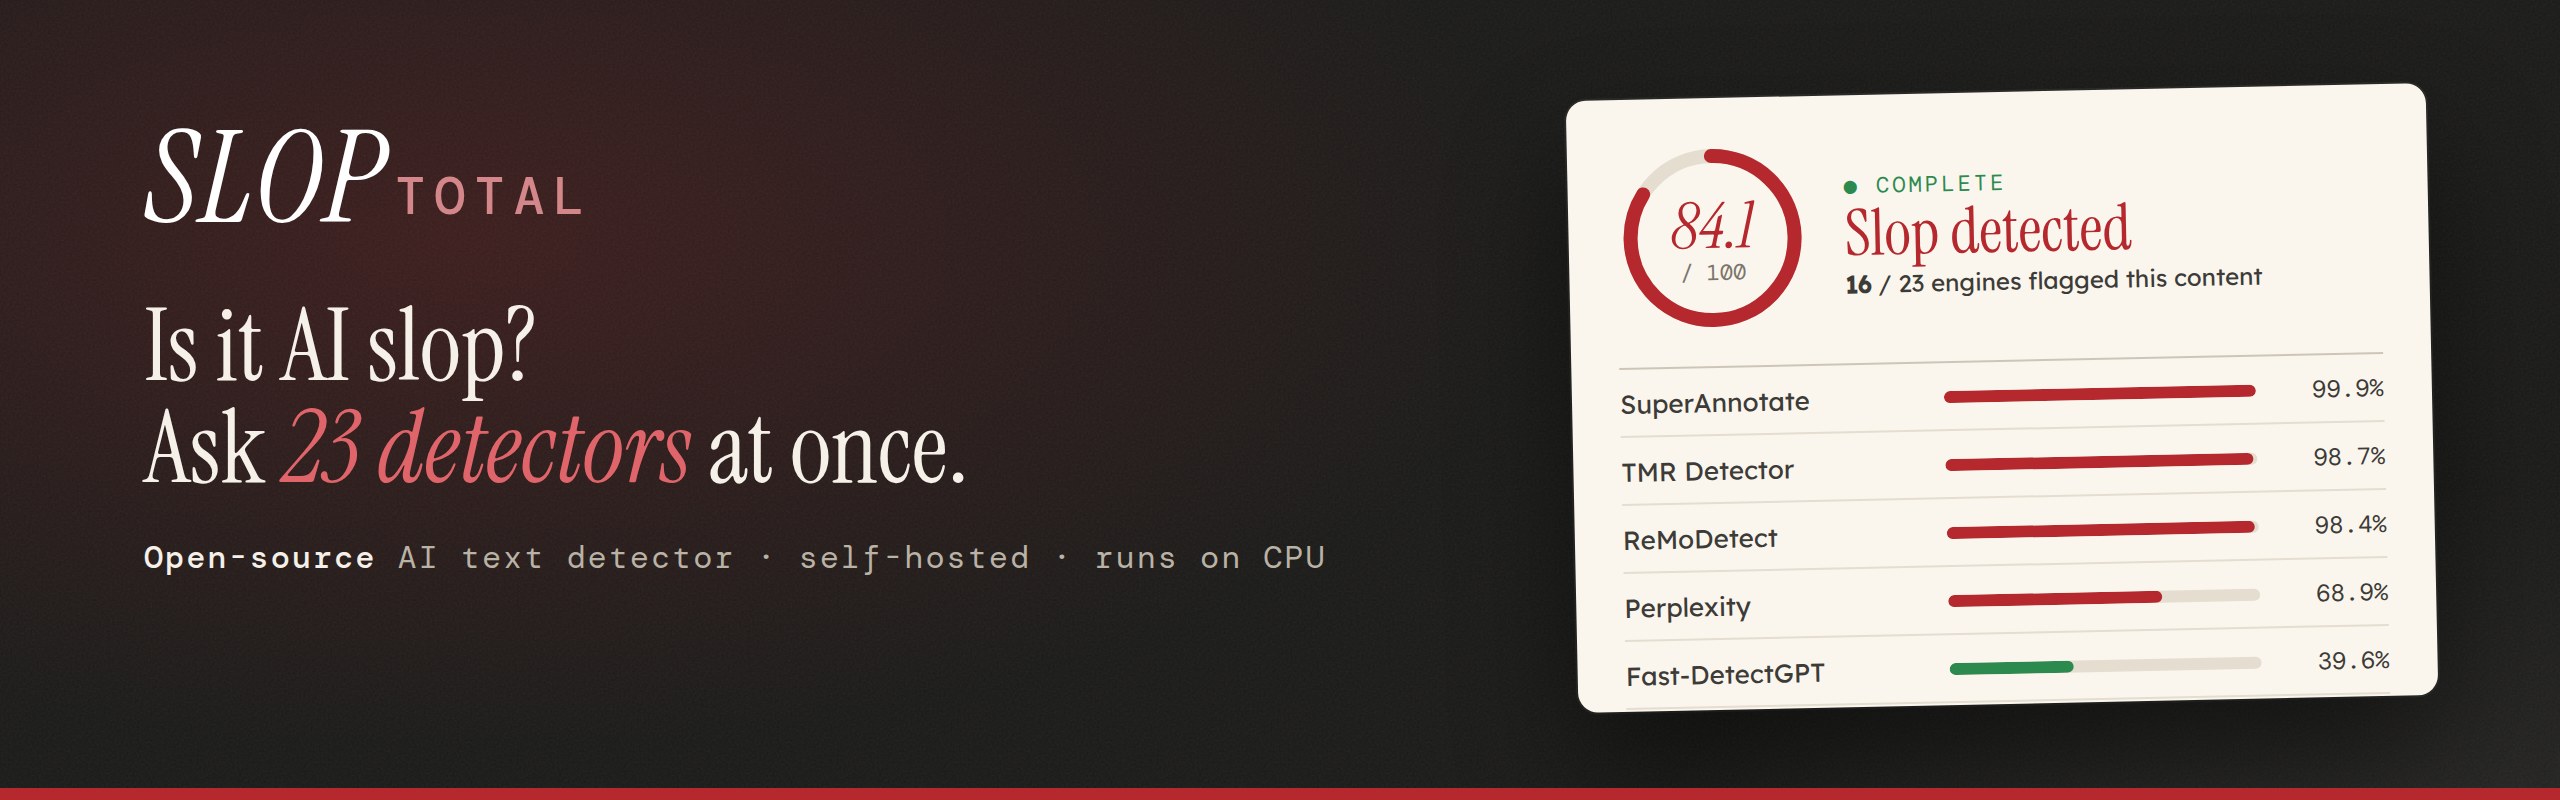
- 23 detection engines, one calibrated score. DeBERTa and RoBERTa classifiers, Binoculars, Fast-DetectGPT, GLTR, perplexity and burstiness tests, and stock-phrase heuristics. Results stream in as each engine finishes.
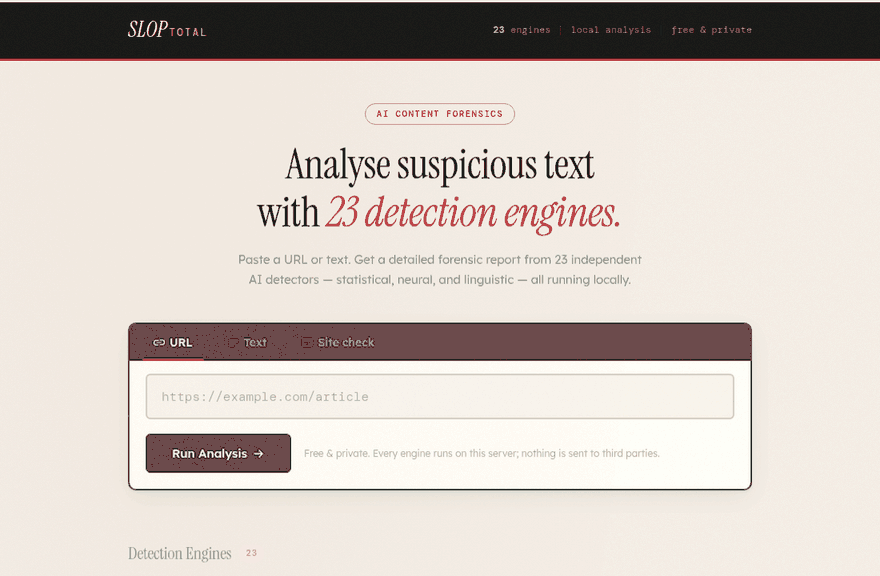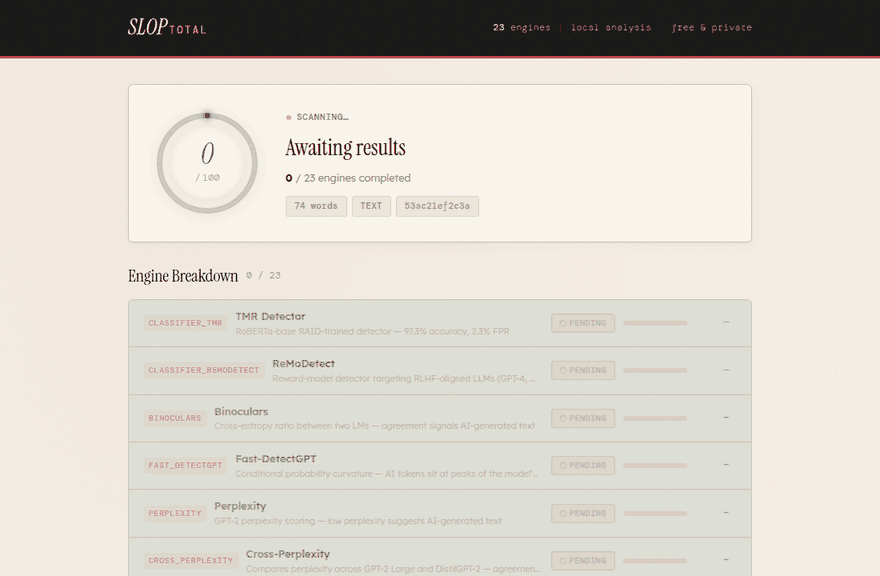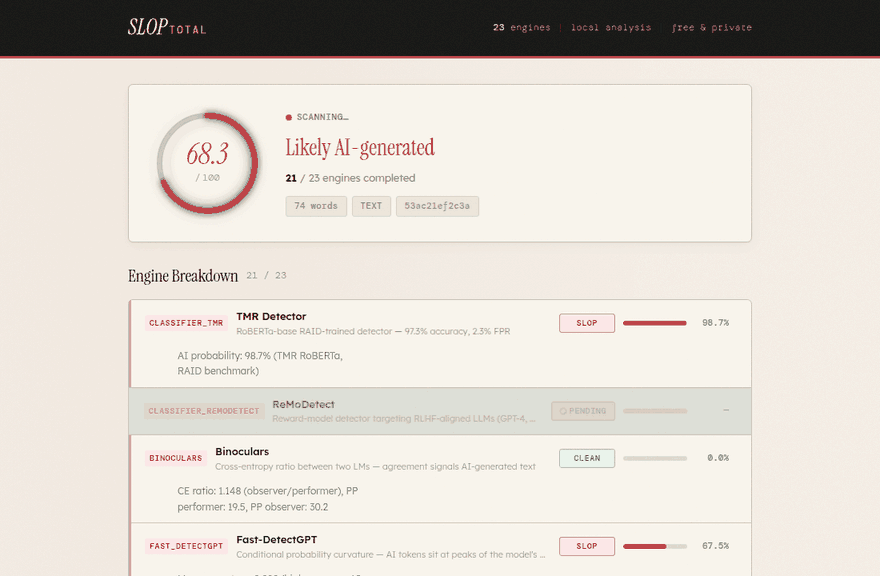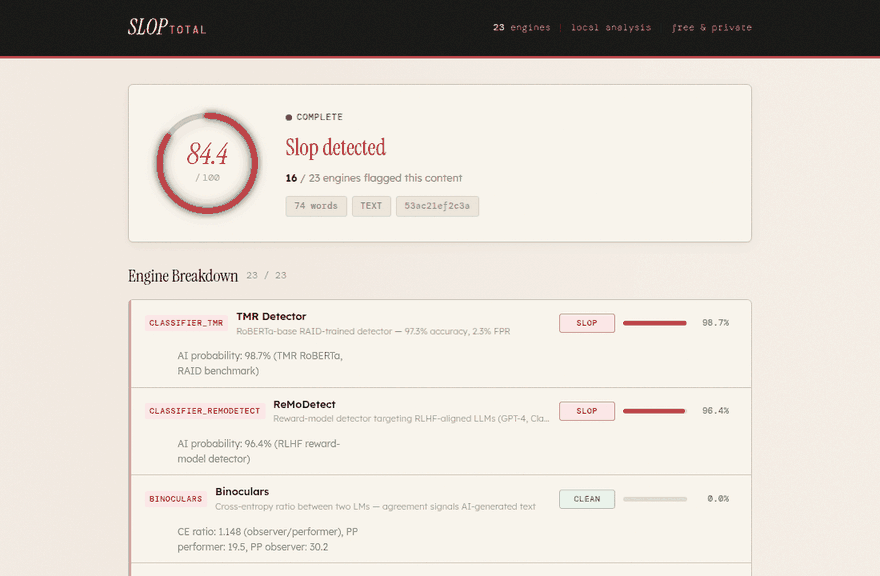
- Text, URLs and documents. Paste text, scan a web page (main content is extracted automatically), or upload .pdf, .docx, .txt or .md.
- Site check: was this website vibe-coded? Finds the fingerprints that Lovable, v0, Bolt, Base44, Replit, Same and Emergent leave in the sites they deploy, and shows the evidence for each one. How it works
- Per-paragraph heat map through the API, to see which parts read as AI.
Crecimiento de estrellas medido
- in 24h
- +2
- in 7 days
- +17
- in 15 days
- +36
- in 1 month
- Recopilando historial
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
Acerca de
Open-source AI text detector and ChatGPT detector: 23 engines, one calibrated score, every number measured on a public benchmark. Self-hosted, runs on CPU.
IAREADME.es.md
Original




English · 简体中文 · Русский · Español
SlopTotal
El VirusTotal del texto escrito por IA. Pega un texto, sube un PDF o un archivo de Word, o pasa un enlace. Veintitrés detectores de IA independientes (clasificadores neuronales, pruebas estadísticas y heurísticas lingüísticas) lo puntúan en paralelo, y un ensamble calibrado combina sus votos en un único veredicto que puedes desglosar motor por motor. Todo se ejecuta en tu CPU, así que el texto que analizas nunca sale de tu máquina.
Es una alternativa gratuita, de código abierto y autoalojada a detectores en línea como GPTZero, Originality.ai, Copyleaks o ZeroGPT. En lugar de un único número de un único modelo, ves la opinión de cada modelo, y el proyecto publica su precisión, fallos incluidos.
Pruébalo: sloptotal.com/es · Ejecútalo tú mismo: docker run -p 8000:8000 ghcr.io/pablocaeg/sloptotal
Esta es la versión en español del README en inglés. Si no coinciden, manda la versión en inglés.
Funciones
- 23 motores de detección, una puntuación calibrada. Clasificadores DeBERTa y RoBERTa, Binoculars, Fast-DetectGPT, GLTR, pruebas de perplejidad y de burstiness (variabilidad), y búsqueda de frases hechas. Los resultados aparecen a medida que cada motor termina.
- Texto, enlaces y documentos. Pega un texto, analiza una página web (el texto principal se extrae automáticamente) o sube un
.pdf,.docx,.txto.md. - Comprobación de sitios: ¿lo ha hecho una IA? Encuentra las huellas que Lovable, v0, Bolt, Base44, Replit, Same y Emergent dejan en los sitios que despliegan, y muestra la prueba de cada una. Cómo funciona
- Mapa de calor por párrafos a través de la API: muestra qué partes del texto parecen de IA.
- Medido, no prometido. Cada cifra de precisión de abajo tiene su corpus, el código con el que se midió y las puntuaciones de cada muestra.
- Privado por defecto. Autoalojado, sin APIs de IA de terceros, sin rastreo; los informes se borran a los 30 días.
- Basta con una CPU. El hardware se detecta automáticamente y la GPU es opcional.
- API JSON y extensión para Chrome, que marca los resultados con pinta de IA en la búsqueda de Google y en LinkedIn.
Precisión medida
La mayoría de los detectores publican un porcentaje de precisión sin decir sobre qué se midió. SlopTotal se mide con SlopBench: 1626 textos escritos por personas (todos anteriores a ChatGPT) y 1626 textos de IA sobre los mismos temas y con la misma longitud, generados por 14 modelos actuales, en 15 géneros (noticias, Wikipedia, arXiv, Stack Exchange, Reddit, reseñas, redacciones escolares y universitarias, inglés de hablantes no nativos, ficción y literatura publicada entre 1532 y 1915). Cada cifra de abajo se ha medido en géneros con los que el modelo no se ajustó.
| AUC | 0,942 |
| Textos de IA con veredicto «Probablemente IA» (55+) | 67 % |
| Textos humanos con veredicto «Probablemente IA» (55+) | 1,7 % |
| Textos humanos marcados de alguna forma (45+) | 3,9 % |
| Literatura de 1532 a 1915 marcada como IA | 0 de 87 |
Los rangos de puntuación están anclados a textos humanos. A partir de 45 puntos empieza el 5 % de los textos humanos más «sospechosos», a partir de 55 el 2 % y a partir de 80 el 0,5 %. Es decir, «Probablemente IA» significa que menos de 2 de cada 100 textos humanos reciben esa puntuación.
El español está soportado. La calibración multilingüe se ha comprobado por separado en español, que forma parte del grupo «supported» (AUC de al menos 0,90 y al menos el 60 % de los textos de IA detectados con el umbral de 45), junto con el francés, el alemán, el italiano, el portugués, el neerlandés, el polaco, el ruso y el japonés. El árabe y el coreano todavía son experimentales; el hindi, el turco y el chino aún no son fiables, y el informe lo dice claramente.
Lo que no funciona. Las redacciones en inglés de hablantes no nativos todavía se marcan más a menudo (el 15 % de las redacciones del TOEFL reciben «Probablemente IA», frente a ninguna de 88 redacciones de estudiantes estadounidenses). Por debajo de unas 80 palabras, la puntuación es una señal débil. El texto de IA pasado por un «humanizador» se detecta más o menos la mitad de las veces. Estos motores no analizan código fuente. Todos los resultados por fuente, modelo y motor están en los hallazgos, incluido que los clasificadores que lideran el benchmark RAID caen a un AUC de 0,75 con los modelos actuales.
Inicio rápido
Docker (lo más rápido)
docker run -p 8000:8000 -v sloptotal-models:/app/models ghcr.io/pablocaeg/sloptotal
Abre http://localhost:8000. El primer análisis descarga los modelos (unos 9 GB, consulta docs/MODELS.md) en el volumen sloptotal-models, así que los siguientes arranques son rápidos.
Desde el código fuente
Necesitas Python 3.10+.
git clone https://github.com/pablocaeg/sloptotal.git
cd sloptotal
python3.11 -m venv venv && source venv/bin/activate
pip install -r requirements.txt
./scripts/start.sh    # o: uvicorn app.main:app --port 8000
Para comprobar que cada motor se carga y devuelve una puntuación:
python scripts/smoke_test.py # por defecto, http://localhost:8000
Comprobación de sitios: ¿lo ha hecho un constructor de IA?
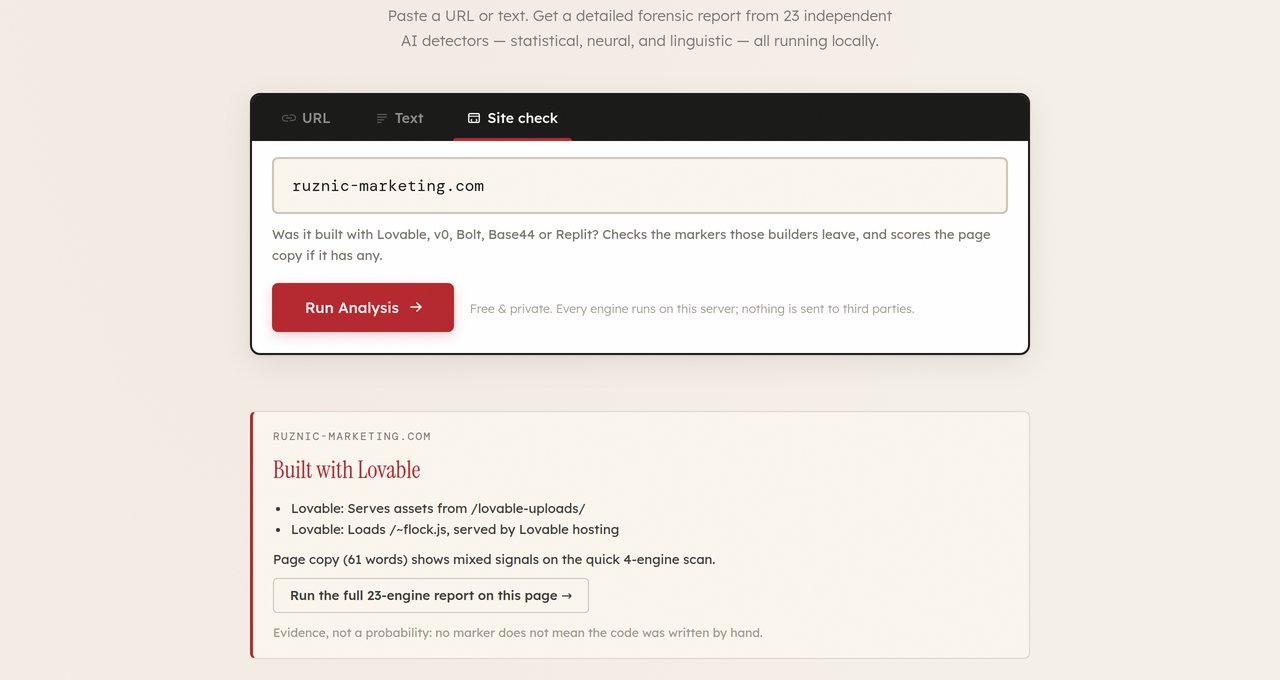
Los servicios del tipo «¿este sitio está hecho con vibe coding?» puntúan sobre todo el estilo (cuántas clases de Tailwind hay, si faltan cabeceras de seguridad, palabras de moda) y lo convierten en un porcentaje. Pero los sitios escritos a mano también tienen todo eso. SlopTotal solo busca las marcas que los propios constructores dejan en lo que despliegan, y cada una está verificada en sitios reales o en las plantillas del propio constructor:
| Constructor | Huellas |
|---|---|
| Lovable | runtime gptengineer.js, recursos en /lovable-uploads/, insignia de Lovable, /~flock.js, *.lovable.app |
| v0 (Vercel) | <meta name="generator" content="v0.app"> de la plantilla de v0, *.vusercontent.net |
| Bolt | cabecera X-Powered-By: Bolt.new, bolt.new/badge.js, *.bolt.host |
| Base44 | llamadas a la plataforma app.base44.com, base44_access_token, *.base44.app |
| Replit | banner de desarrollo de Replit Agent, insignia de Replit, *.replit.app |
| Same | recursos servidos desde same-assets.com |
| Emergent | cookies __emg_sid y __emg_vid, script emergent-main.js, *.emergent.host |
Un sitio sin marcas también puede haberse escrito con ayuda de IA: el código exportado desde estas herramientas y alojado en otro sitio, o escrito en un editor con IA, no deja huellas. Por eso el resultado es una prueba y no una probabilidad. Los textos de la página se puntúan aparte con los motores de texto.
curl -X POST http://localhost:8000/api/scan/site \
  -H "Content-Type: application/json" -d '{"url": "example.com"}'
API
curl -X POST http://localhost:8000/api/analyze \
  -H "Content-Type: application/json" \
  -d '{"text": "Texto que quieres analizar..."}'
La respuesta incluye cada motor con su puntuación, su veredicto y una explicación en lenguaje sencillo, además de overall_score (0-100) y overall_verdict. También hay una puntuación rápida, puntuación por párrafos, análisis por lotes y extracción de texto de documentos: la lista completa está en la sección API del README en inglés. En examples/ hay clientes en Python y Node.js.
El servicio público de sloptotal.com está pensado para la web y la extensión. Si necesitas muchas peticiones, despliega tu propia instancia: es abierta, gratuita y sin límites.
Motores de detección
23 motores en tres grupos:
- Clasificadores neuronales (9): Desklib DeBERTa, SuperAnnotate, E5-Small, TMR, BERT-tiny RAID, ReMoDetect, ChatGPT Detector, Fakespot, OpenAI Detector.
- Métodos estadísticos (7): Log-Rank, GLTR, perplejidad, perplejidad cruzada, Fast-DetectGPT, Binoculars, DivEye.
- Heurísticas lingüísticas (7): análisis estructural, marcadores lingüísticos (las palabras favoritas de la IA, como «delve» o «tapestry»), frases hechas, riqueza de vocabulario, uniformidad de la legibilidad, burstiness y lenguaje evasivo o atenuado.
El modelo, el AUC y la descripción de cada motor están en la tabla del README en inglés, y cada motor tiene su propia página en sloptotal.com con sus puntuaciones medidas. Por separado, las heurísticas son débiles. Se mantienen porque se equivocan de forma independiente de los clasificadores neuronales, y por eso sirven como voto de desempate, no como prueba.
Cómo se calcula la puntuación
La puntuación final la da un modelo logístico entrenado con SlopBench sobre las puntuaciones de los motores. Los parámetros están en app/calibration.json, y qué significa cada campo y cómo volver a calcularlos se explica en docs/CALIBRATION.md.
- Pesos aprendidos, no puestos a mano. La puntuación de cada motor se convierte a log-odds y se multiplica por un peso no negativo. Un motor solo recibe peso por lo que aporta sobre los demás, así que los motores que se equivocan juntos no cuentan dos veces.
- Rangos fijados con textos humanos. 45, 55 y 80 puntos marcan el inicio del 5 %, el 2 % y el 0,5 % superior de los textos humanos.
- Los textos cortos se acercan a la puntuación neutra, porque contienen menos pruebas. Para otros idiomas, incluido el español, se usa una corrección entrenada por separado.
- La confianza depende de la puntuación. Es baja con menos de 80 palabras, en un idioma poco fiable o con una puntuación entre 35 y 65.
Preguntas frecuentes
¿Se puede confiar en los detectores de IA? No a ciegas. Ningún detector, tampoco este, debería ser la única prueba para acusar a alguien. Por eso SlopTotal muestra los 23 votos, cuánto coinciden y la tasa de falsos positivos medida. Los textos cortos (menos de unas 80 palabras) y el texto de IA muy editado no son fiables para ningún detector.
¿Detecta ChatGPT, Claude, DeepSeek, Qwen o Llama? Los textos de IA de SlopBench proceden de 14 modelos actuales, entre ellos GPT, Claude, DeepSeek, Qwen, Kimi, GLM, Gemma, Llama, Mistral y Grok. Los modelos nuevos se cubren en la medida en que comparten rasgos con estos; con las herramientas de evaluación puedes medir el modelo que te interese.
¿Marca la literatura clásica o el estilo formal? En nuestras pruebas, no: ninguno de los 87 textos literarios de 1532 a 1915 se marcó.
¿Se guarda mi texto o se comparte con alguien? Solo se procesa en el servidor que tú ejecutas. Los informes se guardan 30 días (configurable) para que funcionen los enlaces, y no se envía nada a servicios externos.
¿Detecta código escrito por IA? No, y no lo afirmamos. La comprobación de sitios responde a otra pregunta: con qué constructor de IA se hizo un sitio.
Contribuir
Las contribuciones son bienvenidas, sobre todo motores nuevos con sus mediciones y mejoras para el español: corpus, calibración y traducción. Empieza por CONTRIBUTING.md y AGENTS.md.
- Tareas para empezar: cada una indica qué archivos cambiar
- Informar de un error
- Proponer una función
- Proponer un motor nuevo
- Hacer una pregunta o compartir resultados
Si SlopTotal te resulta útil, una ⭐ estrella en GitHub ayuda a que otros lo encuentren.