
maximilianfeix/proxy-scraper
maximilianfeix/proxy-scraper has 94 GitHub stars and 22 forks. GitHot measured +2 stars in 24 hours. Last checked 2026-11-15 16:31 UTC. Last push 2026-11-15.
Crecimiento de estrellas medido
- in 24h
- +2
- in 7 days
- Actualización retrasada
- in 15 days
- Actualización retrasada
- in 1 month
- Actualización retrasada
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
Acerca de
Free HTTP/SOCKS proxy list, rebuilt every hour, with the result of every check on record. CLI, Python API, rotating proxy server, MCP server.
Herramientas de desarrolloREADME.es.md
Original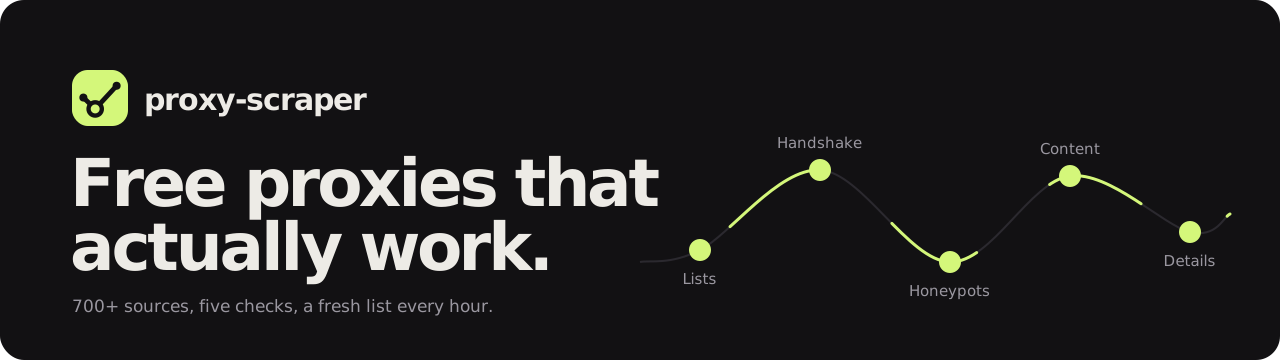






English · 简体中文 · Español · Deutsch · Русский · Português (Brasil) · Français
Instalación · Lista en vivo · Para agentes de IA · Servidor proxy · Cómo funciona · Recetas · Opciones · Preguntas frecuentes
Traducción del README en inglés; si algo no coincide, la versión inglesa es la de referencia.
Comprobaciones de proxies que puedes inspeccionar: cuáles se superaron, cuáles fallaron y cuándo. proxy-scraper recopila proxies públicos HTTP, SOCKS4 y SOCKS5 de cientos de listas, ejecuta hasta cuatro comprobaciones sobre cada uno y guarda el resultado de cada comprobación para los proxies que lista (para el resto cuenta cómo terminó cada comprobación). Así, “funciona” es algo que puedes mirar, no una etiqueta de la que tienes que fiarte.
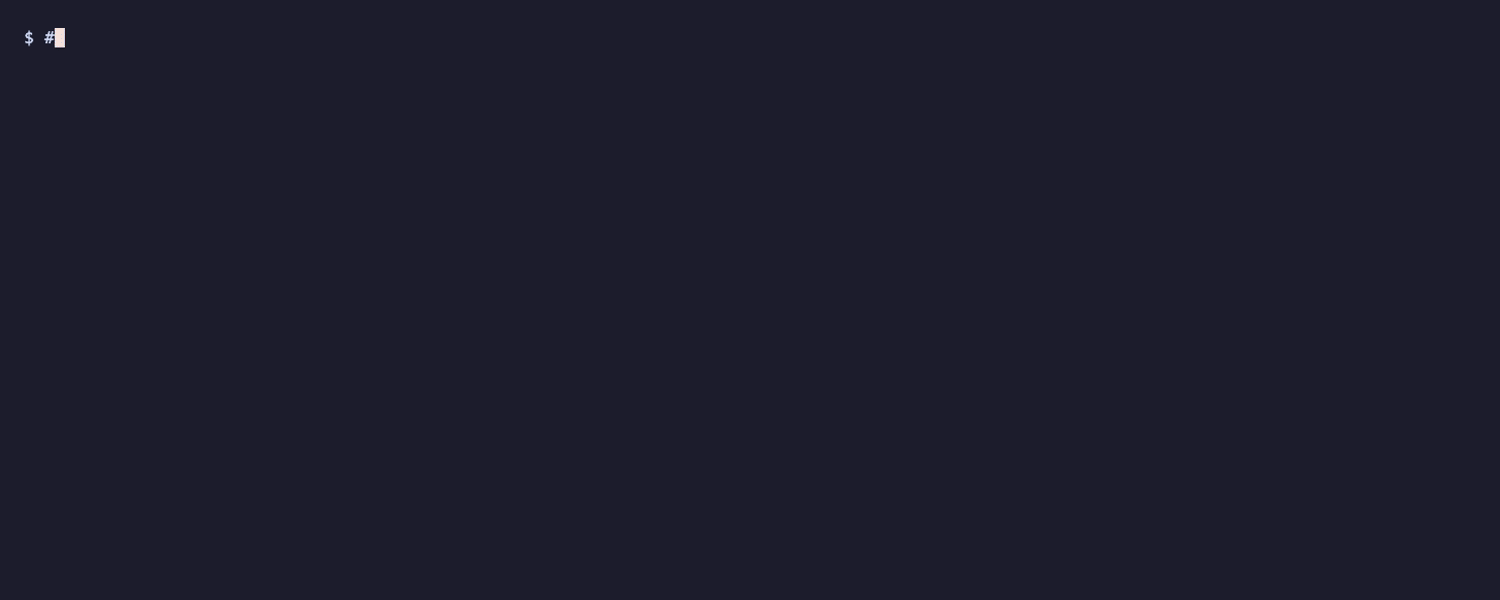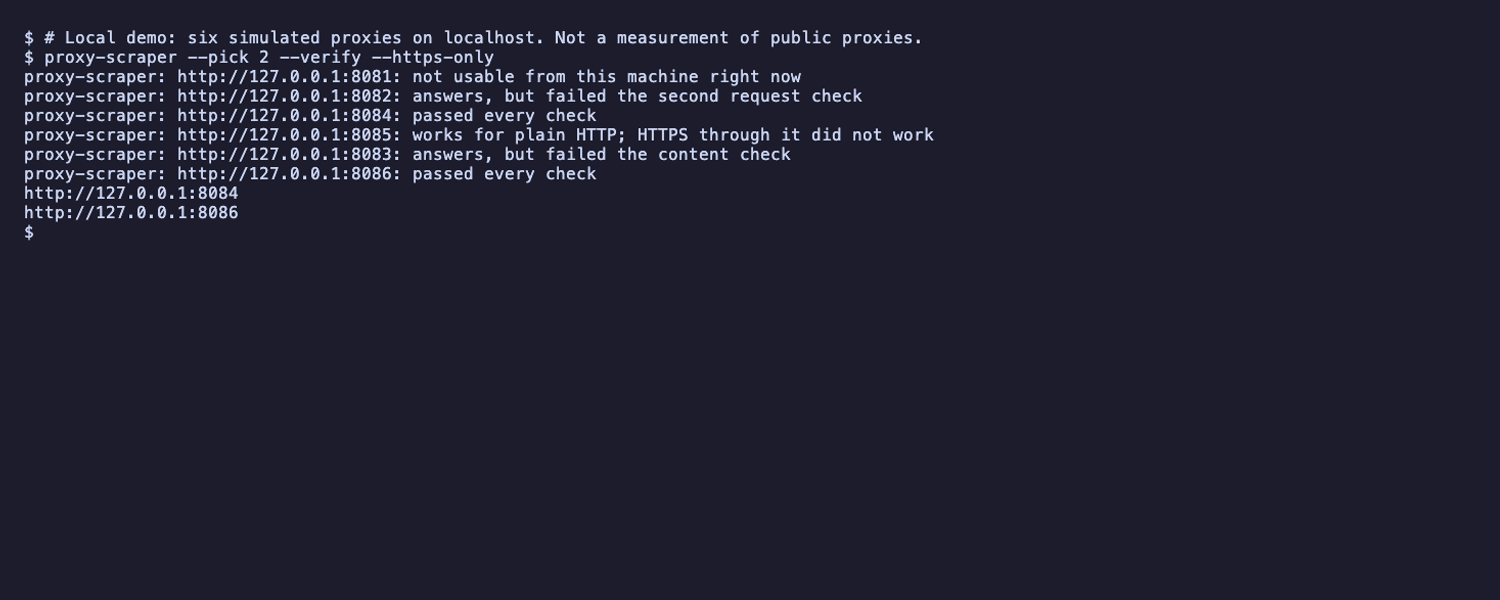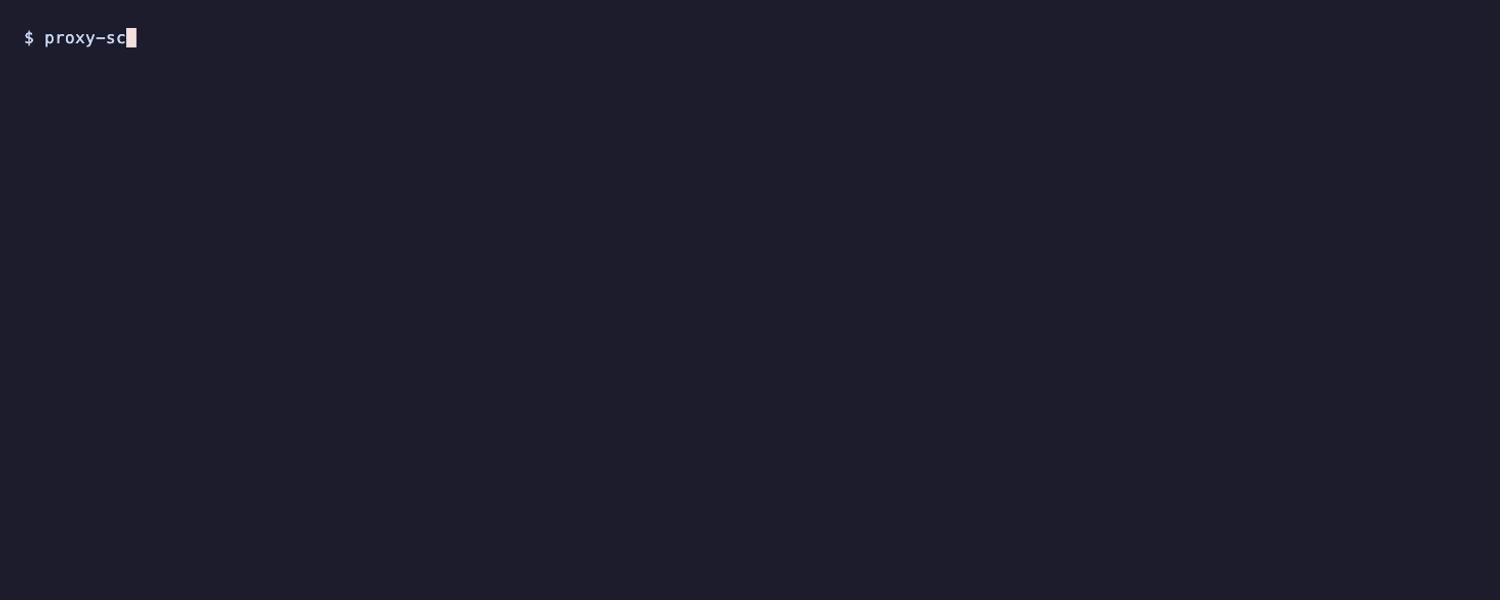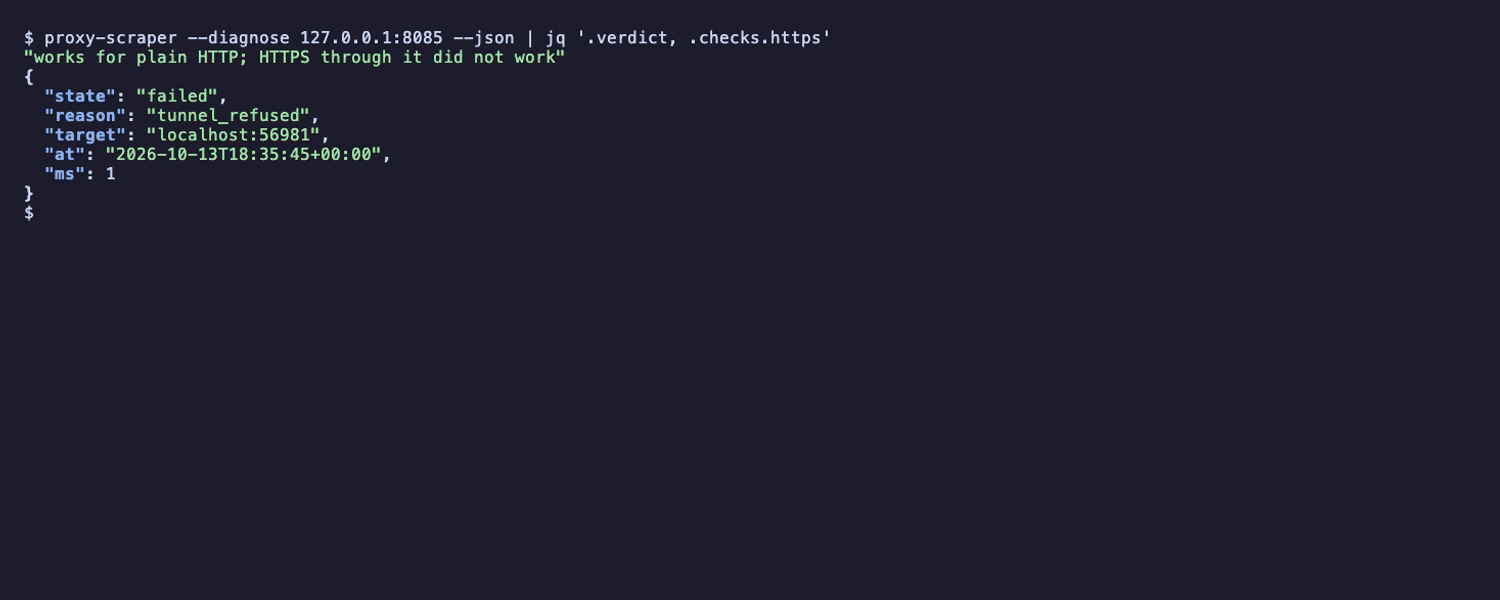
Una grabación real de terminal, hecha contra seis proxies simulados en localhost (reprodúcela). Muestra cómo se presentan los resultados. No mide nada sobre los proxies públicos.
Pruébalo: sin instalar nada, uvx viene con uv (pipx run hace lo mismo):
uvx proxy-scraper-cli --pick 3 --verify               # hasta 3 proxies de la lista horaria que superan las comprobaciones ahora mismo, desde tu red
uvx proxy-scraper-cli --diagnose socks5://HOST:PORT   # un proxy, comprobación por comprobación: qué hizo y qué no
El paquete se llama proxy-scraper-cli en PyPI (el nombre sin sufijo ya estaba cogido). Una vez instalado, el comando es proxy-scraper. --verify y --diagnose necesitan la versión 1.30 o posterior.
Tres formas de conseguir proxies, y qué significa “comprobado” en cada una:
| Comando | De dónde salen los proxies | Comprobados | Tarda |
|---|---|---|---|
proxy-scraper --pick 5 |
de la lista publicada | desde los servidores de GitHub cuando se generó la lista, más o menos cada hora | menos de un segundo |
proxy-scraper --pick 5 --verify |
de la lista publicada | ahora, desde tu red | segundos; las comprobaciones se detienen a los 90 s, más unos segundos para cargar la lista |
proxy-scraper -y |
de todas las listas que conoce la herramienta | ahora, desde tu red | minutos (unos tres en las ejecuciones horarias) |
Qué obtienes
- Cada comprobación tiene un resultado que puedes leer.
passed,failed,unavailableoskipped(superada, fallida, no disponible, omitida), con un código de motivo, el objetivo y la hora, en la terminal, en JSON y desde Python. Una comprobación que no se ejecutó nunca se muestra como superada, y un objetivo de comprobación caído no convierte en fallos los proxies comprobados contra él. → Estados de las comprobaciones - Recién comprobados cuando importa.
--pick --verifycomprueba unos pocos proxies desde tu propia red, normalmente en segundos.--recheckhace lo mismo con una lista tuya, y--diagnosete dice por qué un proxy no funciona. - Más que una lista. Un servidor proxy rotativo local, una API de Python, un servidor MCP para agentes de IA, Docker y exportaciones para curl, proxychains, Clash y sing-box.
Qué no puede hacer. Los proxies gratuitos los gestionan desconocidos, y de la lista de una hora solo alrededor de una cuarta parte vuelve a estar en la lista un día después. Una comprobación superada es una medición, desde una red, contra objetivos de prueba: no es una promesa para la próxima hora ni para el sitio que te interesa. La comprobación de HTTPS es una conexión TLS verificada con un único host de prueba, no una calificación de seguridad. Usa los proxies gratuitos para datos públicos y pruebas, nunca para inicios de sesión, pagos ni nada personal. → Qué muestran las cifras y qué no · Comparación con otros proyectos · Quién gestiona los proxies gratuitos
¿Solo quieres las listas? No necesitas esta herramienta: free-proxy-list las tiene como archivos de texto por protocolo y por país, regenerados más o menos cada hora. O directamente desde aquí: all.txt · http.txt · socks4.txt · socks5.txt · proxies.json · más formatos
Usado por: la lista horaria es una fuente integrada de monosans/proxy-scraper-checker y gfpcom/free-proxy-list.
Tabla de contenidos
- Instalación
- Lista de proxies en vivo
- Para agentes de IA (MCP)
- Características · ¿Por qué no descargar simplemente una lista?
- Ejemplos
- Recetas
- Servidor proxy rotativo
- Bot de Discord y Telegram
- Cómo funciona
- Salida
- Opciones
- GitHub Actions
- Preguntas frecuentes
- Hoja de ruta · Contribuir · Comunidad · Agradecimientos
Instalación
Con pipx (recomendado: te da un comando proxy-scraper en su propio entorno):
pipx install proxy-scraper-cli
proxy-scraper
El paquete se llama proxy-scraper-cli en PyPI (el nombre simple ya está ocupado); el comando es proxy-scraper.
Con Homebrew en macOS y Linux:
brew install maximilianfeix/tap/proxy-scraper
La fórmula sigue cada versión en aproximadamente un día.
Otras formas: Docker, pip, un bucle de eventos más rápido o directamente desde el repositorio
# Docker: el estado aprendido y los resultados se quedan en dos carpetas junto a ti
mkdir -p proxy-data results
docker run --rm --user "$(id -u):$(id -g)" -v "$PWD/proxy-data:/data" -v "$PWD/results:/work/results" \
  ghcr.io/maximilianfeix/proxy-scraper --want 50 --https-only

# pip en el entorno actual
pip install proxy-scraper-cli

# opcional: bucle de eventos más rápido en macOS/Linux
pipx install "proxy-scraper-cli[fast]"

# la última versión de main en lugar de la última release
pipx install git+https://github.com/maximilianfeix/proxy-scraper.git

# sin instalar nada
git clone https://github.com/maximilianfeix/proxy-scraper.git
cd proxy-scraper
pip install -r requirements.txt
python3 proxy_scraper.py
Cada release incluye además un wheel que puedes instalar con pip install <file>.whl, y una imagen multiarquitectura (amd64/arm64) en ghcr.io. En el contenedor el asistente nunca aparece: se ejecuta directamente. Para el servidor proxy usa --serve --serve-host 0.0.0.0 --serve-open con -p 127.0.0.1:8899:8899, de modo que el puerto solo esté abierto en tu propia máquina, o define -e PROXY_SCRAPER_SERVE_PASSWORD=… en lugar de --serve-open.
Autocompletado con tabulador para bash, zsh, fish y PowerShell:
eval "$(proxy-scraper --completion zsh)"     # en ~/.zshrc (después de compinit); lo mismo para bash en ~/.bashrc
proxy-scraper --completion fish > ~/.config/fish/completions/proxy-scraper.fish
proxy-scraper --completion powershell | Out-String | Invoke-Expression   # en $PROFILE
Una vez instalado, el estado aprendido vive en la carpeta de datos de tu usuario (~/Library/Application Support/proxy-scraper, %LOCALAPPDATA%\proxy-scraper o ~/.local/share/proxy-scraper; se puede cambiar con PROXY_SCRAPER_HOME) y los resultados van a ./results. Si se ejecuta desde un clon, ambos se quedan dentro del proyecto. Tras la segunda ejecución que encuentre proxies, pide una sola vez una estrella en GitHub; PROXY_SCRAPER_NO_STAR_HINT=1 lo desactiva (nunca aparece en CI).
Si se inicia sin argumentos, un asistente te pregunta qué estás buscando:
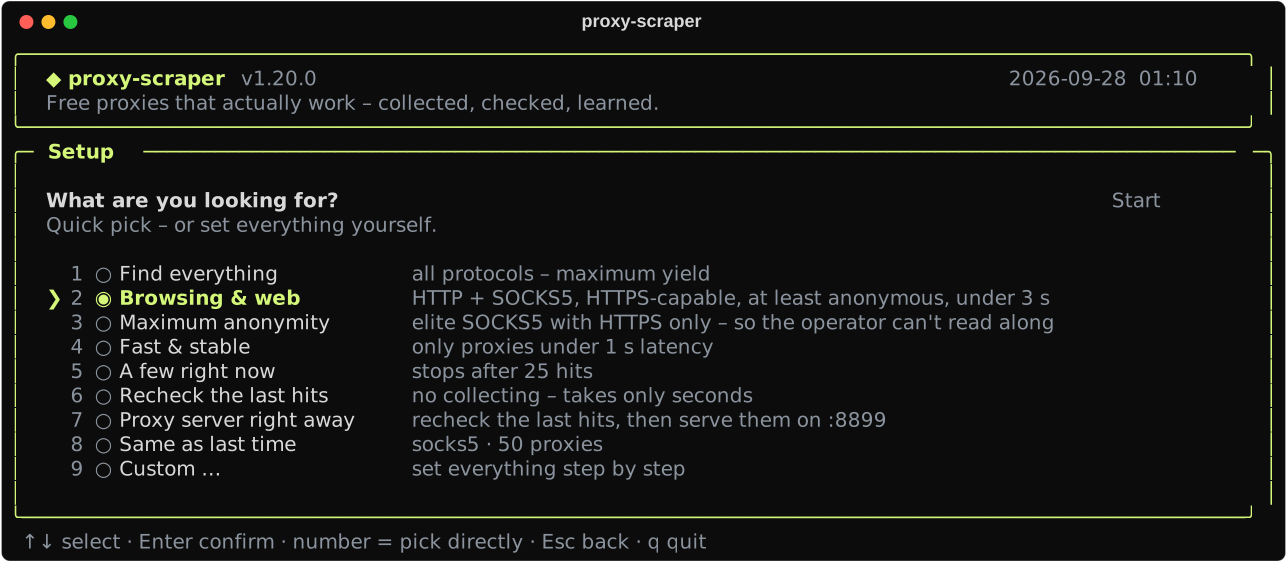 Ilustración: la interfaz real, generada con datos de ejemplo por docs/make_demo.py. Las cifras que aparecen son inventadas.
| Preajuste | Qué hace |
|---|---|
| Encontrar todo | todos los protocolos, máximo rendimiento |
| Navegación y web | HTTP + SOCKS5, compatibles con HTTPS, al menos anónimos, menos de 3 s |
| Máximo anonimato | solo SOCKS5 elite con HTTPS |
| Rápido y estable | solo proxies de menos de 1 s |
| Unos pocos ahora mismo | se detiene tras 25 aciertos |
| Volver a comprobar los últimos aciertos | sin recopilar, tarda segundos |
| Servidor proxy al instante | vuelve a comprobar los últimos aciertos y luego los sirve en :8899 |
| Igual que la última vez | tu elección anterior |
| Personalizado … | protocolos, países, anonimato, HTTPS, sitio objetivo, latencia, cantidad, modo de comprobación |
Teclas: ↑↓ seleccionar · Espacio marcar/desmarcar · 1–9 saltar · Enter siguiente · Esc atrás · q salir. En scripts y tareas cron el asistente nunca aparece: pasa opciones o -y.
Lista de proxies en vivo
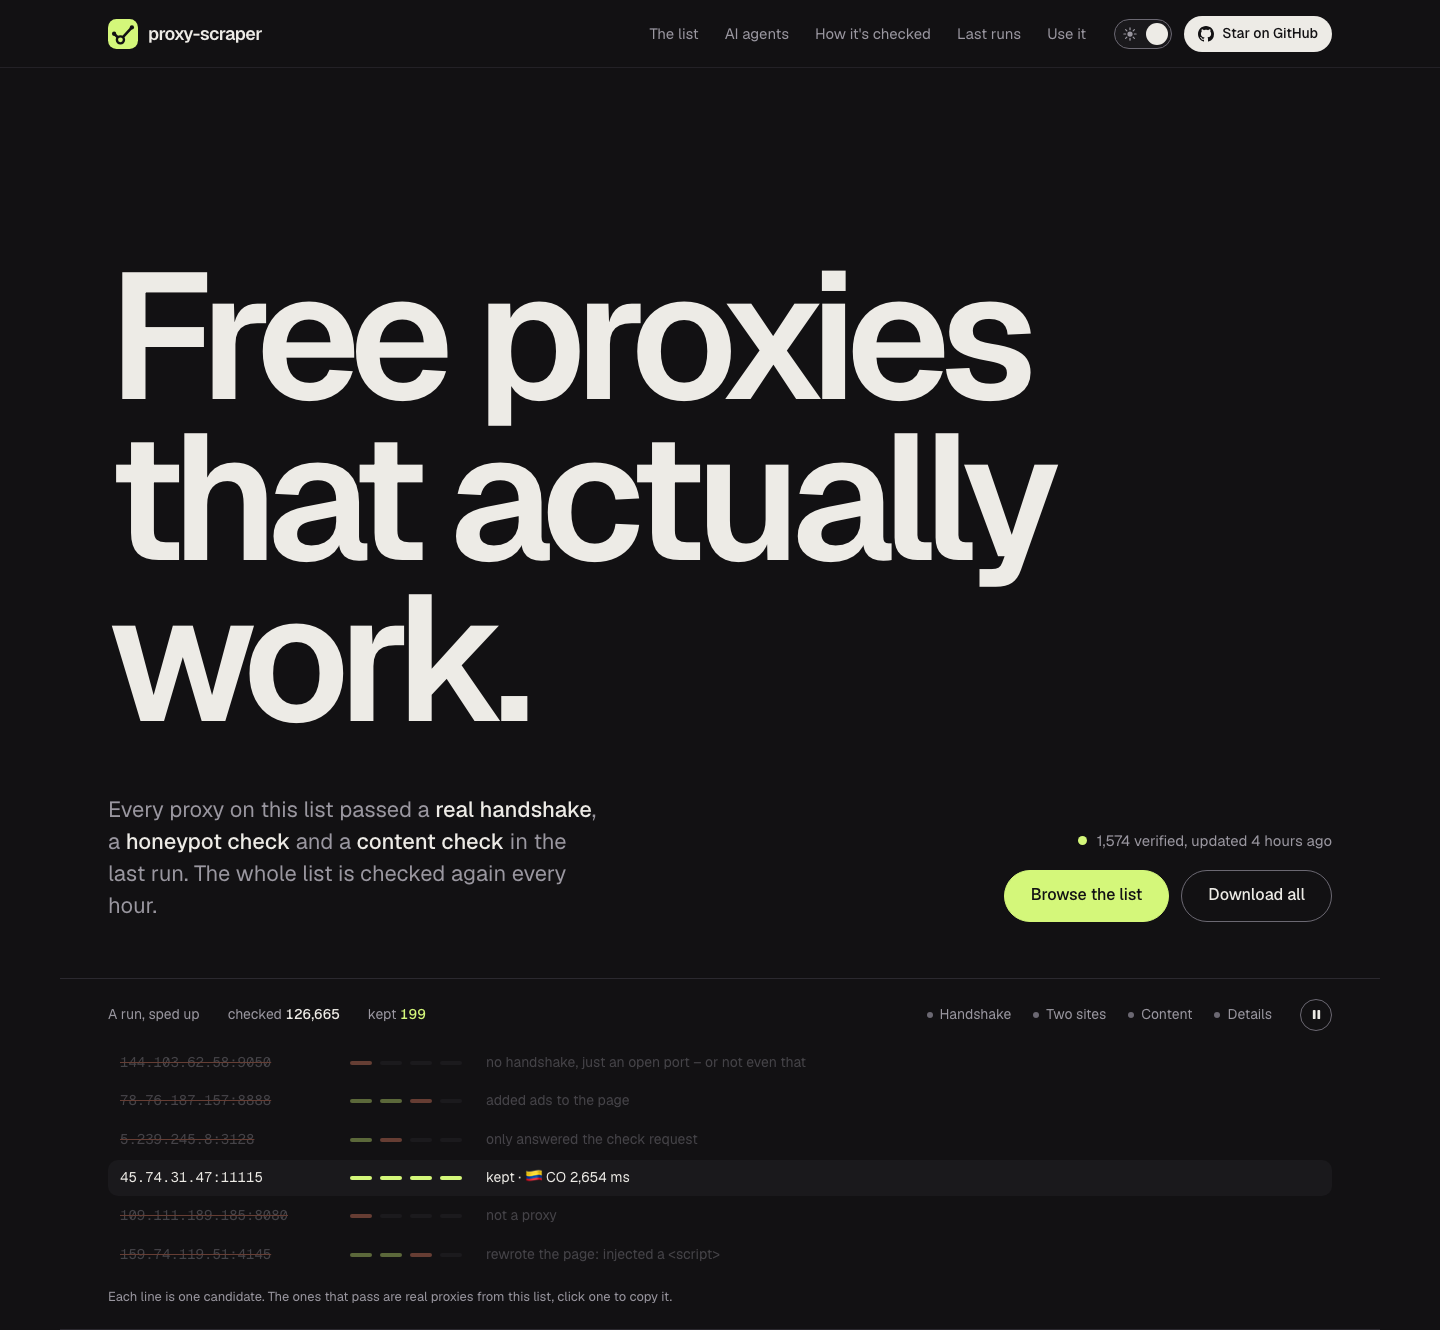
¿No quieres escanear tú mismo? Más o menos cada hora GitHub Actions ejecuta la herramienta y publica los aciertos en la rama proxy-list: cada entrada superó la primera petición, la segunda petición y la comprobación de contenido en la última ejecución (la prueba de HTTPS se registra por entrada, no es obligatoria) y van ordenadas de mejor a peor: los rápidos que probablemente sigan activos aparecen arriba.
¿Solo quieres las listas? También viven en un repositorio propio, maximilianfeix/free-proxy-list: una lista por protocolo, por país y por sitio, actualizadas cada hora, con las cifras de la última ejecución en la portada. Sigue el repositorio o dale una estrella para tenerlo a mano. Otras herramientas también lo consultan: monosans/proxy-scraper-checker y gfpcom/free-proxy-list lo usan como fuente integrada.
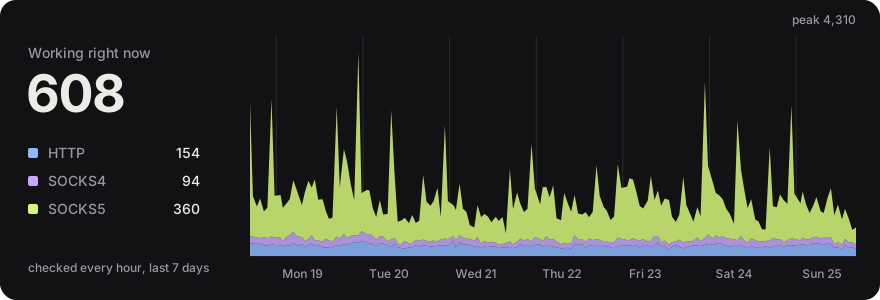
→ Explórala en el sitio web: busca, filtra por tipo, país, HTTPS, proveedor y latencia, mira cuánto tiempo lleva cada proxy en la lista y en cuántas de las ejecuciones de la semana apareció, y copia o descarga exactamente los proxies que necesitas.
Cada protocolo y cada país tiene además su propia página con una descarga simple, p. ej. SOCKS5 o Alemania (country/de/proxies.txt).
| Lista | Formato | Enlace |
|---|---|---|
| Todos | socks5://1.2.3.4:1080 |
all.txt |
| HTTP · SOCKS4 · SOCKS5 | 1.2.3.4:8080 |
http.txt · socks4.txt · socks5.txt |
| Solo compatibles con HTTPS | type://ip:port |
https.txt |
| Solo elite | type://ip:port |
elite.txt |
| Llegan a Google · Reddit · Amazon · Instagram · TikTok · Discord (una petición de prueba recibió una página normal en la última ejecución) | type://ip:port |
google.txt · reddit.txt · amazon.txt · instagram.txt · tiktok.txt · discord.txt |
| Estables, presentes en el 90 % o más de las ejecuciones de esta semana | type://ip:port |
stable.txt |
| Con todos los detalles | latencia, país, HTTPS, anonimato, IP de salida, uptime, sitios | proxies.json · proxies.csv |
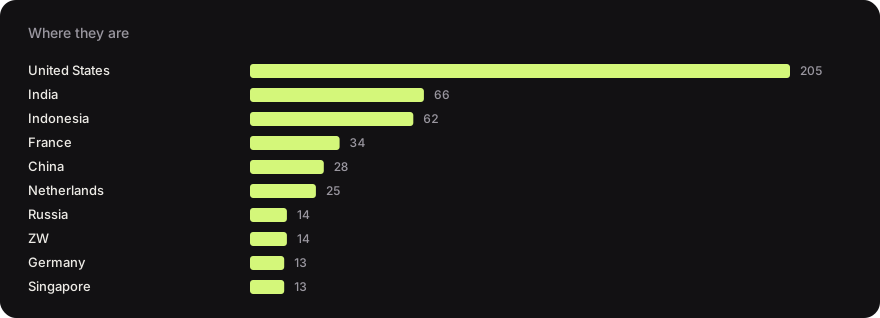
curl -s https://raw.githubusercontent.com/maximilianfeix/proxy-scraper/proxy-list/socks5.txt | head
Con el tiempo: cada día el proxies.json de la primera ejecución se conserva de forma permanente como un recurso comprimido en gzip de la release de ese año, como snapshots-2026: proxies-2026-09-27.json.gz y así sucesivamente, para quien quiera estudiar los proxies gratuitos a lo largo de semanas y meses.
Cada archivo está también en el sitio web, que no tiene límite de peticiones como raw.githubusercontent y envía cabeceras CORS, así que funciona directamente desde el navegador: https://proxy-scraper.de/socks5.txt. jsDelivr también sirve, pero puede ir con unas horas de retraso.
O deja que la herramienta parta de ella: proxy-scraper --recheck live descarga la lista y la vuelve a comprobar desde tu red: bastante menos de un minuto en lugar de un escaneo completo. Cuántos siguen funcionando desde tu red difiere mucho de la cifra de la propia lista, y por eso merece la pena volver a comprobar. Añade --serve y el resultado es un proxy rotativo.
Para agentes de IA (MCP)
proxy-scraper-mcp es un servidor MCP: Claude Code, Claude Desktop, Cursor, VS Code, Codex y cualquier otro cliente MCP pueden pedir proxies que funcionen y cargar páginas a través de ellos.
| Herramienta | Qué hace |
|---|---|
get_proxies |
proxies de la lista horaria, tal como se comprobaron en su última ejecución: filtra por protocolo, país, HTTPS, elite, sin datacenter, fuera de listas negras, estables, uptime, latencia, y por si llegan a Google/Reddit/Amazon |
check_proxies |
comprueba proxies desde tu propia red, para que funcionen desde donde se ejecuta tu código (30–90 s, informa del progreso) |
fetch_url |
carga una página a través de un proxy de la lista comprobada, cambia de proxy por sí solo cuando uno falla y devuelve texto legible; HTTPS solo a través de proxies que superaron la prueba de TLS |
Cosas que puedes pedirle a tu agente: "Carga bbc.com/news tal como se ve desde el Reino Unido", "Dame 5 proxies SOCKS5 de Alemania que no estén en un datacenter", "Comprueba cuáles de estos sitios bloquean los proxies gratuitos".
Requiere uv, que descarga por sí mismo un Python adecuado si el tuyo es anterior a la 3.10. Claude Code:
claude mcp add proxy-scraper -- uvx --python ">=3.10" --from "proxy-scraper-cli[mcp]" proxy-scraper-mcp
Claude Desktop, Cursor y la mayoría de los demás clientes: añade esto a la configuración de MCP (Claude Desktop: Settings → Developer → Edit Config, Cursor: ~/.cursor/mcp.json):
{
  "mcpServers": {
    "proxy-scraper": {
      "command": "uvx",
      "args": ["--python", ">=3.10", "--from", "proxy-scraper-cli[mcp]", "proxy-scraper-mcp"]
    }
  }
}
VS Code, Codex, Docker o sin uv
VS Code – .vscode/mcp.json:
{
  "servers": {
    "proxy-scraper": {
      "type": "stdio",
      "command": "uvx",
      "args": ["--python", ">=3.10", "--from", "proxy-scraper-cli[mcp]", "proxy-scraper-mcp"]
    }
  }
}
Codex – ~/.codex/config.toml:
[mcp_servers.proxy-scraper]
command = "uvx"
args = ["--python", ">=3.10", "--from", "proxy-scraper-cli[mcp]", "proxy-scraper-mcp"]
Sin uv: pipx install --python python3.12 "proxy-scraper-cli[mcp]" (cualquier Python 3.10+), y luego usa proxy-scraper-mcp como comando.
Docker – no hace falta Python, la imagen lo trae todo:
{
  "mcpServers": {
    "proxy-scraper": {
      "command": "docker",
      "args": ["run", "-i", "--rm", "ghcr.io/maximilianfeix/proxy-scraper", "--mcp"]
    }
  }
}
También está en el registro oficial de MCP como io.github.maximilianfeix/proxy-scraper, así que los clientes que exploran el registro pueden instalarlo desde ahí.
El servidor les dice a los agentes lo mismo que te dice a ti: los proxies gratuitos los gestionan desconocidos, así que nada de inicios de sesión, cookies ni datos personales a través de ellos. Se rechazan las direcciones locales y privadas, y los resultados van a la carpeta de datos de proxy-scraper, no al proyecto en el que estás trabajando.
Características
Asistente de configuración |
Rápido |
Verificación real |
Aprende en cada ejecución |
Encuentra fuentes nuevas por sí mismo |
Filtros y sitios objetivo |
Panel en vivo |
Servidor proxy rotativo |
Funciona en todas partes |
Probado a fondo |
¿Por qué no descargar simplemente una lista?
Una lista te dice qué le funcionó a su autor cuando la generó. Esto es lo que añade la herramienta; lo que otros proyectos documentan sobre sus propias comprobaciones está en la comparación, y para ella no se midió ninguna otra lista.
| proxy-scraper | |
|---|---|
| Comprobados justo antes de usarlos, desde tu red | --pick --verify, --recheck o un escaneo |
| El resultado de cada comprobación, con motivo y hora | checks en JSON, --diagnose |
| Una segunda petición que tiene que mostrar la misma IP de salida | siempre se intenta; si su objetivo está caído, tu propia ejecución conserva el proxy como unavailable, la lista horaria y --verify no |
| Una página de prueba que tiene que llegar byte por byte | lo mismo |
| HTTPS probado con un certificado que se verifica (un único host de prueba) | salvo con --fast |
| Nivel de anonimato y país por proxy | sí |
| Solo proxies que llegan a tu sitio objetivo | --target |
| Aprende qué fuentes merecen la pena | sí |
| Utilizable como un único proxy rotativo | --serve |
| API para obtener un proxy (compatible con proxy_pool) | /get |
| Lista lista para usar sin ejecutar nada | lista en vivo |
Ejemplos
# 50 proxies que soportan HTTPS, y luego parar
proxy-scraper --want 50 --https-only

# solo Alemania, Austria y Suiza, los 20.000 candidatos más prometedores
proxy-scraper --country DE,AT,CH -l 20000

# proxies SOCKS5 elite rápidos
proxy-scraper --types socks5 --anonymity elite --max-latency 1500

# 20 proxies que de verdad llegan a Google Y a Discord
proxy-scraper --target google.com --target discord.com --want 20

# volver a comprobar solo los últimos aciertos (más el historial): tarda segundos
proxy-scraper --recheck

# asistente con valores por defecto: conserva lo que ya pasaste
proxy-scraper -i --country DE

# ¿qué fuentes aportan más?
proxy-scraper --list-sources
¿Lo ejecutas desde un clon? Sustituye proxy-scraper por python3 proxy_scraper.py.
Desde Python
from proxyscraper import check_proxies, find_proxies

if __name__ == "__main__":  # necesario en macOS/Windows: el analizador usa un pool de procesos
    for p in find_proxies(want=20, https=True, countries=["DE", "NL"], no_datacenter=True):
        print(p.url, p.latency, p.country, p.org)

    alive = check_proxies(["socks5://1.2.3.4:1080", "5.6.7.8:3128"])  # tu propia lista
La misma ejecución que en la línea de comandos (fuentes, aprendizaje, todas las comprobaciones, archivos de resultados), solo que sin salida por terminal. Cada resultado tiene url, latency, exit_ip, https, anonymity, country, asn, org y hosting. Existe una versión asíncrona de ambas (find_proxies_async, check_proxies_async).
¿No necesitas un escaneo nuevo? live_proxies toma la lista en vivo: sin comprobaciones, una descarga, listo en aproximadamente un segundo:
import itertools, requests
from proxyscraper import live_proxies

proxies = live_proxies(types=["socks5"], https=True, min_uptime=90)  # los fiables de esta semana
pool = itertools.cycle(p.url for p in proxies)
r = requests.get("https://api.ipify.org", proxies={"https": next(pool)}, timeout=15)  # pip install "requests[socks]"
Filtra por types, countries, https, anonymity, max_latency, no_datacenter y no_blocklisted como find_proxies, y además por min_uptime, min_speed (KiB/s), works_on (["google"], "reddit", "amazon", "instagram", "tiktok", "discord") y limit. Cada resultado tiene además uptime_24h, uptime_7d, first_seen, up_for_hours, sites y speed_kbps.
O deja que la biblioteca se encargue de los reintentos: ProxyRotator carga una URL a través de la lista y pasa al siguiente proxy cuando uno falla; HTTPS solo a través de proxies con TLS verificado.
from proxyscraper import ProxyRotator

with ProxyRotator(country="DE") as rotator:
    r = rotator.get("https://httpbin.org/ip")
    print(r.status, r.text, "via", r.via)
Normalmente tarda unos segundos; cuando caen muchos proxies seguidos puede tardar un minuto (timeout= es por intento). Existe aget() con async with para código asyncio.
¿Ya usas requests, httpx, Playwright o Scrapy? proxy_url() te da una única dirección de proxy local que rota entre bastidores: cada conexión sale por otro proxy de la lista, los mejores primero, y se saltan los que están caídos:
import requests
from proxyscraper import ProxyRotator

with ProxyRotator(country="DE") as rotator:
    proxy = rotator.proxy_url()          # http://country-de:…@127.0.0.1:…
    requests.get("https://api.ipify.org", proxies={"http": proxy, "https": proxy})
    # httpx.Client(proxy=proxy) · scrapy: meta={"proxy": proxy} · curl -x "$proxy"
    # Playwright quiere las credenciales por separado: chromium.launch(proxy=rotator.playwright_proxy())
Se ejecuta en 127.0.0.1 con una contraseña aleatoria, adopta por sí solo cada nueva lista horaria y se detiene al terminar el bloque with.
Servidor proxy rotativo
Una lista está bien, pero normalmente lo que quieres es introducir una dirección de proxy y tener detrás algo que siga intentándolo:
proxy-scraper --recheck --serve # vuelve a comprobar los últimos aciertos y arranca: tarda segundos
curl -x http://127.0.0.1:8899 https://api.ipify.org              # una IP distinta cada vez
curl -x socks5h://127.0.0.1:8899 https://api.ipify.org           # SOCKS5 en el mismo puerto
curl -x http://country-de:[email protected]:8899 https://api.ipify.org # solo salidas alemanas
curl -x http://session-cart42:[email protected]:8899 https://shop.example  # el mismo proxy durante esta sesión
curl http://127.0.0.1:8899/__proxy-scraper/status                # pool y contadores en JSON
curl http://127.0.0.1:8899/__proxy-scraper/metrics               # lo mismo para Prometheus/Grafana
Como los proxies rotativos comerciales, el nombre de usuario lleva lo que quieres: country-XX, type-http|socks4|socks5 y session-NAME, combinables (country-us-type-socks5-session-a). Funciona con HTTP (Proxy-Authorization) y SOCKS5 (autenticación de usuario/contraseña). Por defecto la contraseña se ignora y el servidor solo escucha en 127.0.0.1.
Para acceder desde otras máquinas, ponle una contraseña: todos los clientes tendrán que enviarla, tanto por HTTP como por SOCKS5, y la página de estado la pedirá como autenticación Basic:
export PROXY_SCRAPER_SERVE_PASSWORD=$(openssl rand -hex 16)   # la variable de entorno la mantiene fuera de `ps`
proxy-scraper --recheck --serve --serve-host 0.0.0.0
curl -x "http://country-de:$PROXY_SCRAPER_SERVE_PASSWORD@your-server:8899" https://api.ipify.org
Sin contraseña, el servidor no arranca en ninguna dirección que no sea 127.0.0.1: sería un proxy abierto para cualquiera que llegue al puerto (Docker publica los puertos saltándose cortafuegos como ufw). Si un cortafuegos o -p 127.0.0.1:… ya impide el acceso a otros, indícalo con --serve-open. El compose.yaml incluido inicia el servidor en Docker a partir de la lista en vivo, con contraseña, comprobación de estado y el estado aprendido en un volumen: pon PROXY_PASSWORD=… en .env y luego ejecuta docker compose up -d.
| Opción | Qué hace |
|---|---|
--rotate weighted |
por defecto: los proxies rápidos y probados salen más a menudo, y todos tienen su oportunidad |
--rotate random / round-robin |
de forma uniforme, al azar o por turnos |
--rotate fastest |
siempre el más rápido que no esté ocupado |
--sticky 300 |
el mismo sitio conserva su proxy durante 5 minutos (inicios de sesión, carritos) |
- cada conexión pasa por un proxy distinto (salvo con sticky); se prefieren los rápidos y probados
CONNECTpara HTTPS y peticiones HTTP simples; detrás pueden estar proxies HTTP, SOCKS4 y SOCKS5 (SOCKS5 con DNS a través del proxy)- HTTPS prefiere los proxies que pasaron la prueba con TLS verificado; cuando ahora mismo no hay ninguno que encaje (ninguno cumple una petición como
country-de, o todos han salido de la rotación) usa los demás; la comprobación de certificados de tu propio cliente sigue detectando un proxy que rompe el cifrado, así que déjala activada - si un proxy se queda en silencio dentro del túnel o devuelve una página de error en lugar de TLS, el mismo primer paquete pasa discretamente al siguiente, pero solo cuando enviarlo dos veces no puede hacer nada dos veces: un handshake TLS (sin datos 0-RTT), nada en absoluto, o la cabecera de una única petición
GET/HEAD/OPTIONS/TRACE - tres fallos seguidos y un proxy sale de la rotación; cada 5 minutos se vuelven a comprobar y regresan si vuelven a funcionar
--serve-refill 6comprueba proxies nuevos cada 6 horas en segundo plano (la lista en vivo con--recheck live, o si no la última ejecución + historial) con las mismas comprobaciones y filtros, y añade los aciertos: un servidor que lleva días en marcha no se queda sin proxies- escucha solo en
127.0.0.1(salvo que--serve-hostdiga otra cosa), opcionalmente con contraseña; vista en vivo con peticiones, tasa de éxito, pool y las últimas conexiones
En el asistente esto es Servidor proxy al instante.
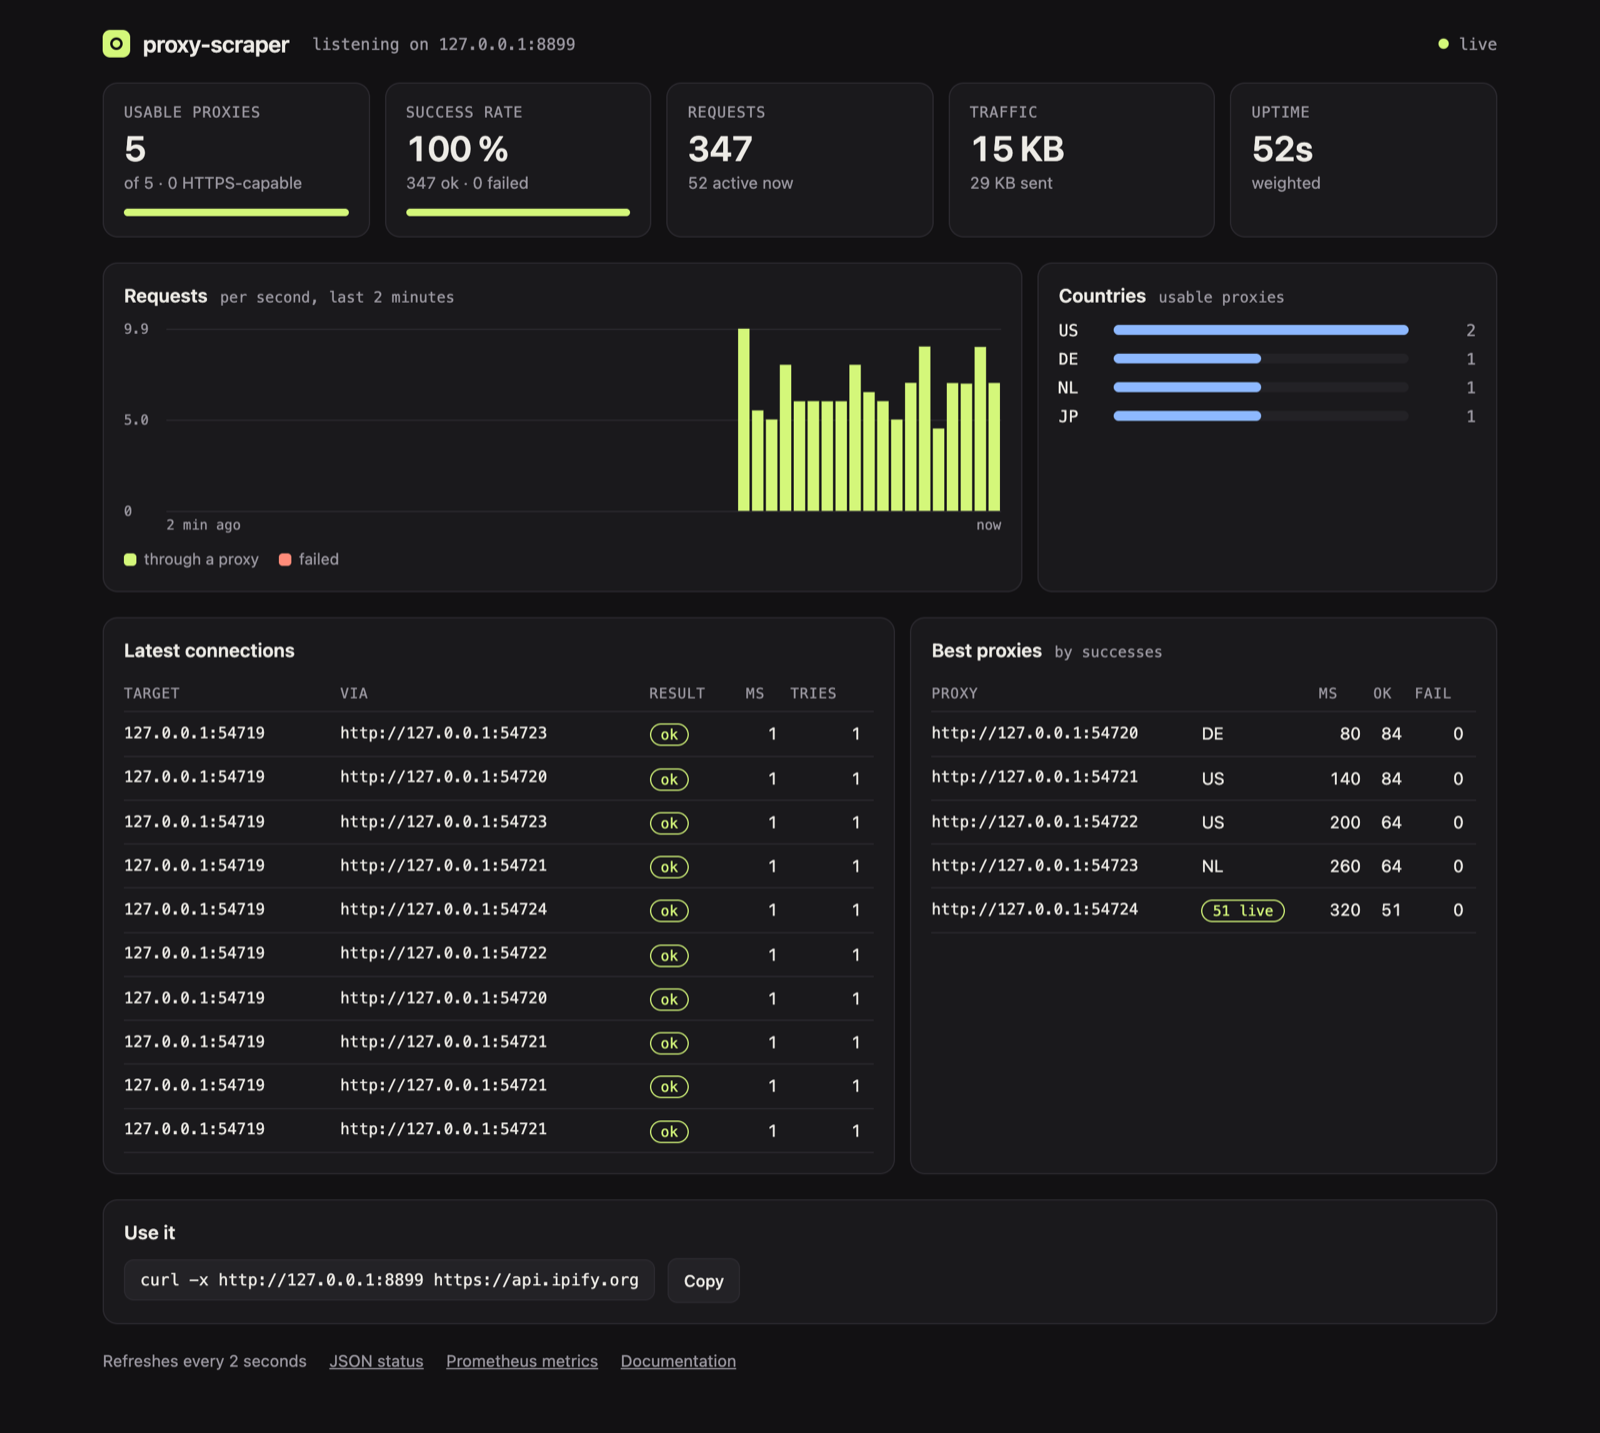
Panel en vivo: abre http://127.0.0.1:8899/__proxy-scraper/ en un navegador: el pool, la tasa de éxito, el tráfico, un gráfico en vivo de peticiones, países, los mejores proxies y las últimas conexiones, actualizado cada dos segundos. No necesita nada de internet, y --serve-password lo protege igual que al resto.
API del pool de proxies
Algunos programas quieren una dirección de proxy, no un proxy: para pasársela a un navegador, a un worker o a una cola. El mismo puerto responde a peticiones HTTP simples con una:
curl http://127.0.0.1:8899/get                          # un proxy en JSON, elegido como se elegiría para una conexión
curl "http://127.0.0.1:8899/get?country=DE&https=1&format=txt"   # → http://203.0.113.7:8080
curl "http://127.0.0.1:8899/all?protocol=socks5&limit=20"        # los 20 mejores proxies SOCKS5
curl "http://127.0.0.1:8899/report?proxy=203.0.113.7:8080&ok=0"  # te falló: a la tercera sale del pool
| Endpoint | Qué hace |
|---|---|
/get |
un proxy, elegido según la estrategia de --rotate |
/pop |
como /get, y el proxy sale del pool |
/all |
todos los proxies utilizables, los mejores primero (limit=N) |
/count |
totales por tipo y país |
/delete?proxy=IP:PORT |
elimina un proxy |
/report?proxy=IP:PORT&ok=0 |
comentarios sobre el resultado de tus propias peticiones |
Los filtros funcionan en /get, /pop y /all: country=DE,AT, protocol=socks5, https=1, anonymity=elite, max_latency=1500, y format=txt para URLs simples. Con --serve-password la API la pide como autenticación Basic, igual que la página de estado.
¿Vienes de jhao104/proxy_pool? Los endpoints, type=https y la mayoría de los campos JSON (proxy, https, region, check_count, fail_count, …) son los mismos, así que apunta tu código al puerto 8899 y casi todo seguirá funcionando (tres diferencias: no existe last_time, anonymous es true/false, no una cadena, y source es siempre proxy-scraper): sin Redis, y con proxies que han superado las comprobaciones de segunda petición, de contenido y de TLS:
import requests
proxy = requests.get("http://127.0.0.1:8899/get?type=https").json()["url"]   # p. ej. socks5://…, con el tipo incluido
requests.get("https://example.com", proxies={"http": proxy, "https": proxy})
Bot de Discord y Telegram
La lista en vivo también puede venir a ti: bot/ es un bot de Discord que publica cada ejecución en un servidor: un resumen con los proxies más rápidos, las listas completas por protocolo como archivos y comandos slash como /proxies type:socks5 country:DE https:true. Configura sus propios canales de solo lectura cuando lo invitas, y una GitHub Action lo despliega en un servidor como servicio de systemd. El mismo proceso responde también en Telegram: /proxy de socks5 para un proxy con una línea de curl, /proxies 10 us https para una lista corta. La configuración está en bot/README.md.
Cómo funciona
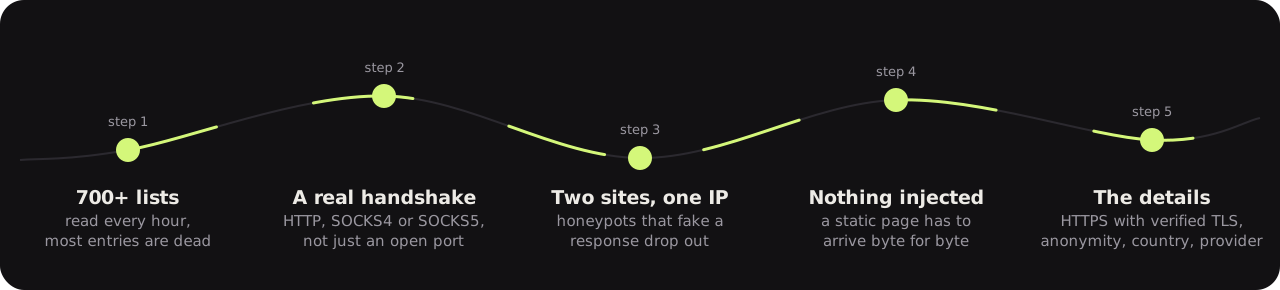
flowchart LR
    A[sources.json<br/>metalistas<br/>descubrimiento en GitHub] --> B[Descargar y analizar<br/>en paralelo en todos los núcleos]
    B --> C[Priorizar<br/>historial → buenas fuentes → resto]
    C --> D[Comprobar<br/>HTTP · SOCKS4 · SOCKS5]
    D --> E[Detalles<br/>HTTPS · anonimato · país]
    E --> F[results/]
    D -. tasa de aciertos por fuente .-> G[(estado aprendido)]
    G -. siguiente ejecución .-> C
- Fuentes: la lista curada en
sources.json, metafuentes (otros proyectos que mantienen listas de fuentes de proxies) y, una vez al día, una búsqueda en GitHub de repositorios mantenidos activamente. Cada búsqueda suma a lo que encontraron las anteriores; una lista que la búsqueda no ha visto en tres semanas se descarta. - Recopilar: se reconocen texto simple, tablas HTML, APIs JSON y líneas
type://ip:port; se descartan los rangos de direcciones privadas y reservadas. Las listas que no han cambiado desde la última ejecución responden304y salen de una caché local: una segunda ejecución justo después de la primera descarga solo lo que cambió (en la ejecución horaria del 10 de noviembre de 2026, 11:22 UTC: 125 MB, con 538 de las 791 listas activas sin cambios). - Priorizar: primero los proxies que se sabe que funcionan, luego según la tasa de aciertos aprendida de sus fuentes.
- Comprobar: cada proxy tiene que obtener su IP de salida de un objetivo de comprobación (
checkip.amazonaws.com, conifconfig.me,ipinfo.io,wtfismyip.comeident.mecomo reserva; ninguno detrás de Cloudflare) y devolver una IP válida y ajena. Si el objetivo se cae a mitad de ejecución, la herramienta cambia de objetivo y vuelve a comprobar los proxies afectados, para que las estadísticas no aprendan de una caída. A los objetivos de las comprobaciones posteriores se les pregunta directamente cuando una comprobación contra ellos falla; si tampoco responden, la comprobación del proxy queda comounavailable, no comofailed. Quien deje pasar tu propia IP queda fuera. Después llega la segunda petición mediantehttpbin.org, que tiene que ver la misma IP de salida: los proxies que solo responden a la primera comprobación con “200 + IP” fallan aquí, igual que los inestables y las salidas que rotan. Por último, una página HTML estática tiene que llegar byte por byte igual que sin proxy. Cada una de ellas deja su resultado en el resultado del proxy. - Países y proveedores: se consultan sin conexión en las bases de datos gratuitas de DB-IP, incluido el proveedor (ASN) y si el nombre del proveedor parece el de una empresa de hosting (entre el 31 % y el 72 % de las entradas en las instantáneas diarias del 27 de septiembre al 10 de noviembre de 2026) (se descargan una vez al mes, ~2 µs por consulta); a ip-api.com solo se le pregunta por las pocas direcciones que no conoce.
- Listas negras: una consulta DNS por IP de salida contra SpamCop, en caché durante la ejecución: entre el 21 % y el 53 % de las entradas de esas mismas instantáneas salían por una IP listada, y los sitios que usan esa lista les muestran captchas o los bloquean.
--no-blocklistedlos descarta. Si SpamCop rechaza tu resolutor DNS (los grandes resolutores públicos lo son), la consulta se omite en lugar de adivinar. - Aprender: se guardan las tasas de aciertos y el historial. Las fuentes sin aciertos, con el contenido sin cambios durante una semana o permanentemente inaccesibles se omiten.
📸 Mira el panel en vivo y el informe final
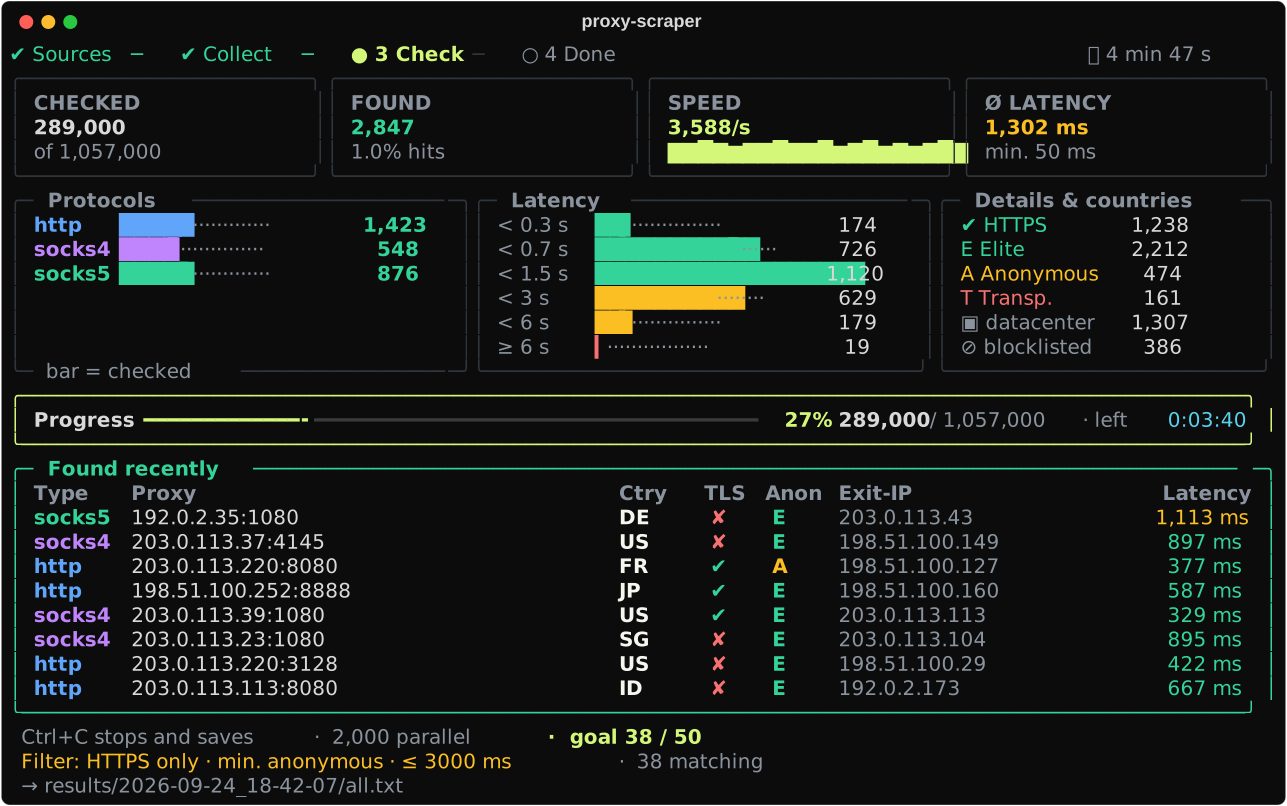
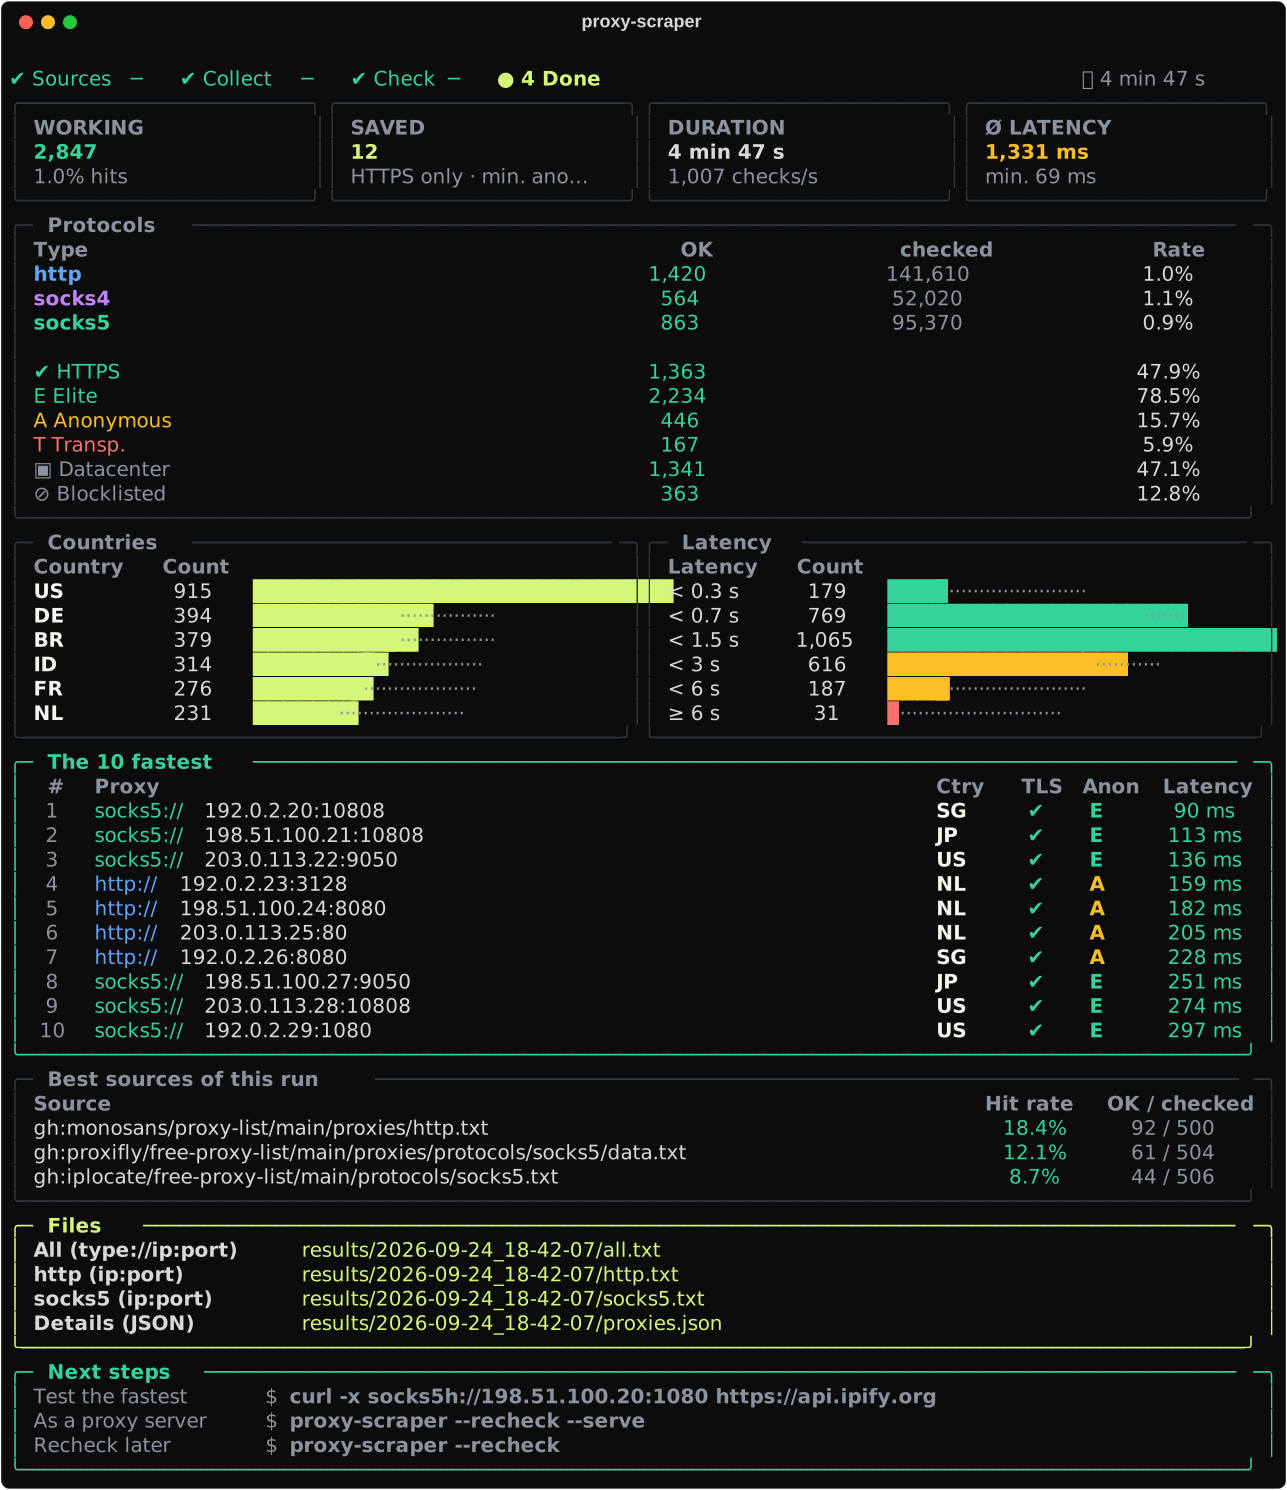 Ilustración: la interfaz real, generada con datos de ejemplo por docs/make_demo.py. Las cifras que aparecen son inventadas.
Tus propias listas
proxy-scraper --source https://example.com/my-list.txt --source socks5=./socks.txt   # además de las fuentes integradas
proxy-scraper --only-sources --source bought.txt --want 50                            # solo las tuyas
Sirve cualquier texto con ip:port; las líneas como socks5://user:pass@host:port conservan su tipo, y las simples se prueban como HTTP y SOCKS5 salvo que escribas http=…. Para credenciales escritas como las exportan muchas listas de pago, ip:port:user:pass, usa --recheck bought.txt o pasa la lista por tubería a --recheck -; las fuentes dejan esa forma sin tocar, ya que listas como ip:port:US:elite tienen el mismo aspecto.
Salida
Cada ejecución tiene su propia carpeta; results/latest.txt siempre indica la más reciente (en macOS/Linux existe además el enlace simbólico results/latest):
results/2026-09-24_18-42-07/
├── all.txt        socks5://203.0.113.10:1080   (el más rápido primero)
├── http.txt       203.0.113.20:8080            (listas ip:port simples por tipo)
├── socks4.txt
├── socks5.txt
├── proxies.json   latencia, país, HTTPS, anonimato, IP de salida
└── proxies.csv
Recetas
Usa el proxy más rápido de la última ejecución: los proxies gratuitos mueren rápido, así que haz primero --recheck si la ejecución tiene más de unos minutos
proxy-scraper --recheck -y
curl -x "$(head -1 results/latest/all.txt)" http://api.ipify.org
Para HTTPS, elige un proxy con "https": true en proxies.json, como hace el ejemplo de Python que sigue.
Python requests (pip install "requests[socks]" para SOCKS)
import json
from pathlib import Path

import requests

run = Path("results") / Path("results/latest.txt").read_text().strip()   # funciona en todos los sistemas operativos
proxies = json.loads((run / "proxies.json").read_text())   # el más rápido primero

for p in proxies:
    if not p["https"]:
        continue
    try:
        r = requests.get("https://api.ipify.org", proxies={"http": p["url"], "https": p["url"]}, timeout=8)
        print(p["url"], "→", r.text)
        break
    except requests.RequestException:
        continue  # los proxies gratuitos van y vienen: simplemente toma el siguiente
httpx (pip install "httpx[socks]"): directamente desde la lista horaria, sin escaneo
import httpx
from proxyscraper import live_proxies

for p in live_proxies(types=["http", "socks5"], https=True, min_uptime=90, limit=10):  # httpx no soporta SOCKS4
    try:
        with httpx.Client(proxy=p.url, timeout=10) as client:
            print(p.url, "→", client.get("https://api.ipify.org").text)
        break
    except httpx.HTTPError:
        continue  # el siguiente
aiohttp (pip install aiohttp aiohttp-socks: aiohttp por sí solo no soporta SOCKS)
import asyncio

import aiohttp
from aiohttp_socks import ProxyConnector, ProxyError
from proxyscraper import live_proxies_async


async def main():
    for p in await live_proxies_async(https=True, min_uptime=90, limit=10):
        try:
            async with aiohttp.ClientSession(connector=ProxyConnector.from_url(p.url)) as session:
                async with session.get("https://api.ipify.org", timeout=aiohttp.ClientTimeout(total=10)) as r:
                    print(p.url, "→", await r.text())
                    return
        except (aiohttp.ClientError, ProxyError, asyncio.TimeoutError, OSError):
            continue  # los proxies gratuitos van y vienen: simplemente toma el siguiente

asyncio.run(main())
Scrapy: un middleware de descarga que envía cada petición, reintentos incluidos, por el siguiente proxy. Scrapy solo habla con proxies HTTP; https=True elige los que pueden tunelizar páginas https://
import itertools

import scrapy
from scrapy.crawler import CrawlerProcess
from proxyscraper import live_proxies

PROXIES = [p.url for p in live_proxies(types="http", https=True, min_uptime=50)]
if not PROXIES:
    raise SystemExit("No proxy matches right now – loosen the filters (e.g. min_uptime)")
POOL = itertools.cycle(PROXIES)


class RotatingProxy:
    def process_request(self, request, spider=None):  # las versiones más recientes de Scrapy omiten spider
        request.meta["proxy"] = next(POOL)


class IpSpider(scrapy.Spider):
    name = "ip"
    start_urls = [f"https://api.ipify.org/?n={i}" for i in range(3)]
    custom_settings = {
        "DOWNLOADER_MIDDLEWARES": {f"{__name__}.RotatingProxy": 350},
        "RETRY_TIMES": 5, "DOWNLOAD_TIMEOUT": 15,
    }

    def parse(self, response):
        print(response.meta["proxy"], "→", response.text)


if __name__ == "__main__":
    process = CrawlerProcess()
    process.crawl(IpSpider)
    process.start()
En un proyecto de Scrapy, pon RotatingProxy en middlewares.py y añádelo a DOWNLOADER_MIDDLEWARES en settings.py. Para rastreos largos, recarga el pool de vez en cuando: la lista cambia cada hora.
proxychains, Clash / Mihomo, sing-box: configuraciones listas para usar con --export
proxy-scraper --want 30 -y --export proxychains,clash,singbox
proxychains4 -f results/latest/proxychains.conf curl https://api.ipify.org
clash.yaml contiene todos los proxies HTTP y SOCKS5 más un grupo url-test que siempre elige el más rápido. singbox.json hace lo mismo para sing-box, SOCKS4 incluido, y abre un proxy local: sing-box run -c results/latest/singbox.json, y luego usa 127.0.0.1:2080 como proxy HTTP o SOCKS5. Los tres omiten los proxies HTTP que no pueden tunelizar (CONNECT), porque estas herramientas tunelizan todo.
Navegadores y el sistema operativo: --export pac escribe proxy.pac; apunta hacia él Firefox, Chrome (mediante la configuración del sistema), FoxyProxy o la configuración de proxy de macOS/Windows y cada petición pasará por los mejores 30 proxies HTTP y SOCKS5 por orden, y el navegador pasará al siguiente por sí solo cuando uno falle. Los nombres locales y las direcciones IP privadas van directos (un nombre de host como 10.example.com no cuenta como privado). El archivo en sí no tiene respaldo DIRECT y no resuelve nombres de host, y SOCKS4 queda fuera porque haría que el navegador resolviera los nombres con tu propio DNS. Dos ajustes de Firefox importan: activa Proxy DNS when using SOCKS v5 y pon network.proxy.failover_direct en false en about:config; de lo contrario Firefox va directo cuando todos los proxies han fallado. Sin instalar nada: la lista en vivo publica uno cada hora en https://proxy-scraper.de/proxy.pac.
Burp Suite, OWASP ZAP, mitmproxy: pon el servidor rotativo detrás de tu proxy de interceptación, de modo que un escaneo o una prueba de fuerza bruta salga desde muchas IP mientras sigues viendo cada petición. Inícialo con proxy-scraper --recheck live --serve y luego:
| Herramienta | Dónde | Configurar |
|---|---|---|
| Burp Suite | Settings → Network → Connections → Upstream proxy servers | una regla para el host de destino *, host del proxy 127.0.0.1, puerto 8899; con --serve-password añade autenticación Basic (usuario any o una opción como country-de, y la contraseña) |
| OWASP ZAP | Options → Network → Connection → HTTP Proxy | host 127.0.0.1, puerto 8899, y en su autenticación el usuario (any o una opción) y la contraseña; usa el ajuste HTTP, no SOCKS: ZAP nunca envía las direcciones loopback por su proxy SOCKS |
| mitmproxy | línea de comandos | mitmproxy --mode upstream:http://127.0.0.1:8899 --upstream-auth country-us:x |
Las opciones en el nombre de usuario (country-us envía todo por proxies de EE. UU., session-NAME mantiene una misma IP de salida durante un flujo de inicio de sesión) llegan al servidor como el login del proxy. mitmproxy lo envía de inmediato; Burp y ZAP pueden esperar a que se les pida, así que inicia el servidor con --serve-password cuando dependas de una opción así en ellos. Mantén activadas las comprobaciones de certificados upstream de tu herramienta (sin --ssl-insecure en mitmproxy, sin “ignorar errores de certificado” upstream en Burp o ZAP): los proxies gratuitos los gestionan desconocidos, y esa comprobación es lo que impide que uno lea o modifique tu tráfico HTTPS. Probado de extremo a extremo con mitmproxy 12, con las comprobaciones de certificados activadas: HTTP y HTTPS a través de mitmproxy y del servidor rotativo, cada petición saliendo por un proxy de EE. UU., y un sitio con un certificado caducado rechazado. Prueba solo lo que tengas permiso para probar.
En una tubería: -o - imprime los aciertos en stdout, y la interfaz pasa a stderr
proxy-scraper --recheck live --want 20 -y -o - | grep '^socks5://' > socks.txt
Comprueba una lista que ya tienes: --recheck - la lee de stdin: líneas ip:port simples, type://ip:port, credenciales (user:pass@ip:port o ip:port:user:pass), JSON, una exportación CSV o una tabla pegada de un sitio web (HTML o Markdown), en el orden en que llegó. Solo sale lo que funciona desde tu red:
curl -s https://example.com/proxies.txt | proxy-scraper --recheck - -o - > working.txt
Los proxies sin tipo se prueban como HTTP y como SOCKS5, o solo como SOCKS4 con --types socks4. Una contraseña con coma, comillas, | o corchete no se puede distinguir del texto que la rodea en un pegado; pon esos proxies en un archivo, uno por línea, y usa --recheck file.txt.
Cualquier herramienta, a través del servidor rotativo
proxy-scraper --recheck --serve &
export HTTPS_PROXY=http://127.0.0.1:8899 HTTP_PROXY=http://127.0.0.1:8899
pip download requests   # git, pip, npm y compañía ahora pasan por el pool
En un workflow de GitHub: la action elige proxies que funcionan para los pasos siguientes
- id: proxies
  uses: maximilianfeix/proxy-scraper@v1
  with:
    types: socks5
    https: true
    min-uptime: 90        # en la lista el 90 % o más de la semana
    min-speed: 100        # opcional: descargó 100+ KB/s en la última comprobación
    works-on: google      # opcional: google, reddit, amazon, instagram, tiktok, discord
    recheck: true         # opcional: volver a comprobarlos desde el runner
- run: curl -x "${{ steps.proxies.outputs.proxy }}" https://api.ipify.org
proxy es el más rápido, file un archivo de texto con todos (hasta limit, por defecto 20) y count cuántos hay. Si no hay coincidencias el paso falla, salvo con fail-if-empty: false.
En el shell, sin escaneo: --pick toma proxies de la lista horaria en aproximadamente medio segundo
curl -x "$(proxy-scraper --pick --https-only --min-uptime 90)" https://api.ipify.org
proxy-scraper --pick 10 --country DE --works-on google > de.txt
proxy-scraper --pick 5 --min-speed 200     # solo los que descargaron 200+ KB/s
“El más rápido primero” significa el primero en responder más la velocidad de descarga medida en la última comprobación: en una prueba con páginas reales, los 25 más rápidos en descarga cargaron cuatro veces más páginas que los 25 más rápidos en responder a una petición minúscula.
Sin instalar nada: directamente desde la lista en vivo
curl -s https://raw.githubusercontent.com/maximilianfeix/proxy-scraper/proxy-list/https.txt | head -5
Los fragmentos de shell son para macOS y Linux, donde results/latest apunta a la ejecución más reciente. En Windows, results/latest.txt contiene en su lugar el nombre de la carpeta; en PowerShell:
$run = "results\$(Get-Content results\latest.txt)"
curl.exe -x (Get-Content "$run\all.txt" -TotalCount 1) http://api.ipify.org
Opciones
Mostrar todas las opciones
| Opción | Descripción |
|---|---|
-i, --interactive |
asistente de configuración (se muestra automáticamente sin argumentos) |
-y, --yes |
empieza de inmediato sin el asistente |
--types http socks5 |
solo estos protocolos |
-l, --limit N |
comprueba solo los N proxies más prometedores |
--want N |
se detiene en cuanto se encuentran N proxies que cumplen |
--country DE,AT |
solo estos países |
--https-only |
solo proxies que pueden tunelizar HTTPS |
--anonymity elite |
anonimato mínimo (anonymous o elite) |
--max-latency MS |
latencia máxima |
--no-datacenter |
omite proxies cuya salida está (probablemente) en un datacenter: esos se bloquean antes |
--no-blocklisted |
omite proxies cuya IP de salida está en la lista negra de SpamCop: esos suelen recibir captchas |
--no-dnsbl |
omite la consulta de listas negras |
--target URL |
solo proxies que llegan a este sitio (repetible) |
--recheck [FILE|URL|-|live] |
comprueba solo proxies de un archivo, de una URL, de stdin (-), de la última ejecución o de la lista pública en vivo |
--fast |
omite la prueba HTTPS (la confirmación y el anonimato se siguen ejecutando) |
--no-geo |
omite la consulta de país |
-c, --concurrency N |
comprobaciones simultáneas (por defecto: 2000) |
-t, --timeout S |
tiempo de espera por proxy (por defecto: 8 s) |
--connect-timeout S |
tiempo máximo para la conexión TCP (por defecto: 4 s) |
--discover |
busca nuevas fuentes en GitHub ahora mismo |
--no-discover |
sin búsqueda automática en GitHub |
--discover-repos N |
como máximo N repositorios por búsqueda (por defecto: 400, 40 sin token) |
--all-sources |
carga también las fuentes omitidas por muertas, desactualizadas o inaccesibles |
--source URL|FILE |
carga además esta lista (repetible); socks5=… fija el tipo, véase tus propias listas |
--only-sources |
solo las listas indicadas con --source |
--no-cache |
descarga de nuevo todas las listas (las que no han cambiado normalmente se omiten mediante ETag) |
--list-sources [N] |
muestra el ranking de fuentes (añade --json para scripts: url, estado, tasa de aciertos, comprobaciones, último cambio) |
--pick [N] |
imprime N proxies (por defecto 1) de la lista horaria ya comprobada y sale: sin escaneo, mismos filtros, más --min-uptime PERCENT, --min-speed KBPS y --works-on google,reddit,… |
--verify |
con --pick: comprueba primero los candidatos desde tu máquina e imprime solo los que superan las comprobaciones ahora: 5 candidatos por cada proxy pedido (de 10 a 60), hasta 8 a la vez, 90 s como máximo; código de salida 3 si las superaron menos de N |
--diagnose PROXY |
comprueba un proxy y muestra qué encontró cada comprobación, estado por estado; código de salida 0 si no falló nada, 1 si falló una comprobación, 3 si una comprobación no pudo ejecutarse |
--json |
con --pick o --diagnose (y --list-sources): el resultado como JSON por stdout |
--serve-host ADDR |
dónde escucha el servidor proxy (por defecto 127.0.0.1; cualquier otra dirección necesita contraseña o --serve-open) |
--serve-password SECRET |
los clientes deben enviar esta contraseña en el login del proxy; mejor define PROXY_SCRAPER_SERVE_PASSWORD |
--serve-open |
permite --serve-host sin contraseña: solo detrás de un cortafuegos o con docker -p 127.0.0.1:… |
--rotate STRATEGY · --sticky SEC |
cómo elige proxies el servidor proxy, véase arriba |
--serve-refill HOURS |
mientras sirve, comprueba proxies nuevos cada HOURS y añade los aciertos al pool |
--serve [PORT] |
después sirve como proxy rotativo en 127.0.0.1:PORT (por defecto: 8899) |
-o FILE |
escribe además todos los aciertos en este archivo; -o - los imprime en stdout |
--export FORMATS |
archivos adicionales para otras herramientas: proxychains, clash, singbox, curl, pac, proxifier o all |
-V, --version |
imprime la versión |
--mcp |
se ejecuta como servidor MCP por stdio, igual que proxy-scraper-mcp (MCP) |
--completion SHELL |
imprime el script de autocompletado para bash, zsh, fish o PowerShell |
Todo lo demás: proxy-scraper --help
[!TIP] Para la búsqueda en GitHub basta con un
ghcon la sesión iniciada o la variable de entornoGITHUB_TOKEN. Sin token el límite de la API es de 60 peticiones por hora, y solo se buscan 40 repositorios.
GitHub Actions
El repositorio hace parte del trabajo por sí mismo:
| Workflow | Qué hace |
|---|---|
| tests | 3 sistemas operativos × 4 versiones de Python, más un paquete compilado e instalado, en cada push y pull request |
| lint | ruff con versión fijada: mismas reglas en local y en CI |
| codeql | análisis de seguridad en cada push a main, en cada pull request y una vez por semana |
| proxy list | más o menos cada hora: recopila, comprueba, publica en proxy-list, sube el sitio web a proxy-scraper.de y copia las listas a free-proxy-list. Las estadísticas aprendidas viven en la caché de Actions, así que la herramienta sigue mejorando también en la nube |
| docker | construye la imagen en cada cambio y ejecuta un escaneo real dentro de ella; con una etiqueta de versión publica linux/amd64 + linux/arm64 en ghcr.io |
| release | con una etiqueta de versión: prueba, compila, hace un smoke test y publica una release de GitHub con el wheel |
| discord bot | prueba el bot y lo despliega en el servidor en cada cambio en bot/ |
| live smoke | una vez al día: la GitHub Action y unos pocos proxies reales contra la lista en vivo, sin bloquear pull requests |
| scorecard | OpenSSF Scorecard una vez por semana |
| hf-rebuild | a mano: regenera todos los archivos Parquet del dataset de Hugging Face a partir de las instantáneas |
| Dependabot | mantiene al día las versiones de las actions, las dependencias de Python y la imagen base de Docker |
Preguntas frecuentes
¿Quién gestiona los proxies gratuitos y deberías usarlos?
Casi nadie gestiona un proxy gratuito para ti. Lo que acaba en las listas públicas suele ser una de estas cosas:
- Servidores mal configurados: un Squid, un router o una aplicación con un puerto de proxy que debía permanecer interno.
- Proxies abiertos deliberadamente: unos pocos voluntarios y proyectos de investigación, y servicios que regalan algunos para vender el resto.
- Máquinas infectadas: equipos y dispositivos IoT cuyos dueños no saben que retransmiten tráfico. Muchas salidas residenciales son así.
- Trampas: proxies montados para registrar lo que pasa por ellos, y proxies que reescriben las páginas para añadir anuncios o scripts.
Esto es contexto general, no algo que este proyecto haya medido: una comprobación no puede ver quién gestiona un proxy ni por qué.
proxy-scraper no puede distinguir un router doméstico infectado de un proxy abierto de oficina, pero filtra lo que puede medir: un proxy tiene que responder a dos peticiones independientes con la misma IP de salida, entregar una página conocida byte por byte, y HTTPS solo cuenta con un certificado que se verifica para el host de prueba. Cada acierto indica si su salida está en un datacenter.
Buenos usos: datos públicos, comprobar cómo se ve un sitio desde otro país, probar tus propios bloqueos y límites de tasa, investigación. Nunca envíes contraseñas, cookies, datos de pago ni datos personales a través de un proxy gratuito, y mantén activadas las comprobaciones de certificados HTTPS. Úsalos solo donde tengas permiso.
Casi nada pasa las comprobaciones.
Muchas redes de empresas, colegios y universidades bloquean las conexiones de proxy. La herramienta detecta una tasa de aciertos por debajo del 0,2 % y te avisa: ayuda cambiar a otra red, como el punto de acceso de un teléfono. Las estadísticas aprendidas no se rebajan en una ejecución así.
¿Funciona en Windows?
Sí, en PowerShell y Windows Terminal. uvloop no existe allí y se omite automáticamente. En la antigua ventana de cmd.exe pueden faltar algunos símbolos según la fuente.
¿Por qué encuentra menos proxies de los que dicen tener otras listas?
Porque solo se conservan los proxies que superan todas las comprobaciones: dos peticiones independientes que muestran la misma IP de salida ajena, y una página de prueba que llega sin cambios. En las ejecuciones horarias eso es bastante menos del 1 % de los 150.000 candidatos comprobados (entre el 0,2 % y el 1,3 % por ejecución del 3 al 10 de noviembre de 2026; la cifra actual es total en stats.json). Las superaron desde la red que los comprobó, en ese momento.
¿Y los proxies con usuario y contraseña?
Las líneas como socks5://user:[email protected]:1080 conservan sus credenciales: los proxies HTTP reciben una cabecera Proxy-Authorization, SOCKS5 usa autenticación de usuario/contraseña (RFC 1929) y SOCKS4 el ID de usuario. Lo mismo funciona con --recheck y tu propia lista. Los archivos de resultados conservan las credenciales; el terminal solo muestra user:•••.
¿Con qué frecuencia se actualiza la lista en vivo?
Se reconstruye más o menos cada hora; la insignia “actualizado” muestra la última ejecución. Los proxies gratuitos van y vienen rápidamente, así que para cualquier cosa importante ejecuta proxy-scraper --recheck justo antes de usarlos.
¿Es seguro usar proxies gratuitos?
Solo para cosas que no importan. Los proxies públicos los gestionan desconocidos que pueden leer todo lo que no esté cifrado. Nunca envíes contraseñas ni datos personales a través de ellos, y úsalos solo con fines legales.
Hoja de ruta
Lo que viene está en las issues abiertas; las ideas y deseos son bienvenidos como issue. Durante Hacktoberfest hay issues aptas para principiantes con indicaciones de por dónde empezar.
Publicado de la v1.24 a la v1.26: --recheck - para listas que pasas por tubería, qué proxies llegan a Discord, un README que puedes probar en cinco segundos, el servidor MCP en la imagen de Docker, credenciales escritas como ip:port:user:pass y un dataset de Hugging Face que se carga en una línea.
Publicado en v1.22 y v1.23: un panel en vivo para el servidor rotativo, --export pac y un proxy.pac horario, un «mejor primero» que cuenta la probabilidad de que un proxy siga activo, las listas en un repositorio propio (free-proxy-list), snapshots diarios en Hugging Face, brew install, un README en chino, Python 3.14 y una receta para Burp Suite, ZAP y mitmproxy.
Publicado en v1.10 a v1.21: velocidad de descarga por proxy y «mejor primero» en todas partes, snapshots diarios, una URL de proxy rotativo para requests, httpx y Playwright, --pick para obtener proxies que funcionan sin escaneo, una API de pool de proxies compatible con jhao104/proxy_pool, tus propias listas con --source, una GitHub Action, un bot de Telegram y un feed Atom para el informe semanal.
Publicado en v1.8 y v1.9: uptime por proxy y stable.txt, qué proxies llegan a Google, Reddit y Amazon, live_proxies() en Python, una página por proxy con su semana de comprobaciones, un informe semanal, gráficos en vivo en este README, filtros que se pueden compartir en el sitio web, fuentes extraídas de las listas de otros scrapers, listas sin tipo probadas como HTTP y SOCKS5, --export singbox, autocompletado para PowerShell y recetas para httpx, aiohttp y Scrapy.
Publicado en v1.7: un servidor MCP para que los agentes de IA obtengan proxies que funcionan y puedan cargar páginas a través de ellos, 28 fuentes nuevas y una búsqueda en GitHub que se ejecuta a diario y conserva lo que encontró, y un sitio web más limpio.
Publicado en v1.6: comprobación de listas negras de spam para cada IP de salida, una lista en vivo actualizada cada hora, páginas por protocolo y país, una contraseña opcional para el servidor proxy y un pool que se rellena solo mientras funciona, compose.yaml, -o - para tuberías, un bot de Discord, y un sitio web y un README nuevos: todo en inglés a partir de entonces (el README original).
Publicado en v1.5: comprobación de manipulación de contenido, sitio web de la lista en vivo con tendencia y proxies estables, información de proveedor/datacenter, un servidor proxy mucho más completo (estrategias de rotación, sesiones sticky, entrada SOCKS5, estado y métricas de Prometheus), --recheck live, API de Python, autocompletado de shell. Medido y descartado antes: la detección de protocolo con una conexión adicional (#3) e IPv6 (#1).
Contribuir
Los informes de errores, las nuevas fuentes y los pull requests son muy bienvenidos: consulta CONTRIBUTING.md, y docs/ARCHITECTURE.md para ver cómo encajan las piezas. La versión corta:
pip install -e ".[dev]"
python3 -m pytest          # se ejecuta sin conexión: proxies falsos en localhost
ruff check .
python3 docs/make_demo.py  # regenera las imágenes de este README
Estructura del proyecto
proxy_scraper.py        punto de entrada al ejecutar desde un clon
bot/                    bot de Discord para la lista en vivo (requisitos propios, desplegado con GitHub Actions)
proxyscraper/
├── cli.py              argumentos, asistente o inicio directo
├── app.py              una ejecución en fases: red → trabajos → comprobación → aprendizaje e informe
├── options.py          RunOptions + Filters: todos los ajustes en un solo lugar
├── pipeline.py         recopilar fuentes, priorizar, bucle de comprobación
├── checker.py          las comprobaciones: básica, segunda petición, contenido, HTTPS
├── handshake.py        handshakes HTTP/SOCKS4/SOCKS5 incluido el login
├── judges.py           objetivos de comprobación, filtro de Cloudflare, conmutación por error
├── sources.py          listas de fuentes, metafuentes, descubrimiento en GitHub, estadísticas
├── sources.json        fuentes curadas
├── fetchcache.py       caché ETag para listas sin cambios
├── parsing.py          encontrar proxies en texto, HTML y JSON
├── history.py          historial de proxies que funcionan
├── geo.py              países: primero sin conexión, ip-api.com como respaldo
├── asndb.py            base de datos de proveedores de DB-IP, heurística de datacenter
├── geodb.py            base de datos de países de DB-IP (mensual, búsqueda binaria)
├── targets.py          sitios objetivo para --target
├── output.py           archivos de resultados
├── exporters.py        formatos proxychains, Clash, sing-box, curl, PAC y Proxifier (--export)
├── server/             servidor proxy rotativo (--serve): pool · http · upstream · socks · status · api · core
├── api.py              find_proxies() / check_proxies() para Python
├── agent.py            herramientas MCP sin el SDK: lista en vivo, filtros, descarga a través de proxies
├── mcp_server.py       servidor MCP (proxy-scraper-mcp) para agentes de IA
├── publish.py          lista en vivo para GitHub Actions
├── mirror.py           las mismas listas en su propio repositorio (free-proxy-list)
├── paths.py            dónde se guardan el estado y los resultados
├── compat.py           diferencias entre Unix y Windows
├── netio.py            pequeño cliente HTTP sobre asyncio
└── ui/                 widgets · dashboard · report · wizard · serve · keys
Comunidad
Las preguntas, ideas y lo que hayas construido con ella van a Discussions; los errores, a las issues. Si proxy-scraper te ahorra tiempo, una ⭐ ayuda a que otros lo encuentren.
Gracias a todos los que ayudaron a construirlo: nuevas fuentes, países, Python 3.14, ejemplos y más:
¿Quieres unirte? Las issues aptas para principiantes indican por dónde empezar.
Agradecimientos
proxy-scraper se apoya en el trabajo de quienes publican listas de proxies gratuitos. Gracias a todos los que aparecen en sources.json, y en especial a
- monosans/proxy-scraper-checker y gfpcom/free-proxy-list, cuyas colecciones curadas de fuentes se leen como metafuentes
- Textualize/rich, que dibuja toda la interfaz de terminal
- IP Geolocation by DB-IP: la base de datos gratuita de países (CC BY 4.0) usada para las consultas de país sin conexión
- httpbin, checkip.amazonaws.com, ifconfig.me, ipinfo.io, wtfismyip.com, ident.me e ip-api.com, usados como objetivos de comprobación y para las consultas de país, y speed.cloudflare.com para la velocidad de descarga
Aviso legal
Esta herramienta solo recopila proxies listados públicamente y comprueba si funcionan. Tú eres responsable de cómo los uses: respeta los términos de los sitios que visitas y las leyes del lugar donde vives.
Hecho en Alemania por @maximilianfeix · Licencia MIT · Changelog · Seguridad · Contribuir
Si proxy-scraper te ahorra tiempo, una ⭐ ayuda a que otros lo encuentren.