
libredb/libredb-studio
libredb/libredb-studio has 1,322 GitHub stars and 271 forks. GitHot measured +1 stars in 24 hours and +10 in 7 days. Last checked 2026-11-09 02:19 UTC. Last push 2026-11-01.
One browser tab for PostgreSQL, MySQL, Oracle, SQL Server, MongoDB, Redis, SQLite, Couchbase, ClickHouse, Druid, DuckDB, Turso and more. An open-source SQL IDE with SSO, audit trail and AI-assisted queries MIT licensed, with nothing held back behind an enterprise wall.
Crecimiento de estrellas medido
- in 24h
- +1
- in 7 days
- +10
- in 15 days
- Recopilando historial
- in 1 month
- Recopilando historial
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
README_es.md
Original

LibreDB Studio
El editor de bases de datos que se despliega junto a tus datos, no dentro de tu laptop.
English · 简体中文 · 日本語 · Español · اردو · हिन्दी · 한국어 · Português (Brasil) · Русский
Listado por el proyecto PostgreSQL: News · PostgreSQL Clients · Software Catalogue · Community Guide to GUI Tools · Design Tools
Listado también en la documentación oficial de Oracle, MySQL, Redis, Valkey, ClickHouse Visual Interfaces, ClickHouse SQL Clients, MariaDB Graphical Clients, MariaDB Ecosystem Hub, Trino, YugabyteDB, TimescaleDB, DragonflyDB, Garnet, OpenSearch, DuckDB, StarRocks, Databend, Aiven for PostgreSQL, Aiven for MySQL, ScyllaDB, Couchbase, etcd, Apache Cloudberry, Apache Doris, Apache Kafka, Apache Cassandra, Apache Druid y Oxia
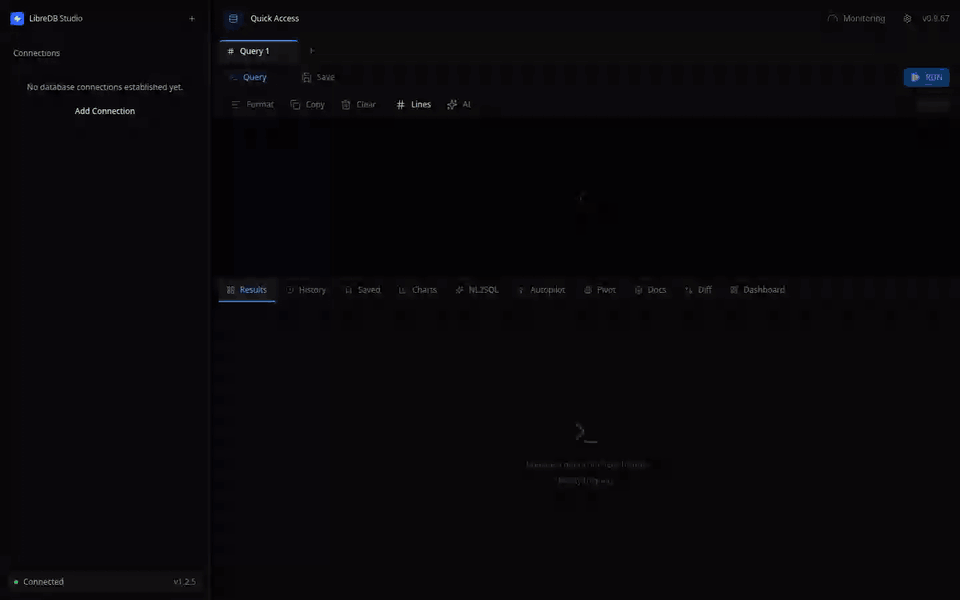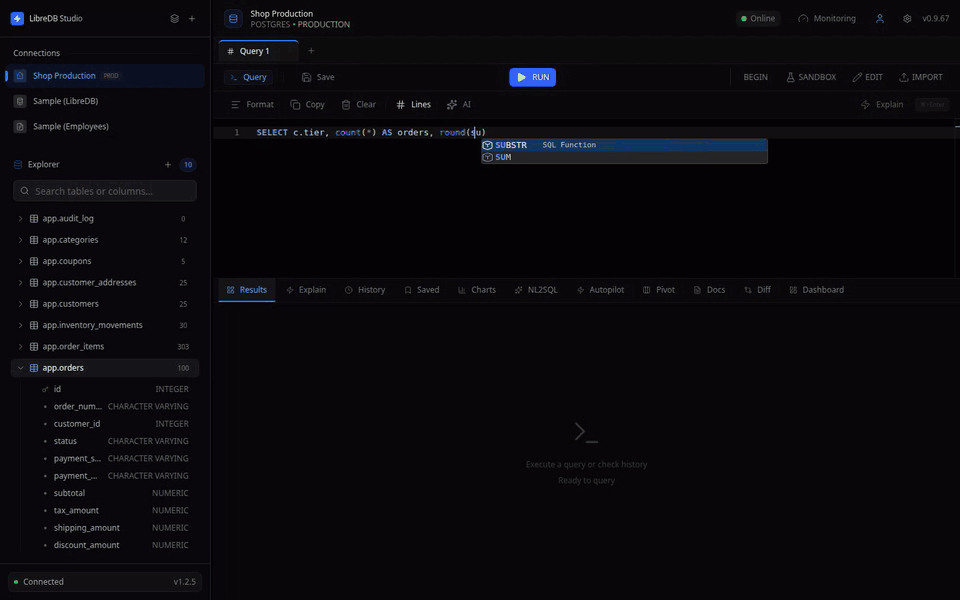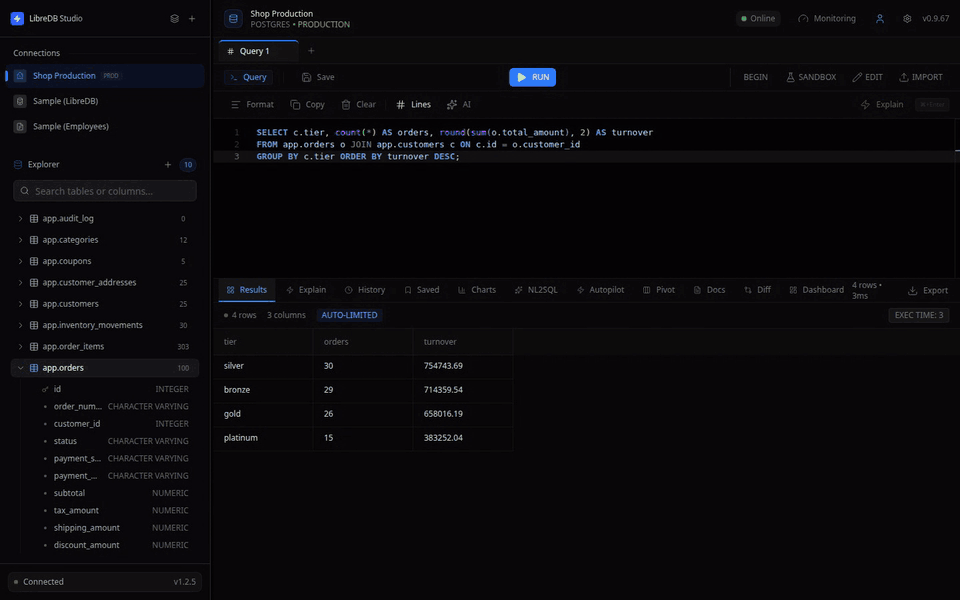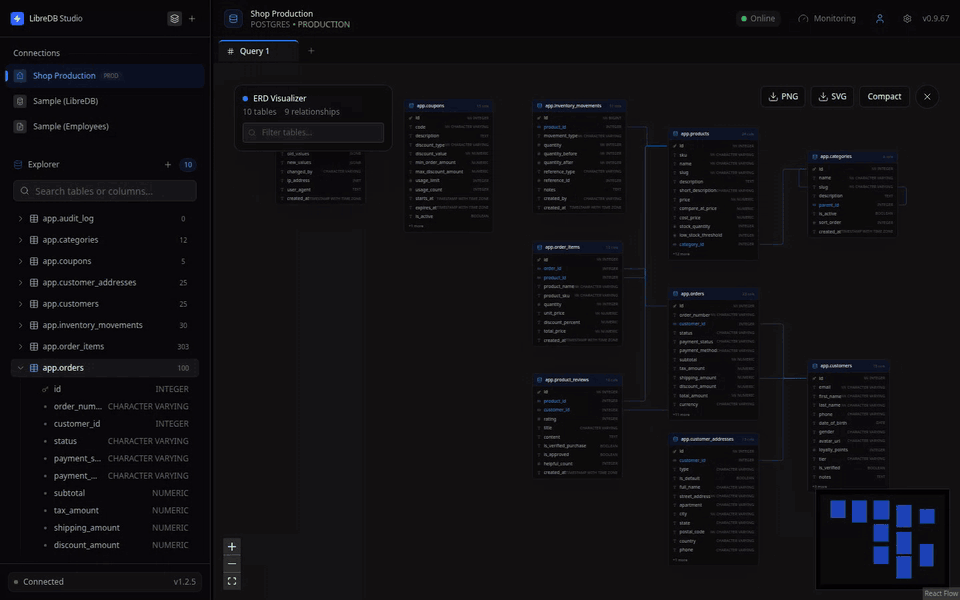




Quick Start • Live Demo • Install Options • Deploy Your Own
Este README en español es una traducción de la comunidad y puede ir por detrás del inglés. Si difieren, manda la versión en inglés.
Inicio rápido
Un IDE SQL completo con un solo comando: sin clonar, sin compilar.
# Docker (recomendado)
docker run -p 3000:3000 ghcr.io/libredb/libredb-studio:latest

# o con Node.js 24+ (sin Docker)
npx @libredb/studio
Luego abrí http://localhost:3000. En el primer arranque la contraseña de administrador se imprime en el log, sin ningún archivo de configuración.
Si el navegador no entra por localhost ni por HTTPS (por ejemplo
http://192.168.x.x:3000en la red local), hay que agregarAUTH_COOKIE_SECURE=false. Si no, el health check pasa sin problemas pero el login falla en silencio y vuelve a la pantalla de inicio de sesión una y otra vez.
¿Necesitás Helm, Homebrew, Snap, winget o deb/rpm? Ver Instalación más abajo.
Por qué otra herramienta de bases de datos
Creás un Postgres en una plataforma administrada y está listo en cuarenta segundos.
Después querés ver qué hay adentro. Entonces exponés un puerto a internet, o instalás un cliente de escritorio y cavás un túnel SSH, o te rendís y volvés a la línea de comandos. La base de datos tardó cuarenta segundos; abrirle una ventana te costó la tarde.
Ahora multiplicá eso por escala. La aplicación usa Postgres, los documentos van en Mongo, el caché en Redis, los eventos en ClickHouse. Cuatro bases, cuatro clientes, cuatro juegos de credenciales. El lunes entra alguien nuevo y, antes de escribir su primera línea de código, tiene que averiguar qué dato vive dónde, buscar cadenas de conexión en la wiki y en tres chats privados, esperar el acceso a la VPN, e instalar una herramienta distinta por cada motor.
Las bases de datos ya se mudaron. Se fueron a Kubernetes, a nubes administradas, a VPC de clientes a las que solo se llega cruzando un bastión. Pero las herramientas para leerlas no se mudaron con ellas. Siguen siendo aplicaciones de escritorio: pesadas, con licencia por asiento, que hay que instalar antes de usar, y que asumen que tenés una sola base, una sola laptop y una persona que nunca cambia de equipo.
LibreDB Studio va por el otro camino: la herramienta va hacia los datos, en lugar de traer los datos hacia la herramienta.
Tomada en serio, esa frase deja de ser una preferencia y se vuelve una especificación.
- El editor tiene que correr en el navegador, porque los datos no están en tu máquina y tus compañeros tampoco.
- Tiene que abrirse en el teléfono, porque la falla que necesita una consulta no espera a que enciendas la laptop.
- Tiene que desplegarse como infraestructura (contenedor, Helm chart, Operator, plantilla de un clic), porque así se instala todo lo que vive junto a una base de datos.
- Tiene que poder incrustarse, porque el lugar más útil para un editor es dentro del producto que creó la base.
- No puede reservarse nada. No podés meter una herramienta con licencia por asiento y funciones escalonadas en cada entorno que administrás. Si el inicio de sesión único cuesta extra, la herramienta deja de ser desplegable por defecto.
MIT no es generosidad acá: es un requisito duro de esta arquitectura.
Capacidades principales
Cuarenta y dos motores, una sola interfaz
PostgreSQL · MySQL · Oracle · Db2 LUW · SQL Server · SQLite · libSQL · DuckDB · MongoDB · Redis · Couchbase · Firestore · ClickHouse · Apache Druid · Elasticsearch · OpenSearch · Trino · BigQuery · Databend · Snowflake · Apache Spark · Apache Cassandra · Prometheus · Apache Kafka · etcd · Neo4j · Milvus · Qdrant · Weaviate · InfluxDB (InfluxQL) · InfluxDB 3 (SQL) · Oxia · S3-compatible object storage · Kubernetes · MQTT · RabbitMQ · OPC UA · MTConnect · Modbus · NETCONF · SNMP · Sparkplug B
Todos los motores SQL comparten el mismo explorador de esquemas, los diagramas ER, la comparación de esquemas y los paneles de monitoreo. MongoDB y Redis no son motores SQL: no tienen diagrama ER ni comparación de esquemas. Druid, Elasticsearch, OpenSearch y Trino son doblemente excepcionales: sus interfaces SQL sobre HTTP no tienen una forma de URI que este build sepa interpretar, así que se configuran por host y puerto, y las migraciones que se generan explican la limitación en lugar de inventar DDL para un motor cuyo SQL no tiene sentencias de cambio de columna. Lo mismo pasa con las colecciones sin esquema de Couchbase. El diagrama ER de los clústeres de búsqueda tiene cajas pero no líneas: los índices no declaran claves foráneas, y en el modelo del motor no hay ninguna que declarar.
| Base de datos | Driver | Capacidades |
|---|---|---|
| PostgreSQL | pg |
IDE SQL completo, planes de ejecución EXPLAIN, transacciones, cancelación de consultas (pg_cancel_backend) |
| MySQL | mysql2 |
IDE SQL completo, EXPLAIN, transacciones, cancelación de consultas (KILL QUERY) |
| Oracle | oracledb (modo Thin) |
IDE SQL completo, paginación con FETCH FIRST N ROWS, vistas de monitoreo V$, ANALYZE TABLE, ALTER INDEX REBUILD, transacciones |
| Db2 LUW | db2-node (un cliente DRDA escrito en Rust mediante un complemento nativo N-API, sin necesidad del cliente de IBM) |
IDE SQL para Db2 en Linux, UNIX y Windows: explorador de esquemas con tablas, vistas, tablas de consultas materializadas, alias, secuencias, módulos, rutinas y triggers, definiciones almacenadas, paginación con FETCH FIRST / OFFSET, ejecución de RUNSTATS y REORG por tabla, edición en línea e importación en tablas existentes. TLS es obligatorio, a menos que se desactive expresamente, porque sin él la contraseña se transmite por la red sin cifrar. Los valores asignados a columnas CLOB, DBCLOB o BLOB grandes no se guardan y no se muestra ningún error; por eso, la vista previa de la tabla omite esas columnas y no permite editarlas. Las opciones Create Table, EXPLAIN, transacciones y cancelación no están disponibles. Los problemas conocidos se describen en docs/providers/db2.md |
| SQL Server | mssql (tedious) |
IDE SQL completo, paginación con TOP N / OFFSET FETCH, DMV sys.dm_*, UPDATE STATISTICS, DBCC CHECKDB, transacciones, detección automática de Azure SQL |
| SQLite | bun:sqlite / node:sqlite (según el runtime) |
IDE SQL completo, sobre archivo o en memoria |
| libSQL | Sin driver, HTTP puro (protocolo Hrana, POST /v2/pipeline, puerto 8080) |
IDE SQL completo. El mismo type-id conecta tanto a un servidor libSQL propio (sqld) como a Turso Cloud. Es el dialecto de SQLite a través de la red, y con dbstat da el tamaño real en bytes de tablas e índices. La credencial es un auth token, no una contraseña. Solo hay dos operaciones de mantenimiento, Reindex y verificación de integridad: VACUUM, ANALYZE y PRAGMA optimize los rechaza el servidor |
| DuckDB | @duckdb/node-api (complemento nativo N-API, unos 68 MB por plataforma) |
IDE SQL completo sobre archivos DuckDB locales o :memory:, ejecutando en el mismo servidor que la aplicación. Árbol de plan físico con EXPLAIN (FORMAT JSON), introspección del catálogo duckdb_*, tamaño real por tabla a partir de la asignación de bloques de pragma_storage_info, y cancelación de consultas mediante el interrupt() del propio driver. Tres operaciones de mantenimiento: VACUUM, ANALYZE y CHECKPOINT. Acá REINDEX es un error de sintaxis, y PRAGMA integrity_check y PRAGMA optimize no existen, así que no se ofrecen. No hay log de consultas lentas ni lista de sesiones: DuckDB no expone ninguna de las dos, así que esos paneles lo dicen en lugar de mostrar 0. Un archivo de base solo admite un proceso del sistema operativo (incluso en modo lectura), así que una segunda instancia de Studio no puede abrir el archivo que ya tiene abierto la primera |
| MongoDB | mongodb |
Editor de consultas JSON y operaciones sobre colecciones (find, aggregate, insert, update, delete) |
| Couchbase | Sin driver, HTTP puro (REST de Query y de administración) | IDE SQL++ completo, EXPLAIN, explorador de buckets, scopes y colecciones, inferencia de campos con INFER |
| Firestore | Sin driver, REST (la API REST v1 de Firestore) | Solo lectura: colecciones de primer nivel en el árbol, documentos y subcolecciones a cualquier profundidad en el panel Keys, los datos de un documento en la pestaña Source, y la cadena de consultas del Admin SDK, que Studio analiza y nunca ejecuta como JavaScript, con count(), sum(), average(), findNearest y Query Explain |
| ClickHouse | Sin driver, HTTP puro (interfaz SQL, puerto 8123) | IDE SQL completo, árbol EXPLAIN en JSON, introspección de esquemas por tablas de sistema, OPTIMIZE TABLE |
| Apache Druid | Sin driver, HTTP puro (POST /druid/v2/sql) |
IDE SQL de solo lectura, árbol EXPLAIN de la consulta nativa, introspección por INFORMATION_SCHEMA, monitoreo con sys.* |
| Elasticsearch | Sin driver, HTTP puro (POST /_sql?format=json, puerto 9200) |
IDE SQL de solo lectura, explorador de índices y campos basado en el mapping, salud del clúster y cantidad de documentos y tamaño por índice. Sin EXPLAIN, sin operaciones de mantenimiento y sin paneles de consultas lentas ni sesiones. El SQL de Elasticsearch tampoco tiene OFFSET, así que no se puede pedir la segunda página de resultados |
| OpenSearch | Sin driver, HTTP puro (POST /_plugins/_sql, puerto 9200) |
El mismo módulo de proveedor que Elasticsearch, con el mismo IDE de solo lectura y el mismo explorador. Acá sí funciona LIMIT n OFFSET m, así que la paginación está disponible |
| Trino | Sin driver, HTTP puro (protocolo de cliente, POST /v1/statement, puerto 8080) |
IDE SQL completo sobre todos los catálogos configurados, árbol de esquemas por el information_schema del catálogo fijado en la conexión, monitoreo con system.runtime y jmx, conteos reales de filas vía SHOW STATS, cancelación de consultas y mantenimiento con kill_query. Trino es un motor de consultas y no almacena datos, así que no declara claves primarias, foráneas ni índices en ningún lado: el diagrama ER tiene cajas sin líneas, la edición en línea está desactivada, y el panel de capacidad lista catálogos en vez de inventar un tamaño. Las sentencias que fallan también vuelven con HTTP 200; y aunque el clúster tenga la autenticación desactivada, una contraseña sobre HTTP en texto plano se sigue rechazando |
| Databend | Sin driver, HTTP puro (la API de consultas propia de Databend, POST /v1/query, puerto 8000) |
IDE SQL contra un servidor Databend propio o un warehouse de Databend Cloud: catálogos y bases de datos en el árbol con tablas, vistas, vistas materializadas y tablas dinámicas, planes EXPLAIN en texto, monitoreo con system.* del catálogo por defecto, y cancelación de consultas con KILL QUERY desde el panel de sesiones. Cada sentencia corre en una sesión propia, así que una transacción o una tabla temporal termina con la sentencia que la abrió. Databend no declara claves, así que la edición en línea está desactivada, y también Create Table. Una contraseña por HTTP sin cifrar hacia un host que no es loopback ni va por túnel se rechaza, a menos que la conexión lo consienta. Una conexión a Cloud nombra su warehouse, que se reanuda, y factura, con la primera sentencia, incluida la apertura de la conexión, porque lee el árbol de objetos. TLS con CA propia y certificados de cliente; túnel SSH |
| BigQuery | Sin driver, HTTP puro (la API REST de BigQuery, jobs.query) |
IDE SQL (GoogleSQL): proyectos, datasets, tablas, vistas y vistas materializadas en el árbol, sentencias mediante jobs.query. EXPLAIN es una ejecución en seco (dry run) que informa los bytes procesados. Credenciales con clave de cuenta de servicio o token de acceso |
| Snowflake | Sin driver, HTTP puro (la SQL API v2 de Snowflake) | IDE SQL: bases de datos, esquemas, tablas, vistas, streams, tareas, stages y más en el árbol, una sentencia por petición. EXPLAIN USING JSON compila sin ejecutar. Inicio de sesión con par de claves o token de acceso programático, cada sentencia con un solo rol |
| Apache Spark | @grpc/grpc-js y apache-arrow, gRPC (Spark Connect, Spark 4.1 y posteriores) |
IDE SQL: catálogos y espacios de nombres con sus tablas, vistas y funciones en el árbol, una sesión de Spark por petición, EXPLAIN FORMATTED planifica sin ejecutar. Token por TLS, en loopback o por un túnel SSH; modo de plan del agente |
| Apache Cassandra | cassandra-driver (JavaScript puro, sin módulos nativos) |
IDE de CQL sobre el protocolo nativo (puerto 9042), explorador de keyspaces con las claves de partición y de agrupamiento marcadas, resumen desde system_views, tiempo de actividad y sentencias en ejecución. La conexión exige localDataCenter: sin eso el driver se niega a conectar. No hay EXPLAIN (la gramática de CQL directamente no tiene esa palabra clave), no hay cancelación de consultas (el protocolo no tiene un frame de cancelación) y no hay operaciones de mantenimiento (compaction, repair y flush son operaciones JMX de nodetool). Y no muestra ninguna cantidad de filas ni tamaño: lo único que Cassandra puede dar es una estimación de particiones a partir de los archivos ya escritos a disco (una tabla de 500 filas se leyó como 143) y enteros en MiB (una tabla de 19.476 bytes se lee como 1 MiB), así que preferimos no mostrar nada antes que mostrar un número equivocado |
| Prometheus | Sin driver, HTTP puro (la API HTTP de Prometheus, puerto 9090) | Editor de PromQL que envía el texto al servidor sin cambios, resultados en la grilla y en la pestaña de gráficos (una subconsulta con paso, como rate(x[5m])[1h:1m], se grafica como líneas sobre sus marcas de tiempo: la pestaña abre con la primera serie, se agregan más desde el menú Y-Axis, una línea cada una, y se dibujan como máximo ocho a la vez, más allá de lo cual dice "Showing first 8 of N series"; pero el gráfico dibuja en 0 una muestra que falta y un NaN o Inf entre números, así que un rango crudo sobre targets con desfases de scrape distintos muestra ceros falsos), explorador de métricas con los nombres de etiqueta como columnas y los metadatos como fuente, grupos de reglas con reglas de registro y de alerta (una alerta disparada se marca en el árbol), pools y targets de scrape (un target caído se marca en el árbol), y salud, versión, tiempo de actividad y estadísticas del TSDB. Solo lectura por diseño: no llama a la API de administración, no hace remote write, no tiene EXPLAIN (el endpoint de parseo es experimental) ni operaciones de mantenimiento. Una credencial sobre HTTP en texto plano se envía en vez de rechazarse, así que activá TLS si la conexión cruza una red que no controlás |
| Apache Kafka | @platformatic/kafka (TypeScript puro, puerto 9092) |
Una solicitud de lectura en JSON que lee un topic por partición, offset o marca de tiempo, desde su offset más antiguo o sus mensajes más recientes, con claves, valores y cabeceras decodificados como JSON, texto o base64 y un valor con el formato de Confluent etiquetado con su id de esquema; explorador de topics con sus particiones y configuraciones no predeterminadas (un topic offline o con réplicas insuficientes se marca), grupos de consumidores de ambos protocolos con su retraso por partición, brokers con su configuración, y salud, cantidad de topics y tamaño en disco. Solo lectura por construcción: no produce, no confirma offsets, no se une a grupos y no crea topics. TLS con CA propia y certificados de cliente, y SASL PLAIN o SCRAM solo sobre TLS; sin túnel SSH, porque a los brokers se llega por las direcciones que anuncian |
| etcd | @grpc/grpc-js (JavaScript puro, gRPC, puerto 2379) |
Un subconjunto de etcdctl en el editor (get, put, del, txn, leases, un watch acotado, miembros, alarmas, usuarios y roles); grupos por prefijo de clave en el árbol y cada clave en el panel de claves; el valor de una clave editado en una transacción condicionada a su revisión; compactación, desfragmentación y desactivación de alarmas para administradores, cada una confirmada escribiendo el nombre de la conexión. Se rechaza toda escritura bajo un prefijo de Kubernetes o en compact_rev_key, y nunca se muestran los Secrets de Kubernetes ni los valores protobuf o cifrados. TLS con CA propia, certificados de cliente (su Common Name como usuario de etcd) e inicio de sesión con contraseña solo sobre TLS; túnel SSH; un modo de solo lectura declarado en la semilla |
| Neo4j | neo4j-driver-lite (JavaScript puro, Bolt, puerto 7687) |
Cypher de solo lectura en el editor, una sentencia por ejecución, contra Neo4j 5.26 LTS; etiquetas de nodo y tipos de relación con sus propiedades como columnas, índices y restricciones en el árbol; nodos, relaciones y caminos como celdas JSON etiquetadas en la grilla, con los enteros de 64 bits y los valores temporales exactos; los paneles de monitoreo que ofrece Community. Cada sentencia pasa una política de lectura sobre sus tokens, luego la clasificación del propio servidor mediante EXPLAIN (que una forma SHOW permitida omite), y corre en una sesión READ, así que una escritura tendría que vencer las tres. Sin vista de EXPLAIN ni PROFILE y sin mantenimiento; el agente ejecuta en Enterprise Edition con un usuario que el servidor demuestra de solo lectura, y run_read_query de MCP sigue cerrado. TLS con CA propia y túnel SSH; sin cadena de conexión |
| Milvus | @grpc/grpc-js (JavaScript puro, gRPC, puerto 19530) |
Las peticiones REST v2 propias de Milvus en el editor (POST /v2/vectordb/<ruta> con un cuerpo JSON) para lecturas, conteos exactos y búsquedas vectoriales sobre todo tipo de vector, incluidas BM25 y la búsqueda híbrida; bases de datos y colecciones en el árbol con campos, particiones, índices y estado de carga; celdas vectoriales con su dimensión y copia del valor completo; Load y Release para administradores, con vista previa y confirmación. Studio no escribe datos, rechaza las peticiones que harían que el servidor llame a otro servicio y avisa de la contraseña root por defecto. TLS con CA propia y certificados de cliente; la contraseña solo sobre TLS, en loopback o por el túnel SSH; un modo de solo lectura declarado en la semilla |
| Qdrant | ninguno, HTTP (la API REST de Qdrant, Weaviate, puerto 6333) | Las peticiones REST propias de Qdrant en el editor (MÉTODO /ruta con un cuerpo JSON), diecisiete rutas de lectura: lecturas de puntos, scroll, conteos exactos, facetas, y consultas, lotes y consultas agrupadas sobre vectores densos, dispersos y multivector, incluido el modelo BM25 local; colecciones en el árbol con sus vectores, índices de payload y una vista muestreada de las claves del payload; celdas vectoriales con su dimensión y copia del valor completo. Studio no escribe nada, rechaza toda entrada de inferencia salvo BM25 local y avisa de un JWT sin caducidad o con acceso de gestión. TLS con CA propia y certificados de cliente; la clave solo sobre TLS, en loopback o por el túnel SSH; un modo de solo lectura declarado en la semilla |
| Weaviate | ninguno, HTTP (la API REST de Weaviate, y GraphQL para las búsquedas de un servidor anterior a 1.39.7, puerto 8080) | Las peticiones REST propias de Weaviate en el editor (MÉTODO /v1/ruta con un cuerpo JSON), diecisiete rutas de lectura: listas de objetos y lecturas por id, búsquedas BM25, híbridas con alpha 0, near-vector y near-object, filtros y conteos de agregación, escritas con la forma de la búsqueda REST en todo servidor y ejecutadas por GraphQL en uno anterior a 1.39.7; colecciones en el árbol con sus propiedades y vectores, tenants y alias en el Source de la colección, conteos exactos. Studio no escribe nada, rechaza toda petición que enviaría texto a un modelo y nunca despierta un tenant frío. TLS con CA propia; la clave de API o el token de acceso OIDC solo sobre TLS, en loopback o por el túnel SSH; probado en Weaviate 1.40.2, 1.38.22 y 1.37.4 |
| InfluxDB (InfluxQL) | ninguno, HTTP (la API v1 de InfluxDB, puerto 8086) | InfluxQL de solo lectura en el editor contra InfluxDB 1.x, 2.x y 3 por la API v1 /query, un SELECT, SHOW o EXPLAIN por ejecución; bases de datos y measurements en el árbol, con los tags y fields de cada measurement como columnas, y enteros por encima de 2^53 y marcas de tiempo en nanosegundos exactos en la cuadrícula. Solo lectura diga lo que diga la conexión: en 1.x y 2.x la política de lectura propia de Studio es la única barrera antes de DROP DATABASE, así que toda otra sentencia se rechaza antes de cualquier petición, y no se llega a ningún endpoint de escritura. Usuario y contraseña, o un token en el campo de contraseña; una credencial por HTTP sin cifrar hacia un host que no es loopback ni va por túnel se rechaza salvo que la conexión lo consienta; _internal nunca se lee en un servidor InfluxDB 3 |
| InfluxDB 3 (SQL) | ninguno, HTTP (la API SQL de InfluxDB 3, puerto 8181) | SQL de solo lectura en el editor contra InfluxDB 3 Core y Enterprise; las tablas de la base de datos de la conexión en el árbol, con sus columnas. Solo lectura diga lo que diga la conexión: la tabla de rutas no llega a ningún endpoint de escritura, tokens, caché o plugins, y de los de configuración solo al listado de bases de datos, un GET, toda sentencia que no empiece por una palabra clave de lectura se rechaza antes de cualquier petición, y el planificador del servidor rechaza además toda escritura. Un token y ningún usuario; un token por HTTP sin cifrar hacia un host que no es loopback ni va por túnel se rechaza salvo que la conexión lo consienta; apuntada a un servidor 1.x o 2.x, indica que se elija InfluxDB (InfluxQL) |
| Oxia | @grpc/grpc-js (JavaScript puro, gRPC, puerto 6648) |
Comandos oxia client de solo lectura (get, list, range-scan), shards en el árbol y cada clave en el panel de claves |
| S3-compatible object storage | ninguno, HTTP (la API REST de S3, estilo de ruta, firmada por el propio código SigV4 de Studio; hyparquet para las vistas previas de Parquet) |
Comandos de lectura de la AWS CLI, de solo lectura (aws s3 ls, aws s3api list-buckets, aws s3api head-object, aws s3api list-object-versions), y el preview propio de Studio; buckets en el árbol y carpetas en el panel de claves, un nivel cada vez; los metadatos de cada objeto y una vista previa acotada de texto, JSON, CSV y Parquet. Verificado en MinIO, Silo, Garage y RustFS; no verificado en AWS S3 ni en servicios alojados |
| Kubernetes | Sin driver, HTTP (la API REST del servidor de API, puerto 6443) | Solo lectura: un subconjunto de kubectl en el editor (get, describe, logs, top, events, explain, auth can-i), los espacios de nombres y sus tipos en el árbol con una vista YAML de cada objeto, e importación de kubeconfig en el diálogo de conexión. Los valores de los Secrets nunca se muestran |
| MQTT | mqtt-packet (solo su analizador; los cinco paquetes que envía Studio, el gestor de conexión y la válvula unidireccional son código propio de Studio) |
De solo lectura por construcción: la vía de salida codifica únicamente CONNECT, SUBSCRIBE, UNSUBSCRIBE, PINGREQ y DISCONNECT, no existe ninguna función que escriba un PUBLISH y el CONNECT no lleva Will. El panel de claves construye un árbol de temas a partir de una sola suscripción, con el tiempo de vida restante que informa el propio servidor junto a cada fila, y un tema se abre con su carga útil y sus metadatos. MQTT no tiene ninguna orden que liste los temas, así que ninguna lectura afirma estar completa: cada una informa de lo que vio, por qué se detuvo y qué puede demostrar que perdió. Los filtros $share/, $queue/ y $exclusive/ se rechazan antes de enviar el SUBSCRIBE, porque cada uno quita mensajes a los dispositivos suscritos junto a Studio. Verificado en Mosquitto, EMQX, HiveMQ CE, NanoMQ y RabbitMQ 4 |
| RabbitMQ | ninguno: la API HTTP de gestión (puerto 15672) y el cliente de lectura AMQP 0-9-1 propio de Studio (puerto 5672) | De solo lectura por construcción: el cliente de lectura no codifica publicaciones, extracciones ni declaraciones. Hosts virtuales, streams, colas y exchanges en el árbol; una petición de lectura JSON lee los mensajes de un stream, nunca los de una cola |
| OPC UA | node-opcua-client (JavaScript puro, opc.tcp, puerto 4840) |
De solo lectura por construcción: la costura del cliente declara ocho servicios de lectura (GetEndpoints, CreateSession, ActivateSession, Browse, BrowseNext, Read, HistoryRead y CloseSession) y en el proveedor no hay Write, Call, HistoryUpdate ni suscripción alguna. El panel de claves recorre el espacio de direcciones nivel por nivel, un Browse por nivel, con la ruta de exploración escapada, porque un BrowseName puede contener el separador; un nodo se abre con su valor, su estado, sus dos marcas de tiempo y su AccessLevel descodificado, y la consola lee valores actuales o historial sin procesar como una sola petición JSON. Cada límite es el de Studio y no el que publica el servidor: de los cuatro servidores medidos, dos atienden peticiones muy por encima del límite que publican y uno lo publica como 0. Un nodo de método se lista y nunca se llama. Verificado con Microsoft OPC PLC 2.15.10, open62541 1.5.9, Python asyncua 2.1.0 y la demo de Eclipse Milo |
| MTConnect | ninguno: un cliente propio de este repositorio sobre el transporte node:http(s) compartido (puerto 5000) |
De solo lectura por construcción: la tabla de rutas tiene nueve entradas y todas son GET, así que no hay PUT, POST ni stream que enviar. Un dispositivo es un contenedor, un data item y una condition son relaciones cuyas filas son valor, marca de tiempo y secuencia, y el XML de cada asset se abre en una pestaña Source |
| Modbus | ninguno: un cliente propio de este repositorio sobre un socket en crudo, a traves de la regla de salida compartida (puerto 502, u 802 para MODBUS/TCP Security) | Solo lectura por construccion: el codificador nombra cuatro codigos de funcion de lectura y la identificacion del dispositivo, ninguna funcion construye una escritura, y una valvula vuelve a comprobar cada byte que sale. Modbus no tiene descubrimiento, asi que el arbol se construye a partir de un mapa de registros guardado con la conexion, y una lectura es una sola peticion JSON sobre los puntos que ese mapa nombra |
| NETCONF | ssh2 (solo el transporte SSH; este repositorio abre el socket y lo entrega, y el framing, las peticiones y la sesión NETCONF son propios, puerto 830) |
De solo lectura por construcción: requests.ts construye cinco cuerpos de petición y cuatro de ellos son las lecturas, <get-config>, <get>, <get-data> y <get-schema>, mientras el quinto cierra la sesión, y ninguna función construye un <edit-config>, un <copy-config>, un <commit> ni un <lock>. Un datastore es un contenedor y un módulo YANG otro por debajo, el contenedor o la lista de primer nivel de un módulo es un objeto, y las hojas clave de una entrada de lista son las columnas del objeto |
| SNMP | ninguno: un cliente propio de este repositorio sobre UDP (puerto 161), a través de la regla de salida compartida | De solo lectura por construcción: la válvula de salida rechaza cualquier PDU que no sea Get, GetNext o GetBulk, así que un Set nunca llega al socket. Un grupo de objetos es un contenedor, el recorrido de un subárbol es la lectura y una tabla se arma con las respuestas de GetBulk |
| Sparkplug B | ninguno: una sesión MQTT acotada propia de este repositorio sobre los transportes compartidos node:net y node:tls (puerto 1883, u 8883 a través del panel SSL / TLS) |
De solo lectura por construcción: el codificador no tiene ninguna función que escriba un PUBLISH y el CONNECT no lleva testamento (will), porque 5.4 registra el certificado de defunción de un nodo de borde como su will y un lector que lo fijara publicaría una defunción al caerse su propio socket. Un grupo y un nodo de borde son contenedores, y una métrica es una fila cuyo valor, marca de tiempo y definición vienen del certificado de nacimiento que la declaró |
| Redis | ioredis |
Editor de comandos, explorador de claves, monitoreo basado en INFO |
La seguridad del transporte es transversal, no depende del motor. El túnel SSH se abre antes de que el proveedor establezca la conexión y esta se redirige al extremo local, por lo que funciona independientemente del motor. Se aplica a cualquier conexión configurada con host y puerto, excepto Kafka, que no admite este túnel porque sus clientes se conectan a cada broker usando la dirección que este anuncia, y un túnel que redirige una sola dirección no puede cubrir todas esas conexiones. Las conexiones configuradas mediante una cadena de conexión (una opción disponible para MongoDB, Couchbase, ClickHouse y libSQL) no pasan por el túnel SSH porque no utilizan host y puerto por separado. SQLite y DuckDB tampoco tienen host ni puerto. El panel de SSL/TLS funciona en todos los motores que lo muestran. SQLite, DuckDB y LibreDB integrado no muestran este panel porque no tienen una conexión de red que proteger. En Trino, SSL/TLS es obligatorio porque el coordinador rechaza las contraseñas enviadas por HTTP sin cifrar. Oracle tiene una particularidad: su driver Thin siempre verifica la cadena de certificados, por lo que, si se usa
requirecon un certificado autofirmado, es necesario proporcionar la CA del servidor. Además, si se pega una cadena de conexión completa, se conserva el protocolo que esta indique. Por su parte, Db2 LUW exige TLS de forma predeterminada, a menos que se desactive intencionalmente, porque sin esta protección el driver envía la contraseña sin cifrar.
Que Redis entre en una interfaz pensada para SQL se sostiene sobre una convención.
getSchema()agrupa prefijos de claves en "tablas" usandoSCAN, que no bloquea (nuncaKEYS *); la salud y las métricas salen deINFO; las consultas lentas y las sesiones, deSLOWLOG GETyCLIENT LIST.
Editor SQL profesional
- Motor Monaco: el mismo núcleo que usa VS Code.
- Autocompletado con conocimiento del esquema: tablas, columnas y palabras clave.
- Espacio de trabajo con pestañas: cada pestaña con su propio estado de ejecución.
- EXPLAIN visual: planes de ejecución gráficos para encontrar cuellos de botella.
- Diagramas ER interactivos: grafo del esquema con aristas de claves foráneas reales, etiquetas de cardinalidad, minimapa, búsqueda y filtrado de tablas, modo compacto y exportación a PNG y SVG. El layout jerárquico automático lo hace ELK.js.
- Comparación de esquemas y migraciones: compara instantáneas o esquemas de conexiones distintas lado a lado. Vista de diferencias con colores (agregado, eliminado, modificado) y generación automática del SQL de migración para PostgreSQL, MySQL, SQLite, Oracle y SQL Server, más los cambios de columna de ClickHouse.
- Línea de tiempo de instantáneas: una línea horizontal con las instantáneas del esquema. Se eligen dos puntos y se comparan al instante, para seguir cómo evolucionó el esquema.
El agente de base de datos (solo lectura)
La superficie principal de IA es un panel de agente al lado del editor. Se plantea un objetivo — "¿qué departamento tiene más empleados?", "¿por qué esta consulta va lenta?" — y se presiona Start. La ejecución redacta SQL contra la base conectada, lee los resultados y escribe un informe cuyas afirmaciones citan esos resultados.
Otras funciones con modelo (opcional, con tu propio modelo)
- Compatible con cualquier LLM: por defecto usa Gemini, y funciona con OpenAI, Ollama y cualquier endpoint compatible con OpenAI (LM Studio, LiteLLM, vLLM).
- Análisis de seguridad de consultas: evaluación de riesgo previa a la ejecución para sentencias destructivas (DELETE, DROP, TRUNCATE).
- Explicación de consultas: planes EXPLAIN traducidos a lenguaje llano, con sugerencias de optimización.
- Conocimiento del esquema: el esquema de la base conectada se envía como contexto, así que la explicación nombra tus propias tablas y columnas.
- Resumen del perfilador de datos: las estadísticas por columna del perfilador, redactadas en prosa. Ese contexto incluye el
miny elmaxde cada columna, que son valores reales de tus datos; ver Agent Data Flow.
Gestión de datos
- Grilla universal: renderizado virtualizado (TanStack) para millones de filas.
- Edición en línea: doble clic para actualizar valores directamente en la grilla, en los motores cuyo SQL tiene actualización de fila sobre una sola tabla (en el resto el control no aparece).
- Filtros por columna: filtros de texto sobre los resultados, para explorar sin reescribir la consulta.
- Tabla dinámica interactiva: pivoteo del lado del cliente con cinco funciones de agregación (COUNT, SUM, AVG, MIN, MAX) y generación del SQL equivalente.
- Exportación: CSV y JSON al instante.
- Ocho tipos de gráficos: barras, líneas, torta, área, dispersión, histograma, barras apiladas y área apilada, con Recharts. Agrupación por hora, día, semana, mes o año, y configuraciones de gráfico que se guardan y se recargan.
Herramientas de análisis y desarrollo
- Perfilador de datos: perfilado de tablas en un clic, con estadísticas por columna (porcentaje de nulos, cardinalidad, mínimo y máximo, valores de muestra) y resúmenes narrativos generados por el modelo.
- Generador de código ORM: interfaces de TypeScript, esquemas de Zod, modelos de Prisma, structs de Go, dataclasses de Python y POJOs de Java a partir del esquema real de las tablas.
- Generador de datos de prueba: datos falsos con conocimiento del esquema y más de 30 inferencias semánticas de columna (email, teléfono, nombre, dirección y otras). Produce sentencias INSERT o JSON para
insertManyde MongoDB. - Documentación de la base: diccionario de datos generado y buscable, a partir del esquema real, con documentación asistida por modelo y exportación a Markdown.
Autenticación y SSO: todo en la versión MIT
- Dos modos de autenticación: usuario y contraseña locales, o inicio de sesión único por OpenID Connect (OIDC), conmutables con una variable de entorno.
- OIDC agnóstico del proveedor: funciona con cualquier proveedor que cumpla OIDC — Auth0, Keycloak, Okta, Azure AD, Zitadel, Google y otros.
- Seguridad PKCE: Authorization Code Flow con Proof Key for Code Exchange (S256).
- Mapeo automático de roles: mapeo por claims configurable, con notación de punto para claims anidados (por ejemplo
realm_access.roles). - Cierre de sesión en el proveedor: al salir se cierra tanto la sesión JWT local como la del proveedor de identidad.
Herramientas de mantenimiento para DBA (solo admin)
- Panel de monitoreo en vivo: siete pestañas — resumen, rendimiento, consultas, sesiones, tablas, almacenamiento y pool de conexiones.
- Gráficos de tendencia: métricas en tiempo real (conexiones, tasa de aciertos de caché, buffer pool, deadlocks) con historial en buffer circular y refresco automático configurable entre 5 y 60 segundos.
- Alertas por umbral: indicadores de salud con colores (sano, advertencia, crítico) para la tasa de aciertos de caché, el uso de conexiones, los deadlocks y el uso del buffer pool.
- Mantenimiento en un clic:
VACUUM,ANALYZE,REINDEX,UPDATE STATISTICS,DBCC CHECKDByALTER INDEX REBUILD, según el motor. - Registro de auditoría: la pestaña Auditoría del administrador muestra los eventos de auditoría recientes del servidor, como inicios de sesión, denegaciones de permiso, acciones de mantenimiento, ediciones de objetos y operaciones del agente y de MCP, cada uno con el usuario que está detrás, y el historial de consultas del propio administrador que ha iniciado sesión. Ambos se exportan como CSV o JSON, respetando los filtros actuales. Bajo la gobernanza, Studio registra un evento de consulta por cada sentencia que ejecuta una persona, y el plano de control conserva ese registro de toda la organización.
Instalación
| Método | Comando |
|---|---|
| Docker | docker run -p 3000:3000 ghcr.io/libredb/libredb-studio:latest |
| npx | npx @libredb/studio |
| Helm | helm install libredb oci://ghcr.io/libredb/charts/libredb-studio |
| Homebrew | brew trust libredb/tap && brew install libredb/tap/libredb-studio |
| Snap | sudo snap install libredb-studio |
| winget | winget install LibreDB.Studio |
| deb / rpm (servidor, con servicio systemd) | Página de releases |
| Aplicación de escritorio (AppImage / deb) | Página de releases. Ventana nativa, con el servidor corriendo como sidecar local y sin pantalla de login. No es el paquete de servidor de la fila anterior. |
| Aplicación de escritorio (Flatpak, en sandbox) | flatpak --user remote-add --if-not-exists flatpark https://dl.flatpark.org/flatpark.flatpakrepoflatpak --user install flatpark org.libredb.Studio |
brew trust se ejecuta una sola vez (requiere Homebrew 6+; si dice que el comando no existe, correr brew update primero). Docker, Helm y Snap no necesitan configuración: la contraseña de administrador del primer arranque se imprime en el log del contenedor, en el log del pod y en sudo snap logs libredb-studio, respectivamente. Las instrucciones completas de cada canal (comandos, configuración, uso con systemd, modelo de etiquetas de las imágenes Docker) están en docs/DISTRIBUTION.md.
Plantillas de despliegue en un clic: Railway, Dokploy, CapRover, Sealos, Kubero, Cosmos, DigitalOcean Marketplace, Unraid Community Apps, Render Blueprint, Fly.io y Koyeb. La lista completa está en docs/CHANNELS.md.
Para Kubernetes también hay un bundle de Operator para OpenShift y OLM.
Integrarlo en tu propio producto
npm i @libredb/studio
Studio también se publica como paquete de npm, así que se puede incrustar directamente en tu aplicación. Si tu producto crea bases de datos para sus usuarios, ese es el lugar donde el editor más sirve.
Pruebas y calidad
- Siete capas de pruebas: unitarias, de API, de integración, de hooks, de seguridad, de evaluaciones y de componentes, más las end-to-end
- Cobertura de líneas del 100%, y es una barrera dura en CI. Si la cobertura baja, el merge se bloquea
- Quality gate de SonarCloud
- Pruebas de humo en Node 24 y 26 en cada release
bun run test           # todas las pruebas
bun run test:e2e       # Playwright (requiere compilar antes)
bun run test:coverage  # reporte de cobertura
Documentación
El material en profundidad está por ahora solo en inglés:
- Arquitectura · Proveedores de bases de datos · Referencia por motor
- Documentación de la API · Configuración de OIDC · Capa de almacenamiento
- Helm Chart · Canales de distribución · Agregar una base de datos
Contribuir
Los issues y los pull requests son bienvenidos, y podés escribirlos en español sin problema. Empezá por CONTRIBUTING.md.
Para agregar un motor de base de datos, ver docs/ADDING_A_PROVIDER.md. El código, la documentación y las pruebas viajan juntos en el mismo pull request.
Licencia
MIT. Sin CLA, sin edición empresarial, sin nada reservado.
Hecho para todos los que trabajan con datos, estén donde estén o vayan adonde vayan.
Explorar proyectos relacionados
Asabeneh/30-Days-Of-Python
El reto de programación 30 Days of Python es una guía paso a paso para aprender el lenguaje de programación Python en 30 días. Este reto puede llevar más de 100 días. Sigue tu propio ritmo. Estos vídeos también pueden ayudarte: https://www.youtube.com/channel/UC7PNRuno1rzYPb1xLa4yktw
78,423 estrellasgrafana/grafana
Plataforma abierta y componible de observabilidad y visualización de datos. Visualiza métricas, registros y trazas de múltiples fuentes, como Prometheus, Loki, Elasticsearch, InfluxDB, Postgres y muchas más.
77,763 estrellasredis/redis
Para los desarrolladores que crean aplicaciones en tiempo real basadas en datos, Redis es la opción preferida, la más rápida y la de más funciones como caché, servidor de estructuras de datos y motor de consultas de documentos y vectores.
77,309 estrellasapache/superset
Apache Superset es una plataforma de visualización y exploración de datos.
75,453 estrellas