
ilien-dev/quiron
ilien-dev/quiron has 66 GitHub stars and 5 forks. GitHot measured 0 stars in 24 hours and +1 in 7 days. Last checked 2026-11-15 08:49 UTC. Last push 2026-11-05.
Crecimiento de estrellas medido
- in 24h
- 0
- in 7 days
- +1
- in 15 days
- Recopilando historial
- in 1 month
- Recopilando historial
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
Acerca de
AI humanizer skill for Claude Code, Codex and Cursor. Removes AI slop and the signs of AI writing, then measures the rewrite against human baselines.
IAREADME.es.md
Original
English · Español
Quirón: un skill para humanizar textos de IA que mide su propio trabajo
Un skill para Claude Code, Codex y Cursor. Quita los hábitos que delatan un texto escrito por IA
y después compara el resultado con escritura humana medida, no con una corazonada.
Dale un borrador a tu agente y pídele que lo humanice, o que un README suene menos a ChatGPT. Quirón reescribe el texto y luego lo mide. Te devuelve la versión nueva junto con unos números que dicen si ya se lee como algo que escribió una persona.
Instalación
Con la CLI de skills se instala en Claude Code y en los demás agentes que soporta, entre ellos Gemini CLI y GitHub Copilot:
npx skills add ilien-dev/quiron
No hace falta ninguna API key. Corre sobre el modelo que ya usas, y los scripts no piden nada fuera de la biblioteca estándar de Python 3.
Como plugin de Claude Code
Ejecuta estos dos comandos dentro de Claude Code:
/plugin marketplace add ilien-dev/quiron
/plugin install quiron@quiron
El plugin guarda el skill bajo su propio nombre, así que lo llamas con /quiron:quiron.
Demo: lo que pasa por detrás
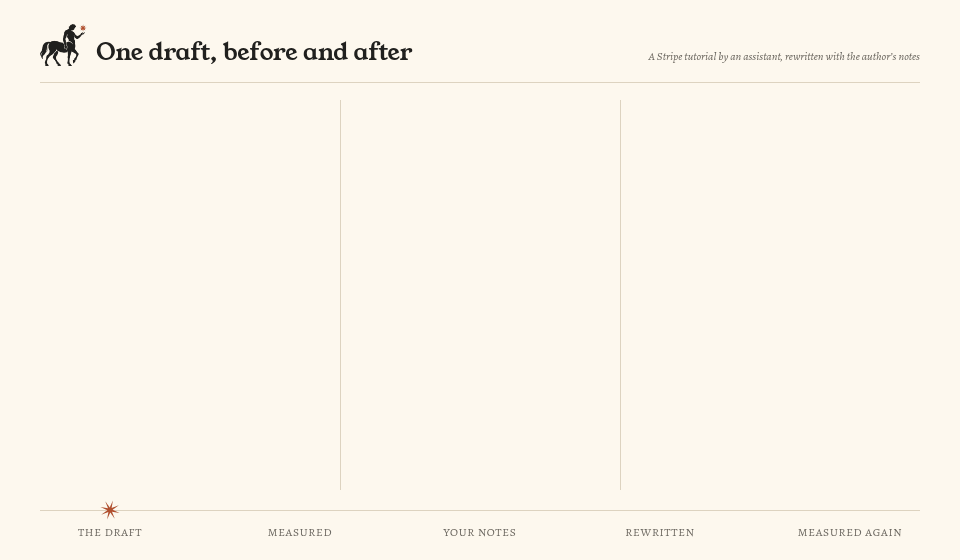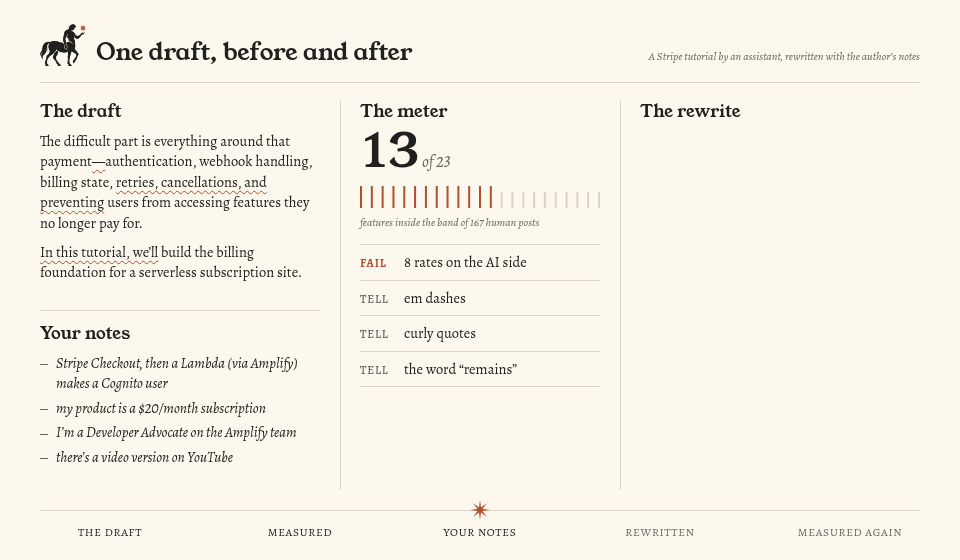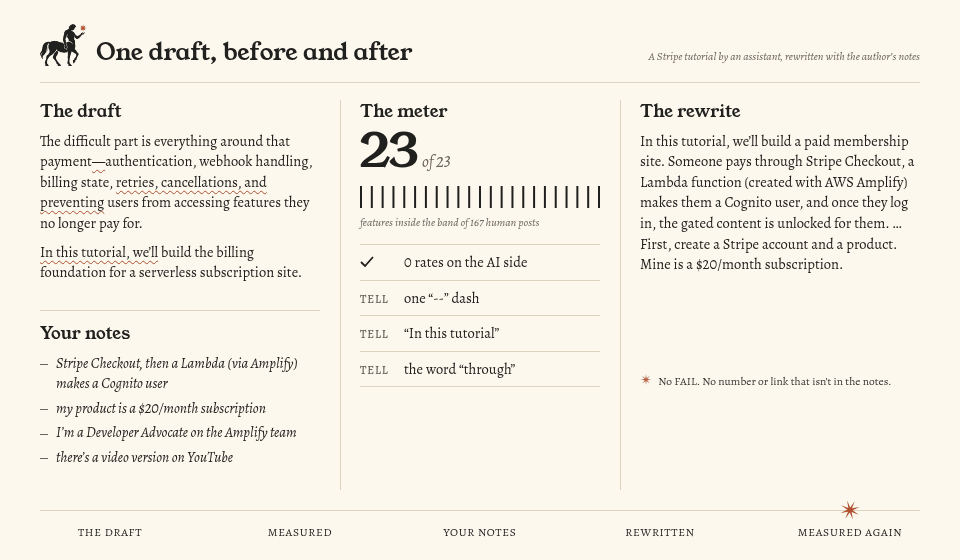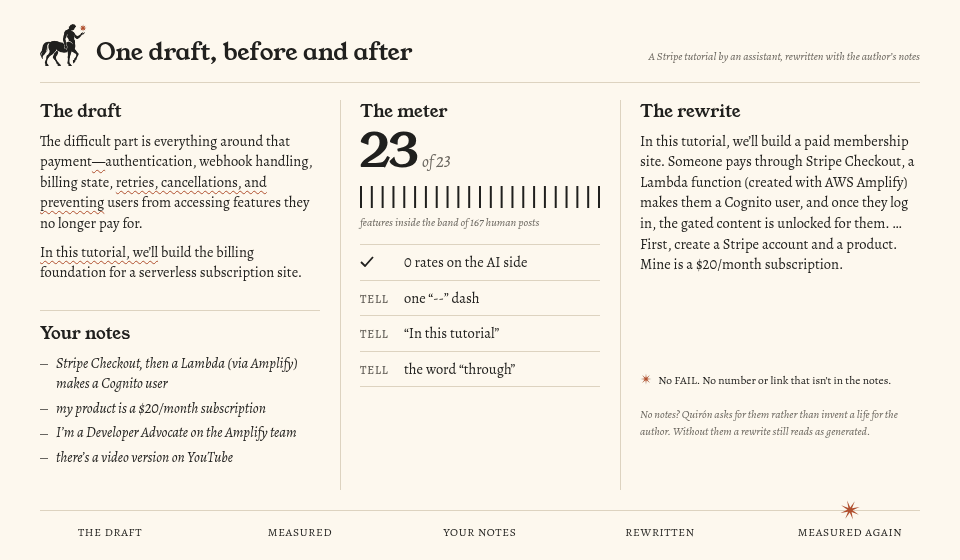
La animación enseña lo que hace el skill por detrás. No vas a ver esta pantalla al usarlo, y tampoco
levanta un servidor ni abre un informe: el modelo edita tu texto en el chat y ahí mismo te da el resultado del medidor.
[!IMPORTANT] Úsalo con responsabilidad. Quirón está pensado para lo que escribes para ti o para tu equipo: una guía interna, documentación, las notas de una reunión, un borrador que nadie de fuera va a leer. La idea es que el texto se sienta cercano y fácil de leer, no que finja que lo escribió una persona.
No lo uses para hacer pasar texto de IA por humano en público: redes sociales, artículos publicados, tareas de clase, reseñas, solicitudes de empleo, cualquier sitio donde quien lee tiene derecho a saber quién lo escribió. Nunca lo uses para engañar ni estafar a nadie. Tampoco vence a los detectores de IA que leen probabilidades de tokens, y no se hizo para eso.
Qué detecta
Pídele a un modelo un post de blog y te llega con una forma que se aprende a reconocer: listas de tres, el doble de encabezados de los que pondría una persona, una sección de resumen al final. En español hay dos más: el "no es X: es Y" y el cierre con "## Conclusión". Quirón le da al modelo una lista de 33 de estas señales de escritura con IA y un medidor que dice con números si el arreglo funcionó o se pasó de la raya.
La lista famosa de expresiones como cabe destacar, es importante señalar o sumérgete ya no sirve con los modelos de 2026. En la prueba de este repo aparecieron en 2 de 32 posts de IA, y en un 4 a 10% de los humanos. Lo que delata a un modelo hoy es más sutil, y también lo que falta: casi no escribe palabras que la gente usa todo el tiempo, como muy, hay o porque.
Así se ve el medidor sobre un tutorial de Stripe escrito por un asistente, sacado de
eval/ai/blog/ (el ejemplo está en inglés):
$ python3 scripts/aimeter.py eval/ai/blog/e2e-raw/aspittel-782713.md

feature                   this   human band      verdict
long words (7+) /1k     353.83   159.68 - 250.46  above band, AI side
nominalizations /1k      55.21     7.29 - 32.65   above band, AI side
em dashes /1k             3.76     0.00 - 2.74    above band, AI side
lists of three /1k       11.29     0.00 - 5.51    above band, AI side
plain words /1k          33.88    43.19 - 95.24   below band, AI side
...
13/23 features inside the human band (p10-p90 of 167 human texts)

! triads: retries, cancellations, and preventing, refund, tax, and privacy
La nueva versión del mismo post, hecha a partir de las notas del autor, saca 23 de 23.
En qué se diferencia de otros humanizadores
Los skills más conocidos para humanizar texto, humanizer y stop-slop, le dan al modelo una lista de patrones de escritura con IA para quitar, y funcionan. no-ai-slop hace lo mismo. Stop-slop además le pide al modelo que califique su propio borrador del 1 al 10 en cinco preguntas.
Quirón también tiene su lista, pero el modelo no se pone nota a sí mismo. Un script mide 23 tasas en el texto y compara cada una con el rango de la escritura humana publicada antes de ChatGPT. Eso atrapa un fallo que una lista no ve. Si le dices a un modelo que escriba como una persona, normalmente se pasa: le salen frases más cortadas y palabras más simples que las de cualquier persona. El medidor avisa de eso con la misma fuerza que avisa del lado de la IA.
En qué se apoya
Cada regla y cada número salen de un estudio publicado o de una corrida de los scripts de este repo. Nada entra porque "se lee mejor".
- Bases humanas. Las bandas salen de 167 posts de dev.to y 157 cuentos de WritingPrompts escritos antes de que existiera ChatGPT, y de 241 posts de dev.to en español de 118 autores. Una cuarta parte de cada conjunto se reserva y nunca se usa para elegir nada.
- Texto de IA de 2026 con los mismos títulos. Claude Opus, Sonnet, Haiku y GPT
escribieron los textos de comparación que hay en
eval/ai/, a partir de la petición simple que escribiría cualquier usuario. - Dos formas de fallar. Un texto puede quedar del lado de la IA o pasarse al otro lado de la banda humana. Pasarse también delata: los modelos a los que se les pide "escribir como humano" acaban más cortados y más planos que cualquier persona. El medidor marca los dos casos.
- Jueces a ciegas. Modelos nuevos leyeron posts de uno en uno y adivinaron cuáles eran
de IA. De esa prueba sale el hallazgo más importante, que está justo abajo. Desde
septiembre de 2026, cada cambio a las reglas de reescritura lo juzgan también jueces de
Claude y de GPT sobre títulos con los que no se ajustó, en inglés, en español y en
ficción; el código está en
eval/e2e/.
Cómo se midió cada número y de dónde viene cada regla está en SKILL.md,
references/spanish.md y eval/README.md,
en inglés.
Consejos para que el texto se lea humano
Los cambios de estilo por sí solos no engañaron a los jueces. Una versión con todas las tasas dentro de la banda humana siguió pareciendo de IA 12 veces de 12. Lo que los hizo cambiar de opinión fue el material propio de quien escribe. Así que:
- Parte de algo real. Tus notas, un borrador a medias, un hilo de Slack, un post-mortem. Un modelo que escribe desde cero tiene que inventarlo todo. Cuando los jueces decían que un post era de IA, daban razones como "no cuenta nada concreto" o "resumen genérico de tendencias".
- Dale los detalles. Qué pasó, los nombres reales, los números que conoces, los enlaces, qué salió mal.
- Di lo que piensas. Tu opinión, lo que no tienes claro, el error que cometiste. El modelo no puede poner eso sin inventárselo.
- Pásale algo que hayas escrito tú para que imite cómo escribes.
- Para cuando estés en el rango humano. Lo normal son dos o tres pasadas del medidor. Perseguir el 23 de 23 es exactamente como uno se pasa.
Uso
Pídeselo a tu agente con tus palabras, o llama a /quiron:
Humaniza este post: [pega el texto]
Haz que docs/lanzamiento.md suene menos a IA. Estas son mis notas: [notas]
Revisa si este correo tiene señales de IA, todavía no lo reescribas.
Los scripts también funcionan solos desde un clon del repositorio. Para textos en español hay que elegir las bandas en español:
export QUIRON_BANDS=scripts/bands-es.json
python3 scripts/aimeter.py ARCHIVO        # 23 tasas frente a las bandas humanas
python3 scripts/audit.py --brief ARCHIVO  # la lista de patrones
scripts/check.sh ARCHIVO                  # una pasada del ciclo completo
Para ficción en inglés se usa scripts/bands-fiction.json, y sin la variable se mide
contra posts de blog en inglés. Los textos de menos de unas 120 palabras no se miden.
Otros idiomas reciben la misma lista como mejor esfuerzo, porque todavía no tienen una base humana. El medidor lo dice y solo muestra los números que no dependen de las palabras, como el largo de los párrafos o los encabezados.
Preguntas frecuentes
¿Sirve para que un texto pase GPTZero, Turnitin u otros detectores de IA? No. Esas herramientas leen probabilidades de tokens, y Quirón no las toca. Trabaja únicamente sobre lo que realmente nota alguien al leer.
¿Con qué modelos funciona? Con cualquier modelo detrás de un agente que cargue skills. Se probó con texto de tres modelos de Claude y uno de GPT.
¿Se inventa cosas para sonar humano? Sus instrucciones se lo prohíben. Una nueva
versión solo puede usar datos de tu texto o de tus notas. scripts/factdiff.py lista los
números y enlaces de la versión nueva que no están en el original. Cuando le falta un
detalle, lo pregunta.
El nombre
Casi todos los centauros de la mitología griega eran salvajes y violentos. Quirón era el sabio: fue maestro de Aquiles, Asclepio y Jasón, y también era sanador. Cuando lo hirió una flecha envenenada, su inmortalidad le impedía morir de esa herida, así que renunció a ella, y Zeus lo puso entre las estrellas. El logo lo muestra sosteniendo esa estrella.
Le queda bien al skill por dos razones. Fue maestro de personas, y este skill le enseña a un modelo cómo escriben las personas. Y era mitad hombre, mitad caballo: el texto que Quirón ayuda a producir también es un híbrido. El modelo hace el borrador, y la parte humana tiene que venir de ti.
Licencia
Puedes usarlo y modificarlo libremente bajo la GNU AGPL v3, con un término
añadido en NOTICE. Cualquier trabajo basado en Quirón tiene que seguir abierto
bajo la misma licencia, también una versión modificada que se ofrezca como servicio en
red, y tiene que dar crédito al original: "Based on Quirón by ilien", con un enlace a este
repositorio.