
PerryLink/dsh-data-quality
PerryLink/dsh-data-quality has 53 GitHub stars and 1 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-15 19:38 UTC. Last push 2026-11-04.
Crecimiento de estrellas medido
- in 24h
- 0
- in 7 days
- 0
- in 15 days
- Actualización retrasada
- in 1 month
- Actualización retrasada
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
Acerca de
DeepSeek Harness plugin: deterministic data profiling, cleaning, and verification (dsh-data-quality)
IAREADME-es.md
Originaldsh-data-quality
Perfilado, limpieza y verificación de datos deterministas para DeepSeek Harness.
- Canal 1024 store:
npm i -g dsh1024una vez, luegodsh1024 plugin --profile web add dsh-data-quality(cuenta para el ranking de instalaciones de deepseek1024.com).
Perfilado, limpieza y verificación de datos deterministas para DeepSeek Harness.
Todo el cálculo es TypeScript puro dentro del proceso del harness — el modelo nunca hace las cuentas. Una costura de capacidad ctx.dataQuality (Service Definition / Provider local / Consumers de herramientas) expone tres herramientas para el modelo más un contrato congelado de verificación de citas entre plugins.
English · 简体中文 · Español · Português · हिन्दी
dsh plugin --profile <name> add dsh-data-quality
📖 Base de conocimiento del ecosistema — datos medidos, no marketing: guía de desarrollo · datos de selección · criterios de mantenimiento.
Install & uninstall
dsh plugin --profile web add dsh-data-quality      # instalar (npm) — o las formas anteriores
dsh plugin --profile web remove dsh-data-quality   # desinstalar
⭐ 如果它帮到了你
Este plugin forma parte de la familia de plugins DSH (más de 40, todos Apache-2.0). Si te resulta útil, dale una estrella: no desbloquea nada, pero ayuda a que la siguiente persona lo encuentre antes.
English: part of a 95 plugin family for DeepSeek Harness. If it is useful, a star helps the next person find it — nothing is gated behind it.
What is dsh-data-quality?
Perfilado, limpieza y verificación de datos deterministas para DeepSeek Harness.
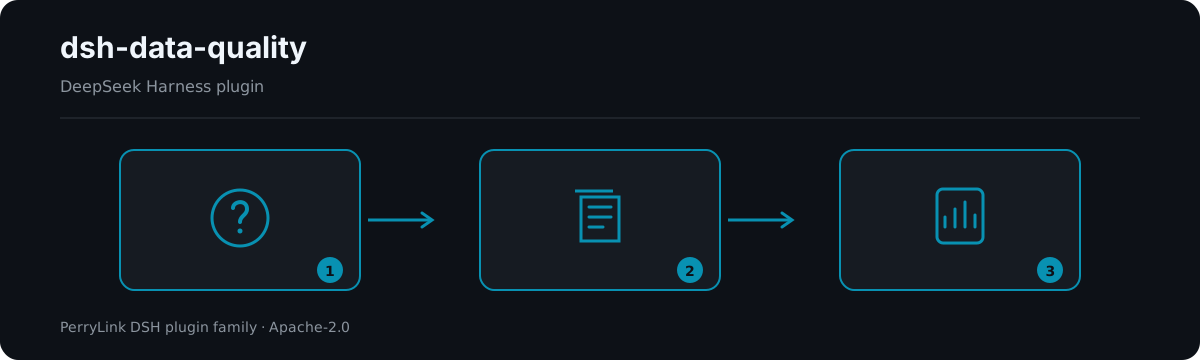
Resumen del flujo: pregunta → fuentes selladas → informe. Los ejemplos siguientes usan la superficie de comandos real.
La misma ejecución, animada.
Comparison
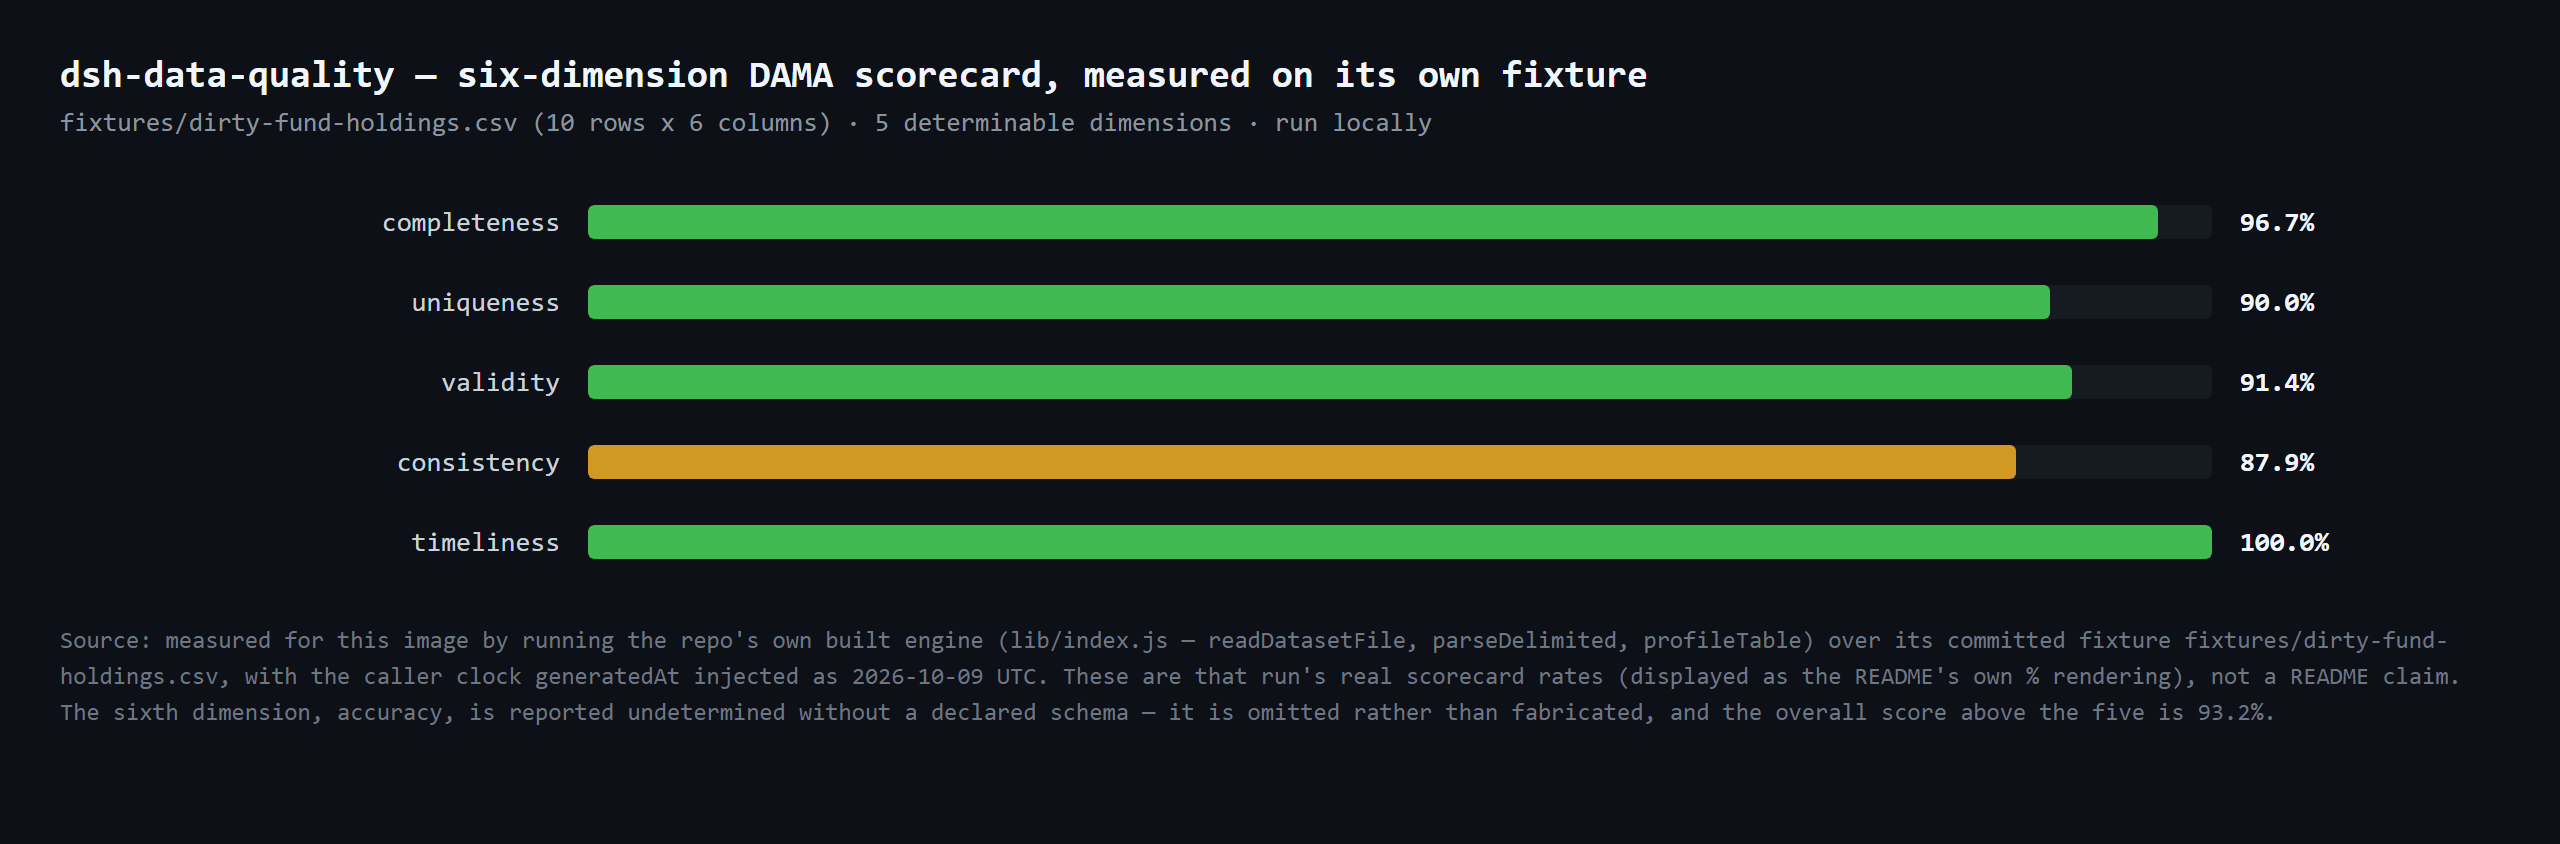
fixtures/dirty-fund-holdings.csv (10 rows x 6 columns) · 5 determinable dimensions · run locally
Compatibility
| Componente | Versión |
|---|---|
| DeepSeek Harness | dsh-v0.2.1-alpha.1 (adaptado el 2026-10-04): el rango de peers admite la línea alpha.2; allí el tercer parámetro de Session.append existe solo para tipos de superficie y es un SurfaceIntent, así que la puerta de auditoría sigue omitiendo y el informe del dominio de almacenamiento sigue siendo la copia duradera. Verificado el 2026-09-24 (doble typecheck + suite completa en verde). |
| Node.js | ^22.19.0 || >=24.0.0 |
| Gestor de paquetes | [email protected] |
| Plataforma | Windows / macOS / Linux (plugin solo de host) |
What you get
- Servicio
ctx.dataQuality— un servicio Cordis que otros plugins pueden consumir opcionalmente (inject = ['dataQuality']). Además de las tres operaciones sobre datasets detrás de las herramientas, implementa el contrato congeladoverifyCitations(request): verifica que los números/cadenas citados en un documento coincidan con una instantánea del dataset, con comparación numérica por tolerancia relativa y estadosverified/mismatch/not-found/unverifiable. - Herramienta
data_profile— perfilado de datasets: conteos de filas/columnas, tipos de columna inferidos (number/date/boolean/string/empty/mixed), tasas de valores faltantes, conteos de valores únicos, distribuciones numéricas (min/max/mean/median/p25/p75), conteo de valores atípicos IQR, notas de sospecha por tipos mixtos y conteo de filas duplicadas de la tabla completa. Muestreo sistemático determinista opcional para archivos grandes. - Herramienta
data_clean— reglas declarativas de limpieza en orden:dedupe(por grupo de columnas),fill-missing(constant/mean/median/forward),coerce-type(number/date/boolean; los fallos se cuentan y quedan como faltantes),normalize-unit(p. ej. sufijos 万/亿 a unidades base),trim,map-values(mapeo de enumeraciones). Devuelve un registro de auditoría por regla más una vista previa acotada; solo escribe el dataset limpio cuando se indicaoutputPathy nunca sobrescribe el origen. - Herramienta
data_verify— reglas declarativas de verificación:not-null,unique,range,regex,enum,cross-column(p. ej.startDate < endDate),freshness(columna de fecha dentro de N días de una fecha de referencia). pass/fail por regla con evidencia acotada de filas fallidas; un fallo global es un resultado normalpassed: false, no un error de herramienta. - Informes duraderos — cada ejecución de perfilado/limpieza/verificación/citas persiste en el dominio de almacenamiento
data_quality(backend JSON), con clave de marca de tiempo más huella de la ruta del dataset; la clave se devuelve comoreportKeyen los resultados. Los informes de limpieza también persisten la vista previa acotada, de modo que todo resultado visible para el modelo es reconstruible a partir de sureportKey. - Eventos de sesión — en hosts que los soportan con seguridad, las ejecuciones añaden eventos
data-quality/profile/data-quality/clean/data-quality/verify(con la marcaignorabledonde se admite). En la línea publicada0.1.7-rc.2(como en las líneas rc anteriores) el append se omite por diseño — el informe del dominio de almacenamiento es siempre la copia duradera (véase «Known limitations»).
Quick start
dsh plugin --profile web add github:PerryLink/dsh-data-quality
Canal npm
dsh plugin --profile web add dsh-data-quality
Canal tarball (no requiere permiso de compilación)
pnpm pack                                  # produce dsh-data-quality-<version>.tgz
dsh plugin --profile web add ./dsh-data-quality-<version>.tgz
Canal git
dsh plugin --profile web add github:YOUR_ORG/dsh-data-quality#<commit-sha>
El primer add falla porque pnpm bloquea la compilación prepare del paquete; copia la clave exacta que pnpm imprimió en el pnpm-workspace.yaml del perfil y vuelve a ejecutar:
allowBuilds:
  'dsh-data-quality': true
Reinicia el perfil tras instalar (los bundles se activan al reiniciar). Luego pide al agente, en un workspace que contenga un CSV:
Perfila
holdings.csv, luego límpialo recortando espacios, deduplicando porfund_codey normalizando las unidades 万/亿 de la columnaholding_value; finalmente verifica quefund_codesea único y no nulo.
Ejemplos
Son los puntos de entrada reales; instala y llama a uno.
Ejemplo detallado
Comando
data_profile({ path: "dirty-fund-holdings.csv" })
Salida
Profile of dirty-fund-holdings.csv: 10 rows x 6 columns
Duplicate rows: 1 (10.0%); sample row indexes: 8
- nav: mixed; missing 1 (10.0%); unique 7; note: mixed types among 9 present values: 8 numeric, 1 string
Scorecard (overall 93.2%, weighted 93.2%):
Observado en README.md:147-149; test/profile.spec.ts:130-132; test/loader.spec.ts:98-99; src/profile.ts:311-315
Rama de fallo
Entrada
{"path":"dirty-fund-holdings.csv","rules":[{"rule":"dedupe","columns":["nope"]}]}
Salida
isError=true; error.message=rule 0: unknown column "nope" (columns: fund_code, fund_name, nav, nav_date, holding_value, currency)
Observado en plugins/dsh-data-quality/src/clean.ts:66-68; plugins/dsh-data-quality/fixtures/dirty-fund-holdings.csv; exercised through plugins/dsh-data-quality/test/harness.ts
Ejemplos breves
data_cleandata_verify
Configuration
Todas las claves son opcionales (se muestran los valores por defecto); los valores inválidos fallan ruidosamente al cargar. Cada clave se puede cambiar desde cordis.yml (el bundle incluye cordis.patch.yml con los mismos valores).
| Key | Default | Description |
|---|---|---|
enabled |
true |
Interruptor maestro; false no monta nada. |
maxRows |
200000 |
Tope duro de filas por carga; entradas mayores se rechazan ruidosamente (usa el parámetro sample de la herramienta). |
maxFileSizeMB |
64 |
Tope duro de tamaño de archivo en MiB por carga. |
defaultTolerance |
1e-9 |
Tolerancia relativa por defecto para la comparación numérica de citas cuando la cita omite tolerance. |
evidenceRowLimit |
20 |
Tope de filas de evidencia (verify) y de vista previa (clean) en un resultado. |
allowedExtensions |
['.csv', '.tsv', '.json', '.jsonl'] |
Extensiones aceptadas como datasets. |
workspaceRoot |
"" |
Raíz absoluta para llamadas a nivel de SERVICIO (p. ej. verifyCitations) sin workspace de sesión; vacío = directorio de arranque del proceso del harness. Las herramientas siempre usan el cwd del workspace de la sesión. |
storeReports |
true |
Persistir los informes en el dominio de almacenamiento data_quality y devolver reportKey. |
scorecardWeights |
todo 1 (igual) | Ponderaciones por dimensión (completeness/uniqueness/validity/consistency/timeliness/accuracy) para el total ponderado del scorecard; cada peso debe ser un número no negativo. |
Tools & surfaces
data_profile({ path, sample?, industryPreset? })
Perfila un dataset del workspace. path es relativo al workspace (.csv/.tsv/.json/.jsonl; JSON debe ser un array de objetos planos). sample toma cada ceil(N/sample)-ésima fila para las tarjetas de columna (determinista; los conteos de filas siguen siendo exactos). industryPreset (retail/saas/fund/real-estate/e-commerce/healthcare/logistics/manufacturing/energy) inyecta las columnas esperadas de esa industria para que la dimensión accuracy del scorecard sea determinable; los ids desconocidos fallan alto. Devuelve el informe estructurado y renderiza un resumen legible por columna.
data_clean({ path, rules, outputPath?, dryRun? })
Aplica rules en orden de array; cada regla ve la salida de la anterior. Referencia de reglas:
| Regla | Campos extra | Semántica |
|---|---|---|
dedupe |
columns? |
Elimina filas cuya combinación de columnas clave duplica una fila anterior (se conserva la primera; todas las columnas si se omite). |
fill-missing |
column, strategy, value? |
Rellena faltantes: constant (requiere value), mean/median (columnas numéricas), forward (valor anterior no faltante). |
coerce-type |
column, to |
Convierte a number/date (ISO)/boolean; los fallos quedan como faltantes y se cuentan. |
normalize-unit |
column, factors |
Quita el sufijo de unidad y multiplica ({"万": 10000, "亿": 100000000}); los numéricos planos también se convierten. |
trim |
columns? |
Recorta espacios en celdas de texto (todas las columnas si se omite). |
map-values |
column, map, else? |
Mapeo por coincidencia exacta; los valores no mapeados se conservan (keep, por defecto) o quedan missing. |
El archivo de origen nunca se sobrescribe. Con outputPath el dataset limpio se escribe allí (confinado al workspace, formato por extensión); sin él la ejecución es solo vista previa. Con dryRun: true no se escribe ningún archivo ni se persiste nada: el resultado devuelve el plan de limpieza por columna y el contract/diffPreview esperados. El resultado también lleva un resumen de contract previo a la entrega, y un informe de perfil clean-diff antes/después se persiste en el dominio de almacenamiento.
data_report({ key?, kind?, format? })
Lee informes persistidos del dominio de almacenamiento. Pasa key (el reportKey exacto que devolvió una ejecución anterior) para obtener un informe, o kind (profile/clean/clean-diff/verify/citations) para listar cronológicamente todos los informes de ese tipo; se requiere exactamente uno de key/kind. Las claves malformadas o ausentes fallan alto. format: html (con key) renderiza el informe como un documento HTML offline autocontenido: CSS/JS en línea, sin peticiones externas, el scorecard DAMA de seis dimensiones y las tablas de resumen de perfil/limpieza (solo informes profile/clean).
data_verify({ path, rules, expectations? })
Evalúa reglas de verificación. Referencia de reglas:
| Regla | Campos extra | Semántica |
|---|---|---|
not-null |
column |
Fallan las celdas faltantes (null/vacío/solo espacios). |
unique |
columns |
Falla cada fila cuya combinación clave se repite (los faltantes participan). |
range |
column, min?, max? |
Fallan celdas faltantes/no parseables y valores fuera de los límites inclusivos (se requiere al menos un límite). |
regex |
column, pattern, flags? |
Fallan celdas faltantes o que no coinciden (regex JS completa). |
enum |
column, values |
Fallan celdas cuyo texto recortado no está en la lista. |
cross-column |
left, op, rightColumn?, value? |
Compara por fila: numérico si ambos lados parsean, fechas como épocas, cadenas solo para ==/!= (exactamente uno de rightColumn/value). |
freshness |
column, maxAgeDays, asOf? |
Fallan fechas más viejas que maxAgeDays antes de asOf (por defecto: ahora); no parseable/faltante falla. |
Una celda faltante hace fallar toda regla que la lee. La evidencia se limita a evidenceRowLimit filas fallidas por regla.
expectations reconcilia métricas deterministas con valores esperados: rowCount, columnSum, columnMean, uniqueCount, nullCount (cada uno con column salvo rowCount, más expected y una tolerance relativa opcional en [0, 1]). Cada expectativa produce passed más actual/expected/tolerance; una discrepancia es un veredicto normal passed: false, nunca un error de herramienta. Métricas inválidas, columnas ausentes y tolerancias fuera de rango fallan alto.
ctx.dataQuality (para otros plugins)
const result = await ctx.dataQuality.verifyCitations({
  dataset: 'holdings.csv',          // se resuelve contra workspaceRoot
  citations: [
    { id: 'c1', path: 'rows[3].nav', value: 1.234, tolerance: 0.01 },
    { id: 'c2', path: 'summary.annualReturn', value: '12.34%' },
  ],
})
// result.results[i] = { id, status: 'verified' | 'mismatch' | 'not-found' | 'unverifiable', actual?, note? }
Los localizadores recorren el documento del dataset: CSV/TSV cargan como { columns, rows } (así rows[3].nav resuelve), JSON es el valor parseado, JSONL el array de líneas parseadas. Los números comparan con tolerancia relativa (|a-b| <= tolerance * max(|a|, |b|)); una celda de texto CSV que parsea numéricamente compara como número; las cadenas comparan exactas; los pares de tipos incomparables son unverifiable. El servicio también expone profileDataset / cleanDataset / verifyDataset (las mismas operaciones que llaman las herramientas).
Permissions & data
- Lee archivos de dataset del workspace (solo extensiones permitidas).
- Escribe solo: el archivo de salida de
data_clean(outputPathexplícito, confinado al workspace, nunca la entrada) y los informes del dominio de almacenamientodata_qualityen el directorio de datos del harness. - Sin red, sin credenciales, sin procesos externos — todo el parseo y la estadística son TypeScript en proceso.
- Los informes pueden contener valores de celda de muestra de tus datasets (acotados por
evidenceRowLimity el truncado de presentación); el registro de sesión registra argumentos y resultados de herramientas como siempre.
Security boundaries
- Confinamiento de rutas — las rutas de dataset y salida deben resolverse dentro del workspace de sesión (
verifyCitationsusaworkspaceRoot); se rechazan escapes..y rutas absolutas fuera de la raíz, y ambos lados se normalizan antes de comparar (seguro con barras de Windows). - Trabajo acotado — las guardas
maxRows/maxFileSizeMBrechazan entradas sobredimensionadas ruidosamente; las señales de aborto cancelan cargas largas a mitad de camino. - Sin sobrescritura —
data_cleanrechaza unoutputPathigual a la ruta de entrada. - Cálculo determinista — misma entrada, misma salida; el único reloj es el inyectado para los valores por defecto de
freshnessy las marcas de tiempo de informes.
Known limitations
- Los eventos de sesión son adaptativos. La línea publicada
0.1.7-rc.2(como las líneas rc anteriores) no tiene superficie de registro de eventos de sesión para plugins y suSession.appendno puede estampar la marcaignorable, así que añadir un tipodata-quality/*desconocido haría ilegible el registro de sesión al restaurarlo. Por eso el plugin solo añade cuando el host conoce el vocabulario o soporta el flagignorable; en la línea publicada el informe del dominio de almacenamiento es el registro duradero. - Dialecto CSV — coma/tab con comillas RFC-4180, fila de cabecera obligatoria, líneas en blanco omitidas; sin autodetección de delimitador ni líneas de comentario.
- El parseo de tipos es estricto — los números no llevan separadores de miles; las fechas son
YYYY-MM-DD/YYYY/MM/DD/ datetimes estilo ISO (UTC); los booleanos sontrue/false/yes/no/1/0. Todo lo demás se perfila comostring/mixed— límpialo concoerce-typesi es intencionado. - JSON debe ser tabular para las herramientas (array de objetos planos);
verifyCitationsrecorre documentos JSON arbitrarios. - Sin detección de anomalías por ML, sin enmascarado de PII, sin bases de datos, sin SQL — solo notas de sospecha basadas en reglas.
Development
pnpm install
pnpm run typecheck && pnpm run typecheck:ci && pnpm run typecheck:checkout && pnpm test && pnpm run build
pnpm run verify:self-contained && pnpm run verify:artifacts && pnpm run verify:readme-sync && pnpm pack
- Las pruebas ejecutan vitest contra los
Context/Session/ToolRuntime/dominio de almacenamiento REALES de los peers 0.1.7-rc.2 (sin mocks de servicios escritos a mano) más specs de motor puros; cada regla de limpieza/verificación tiene casos positivos y negativos, yverifyCitationscubre los cuatro estados. scripts/loader-runner.mjsarranca la composición real del Loader y ejecuta la cadena perfilar → limpiar → verificar contrafixtures/sin clave de API.- Release:
node scripts/release.mjs <x.y.z>(nunca hace push; el tag dispararelease.yml).
Topics
dsh · dsh-plugin · deepseek-harness · cordis · data-quality · data-cleaning · data-profiling · data-verification
Contributors
Gracias a todas las personas que han dado forma a este plugin.
- PerryLink — mantenimiento y releases (
0.1.2/0.1.3), mejoras de peer-dependencies, las insignias de npm version/downloads/CI, y correcciones recientes. - dsh-data-quality contributors — el scaffold inicial, el seam
ctx.dataQualityy el contrato congeladoverifyCitations, la capa de datasets determinista y los motores puros, los informes del dominio de almacenamientodata_quality, la suite vitest con servicios reales, los flujos CI/compat/release, y los READMEs en cinco idiomas.
Este repositorio aún no tiene historial público de issues o pull requests; aquí se acreditarán los números de PR/issue cuando lleguen.
PerryLink DSH Plugin Family
Este proyecto forma parte de la familia de plugins de DeepSeek Harness de PerryLink. El registro permanece plegado abajo para que cada README conserve una primera pantalla corta; expándelo para ver cada fila y su estado.