
PStarH/VisiLens
PStarH/VisiLens has 57 GitHub stars and 1 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-17 00:16 UTC. Last push 2025-12-01.
What you can do
- Instant Data Visualization: Just run visilens data.csv to visualize large datasets instantly.
- Backend-powered Sorting & Filtering: Perform complex queries on millions of rows using the VisiData engine.
- Column Manipulation: Change column types, rename columns, and edit data with an intuitive context menu.
- Advanced Filtering: Apply multiple filter conditions with support for regex pattern matching.
Crecimiento de estrellas medido
- in 24h
- 0
- in 7 days
- 0
- in 15 days
- Recopilando historial
- in 1 month
- Recopilando historial
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
Acerca de
A fast, local-first web GUI for exploring large CSV/Parquet/JSONL files. Powered by VisiData’s engine. Opens millions of rows instantly. Works with local files, SSH servers, and Jupyter. Your new data debugging lens.
Herramientas de desarrolloDOCUMENTATION/README_es.md
Original
VisiLens
El Excel para desarrolladores
Abre millones de filas en segundos. Local, rápido y ligero.
VisiLens es una interfaz web de alto rendimiento, pensada para la exploración de conjuntos de datos en local. Aprovecha la potencia de VisiData para visualizar y filtrar al instante archivos CSV, Parquet, Excel y JSON.


English • 简体中文 • Español • 日本語 • Русский
Características • Instalación • Uso • Arquitectura • Contribución

🚀 ¿Por qué VisiLens?
Explorar datos no debería implicar escribir siempre el mismo código en Pandas ni esperar a que arranque un software de hoja de cálculo pesado como Excel. VisiLens es un visor de CSV y explorador de Parquet moderno que combina la velocidad extrema de VisiData con una interfaz web ligera.
- ⚡️ Carga 1 millón de filas en menos de 2 segundos: gracias al motor de VisiData, altamente optimizado.
- 🔒 Todo en local: tus datos nunca salen de tu máquina. Nada se sube a la nube.
- 🛠 Cero configuración: flujo de trabajo orientado a la CLI: canaliza los datos, explóralos y sigue programando.
- 🔌 Soporte amplio de formatos: abre CSV, TSV, JSON, Parquet, Excel, SQLite y más de 50 formatos.
✨ Características
- Visualización instantánea de datos: basta con ejecutar
visilens data.csvpara visualizar al instante conjuntos de datos grandes. - Ordenación y filtrado desde el backend: ejecuta consultas complejas sobre millones de filas apoyándote en el motor de VisiData.
- Cuadrícula de datos virtualizada y ligera: vista de tabla basada en React, diseñada para un desplazamiento fluido incluso con muchas filas.
- Cero configuración: no necesitas montar una base de datos; funciona como visor independiente de CSV/Parquet.
📂 Formatos Soportados
VisiLens aprovecha los cargadores de VisiData para soportar una amplia gama de formatos desde el primer momento:
- Tabular:
.csv,.tsv,.xlsx(Excel),.parquet - Estructurado:
.json,.jsonl,.yaml - Base de datos:
.sqlite,.db - Código:
.pcap(Wireshark),.xml,.htmltablas
📊 Pruebas de rendimiento
Nos tomamos el rendimiento muy en serio. Así se comporta VisiLens al abrir un conjunto de datos CSV de 1.000.000 de filas en un MacBook Air estándar (M2):
| Herramienta | Tiempo de Carga (1M Filas) | Huella de Memoria | Ordenación Interactiva |
|---|---|---|---|
| VisiLens | ~1.7s | Mínima (< 50MB Total) | Instantánea (Backend: < 0.4s) |
| Excel | > 30s (A menudo falla) | Alta (Bloquea RAM) | Lenta/Sin respuesta |
| GUI basada en Pandas | > 15s (Arranque en frío) | Alta (Todo el DF en RAM) | Lenta (No virtualizada) |
| Jupyter (print df) | Rápida | Media | Texto estático |
Datos de prueba: 1M filas, 3 columnas (tipos mixtos). Las cifras proceden de mi MacBook Air M2 en un uso real de desarrollo.
📦 Instalación
VisiLens está disponible como un paquete de Python.
pip install visilens
Nota: VisiLens requiere Python 3.10 o superior.
💻 Uso
Interfaz de Línea de Comandos
La forma principal de usar VisiLens es a través de la línea de comandos.
# Abrir un archivo CSV
visilens data.csv

# Abrir un archivo Parquet
visilens large-dataset.parquet

# Abrir un archivo Excel
visilens spreadsheet.xlsx

# Lanzar sin abrir el navegador automáticamente
visilens data.json --no-browser

# Especificar un puerto personalizado
visilens data.csv --port 9000
Interfaz Web
Una vez lanzado, VisiLens se abre en su navegador predeterminado (generalmente http://localhost:8000).
- Ver Datos: Desplácese por su conjunto de datos de manera eficiente.
- Ordenar: Haga clic en los encabezados de las columnas para ordenar ascendente/descendente.
- Filtrar: Use las entradas de filtro para buscar dentro de las columnas.
- Cargar Nuevos Datos: (Próximamente) Arrastre y suelte archivos directamente en la ventana.
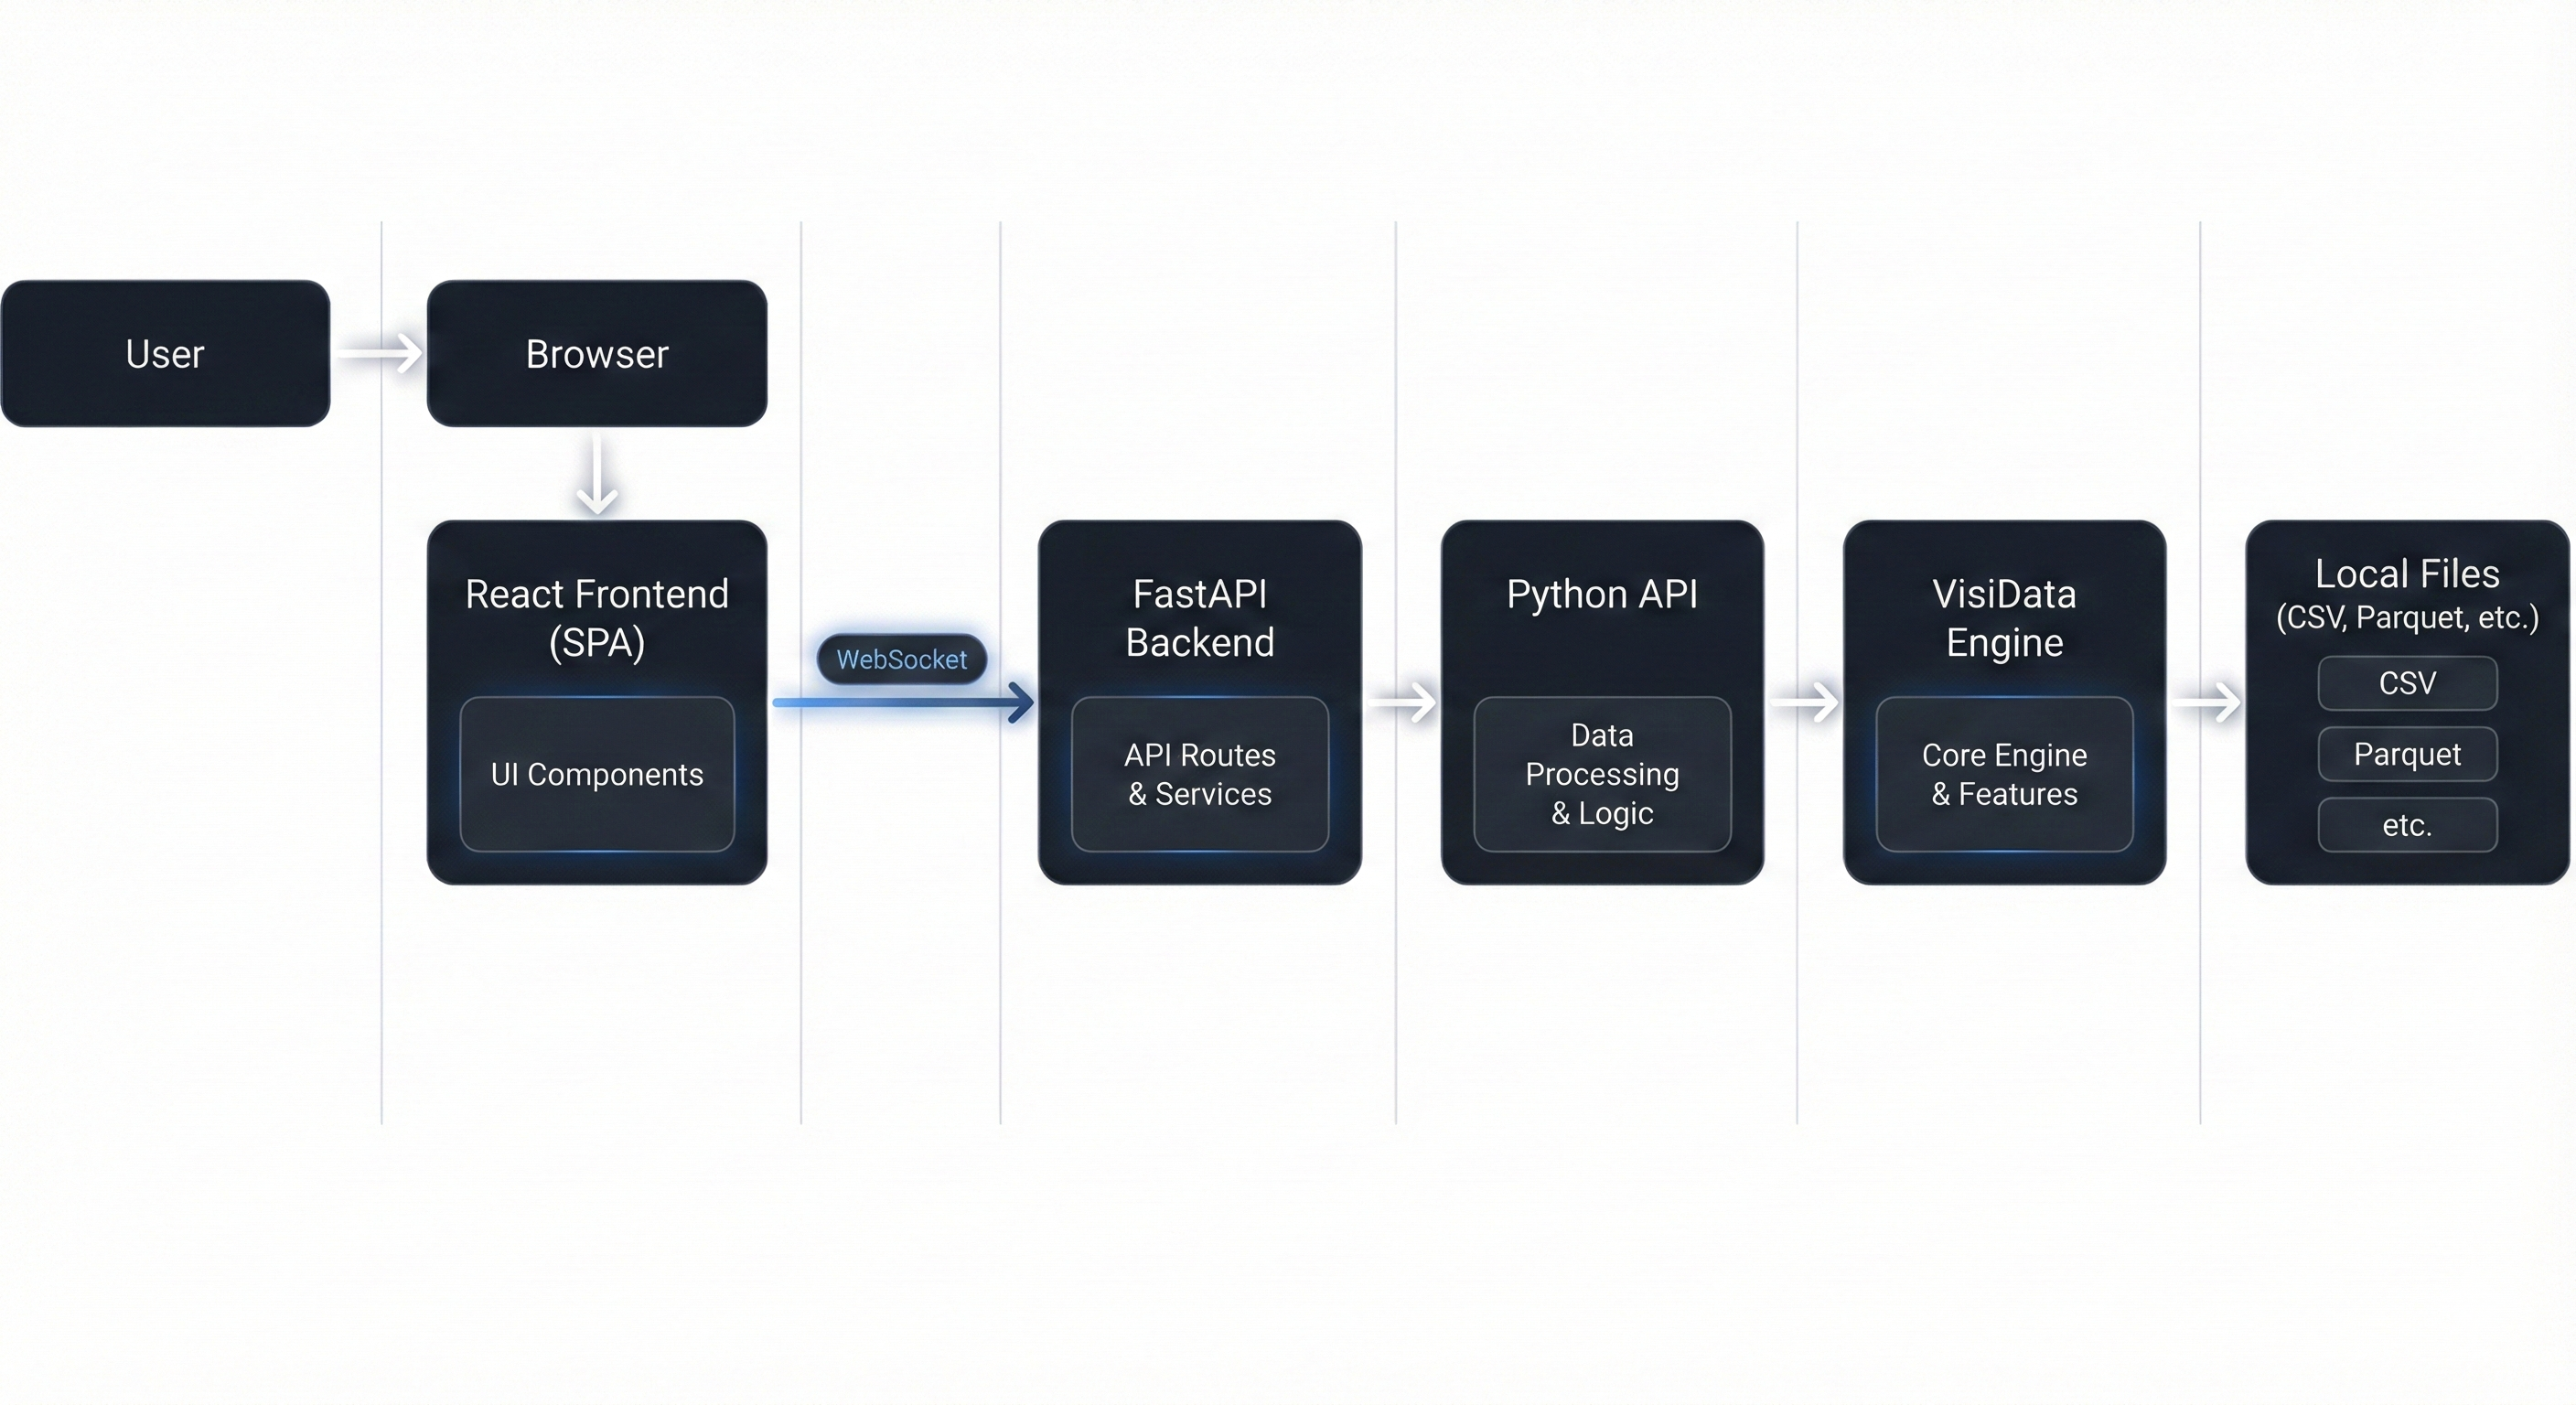
🏗 Arquitectura
VisiLens está construido sobre una pila moderna y robusta diseñada para el rendimiento:
- Backend: Servidor FastAPI que une VisiData y el navegador.
- Comunicación: WebSockets transmiten fragmentos bajo demanda.
- Frontend: Cuadrícula React que renderiza solo lo que ve.
🗺 Hoja de Ruta
Estamos trabajando activamente para hacer de VisiLens el compañero de datos local definitivo.
- v0.1: Motor Principal, Desplazamiento Virtual, Ordenación, Filtrado.
- Integración con Jupyter: Lanzar VisiLens directamente desde una celda de notebook (
visilens.view(df)). - Carga de archivos arrastrar y soltar
- Gráficos: Histogramas rápidos y gráficos de dispersión a través de Vega-Lite.
- Edición: Editar celdas y guardar cambios en CSV/Parquet.
- Soporte SQL: Conectar directamente a SQLite/Postgres/DuckDB.
🛠 Desarrollo
¿Quieres contribuir? ¡Genial! Aquí se explica cómo configurar el entorno de desarrollo.
Requisitos Previos
- Python 3.10+
- Node.js 18+
- npm o pnpm
Configuración
Clonar el repositorio
git clone https://github.com/PStarH/VisiLens.git
cd VisiLens
Configuración del Backend
# Crear entorno virtual
python -m venv .venv
source .venv/bin/activate  # o .venv\Scripts\activate en Windows

# Instalar dependencias
pip install -e ".[dev]"
Configuración del Frontend
cd frontend
npm install
Ejecutar Localmente
Terminal 1 (Backend):
uvicorn backend.main:app --reload --port 8000
Terminal 2 (Frontend):
cd frontend
npm run dev
- Construir activos del frontend (opcional)
Si prefiere ejecutar solo la CLI de Python (sin un servidor de desarrollo Vite separado), puede construir el frontend una vez:
cd frontend
npm run build
Esto produce un paquete de producción bajo frontend/dist/ que se copia en vdweb/static/ para lanzamientos. Los usuarios finales solo ejecutan:
visilens path/to/data.csv
🤝 Contribución
Para Colaboradores: dónde viven las cosas
- Paquete Python (
vdweb/): Este es el paquete instalable publicado en PyPI. Los puntos de entrada CLIvisilens/visilensse resuelven envisilens.cli:maincomo se configura enpyproject.toml. - Backend de desarrollo (
backend/): Una aplicación FastAPI separada utilizada solo para desarrollo local (uvicorn backend.main:app). Refleja el comportamiento del backend empaquetado pero no es lo que los usuarios importan cuando instalanvisilens. - Lógica central: La capa de acceso a datos impulsada por VisiData vive en
vdweb/core.py(y se refleja enbackend/core.pypara la aplicación de desarrollo). Si desea cambiar cómo se cargan/ordenan/filtran los datos, comience aquí.
Flujo de trabajo típico del colaborador
- Edite la lógica del backend / núcleo en
vdweb/(y actualicebackend/si es necesario para la paridad de desarrollo). - Ejecute el backend de desarrollo + frontend localmente como se describe en Desarrollo.
- Si cambia la aplicación React y desea que esos cambios se envíen, ejecute
npm run buildenfrontend/para que el paquete que se copiará envdweb/static/esté actualizado.
📄 Licencia
Este proyecto está licenciado bajo la Licencia MIT - vea el archivo LICENSE para más detalles.
Este README fue traducido por IA y no ha sido revisado. Siéntase libre de enviar un PR para mejorarlo.