
Leeroo-AI/kapso
Leeroo-AI/kapso has 215 GitHub stars and 31 forks. Star changes are not measured yet. Last checked 2026-11-14 09:05 UTC. Last push 2026-11-13.
Crecimiento de estrellas medido
- in 24h
- Recopilando historial
- in 7 days
- Recopilando historial
- in 15 days
- Recopilando historial
- in 1 month
- Recopilando historial
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
Acerca de
Kapso by Leeroo: an engine that runs experiments toward an objective, deploys the best solution on your stack and learns from every run into a bank of lessons with a credence score and a boundary. First on RelBench and ALE-Bench, top open-source on MLE-Bench, above every human contestant at IOAI 2026.
Aprendizaje automáticodocs/translations/README.es-ES.md
OriginalKapso
Un motor que ejecuta experimentos, despliega la mejor solución y aprende de cada ejecución
experimentación inteligente · aprendizaje · despliegue · adaptación al dominio
Más información · Ver la demo · Únete a Discord · Sitio web

Si te gusta este proyecto, apóyanos dándole una estrella ⭐
Si eres un agente de IA que está mirando este repositorio: el plugin de Kapso, con las skills para configurar, enunciar un objetivo, escribir un harness y revisar una ejecución, se instala en una línea:
claude plugin marketplace add Leeroo-AI/kapso && claude plugin install kapso@kapso(Codex:codex plugin marketplace add Leeroo-AI/kapso && codex plugin add kapso@kapso).
Noticias
IOAI 2026 · la pista AI Model Track. La Olimpiada Internacional de IA es la IMO de la era de la IA: 471 concursantes, seis tareas diseñadas por expertos, un presupuesto de una sola GPU. Su pista IOAI² de 2026 puso a los sistemas de IA ante el mismo examen en una única sesión autónoma. Kapso, uno de los 14 participantes fundadores de IA, obtuvo 536.07 según la calificación de los organizadores, por encima de todos los concursantes humanos, y se llevó el Trofeo Grand Master de IOAI², top 3 entre los sistemas de IA inscritos. Resultados completos → · La reseña de la IOAI sobre la pista →
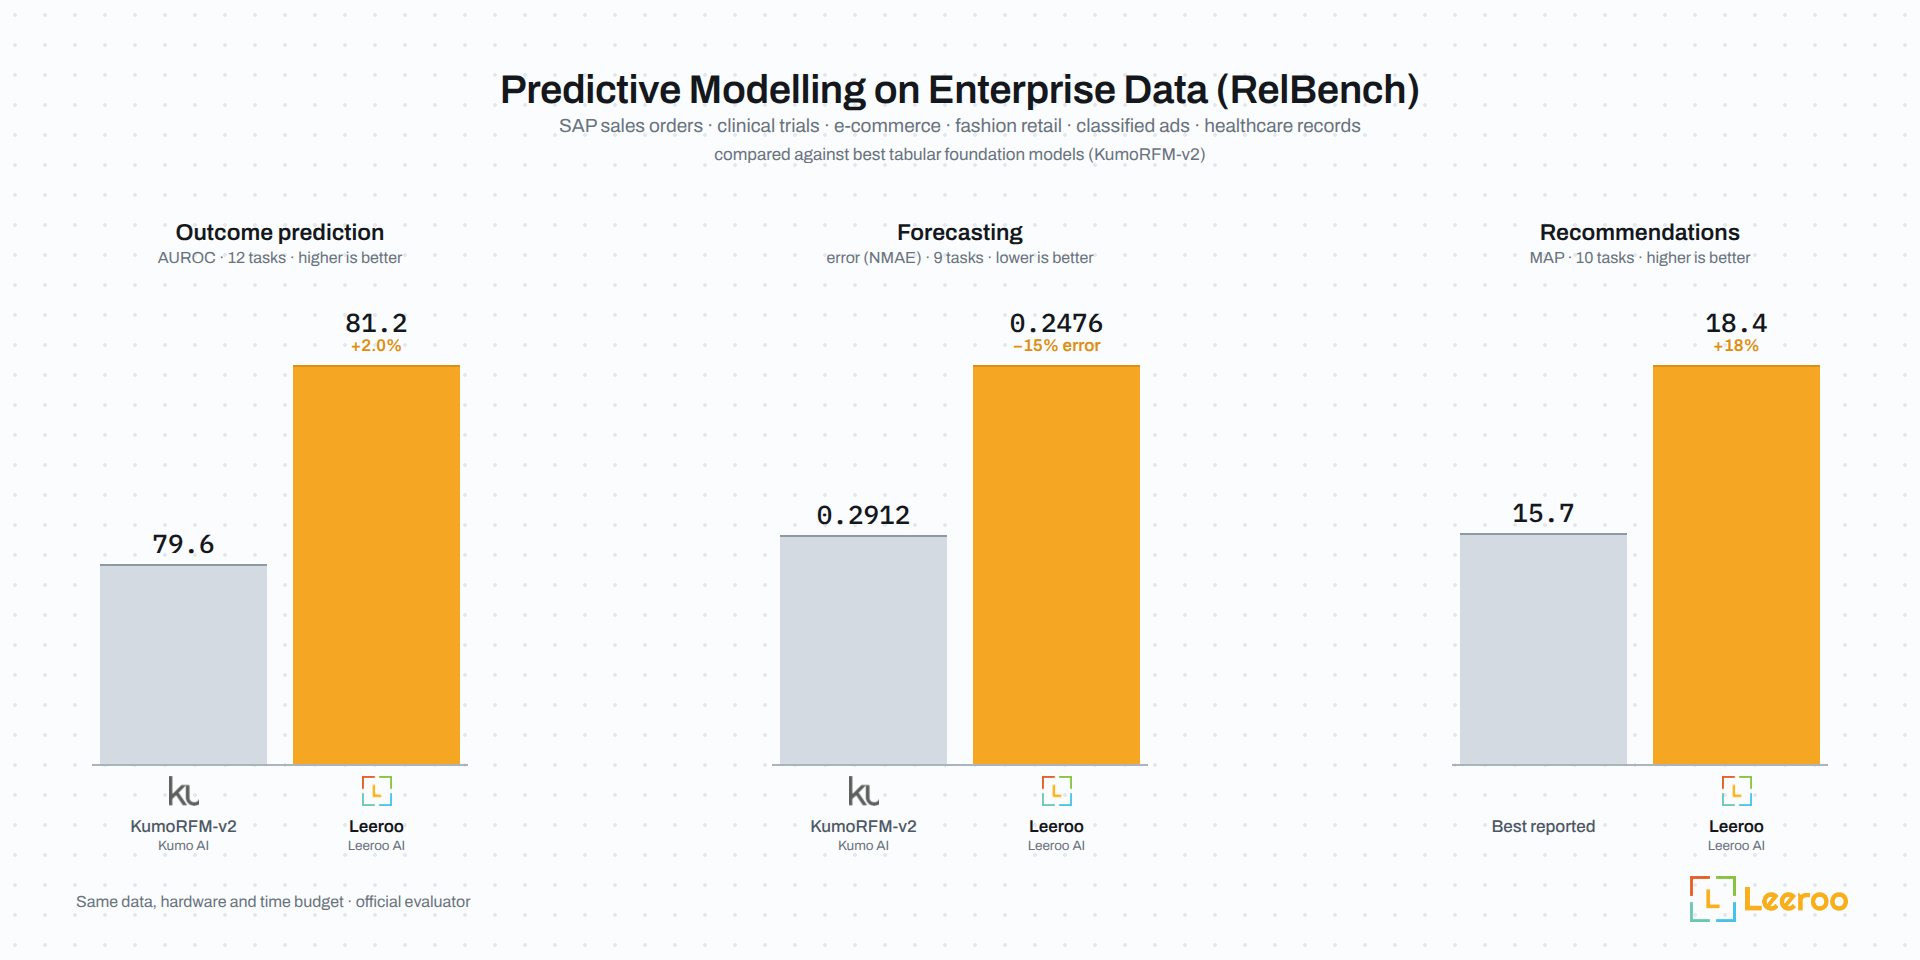
Primero en los tres rankings de RelBench. En el benchmark de Stanford para ML predictivo sobre datos relacionales, Kapso lidera el ranking oficial en clasificación (81.2 de AUROC frente a 79.3 de KumoRFM-v2 y 79.0 de RT-J de Stanford STAR), regresión (0.2476 de NMAE frente a 0.2711 y 0.2847) y recomendaciones (18.4 de MAP frente a 9.3 de ID-GNN, la mejor de las demás entradas).
Leeroopedia: nuestro banco de lecciones público en los dominios de datos y ML, alrededor de 100k páginas extraídas experimentando sobre artículos y repositorios, que atiende unas 6M de solicitudes al mes, alrededor del 28% de ellas procedentes de agentes de IA. Las sesiones de Kapso lo consultan por MCP durante la ideación y la implementación.
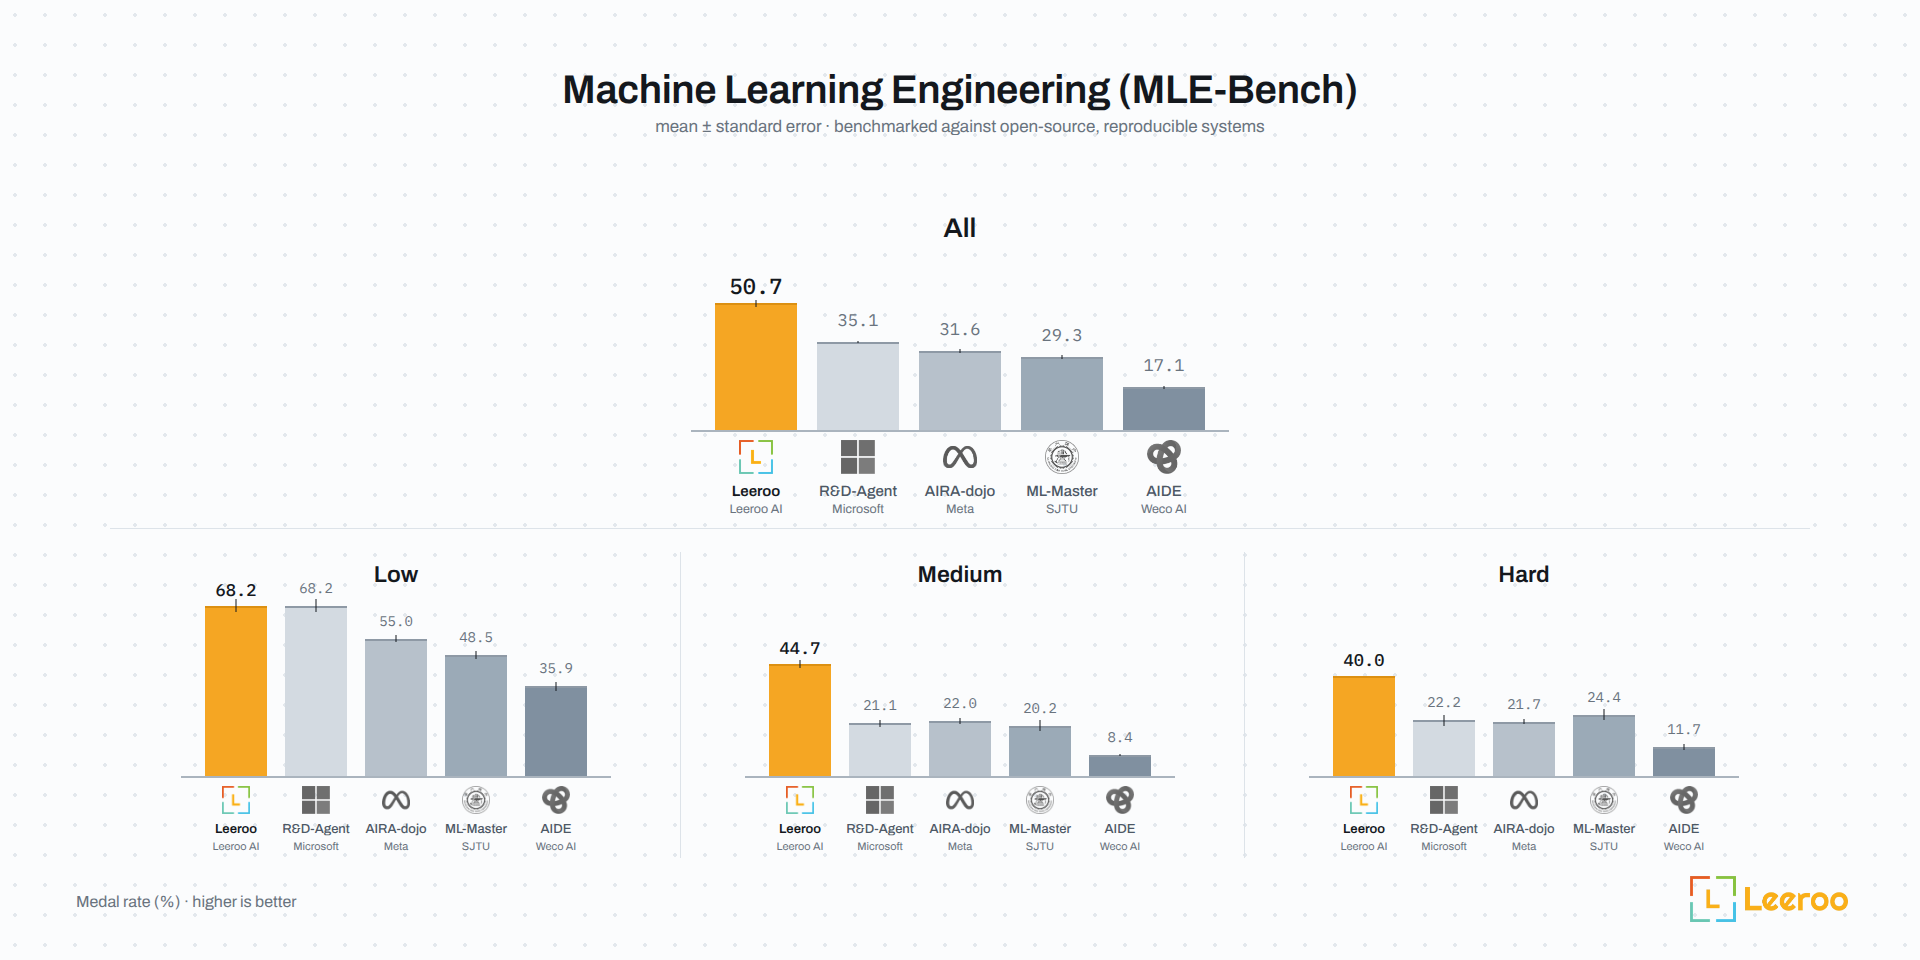
#1 en MLE-Bench: KAPSO logró la primera posición entre los sistemas de código abierto en competiciones de ML de Kaggle (MLE Benchmark).
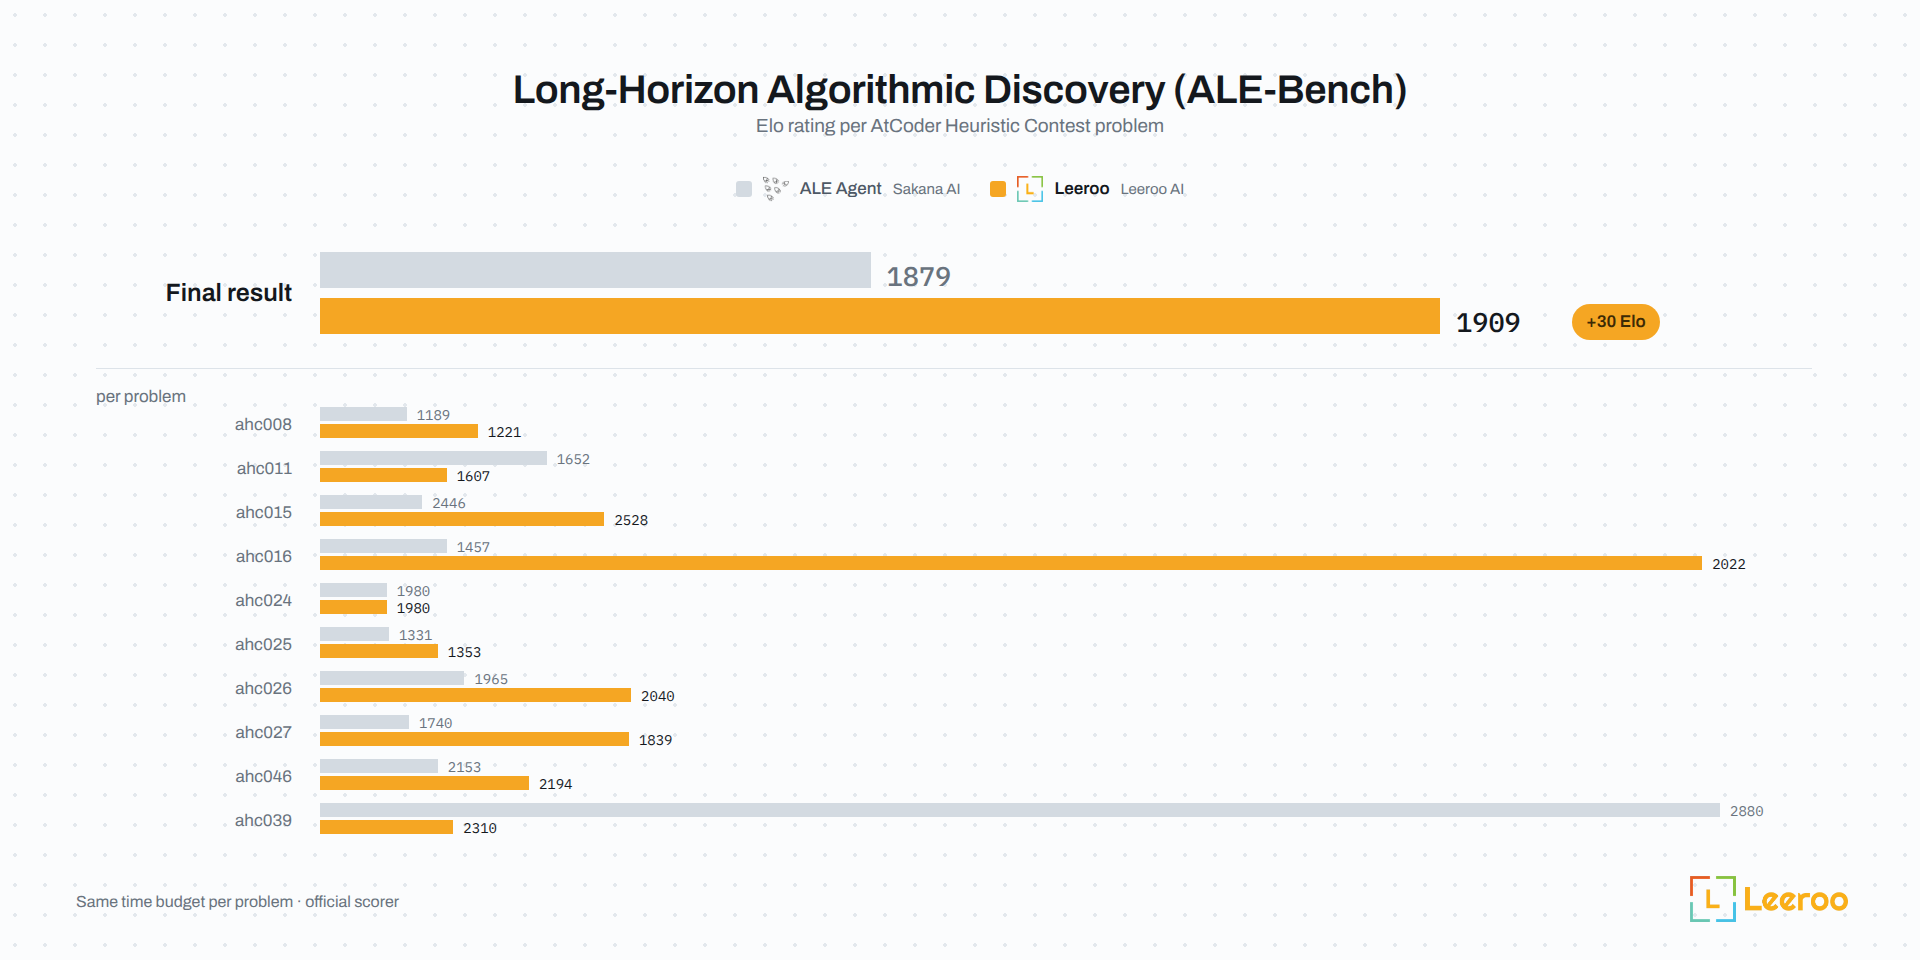
#1 en ALE-Bench: KAPSO logró la primera posición en problemas de descubrimiento algorítmico de horizonte largo (ALE Benchmark).
¿Qué es Kapso?
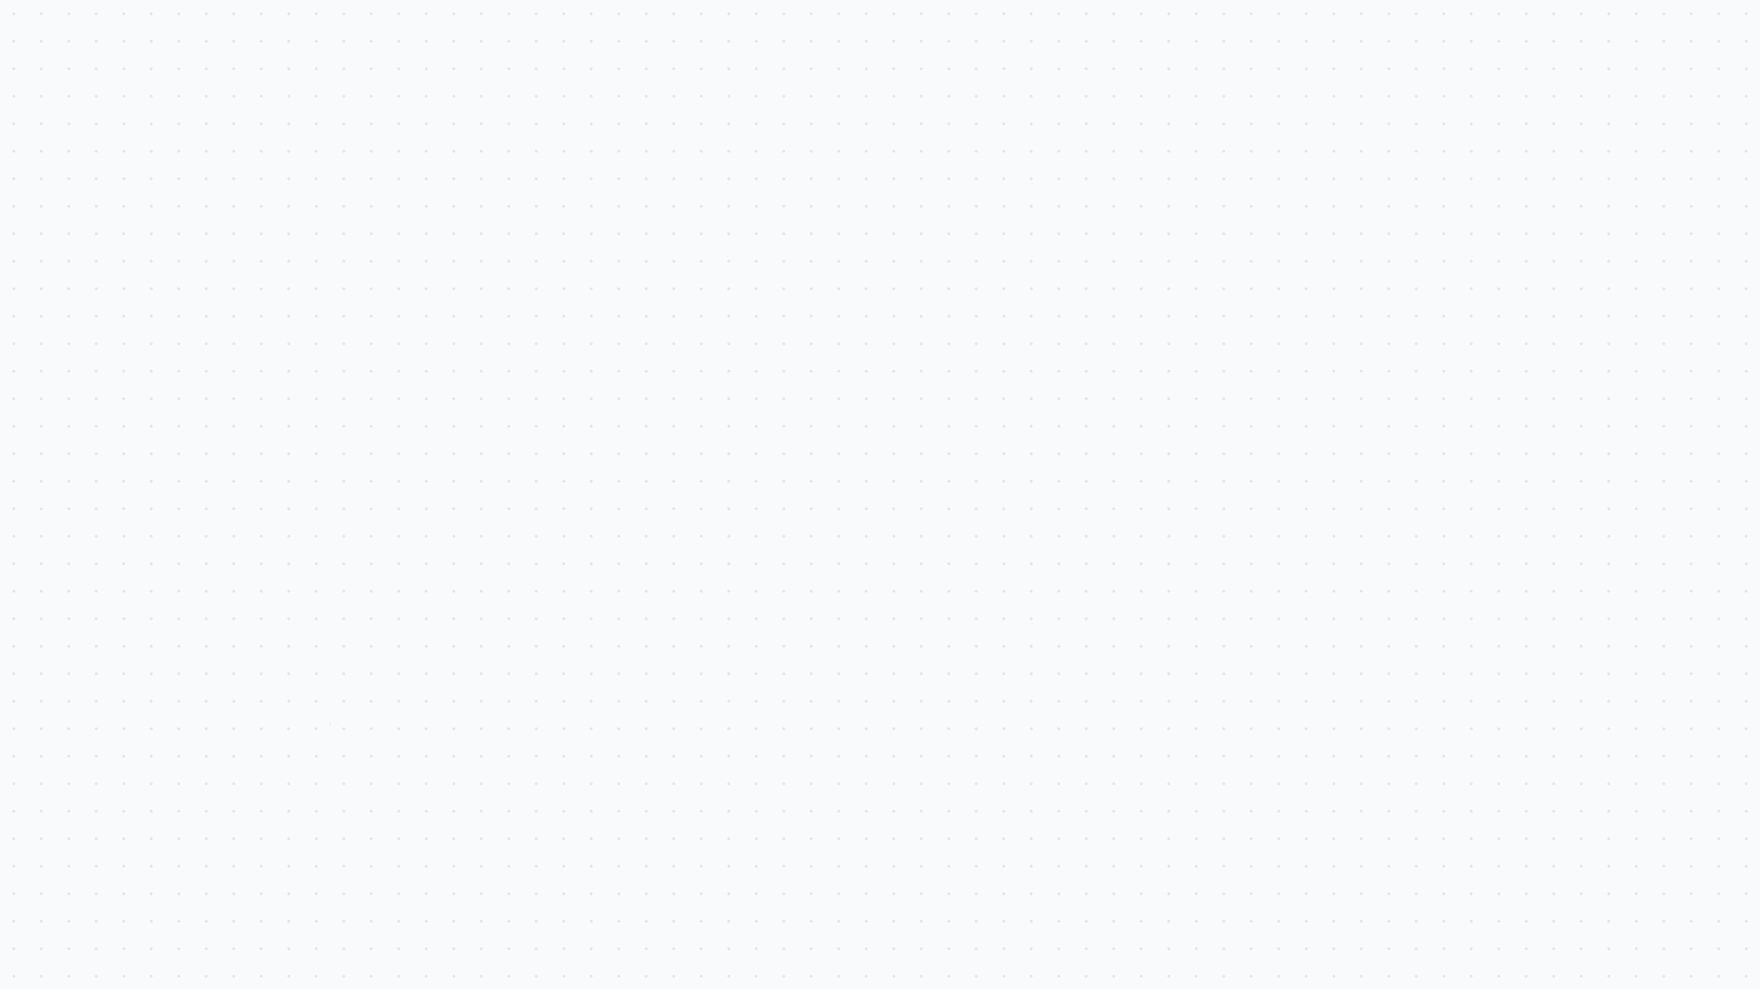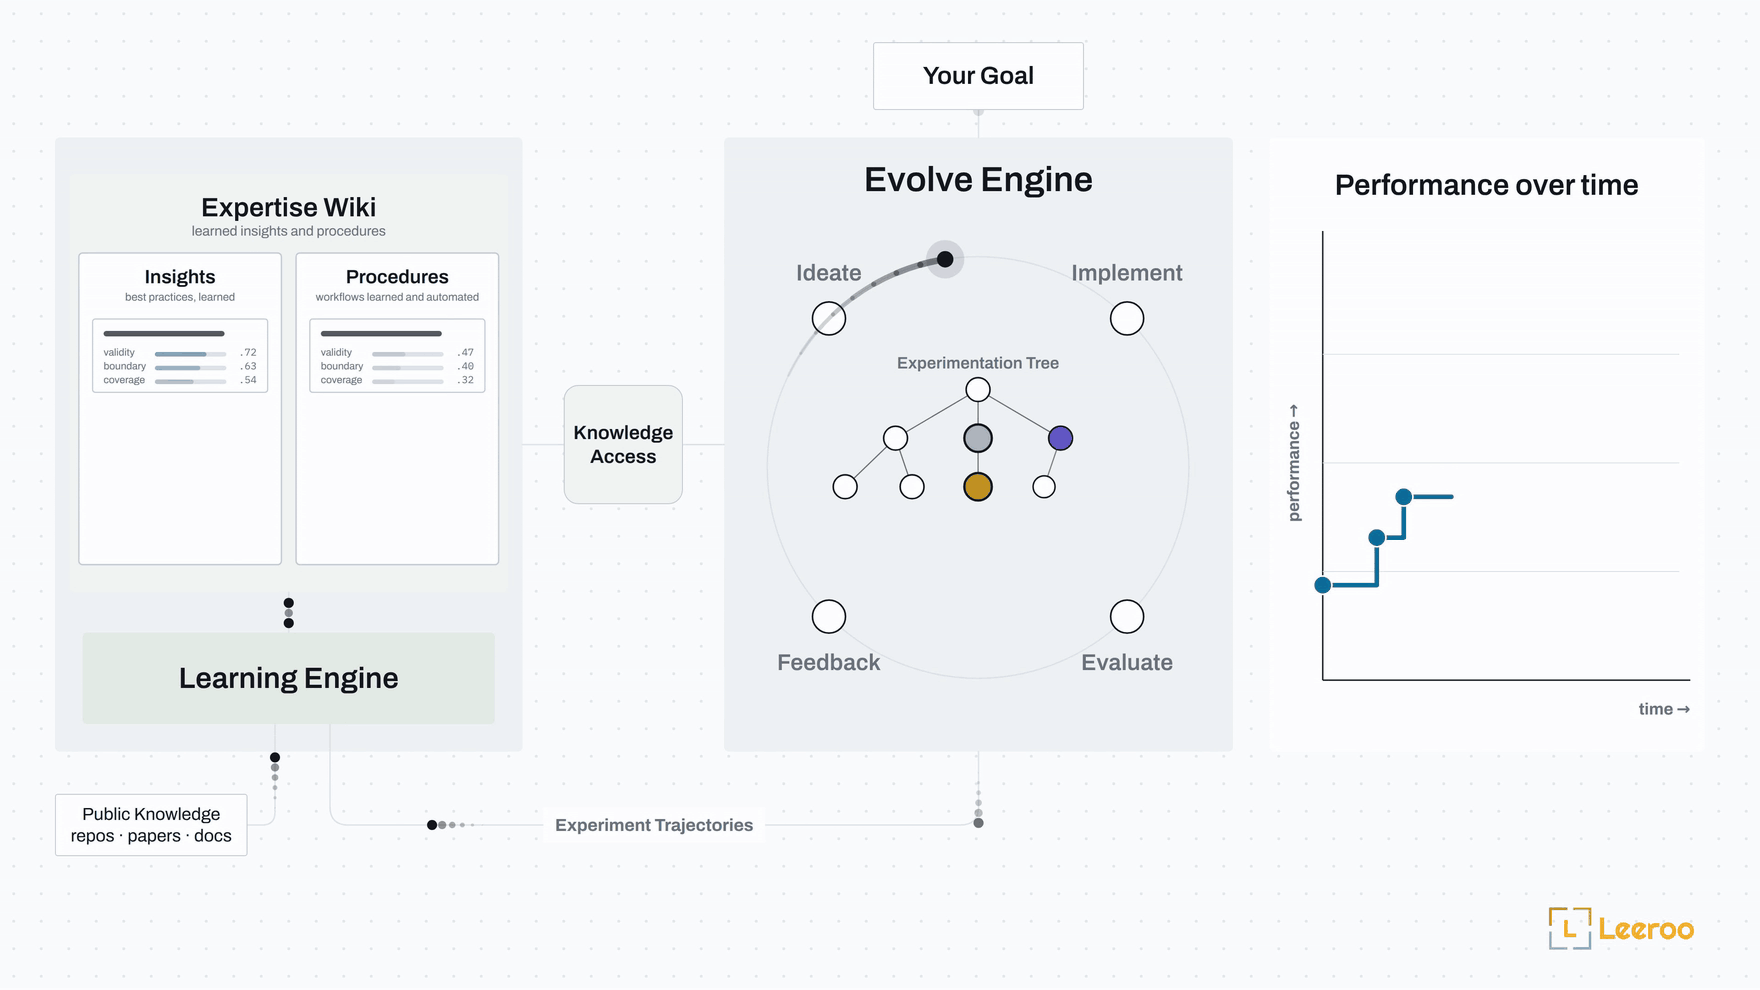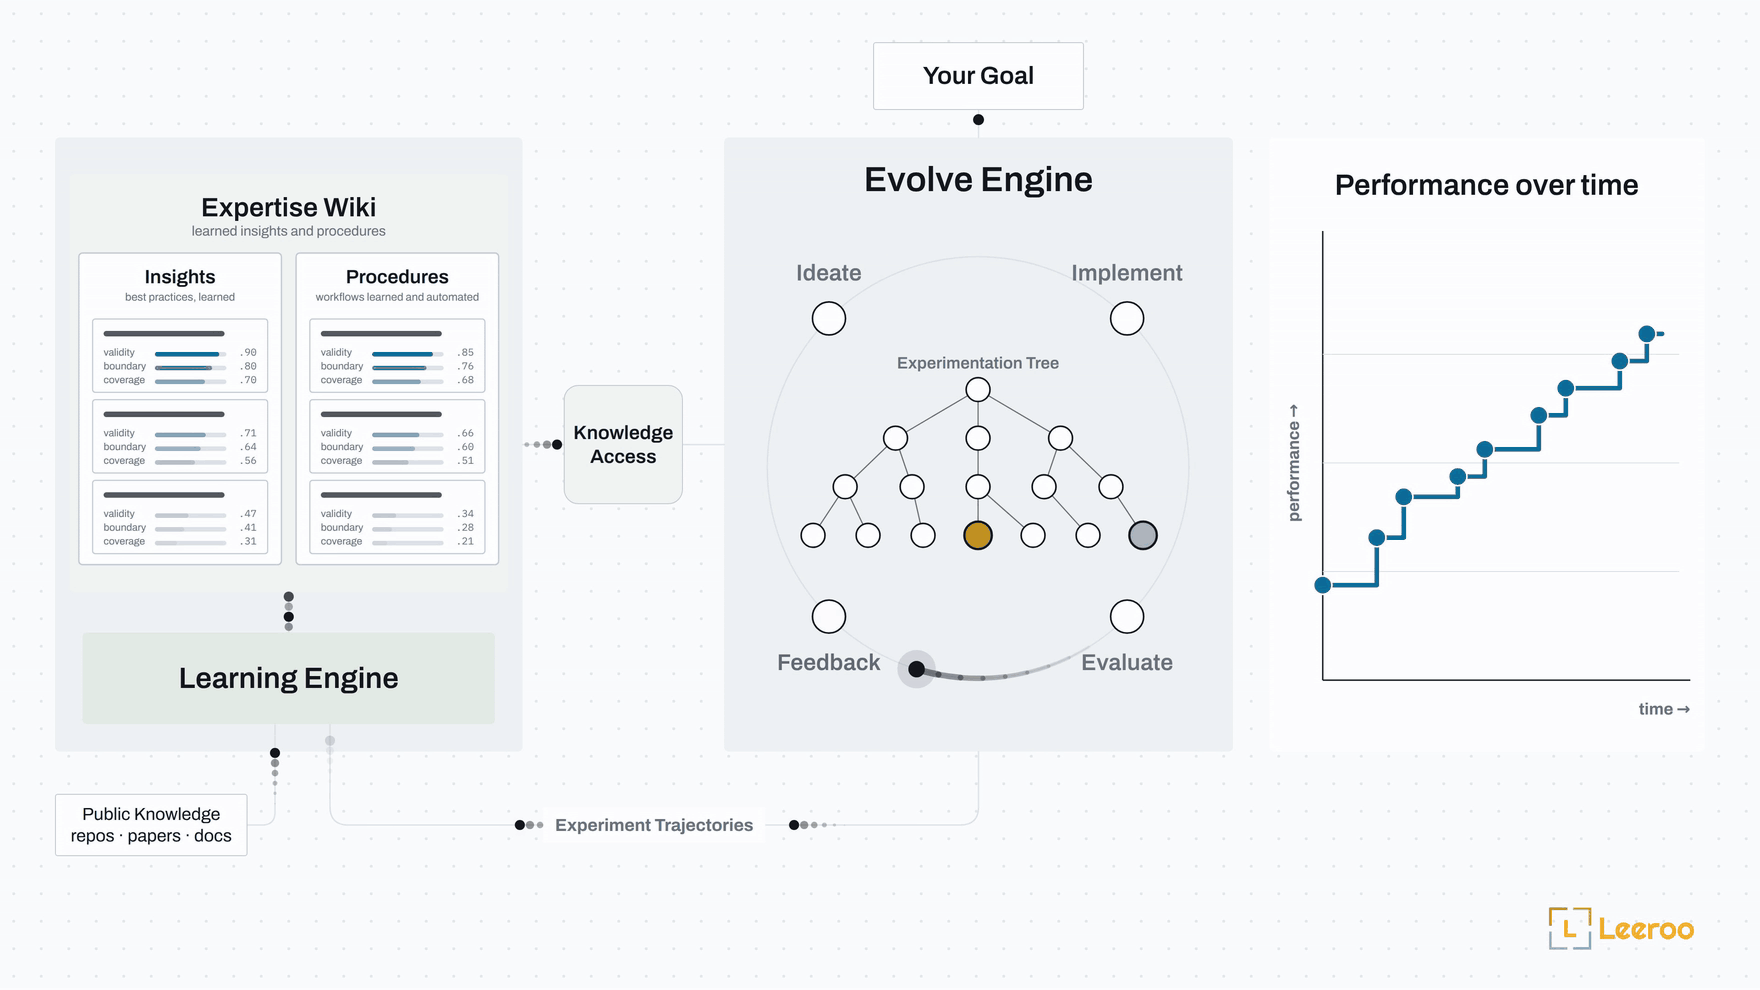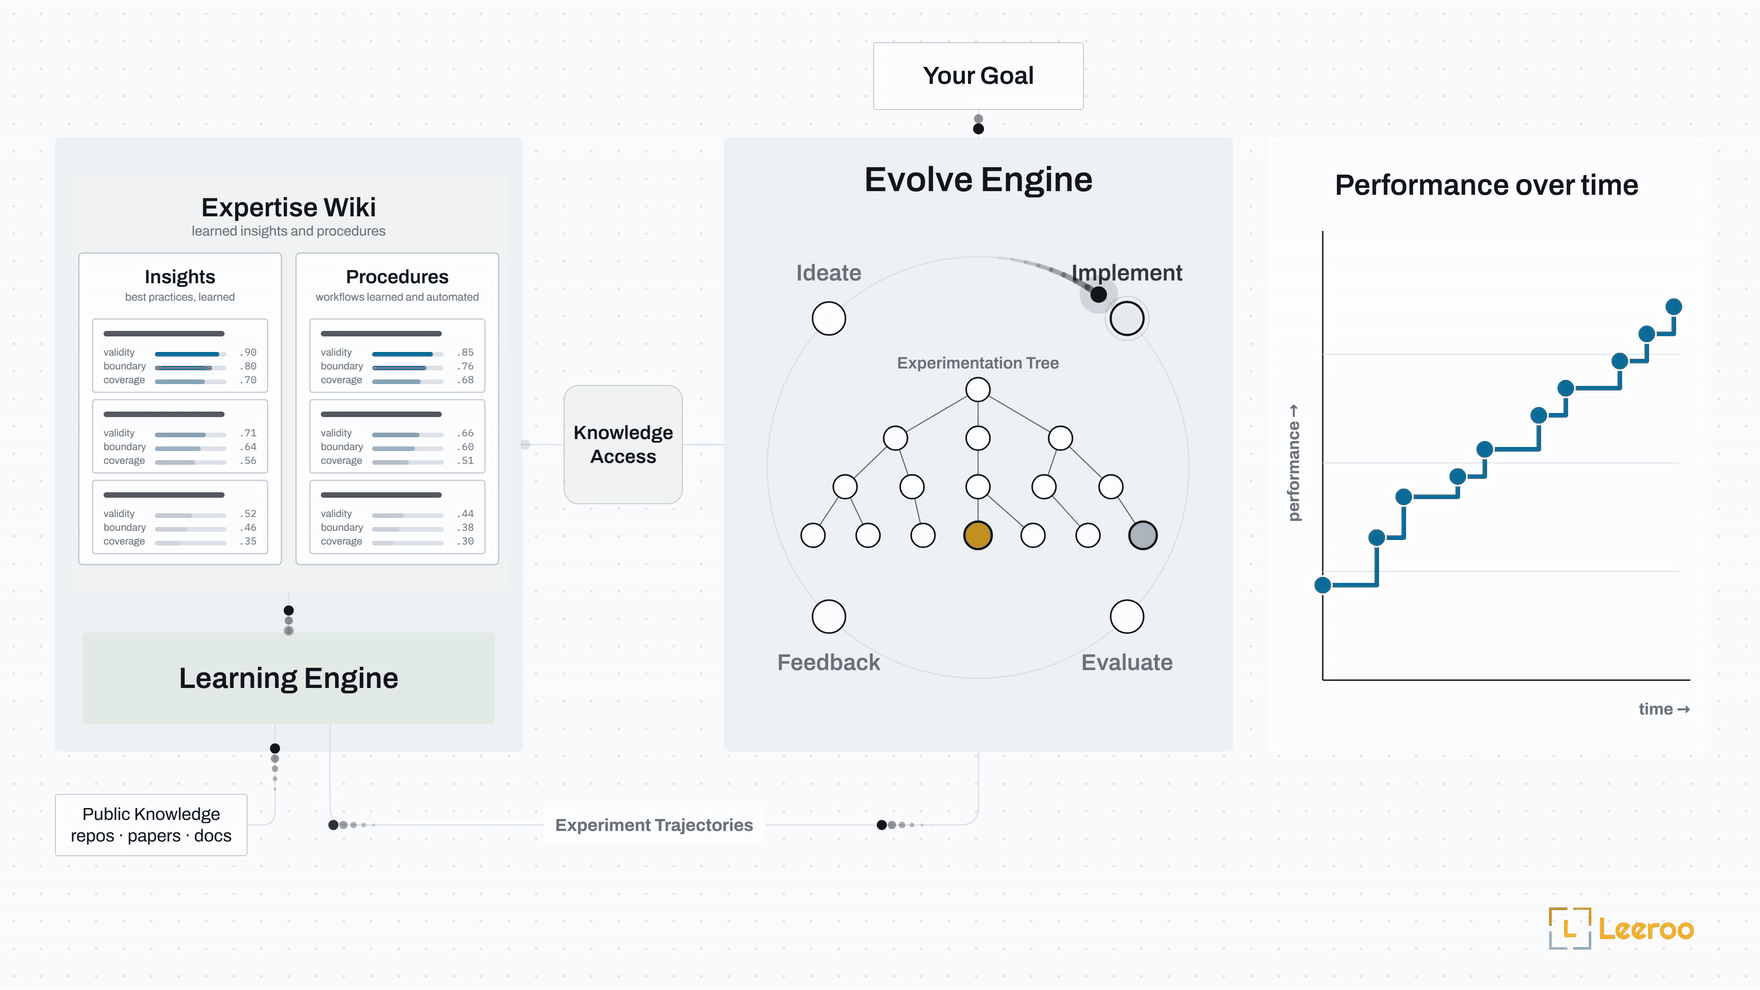
Kapso es un motor de código abierto que ejecuta experimentos, despliega la mejor solución y aprende de cada ejecución. Parte de un harness de dominio y de un banco de lecciones vacío y, dados un objetivo y unos criterios de éxito:
- ejecuta un árbol de experimentos: propone hipótesis y después implementa y verifica cada una;
- despliega la mejor solución en el stack de destino;
- aprende de la ejecución: cada hipótesis e implementación recibe crédito según su impacto en el resultado, y el banco se actualiza, con cada lección portando una puntuación de credibilidad y un límite de dónde se aplica.
Con el tiempo, el harness de dominio lleva consigo un banco de lecciones: las mejores prácticas experimentadas de ese entorno. Kapso es agnóstico respecto al modelo y al agente de programación, está hecho por Leeroo y se publica en PyPI como leeroo-kapso.
Las cuatro partes
| Parte | Verbo | Qué hace |
|---|---|---|
| Experimentación inteligente | .build() |
Cada experimento es una hipótesis implementada en su propia rama y puntuada, dentro de un árbol. La ideación se nutre de experimentos anteriores y del banco de lecciones y reordena las ideas según el retorno esperado frente al presupuesto, de modo que encajan en este entorno en lugar de ser las genéricas de un LLM a secas o de un RAG; un evaluador con huella digital que ningún experimento puede tocar verifica el resultado, y los módulos pueden proponer actualizaciones de la evaluación para que el verificador las apruebe. Cómo funciona → |
| Aprendizaje | .learn() / .load_experience() |
Cada lección se induce o se deduce a partir de trazas de experimentación y lleva una puntuación de credibilidad, un límite de dónde se aplica y su evidencia; learn() las actualiza con el resultado de cada ejecución y somete cada cambio a una prueba A/B reconstruyendo con y sin él, de modo que la mejora se mide, no se supone. El banco está construido sobre git: kapso experience share, list y update. Experiencia → nombra lo que se le sirve a un build. |
| Despliegue | .deploy() |
Una experimentación más corta del mismo tipo adapta la mejor solución al stack de destino, la despliega y demuestra las comprobaciones de salud y una llamada que funciona. Docker, Modal, BentoCloud y LangGraph Platform vienen incluidos; un harness puede añadir un destino. |
| Adaptación al dominio | kapso harness |
Un harness es el paquete de dominio de Kapso: el conocimiento y los flujos de trabajo de un área como el modelado predictivo, para que un build nunca empiece desde cero, y el lugar donde se acumula el banco de lecciones. El modelado predictivo y la programación competitiva vienen incluidos; escribe el tuyo con /kapso:harness en el plugin o con kapso harness en la CLI. |
🚀 Inicio rápido

▶ Mira el recorrido antes de instalar
Instalación
0. ¿Estás en un agente de programación? Instala el plugin de Kapso y deja que recorra contigo los pasos siguientes:
claude plugin marketplace add Leeroo-AI/kapso && claude plugin install kapso@kapso   # Claude Code
codex plugin marketplace add Leeroo-AI/kapso && codex plugin add kapso@kapso         # Codex
Después, /kapso:setup instala y verifica, y /kapso:build <what you want>
lanza la primera campaña (en Codex: $kapso-setup, $kapso-build <what you want>). Consulta El plugin de Kapso.
1. Requisitos previos. Kapso ejecuta su inferencia a través de las CLI de agentes de programación (no hay alternativa de API directa), así que necesitas Node.js y ambas CLI de agente con sesión iniciada antes de que nada funcione:
# Node.js 18+ (https://nodejs.org), después:
npm install -g @openai/codex            # investigación, evaluación como juez, utilidades
codex login

npm install -g @anthropic-ai/claude-code  # ideación + implementación (el host por defecto)
claude auth login
Una clave de OpenAI es opcional: solo el grafo de conocimiento y la búsqueda semántica
sobre experimentos pasados (models.embedding en tu configuración) generan embeddings del texto, y
la generación nunca la usa. Cuando actives cualquiera de los dos:
echo 'OPENAI_API_KEY=sk-...' >> .env
2. Conecta Leeroopedia (recomendado). Una clave da a cada sesión Leeroopedia, nuestro banco de lecciones alojado sobre ML y frameworks de IA. Nada que instalar; una cuenta nueva en el panel de Leeroopedia viene con $20 de crédito gratuito.
echo 'LEEROOPEDIA_API_KEY=kpsk_...' >> .env
3. Instala el paquete (Python 3.10+):
pip install leeroo-kapso
4. Verifica la configuración:
kapso doctor
doctor informa de lo que tu configuración necesita realmente y nombra la solución
exacta para todo lo que falte. Los requisitos siguen a la configuración, así que a una
instalación solo con codex nunca se le pide claude. Acótalo a un verbo para ver solo los
requisitos de ese verbo:
kapso doctor build # o learn / deploy / experience
Esas son las mismas comprobaciones que el propio verbo ejecuta antes de hacer ningún trabajo:
kapso.build(...) falla en segundos por una CLI que falta en lugar de hacerlo en lo
profundo de una sesión. Los elementos marcados [-- ] son opcionales; limitan funciones
que quizá no necesites (docker, Weaviate, Neo4j, los destinos de despliegue).
O deja que tu agente de programación haga todo esto: pega el prompt de configuración en Claude Code, Codex u OpenCode.
Los almacenes que necesita un índice (opcional): kapso experience add --repo
y --research ingieren un corpus en Weaviate + Neo4j locales. Desde un
checkout del código fuente:
bash scripts/start_infra.sh # arranca ambos mediante docker
Desde el código fuente (para desarrollo)
git clone https://github.com/leeroo-ai/kapso.git
cd kapso

conda create -n kapso python=3.12 && conda activate kapso
pip install -e .
El adaptador heredado de aider es un extra (pip install "leeroo-kapso[aider]",
Python <3.13); los agentes claude/codex por defecto no necesitan extras.
Uso básico
Los verbos principales no necesitan nada más allá de los requisitos previos anteriores:
from kapso import Kapso, Budget

kapso = Kapso()   # no hace falta un grafo de conocimiento para empezar

# Build: una solución mediante experimentación. La campaña imprime
# `status: <path>` al lanzarse; síguela en directo desde otro terminal con
#     kapso watch ./campaign
# Si una sesión necesita algo que solo tú puedes proporcionar (una clave de API, un archivo),
# la campaña se pausa y `kapso inbox reply` la reanuda:
#     https://docs.leeroo.com/docs/build/inbox
# Comparte el resultado como Markdown para un pull request o un issue con
#     kapso report ./campaign -o report.md
solution = kapso.build(
    "Optimize the model in train.py; target accuracy > 0.80 on evaluate.py",
    repo="./my_project",                 # u omítelo para empezar desde cero
    output="./campaign",
    budget=Budget(minutes=120),
)
print(solution.explain())

# Aprende de la campaña que acabas de ejecutar: extrae la trayectoria, califica las
# lecciones y guarda en el banco tarjetas de conocimiento valoradas por su evidencia. El banco (un
# repositorio git local) se crea automáticamente en el primer uso; las lecciones se quedan en tu
# máquina hasta que las compartas:
#     kapso experience share <git-url>
# tras lo cual cada learn() hace push del banco allí.
lesson = kapso.learn(solution)
print(lesson.explain())

# Vuelve a hacer build, sirviéndole las tarjetas que acaba de ganar: a un build se le sirve
# exactamente la experiencia que carga.
kapso.load_experience("mine")
solution2 = kapso.build("...", output="./campaign2")
Con los almacenes en marcha, también puedes ingerir conocimiento externo en un índice y servirlo del mismo modo:
from kapso import Kapso

kapso = Kapso()

# Una vez: un repositorio, o la web investigada para una pregunta, a un índice
kapso.add_experience(repo="https://github.com/huggingface/trl", name="trl")
kapso.add_experience(research="RLHF and DPO fine-tuning for legal contract analysis", name="dpo-legal")

# Cada build que carga el índice lo busca; Leeroopedia va incluida con su clave
kapso.load_experience("trl")
kapso.load_experience("leeroopedia")
solution = kapso.build("Fine-tune Llama-3.1-8B for clause risk classification")
Una nota sobre el presupuesto: una ingesta extrae todo lo que el material permite. Una sola pregunta puede convertirse en decenas de páginas enlazadas y una ingesta de horas; el tiempo de ingesta crece con la sustancia extraíble, así que añade las fuentes que vas a buscar, no todas las fuentes que tienes.
Y para convertir una solución en software en ejecución:
software = kapso.deploy(solution, target="local")   # o docker, modal, bentoml, langgraph, auto
result = software.run(software.proof["inputs"])     # la llamada que el despliegue demostró
software.stop()
¿Cómo acoto una campaña?
Usa max_iterations, time_budget_minutes y cost_budget para acotar las iteraciones, el tiempo transcurrido y el gasto aproximado en modelos en USD.
Para los costes de plataforma, activa la selección consciente del coste en search_strategy.params.cost con tu estimador, cap_per_candidate y campaign_budget; su weight también permite que la selección prefiera candidatos más baratos.
Elegir los modelos
Cada modelo que usa Kapso está nombrado en un único archivo de configuración. El valor por
defecto empaquetado ejecuta las sesiones de build en claude-opus-5, los equipos de aprendizaje en
claude-fable-5 y los roles de codex en gpt-5.6-sol, pero el acceso a los modelos
depende de la suscripción (un plan puede limitar un modelo mientras sirve otro).
Para ejecutar con otros modelos, copia la configuración empaquetada, edítala y apunta
Kapso a la tuya:
from pathlib import Path
import yaml
from kapso import Kapso
from kapso.kapso import DEFAULT_CONFIG_PATH

config = yaml.safe_load(Path(DEFAULT_CONFIG_PATH).read_text())
# p. ej., ejecutar los equipos de aprendizaje en opus en lugar de fable:
crews = yaml.safe_dump(config).replace("claude-fable-5", "claude-opus-5")
Path("kapso-config.yaml").write_text(crews)

kapso = Kapso(config="kapso-config.yaml")
Los roles de inferencia solo de texto pueden optar por las Chat Completions openai_compatible.
Define el modelo y el endpoint en tu configuración; las credenciales se quedan en el entorno.
Carga la configuración con Kapso(config=...) o kapso build --config ....
La programación y la investigación web siguen requiriendo agentes con las herramientas correspondientes.
Consulta el ejemplo de configuración y sus limitaciones.
Antes de una ejecución larga, sondea cada modelo que nombra tu configuración contra tus suscripciones reales: un modelo que tu inicio de sesión no puede servir falla aquí en segundos en lugar de horas después dentro de una ejecución. Un tope de uso en un modelo que sí puedes servir no es visible para una sonda de un token:
kapso doctor --models                            # configuración empaquetada
kapso doctor --models --config kapso-config.yaml # la tuya
kapso doctor learn --models                      # solo los equipos de aprendizaje
Para que esa sonda forme parte de cada llamada en lugar de ser algo que tienes que acordarte
de ejecutar, actívala en tu configuración. Cuesta un token desechable por cada par
{cli, model} distinto, lo que merece la pena antes de un learn() desatendido
de varias horas:
preflight:
  enabled: true            # comprobaciones estáticas antes de cada verbo (por defecto)
  live_model_probe: true   # + sondas de modelo de un token (por defecto: false)
Los cambios de modelo también cambian el ritmo: los topes timeout_minutes de los equipos en la
configuración se calibraron con los modelos por defecto, y un modelo sustituto que
razona durante más tiempo puede necesitar que se eleven.
Para ver los pasos de integración en detalle, consulta las guías de Inicio rápido e Instalación.
Benchmarks compatibles
| Benchmark | Descripción |
|---|---|
| MLE-Bench | El benchmark de ingeniería de ML de OpenAI: competiciones completas en tabular, visión, texto y audio, desde los datos en bruto hasta la entrega calificada |
| ALE-Bench | El benchmark de optimización algorítmica de Sakana AI: diseñar, implementar e iterar heurísticas de concurso en búsquedas de horas de duración |
| RelBench | El benchmark de Stanford para ML predictivo sobre datos relacionales: clasificación, regresión y recomendación directamente desde las bases de datos multitabla de Amazon, H&M, Stack Exchange, ensayos clínicos y más |
| IOAI 2026 | ML de olimpiada contrarreloj en visión, lenguaje y optimización: tareas fijadas por expertos, hardware de concurso, sin ayuda humana alguna |
Cada benchmark también tiene una página de documentación que explica cómo ejecutarlo, sus opciones de CLI y qué contiene la salida: IOAI 2026 · MLE-Bench · ALE-Bench · RelBench
Ejemplos
Cada ejemplo es una tarea: un brief, un repositorio de partida, los datos o cómo obtenerlos, y un driver de como máximo doce líneas; examples/README.md tiene los minutos y el único comando.
| Ejemplo | La tarea |
|---|---|
| Ingeniería de datos (modelos dbt en Snowflake) | Corregir los modelos dbt con problemas de calidad de datos y construir los nuevos que pide un backlog de diecisiete tickets, sobre un almacén de datos minorista en Snowflake, hasta que cada ticket supere sus pruebas de producción; después entregar una pull request por ticket y publicarlas en producción. |
| Optimización del harness (agente de atención al cliente) | Optimizar el harness de un agente de atención al cliente para cambiar el LLM subyacente de Fable 5.1 a un Qwen 27B local sin perder resolución en las conversaciones con clientes, y después desplegarlo en Docker y aprender de la ejecución. |
| Modelado predictivo (abandono de clientes) | Predecir qué clientes se irán: elevar el ROC AUC fuera de muestra de un modelo de abandono hacia el objetivo, bajo un evaluador que la campaña no puede editar. |
| Detección de fraude | Puntuar transacciones en busca de fraude cuando el repositorio no tiene evaluador: el brief enuncia el protocolo, la campaña construye primero el evaluador y después mejora el puntuador. |
| Finanzas cuantitativas | Una estrategia de trading diaria sobre instrumentos sintéticos: elevar el Sharpe fuera de muestra en el harness de trading, con sus comprobaciones en cada intento. Un ejemplo de investigación, no asesoramiento financiero. |
| ML tabular | Una competición de Kaggle de principio a fin: Spaceship Titanic desde un clasificador dummy hasta un modelo real, y después revisar, aprender, volver a construir con la lección y desplegar. |
| Optimización de PyTorch | Hacer más rápido un módulo de PyTorch en CUDA dentro de una tolerancia numérica: fusión, compilación, menos tráfico de memoria. |
| Optimización de kernels de GPU | Acelerar la autoatención multicabezal en CUDA con flash attention o un kernel de Triton, dentro de una tolerancia numérica. |
📚 Documentación y soporte
- Documentación completa: docs.leeroo.com
- Instalación: las CLI de agentes de programación, el paquete y
kapso doctor - Inicio rápido: tu primera campaña
- Referencia de la CLI: cada comando, flag y valor por defecto
- API de Python: cada método público de
Kapso - Configuración: cada clave de
config.yaml - Qué produce learn: el banco de lecciones, cada una con una puntuación de credibilidad, un límite y su evidencia, y el modo de desarrollo
- Experimentación inteligente: el árbol de experimentos y sus módulos, y qué ocurre dentro de un experimento
- Experiencia: tu banco, Leeroopedia, repositorios y artículos convertidos en conocimiento consultable
- Deploy: local, Docker, Modal y los demás destinos
- El plugin de Kapso: los comandos, las skills y el servidor MCP para Claude Code, Codex y Cursor
- Instalación: las CLI de agentes de programación, el paquete y
- Desde tu agente de programación: la documentación ejecuta un servidor MCP en
https://docs.leeroo.com/mcp, y cada página se sirve como Markdown; consulta llms.txt y Kapso en tu agente de programación.claude mcp add --transport http kapso-docs https://docs.leeroo.com/mcp # Claude Code codex mcp add kapso-docs --url https://docs.leeroo.com/mcp # Codex CLI - Deja que tu agente de programación ejecute Kapso: el plugin bajo
plugin/incluye diez comandos, seis skills y el servidor MCP, una línea de instalación por host (paso 0 anterior); OpenCode carga las skills como una carpeta (ln -s <clone>/plugin/skills .opencode/skills). Consulta El plugin de Kapso. - Dale a tu agente de programación las herramientas de conocimiento de Kapso:
kapso-mcp, que se instala con el paquete, sirve investigación web, la memoria del repositorio, el historial de experimentos de la campaña y el banco de lecciones a la sesión en la que trabajas; consulta Puertas MCP.claude mcp add kapso -- kapso-mcp # Claude Code codex mcp add kapso -- kapso-mcp # Codex CLI; después `startup_timeout_sec = 60` bajo [mcp_servers.kapso] en ~/.codex/config.toml (los diez segundos de Codex se quedan cortos en una máquina ocupada) - Comunidad: Discord
- Sitio web: leeroo.com
Kapso para empresas
En la empresa, los agentes de Kapso vienen con harnesses iniciales de ingeniería de datos y de IA y un banco de lecciones, y convierten por sí solos objetivos de negocio en sistemas de IA y de datos que funcionan, investigando los artefactos, repositorios, pipelines, fuentes de datos y demás de la compañía, para ir construyendo el patrimonio de datos de la empresa sobre la marcha. Para incorporar Kapso a las tareas de tu empresa, habla con nosotros.
Contribuir
¡Agradecemos las contribuciones! Consulta nuestra Guía de contribución para saber cómo empezar.
Colaboradores
Hecho con contrib.rocks.
Explorar proyectos relacionados
tensorflow/tensorflow
Un framework de código abierto de aprendizaje automático para todos
201,594 estrellashuggingface/transformers
🤗 Transformers: el framework de definición de modelos para modelos de aprendizaje automático de vanguardia en texto, visión, audio y multimodal, tanto para inferencia como para entrenamiento.
168,962 estrellasAUTOMATIC1111/stable-diffusion-webui
Interfaz web de Stable Diffusion
165,311 estrellasComfy-Org/ComfyUI
La GUI, la API y el backend más potentes y modulares para modelos de difusión, con una interfaz de grafos y nodos. El motor de inferencia local más rápido del mundo.
146,759 estrellas