
ClickHouse/loom has 108 GitHub stars and 15 forks. GitHot measured +51 stars in 24 hours. Last checked 2026-11-15 22:12 UTC. Last push 2026-11-14.
Crecimiento de estrellas medido
- in 24h
- +51
- in 7 days
- Actualización retrasada
- in 15 days
- Actualización retrasada
- in 1 month
- Actualización retrasada
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
Acerca de
Shared long-term memory, document search and a code index for AI agents, linked to your code. Memories point at the files and symbols they're about and surface when an agent edits them. MCP server, Claude Code and Codex plugins, SDKs. Self-hosted on ClickHouse.
IAi18n/es/README.md
OriginalEsta página es una traducción automática de la página en inglés, que prevalece. Machine-translated from the English page, which is authoritative.
ClickHouse Loom
Memoria compartida, búsqueda de documentos e inteligencia de código para agentes de IA.
Para Claude Code, Codex, Cursor y tus propios agentes.


English · 简体中文 · 日本語 · 한국어 · Português (Brasil) · Español · Русский
Para qué sirve Loom · Pruebas de rendimiento · Primeros pasos · Capacidades · Integraciones · Documentación
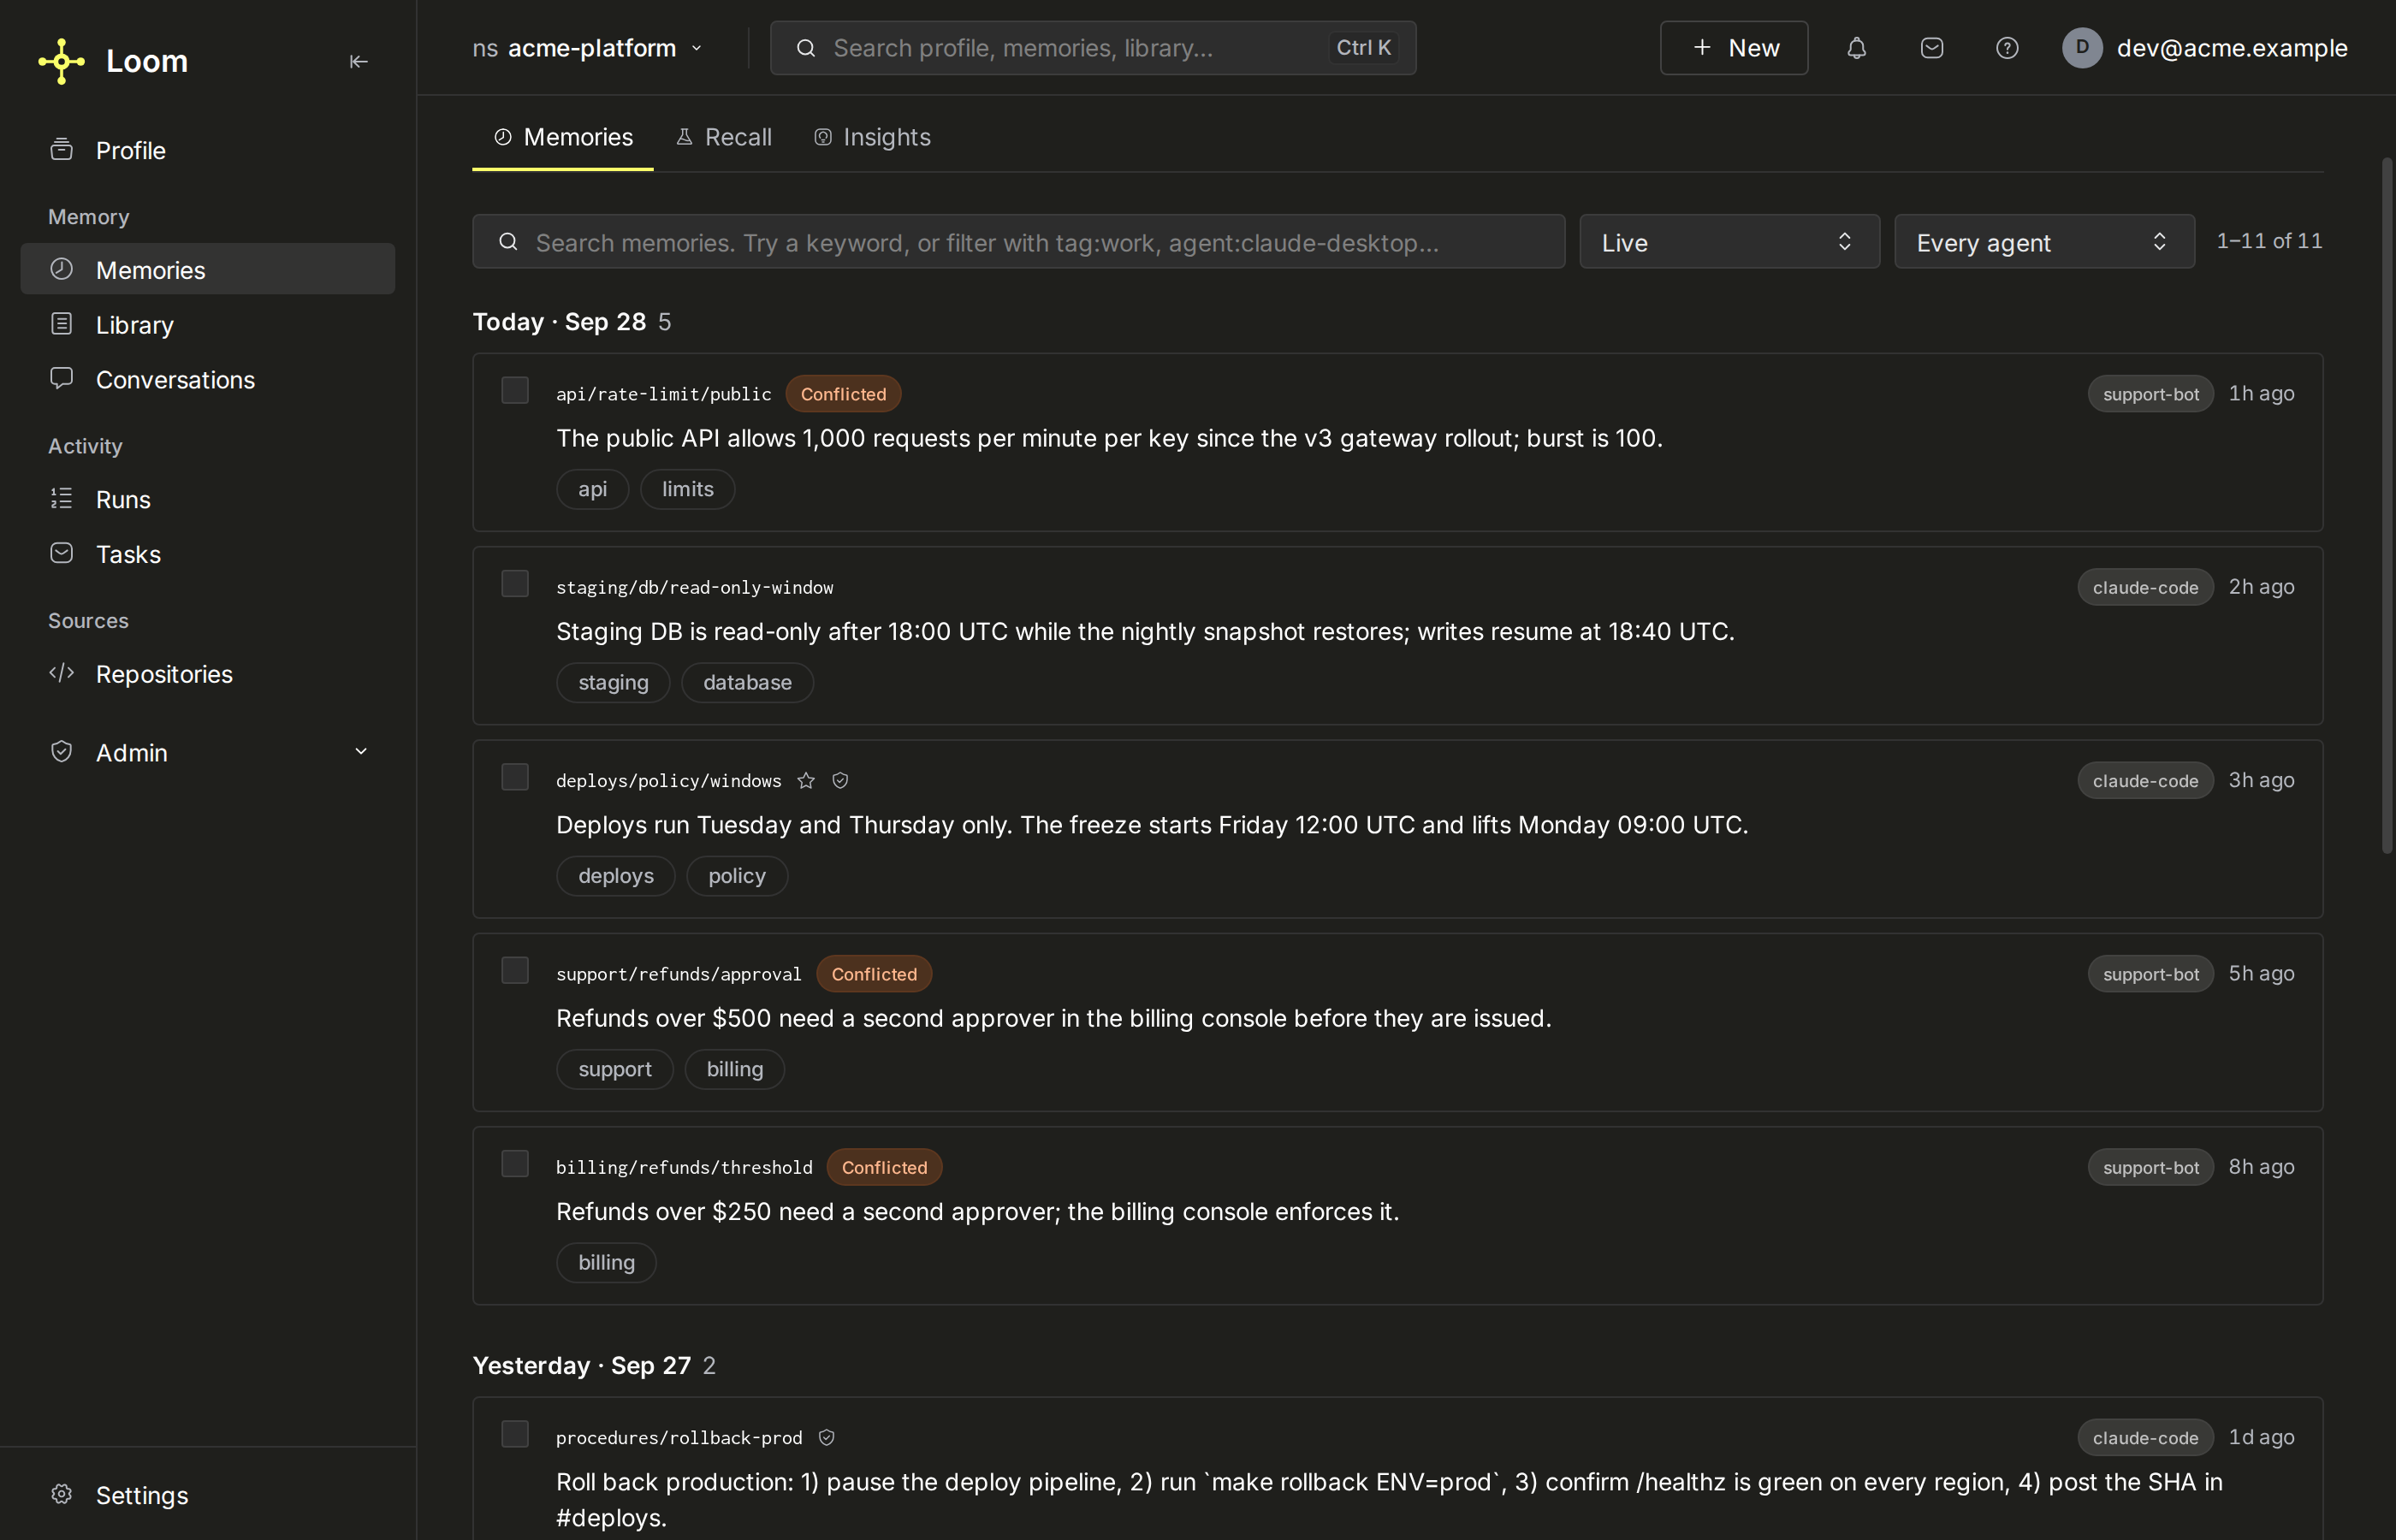
Loom es un servidor MCP de código abierto y autoalojado que da a tus agentes memoria compartida a largo plazo: lo que un agente aprende en una sesión, el siguiente agente o herramienta puede encontrarlo.
Los agentes se conectan mediante MCP, HTTP, Python o TypeScript. Puedes autoalojarlo con Docker o en Kubernetes con el Helm chart; el contexto de los agentes y los datos del índice residen en ClickHouse, y un despliegue puede elegir Postgres en el primer arranque para el estado de la memoria activa y del conocimiento. El panel reúne en un solo lugar las memorias, los repositorios, las tareas y las ejecuciones.
Para qué sirve Loom
- Memoria a largo plazo compartida entre tus agentes de programación, con plugins que cargan contexto al inicio de la sesión y capturan la sesión mientras se ejecuta. Memoria de agentes · Conectar un agente de programación
- Memoria para una aplicación de agentes, por usuario, desde el SDK de Python o TypeScript. Tu primer agente
- Un servidor de memoria MCP multiusuario con espacios de nombres, roles y tokens. Modo multiusuario · Espacios de nombres y uso compartido
- Un índice de código de tus repositorios que los agentes de programación consultan para obtener definiciones, llamadores e impacto de los cambios. Índice de código
- Menor costo de modelo para los agentes de programación, según lo medido más abajo. Costo de los agentes de programación
- Búsqueda de documentos con citas (RAG), incluidos los archivos PDF,
.docxy.pptxque convierte el servicio extractor. Búsqueda de documentos - Contexto compartido para flujos de trabajo con varios agentes: memoria compartida, bandejas de tareas y decisiones. Multiagente
- Memoria, recuperación, auditoría y borrado para agentes autónomos. Agentes autónomos
- Un registro del trabajo de los agentes, con conversaciones con búsqueda (cuando la grabación está activada), resúmenes de sesión desde los que retomar el trabajo, ejecuciones con sus objetivos, resultados y costos de modelo cuando se proporcionan, e historial de PR y de gestores de incidencias. Ejecuciones e historial de PR
Todos los casos de uso, y cuándo conviene más otra herramienta: casos de uso.
Loom no es una biblioteca en proceso para la memoria de corta duración de un solo agente, ni un framework de agentes. Cuándo Loom no encaja
Resultados medidos
| Evaluación | Con Loom | Sin Loom | Mejora de eficiencia | Alcance |
|---|---|---|---|---|
| Calidad de respuesta del agente de código | 0.84 | 0.78 | 20% menos de costo del modelo | 24 preguntas × 3 ejecuciones pareadas |
| Localización de archivos del agente de código | 96.4% | 91.4% | 21% menos de costo del modelo | 36 preguntas × 10 ejecuciones pareadas |
| Memoria frente a respuestas con historial completo | 94% | 90% | 91% menos de tokens en el prompt del lector | 100 preguntas pareadas de LongMemEval-S |
Ambas configuraciones de código usan Claude Code (claude-sonnet-5) sobre el código de ClickHouse;
el costo es la factura de modelo de toda la sesión, sin incluir las llamadas a modelos del lado del servidor de Loom, el alojamiento
ni la indexación. La calidad de respuesta
mide la cobertura de los puntos clave de una respuesta verificada, con una penalización por contradicciones.
La localización de archivos cuenta si el archivo correcto está entre los hasta tres archivos que se le
pide al agente nombrar al final de su respuesta.
La fila de memoria compara las memorias recuperadas con el historial completo de la conversación usando
el mismo lector gpt-5. El ahorro de tokens excluye la construcción de las memorias; la diferencia de precisión
de 94% frente a 90% es descriptiva, no está establecida estadísticamente.
Por separado, la configuración memory.ask de Loom obtuvo una precisión de respuesta del 96.6% en las
500 preguntas de LongMemEval-S. Se trata de una evaluación de producto con sus propios modelos de respuesta configurados, no de la comparación con lector fijo anterior.
Los resultados son específicos de las cargas de trabajo evaluadas.
Protocolos y artefactos reproducibles · resultados detallados · evalúa con tu carga de trabajo
Primeros pasos
1. Elige tu configuración de Docker
- Uso personal (el predeterminado): sin inicio de sesión, acceso solo desde localhost y un
espacio de nombres
dev/local. Una persona puede conectar varios agentes. - Uso en equipo: cuentas autenticadas y controles de acceso a los espacios de nombres. Empieza en modo multiusuario desde el primer arranque.
Ambos modos admiten las mismas funciones de Loom, incluidos los LLM y los embeddings configurados. El modo de un solo usuario no es una edición con funciones reducidas. También puedes cambiar una instalación existente sin borrar sus datos; da a las cuentas nuevas acceso a los espacios de nombres existentes.
Para probarlo sin instalar nada, ábrelo en un codespace:
 (qué ejecuta y quién puede acceder)
Para la instalación personal predeterminada, con Docker instalado (en Windows, en una terminal
WSL 2 donde docker funcione: Docker Desktop con su integración WSL activada, o Docker Engine
instalado en la distribución):
curl -fsSL https://github.com/ClickHouse/loom/releases/latest/download/install.sh -o loom-install.sh && sh loom-install.sh && rm loom-install.sh
Ejecútalo desde tu directorio personal, o desde otro
directorio en el que solo tú puedas escribir.
El instalador inicia Loom y ClickHouse, aplica las migraciones e imprime la URL del dashboard:
http://localhost:7777/; en una instalación nueva, después comprueba que una memoria se guarda y se lee
de vuelta. En una terminal, también ofrece conectar los agentes de programación que encuentre (Claude Code, Codex,
VS Code) y, en una instalación nueva, abre el dashboard. La imagen incluye el servidor,
los workers, el dashboard y los indexadores de código de Python, TypeScript y Go, además del de C++ en
amd64; las dependencias de TypeScript se preparan automáticamente. Inicio rápido y versiones fijas
La instalación vive en ~/.loom (LOOM_INSTALL_DIR elige otro directorio): el
archivo Compose y los ajustes de arranque en ~/.loom/.env. Si ejecutas de nuevo el comando de instalación,
se actualiza en el mismo lugar y se conservan tus ajustes de .env.
Mantén el modo de un solo usuario solo en localhost. Para el acceso compartido, sigue la guía de despliegue para equipos, incluido TLS.
2. Configura los modelos y las claves de API
La instalación de serie arranca sin claves ni red. El almacenamiento, el dashboard, la indexación estructural del código y la búsqueda semántica funcionan, con un pequeño modelo de embeddings local que lleva la imagen; el LLM falso no genera respuestas con IA.
| Componente | Configurar para uso real | Sin configuración |
|---|---|---|
| Embeddings | Proveedor, modelo de embeddings, dimensiones y clave de API. | local (bge-small en CPU): recuperación semántica, más débil que un modelo alojado. |
| LLM | Proveedor, modelo y clave de API. | fake-echo-1: sin extracción, resúmenes ni respuestas significativos. |
Abre Settings → Models & keys, elige ambos proveedores y modelos, introduce sus
claves y haz clic en Test & apply. No hace falta reiniciar Docker; si cambias el espacio de
embeddings, se reconstruye el índice existente. Las opciones de embeddings del dashboard son
proveedores alojados: para mantener local y añadir un LLM, define en cambio las líneas del LLM en ~/.loom/.env
(Modelos y claves).
Una sola clave de API de OpenAI puede servir para ambos roles. Claude necesita un proveedor de embeddings aparte. Se admiten OpenAI, Gemini y endpoints de embeddings compatibles con OpenAI. El inicio de sesión de la CLI de tu agente o su suscripción no proporciona las claves de proveedor de Loom.
¿Prefieres configurar por variables de entorno? Edita ~/.loom/.env y luego recrea el servidor:
docker compose --project-directory "$HOME/.loom" up -d --force-recreate loom
Una clave por sí sola no cambia los modelos fijados (el embedder local y el LLM falso); define también
el proveedor y el modelo.
Los ajustes guardados en el dashboard tienen prioridad sobre .env. Consulta
modelos y claves de API para ver recetas por proveedor
y comprobaciones de estado.
Todo lo demás está en un solo archivo. loom.example.yaml enumera
cada ajuste con su valor predeterminado y lo que hace, por áreas: la conexión con ClickHouse,
tiempos de espera y presupuestos, límites de tasa, workers y los interruptores *_enabled que activan y desactivan
funciones. Define cualquiera de ellos como LOOM_<NAME> en ~/.loom/.env y recrea el
servidor; un despliegue que monta un archivo de configuración puede definirlos en una copia de este archivo
(cómo se leen los ajustes). Los marcados como
live también cambian mientras Loom se ejecuta: loom settings set <name> <value>, o Admin → Deployment
settings. loom settings list --changed muestra qué difiere de los valores predeterminados y
de dónde vino cada valor (ajustes en tiempo de ejecución).
3. Conecta tus agentes
Si el instalador conectó tu agente, omite los comandos siguientes. En la máquina que ejecuta una instalación personal, los plugins no necesitan token:
# Claude Code
claude plugin marketplace add ClickHouse/loom
claude plugin install loom@loom

# Codex
codex plugin marketplace add ClickHouse/loom
codex plugin add loom@loom
Inicia una sesión nueva; la primera se conecta a http://localhost:7777. En Codex, ejecuta
codex de forma interactiva una vez y aprueba los hooks del plugin; hasta entonces solo funcionan
las herramientas. Cuéntale al agente algo que valga la pena conservar y pregúntale por ello en la siguiente sesión.
Para Cursor en la máquina que ejecuta una instalación personal, el botón siguiente añade la entrada MCP local, que no necesita token:

Para el modo agente de VS Code en la máquina que ejecuta una instalación personal, los botones siguientes añaden la entrada MCP local, que no necesita token:
Para un servidor de equipo, pasa --config server_url=… --config token=… a Claude Code, o
apunta Codex hacia él como se describe en
conectar un agente de programación. Crea
los tokens en Settings → Tokens. Cursor y otros clientes MCP, y
el SDK, también se tratan allí.
Por qué Loom
- Memoria que se mantiene a lo largo del tiempo. Comparte decisiones y hallazgos entre agentes y sesiones. Cada hecho registra quién lo escribió, el historial de versiones y la revisión de conflictos hacen que las correcciones sean trazables, y un espacio de nombres puede revertirse a cualquier punto en el tiempo. Memoria
- Inteligencia de código con evidencia. Encuentra definiciones, llamadores, impacto de cambios y pruebas relevantes; conecta el código con commits, pull requests e issues. Los resultados identifican su revisión, ubicación en el código fuente y grado de completitud. Índice de código
- Recuperación fundamentada. Busca en memorias, documentos, conversaciones y registros de seguimiento permitidos. Las respuestas citan sus fuentes; la recuperación con baja confianza puede abstenerse. Recuperación
- Traspasos entre varios agentes. Asigna trabajo mediante bandejas de tareas duraderas con arrendamientos (leases), reintentos, reglas de revisión y resultados. Tus agentes ejecutan el flujo de trabajo; Loom conserva los traspasos. Colas de tareas
- Control sobre los datos de los agentes. Gestiona el acceso a los espacios de nombres, la procedencia, la retención, los registros de auditoría y el borrado verificado. El contexto sigue siendo consultable en ClickHouse. Seguridad
Integraciones
| Integración | Qué conecta |
|---|---|
| Claude Code, Codex, Cursor y otros clientes MCP (todas las integraciones) | Memoria e inteligencia de código en el flujo de trabajo de tu agente actual. |
| Python, TypeScript y HTTP | Tus propios agentes y aplicaciones. |
| Langfuse | Trazas de solicitudes, costos de modelos, puntuaciones de recuperación y atribución de versiones de prompts. |
| ClickStack / HyperDX | Trazas, registros y métricas de OpenTelemetry en ClickHouse. |
Langfuse y ClickStack son integraciones opcionales, no servicios incluidos en el stack de Docker.
Detalles de los benchmarks
Resultados detallados de recuperación, lector y búsqueda de código
| Evaluación | Resultado |
|---|---|
| Recuperación de evidencia en LongMemEval-S (500 preguntas) | 98.6% de las preguntas con al menos una sesión de apoyo entre las primeras 30 memorias. |
Lector fijo gpt-5 en LongMemEval-S (500 preguntas) |
92.0% de precisión en las respuestas a partir de las 200 memorias principales. |
| LoCoMo (las 10 conversaciones) | 89.6% de precisión en las respuestas; 90.8% de abstenciones correctas en preguntas adversarias. |
| Muestra de preguntas de hechos de MemoryAgentBench (500 preguntas) | 99.0% SubEM; 95.7% de F1 por solapamiento de tokens en las respuestas generadas. |
| Búsqueda conceptual de código (36 preguntas) | Recall del archivo de referencia 91.2% en 5 / 97.2% en 10; MRR 0.91. |
| Localización de archivos en SWE-bench Verified (200 incidencias) | Incidencias con un archivo modificado entre los primeros 10: 82% frente a 57% de BM25; 76.5% entre los primeros 5. |
| Detección de duplicados en el tracker (104 pares) | El duplicado anterior registrado quedó en primer lugar el 87.5% de las veces. |
Estas pruebas miden tareas distintas, no una puntuación agregada. SWE-bench mide la localización de archivos, no la resolución de incidencias. El registro de resultados incluye las definiciones de puntuación, las evaluaciones con muestras pequeñas, los hallazgos más débiles y negativos, y los protocolos completos, los modelos y los artefactos.
Metodología · cobertura y limitaciones conocidas · ejecutar los benchmarks
Documentación y contribución
Para contexto compartido entre agentes, inteligencia de código y recuperación con permisos, empieza por la documentación. Para conocer los requisitos de despliegue, consulta los requisitos previos.
Despliegue · Preguntas frecuentes ·
Contribución · Reporte de seguridad ·
llms.txt