
AlicanKaya192/Data-Science-RoadMap
AlicanKaya192/Data-Science-RoadMap has 58 GitHub stars and 8 forks. GitHot measured 0 in 7 days and 0 in 15 days. Last checked 2026-11-18 09:33 UTC. Last push 2026-09-14.
Crecimiento de estrellas medido
- in 24h
- Actualización retrasada
- in 7 days
- 0
- in 15 days
- 0
- in 1 month
- Recopilando historial
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
Acerca de
Python temellerinden Reinforcement Learning'e kadar uzanan, 22 modüllük uçtan uca Veri Bilimi & Makine Öğrenmesi yol haritası. Her konuda çalıştırılmış notebook'lar ve PDF tekrar soruları.
IAREADME.es-ES.md
OriginalAlican Kaya Data-Science-RoadMap
🇹🇷 Türkçe | 🇬🇧 English | 🇪🇸 Español


[!CAUTION] Debido al gran interés que ha despertado este proyecto, la cuota de datos de Git LFS se está agotando rápidamente. Si clona el repositorio cuando la cuota esté llena, los documentos PDF y los conjuntos de datos se descargarán incompletos. Para acceder a todos los archivos por completo, utilice la opción 'Descargar ZIP' (Download ZIP) en el repositorio de GitHub.
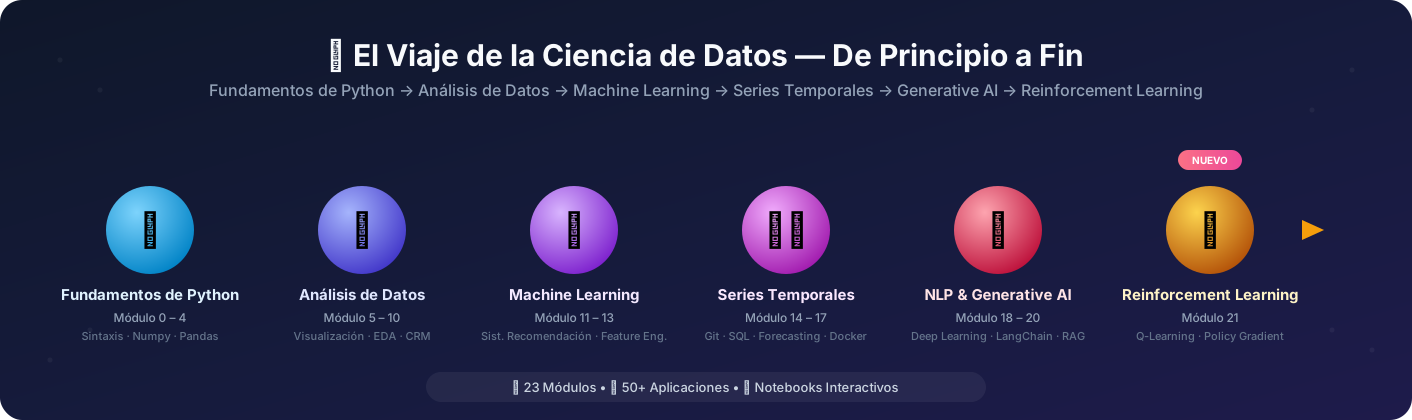
De Python a Generative AI: Un viaje completo de Ciencia de Datos 🚀
✨ Destacados
| 📦 23 Módulos | Plan de estudios completo de Python básico a Generative AI, Reinforcement Learning y Desarrollo de APIs |
| 🧪 50+ Aplicaciones & Proyectos | Trabajos prácticos con conjuntos de datos reales |
| 📓 Notebooks Interactivos | Jupyter Notebook con salidas ejecutadas en módulos centrados en visualización |
| 📄 100+ Documentos PDF | Explicaciones teóricas detalladas y materiales de referencia |
| ✅ Soportado por CI | Base de código validada con lint + pruebas smoke en cada push |
🛠️ Stack Tecnológico


📑 Tabla de Contenidos
Nota: Las carpetas dentro del repositorio están numeradas según el orden de aprendizaje. El contenido detallado de cada módulo se encuentra en el archivo
README.mdde su propia carpeta. Por favor, haga clic en los nombres de los módulos de la tabla a continuación para navegar a cada módulo.
- 📌 Sobre el Repositorio
- 📚 Mapa de Aprendizaje y Contenidos
- 📂 Proyectos y Recursos Adicionales
- 📖 Estado e Progreso del Proyecto
- 💡 Métodos de Estudio Recomendados
- 🤝 Cómo Contribuir
- 📜 Licencia
📚 Mapa de Aprendizaje y Contenidos
| # | Módulo | Títulos de Temas |
|---|---|---|
| 0 | Fundamentos de Python | Introducción, tipos de datos, POO, operaciones de archivos/bases de datos |
| 1 | Configuración del Entorno de Trabajo | Entorno virtual, gestión de paquetes |
| 2 | Estructuras de Datos | String, List, Dictionary, Tuple, Set |
| 3 | Funciones, Condiciones, Bucles y Comprehensions | if-else, bucles, lambda, map/filter, comprehensions |
| 4 | Ejercicios (Python y List Comprehensions) | Ejercicios de reforzamiento |
| 5 | Numpy | Creación de arrays, indexación, fancy index, operaciones matemáticas |
| 6 | Pandas | Series/DataFrame, selección, agrupación, apply/lambda, join |
| 7 | Visualización de Datos (Matplotlib & Seaborn) | Gráficos de líneas, barras, histogramas, scatter plot |
| 8 | Análisis Exploratorio de Datos Avanzado (EDA) | Análisis categórico/numérico, variable objetivo, correlación |
| 9 | Analítica CRM | RFM, Valor de Vida del Cliente (CLTV) |
| 10 | Problemas de Medición | Puntuación/clasificación de productos/comentarios, Pruebas A/B |
| 11 | Sistemas de Recomendación | Reglas de asociación, filtrado basado en contenido/colaborativo, factorización de matrices |
| 12 | Ingeniería de Características (Feature Engineering) | Valores atípicos/faltantes, codificación, extracción de características |
| 13 | Machine Learning (Aprendizaje Automático) | Regresión, KNN, CART, métodos de árboles, estudios de caso |
| 14 | GIT | Fundamentos de control de versiones y uso avanzado |
| 15 | SQL | Gestión de bases de datos, consultas |
| 16 | Series Temporales | Suavización, ARIMA/SARIMA, predicción con LightGBM |
| 17 | Docker | Fundamentos de contenedorización |
| 18 | Ruta de Deep Learning ↗ | (Repositorio separado) |
| 19 | Procesamiento de Lenguaje Natural (NLP) | Preprocesamiento de texto, análisis de sentimiento, clasificación |
| 20 | Generative AI & Prompt Engineering | LLMs, LangChain, RAG, agentes autónomos, ajuste fino |
| 21 | Reinforcement Learning | Q-Learning, Policy Gradient (REINFORCE), conceptos de DQN, entornos Gymnasium |
| 22 | API (Application Programming Interface) | HTTP, diseño REST, autenticación/seguridad, consumo de APIs con Python, creación de APIs con FastAPI, GraphQL/gRPC/Webhooks |
📌 Sobre el Repositorio
Este repositorio es un recurso integral que contiene mis notas, ejemplos de código y proyectos creados durante mi proceso de aprendizaje del lenguaje de programación Python. Siguiendo el mapa de ruta de Ciencia de Datos y Aprendizaje Automático, ofrece una estructura que abarca desde temas básicos de Python hasta análisis de datos avanzado, ingeniería de características y modelos de aprendizaje automático.
Mi objetivo es documentar lo que he aprendido de manera organizada y crear una guía útil para aquellos que sigan un camino similar.
[!CAUTION]
⚠️ Crítico: Instalación de las Dependencias Requeridas
Para ejecutar el código de este repositorio, es necesario instalar todas las bibliotecas listadas en el archivo
requirements.txt.¿Qué es
requirements.txt?Este archivo contiene la lista de bibliotecas de Python que el proyecto necesita. Incluye: pandas, numpy, scikit-learn, matplotlib, seaborn, xgboost, lightgbm, catboost, streamlit, openai, google.generativeai y muchas otras bibliotecas de ciencia de datos, aprendizaje automático e IA generativa.
Actualmente,
requirements.txtinstala tres archivos separados en conjunto con fines de compatibilidad. Si solo está interesado en una sección específica, puede instalar el archivo correspondiente por separado para una instalación más ligera/rápida:
requirements-core.txt— Módulos 0-13, 16, 21, 22 (Ciencia de Datos Clásica, Aprendizaje Automático, Reinforcement Learning & Desarrollo de APIs)requirements-nlp.txt— Módulo 19 (Procesamiento de Lenguaje Natural)requirements-genai.txt— Módulo 20 (Generative AI, LangChain, Agentes)Pasos de Instalación:
# 1. Clone el repositorio
git clone https://github.com/AlicanKaya192/Data-Science-RoadMap.git

# 2. Navegue al directorio del proyecto
cd Data-Science-RoadMap

# 3. (Recomendado) Cree y active un entorno virtual
python -m venv venv
# Windows:
venv\Scripts\activate
# macOS/Linux:
source venv/bin/activate

# 4. Instale todas las dependencias
pip install -r requirements.txt
Nota: Algunas bibliotecas (ej:
google.generativeai,openai) pueden requerir una clave API. Para el Módulo 20 (Generative AI), copie el archivo20-Generative_AI_and_Prompt_Engineer/.env.examplecomo.envy rellénelo con sus propias claves.
📂 Proyectos y Recursos Adicionales
- Proyecto Armut ARL: Escenario del mundo real sobre Aprendizaje de Reglas de Asociación (Association Rule Learning).
- CheatSheets: Hojas de referencia rápidas para Python, Pandas, Numpy, Matplotlib, Seaborn, SQL, Docker, Machine Learning y AI Agents.
- Datasets: Archivo de conjuntos de datos utilizados en los trabajos. Consulte el enlace para notas de fuente y licencia de conjuntos de datos de terceros.
- Preguntas de Entrevista: Preguntas y soluciones para prepararse para entrevistas técnicas.
- Soluciones de Mentor: Soluciones alternativas y profesionales para problemas de ejemplo.
- Preguntas de Kahoot!: Cuestiones divertidas para probar el conocimiento adquirido.
- Global CO₂ Analysis & Future Projections: Proyecto de análisis de emisiones globales de CO₂ y proyecciones futuras. Incluye análisis de series temporales, visualización de datos y modelos de predicción.
Nota: Este proyecto debe revisarse después de los temas de Machine Learning (13) y Time Series (16).
- 21 Diferentes Proyectos de Python: Colección de 21 proyectos diferentes diseñados para practicar desde nivel inicial hasta avanzado en el camino de aprendizaje de Python. Web Scraping, Reloj de Escritorio Digital, Generación de Códigos QR y más.
Nota: Estos proyectos pueden estudiarse de forma independiente después de la sección Python Temelleri (0).
- Odyssey: Versión de escritorio de este roadmap — permite completar las secciones mediante lecciones, imágenes, PDFs y exámenes, además de ejercicios de código que se comprueban automáticamente, como proyecto independiente.
📖 Estado e Progreso del Proyecto


Los 23 módulos completos de la tabla de Mapa de Aprendizaje están en estado finalizados.
Nota: El orden de los puntos 18, 19 y 20 puede cambiarse según sea necesario. Se agregarán encabezados adicionales si se considera necesario. Además, se incluirán los conceptos matemáticos que deben conocerse.
💡 Métodos de Estudio Recomendados
- Siga el orden: Dado que los temas se construyen unos sobre otros, se recomienda avanzar según el número de las carpetas.
- Practique: En lugar de solo leer el código, realice sus propios análisis utilizando los datos de la carpeta
Datasets_Genel_. - Revise los proyectos: Específicamente, intente comprender los proyectos integrales (pipelines) en las carpetas
09-CRM_Analitiky13-Machine_Learning_Makine_Öğrenimi_.
Sitios de Práctica de Algoritmos y Código
- Hackerrank: Para preguntas de nivel inicial e intermedio.
- Codewars: Tareas pequeñas centradas en la práctica.
- Leetcode: Para usuarios de nivel intermedio y avanzado (se debe completar Hackerrank/Codewars primero).
- Spoj: Solo contiene preguntas, sin editor de código. Puede usarse después de los otros sitios.
Nota: Puede ingresar a estos sitios en cualquier momento para hacer pequeñas prácticas. Se recomienda dedicar más tiempo a practicar con conjuntos de datos.
🤝 Cómo Contribuir
Quienes deseen contribuir al desarrollo de estos recursos pueden abrir PR (Pull Request) e issues — son totalmente bienvenidos. Consulta CONTRIBUTING.md (en turco/inglés) para ver los pasos detallados, estándares de código e instrucciones de prueba.
Por favor lee CODE_OF_CONDUCT.md antes de contribuir. Si encuentras una vulnerabilidad de seguridad, sigue el proceso descrito en SECURITY.md.
Inicio Rápido
# 1. Haz fork del repositorio (a través de GitHub)

# 2. Clona tu fork
git clone https://github.com/TU_USUARIO/Data-Science-RoadMap.git

# 3. Crea una nueva rama
git checkout -b feature/nueva-funcionalidad

# 4. Realiza tus cambios y haz commit
git add .
git commit -m "feat: Descripción de la nueva funcionalidad"

# 5. Haz push de tu rama
git push origin feature/nueva-funcionalidad

# 6. Abre un Pull Request a través de GitHub (completa la lista de verificación de la plantilla)
📜 Licencia
Este proyecto está licenciado bajo la MIT License. Consulte el archivo LICENSE para más detalles.
Resumen: Este repositorio es de código abierto. Puede usar, modificar y distribuir su contenido con fines personales, comerciales o educativos. Sin embargo, se debe acreditar la fuente y conservar la declaración de licencia. Siempre se agradece su contribución a la naturaleza de código abierto del proyecto.