
AIMixer/ComfyUI_MiniMaxH3_Director
AIMixer/ComfyUI_MiniMaxH3_Director has 2,750 GitHub stars and 326 forks. GitHot measured +20 stars in 24 hours and +80 in 7 days. Last checked 2026-11-09 18:08 UTC. Last push 2026-10-13.
Multi-segment MiniMax H3 Director for official ComfyUI MiniMax-H3
Crecimiento de estrellas medido
- in 24h
- +20
- in 7 days
- +80
- in 15 days
- Actualización retrasada
- in 1 month
- Actualización retrasada
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
README.md
OriginalComfyUI MiniMax H3 Director
基于 ComfyUI 官方 MiniMax-H3 的多段音视频导演台插件。仓库地址:AIMixer/ComfyUI_MiniMaxH3_Director
English → README_EN.md
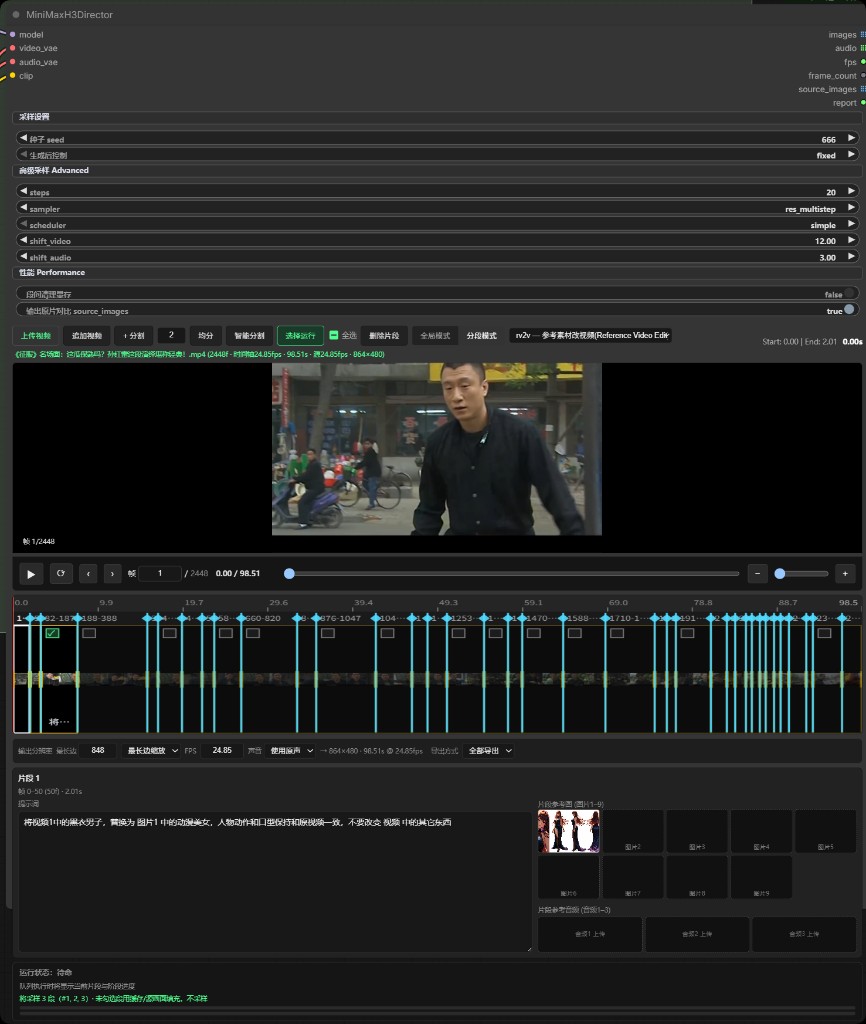
功能介绍
MiniMaxH3Director 是面向长视频、多段生成的 MiniMax H3 导演台节点,把分段计划、条件编码、采样解码和导出整合在一个节点里。底层走官方 MiniMaxH3ImageToVideo / MiniMaxH3ReferenceToVideo + MiniMaxH3SigmaShift + KSampler + AV 分离解码链路,原生输出立体声音频。
核心能力
| 功能 | 说明 |
|---|---|
| 多段时间轴 | 节点内上传视频,支持切分、均分、智能分镜分割(PySceneDetect)、追加;分割点可选中删除;可视化时间轴预览每段范围与缩略图 |
| 多任务模式 | task_type:t2v(文生视频)、i2v(图生视频)、fl2v(首尾帧生视频)、r2v(参考主体生视频 / 素材组)、v2v(视频转视频)、rv2v(参考素材改视频) |
| 首尾帧 (fl2v) | 独立首尾帧时间轴:多组关键帧、「添加一组」可只写提示词(文生)、或上传首帧和/或尾帧(官方支持只传尾帧);开「段间引导」并勾「引用上段」时,空组用上一段末尾 N 帧做运动/音频衔接;拖缘调时长;支持「选择运行」只跑部分组 |
| 参考素材组 (r2v) | fl2v 式分组 UI:上方「公共参数」共享参考图/音频与公共提示词(与每组提示词拼接);每组可再挂图片1–9 / 音频1–3 / 视频1–3;提示词用 <Picture N> / <Video K> / <Audio J>(或 @ 引用);时间轴预览与选中状态同步 |
| 源视频编辑 (v2v / rv2v) | Bernini 风格源视频时间轴;每段源画面自动绑定 <Video 1>;rv2v 另可挂参考图(图片1–9)与参考音频(音频1–3) |
| 选择运行 | 开启后只采样勾选的片段/素材组;未勾选段可用缓存或源画面填充(全部导出时) |
| 外部多组接线 | Director Group (Image to Video) / (Reference to Video) + Groups Combine;连入导演台 i2v_groups / r2v_groups 后外部优先覆盖 UI 素材,仍支持跑批与选择运行 |
| 原生立体声音频 | 与画面同次采样生成;v2v/rv2v 可选生成声音 / 使用原声 / 静音 |
| 段间引导 | 默认关闭;多段 t2v / i2v / fl2v / r2v / v2v / rv2v 时可开启,将上一段生成结果的末尾运动(及生成音频)钉入下一段采样再裁掉前缀。上下文帧数:5 / 22 / 39 / 56,默认推荐为 22。感谢 ComfyUI-H3-Motion-Context 提供的实现思路 |
| 语义桥 (Semantic Bridge) | 外接 MiniMax H3 Director Semantic Bridge 到导演台 selflift 上方的 semantic_bridge 口。未接线 = 完全相同。接线后用 student MLP 改写官方 cond token(RMS-norm → 残差混合)。权重自行放到 models/semantic_bridge/,本插件不分发;节点里换 adapter 即可在原版与 BUNNY 之间切换,不要串两座桥。原版偏构图/空间/计数等静态关系;BUNNY 偏动作归属与复杂多人。蒸馏于 FL2VA;r2v / v2v / rv2v 为强制兼容,请谨慎使用。参考 speach1sdef178/MiniMax-H3-Semantic-Bridge、JOKER141/BUNNY_H3_Conditioning_Bridge |
| 渐进一采 (SelfLift) | 外接 MiniMax H3 Director SelfLift 到导演台 selflift 口(Refine 上方)。未接线 = 原来的单阶段一采。接线后一采变为低清前缀 + 3D lift + 高清收尾,画布仍是导演台分辨率。Euler。感谢 slmonker/selflift-Avatar 提供的实现思路 |
| 二采 / 放大 (Refine) | 外接 MiniMax H3 Director Refine 到导演台 refine 口。未接线 = 原来的单次采样。refine = 同分辨率精修;upscale = 先放大到目标画布再按 SIGMAS 二采(像素插值 / RTX VSR / H3 latent);latent_upscale = 只放大 H3 latent、不二采。passes 可多次精修(upscale 只放大一次)。可选接 refine_model 换二采 UNET。images 为二采后成片,images_pre_refine 为一采(放大前)画面 |
| 运行报告 | report 口输出分段计划、每段任务摘要 |
| 导演包导入导出 | 工具栏「导入/导出导演包」:zip 内保存时间轴 JSON 与参考图/视频/音频。目录名为英文(shared_params/、asset_groups/01/、Picture1…),与切到 EN 后的界面用语对应,避免路径编码问题 |
参考音频槽可直接选择已有视频,或从本地选择音频/视频;视频会立即提取首条音轨为 FLAC,结果直接保存到 input/。本地视频只在临时目录中用于提取,不会作为视频素材保存。音频沿用 ComfyUI 现有上传规则:同名同内容直接复用,同名不同内容自动添加序号且不会覆盖;当前素材组也不会重复添加同一路径。
输入 / 输出
输入: model → video_vae → audio_vae → clip
可选: i2v_groups(Image to Video 多组)/ r2v_groups(Reference to Video 多组)/ semantic_bridge(MiniMax H3 Director Semantic Bridge)/ selflift(MiniMax H3 Director SelfLift)/ refine(MiniMax H3 Director Refine)
缓存文件夹名(
cache_name,面板「性能」组最下方):分段缓存的目录名。 填了就落到output/minimax_seg_cache/<名字>_<节点id>/,留空则只有节点 id(旧行为不变)。 同一个名字配上不同节点 id 会分开。复制工作流后节点 id 通常还是原来的,名字也相同就会继续共用一个目录,要隔开就改名字。 名字会自动过滤/ \ : * ? " < > |与 Windows 保留名(CON/NUL…),最长 64 字符。
输出: images → audio → fps → frame_count → source_images → report → images_pre_refine
CLIP Loader 的 type 必须选
minimax(Qwen3-VL)。t2v/i2v/fl2v用 fl2va UNET;r2v/v2v/rv2v用 ref2va UNET。
输出原片到 source_images 只填充独立的 source_images 输出,不会改变主 images。请将 source_images 另接预览或视频合成节点查看;解码失败时运行报告会明确说明,并输出灰色占位而不会冒充生成画面。
导演包(剧本 + 素材)
工具栏右侧 导入导演包 / 导出导演包。导出为 *.mmxpack.zip。路径只用 ASCII,与英文界面一致(与当前 UI 语言无关)。
| English UI | Pack path |
|---|---|
| Shared params | shared_params/ |
| Asset group 1 | asset_groups/01/ |
| Picture 1–9 | Picture1.png … Picture9.webp |
| Video 1–3 | Video1.mp4 |
| Audio 1–3 | Audio1.wav |
| start / end (fl2v) | start.jpg / end.jpg in that group folder |
| Upload video (v2v source) | source_video/ |
pack.json
shared_params/shared_params.json
shared_params/Picture1.png
asset_groups/01/group.json
asset_groups/01/Picture4.png
timeline.json
timeline.json:导演台导出时写入,用于无损往返(含其它任务草稿等)。- 转换工具可以只写
pack.json+shared_params/+asset_groups/,不必手写timeline.json。 - 槽位编号与界面相同:公共参数占用 Picture 1–3 时,组文件夹里从
Picture4续编,不要在组内把第一张改名为Picture1。 - 不含 UNET / CLIP / VAE。导入会覆盖当前节点时间轴(有确认)。媒体落到 ComfyUI
input/minimax_director_packs/。
依赖
请将 ComfyUI 升级到 v0.30.0 及以上(含官方 MiniMax H3 节点:PR #15224、PR #15228)。
可选:scenedetect(智能分割)、opencv-python-headless(源视频解码)、imageio-ffmpeg(原声抽取)——见 requirements.txt。
Refine 的 nvidia_rtx_vsr 另需 NVIDIA GPU,可 pip install nvidia-vfx --extra-index-url https://pypi.nvidia.com(不是硬依赖)。
安装
方法一:手动安装(标准方式)
cd ComfyUI/custom_nodes
git clone https://github.com/AIMixer/ComfyUI_MiniMaxH3_Director.git

pip install -r ComfyUI_MiniMaxH3_Director/requirements.txt
重启 ComfyUI。
方法二:ComfyUI Manager
- 打开 ComfyUI Manager
- 选择 Install via Git URL
- 填入
https://github.com/AIMixer/ComfyUI_MiniMaxH3_Director.git并安装 - 重启 ComfyUI
模型与工作流下载
完整资源包(MiniMax H3 模型权重 + 示例 JSON 工作流)见:
Comfyit 搅拌站 · 文章 506:MiniMax H3 模型和工作流
下载后将 models/ 合并到 ComfyUI/models/,JSON 工作流拖入 ComfyUI 即可。
也可参考:
- Hugging Face: Comfy-Org/MiniMax-H3
- ComfyUI 文档: MiniMax H3 工作流示例
本仓库自带示例:example_workflows/
| 工作流 | task_type | UNET | 说明 |
|---|---|---|---|
minimax_h3_director_t2v.json |
t2v | fl2va | 文生音视频 |
minimax_h3_director_fl2v.json |
fl2v | fl2va | 首尾帧(「添加一组」) |
minimax_h3_director_r2v.json |
r2v | ref2va | 参考改视频素材组 |
minimax_h3_director_v2v.json |
v2v | ref2va | 源视频时间轴编辑 |
minimax_h3_director_rv2v.json |
rv2v | ref2va | 源视频 + 参考图/音频 |
minimax_h3_director_external_groups_i2v.json |
fl2v | fl2va | 外部 Group×2 → Combine → i2v_groups |
minimax_h3_director_external_groups_r2v.json |
r2v | ref2va | 外部 Group×N → Combine → r2v_groups |
minimax_h3_director_二采_加速.json |
r2v | ref2va | 外接 Refine 二采(SIGMAS + H3 latent);images 与 images_pre_refine 各出一路成片 |
推荐模型文件
| 用途 | 文件名 | 目录 |
|---|---|---|
| UNET (t2v / i2v / fl2v) | minimax_h3_fl2va_pruned_int8_convrot.safetensors |
models/diffusion_models/ |
| UNET (r2v / v2v / rv2v) | minimax_h3_ref2va_pruned_int8_convrot.safetensors |
models/diffusion_models/ |
| CLIP | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
models/text_encoders/ |
| Video VAE | minimax_h3_video_vae_fp16.safetensors |
models/vae/ |
| Audio VAE | minimax_h3_audio_vae_fp32.safetensors |
models/vae/ |
快速开始
- 确认 ComfyUI ≥ 0.30.0,已能加载官方 MiniMax H3 节点
- 从 文章 506 或本仓库
example_workflows/加载示例 - 连接 UNET / CLIP / video_vae / audio_vae,在导演台 UI 内编辑时间轴与提示词后 Queue
视频教程: B 站合集 · 插件使用教程
默认采样参数
- 画布默认 0.4MP 16:9(864×480),5 秒 / 124 帧 @ 24 fps(17k+5 网格)
- 25 steps,
res_multistep+simple,CFG 1.0 - Sigma shift:video 12 / audio 3
首尾帧 fl2v 用法摘要
- 任务类型选 「首尾帧生视频 (fl2v)」
- 点击「添加一组」:可只写提示词(文生);或上传首帧和/或尾帧(可只传尾帧;仅首帧=图生)
- 多组时打开「段间引导」并勾「引用上段」,空组会用上一段末尾 N 帧(上下文帧数,默认 22)引导衔接
- 在镜卡片或时间轴上调整时长;提示词写中间运动 / 镜头 / 过渡
- Queue 生成;多组可勾选「选择运行」只跑部分组
参考主体 r2v 用法摘要
- 任务类型选 「参考主体生视频 (r2v)」(需 ref2va UNET + audio_vae)
- 点击 「启用公共参数」 展开面板(默认折叠/关闭);上传共用参考图/音频并写公共提示词(如角色锁定 /
subject_definitions);启用后会与每组提示词拼接 - 点击「添加素材组」;每组写分镜提示词,可按需再挂本组独有素材(同槽位覆盖公共素材)
- 提示词中用
<Picture N>/<Video K>/<Audio J>,或输入@(启用公共参数时可引用公共 + 本组素材) - 时间轴可预览各组时长与缩略图;「选择运行」与素材组勾选同步
源视频 v2v / rv2v 用法摘要
- 选 v2v 或 rv2v,上传源视频并分段(切分 / 均分 / 智能分割)
- 每段写提示词;系统自动将源片段绑定为
<Video 1> rv2v可额外上传参考图 / 参考音频;声音模式可选生成 / 原声 / 静音
二采 / 放大 Refine 用法摘要
- 添加 MiniMax H3 Director Refine,把
refine接到导演台refine口。不接则仍是原来的一采 mode=refine:同分辨率再采一遍(精修)。mode=upscale:先放大到目标画布再二采。mode=latent_upscale:只放大 H3 视频 latent,不再二采。分辨率控件在upscale/latent_upscale时显示(可跟随导演台、按比例+百万像素,或自定义宽高)。导演台是一采分辨率,Refine 目标才是放大后的宽高passes:精修次数,默认 1、最多 9999。upscale只在第 1 次放大,后面都是同分辨率精修;latent_upscale不二采- 可选接
refine_model(二采 UNET);不接则用导演台主模型。适合一采挂 Turbo LoRA、二采卸掉或换另一套 - 导演台
images是二采后成片;images_pre_refine是一采、放大前的画面,便于对比。source_images仍是时间轴原片,不是一采结果。开启confirm_first_pass后,首次 Queue 只输出images_pre_refine并阻断主images下游保存;再次 Queue 命中缓存并完成二采后,images才输出 - 二采用 SIGMAS:把
BasicScheduler或ManualSigmas接到 Refine 的sigmas口 - fl2v 默认跳过二采(保护钉死的首尾帧);关掉 Refine 上的
skip_fl2v才会采 upscale默认h3_latent:在 Refine 节点里选 3D 权重(upscale_method下方下拉框;mode=latent_upscale时同样出现)。权重放ComfyUI/models/latent_upscale_models/。lanczos可另接upscale_model(RealESRGAN 等),不接则纯插值;也可改nvidia_rtx_vsr- 「分段导出」且
passes>1时,每轮会另落seg_XXXX_pN.mp4;「全部导出」只出一采和终稿
示例:example_workflows/minimax_h3_director_二采_加速.json
外部多组接线(第三方节点接入)
对齐官网两个 conditioning 节点,把扩写 / 抠图 / Load Video 等处理结果以多组形式送进导演台:
- 添加
MiniMax H3 Director Group (Image to Video)或(Reference to Video) - 按组接线:
prompt/duration_sec;I2V 系接first_frame/last_frame(无帧=t2v,仅首=i2v,仅尾或首+尾=fl2v);R2V 为 Autogrow(同官方 Reference to Video):接图/视频/音频会自动多出空口(图≤9、视频≤3、音频≤3)。输出宽高在导演台统一设置 - 多组:用
Director Groups Combine(Autogrow:接满最后一个口会自动多出新口,同官方 Reference to Video)→ 导演台i2v_groups/r2v_groups;单组可直接把group连到导演台 - 导演台
task_type与口一致(t2v/i2v/fl2v ↔i2v_groups;r2v ↔r2v_groups);不要两口同时连接 - 连接后执行以图中接线为准(外部优先);UI 卡片变淡,仍可用「选择运行」按组序勾选
配套生态 · Comfyit 搅拌站
Comfyit 提供环境、模型、工作流与教程配套:
| 栏目 | 链接 |
|---|---|
| 模型 / 工作流包 | comfyit.cn/article/506 |
| 官方 MiniMax H3 文档 | docs.comfy.org · MiniMax H3 |
| 插件视频教程 | B 站合集 |
| 产品中心 | comfyit.cn/products |
| 插件广场 | comfyit.cn/plugins |
| 模型广场 | comfyit.cn/resources/models |
| 工作流广场 | comfyit.cn/workflows |
作者与交流
| 维护者 | AI搅拌手 / AIMixer |
| 本仓库 | github.com/AIMixer/ComfyUI_MiniMaxH3_Director |
| 姊妹插件 | ComfyUI_Bernini_Director |
| 作者 QQ | 3697688140 |
| B 站 | space.bilibili.com/1997403556 |
| 插件教程 | B 站合集 · 使用教程 |
| QQ 交流群 | 551482703 · 425064221 · 559826331 |
| Comfyit 搅拌站 | comfyit.cn |
致谢
- Comfy-Org / ComfyUI — 官方 MiniMax H3 支持
- MiniMax-AI — MiniMax H3 模型
- Comfy-Org/MiniMax-H3 — 权重与文档
- NikoDemon80/ComfyUI-H3-Motion-Context — 段间运动/音频续拍思路参考
- LBH-123-AI/Comfyui_Minimax_h3_latent_Upscaler — H3 3D latent 放大架构与权重格式参考
- slmonker/selflift-Avatar — SelfLift 渐进一采思路参考
- speach1sdef178/MiniMax-H3-Semantic-Bridge — Semantic Bridge student 公式与适配器格式参考
- JOKER141/BUNNY_H3_Conditioning_Bridge — 同架构的动作逻辑 / 多人场景适配器参考
许可证
Apache-2.0
Explorar proyectos relacionados
codecrafters-io/build-your-own-x
Domina la programación recreando desde cero tus tecnologías favoritas.
561,398 estrellaspublic-apis/public-apis
Una lista colectiva de API gratuitas
497,679 estrellasmorluto/rea
Ingeniería inversa de cualquier cosa con agentes, desde el comportamiento de la aplicación hasta los binarios nativos.
447,495 estrellasopenclaw/openclaw
La IA que de verdad hace las cosas. Cualquier sistema operativo y cualquier plataforma. Al estilo langosta. 🦞
394,261 estrellas