
0xErwin1/dbflux
0xErwin1/dbflux has 524 GitHub stars and 41 forks. GitHot measured +2 stars in 24 hours. Last checked 2026-11-08 09:53 UTC. Last push 2026-11-04.
A fast, keyboard-first database client built with Rust and GPUI.
Crecimiento de estrellas medido
- in 24h
- +2
- in 7 days
- Actualización retrasada
- in 15 days
- Actualización retrasada
- in 1 month
- Actualización retrasada
Cambios netos en períodos que se solapan, no totales diarios. Los datos no disponibles se dejan en blanco. Las estrellas indican interés, no calidad.
docs/es/README.md
OriginalDBFlux
English · Español · 한국어 · 简体中文 · Português (Brasil)
Una plataforma de datos extensible y orientada al teclado, distribuida como un cliente de escritorio Rust + GPUI.
dbflux.dev · Documentación · Instalar
Descripción general
DBFlux es un cliente de escritorio de código abierto con drivers integrados para bases de datos relacionales y no relacionales. Sus contratos core son agnósticos al driver, y los drivers externos pueden integrarse por RPC.
El cliente se enfoca en rendimiento, una UX limpia y flujos de trabajo orientados al teclado. El objetivo a largo plazo es un cliente totalmente open-source para cada base de datos con la que trabajes.
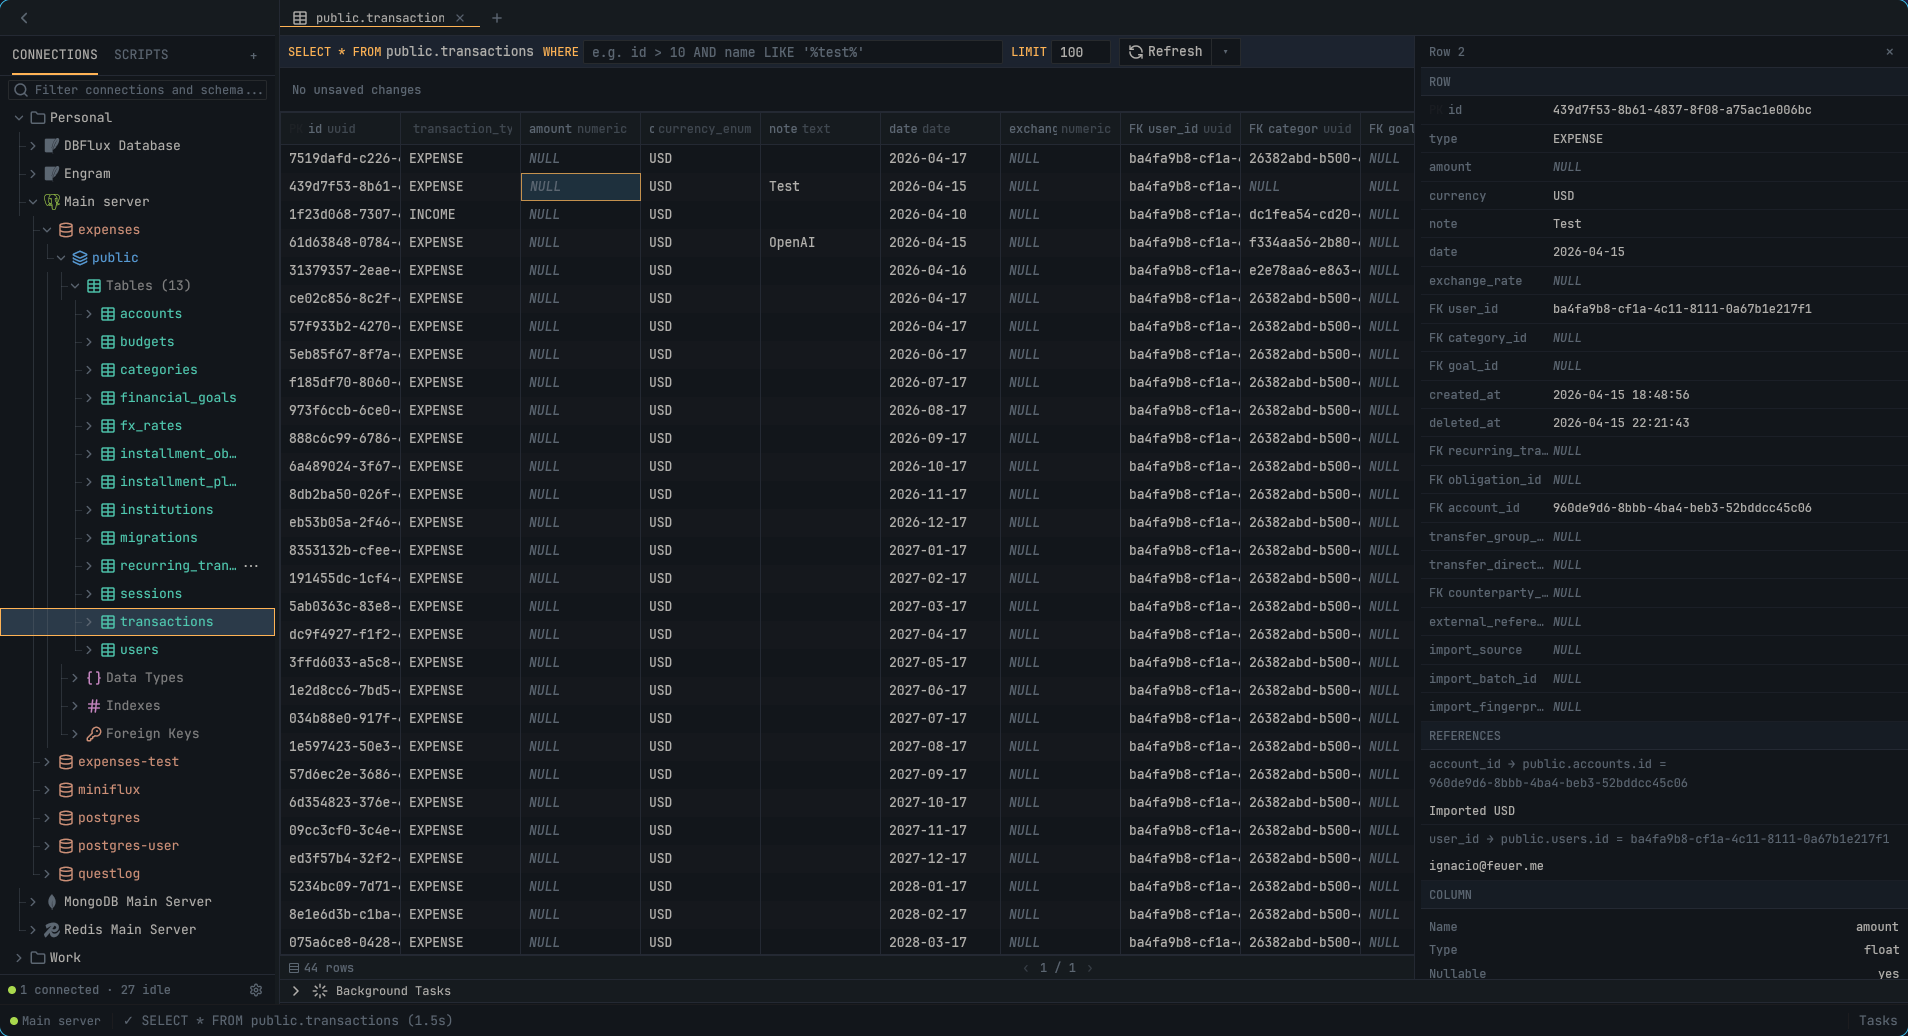
Documentación
Todo lo de abajo se publica en docs.dbflux.dev, renderizado a partir de estos mismos archivos, con búsqueda y un selector de versión. Los enlaces aquí apuntan a la fuente; léelos en el sitio si lo prefieres.
Elige el camino que corresponda a lo que quieres hacer.
Empieza aquí
| Objetivo | Guía |
|---|---|
| Crear una conexión | Comienza con Primeros pasos. Para túneles SSH, proxies, AWS SSO y value sources, usa Conectando — Configuración avanzada. |
| Ejecutar queries y seguir flujos de trabajo comunes | Sigue la Guía de uso para hacer queries, navegar resultados, graficar, exportar y usar la navegación por teclado. |
| Ver eventos de auditoría | Abre el visor de auditoría con la guía del visor de auditoría. |
| Usar MCP | Sigue la Guía de integración de IA + MCP. |
| Revisar el soporte y las limitaciones de drivers | Usa Vista general de drivers, la vista canónica de capacidades y limitaciones. |
Más guías de usuario
- Ajustes y hooks — ajustes, hooks de conexión y perfiles de acceso
- Datos y privacidad — almacenamiento de datos y secretos, backup y reseteo
- Scripting con Lua — el runtime de Lua embebido para hooks
Contribuidores
- Contribuir — configuración, checks y flujo de contribución
- Conceptos clave — el modelo mental breve para contratos y límites de subsistemas
- Autoría de drivers — elige e implementa un driver Rust integrado o un driver externo por RPC
- Arquitectura — el mapa canónico de arquitectura y crates, incluyendo límites de crates y flujos cross-crate
Traducciones
DBFlux se traduce en Hosted Weblate.
Los catálogos viven en crates/dbflux_i18n/locales/, un archivo YAML por idioma, y
las actualizaciones de traducción llegan como pull requests desde Weblate.

Referencia
- Charts — tipos de chart, tipos de columna y auto-detección de ejes
- Dashboards — dashboards, saved charts, métricas de instancia e inspectors
- Auditoría — esquema de eventos de auditoría y redacción
- Protocolo RPC de drivers
- Configuración de servicios RPC
- Proceso de release
- Estilo de código
- Instrucciones para agentes
- Instrucciones para Claude
Instalación
# Linux — instalar en /usr/local
curl -fsSL https://raw.githubusercontent.com/0xErwin1/dbflux/main/scripts/install.sh | sudo bash
Los paquetes para cada plataforma — tarball, AUR, .deb, .rpm, AppImage, Nix, DMG de
macOS e instalador de Windows — están en la página de Releases.
La guía completa, incluyendo los pasos de Gatekeeper y SmartScreen para los builds sin firmar
de macOS y Windows, está en Instalar DBFlux.
En macOS y Linux, Homebrew lo instala con brew install --cask 0xErwin1/dbflux/dbflux.
Funcionalidades
Soporte de bases de datos
- PostgreSQL con modos SSL/TLS (Disable, Prefer, Require)
- Amazon Redshift con SQL de solo lectura sobre el protocolo de wire de PostgreSQL, túnel SSH y certificados TLS/cliente
- MySQL / MariaDB
- SQLite para archivos de base de datos locales
- Microsoft SQL Server (TDS) con TLS, ruteo por instancia nombrada vía SQL Browser e introspección multi-schema
- MongoDB con navegación de colecciones, CRUD de documentos y generación de queries de shell
- Redis con navegación de keys para todos los tipos (String, Hash, List, Set, Sorted Set, Stream)
- DynamoDB con navegación de tablas, CRUD de items y autenticación AWS
- InfluxDB v1 y v2 (InfluxQL en v1, InfluxQL + Flux en v2)
- ClickHouse y ClickHouse Cloud sobre HTTP(S), con descubrimiento de bases de datos/tablas, SELECTs visuales y ejecución explícita de SQL crudo
- TursoDB y libSQL (
sqld) sobre HTTP, con descubrimiento de esquema, CRUD tipado y transacciones interactivas por pestaña del editor - DuckDB en archivos y en memoria, con catálogos DuckLake adjuntados al conectar
- CloudWatch Logs con navegación de log groups/streams y streaming de eventos
- Amazon S3 con navegación de buckets, preview/edición de objetos, CRUD completo y URLs presignadas, incluyendo endpoints compatibles con S3 (Cloudflare R2, MinIO)
- AWS Secrets Manager y Parameter Store con listado paginado, navegación por paths de parámetros, detalles de secretos y lectura auditada del valor solo a pedido explícito
- Drivers externos por RPC (registra drivers fuera de proceso vía el Protocolo RPC de drivers)
Ver docs/DRIVERS.md para una matriz de capacidades completa y limitaciones por driver.
Interfaz de usuario
- Workspace basado en documentos con múltiples tabs de resultados (como DBeaver/VS Code)
- Sidebar colapsable y redimensionable con el comando ToggleSidebar (Ctrl+B)
- Navegador de árbol de schema con lazy loading para bases de datos grandes
- Metadata a nivel de schema: índices, foreign keys, constraints, tipos personalizados (PostgreSQL)
- Carpeta de stored procedures / routines por schema (drivers que los exponen)
- Editor SQL multi-tab con syntax highlighting y ejecución multi-statement (un result set por statement, cuando el driver lo soporta)
- Tabla de datos virtualizada con resize de columnas, scroll horizontal y ordenamiento
- Navegador de tablas con filtros WHERE, LIMIT personalizado y paginación
- Rail inspector del workspace para detalles de fila/documento
- Menú contextual "Copy as Query" para copiar INSERT/UPDATE/DELETE como SQL, shell de MongoDB o comandos de Redis
- Modal de preview de query con syntax highlighting específico del lenguaje
- Command palette con búsqueda difusa
- Sistema de notificaciones toast personalizado con auto-dismiss
- Panel de tareas en background
- Restauración de sesión: los tabs abiertos se restauran al iniciar, y un borrador recuperado que difiere de su archivo nunca lo sobrescribe
Constructor visual de queries
- Constructor de SELECT en el rail derecho: proyección, joins, un árbol anidado de predicados WHERE, ORDER BY y LIMIT/OFFSET, con preview de SQL parametrizado en vivo
- GROUP BY con agregados (COUNT, SUM, AVG, MIN, MAX) y HAVING
- Constructor visual de UPDATE / DELETE con políticas de mutación (solo lectura / requiere aprobación) y ejecución por chunks, cancelable
- Autocompletado consciente del schema en los inputs del constructor y el filtro WHERE de resultados
- Filtros relacionales en la barra de filtros de resultados vía paths de foreign key con puntos (p. ej.
created_by.email LIKE '%@acme.com') - Edición de celda inline y borrado de fila en resultados generados por el constructor cuando mapean 1:1 a una sola tabla
- Queries visuales guardadas por conexión
- Solo drivers SQL (SQLite, PostgreSQL, MySQL/MariaDB, SQL Server); agnóstico al driver por construcción
Charts y visualización
- Grafica cualquier resultado de query o colección: Line, Bar, Scatter, Area, Stacked Bar y Pie
- Detección automática de ejes a partir de los tipos de columna (eje X de timestamp, series Y numéricas) — sin heurísticas por driver
- Charts guardados que se reabren como su propio tab de documento
- Dashboards: organiza charts guardados, dividers y paneles de inspector en una grilla de 12 columnas con un rango de tiempo compartido
- Instance Overview de solo lectura por conexión — métricas de servidor en vivo e inspectors tabulares, con "Save as editable"; PostgreSQL, MySQL/MariaDB, MongoDB, Redis y SQL Server incluyen catálogos de instancia
- Navega e importa dashboards de proveedores upstream (CloudWatch)
- Ver docs/CHARTS.md y docs/DASHBOARDS.md para más detalles
Conectividad y acceso
- Túneles SSH con autenticación por key, contraseña y agent; perfiles de túnel SSH reutilizables
- Túneles proxy SOCKS5 / HTTP CONNECT con perfiles de proxy reutilizables
- Proveedores de acceso administrado (AWS SSM) para conectar sin exponer puertos
- Perfiles de autenticación impulsados por proveedor (p. ej. AWS SSO/shared/static), con importación desde
~/.aws/config - Hooks de conexión en PreConnect/PostConnect/PreDisconnect/PostDisconnect, ejecutables como comando, script o Lua en proceso
Integración de IA y MCP
- Servidor Model Context Protocol (MCP) integrado (
dbflux mcp) para clientes de IA - Capa de gobernanza: clasificación de operaciones, motor de roles/políticas, clientes confiables y flujo de aprobación humana para operaciones de escritura/destructivas
- Ver docs/MCP_AI_INTEGRATION.md
Auditoría y scripting
- Log de auditoría respaldado por SQLite para queries, conexiones, hooks, scripts, MCP, gobernanza y eventos de configuración, con redacción y fingerprinting de queries — ver docs/AUDIT.md
- Reporte de errores centralizado orientado al usuario: los fallos aparecen como un toast con un correlation id y una acción "View in Audit", activan un badge de error en la status bar, y se correlacionan con su fila de auditoría
- Scripts Lua, Python y Bash se ejecutan como documentos con salida en streaming en vivo — ver docs/LUA.md
Navegación por teclado
- Navegación estilo Vim (
j/k/h/l) en toda la app - Keybindings conscientes del contexto (Document, Sidebar, BackgroundTasks)
- Foco de documento con navegación interna de editor/resultados
- Toolbar de resultados:
fpara enfocar,h/lpara navegar,Enterpara editar/ejecutar,Escpara salir - Toggle de sidebar con
Ctrl+B - Cambio de tabs (orden MRU) con
Ctrl+Tab/Ctrl+Shift+Tab
Gestión de queries
- Historial de queries con timestamps
- Queries guardadas con favoritos
- Búsqueda en historial y queries guardadas
Exportación
- Exportación basada en shape: CSV, JSON (pretty/compact), Text, Binary (raw/hex/base64)
- Formato de exportación determinado por el tipo de resultado (table, JSON, text, binary)
Desarrollo
Prerrequisitos
En Linux, el linker mold es obligatorio para builds locales: el
.cargo/config.toml del repo enlaza el target x86_64-unknown-linux-gnu con
-fuse-ld=mold para reducir el tiempo de linkeo y la memoria en los más de 60
crates del workspace. El dev shell de Nix lo provee automáticamente; para
setups sin Nix instálalo con tu gestor de paquetes (incluido abajo). Windows y
macOS usan su linker por defecto y no se ven afectados.
Ubuntu/Debian:
sudo apt install pkg-config libssl-dev libdbus-1-dev libxkbcommon-dev mold
Fedora:
sudo dnf install pkg-config openssl-devel dbus-devel libxkbcommon-devel mold
Arch:
sudo pacman -S pkg-config openssl dbus libxkbcommon mold
macOS:
# Xcode Command Line Tools (obligatorio)
xcode-select --install
Windows:
# Visual Studio Build Tools con el workload de C++ (obligatorio)
# Descarga desde: https://visualstudio.microsoft.com/visual-cpp-build-tools/
Compilar
cargo build -p dbflux --release
Ejecutar
cargo run -p dbflux
Comandos
cargo check --workspace                    # Type checking
python3 scripts/lint.py clippy             # Lint
python3 scripts/lint.py fmt                # Format
cargo test --workspace                     # Tests
Tests más rápidos con nextest
cargo-nextest es el test runner recomendado para este
workspace: ejecuta cada test en su propio proceso en un pool global, lo cual
es notablemente más rápido que cargo test en un workspace de este tamaño. El
dev shell de Nix lo provee; de lo contrario instálalo desde
https://nexte.st/docs/installation.
cargo nextest run --workspace              # tests unitarios + de integración
cargo test --doc --workspace               # doctests (nextest no los ejecuta)
Los tests de integración en vivo (normalmente marcados #[ignore]) usan un flag distinto en nextest:
cargo nextest run -p dbflux_driver_sqlite --run-ignored all
Sitio web
El sitio bajo web/ es un build estático de Astro. Lee docs/, los README de drivers,
ARCHITECTURE.md y CONTRIBUTING.md directamente de git, un set por cada versión publicada, así que editar un
documento es todo lo necesario para cambiar lo que muestra el sitio.
cd web
pnpm install
pnpm dev          # servidor local
pnpm build        # output estático en web/dist
pnpm check        # types
pnpm format       # prettier
Qué versiones se publican se declara en web/versions.json. Cada entrada nombra un git ref; la
versión de producto mostrada para esa entrada se lee del Cargo.toml de ese ref.
DOCS_MODE decide dónde se sirve la documentación: embedded (el default, todo en un
solo origin bajo /docs/), o site y docs para un deployment dividido entre dos hosts. El
desarrollo local usa el default, así que un solo comando sigue levantando el sitio completo.
Dev shell de Nix
Si usas Nix, puedes entrar a un dev shell con todas las dependencias:
# Con flakes
nix develop

# Tradicional
nix-shell
Licencia
MIT & Apache-2.0
Historial de estrellas
Colaboradores
Explorar proyectos relacionados
Asabeneh/30-Days-Of-Python
El reto de programación 30 Days of Python es una guía paso a paso para aprender el lenguaje de programación Python en 30 días. Este reto puede llevar más de 100 días. Sigue tu propio ritmo. Estos vídeos también pueden ayudarte: https://www.youtube.com/channel/UC7PNRuno1rzYPb1xLa4yktw
78,370 estrellasgrafana/grafana
Plataforma abierta y componible de observabilidad y visualización de datos. Visualiza métricas, registros y trazas de múltiples fuentes, como Prometheus, Loki, Elasticsearch, InfluxDB, Postgres y muchas más.
77,763 estrellasredis/redis
Para los desarrolladores que crean aplicaciones en tiempo real basadas en datos, Redis es la opción preferida, la más rápida y la de más funciones como caché, servidor de estructuras de datos y motor de consultas de documentos y vectores.
77,288 estrellasapache/superset
Apache Superset es una plataforma de visualización y exploración de datos.
75,453 estrellas