
BERTopic
MaartenGr
7,942Sterne+5in 24h
Leveraging BERT and c-TF-IDF to create easily interpretable topics.
Finde Frameworks zum Trainieren, Bewerten und Ausführen von Modellen und vergleiche das Community-Interesse.
MaartenGr
Leveraging BERT and c-TF-IDF to create easily interpretable topics.

mrdbourke
All course materials for the Zero to Mastery Machine Learning and Data Science course.

netdata
Der schnellste Weg zur KI-gestützten Full-Stack-Observability, auch für schlanke Teams.

NiuTrans
A comprehensive book on neural networks and large language models in NLP

nmap
Nmap - the Network Mapper. Github mirror of official SVN repository.

NVIDIA
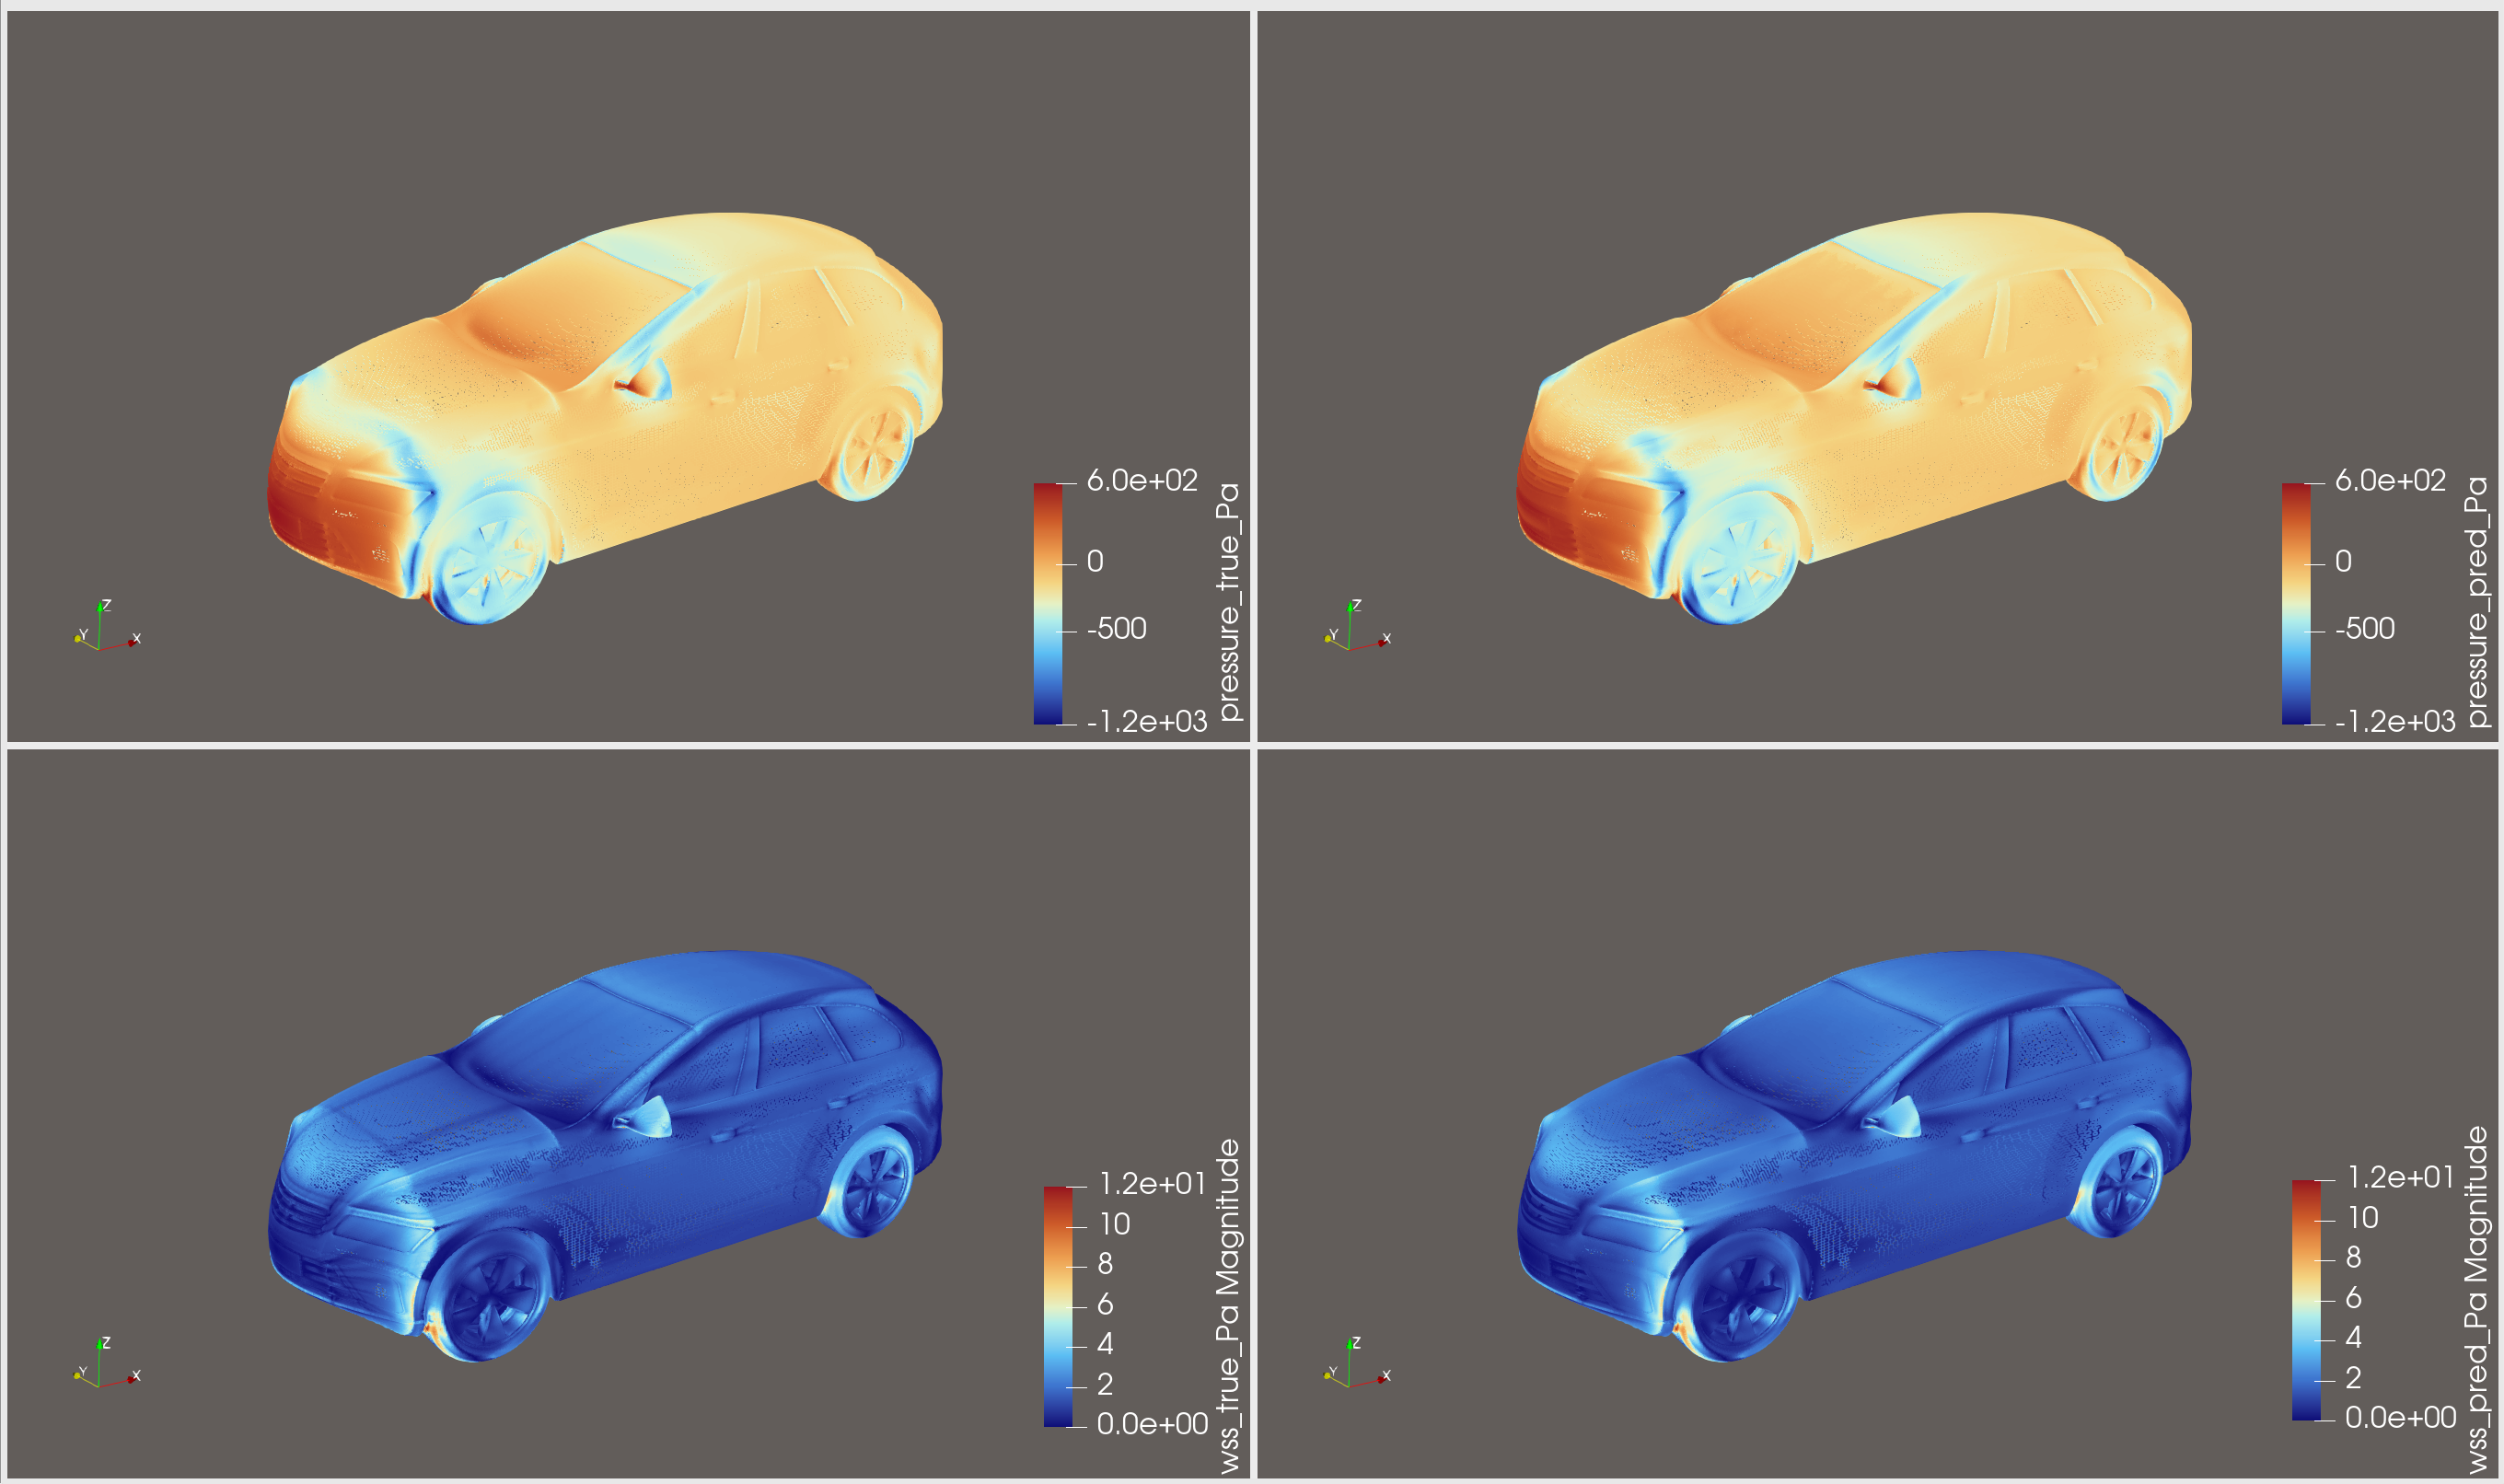
Open-Source-Framework für Deep Learning zum Erstellen, Trainieren und Feinabstimmen von Deep-Learning-Modellen mit modernsten Physics-ML-Methoden

NVlabs

SANA & Sol: Efficient Generative Models and Full-Stack Training & Inference Engines for Image, Video, and World Modeling

onnx

Offener Standard für die Interoperabilität im maschinellen Lernen

sacridini
Umfangreiche Liste geospatialer Tools und Ressourcen

SakuraMathcraft
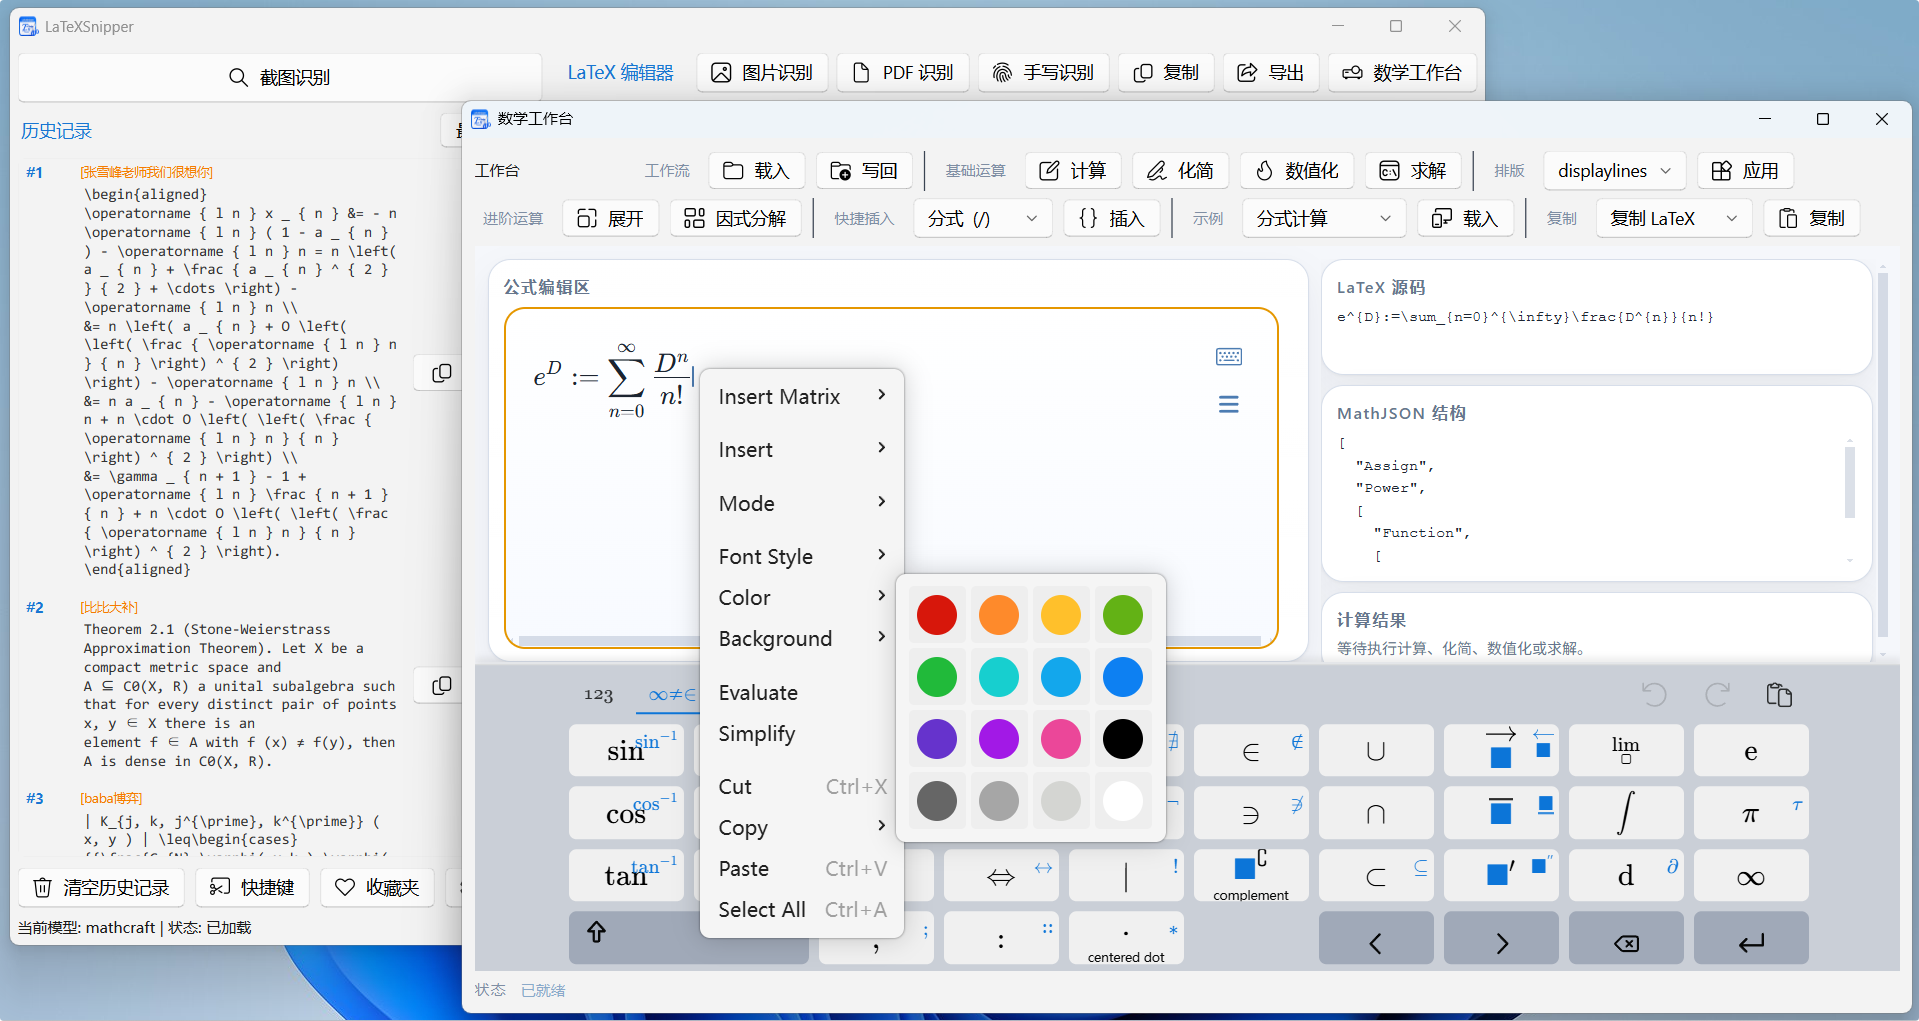
Formula Recognition & Office Editing | Handwriting & PDF to LaTeX/Markdown | Secure API Integrations.

sdatkinson
Neural network emulator for guitar amplifiers.

stas00
Offenes Buch zur Entwicklung von Machine-Learning-Systemen

tkarim45

This repository is a curated collection of hands-on data science projects tailored for beginners. Whether you're just starting your journey in data science or looking to strengthen your skills, these projects provide a practical and interactive way to apply your knowledge.

Unstructured-IO
Convert documents to structured data effortlessly. Unstructured is open-source ETL solution for transforming complex documents into clean, structured formats for language models. Visit our website to learn more about our enterprise grade Platform product for production grade workflows, partitioning, enrichments, chunking and embedding.
”数学不难“ 之 《线性代数不难》上下册,66话题完册;欢迎批评指正

WeThinkIn
【Drei Jahre Bewerbungsgespräche, fünf Jahre Probeinterviews】Ressourcenplattform für Bewerbungsgespräche von Algorithmusentwicklern in den Bereichen AIGC, LLM und AI Agent. Sie umfasst praxisnahe Erfahrungen und Kernwissen mit langfristiger Relevanz für Bewerbungsgespräche und schriftliche Prüfungen zu AIGC, großen Sprachmodellen, AI Agents, verkörperter Intelligenz, klassischem Deep Learning, Computer Vision, natürlicher Sprachverarbeitung, autonomem Fahren, maschinellem Lernen, Reinforcement Learning, Big-Data-Mining, Weltmodellen, dem Metaverse, AGI und weiteren Bereichen der KI-Branche.

YaoFANGUK

视频硬字幕提取,生成srt文件。无需申请第三方API,本地实现文本识别。基于深度学习的视频字幕提取框架,包含字幕区域检测、字幕内容提取。A GUI tool for extracting hard-coded subtitle (hardsub) from videos and generating srt files.

alphacep
Offline-Spracherkennungs-API für Android, iOS, Raspberry Pi und Server mit Unterstützung für Python, Java, C# und Node
Sammlung von Papers und Open-Source-Projekten der CVPR 2026

bbfamily

Abu-Quant-Trading-System (Aktien, Optionen, Futures, Bitcoin und maschinelles Lernen), eine auf Python basierende Open-Source-Architektur für quantitativen Handel und quantitative Geldanlage.

charliedream1
Stock AI Trader: eine All-in-one-Plattform zum Lernen sowie für simulierten und Live-Handel. Behandelt werden Aktiengrundlagen, Strategien, LLMs, Faktor-Mining, ML/DL/RL, Graphnetzwerke, HFT, C++-Deployment und JoinQuant-Code.

ChristosChristofidis

Eine kuratierte Liste hervorragender Tutorials, Projekte und Communities zum Deep Learning.

dair-ai
🧮 A collection of resources to learn mathematics for machine learning

dmlc

Skalierbare, portable und verteilte Gradient-Boosting-Bibliothek (GBDT, GBRT oder GBM) für Python, R, Java, Scala, C und weitere Sprachen. Läuft auf einem einzelnen Rechner sowie auf Hadoop, Spark, Dask, Flink und DataFlow.

