
yueliu1999/Awesome-Efficient-Inference-for-LRMs
yueliu1999/Awesome-Efficient-Inference-for-LRMs has 244 GitHub stars and 20 forks. Star changes are not measured yet. Last checked 2026-11-15 20:05 UTC. Last push 2026-10-26.
Gemessener Sternzuwachs
- in 24h
- Aktualisierung verzögert
- in 7 days
- Aktualisierung verzögert
- in 15 days
- Aktualisierung verzögert
- in 1 month
- Aktualisierung verzögert
Nettoänderungen in überlappenden Zeiträumen, keine Tagessummen. Fehlende Messwerte bleiben leer. Sterne zeigen Interesse, nicht Qualität.
Über uns
[IEEE T-PAMI] Awesome-Efficient-Inference-for-LRMs is a collection of state-of-the-art, novel, exciting, token-efficient methods for Large Reasoning Models (LRMs). It contains papers, codes, datasets, evaluations, and analyses. https://arxiv.org/pdf/2503.23077
LernenREADME.md
OriginalAwesome-Efficient-Inference-for-LRMs
Awesome-Efficient-Inference-for-LRMs is a collection of state-of-the-art, novel, exciting, token-efficient methods for Large Reasoning Models (LRMs). It contains papers, codes, datasets, evaluations, and analyses. Any additional things regarding efficient inference for LRMs, PRs, and issues are welcome, and we are glad to add you to the contributor list here. Any problems, please contact [email protected]. Our survey paper is online: Efficient Inference for Large Reasoning Models: A Survey. If you find this repository useful to your research or work, it is really appreciated if to star this repository and cite our papers here. :sparkles:
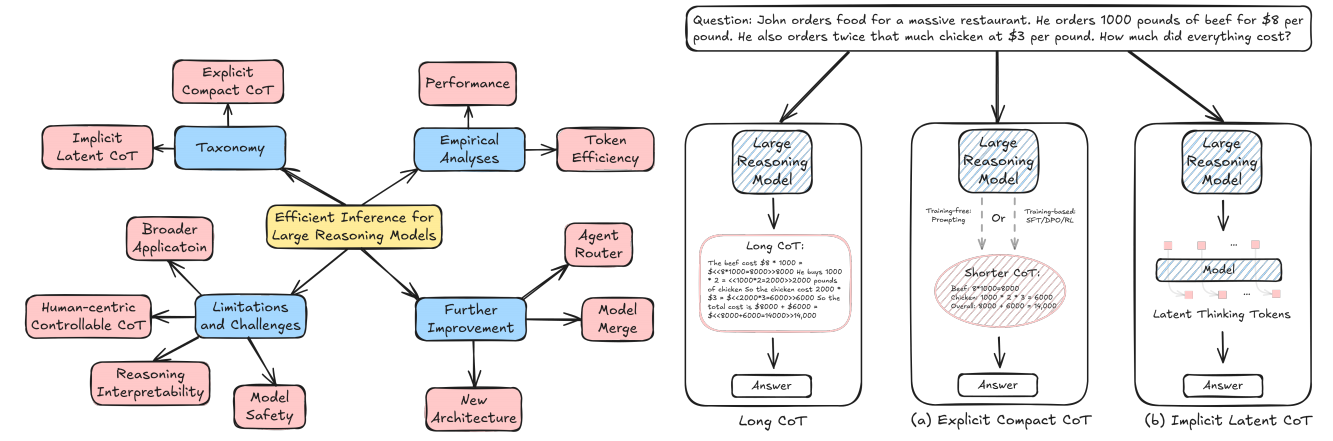
Update
- (2026/06/07) Added 40+ new papers (2025.05–2026.06) across Explicit Compact CoT, Implicit Latent CoT, Limitations & Challenges, Further Improvement, and Survey.
- (2026/05/31) Our survey paper has been accepted by the IEEE T-PAMI 2026.
- (2025/03/29) Our survey paper is online: Efficient Inference for Large Reasoning Models: A Survey.
Reference
If you find this repository helpful for your research, we would greatly appreciate it if you could cite our papers. :sparkles:
@article{liu2025efficient,
  title={Efficient Inference for Large Reasoning Models: A Survey},
  author={Liu, Yue and Wu, Jiaying and He, Yufei and Gao, Hongcheng and Chen, Hongyu and Bi, Baolong and Zhang, Jiaheng and Huang, Zhiqi and Hooi, Bryan},
  journal={arXiv preprint arXiv:2503.23077},
  year={2025}
}
Bookmarks
Papers
Survey
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2026.05 | Efficient Inference for Large Reasoning Models: A Survey | IEEE T-PAMI'26 | link | link |
| 2025.08 | Don't Overthink It: A Survey of Efficient R1-style Large Reasoning Models | arXiv'25 | link | - |
| 2025.07 | Towards Concise and Adaptive Thinking in Large Reasoning Models: A Survey | arXiv'25 | link | - |
| 2025.07 | Reasoning on a Budget: A Survey of Adaptive and Controllable Test-Time Compute in LLMs | arXiv'25 | link | - |
| 2025.04 | Reasoning Beyond Language: A Comprehensive Survey on Latent Chain-of-Thought Reasoning | arXiv'25 | link | link |
| 2025.04 | Efficient Reasoning Models: A Survey | arXiv'25 | link | link |
| 2025.03 | Efficient Inference for Large Reasoning Models: A Survey | arXiv'25 | link | link |
| 2025.03 | Harnessing the Reasoning Economy: A Survey of Efficient Reasoning for Large Language Models | arXiv'25 | link | link |
| 2025.03 | A Survey of Efficient Reasoning for Large Reasoning Models: Language, Multimodality, and Beyond | arXiv'25 | link | link |
| 2025.03 | Stop Overthinking: A Survey on Efficient Reasoning for Large Language Models | arXiv'25 | link | link |
Explicit Compact CoT
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2026.10 | DoubtLess: Training-Free Contrastive Decoding for Efficient Reasoning | arXiv'26 | link | link |
| 2026.05 | Stop When Reasoning Converges: Semantic-Preserving Early Exit for Reasoning Models | arXiv'26 | link | link |
| 2026.03 | Efficient Reasoning with Balanced Thinking (ReBalance) | arXiv'26 | link | - |
| 2026.03 | Draft-Thinking: Learning Efficient Reasoning in Long Chain-of-Thought LLMs | arXiv'26 | link | - |
| 2026.02 | Towards Efficient Large Language Reasoning Models via Extreme-Ratio Chain-of-Thought Compression | arXiv'26 | link | - |
| 2026.02 | Self-Verification Dilemma: Experience-Driven Suppression of Overused Checking in LLM Reasoning | arXiv'26 | link | - |
| 2026.02 | Short Chains, Deep Thoughts: Balancing Reasoning Efficiency and Intra-Segment Capability via Split-Merge Optimization | arXiv'26 | link | - |
| 2026.01 | Mitigating Overthinking in Large Reasoning Models via Difficulty-aware Reinforcement Learning | arXiv'26 | link | - |
| 2025.10 | DLER: Doing Length pEnalty Right - Incentivizing More Intelligence per Token via Reinforcement Learning | arXiv'25 | link | - |
| 2025.10 | Learning to Reason Efficiently with Discounted Reinforcement Learning | arXiv'25 | link | - |
| 2025.10 | Beyond Token Length: Step Pruner for Efficient and Accurate Reasoning in Large Language Models | arXiv'25 | link | - |
| 2025.09 | Your Models Have Thought Enough: Training Large Reasoning Models to Stop Overthinking | arXiv'25 | link | - |
| 2025.08 | Making Slow Thinking Faster: Compressing LLM Chain-of-Thought via Step Entropy | arXiv'25 | link | link |
| 2025.08 | BudgetThinker: Empowering Budget-aware LLM Reasoning with Control Tokens | arXiv'25 | link | - |
| 2025.08 | Efficient Reasoning for Large Reasoning Language Models via Certainty-Guided Reflection Suppression | arXiv'25 | link | - |
| 2025.07 | Think Clearly: Improving Reasoning via Redundant Token Pruning | arXiv'25 | link | - |
| 2025.06 | Structured Reasoning for LLMs: A Unified Framework for Efficiency and Explainability | ICLR'26 | link | link |
| 2025.06 | AALC: Large Language Model Efficient Reasoning via Adaptive Accuracy-Length Control | arXiv'25 | link | - |
| 2025.06 | Steering LLM Thinking with Budget Guidance | arXiv'25 | link | link |
| 2025.06 | Exploring and Exploiting the Inherent Efficiency within Large Reasoning Models for Self-Guided Efficiency Enhancement | arXiv'25 | link | - |
| 2025.05 | REA-RL: Reflection-Aware Online Reinforcement Learning for Efficient Reasoning | arXiv'25 | link | link |
| 2025.05 | Can Pruning Improve Reasoning? Revisiting Long-CoT Compression with Capability in Mind for Better Reasoning | arXiv'25 | link | - |
| 2025.05 | Long-Short Chain-of-Thought Mixture Supervised Fine-Tuning Eliciting Efficient Reasoning in Large Language Models | arXiv'25 | link | link |
| 2025.05 | ConCISE: Confidence-guided Compression in Step-by-step Efficient Reasoning | arXiv'25 | link | - |
| 2025.05 | Scalable Chain of Thoughts via Elastic Reasoning | arXiv'25 | link | - |
| 2025.05 | S-GRPO: Early Exit via Reinforcement Learning in Reasoning Models | arXiv'25 | link | - |
| 2025.05 | Making Small Language Models Efficient Reasoners: Intervention, Supervision, Reinforcement | arXiv'25 | link | - |
| 2025.05 | Accelerating Chain-of-Thought Reasoning: When Goal-Gradient Importance Meets Dynamic Skipping | arXiv'25 | link | - |
| 2025.05 | SelfBudgeter: Adaptive Token Allocation for Efficient LLM Reasoning | arXiv'25 | link | - |
| 2025.05 | Not All Thoughts are Generated Equal: Efficient LLM Reasoning via Multi-Turn Reinforcement Learning | arXiv'25 | link | link |
| 2025.05 | Fractured Chain-of-Thought Reasoning | arXiv'25 | link | - |
| 2025.05 | Efficient RL Training for Reasoning Models via Length-Aware Optimization | arXiv'25 | link | - |
| 2025.05 | DRP: Distilled Reasoning Pruning with Skill-aware Step Decomposition for Efficient Large Reasoning Models | arXiv'25 | link | - |
| 2025.05 | FlashThink: An Early Exit Method For Efficient Reasoning | arXiv'25 | link | - |
| 2025.05 | Optimizing Anytime Reasoning via Budget Relative Policy Optimization | arXiv'25 | link | link |
| 2025.05 | VeriThinker: Learning to Verify Makes Reasoning Model Efficient | arXiv'25 | link | link |
| 2025.05 | Reasoning Path Compression: Compressing Generation Trajectories for Efficient LLM Reasoning | arXiv'25 | link | link |
| 2025.05 | ThinkLess: A Training-Free Inference-Efficient Method for Reducing Reasoning Redundancy | arXiv'25 | link | - |
| 2025.05 | Learn to Reason Efficiently with Adaptive Length-based Reward Shaping | arXiv'25 | link | link |
| 2025.05 | R1-Compress: Long Chain-of-Thought Compression via Chunk Compression and Search | arXiv'25 | link | link |
| 2025.05 | Incentivizing Dual Process Thinking for Efficient Large Language Model Reasoning | arXiv'25 | link | - |
| 2025.05 | ConciseRL: Conciseness-Guided Reinforcement Learning for Efficient Reasoning Models | arXiv'25 | link | link |
| 2025.05 | TrimR: Verifier-based Training-Free Thinking Compression for Efficient Test-Time Scaling | arXiv'25 | link | - |
| 2025.05 | Not All Tokens Are What You Need In Thinking | arXiv'25 | link | link |
| 2025.05 | LIMOPro: Reasoning Refinement for Efficient and Effective Test-time Scaling | arXiv'25 | link | link |
| 2025.05 | Walk Before You Run! Concise LLM Reasoning via Reinforcement Learning | arXiv'25 | link | link |
| 2025.05 | CoThink: Token-Efficient Reasoning via Instruct Models Guiding Reasoning Models | arXiv'25 | link | - |
| 2025.05 | Don't Think Longer, Think Wisely: Optimizing Thinking Dynamics for Large Reasoning Models | arXiv'25 | link | - |
| 2025.05 | A*-Thought: Efficient Reasoning via Bidirectional Compression for Low-Resource Settings | arXiv'25 | link | link |
| 2025.05 | Efficient Reasoning via Chain of Unconscious Thought | arXiv'25 | link | link |
| 2025.04 | Syzygy of Thoughts: Improving LLM CoT with the Minimal Free Resolution | arXiv'25 | link | link |
| 2025.03 | Sketch-of-thought: Efficient llm reasoning with adaptive cognitive-inspired sketching (SoT) | arXiv'25 | link | link |
| 2025.03 | SOLAR: Scalable Optimization of Large-scale Architecture for Reasoning | arXiv'25 | link | - |
| 2025.03 | InftyThink: Breaking the Length Limits of Long-Context Reasoning in Large Language Models | arXiv'25 | link | - |
| 2025.03 | L1: Controlling How Long A Reasoning Model Thinks With Reinforcement Learning | arXiv'25 | link | link |
| 2025.03 | Optimizing Test-Time Compute via Meta Reinforcement Fine-Tuning | arXiv'25 | link | link |
| 2025.02 | Chain of Draft: Thinking Faster by Writing Less | arXiv'25 | link | link |
| 2025.02 | Meta-Reasoner: Dynamic Guidance for Optimized Inference-time Reasoning in Large Language Models | arXiv'25 | link | - |
| 2025.02 | TokenSkip: Controllable Chain-of-Thought Compression in LLMs | arXiv'25 | link | link |
| 2025.02 | LightThinker: Thinking Step-by-Step Compression | arXiv'25 | link | link |
| 2025.02 | CoT-Valve: Length-Compressible Chain-of-Thought Tuning | arXiv'25 | link | - |
| 2025.02 | Self-Training Elicits Concise Reasoning in Large Language Models | arXiv'25 | link | link |
| 2025.02 | DAST: Context-Aware Compression in LLMs via Dynamic Allocation of Soft Tokens | arXiv'25 | link | - |
| 2025.02 | Training Language Models to Reason Efficiently | arXiv'25 | link | link |
| 2025.02 | Anthropic. Claude 3.7 sonnet and claude code | Anthropic'25 | link | - |
| 2025.02 | Stepwise Perplexity-Guided Refinement for Efficient Chain-of-Thought Reasoning in Large Language Models | arXiv'25 | link | - |
| 2025.01 | Kimi k1.5: Scaling Reinforcement Learning with LLMs | arXiv'25 | link | - |
| 2025.01 | O1-Pruner: Length-Harmonizing Fine-Tuning for O1-Like Reasoning Pruning | arXiv'25 | link | link |
| 2025.01 | Think Smarter not Harder: Adaptive Reasoning with Inference Aware Optimization | arXiv'25 | link | - |
| 2024.12 | C3oT: Generating Shorter Chain-of-Thought without Compromising Effectiveness | arXiv'24 | link | - |
| 2024.12 | Token-Budget-Aware LLM Reasoning | arXiv'24 | link | link |
| 2024.12 | Verbosity-Aware Rationale Reduction: Effective Reduction of Redundant Rationale via Principled Criteria | arXiv'24 | link | - |
| 2024.11 | Can Language Models Learn to Skip Steps? | arXiv'24 | link | link |
| 2024.07 | Concise Thoughts: Impact of Output Length on LLM Reasoning and Cost | arXiv'24 | link | - |
| 2024.07 | Distilling System 2 into System 1 | arXiv'24 | link | - |
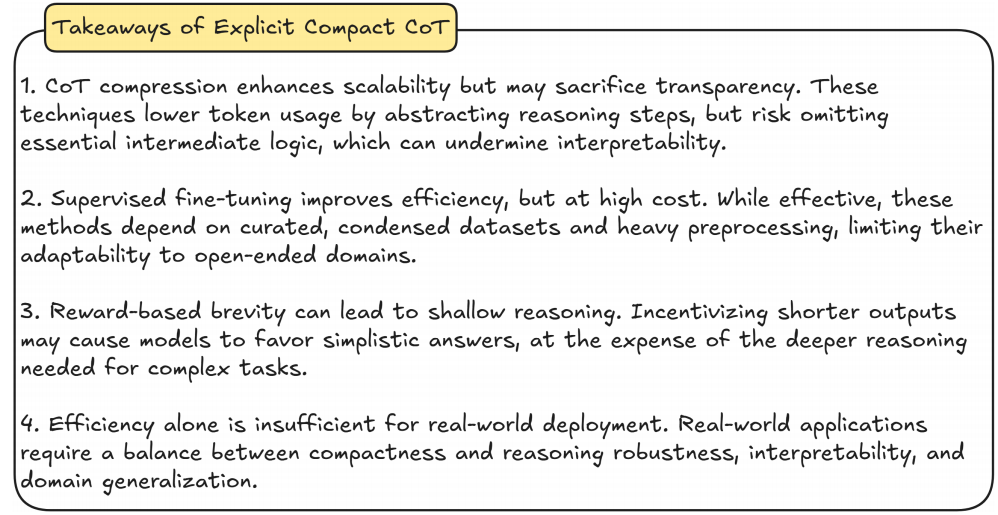
Implicit Latent CoT
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2026.05 | Selective Latent Thinking: Adaptive Compression of LLM Reasoning Chains | arXiv'26 | link | link |
| 2026.05 | LatentRAG: Latent Reasoning and Retrieval for Efficient Agentic RAG | arXiv'26 | link | - |
| 2026.04 | Thinking Without Words: Efficient Latent Reasoning with Abstract Chain-of-Thought | arXiv'26 | link | - |
| 2026.02 | LoopFormer: Elastic-Depth Looped Transformers for Latent Reasoning via Shortcut Modulation | arXiv'26 | link | - |
| 2025.10 | KaVa: Latent Reasoning via Compressed KV-Cache Distillation | arXiv'25 | link | - |
| 2025.05 | Soft Thinking: Unlocking the Reasoning Potential of LLMs in Continuous Concept Space | arXiv'25 | link | link |
| 2025.05 | Think Silently, Think Fast: Dynamic Latent Compression of LLM Reasoning Chains | arXiv'25 | link | link |
| 2025.02 | CODI: Compressing Chain-of-Thought into Continuous Space via Self-Distillation | arXiv'25 | link | - |
| 2025.02 | Token Assorted: Mixing Latent and Text Tokens for Improved Language Model Reasoning | arXiv'25 | link | - |
| 2025.02 | SoftCoT: Soft Chain-of-Thought for Efficient Reasoning with LLMs | arXiv'25 | link | - |
| 2025.01 | Efficient Reasoning with Hidden Thinking | arXiv'25 | link | link |
| 2024.12 | Training Large Language Models to Reason in a Continuous Latent Space | arXiv'24 | link | - |
| 2024.12 | Compressed Chain of Thought: Efficient Reasoning Through Dense Representations | arXiv'24 | link | - |
| 2024.05 | From Explicit CoT to Implicit CoT: Learning to Internalize CoT Step by Step | arXiv'24 | link | link |
| 2023.11 | Implicit Chain of Thought Reasoning via Knowledge Distillation | arXiv'23 | link | link |
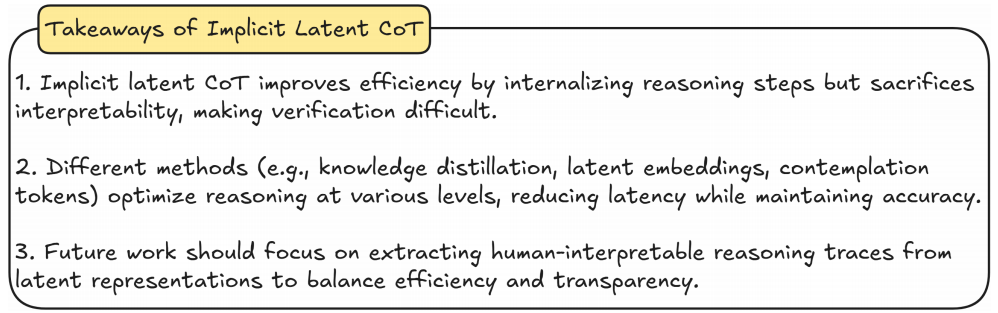
Limitations and Challenges
User-centric Controllable Reasoning
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2026.02 | Conformal Thinking: Risk Control for Reasoning on a Compute Budget | arXiv'26 | link | - |
| 2025.10 | e1: Learning Adaptive Control of Reasoning Effort | arXiv'25 | link | - |
| 2025.05 | When to Continue Thinking: Adaptive Thinking Mode Switching for Efficient Reasoning (ASRR) | arXiv'25 | link | - |
| 2025.02 | OpenAI o3-mini System Card | OpenAI'25 | link | - |
| 2025.02 | Anthropic. Claude 3.7 sonnet and claude code | Anthropic'25 | link | - |
Interpretability of Reasoning
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2026.06 | Unlocking the Black Box of Latent Reasoning: An Interpretability-Guided Approach to Intervention | arXiv'26 | link | - |
| 2026.04 | Are Latent Reasoning Models Easily Interpretable? | arXiv'26 | link | - |
| 2026.04 | LLM Reasoning Is Latent, Not the Chain of Thought | arXiv'26 | link | - |
| 2024.05 | FiDeLiS: Faithful Reasoning in Large Language Model for Knowledge Graph Question Answering | arXiv'24 | link | - |
| 2024.02 | Challenges and barriers of using large language models (LLM) such as ChatGPT for diagnostic medicine with a focus on digital pathology - a recent scoping review | Diagnostic pathology'24 | link | - |
| 2024.02 | (A)I Am Not a Lawyer, But...: Engaging Legal Experts towards Responsible LLM Policies for Legal Advice | arXiv'24 | link | - |
| 2023.12 | Retrieval-Augmented Generation for Large Language Models: A Survey | arXiv'23 | link | link |
| 2023.10 | Contribution and performance of ChatGPT and other Large Language Models (LLM) for scientific and research advancements: a double-edged sword | International Research Journal of Modernization in Engineering Technology and Science'23 | link | - |
| 2023.08 | Reasoning in Large Language Models Through Symbolic Math Word Problems | arXiv'23 | link | - |
| 2021.12 | Chapter 1. Neural-Symbolic Learning and Reasoning: A Survey and Interpretation1 | Neuro-Symbolic Artificial Intelligence'21 | link | - |
Reasoning Safety
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2025.05 | The First Impression Problem: Internal Bias Triggers Overthinking in Reasoning Models | arXiv'25 | link | - |
| 2025.03 | Optimizing Test-Time Compute via Meta Reinforcement Fine-Tuning | arXiv'25 | link | link |
| 2025.03 | Detecting misbehavior in frontier reasoning models | OpenAI'25 | link | - |
| 2025.02 | Evaluating the Paperclip Maximizer: Are RL-Based Language Models More Likely to Pursue Instrumental Goals? | arXiv'25 | link | link |
| 2025.01 | O1-Pruner: Length-Harmonizing Fine-Tuning for O1-Like Reasoning Pruning | arXiv'25 | link | link |
| 2025.01 | GuardReasoner: Towards Reasoning-based LLM Safeguards | arXiv'25 | link | link |
| 2025.01 | Kimi k1.5: Scaling Reinforcement Learning with LLMs | arXiv'25 | link | - |
| 2024.12 | C3oT: Generating Shorter Chain-of-Thought without Compromising Effectiveness | arXiv'24 | link | - |
| 2024.10 | FlipAttack: Jailbreak LLMs via Flipping | arXiv'24 | link | link |
| 2023.10 | Privacy in Large Language Models: Attacks, Defenses and Future Directions | arXiv'23 | link | - |
Broader Application
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2025.03 | SOLAR: Scalable Optimization of Large-scale Architecture for Reasoning | arXiv'25 | link | - |
| 2025.03 | Large language models (LLM) in computational social science: prospects, current state, and challenges | Social Network Analysis and Mining'25 | link | - |
| 2025.03 | Gemini robotics brings ai into the physical world | Google'25 | link | - |
| 2025.03 | Nvidia isaac gr00t n1: An open foundation model for humanoid robots. | Nvidia'25 | link | - |
| 2025.02 | Anthropic. Claude 3.7 sonnet and claude code | Anthropic'25 | link | - |
| 2025.02 | TokenSkip: Controllable Chain-of-Thought Compression in LLMs | arXiv'25 | link | link |
| 2025.02 | RoboBrain: A Unified Brain Model for Robotic Manipulation from Abstract to Concrete | arXiv'25 | link | - |
| 2025.02 | From Personas to Talks: Revisiting the Impact of Personas on LLM-Synthesized Emotional Support Conversations | arXiv'25 | link | - |
| 2025.02 | Introducing deep research | OpenAI'25 | link | - |
| 2025.02 | Introducing gpt-4.5 | OpenAI'25 | link | - |
| 2025.01 | Kimi k1.5: Scaling Reinforcement Learning with LLMs | arXiv'25 | link | - |
| 2024.12 | Compressed Chain of Thought: Efficient Reasoning Through Dense Representations | arXiv'24 | link | - |
| 2024.08 | Large Language Model Agent in Financial Trading: A Survey | arXiv'24 | link | - |
| 2024.04 | Automated Social Science: Language Models as Scientist and Subjects | arXiv'24 | link | link |
| 2023.11 | LLM4Drive: A Survey of Large Language Models for Autonomous Driving | arXiv'24 | link | link |
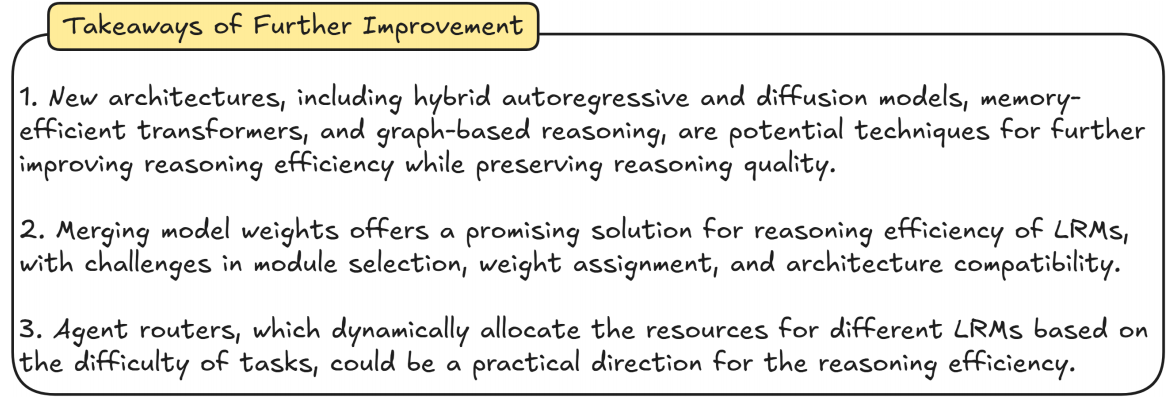
Further Improvement
New Architecture
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2026.06 | Genesis 2: Cascade MoE for Ultra-Efficient CPU Inference | GitHub'26 | - | link |
| 2025.10 | ThinKV: Thought-Adaptive KV Cache Compression for Efficient Reasoning Models | ICLR'26 | link | - |
| 2025.05 | R-KV: Redundancy-aware KV Cache Compression for Reasoning Models | arXiv'25 | link | - |
| 2025.02 | Large Language Diffusion Models | arXiv'25 | link | link |
| 2025.02 | UniGraph2: Learning a Unified Embedding Space to Bind Multimodal Graphs | arXiv'25 | link | link |
| 2024.03 | Graph of Thoughts: Solving Elaborate Problems with Large Language Models | AAAI Conference on Artificial Intelligence'24 | link | link |
| 2024.02 | UniGraph: Learning a Unified Cross-Domain Foundation Model for Text-Attributed Graphs | arXiv'24 | link | link |
| 2023.12 | Mamba: Linear-Time Sequence Modeling with Selective State Spaces | arXiv'23 | link | link |
| 2023.10 | Language Agent Tree Search Unifies Reasoning Acting and Planning in Language Models | arXiv'23 | link | link |
| 2023.05 | RWKV: Reinventing RNNs for the Transformer Era | arXiv'23 | link | link |
| 2017.10 | Mastering the game of Go without human knowledge | nature'17 | link | - |
Model Merge
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2026.04 | Multi-objective Evolutionary Merging Enables Efficient Reasoning Models | arXiv'26 | link | - |
| 2025.09 | The Thinking Spectrum: An Empirical Study of Tunable Reasoning in LLMs through Model Merging | arXiv'25 | link | - |
| 2025.06 | Accelerated Test-Time Scaling with Model-Free Speculative Sampling | arXiv'25 | link | - |
| 2025.03 | Unlocking Efficient Long-to-Short LLM Reasoning with Model Merging | arXiv'25 | link | link |
| 2025.03 | SOLAR: Scalable Optimization of Large-scale Architecture for Reasoning | arXiv'25 | link | - |
| 2025.03 | Optimizing Test-Time Compute via Meta Reinforcement Fine-Tuning | arXiv'25 | link | link |
| 2025.02 | Meta-Reasoner: Dynamic Guidance for Optimized Inference-time Reasoning in Large Language Models | arXiv'25 | link | - |
| 2025.01 | Kimi k1.5: Scaling Reinforcement Learning with LLMs | arXiv'25 | link | - |
| 2025.01 | DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning | arXiv'25 | link | - |
| 2024.12 | Token-Budget-Aware LLM Reasoning | arXiv'24 | link | link |
| 2024.08 | Model Merging in LLMs, MLLMs, and Beyond: Methods, Theories, Applications and Opportunities | arXiv'24 | link | link |
| 2024.07 | The Llama 3 Herd of Models | arXiv'24 | link | link |
Agent Router
| Time | Title | Venue | Paper | Code |
|---|---|---|---|---|
| 2026.05 | Breaking the Reward Barrier: Accelerating Tree-of-Thought Reasoning via Speculative Exploration (SPEX) | arXiv'26 | link | - |
| 2026.04 | Step-GRPO: Internalizing Dynamic Early Exit for Efficient Reasoning | arXiv'26 | link | - |
| 2026.04 | Early Stopping for Large Reasoning Models via Confidence Dynamics | arXiv'26 | link | - |
| 2026.03 | Ares: Adaptive Reasoning Effort Selection for Efficient LLM Agents | arXiv'26 | link | - |
| 2025.09 | FastTTS: Accelerating Test-Time Scaling for Edge LLM Reasoning | ASPLOS'26 | link | - |
| 2025.06 | SPECS: Faster Test-Time Scaling through Speculative Drafts | arXiv'25 | link | - |
| 2025.05 | R2R: Efficiently Navigating Divergent Reasoning Paths with Small-Large Model Token Routing | arXiv'25 | link | link |
| 2025.04 | SpecReason: Fast and Accurate Inference-Time Compute via Speculative Reasoning | arXiv'25 | link | link |
| 2025.02 | Confident or Seek Stronger: Exploring Uncertainty-Based On-device LLM Routing From Benchmarking to Generalization | arXiv'25 | link | - |
| 2025.01 | RouteLLM: Learning to Route LLMs from Preference Data | The Thirteenth International Conference on Learning Representations'25 | link | - |
| 2024.10 | Learning to Route LLMs with Confidence Tokens | arXiv'24 | link | - |
| 2024.09 | RouterDC: Query-Based Router by Dual Contrastive Learning for Assembling Large Language Models | The Thirty-Ninth Annual Conference on Neural Information Processing Systems | link |
Contributors


