
tocreator/tostore
tocreator/tostore has 67 GitHub stars and 11 forks. GitHot measured 0 stars in 24 hours and 0 in 7 days. Last checked 2026-11-15 04:06 UTC. Last push 2026-11-05.
What you can do
- Declarative schema changes—automatic refactoring, no manual versioning
- Key rotation, schema migration, massive refactoring—all online, business-transparent
- Built-in status spec for automated O&M and Agent recognition
- Supports autonomous evolution and continuous iteration without interrupting service
Gemessener Sternzuwachs
- in 24h
- 0
- in 7 days
- 0
- in 15 days
- Verlauf wird gesammelt
- in 1 month
- Verlauf wird gesammelt
Nettoänderungen in überlappenden Zeiträumen, keine Tagessummen. Fehlende Messwerte bleiben leer. Sterne zeigen Interesse, nicht Qualität.
Über uns
Data engine: AI vector & SQL/NoSQL database. Key-value/KV, embeddings, BM25 full-text, hybrid & semantic search for RAG/LLM. Local storage, TTL/LRU cache, offline encrypted.
KIdoc/translations/de/README.md
Original


English | 简体中文 | 日本語 | 한국어 | Español | Português (Brasil) | Русский | Deutsch | Français | Italiano | Türkçe
Schnelle Navigation
- Why ToStore | Hauptmerkmale | Installationsanleitung | KV-Modus | Tabellenmodus | Speichermodus
- Schemadefinition | Verteilte Architektur | Kaskadierende Fremdschlüssel | Mobil/Desktop | Server/Agent | Primärschlüsselalgorithmen
- Erweiterte Abfragen (JOIN) | Aggregation & Statistik | Komplexe Logik (Abfragebedingung) | Reaktive Abfrage (beobachten) | Streaming-Anfrage
- Fortgeschrittenes KV | Stapeloperationen | Wiederherstellungsgarantie | Hybridabruf (dicht / sparse / Text) | TTL auf Tabellenebene | Kapazitätsbereinigung | Effiziente Paginierung | Speicher-Sonde und synchrone Abfrage (peek) | Abfrage-Cache | Atomare Ausdrücke | Transaktionen
- Administration | Sicherheitskonfiguration | Fehlerbehandlung | Leistung und Diagnose | Mitwirken | KI-Assistenten
Warum ToStore wählen?
ToStore ist eine moderne Daten-Engine für die AGI-Ära und Edge-Intelligence-Szenarien. Basierend auf einer Self-Routing-Knotenarchitektur bietet sie Knoten hohe Autonomie und elastische horizontale Skalierbarkeit, wobei Leistung und Datenumfang logisch entkoppelt werden — Edge- und Cloud-Einzelknoten sind auf strukturierte Tabellen im Billionen-Maßstab ausgelegt; Vektor- und Sparse-Text-Abruf zielen ebenfalls auf 10B+ ab.
Runtime-Modellierung und nicht-blockierende Ausführungspfade halten die Architekturentwicklung stets online und vollständig transparent für den Geschäftsbetrieb – deklarativer Schemawechsel, Rotation der Datenkodierungsschlüssel und umfangreiches Daten-Refactoring erfolgen nahtlos online. Es unterstützt Agenten und automatisiertes O&M mit Tabellenerstellung zur Laufzeit, dynamischer Speicherevolution sowie deren autonomer Evolution und kontinuierlicher Iteration — ohne Dienstunterbrechung.
Es vereint relationale strukturierte Daten, dichte Vektoren, neuronale Sparse-Vektoren und unstrukturierten Text in einer Engine, mit integriertem lexikalischem Textabruf, dichtem Vektorabruf, neuronalem Sparse-Abruf und mehrwegiger Recall-Fusion. Enterprise-Funktionen umfassen ACID-Transaktionen, komplexe relationale Abfragen (JOINs, kaskadierende Fremdschlüssel), TTL auf Tabellenebene, Aggregationen sowie verteilte Primärschlüsselalgorithmen, atomare Ausdrücke, Verschlüsselung, Multi-Space-Isolierung und Selbstheilung.
Da sich die Datenverarbeitung zunehmend in Richtung Edge Intelligence verlagert, sind Geräte nicht mehr nur „Inhaltsanzeigen". Sie sind intelligente Knoten für lokale Erzeugung, Umweltbewusstsein, Echtzeitentscheidungen und koordinierten Datenfluss. ToStore bietet dem Edge verteilte Funktionen für riesige Datensätze und komplexe lokale KI-Generierung. Die tiefe intelligente Zusammenarbeit zwischen Edge- und Cloud-Knoten schafft eine zuverlässige Datengrundlage für multimodale Interaktion, Langzeitgedächtnis, RAG und lokale Wissensbasen, Hybridabruf, räumliche Modellierung, autonome Edge-Zusammenarbeit und ähnliche Szenarien.
Hauptmerkmale
🤖 Runtime-Evolution und intelligentes O&M
- Deklarative Schemaänderungen — automatisches Refactoring, ohne manuelle Versionsverwaltung
- Schlüsselrotation, Schemamigration, umfangreiches Refactoring — alles online, geschäftstransparent
- Integrierte Statusspezifikation für automatisiertes O&M und Agent-Erkennung
- Unterstützt autonome Evolution und kontinuierliche Iteration ohne Dienstunterbrechung
🧠 Self-Routing-Verteilte Architektur
- Self-Routing-Knotenarchitektur, die physische Adressierung vom Datenumfang entkoppelt
- Hochautonome Knoten arbeiten zusammen für eine flexible Datentopologie
- Elastische horizontale Skalierung; Einzelknoten: Tabellen Billionen-, Vektoren 10B+-Maßstab
🌐 Einheitliche plattformübergreifende Daten-Engine
- Einheitliche API für Mobil-, Desktop-, Web- und Serverumgebungen
- Abdeckung relationaler Daten, dichter / neuronaler Sparse-Vektoren und Textabruf
- Vollständige Datenpipeline vom lokalen Speicher bis zur Edge-Cloud-Zusammenarbeit
🔍 Strukturierte Abfragen und Hybridabruf
- Komplexe Prädikate, JOINs, Aggregationen, TTL auf Tabellenebene und Kapazitätsbereinigung (FIFO / LRU)
- Lexikalischer Text, dichte Vektoren und neuronaler Sparse-Abruf in derselben Abfragekette
- Mehrwegiges Recall-Fusion-Ranking; Scores und Kanaldiagnosen im Ergebnis
⚡ Parallele Ausführung und Ressourcenplanung
- Kaltstart konstant ~35 ms, unabhängig vom Datenumfang
- Ressourcenbewusste Lastplanung; parallele Mehrknoten-Aufgabenzerlegung
- Time-Slicing hält UI-Animationen auch unter hoher Last flüssig
🔐 Offline-First & Privatsphäre
- Daten gerätegebunden und offline nutzbar halten — weniger Cloud-Abhängigkeit und geringere Expositionsfläche
- Multi-Space-Isolierung mit optionaler globaler Freigabe — bereit für Multi-User / Multi-Tenant
- Integrierte ChaCha20-Poly1305- und AES-256-GCM-Verschlüsselung
- Validiert durch mehrere komplexe Disaster-Recovery-Szenarien
Installation
[!IMPORTANT] Upgrade von v2.x? Bitte lesen Sie den v3.x-Upgrade-Leitfaden für wichtige Migrationsschritte und wichtige Änderungen.
Fügen Sie tostore zu Ihrem pubspec.yaml hinzu:
dependencies:
  tostore: any # Please use the latest version
For AI Coding Assistants
Wenn Sie ToStore-Clientcode mit einem KI-Assistenten erzeugen, geben Sie ihm das Einzeldatei-Korpus llms-full.txt — z. B. @llms-full.txt in der IDE, Datei hochladen/einfügen oder die raw URL in die Assistenten-Dokumentation aufnehmen. Die Datei enthält API-Signaturen, Einschränkungen und Anti-Patterns, damit das Modell zur echten öffentlichen Oberfläche passt. Index: llms.txt.
Schnellstart
[!TIP] Wie sollten Sie einen Speichermodus auswählen?
- Schlüsselwertmodus (KV): Am besten für Konfigurationszugriff, verteilte Statusverwaltung oder JSON-Datenspeicherung geeignet. Dies ist der schnellste Weg, um loszulegen.
- Strukturierter Tabellenmodus: Am besten für Kerngeschäftsdaten geeignet, die komplexe Abfragen, Einschränkungsvalidierung oder umfangreiche Datenverwaltung erfordern. Indem Sie die Integritätslogik in die Engine integrieren, können Sie die Entwicklungs- und Wartungskosten auf der Anwendungsebene erheblich senken.
- Speichermodus: Am besten für temporäre Berechnungen, Unit-Tests, begrenzte In-Memory-Caches (TTL und FIFO / LRU Kapazitätsbereinigung) oder ultraschnelle globale Zustandsverwaltung. Mit globalen Abfragen und
watch-Listenern können Sie die Anwendungsinteraktion umgestalten, ohne einen Stapel globaler Variablen verwalten zu müssen.
Schlüsselwertspeicher (KV)
Dieser Modus eignet sich, wenn Sie keine vordefinierten strukturierten Tabellen benötigen. Es ist einfach, praktisch und wird von einer leistungsstarken Speicher-Engine unterstützt. Seine effiziente Indexierungsarchitektur sorgt dafür, dass die Abfrageleistung selbst auf normalen Mobilgeräten bei sehr großen Datenmengen äußerst stabil und extrem reaktionsfähig bleibt. Daten in verschiedenen Spaces werden natürlich isoliert, während auch die globale Freigabe unterstützt wird.
// Initialize the database
final db = await ToStore.open();

// Set key-value pairs (supports String, int, bool, double, Map, List, Json, and more)
await db.setValue('user_profile', {
  'name': 'John',
  'age': 25,
});

// Switch space - isolate data for different users
await db.switchSpace(spaceName: 'user_123');

// Set a globally shared variable (isGlobal: true enables cross-space sharing, such as login state)
await db.setValue('current_user', 'John', isGlobal: true);

// Automatic expiration cleanup (TTL)
// Supports either a relative lifetime (ttl) or an absolute expiration time (expiresAt)
await db.setValue('temp_config', 'value', ttl: Duration(hours: 2));
await db.setValue('session_token', 'abc', expiresAt: DateTime(2026, 2, 31));

// Read data
final profile = await db.getValue('user_profile'); // Map<String, dynamic>

// Listen for real-time value changes (useful for refreshing local UI without extra state frameworks)
db.watchValue('current_user', isGlobal: true).listen((value) {
  print('Logged-in user changed to: $value');
});

// Listen to multiple keys at once
db.watchValues(['current_user', 'login_status']).listen((map) {
  print('Multiple config values were updated: $map');
});

// Remove data
await db.removeValue('current_user');
[!TIP] Benötigen Sie weitere Key-Value-Funktionen? Für fortgeschrittene Operationen wie typsicheres Lesen (
getInt,getBool), atomares Inkrementieren, Präfixsuche, verkettete paginierte Datensatzabfragen (db.kv.query()) und Key-Space-Exploration lesen Sie bitte Fortgeschrittene Key-Value-Operationen (db.kv).
Beispiel für die automatische Aktualisierung der Flutter-Benutzeroberfläche
In Flutter erhalten Sie mit StreamBuilder plus watchValue einen sehr prägnanten reaktiven Aktualisierungsfluss:
StreamBuilder(
  // When listening to a global variable, remember to set isGlobal: true
  stream: db.watchValue('current_user', isGlobal: true),
  builder: (context, snapshot) {
    // snapshot.data is the latest value of 'current_user' in KV storage
    final user = snapshot.data ?? 'Not logged in';
    return Text('Current user: $user');
  },
)
Strukturierter Tabellenmodus
CRUD für strukturierte Tabellen erfordert, dass das Schema im Voraus erstellt wird (siehe Schemadefinition). Empfohlene Integrationsansätze für verschiedene Szenarien:
- Mobil/Desktop: Für häufige Startszenarien wird empfohlen,
schemaswährend der Initialisierung zu übergeben. - Server/Agent: Für Szenarien mit langer Laufzeit wird empfohlen, Tabellen dynamisch über
createTableszu erstellen.
// 1. Initialize the database
final db = await ToStore.open();

// 2. Insert data (prepare some base records)
final result = await db.insert('users', {
  'username': 'John',
  'email': '[email protected]',
  'age': 25,
});

// Unified operation result model: DbResult
// It is recommended to check hasErrors
if (!result.hasErrors) {
  print('Insert succeeded, generated primary key ID: ${result.firstPrimaryKey}');
} else {
  print('Insert failed: ${result.message}');
}

// Chained query (see [Query Operators](#query-operators); supports =, !=, >, <, LIKE, IN, and more)
final users = await db.query('users')
    .where('age', '>', 20)
    .where('username', 'like', '%John%')
    .orderByDesc('age')
    .limit(20);

// Update and delete
await db.update('users', {'age': 26}).where('username', '=', 'John');
await db.delete('users').where('username', '=', 'John');

// Real-time listening (see [Reactive Query](#reactive-query) for more details)
db.query('users').where('age', '>', 18).watch().listen((users) {
  print('Users matching the condition have changed: $users');
});

// Pair with Flutter StreamBuilder for automatic local UI refresh
StreamBuilder(
  stream: db.query('users').where('age', '>', 18).watch(),
  builder: (context, snapshot) {
    final users = snapshot.data ?? [];
    return ListView.builder(
      itemCount: users.length,
      itemBuilder: (context, index) => Text(users[index]['username']),
    );
  },
);
Speichermodus
Für Szenarien wie Caching, temporäre Berechnungen oder Arbeitslasten, die keine Persistenz auf der Festplatte benötigen, können Sie eine reine In-Memory-Datenbank über ToStore.memory() initialisieren. In diesem Modus verbleiben alle Daten, einschließlich Schemata, Indizes und Schlüssel-Wert-Paare, vollständig im Speicher, um eine maximale Lese-/Schreibleistung zu gewährleisten.
Der Speichermodus unterstützt mehrere Eviction-Strategien: zeitbasiertes TTL auf Tabellenebene / KV-TTL sowie mengen-/größenbasierte Kapazitätsbereinigung (FIFO / LRU)—einzeln oder kombiniert, damit Hot-Daten planmäßig ablaufen oder begrenzt bleiben. Ideal für Sitzungscaches, Abfrageergebnis-Pools und speicherempfindliche Pfade.
💡 Funktioniert auch als Global State Management
Sie benötigen keinen Haufen globaler Variablen oder ein schwergewichtiges Zustandsverwaltungs-Framework. Durch die Kombination des Speichermodus mit watchValue oder watch() können Sie eine vollautomatische Aktualisierung der Benutzeroberfläche über Widgets und Seiten hinweg erreichen. Es behält die leistungsstarken Abruffähigkeiten einer Datenbank bei und bietet Ihnen gleichzeitig ein reaktives Erlebnis, das weit über gewöhnliche Variablen hinausgeht, was es ideal für den Anmeldestatus, die Live-Konfiguration oder globale Nachrichtenzähler macht.
[!CAUTION] Hinweis: Im reinen Speichermodus erstellte Daten gehen vollständig verloren, nachdem die App geschlossen oder neu gestartet wird. Verwenden Sie es nicht für Kerngeschäftsdaten.
// Reine In-Memory-DB — TTL und/oder FIFO/LRU-Kapazität nach Bedarf
final memDb = await ToStore.memory(
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
  ),
);

// Set a global state value (for example: unread message count)
await memDb.setValue('unread_count', 5, isGlobal: true);

// Listen from anywhere in the UI without passing parameters around
memDb.watchValue<int>('unread_count', isGlobal: true).listen((count) {
  print('UI automatically sensed the message count change: $count');
});

// All CRUD, KV access, and vector search run at in-memory speed
await memDb.insert('active_users', {'name': 'Marley', 'status': 'online'});
Schemadefinition
Definieren Sie es einmal und überlassen Sie die Engine die automatisierte End-to-End-Governance, sodass für Ihre Anwendung keine aufwändige Validierungswartung mehr erforderlich ist.
Die folgenden mobilen, serverseitigen und Agent-Beispiele verwenden alle das hier definierte appSchemas wieder.
TableSchema-Übersicht
const userSchema = TableSchema(
  name: 'users', // Table name, required
  tableId: 'users', // Unique identifier of the table, optional
  primaryKeyConfig: PrimaryKeyConfig(
    name: 'id', // Primary key field name, defaults to id
    type: PrimaryKeyType.sequential, // Primary key auto-generation strategy
    sequentialConfig: SequentialIdConfig(
      initialValue: 1000, // Initial value for sequential IDs
      increment: 1, // Step size
      useRandomIncrement: false, // Whether to use random step sizes
    ),
  ),
  fields: [
    FieldSchema(
      name: 'username', // Field name, required
      type: DataType.text, // Field data type, required
      nullable: false, // Whether null is allowed
      minLength: 3, // Minimum length
      maxLength: 32, // Maximum length
      unique: true, // Whether it must be unique
      fieldId: 'username', // Stable field identifier, optional, used to detect field renames
      comment: 'Login name', // Optional comment
    ),
    FieldSchema(
      name: 'status',
      type: DataType.integer,
      minValue: 0, // Minimum numeric value
      maxValue: 150, // Maximum numeric value
      defaultValue: 0, // Static default value
      createIndex: true, // Shortcut for creating an index
    ),
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      defaultValueType: DefaultValueType.currentTimestamp, // Automatically fill with current time
      createIndex: true,
    ),
  ],
  indexes: const [
    IndexSchema(
      indexName: 'idx_users_status_created_at', // Optional index name
      fields: ['status', 'created_at'], // Composite index fields
      unique: false, // Whether it is a unique index
      type: IndexType.btree, // Index type: btree/vector
    ),
  ],
  foreignKeys: const [], // Optional foreign-key constraints; see "Foreign Keys & Cascading"
  isGlobal: false, // Whether this is a global table; true means it can be shared across spaces
  ttlConfig: null, // Optional table-level TTL; see "Table-level TTL"
  capacityConfig: null, // Optional capacity eviction; see "Capacity Eviction"
);

const appSchemas = [userSchema];
Gemeinsame
DataType-Zuordnungen:Geben Sie ein Entsprechender Darttyp Beschreibung integerintStandard-Ganzzahl, geeignet für IDs, Zähler und ähnliche Daten bigIntBigInt/StringGroße ganze Zahlen; empfohlen, wenn Zahlen mehr als 18 Ziffern umfassen, um Genauigkeitsverluste zu vermeiden doubledoubleGleitkommazahl, geeignet für Preise, Koordinaten und ähnliche Daten textStringTextzeichenfolge mit optionalen Längenbeschränkungen blobUint8ListRohe Binärdaten booleanboolBoolescher Wert datetimeDateTime/StringDatum/Uhrzeit; intern als ISO8601 arrayListListen- oder Array-Typ jsonMap<String, dynamic>JSON-Objekt, geeignet für dynamisch strukturierte Daten vectorVectorData/List<num>Dichte Vektoren für semantischen Nearest-Neighbor-Abruf (Embeddings) sparseSparseVectorDataNeuronale Sparse-Vektoren für Sparse-Abruf PrimaryKeyTypeStrategien zur automatischen Generierung:Strategie Beschreibung Eigenschaften noneKeine automatische Generierung Sie müssen den Primärschlüssel beim Einfügen manuell angeben sequentialSequentielles Inkrement Gut für benutzerfreundliche IDs, aber weniger geeignet für verteilte Leistung timestampBasedZeitstempelbasiert Empfohlen für verteilte Umgebungen datePrefixedDatum mit Präfix Nützlich, wenn die Lesbarkeit des Datums für das Unternehmen wichtig ist shortCodeKurzcode-Primärschlüssel Kompakt und für externe Anzeige geeignet
Alle Primärschlüssel werden standardmäßig als
text(String) gespeichert.
Einschränkungen und automatische Validierung
Sie können allgemeine Validierungsregeln direkt in FieldSchema schreiben und so doppelte Logik im Anwendungscode vermeiden:
nullable: false: Nicht-Null-EinschränkungminLength/maxLength: Einschränkungen der TextlängeminValue/maxValue: Ganzzahl- oder Gleitkomma-BereichseinschränkungendefaultValue/defaultValueType: statische Standardwerte und dynamische Standardwerteunique: eindeutige EinschränkungcreateIndex: Erstellen Sie Indizes für Hochfrequenzfilterung, Sortierung oder BeziehungenfieldId/tableId: Unterstützt die Umbenennungserkennung für Felder und Tabellen während der Migration
Darüber hinaus erstellt unique: true automatisch einen eindeutigen Einzelfeldindex. createIndex: true und Fremdschlüssel erstellen automatisch normale Einzelfeldindizes. Verwenden Sie indexes, wenn Sie zusammengesetzte Indizes, benannte Indizes oder Text- / Sparse- / Vektor-Abrufindizes benötigen.
Schemaentwicklung (Schema Evolution)
Die Engine erkennt strukturelle Änderungen automatisch (Hinzufügen, Entfernen oder Umbenennen von Tabellen/Feldern, Attributanpassungen, Indexänderungen usw.) und führt die Datenmigration durch — ohne manuelle Versionsverwaltung oder Migrationsskripte. Deklarative schemas entwickeln sich bei ToStore.open(); zur Laufzeit auch per updateSchema — geschäftslogiktransparent, Lesen und Schreiben bleiben unterbrechungsfrei.
Eindeutiges Feld zum Primärschlüssel erheben
Ein bestehendes eindeutiges, nicht-null-Feld kann zum Primärschlüssel erhoben werden (Umbenennung optional; mit vorhandenen Daten; geschäftslogiktransparent). Nicht zusammen mit setPrimaryKeyConfig ändern.
- Mobil (deklarative
schemas): Automatische Erkennung beiToStore.open(). Der Ziel-Primärschlüssel mussPrimaryKeyType.nonesein (Werte stammen aus dem Quellfeld; andere Auto-Generierungstypen werden nicht unterstützt). Bei gleichem Namen reicht der Name; zum UmbenennenfromFieldIdauf diefieldIddes Quellfelds setzen. - Server (Laufzeit):
updateSchema(...).promoteFieldToPrimaryKey(sourceFieldName: ..., targetPrimaryKeyName: ...)aufrufen.targetPrimaryKeyNameist optional; ohne Angabe bleibt der Quellfeldname erhalten.
Auswahl einer Integrationsmethode
- Mobil/Desktop: Am besten, wenn
appSchemasdirekt anToStore.open(...)übergeben wird - Server/Agent: Am besten geeignet, wenn Schemata zur Laufzeit dynamisch über
createTables(appSchemas)erstellt werden.
Integration für Mobilgeräte, Desktops und andere häufige Startszenarien
📱 Beispiel: mobile_quickstart.dart
import 'package:path/path.dart' as p;
import 'package:path_provider/path_provider.dart';

// On Android/iOS, resolve the app's writable directory first, then pass dbPath explicitly
final docDir = await getApplicationDocumentsDirectory();
final dbRoot = p.join(docDir.path, 'common');

// Reuse the appSchemas defined above
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
);

// Multi-space architecture - isolate data for different users
await db.switchSpace(spaceName: 'user_123');
Startfortschritt verfolgen
Normale Schema-Änderungen sind für die Geschäftslogik transparent und blockieren den Start nicht. Nur in seltenen Ausnahmefällen bei mobilen Apps, die häufig zwangsweise geschlossen werden (z. B. kurze Datenvalidierung und Crash-Wiederherstellung nach einem abnormalen Beenden) kann die Initialisierung spürbar dauern — verwenden Sie onStartupProgress, um einen Splash-Screen oder Fortschrittsbalken anzuzeigen:
final db = await ToStore.open(
  dbPath: dbRoot,
  schemas: appSchemas,
  onStartupProgress: (progress, stage) {
    // progress: 0.0 – 1.0  |  stage: opening → recovering → optimizing → ready
    print('Startfortschritt ${(progress * 100).toStringAsFixed(0)}% [$stage]');
    // Splash-Screen / Fortschrittsbalken aktualisieren
  },
);
// Datenbank ist vollständig bereit
Phasen:
opening— Konfiguration laden, Basis-Engine vorbereitenrecovering— Sicherheitsprüfungen und Absturzwiederherstellungoptimizing— Interne Motorabstimmung und Strukturpflege-Optimierungready— Initialisierung abgeschlossen, einsatzbereit
Anmeldestatus und Abmeldung beibehalten (aktiver Bereich)
Multi-Space ist ideal zum Isolieren von Benutzerdaten: ein Space pro Benutzer, eingeschaltet bei der Anmeldung. Mit Active Space und Schließoptionen können Sie den aktuellen Benutzer über App-Neustarts hinweg behalten und ein sauberes Abmeldeverhalten unterstützen.
- Anmeldestatus beibehalten: Nachdem Sie einen Benutzer in seinen eigenen Bereich versetzt haben, markieren Sie diesen Bereich als aktiv. Beim nächsten Start kann dieser Bereich direkt beim Öffnen der Standardinstanz aufgerufen werden, ohne den Schritt „Zuerst Standard, dann wechseln“.
- Abmelden: Wenn sich der Benutzer abmeldet, schließen Sie die Datenbank mit
keepActiveSpace: false. Beim nächsten Start wird nicht automatisch der Bereich des vorherigen Benutzers betreten.
// After login: switch to the user's space and mark it active
await db.switchSpace(spaceName: 'user_$userId', keepActive: true);

// Optional: strictly stay in default when needed (for example, login screen only)
// final db = await ToStore.open(..., applyActiveSpaceOnDefault: false);

// On logout: close and clear the active space so the next launch starts from default
await db.close(keepActiveSpace: false);
Serverseitige / Agenten-Integration (Langzeitszenarien)
🖥️ Beispiel: server_quickstart.dart
final db = await ToStore.open();

// Create table structures while the process is running
await db.createTables(appSchemas);

// Online schema updates
final result = await db.updateSchema('users')
  .renameTable('users_new')                // Rename table
  .modifyField(
    'username',
    minLength: 5,
    maxLength: 20,
    unique: true
  )                                        // Modify field attributes
  .renameField('old_name', 'new_name')     // Rename field
  .removeField('deprecated_field')         // Remove field
  .addField('created_at', type: DataType.datetime)  // Add field
  .removeIndex(fields: ['age'])            // Remove index
  .setPrimaryKeyConfig(                    // Change auto-generated PK strategy; avoid when the table already has data
    const PrimaryKeyConfig(type: PrimaryKeyType.shortCode)
  );
// Promote a unique field to PK (see promote-primary-key section; do not chain with the above):
// await db.updateSchema('users').promoteFieldToPrimaryKey(
//   sourceFieldName: 'user_id',
//   targetPrimaryKeyName: 'uid', // optional; omit to keep the source field name
// );

// Monitor migration progress
final taskId = result.taskId;
if (taskId != null) {
  // Inspect migration metadata
  print('Estimated duration: ${result.estimateDuration?.inMilliseconds} ms');
  print('Migration write mode: ${result.writeMode}'); // e.g. MigrationWriteMode.indexOnly

  final status = await db.queryMigrationTaskStatus(taskId);
  print('Migration progress: ${status?.progressPercentage}%');
}


// Optional performance tuning for pure server workloads
// yieldDurationMs controls how often long-running work yields time slices.
// The default is tuned to 8ms to keep frontend UI animations smooth.
// In environments without UI, 50ms is recommended for higher throughput.
final dbServer = await ToStore.open(
  config: DataStoreConfig(yieldDurationMs: 50),
);
Erweiterte Nutzung
ToStore bietet eine Vielzahl erweiterter Funktionen für komplexe Geschäftsszenarien:
Fortgeschrittene Key-Value-Operationen (db.kv)
Für komplexere Key-Value-Szenarien wird empfohlen, den Namespace db.kv zu verwenden. Er bietet einen vollständigen Satz von APIs mit Speicherplatzisolierung, globaler Freigabe, mehreren Datentypen sowie verketteten komplexen Abfragen und Filtern (z. B. db.kv.query().prefix(...).orderBy...().limit(...) für Paginierung, Sortierung, Ablauf-Filter usw.).
Grundlegender Zugriff (Basic Access)
// Wert setzen (unterstützt String, int, bool, double, Map, List usw.)
await db.kv.set('key', 'value', ttl: Duration(hours: 1));

// Rohwert für dynamischen Typ abrufen
dynamic val = await db.kv.get('key');

// Einzelnen Schlüssel entfernen
await db.kv.remove('key');
Typsichere Getter (Type-Safe Getters) Rufen Sie Daten direkt im Zielformat ab, ohne manuelle Konvertierung:
String? name = await db.kv.getString('user_name');
int? age = await db.kv.getInt('user_age');
bool? isVip = await db.kv.getBool('is_vip');
Map<String, dynamic>? profile = await db.kv.getMap('profile');
List<String>? tags = await db.kv.getList<String>('tags');
Stapeloperationen (Bulk Operations) Verarbeiten Sie effizient mehrere Key-Value-Paare in einer einzigen Operation:
// Stapelweises Setzen
await db.kv.setMany({
  'theme': 'dark',
  'language': 'de_DE',
});

// Stapelweises Entfernen
await db.kv.removeKeys(['temp_1', 'temp_2']);
Atomare Zähler (Atomic Increment) Erhöhen oder verringern Sie numerische Werte sicher in Szenarien mit hoher Parallelität:
// Um 1 erhöhen (Standard)
await db.kv.setIncrement('view_count');
// Um 5 verringern (einen negativen Wert übergeben)
await db.kv.setIncrement('stock_count', amount: -5);
Verkettete Datensatzabfragen (db.kv.query) Verkettete API ähnlich zu
db.query()zum Abfragen von Key-Value-Datensätzen (inkl. dekodiertemvalue) mit Paginierung. Im Gegensatz zugetKeys(nur Schlüsselnamen) liefert dies vollständige Datensätze.// Erste Seite: nach Präfix filtern, nach Update-Zeit absteigend, 20 pro Seite final page = await db.kv.query() .prefix('setting_') .orderByUpdatedAtDesc() // oder orderByKeyAsc / orderByKeyDesc / orderByUpdatedAtAsc .limit(20); for (final record in page.data) { // record enthält: key, value, updated_at, expires_at print('${record['key']} = ${record['value']}'); } // Empfohlen: mit next() / prev() blättern (wie bei Tabellenabfragen, am einfachsten) if (page.hasMore) { final page2 = await page.next(); print('Nächste Seite: ${page2.data.length}'); if (page2.hasPrev) { final back = await page2.prev(); print('Vorherige Seite: ${back.data.length}'); } } // Offset-Paginierung (schließt sich mit cursor aus; für tiefes Blättern besser next() oben) final byOffset = await db.kv.query() .orderByKeyAsc() .limit(20) .offset(20); // Gesamtzahl der Treffer (ohne prefix: O(1)-Metadatenstatistik) final total = await db.kv.query().prefix('setting_').count(); // Ersten Treffer holen final first = await db.kv.query().prefix('setting_').orderByKeyAsc().first(); // Globaler KV-Bereich final globalPage = await db.kv.query(isGlobal: true).limit(50); // Standardmäßig werden abgelaufene Datensätze ausgefiltert; für noch nicht bereinigte: final withExpired = await db.kv.query() .includeExpired() .limit(20);Häufige Kettenmethoden:
Methode Beschreibung prefix(String)Nach Key-Präfix filtern orderByKeyAsc/orderByKeyDescNach Key (Primärschlüssel) sortieren orderByUpdatedAtAsc/orderByUpdatedAtDescNach updated_atsortierenlimit(n)Max. Einträge pro Seite (explizit angeben empfohlen) offset(n)Offset-Paginierung (löscht cursor) cursor(token)Nur Sonderfälle: Paginierungs-Token über Prozesse/Netzwerke includeExpired([true])Abgelaufene, noch nicht bereinigte Datensätze einschließen count()Treffer zählen first()Ersten Datensatz zurückgeben (ändert limit des Builders nicht) Abfrageergebnis
QueryResult: Alltagspaginierung mithasMore/hasPrev+next()/prev();nextCursorToken/prevCursorTokennur für client-/server- oder netzwerkübergreifende Übertragung u. Ä. (wie bei Tabellenabfragen).Erkundung & Verwaltung (Discovery & Management)
// Nur Schlüsselnamen auflisten (ohne value); optional prefix / limit / offset
final keys = await db.kv.getKeys(prefix: 'setting_');
final pageKeys = await db.kv.getKeys(
  prefix: 'setting_',
  limit: 100,
  offset: 0,
);

// Gesamtzahl der Schlüssel im aktuellen Bereich zählen
final count = await db.kv.count();

// Prüfen, ob ein Schlüssel existiert und nicht abgelaufen ist
final exists = await db.kv.exists('config_cache');

// Speichersonde (synchron, nur bei Speichertreffer — siehe [Speicher-Sonde und synchrone Abfrage (peek)](#query-peek))
final theme = db.kv.peekGet('theme') ?? await db.kv.get('theme');
if (db.kv.peekExists('config_cache')) { /* ... */ }

// Alle KV-Daten im aktuellen Bereich löschen
await db.kv.clear();
Lebenszyklus-Management (TTL) Ablauf-Einstellungen für vorhandene Schlüssel prüfen oder aktualisieren:
// Verbleibende Dauer abrufen
Duration? ttl = await db.kv.getTtl('token');

// TTL für einen vorhandenen Schlüssel aktualisieren (läuft in 7 Tagen ab)
await db.kv.setTtl('token', Duration(days: 7));
Reaktive Überwachung (Reactive Watch)
// Einzelnen Schlüssel überwachen
db.kv.watch<int>('unread_count').listen((count) => print(count));

// Snapshot mehrerer Schlüssel überwachen
db.kv.watchValues(['theme', 'font_size']).listen((map) => print(map));
Globale Freigabe (isGlobal) Alle oben genannten Methoden unterstützen den optionalen Parameter
isGlobal:truefür den globalen Bereich (über alle Bereiche hinweg geteilt),false(Standard) für den aktuellen isolierten Bereich.
Stapeloperationen (Bulk Operations)
ToStore bietet spezialisierte Schnittstellen für die Stapelverarbeitung, die für einen hohen Datendurchsatz optimiert sind. Diese Schnittstellen nutzen parallele Aufgabenverteilung und Time-Slicing, um die Reaktionsfähigkeit der Benutzeroberfläche bei intensiven Schreibvorgängen zu gewährleisten.
| Methode | Hauptzweck | Datenanforderungen | Merkmale |
|---|---|---|---|
batchInsert |
Datensätze stapelweise einfügen | Muss alle nicht-nullbaren Felder enthalten | Reines Einfügen, höchste Leistung |
batchUpsert |
Intelligente Synchronisation (Upsert) | Muss alle nicht-nullbaren Felder enthalten | Vollständige Synchronisation, Identifizierung über Primärschlüssel oder eindeutiges Feld |
batchUpdate |
Datensätze stapelweise aktualisieren | Primärschlüssel oder eindeutiges Feld + Aktualisierungsfelder | Partielle Aktualisierungen für vorhandene Datensätze |
Stapelweises Einfügen (batchInsert)
await db.batchInsert('users', [
  {'username': 'user1', 'email': '[email protected]'},
  {'username': 'user2', 'email': '[email protected]'},
]);
Intelligente Stapel-Synchronisation (batchUpsert) Identifiziert automatisch "Einfügen" oder "Aktualisieren" basierend auf dem Primärschlüssel oder eindeutigen Feldern. Häufig für die vollständige Datensynchronisation verwendet.
[!IMPORTANT] Datenanforderungen: Da ein Einfügevorgang ausgelöst werden kann, erfordert
batchUpsert, dass jeder Datensatz alle nicht-nullbaren (nullable: false) Felder enthält.Hochleistungs-Stapelaktualisierung (batchUpdate) Speziell für die Aktualisierung vorhandener Datensätze. Jeder Datensatz muss einen Primärschlüssel oder ein eindeutiges Feld als Bezeichner enthalten, zusammen mit den zu ändernden Feldern.
[!TIP] Partielle Aktualisierungen:
batchUpdateändert nur die bereitgestellten Felder und erfordert nicht alle nicht-nullbaren Felder, was es ideal für inkrementelle Aktualisierungen macht.await db.batchUpdate('users', [ {'username': 'john', 'age': 27}, // Über eindeutiges Feld 'username' identifizieren und 'age' aktualisieren {'id': '1002', 'status': 'active'}, // Kann auch den Primärschlüssel direkt verwenden ]);
[!TIP] Sie können
allowPartialErrors: truefestlegen, um sicherzustellen, dass Fehler bei einzelnen Datensätzen (z. B. eine Verletzung einer eindeutigen Einschränkung) nicht die gesamte Stapeloperation ablehnen.
Garantie für Schreibwiederherstellung (Recovery Durability)
ToStore ermöglicht die flexible Steuerung der Selbstheilungswiederherstellungsstufe zum Zeitpunkt der Rückgabe des Ergebnisses von Schreiboperationen (await-Abschluss):
| Stufe | Wiederherstellungsgarantie bei Antwort | Anwendungsfälle & Eigenschaften |
|---|---|---|
RecoveryDurability.standard(Standardempfehlung) |
Vor der Antwort absturzsicher | Schutz vor App-Abstürzen, nicht abgefangenen Ausnahmen und OOM-Prozessbeendigungen durch das Betriebssystem. Hoher Durchsatz bei alltäglicher Geschäftssicherheit. |
RecoveryDurability.durable |
Vor der Antwort stromausfallsicher | Vor der Rückgabe auf den physischen Speicher erzwungen. Vollständige Selbstheilung auch bei plötzlichen Stromausfällen oder Kernel-Panics. Ideal für Finanztransaktionen und kritische Audits. |
RecoveryDurability.async |
Maximaler Durchsatz (asynchrones Speichern) | Wird in den Speicher eingereiht und gibt sofort die Antwort zurück; nach der Rückgabe besteht bei kleinen Datenmengen meist nur ein extrem kurzes Datenverlustfenster von wenigen Millisekunden. Ideal für Massenprotokolle und Metriken. |
1. Globale Standardkonfiguration
Konfigurieren Sie die Standardwiederherstellungsstufe der Instanz in DataStoreConfig:
final db = await ToStore.open(
  config: DataStoreConfig(
    defaultRecoveryDurability: RecoveryDurability.standard, // Standard: Vor der Antwort absturzsicher
  ),
);
2. Überschreibung pro Operation
Alle strukturierten Tabellenoperationen, Stapeloperationen, verketteten Updates/Deletes sowie der Key-Value-Speicher (KV) unterstützen die individuelle Überschreibung über den optionalen Parameter durability:
// 1. Strukturierte Tabellenoperationen
await db.insert('orders', orderData, durability: RecoveryDurability.durable); // Wichtige Bestellung: Stromausfallsicher
await db.batchInsert('logs', logList, durability: RecoveryDurability.async); // Massenprotokolle: Schnelle asynchrone Speicherung

// 2. Verkettete Updates und Löschvorgänge
await db.update('users', {'status': 'active'})
  .where('id', '=', userId)
  .durability(RecoveryDurability.durable);

// 3. Key-Value-Speicher (KV)
await db.setValue('token', tokenVal, durability: RecoveryDurability.standard);
await db.kv.set('session_id', 'xyz', durability: RecoveryDurability.async);
await db.kv.setMany(settingsMap, durability: RecoveryDurability.durable);
Vektor-, Text- und Hybridabruf
Lexikalischer Textabruf, dichter Vektorabruf und neuronaler Sparse-Abruf teilen sich eine Abfragekette (matchText / matchVector / matchSparse): kombinieren Sie sie mit strukturierten Prädikaten in derselben Kette oder fusionieren Sie mehrere Recall-Zweige. Scores und Kanaldiagnosen werden in QueryResult.retrieval zurückgegeben und sind 1:1 auf data-Zeilen ausgerichtet. Wenn nur Primärschlüssel und Scores nötig sind, bevorzugen Sie .select(['id']) (oder Ihren PK-Feldnamen), damit die Engine keine vollständigen Tabellenzeilen materialisiert — sonst lädt der Hybridabruf komplette Datensätze (inkl. großer Embeddings) und der Durchsatz kann stark sinken. Für dediziertes ANN ohne Filter oder Fusion liefert db.vectorSearch(...) mit demselben Kernsuchpfad List<VectorSearchResult> (Primärschlüssel + Score).
Suchsichtbarkeit: Nach erfolgreichem Insert/Update sind normale Indizes, Textindizes und Sparse-Indizes sofort suchbar; Vektorindizes werden nicht an den Schreibpfad gekoppelt (um den Durchsatz nicht zu belasten) und sind nicht sofort suchbar. Wenn Sie sie für die Suche brauchen, rufen Sie nach Ihrem Geschäftsbatch await db.flush() auf (optionale Bequemlichkeit); erst danach nehmen sie an matchVector / vectorSearch teil.
await db.createTables([
  const TableSchema(
    name: 'documents',
    primaryKeyConfig: PrimaryKeyConfig(
      name: 'id',
      type: PrimaryKeyType.timestampBased,
    ),
    fields: [
      FieldSchema(name: 'content', type: DataType.text, nullable: false),
      FieldSchema(
        name: 'category',
        type: DataType.text,
        nullable: false,
        createIndex: true,
      ),
      FieldSchema(
        name: 'features',
        type: DataType.sparse, // Neural sparse vector
        nullable: false,
      ),
      FieldSchema(
        name: 'embedding',
        type: DataType.vector, // Dense vector
        nullable: false,
        vectorConfig: VectorFieldConfig(
          dimensions: 128, // Written and queried vectors must match this width
        ),
      ),
    ],
    indexes: [
      IndexSchema(fields: ['content'], type: IndexType.text), // Lexical text index
      IndexSchema(fields: ['features'], type: IndexType.sparse), // Neural sparse index
      IndexSchema(
        fields: ['embedding'],
        type: IndexType.vector, // Dense vector index
        vectorConfig: VectorIndexConfig(
          indexType: VectorIndexType.ngh, // NGH: ToStore built-in dense index
          distanceMetric: VectorDistanceMetric.cosine,
        ),
      ),
    ],
  ),
]);

final queryVector =
    VectorData.fromList(List.generate(128, (i) => i * 0.01));
final querySparse = SparseVectorData.fromMap({12: 0.8, 45: 0.6, 90: 0.3});

// 1) Lexical text retrieval (engine tokenizes TextQuery.text;
//    or use pre-tokenized TextQuery.terms / termsWeighted)
final textHits = await db
    .query('documents')
    .select(['id'])
    .matchText('content', TextQuery.text('distributed kernel storage'))
    .limit(5);

// 2) Neural sparse retrieval
final sparseHits = await db
    .query('documents')
    .select(['id'])
    .matchSparse('features', querySparse, minScore: 0.30)
    .limit(5);

// 3) Dense vector ANN (default searchDepth = 50)
final result = await db
    .query('documents')
    .select(['id'])
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

for (var i = 0; i < result.data.length; i++) {
  final record = result.data[i];
  final entry = result.retrieval?.entries[i];
  print('pk=${record['id']}, score=${entry?.score}, '
      'rawScore=${entry?.rawScore}, distance=${entry?.meta?['distance']}');
}

// 4) Structured filter + vector (AND)
final filtered = await db
    .query('documents')
    .whereEqual('category', 'tech')
    .matchVector('embedding', queryVector, minScore: 0.40)
    .limit(5);

// 5) Multi-way fusion: text + sparse + vector (default weightedScore)
final fused = await db
    .query('documents')
    .matchText('content', TextQuery.text('distributed storage'), weight: 0.4)
    .matchSparse('features', querySparse, weight: 0.3, minScore: 0.20)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .limit(10);
print('fusion=${fused.retrieval?.fusionMethod}'); // weightedScore

// Opt into rank-only fusion (relative scores — not absolute relevance bands)
final fusedRrf = await db
    .query('documents')
    .matchText('content', TextQuery.text('distributed storage'), weight: 0.4)
    .matchVector('embedding', queryVector, weight: 0.6, minScore: 0.40)
    .fusionMethod(RetrievalFusionMethod.rrf)
    .limit(10);
print('fusion=${fusedRrf.retrieval?.fusionMethod}'); // rrf

// Dedicated ANN (PK + score only; no query chain / fusion)
final ann = await db.vectorSearch(
  'documents',
  fieldName: 'embedding',
  queryVector: queryVector,
  topK: 5,
  minScore: 0.40,
);
Kanal- / Schema-Zuordnung:
| Kanal | Feldtyp | Index | Abfrage-API | Abfragewert |
|---|---|---|---|---|
| Lexikalischer Text | DataType.text |
IndexType.text |
matchText / orMatchText |
TextQuery.text / terms / termsWeighted |
| Neuronal sparse | DataType.sparse |
IndexType.sparse |
matchSparse / orMatchSparse |
SparseVectorData |
| Dichter Vektor | DataType.vector |
IndexType.vector |
matchVector / orMatchVector |
VectorData usw. |
Konfiguration dichter Vektoren (VectorFieldConfig, VectorIndexConfig):
dimensions: muss der tatsächlichen Embedding-Breite entsprechen, die Sie schreibenindexType: undurchsichtige ID des dichten Algorithmus; derzeitnghdistanceMetric: indexseitige Ähnlichkeitsmetrik für Aufbau und Suche;cosineist üblich für semantische Embeddings,l2für euklidische Distanz,innerProductfür Skalarproduktsuche. Nach dem Schreiben von Daten erfordert eine Änderung in der Regel den Neuaufbau des Vektorindex.
Parameter des verketteten Abrufs (jedes match* / orMatch*, plus limit in der Kette):
- Text
TextQuery.text: wird von der Engine tokenisiertTextQuery.terms/termsWeighted: vorab tokenisiert; kein zweiter Durchlauf; lateinische Terme müssen zur Indexseite passen (meist Kleinbuchstaben)operator:or(Standard; Ranking über Vereinigung) oderand(jeder positiv gewichtete Term muss treffen, dann Ranking)- Phrasen-Matching wird nicht unterstützt
- Sparse
SparseVectorData/SparseVectorData.fromMap(...): Sparse-Abfragevektor- Dokumentseitige Gewichte sollten vorzugsweise in
(0, 1]liegen
- Vektor
field/vector: Zielfeld und AbfragevektorsearchDepth:>= 1, Standard50; größere Werte erhöhen meist Recall und Latenz; approximativer Nearest Neighbor — kein garantiertes Recall@KdistanceThreshold: Distanzobergrenze
- Gemeinsam
weight: Mehrweg-Fusionsgewicht; Standard1.0minScore: Relevanzuntergrenzelimit: Ergebnisanzahl (topK).fusionMethod(...): Mehrweg-StandardweightedScore; umschaltbar aufrrf
Hinweise zu Ergebnis und Scoring (QueryResult / VectorSearchResult):
- Geschäftsdatensätze liegen in
data; Abruf-Scores und Kanalinfos inretrieval.entries, 1:1 aufdataausgerichtet. Bevorzugen Sie.select(['id']), wenn nur Primärschlüssel und Scores nötig sind. score(normalisierter Relevanzscore,0.0 ~ 1.0): einheitliche Relevanz über Text, Sparse und Vektor (höher= relevanter). Exakter Vektor-Selbsttreffer erreicht1.0. MitminScorestarke Treffer behalten und schwache verwerfen. Standard-Mehrweg-weightedScore-Fusion behält einen starken Einzelkanal-Treffer; Text und Sparse bleiben in[0.0, 1.0).rawScore: nicht normalisierte physische Metrik — Kosinus / Skalarprodukt / L2 / Text-Impact. Nutzen SierawScore/distance, wenn Sie die zugrunde liegende Metrik brauchen.entry.meta['distance']: ANN-Distanz auf Vektorkanälen (niedriger= näher).retrieval.fusionMethod:nullbei Einzelkanal-Recall; Mehrweg-StandardweightedScore(umschaltbar via.fusionMethod(RetrievalFusionMethod.rrf)).- Top-Level
db.vectorSearch(...)liefertList<VectorSearchResult>(primaryKey/score/rawScore/distance) für dediziertes ANN. OptionalesminScorenutzt dieselbe Relevanzuntergrenze wiematchVector(kann weniger alstopKliefern).
Relevanzscore (score) & Schwellen-Referenzbasis (Einzelkanal und Mehrweg-weightedScore; nicht für rrf). Für typische Embeddings (Dimensionen ≥ 128); bei niedrigeren Dimensionen können schwache Nachbarn hoch scoren — erhöhen Sie ggf. minScore oder nutzen Sie rawScore:
Relevanzscore (score) |
Basisbedeutung & typische Szenarien |
|---|---|
>= 0.85 |
Gleiche Entität (Gesichtsverifikation, Biometrie, exakte Deduplizierung) |
>= 0.70 |
Semantischer Treffer mit hoher Konfidenz (Kernfakten, präzises Q&A) |
>= 0.40 |
Grundlegende semantische Relevanz (allgemeines RAG, Anti-Halluzination in Wissensbasen) |
>= 0.30 |
Breite Erstrecall (unscharfe Entdeckung, Pre-Rerank-Kandidatenpool) |
< 0.30 |
Schwache Assoziation oder Hintergrundrauschen |
Konfigurieren Sie kanalweise minScore, um Treffer mit geringer Relevanz zu verwerfen.
TTL auf Tabellenebene (automatischer zeitbasierter Ablauf)
Für Protokolle, Telemetrie, Ereignisse und andere Daten, die mit der Zeit ablaufen sollen, können Sie TTL auf Tabellenebene über ttlConfig definieren. Die Engine bereinigt abgelaufene Datensätze automatisch im Hintergrund:
const TableSchema(
  name: 'event_logs',
  fields: [
    FieldSchema(
      name: 'created_at',
      type: DataType.datetime,
      nullable: false,
      createIndex: true,
      defaultValueType: DefaultValueType.currentTimestamp,
    ),
  ],
  ttlConfig: TableTtlConfig(
    ttlMs: 7 * 24 * 60 * 60 * 1000, // 7 Tage aufbewahren
    // Erforderlich für neue Tabellen / erstmaliges Aktivieren von TTL:
    // 1) DataType.datetime  2) nullable: false
    // 3) DefaultValueType.currentTimestamp
    sourceField: 'created_at',
  ),
);
Kapazitätsbereinigung (FIFO / LRU)
Begrenzt die Anzahl der Datensätze einer Tabelle nach Anzahl und/oder ungefährer Größe. Unabhängig von TTL—beides darf kombiniert werden. Überschüssige Zeilen werden im Hintergrund automatisch entfernt.
// FIFO (Standard): älteste Einträge nach Primärschlüssel entfernen.
// sourceField nicht setzen (außer Primärschlüsseltyp ist PrimaryKeyType.none).
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  // maxBytes: 50 * 1024 * 1024, // optionale Größengrenze
  policy: CapacityEvictionPolicy.fifo,
),

// LRU: sourceField erforderlich (datetime, non-null, currentTimestamp).
// Feld aktualisieren, wenn der Datensatz wieder als „verwendet“ gilt.
capacityConfig: CapacityConfig(
  maxEntries: 10000,
  policy: CapacityEvictionPolicy.lru,
  sourceField: 'last_active_at',
),
- Mindestens eines von
maxEntries/maxBytessetzen. - FIFO +
PrimaryKeyType.noneerfordert ebenfallssourceField(gleiche Datetime-Regeln).
Kapazitätsbereinigung kann zur Laufzeit für bestehende Tabellen aktiviert, geändert oder deaktiviert werden (kein Neustart nötig):
// Aktivieren / anpassen
await db.updateSchema('recent_events').setCapacityConfig(
  CapacityConfig(
    maxEntries: 10000,
    policy: CapacityEvictionPolicy.lru,
    sourceField: 'last_active_at',
  ),
);

// Deaktivieren (bestehende Zeilen bleiben; keine kapazitätsbasierten Löschungen mehr)
await db.updateSchema('recent_events').disableCapacity();
KV-Kapazität wird beim Öffnen der Datenbank über DataStoreConfig gesetzt (nicht pro kv.set):
kvCapacityConfig: Limit für Keys im aktuellen SpaceglobalKvCapacityConfig: Limit für globale KV- Gleiche Form wie Tabellen-
CapacityConfig, aber keinsourceField
final db = await ToStore.open(
  dbPath: '...',
  config: DataStoreConfig(
    kvCapacityConfig: CapacityConfig(
      maxEntries: 5000,
      policy: CapacityEvictionPolicy.lru,
    ),
    globalKvCapacityConfig: CapacityConfig(
      maxEntries: 2000,
      policy: CapacityEvictionPolicy.fifo,
    ),
  ),
);
Intelligenter Speicher (Upsert)
ToStore entscheidet basierend auf dem Primärschlüssel oder dem eindeutigen Feld in data, ob aktualisiert oder eingefügt wird. where wird hier nicht unterstützt; das Ziel des Konflikts wird durch die Daten selbst bestimmt.
// Nach Primärschlüssel
final result = await db.upsert('users', {
  'id': 1,
  'username': 'john',
  'email': '[email protected]',
});

// Nach eindeutigem Schlüssel (der Datensatz muss alle Felder enthalten, die an einer eindeutigen Einschränkung beteiligt sind, plus Pflichtfelder)
await db.upsert('users', {
  'username': 'john',
  'email': '[email protected]',
  'age': 26,
});

// Batch Upsert (unterstützt atomaren Modus oder Modus für Teilerfolg)
// allowPartialErrors: true bedeutet, dass einige Zeilen fehlschlagen können, während andere erfolgreich sind
final batchResult = await db.batchUpsert('users', [
  {'username': 'a', 'email': '[email protected]'},
  {'username': 'b', 'email': '[email protected]'},
], allowPartialErrors: true);
Erweiterte Abfragen
ToStore bietet eine deklarativ verkettbare Abfrage-API mit flexibler Feldverarbeitung und komplexen Beziehungen mit mehreren Tabellen.
1. Feldauswahl (select)
Die Methode select gibt an, welche Felder zurückgegeben werden. Wenn Sie es nicht aufrufen, werden standardmäßig alle Felder zurückgegeben.
- Aliase: unterstützt die
field as alias-Syntax (ohne Berücksichtigung der Groß- und Kleinschreibung), um Schlüssel im Ergebnissatz umzubenennen - Tabellenqualifizierte Felder: Bei Verknüpfungen mit mehreren Tabellen vermeidet
table.fieldNamenskonflikte - Aggregationsmischung:
AggObjekte können direkt in derselectListe platziert werden
final results = await db.query('orders')
    .select([
      'orders.id',
      'users.name as customer_name',
      'orders.amount',
      Agg.count('id', alias: 'total_items')
    ])
    .join('users', 'orders.user_id', '=', 'users.id')
    .where('orders.amount', '>', 1000)
    .limit(20);
2. Tritt bei (join)
Unterstützt den Standard join (Inner Join), leftJoin und rightJoin.
3. Intelligente fremdschlüsselbasierte Verknüpfungen (empfohlen)
Wenn foreignKeys in TableSchema korrekt definiert ist, müssen Sie die Join-Bedingungen nicht handschriftlich verfassen. Die Engine kann Referenzbeziehungen auflösen und automatisch den optimalen JOIN-Pfad generieren.
joinReferencedTable(tableName): Verbindet automatisch die übergeordnete Tabelle, auf die die aktuelle Tabelle verweistjoinReferencingTable(tableName): Verbindet automatisch untergeordnete Tabellen, die auf die aktuelle Tabelle verweisen
// Assume posts defines a foreign key to users
final posts = await db.query('posts')
    .joinReferencedTable('users') // Automatically resolves to ON posts.user_id = users.id
    .select(['posts.title', 'users.username'])
    .limit(20);
Aggregation, Gruppierung und Statistik (Agg & GroupBy)
1. Aggregation (Agg Fabrik)
Aggregatfunktionen berechnen Statistiken über einen Datensatz. Mit dem Parameter alias können Sie Ergebnisfeldnamen anpassen.
| Methode | Zweck | Beispiel |
|---|---|---|
Agg.count(field) |
Nicht-Null-Datensätze zählen | Agg.count('id', alias: 'total') |
Agg.sum(field) |
Summenwerte | Agg.sum('amount', alias: 'total_price') |
Agg.avg(field) |
Durchschnittswert | Agg.avg('score', alias: 'average_score') |
Agg.max(field) |
Maximalwert | Agg.max('age') |
Agg.min(field) |
Mindestwert | Agg.min('price') |
[!TIP] Zwei gängige Aggregationsstile
- Abkürzungsmethoden (empfohlen für einzelne Metriken): Rufen Sie direkt die Kette auf und erhalten Sie den berechneten Wert sofort zurück.
num? totalAge = await db.query('users').sum('age');- Eingebettet in
select(für mehrere Metriken oder Gruppierung): Übergeben SieAgg-Objekte an dieselect-Liste.final stats = await db.query('orders').select(['status', Agg.sum('amount')]).groupBy(['status']);
2. Gruppieren und Filtern (groupBy / having)
Verwenden Sie groupBy, um Datensätze zu kategorisieren, und dann having, um aggregierte Ergebnisse zu filtern, ähnlich dem HAVING-Verhalten von SQL.
final stats = await db.query('orders')
    .select([
      'status',
      Agg.sum('amount', alias: 'sum_amount'),
      Agg.count('id', alias: 'order_count')
    ])
    .groupBy(['status'])
    // having accepts a QueryCondition used to filter aggregated results
    .having(QueryCondition().where(Agg.sum('amount'), '>', 5000))
    .limit(10);
3. Hilfsabfragemethoden
exists()(Hochleistung): prüft, ob ein Datensatz übereinstimmt. Im Gegensatz zucount() > 0wird es kurzgeschlossen, sobald eine Übereinstimmung gefunden wird, was sich hervorragend für sehr große Datensätze eignet.count(): Gibt effizient die Anzahl der übereinstimmenden Datensätze zurück.first(): eine praktische Methode, dielimit(1)entspricht und die erste Zeile direkt alsMapzurückgibt.distinct([fields]): dedupliziert Ergebnisse. Wennfieldsangegeben werden, wird die Eindeutigkeit anhand dieser Felder berechnet.
// Efficient existence check
if (await db.query('users').whereEqual('email', '[email protected]').exists()) {
  print('Email is already registered');
}

// Get a deduplicated city list
final cities = await db.query('users').distinct(['city']);
4. Komplexe Logik mit QueryCondition
QueryCondition ist das Kerntool von ToStore für verschachtelte Logik und die Erstellung von Abfragen in Klammern. Wenn einfache verkettete where-Aufrufe für Ausdrücke wie (A AND B) OR (C AND D) nicht ausreichen, ist dies das richtige Werkzeug.
condition(QueryCondition sub): öffnet eineANDverschachtelte GruppeorCondition(QueryCondition sub): öffnet eineORverschachtelte Gruppeor(): Ändert den nächsten Connector zuOR(Standard istAND)
Beispiel 1: Gemischte ODER-Bedingungen
Äquivalentes SQL: WHERE is_active = true AND (role = 'admin' OR fans >= 1000)
final subGroup = QueryCondition()
    .whereEqual('role', 'admin')
    .or()
    .whereGreaterThanOrEqualTo('fans', 1000);

final results = await db.query('users')
    .whereEqual('is_active', true)
    .condition(subGroup);
Beispiel 2: Wiederverwendbare Bedingungsfragmente
Sie können wiederverwendbare Geschäftslogikfragmente einmalig definieren und sie in verschiedenen Abfragen kombinieren:
final hotUser = QueryCondition().whereGreaterThan('fans', 5000);
final recentLogin = QueryCondition().whereGreaterThan('last_login', '2024-01-01');

final targetUsers = await db.query('users')
    .condition(hotUser)
    .condition(recentLogin);
5. Streaming-Abfrage
Geeignet für sehr große Datensätze, wenn Sie nicht alles auf einmal in den Speicher laden möchten. Die Ergebnisse können beim Lesen verarbeitet werden.
db.streamQuery('users').listen((data) {
  print('Processing one record: $data');
});
6. Reaktive Abfrage
Mit der watch()-Methode können Sie Abfrageergebnisse in Echtzeit überwachen. Es gibt ein Stream zurück und führt die Abfrage automatisch erneut aus, wenn sich übereinstimmende Daten in der Zieltabelle ändern.
- Automatische Entprellung: Die integrierte intelligente Entprellung vermeidet redundante Abfragestöße
- UI-Synchronisierung: Funktioniert natürlich mit Flutter
StreamBuilderfür die Live-Aktualisierung von Listen
// Simple listener
db.query('users').whereEqual('is_online', true).watch().listen((users) {
  print('Online user count changed: ${users.length}');
});

// Flutter StreamBuilder integration example
// Local UI refreshes automatically when data changes
StreamBuilder<List<Map<String, dynamic>>>(
  stream: db.query('messages').orderByDesc('id').limit(50).watch(),
  builder: (context, snapshot) {
    if (snapshot.hasData) {
      return ListView.builder(
        itemCount: snapshot.data!.length,
        itemBuilder: (context, index) => MessageTile(snapshot.data![index]),
      );
    }
    return CircularProgressIndicator();
  },
)
Manuelles Zwischenspeichern von Abfrageergebnissen (optional)
[!IMPORTANT] ToStore enthält intern bereits einen effizienten mehrstufigen intelligenten LRU-Cache. Eine routinemäßige manuelle Cache-Verwaltung wird nicht empfohlen. Erwägen Sie dies nur in besonderen Fällen:
- Teure vollständige Scans nicht indizierter Daten, die sich selten ändern
- Anhaltende Anforderungen an extrem niedrige Latenzzeiten, auch für nicht heiße Abfragen
useQueryCache([Duration? expiry]): Cache aktivieren und optional einen Ablauf festlegennoQueryCache(): Cache für diese Abfrage explizit deaktivierenclearQueryCache(): Den Cache für dieses Abfragemuster manuell ungültig machen
final results = await db.query('heavy_table')
    .where('non_indexed_field', '=', 'value')
    .useQueryCache(const Duration(minutes: 10)); // Manual acceleration for a heavy query only
Abfrage und effiziente Paginierung
[!TIP] Geben Sie immer
limitals Seitengröße an: Es wird dringend empfohlen, in jeder Abfrage explizit einlimitfestzulegen. Wenn es weggelassen wird, begrenzt die Engine die Abfrage standardmäßig auf 1.000 Datensätze, um das Laden zu großer Datenmengen auf einmal zu verhindern.
ToStore unterstützt Dual-Mode-Paginierung. Für unendliches Scrollen oder das Laden von Listen empfehlen wir dringend die integrierte nahtlose Cursor-Paginierung. Für das direkte Springen zu bestimmten Seiten reicht die einfache Offset-Paginierung aus:
1. Einfache Paginierung (Offset-Modus)
Geeignet für Szenarien mit geringen Datenmengen (z. B. unter 10k) oder wenn Sie gezielt zu einer bestimmten Seite springen müssen.
final result = await db.query('users')
    .orderByDesc('created_at')
    .offset(40) // Die ersten 40 Zeilen überspringen
    .limit(20); // 20 Zeilen abrufen
[!TIP] Wenn der
offsetsehr groß wird, muss die Datenbank viele Zeilen scannen und verwerfen, wodurch die Leistung linear abnimmt. Für tiefe Paginierung oder größere Datensätze wird der Cursor-Modus empfohlen.
2. Cursor-Paginierung (Cursor-Modus - Empfohlen)
Ideal für riesige Datensätze und unendliches Scrollen. Indem die Startposition des aktuellen Seiten-Datenstroms aufgezeichnet wird, springt die Engine bei der Paginierung direkt dorthin (Seek). Historische Daten müssen nicht gescannt und verworfen werden, wodurch die Geschwindigkeit bei tiefer Paginierung stets konstant bleibt.
- Automatische Verwaltung: Legen Sie die Seitengröße über das Limit fest und rufen Sie einfach
next()oderprev()auf den nachfolgenden Seiten auf, um mühelos eine optimale Paginierungsleistung zu erzielen. - Startpunkt-Verschiebung: Unterstützt die Kombination mit
.offset(N)bei der ersten Abfrage, um das Startfenster festzulegen. Danach rufen nachfolgendenext()-Aufrufe direkt die folgenden Seiten ab.
// 1. Erste Abfrage starten
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

// 2. Nächste Seite abrufen
if (page1.hasMore) {
  final page2 = await page1.next();
  print('Anzahl der Einträge auf der nächsten Seite: \${page2.data.length}');

  // 3. Vorherige Seite abrufen
  if (page2.hasPrev) {
    final prevPage = await page2.prev();
    print('Daten der vorherigen Seite: \${prevPage.data}');
  }
}
Fortgeschrittenes Szenario: Zustandlose Token-basierte Cursor-Paginierung (Token-based Cursor)
Für die Alltagspaginierung in der App bevorzugen Sie die oben genannten next() / prev(). Cursor-Token nur bei Client-Server-APIs oder wenn der Paginierungsstatus über Prozesse/Netzwerke serialisiert werden muss:
- Die erste Abfrage gibt die Token-Strings
nextCursorTokenundprevCursorTokenzurück. - Die nachfolgende Abfrage übergibt das Token über
.cursor(token)für eine gezielte Positionierung (Seek). - Hinweis:
cursorundoffsetschließen sich gegenseitig aus; das Setzen des einen löscht das andere.
// Erste Abfrage (z. B. auf der API-Serverseite)
final page1 = await db.query('users')
    .orderByDesc('id')
    .limit(20);

final String? nextToken = page1.nextCursorToken; // Serialisieren und diesen Token an den Client zurückgeben

// Wenn der Client die nächste Seite mit dem Token anfordert:
if (nextToken != null) {
  final page2 = await db.query('users')
      .orderByDesc('id')
      .limit(20)
      .cursor(nextToken); // Token übergeben, um die Position exakt zu bestimmen und zu lesen
}
| Funktion | Offset-Modus | Cursor-Modus |
|---|---|---|
| Abfrageleistung | Nimmt mit zunehmender Seitenzahl ab | Konstante Geschwindigkeit bei tiefer Paginierung |
| Beste Eignung | Kleinere Datensätze, exakte Seitensprünge | Riesige Datensätze, unendliches Scrollen |
| Konsistenz bei Änderungen | Datenänderungen können zu doppelten oder übersprungenen Zeilen führen | Vermeidet Duplikate und Auslassungen durch Datenänderungen |
Speicher-Sonde und synchrone Abfrage (peek)
Für Szenarien mit extremen Anforderungen an Durchsatz und Latenz bietet ToStore die peek-Serie rein synchroner In-Memory-Abfragen und absorbiert Burst-Hot-Reads direkt im Prozess: Edge-Geräte können Millionen Leseanfragen pro Sekunde verarbeiten; Server mit stärkerer Hardware erreichen zig Millionen pro Maschine (siehe Benchmarks).
[!NOTE] Nur In-Memory-Cache:
peekist ein Zero-Scheduling-Rein-Memory-Bypass. Bei Cache-Miss wird sofort leer/nullzurückgegeben; die Engine führt kein synchrones Datei-I/O aus (vermeidet Event-Loop-Blockierung unter hoher Parallelität). Für vollständige persistente Ergebnisseawait query()in der Anwendung verwenden.
peek-API-Methoden
| Methode | Rückgabetyp | Beschreibung |
|---|---|---|
peekFirst() |
Map<String, dynamic>? |
Einzelner Datensatz; null bei Cache-Miss |
peek() |
QueryResult<T> |
QueryResult mit data-Liste und Paginierungsmetadaten (hasMore, Cursor usw.); Daten nur bei Cache-Treffer |
peekExists() |
bool |
Prüft synchron, ob ein passender Datensatz im Cache existiert |
peekCount() |
int |
Zählt synchron passende Datensätze im Cache |
result.peekNext() |
QueryResult<T> |
Synchrone nächste Seite bei gecachtem Paginierungsergebnis |
result.peekPrev() |
QueryResult<T> |
Synchrone vorherige Seite bei gecachtem Paginierungsergebnis |
Best Practice: Speichersonde zuerst (Peek-Through)
// Einzeldatensatz: Speichersonde zuerst, bei Miss Standard-Async-Abfrage
final q = db.query('users').where('id', '=', userId);
final user = q.peekFirst() ?? await q.first();

// Paginierte Sondenabfrage
final listQ = db.query('users').orderByDesc('id').limit(20);
var page = listQ.peek();
if (page.data.isEmpty) page = await listQ;

if (page.hasMore) {
  final next = page.peekNext(); // Cache-Treffer: synchrone Seitenwechsel
  if (next.data.isEmpty) await page.next();
}
KV-Sonde (db.kv)
| Methode | Async-Entsprechung | Beschreibung |
|---|---|---|
peekGet(key) |
get(key) |
Synchrone In-Memory-Punktabfrage; abgelaufene Schlüssel → null |
peekExists(key) |
exists(key) |
Synchrone Existenzprüfung im Speicher |
db.kv.query().peek() |
await db.kv.query() |
Synchrone paginierte Sondenabfrage (Präfix / Sortierung / limit) |
db.kv.query().peekFirst() |
await db.kv.query().first() |
Synchrone Sondenabfrage für ersten Treffer |
// Punktabfrage: Sonde zuerst, bei Miss async zurückfallen
final theme = db.kv.peekGet('theme', isGlobal: true) ?? await db.kv.get('theme', isGlobal: true);

// Paginierte KV-Sonde
var page = db.kv.query().prefix('setting_').limit(20).peek();
if (page.data.isEmpty) page = await db.kv.query().prefix('setting_').limit(20);
[!TIP] Empfehlung: Standard-Async-Abfragen (
await query()) sichern durch Event-Scheduling langfristige Stabilität und faire Multitasking; 100k+ QPS genügen für die meisten Workloads. Diepeek-Serie ist für extreme Hot-Read-Spitzen mit Millionen/Zig-Millionen QPS pro Maschine konzipiert.
Fremdschlüssel und Kaskadierung
Fremdschlüssel garantieren referenzielle Integrität und ermöglichen die Konfiguration kaskadierender Aktualisierungen und Löschungen. Beziehungen werden beim Schreiben und Aktualisieren validiert. Wenn Kaskadenrichtlinien aktiviert sind, werden zugehörige Daten automatisch aktualisiert, wodurch der Konsistenzaufwand im Anwendungscode reduziert wird.
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(name: 'id'),
    fields: [
      FieldSchema(name: 'username', type: DataType.text, nullable: false),
    ],
  ),
  TableSchema(
    name: 'posts',
    primaryKeyConfig: const PrimaryKeyConfig(name: 'id'),
    fields: [
      const FieldSchema(name: 'title', type: DataType.text, nullable: false),
      const FieldSchema(name: 'user_id', type: DataType.integer, nullable: false),
      const FieldSchema(name: 'content', type: DataType.text),
    ],
    foreignKeys: [
        ForeignKeySchema(
          name: 'fk_posts_user',
          fields: ['user_id'],              // Field in the current table
          referencedTable: 'users',         // Referenced table
          referencedFields: ['id'],         // Referenced field
          onDelete: ForeignKeyCascadeAction.cascade,  // Delete posts automatically when the user is deleted
          onUpdate: ForeignKeyCascadeAction.cascade,  // Cascade updates
        ),
    ],
  ),
]);
Abfrageoperatoren
Alle where(field, operator, value)-Bedingungen unterstützen die folgenden Operatoren (ohne Berücksichtigung der Groß-/Kleinschreibung):
| Operator | Beschreibung | Beispiel / Leistung |
|---|---|---|
= |
Gleich | where('status', '=', 'val') — [Empfohlen] Index-Seek |
!=, <> |
Ungleich | where('role', '!=', 'val') — [Vorsicht] Vollständiger Tabellenscan |
> , >=, <, <= |
Vergleich | where('age', '>', 18) — [Empfohlen] Index-Scan |
IN |
In Liste | where('id', 'IN', [...]) — [Empfohlen] Index-Seek |
NOT IN |
Nicht in der Liste | where('status', 'NOT IN', [...]) — [Vorsicht] Vollständiger Tabellenscan |
BETWEEN |
Bereich | where('age', 'BETWEEN', [18, 65]) — [Empfohlen] Index-Scan |
LIKE |
Musterübereinstimmung (% = beliebige Zeichen, _ = einzelnes Zeichen) |
where('name', 'LIKE', 'John%') — [Vorsicht] Siehe Hinweis unten |
NOT LIKE |
Musterkonflikt | where('email', 'NOT LIKE', '...') — [Vorsicht] Vollständiger Tabellenscan |
IS |
Ist null | where('deleted_at', 'IS', null) — [Empfohlen] Index-Seek |
IS NOT |
Ist nicht null | where('email', 'IS NOT', null) — [Vorsicht] Vollständiger Tabellenscan |
Semantische Abfragemethoden (empfohlen)
Empfohlen, um handgeschriebene Operatorzeichenfolgen zu vermeiden und eine bessere IDE-Unterstützung zu erhalten.
1. Vergleich
Wird für direkte numerische Vergleiche oder Zeichenfolgenvergleiche verwendet.
db.query('users').whereEqual('username', 'John');           // Equal
db.query('users').whereNotEqual('role', 'guest');          // Not equal
db.query('users').whereGreaterThan('age', 18);             // Greater than
db.query('users').whereGreaterThanOrEqualTo('score', 60);  // Greater than or equal
db.query('users').whereLessThan('price', 100);             // Less than
db.query('users').whereLessThanOrEqualTo('quantity', 10);  // Less than or equal
db.query('users').whereTrue('is_active');                  // Is true
db.query('users').whereFalse('is_banned');                 // Is false
2. Kollektion und Sortiment
Wird verwendet, um zu testen, ob ein Feld innerhalb einer Menge oder eines Bereichs liegt.
db.query('users').whereIn('id', ['id1', 'id2']);                 // In list
db.query('users').whereNotIn('status', ['banned', 'pending']);   // Not in list
db.query('users').whereBetween('age', 18, 65);                   // In range (inclusive)
3. Nullprüfung
Wird verwendet, um zu testen, ob ein Feld einen Wert hat.
db.query('users').whereNull('deleted_at');    // Is null
db.query('users').whereNotNull('email');      // Is not null
db.query('users').whereEmpty('nickname');     // Is null or empty string
db.query('users').whereNotEmpty('bio');       // Is not null and not empty
4. Mustervergleich
Unterstützt die Platzhaltersuche im SQL-Stil ((% entspricht einer beliebigen Anzahl von Zeichen, _ entspricht einem einzelnen Zeichen).
db.query('users').whereLike('name', 'John%');                        // SQL-style pattern match
db.query('users').whereContains('bio', 'flutter');                   // Contains match (LIKE '%value%')
db.query('users').whereStartsWith('name', 'Admin');                  // Prefix match (LIKE 'value%')
db.query('users').whereEndsWith('email', '.com');                    // Suffix match (LIKE '%value')
db.query('users').whereContainsAny('tags', ['dart', 'flutter']);     // Fuzzy match against any item in the list
// Equivalent to: .where('age', '>', 18).where('name', 'like', '%John%')
final users = await db.query('users')
    .whereGreaterThan('age', 18)
    .whereLike('username', '%John%')
    .orderByDesc('age')
    .limit(20);
[!CAUTION] Leitfaden zur Abfrageleistung (Index vs. Vollscan)
Befolgen Sie in Szenarien mit großen Datenmengen (Millionen von Zeilen oder mehr) diese Prinzipien, um Verzögerungen im Haupt-Thread und Abfrage-Timeouts zu vermeiden:
Index-optimiert - [Empfohlen]:
- Semantische Methoden:
whereEqual,whereGreaterThan,whereLessThan,whereIn,whereBetween,whereNull,whereTrue,whereFalseundwhereStartsWith(Präfix-Übereinstimmung).- Operatoren:
=,>,<,>=,<=,IN,BETWEEN,IS null,LIKE 'prefix%'.- Erklärung: Diese Operationen erreichen eine superschnelle Positionierung über Indizes. Bei
whereStartsWith/LIKE 'abc%'kann der Index weiterhin einen Präfix-Bereichsscan durchführen.Risiken bei Vollscan - [Vorsicht]:
- Unscharfe Übereinstimmung:
whereContains(LIKE '%val%'),whereEndsWith(LIKE '%val'),whereContainsAny.- Negationsabfragen:
whereNotEqual(!=,<>),whereNotIn(NOT IN),whereNotNull(IS NOT null/whereNotEmpty).- Musterkonflikt:
NOT LIKE.- Erklärung: Die oben genannten Operationen erfordern in der Regel das Durchlaufen des gesamten Datenspeicherbereichs, selbst wenn ein Index erstellt wurde. Während die Auswirkungen auf mobilen oder kleinen Datensätzen minimal sind, sollten sie in verteilten oder extrem großen Datenanalyseszenarien mit Vorsicht verwendet werden, kombiniert mit anderen Indexbedingungen (z. B. Filtern nach ID oder Zeitbereich) und der
limit-Klausel.
Verteilte Architektur
// Configure distributed nodes
final db = await ToStore.open(
  config: DataStoreConfig(
    distributedNodeConfig: const DistributedNodeConfig(
      enableDistributed: true,            // Enable distributed mode
      clusterId: 1,                       // Cluster ID
      centralServerUrl: 'https://127.0.0.1:8080',
      accessToken: 'b7628a4f9b4d269b98649129'
    )
  )
);

// Batch insert
await db.batchInsert('vector_data', [
  {'vector_name': 'face_2365', 'timestamp': DateTime.now()},
  {'vector_name': 'face_2366', 'timestamp': DateTime.now()},
  // ... efficient one-shot insertion of vector records
]);

// Stream and process large datasets
await for (final record in db.streamQuery('vector_data')
  .where('vector_name', '=', 'face_2366')
  .where('timestamp', '>=', DateTime.now().subtract(Duration(days: 30)))
  .stream) {
  // Process each result incrementally to avoid loading everything at once
  print(record);
}
Beispiele für Primärschlüssel
ToStore bietet mehrere verteilte Primärschlüsselalgorithmen für verschiedene Geschäftsszenarien:
- Sequentieller Primärschlüssel (
PrimaryKeyType.sequential):238978991 - Zeitstempelbasierter Primärschlüssel (
PrimaryKeyType.timestampBased):1306866018836946 - Primärschlüssel mit Datumspräfix (
PrimaryKeyType.datePrefixed):20250530182215887631 - Kurzcode-Primärschlüssel (
PrimaryKeyType.shortCode):9eXrF0qeXZ
// Sequential primary key configuration example
await db.createTables([
  const TableSchema(
    name: 'users',
    primaryKeyConfig: PrimaryKeyConfig(
      type: PrimaryKeyType.sequential,
      sequentialConfig: SequentialIdConfig(
        initialValue: 10000,      // Starting value
        increment: 50,            // Step size
        useRandomIncrement: true, // Random step size to hide business volume
      ),
    ),
    fields: [/* field definitions */]
  ),
]);
Atomare Ausdrücke
Das Ausdruckssystem stellt typsichere Aktualisierungen atomarer Felder bereit. Alle Berechnungen werden atomar auf der Datenbankebene ausgeführt, wodurch gleichzeitige Konflikte vermieden werden:
// Simple increment: balance = balance + 100
await db.update('accounts', {
  'balance': Expr.field('balance') + Expr.value(100),
}).where('id', '=', accountId);

// Complex calculation: total = price * quantity + tax
await db.update('orders', {
  'total': Expr.field('price') * Expr.field('quantity') + Expr.field('tax'),
}).where('id', '=', orderId);

// Multi-layer parentheses: finalPrice = ((price * quantity) + tax) * (1 - discount)
await db.update('orders', {
  'finalPrice': ((Expr.field('price') * Expr.field('quantity')) + Expr.field('tax')) *
                 (Expr.value(1) - Expr.field('discount')),
}).where('id', '=', orderId);

// Use functions: price = min(price, maxPrice)
await db.update('products', {
  'price': Expr.min(Expr.field('price'), Expr.field('maxPrice')),
}).where('id', '=', productId);

// Timestamp: updatedAt = now()
await db.update('users', {
  'updatedAt': Expr.now(),
}).where('id', '=', userId);
Bedingte Ausdrücke (z. B. Unterscheidung zwischen Update und Insert in einem Upsert): Verwenden Sie Expr.isUpdate() / Expr.isInsert() zusammen mit Expr.ifElse oder Expr.when, sodass der Ausdruck nur bei der Aktualisierung oder nur beim Einfügen ausgewertet wird.
// Upsert: increment on update, set to 1 on insert
// The insert branch can use a plain literal; expressions are only evaluated on the update path
await db.upsert('counters', {
  'key': 'visits',
  'count': Expr.ifElse(
    Expr.isUpdate(),
    Expr.field('count') + Expr.value(1),
    1,
  ),
});

// Use Expr.when (single branch, otherwise null)
await db.upsert('orders', {
  'id': orderId,
  'updatedAt': Expr.when(Expr.isUpdate(), Expr.now(), otherwise: Expr.now()),
});
Transaktionen
Transaktionen stellen die Atomizität über mehrere Vorgänge hinweg sicher: Entweder ist alles erfolgreich oder alles wird zurückgesetzt, wodurch die Datenkonsistenz gewahrt bleibt.
Transaktionsmerkmale
- Mehrere Vorgänge sind entweder alle erfolgreich oder werden alle rückgängig gemacht
- Unvollendete Arbeiten werden nach Abstürzen automatisch wiederhergestellt
- Erfolgreiche Vorgänge werden sicher aufrechterhalten
// Basic transaction - atomically commit multiple operations
final txResult = await db.transaction(() async {
  // Insert a user
  await db.insert('users', {
    'username': 'john',
    'email': '[email protected]',
    'fans': 100,
  });

  // Atomic update using an expression
  await db.update('users', {
    'fans': Expr.field('fans') + Expr.value(50),
  }).where('username', '=', 'john');

  // If any operation fails, all changes are rolled back automatically
});

if (!txResult.hasErrors) {
  print('Transaktion erfolgreich übermittelt');
} else {
  print('Transaktions-Rollback aus folgenden Gründen:');
  for (final status in txResult.statuses) {
    if (status.type != ResultType.success) {
      print(' - [$status.codeKey}] $status.message}');
    }
  }
}

// Automatic rollback on error
final txResult2 = await db.transaction(() async {
  await db.insert('users', {
    'username': 'jane',
    'email': '[email protected]',
  });
  throw Exception('Business logic error'); // Trigger rollback
}, rollbackOnError: true);
Verwaltung und Wartung
Die folgenden APIs decken die Datenbankverwaltung, Diagnose und Wartung für die Entwicklung im Plugin-Stil, Admin-Panels und Betriebsszenarien ab:
- Tischverwaltung
createTable(schema): eine einzelne Tabelle manuell erstellen; Nützlich zum Laden von Modulen oder zum Erstellen von Laufzeittabellen bei BedarfgetTableSchema(tableName): Rufen Sie die definierten Schemainformationen ab; nützlich für die automatisierte Validierung oder UI-ModellgenerierunggetTableNames({isGlobal}): Tabellennamen im globalen Schema-Inventar auflisten (Benutzertabellen). OptionalisGlobal:truenur global,falsenur nicht-global, weglassen = beide. Nicht-globale Schemas sind raumübergreifend geteilt; nur Daten sind raumisoliert.getTableInfo(tableName): Laufzeitstatistiken abrufen (totalRecordCount,totalTableDataSizeBytes,totalIndexDataSizeBytes,indexCount, Erstellungszeit, ob global)clear(tableName): Alle Tabellendaten löschen und dabei Schema, Indizes und interne/externe Schlüsseleinschränkungen sicher beibehaltendropTable(tableName): Eine Tabelle und ihr Schema vollständig zerstören; nicht reversibel
- Raumverwaltung
currentSpaceName: Erhalten Sie den aktuell aktiven Bereich in EchtzeitlistSpaces(): Listet alle zugewiesenen Bereiche in der aktuellen Datenbankinstanz aufgetSpaceInfo(useCache: true): raumlokale Aggregate (totalRecordCount, Tabellen-/Indexdatengröße).useCache: falsefür Meta-Reconcile.deleteSpace(spaceName): Löschen Sie einen bestimmten Bereich und alle seine Daten, außerdefaultund den aktuell aktiven Bereich
- Instanzerkennung
config: Überprüfen Sie den endgültigen gültigenDataStoreConfigSnapshot für die InstanzinstancePath: Lokalisieren Sie das physische Speicherverzeichnis genaugetVersion()/setVersion(version): geschäftsdefinierte Versionskontrolle für Migrationsentscheidungen auf Anwendungsebene (nicht die Engine-Version)
- Wartung
flush(mode: FlushMode.full): erzwingt das Schreiben ausstehender Daten in den Speicher. Modi:recovery(schnellste; Wiederherstellungsprotokoll nur in OS-Puffer; übersteht App-Absturz, nicht Stromausfall),recoveryDurable(Wiederherstellungsprotokoll auf stabilen Speicher; zielt auf Überstehen von Stromausfällen),full(Standard; Wiederherstellungsprotokoll + Tabellen- und Indexdaten auf stabilen Speicher).deleteDatabase(): alle physischen Dateien und Metadaten für die aktuelle Instanz entfernen; mit Vorsicht verwenden
- Diagnose
db.status.memory(): Überprüfen Sie die Cache-Trefferquoten, die Indexseitennutzung und die gesamte Heap-Zuordnungdb.status.space()/db.status.table(tableName): Überprüfen Sie Live-Statistiken und Gesundheitsinformationen für Räume und Tabellendb.status.config(): Überprüfen Sie den aktuellen Snapshot der Laufzeitkonfigurationdb.status.migration(taskId): Verfolgen Sie den Fortschritt der asynchronen Migration in Echtzeit
final spaces = await db.listSpaces();
final tableNames = await db.getTableNames();
final spaceInfo = await db.getSpaceInfo(useCache: false);
final tableSchema = await db.getTableSchema('users');
final tableInfo = await db.getTableInfo('users');

print('spaces: $spaces');
print('tables: $tableNames');
print(spaceInfo.toJson());
print(tableSchema?.toJson());
print(tableInfo?.toJson());

await db.flush();

final memoryInfo = await db.status.memory();
final configInfo = await db.status.config();
print(memoryInfo.toJson());
print(configInfo.toJson());
Sichern und Wiederherstellen
Besonders nützlich für den lokalen Import/Export für Einzelbenutzer, die Migration großer Offline-Daten und das System-Rollback nach einem Fehler:
- Sicherung (
backup)compress: ob die Komprimierung aktiviert werden soll; empfohlen und standardmäßig aktiviertscope: steuert den Backup-BereichBackupScope.database: Sichert die gesamte Datenbankinstanz, einschließlich aller Leerzeichen und globalen TabellenBackupScope.currentSpace: Sichert nur den aktuell aktiven Speicherplatz, ausgenommen globale TabellenBackupScope.currentSpaceWithGlobal: Sichert den aktuellen Speicherplatz und die zugehörigen globalen Tabellen, ideal für die Migration einzelner Mandanten oder einzelner Benutzer
- Wiederherstellen (
restore)backupPath: physischer Pfad zum Backup-PaketcleanupBeforeRestore: ob zugehörige aktuelle Daten vor der Wiederherstellung stillschweigend gelöscht werden sollen;truewird empfohlen, um gemischte logische Zustände zu vermeidendeleteAfterRestore: Nach erfolgreicher Wiederherstellung wird die Sicherungsquelldatei automatisch gelöscht
// Example: export the full data package for the current user
final backupPath = await db.backup(
  compress: true,
  scope: BackupScope.currentSpaceWithGlobal,
);

// Example: restore from a backup package and clean up the source file automatically
final restored = await db.restore(
  backupPath,
  cleanupBeforeRestore: true,
  deleteAfterRestore: true,
);
Statuscodes und Fehlerbehandlung
Es gibt zwei Kanäle für Fehler- und Ausnahme-Feedback in ToStore:
[!NOTE] Einheitliche Diagnosebasis: Unabhängig davon, ob sie über das Antwort-Ergebnismodell (
statusesinDbResult/QueryResult) zurückgegeben oder über fatale Ausnahmen (statusesinDbException) ausgelöst werden, basieren alle Diagnosezustände einheitlich auf dem strukturiertenResultStatus-System und teilen dieselben Statuscodes, was Konsistenz garantiert.
- Antwort-Ergebnismodell (Result-based Response)
Für alltägliche Operationen wie Einfügen, Aktualisieren, Löschen, Abfragen, Transaktionen und Tabellenstrukturänderungen zur Laufzeit. Diese Operationen lösen keine Ausnahmen aus, wenn Einschränkungsverletzungen, Validierungsfehler oder ungültige Argumente auftreten. Stattdessen verpackt ToStore die Ergebnisse in
DbResultoderQueryResultund zeichnet alle Diagnoseinformationen in der Statusliste auf. Dies garantiert, dass gewöhnliche geschäftslogische Fehler die Datenbank nicht unterbrechen.
hasErrors: Gibt an, ob bei der aktuellen Operation Fehler aufgetreten sind. Bei Batch-Operationen oder Transaktionen ist diese Eigenschafttrue, wenn mindestens ein Fehler vorliegt.statuses: Eine detaillierte Liste allerResultStatus-Diagnosen der Operation. Sie unterstützt eine 1:1-Reihenfolgeübereinstimmung, was für Batch-Operationen sehr nützlich ist.firstPrimaryKey: Liest den physisch generierten Primärschlüssel bei einer einzelnen Einfüge-/Schreiboperation direkt aus, ohne diestatusesmanuell parsen zu müssen.ResultType: Enum für die Zustandskategorie, praktisch für Verzweigungen (z. B.isBusinessError,isDeveloperError).
- Ausnahmen auslösen (Exception-based Throwing)
Für fatale Fehler, die durch Entwicklerfehler oder Designfehler verursacht werden (z. B. Schemaüberprüfungsfehler während
ToStore.open, Inkompatibilität der Engine-Version, schwerwiegende Datenmigrationsfehler usw.). In diesen Fällen löst ToStore eineDbExceptionaus, um die Ausführung zu stoppen und den Entwickler zur Behebung aufzufordern.
[!WARNING] Entwicklungsrichtlinien: Gewöhnliche Geschäftsfehler dürfen keine Ausnahmen auslösen. Sie müssen im Antwort-Ergebnismodell zurückgegeben werden, um den Anwendungsbetrieb nicht zu stören.
Beispiele für Fehler und Ausnahmen
1. Fehlerbehandlung bei einer einzelnen Schreiboperation
final result = await db.insert('users', {
  'username': 'john',
  'email': '[email protected]',
});

if (result.hasErrors) {
  // Ersten Fehlertyp und Beschreibung abrufen
  print('Operation failed: [\${result.firstType.codeKey}] \${result.message}');
} else {
  print('Schreiben erfolgreich, Primärschlüssel ist: \${result.firstPrimaryKey}');
}
2. Batch-Schreiboperationen und detaillierte Diagnose
final batchResult = await db.batchInsert('users', [
  {'username': 'alice', 'email': '[email protected]'},
  {'username': 'bob', 'email': 'invalid-email-format'}, // Validation fails
]);

if (batchResult.hasErrors) {
  print('Batch-Operation teilweise fehlgeschlagen: erfolgreich \${batchResult.successCount}, fehlgeschlagen \${batchResult.failedCount}');

  for (final status in batchResult.statuses) {
    final int idx = status.index;

    if (status is ConstraintStatus) {
      print('Index [\$idx] Einschränkungsverletzung! Tabelle! Tabelle: \${status.tableName}, Felder: \${status.fields}');
    } else if (status is InvalidArgumentStatus) {
      print('Index [\$idx] Argumentfehler! Parameter! Parameter: \${status.parameterName}, übergebener Wert: \${status.passedValue}');
    } else if (status.type != ResultType.success) {
      print('Index [\$idx] Fehler aufgetreten: [\${status.codeKey}] \${status.message}');
    }
  }
}
3. Fatale Fehler und Abfangen von Initialisierungsausnahmen (DbException)
try {
  // Initialize database with schemas that might have validation issues
  final db = await ToStore.open(schemas: appSchemas);
} on DbException catch (e) {
  print('❌ Fatale Datenbank-Ausnahme! Fehlermeldung: \n\${e.message}');

  // Iterate through the detailed status list in the exception
  for (final status in e.statuses) {
    if (status is SchemaValidationStatus) {
      print('Schema-Validierung fehlgeschlagen! Tabelle! Tabelle: \${status.tableName}, Feld: \${status.field}, ungültige Konfiguration: \${status.wrongValue}');
    } else {
      print('Diagnose-Info: [\${status.codeKey}] \${status.message}');
    }
  }
}
Die vollständige Liste der Fehlertypen, Statuscodes, JSON-Serialisierungsformate und Feldzuordnungen finden Sie in der Spezifikation: ToStore ResultStatus-Spezifikation für automatische Diagnose und Statusauflösung.
Protokollrückruf und Datenbankdiagnose
ToStore kann Datenbank-Lebenszyklusprotokolle über ToStore.setLogConfig(...) an die Geschäftsschicht weiterleiten.
- Der
onLog-Callback empfängt alleLogRecord-Protokolleinträge, die die aktuellen FilterenableLogundlogLevelpassieren.- LogLevel.error: Ein lokaler Fehler ist aufgetreten, der den normalen Betrieb nicht beeinträchtigt.
- LogLevel.critical: Globaler Fehler auf Katastrophenebene (z. B. Festplatte voll, unzureichender Arbeitsspeicher, schwerwiegender Migrationsfehler usw.), der ein manuelles Eingreifen erfordert. Es wird empfohlen, auf dieser Stufe Alarmbenachrichtigungen auszulösen.
- Rufen Sie
ToStore.setLogConfig(...)vor der Initialisierung auf, damit auch die während der Initialisierung und der automatischen Migration generierten Protokolle erfasst werden.
  // Protokollparameter oder Callback konfigurieren
  ToStore.setLogConfig(
    enableLog: true,
    logLevel: debugMode ? LogLevel.debug : LogLevel.warn,
    logLabel: 'my_app_db', // Hellgrauer Header-Titel oben im Protokoll zur Unterscheidung von Apps oder Datenbankinstanzen,
    onLog: (log) {
      // In der Produktion können warn/error/critical an das Backend oder die Protokollplattform gemeldet werden
      // log.level entspricht der Protokollstufe (LogLevel.debug, info, warn, error, critical)
      // log.message entspricht dem verarbeiteten Protokolltext
      // log.status entspricht dem zugrunde liegenden ResultStatus-Diagnosestatus (enthält code und codeKey)
      if (!debugMode && (log.level == LogLevel.warn || log.level == LogLevel.error || log.level == LogLevel.critical)) {
        developer.log(log.message, name: 'my_app_db', time: log.timestamp);
      }
    },
  );

  final db = await ToStore.open();
Sicherheitskonfiguration
[!WARNING] Schlüsselverwaltung
Schlüssel Rolle Änderung Vollständige Datenmigration? encodingKeyDatenverschlüsselungsschlüssel Neuen Wert setzen und erneut openJa (zeitaufwendig) encryptionKeySicherheitsschlüssel; schützt encodingKeyZur Laufzeit db.rotateEncryptionKeyaufrufenNein (schnell) Sensible Schlüssel niemals fest kodieren. Zur Gerätebindung
encryptionKeyim OS-Keychain / Keystore / Secure Enclave speichern und an die Engine übergeben.
final db = await ToStore.open(
  config: DataStoreConfig(
    encryptionConfig: EncryptionConfig(
      // Supported: none, xorObfuscation, chacha20Poly1305, aes256Gcm
      encryptionType: EncryptionType.chacha20Poly1305,

      // Data encryption key: encrypts table/index/log data; changing it triggers a background rewrite
      encodingKey: 'Your-Encoding-Key...',

      // Security key: protects encodingKey; rotate online via db.rotateEncryptionKey
      encryptionKey: 'Your-Secure-Encryption-Key...',

      // standard: critical table data, B-tree indexes, and log payloads
      // full: encrypts the entire engine files
      encryptionScope: EncryptionScope.standard,
    ),
    // Enable crash recovery logging (Write-Ahead Logging), enabled by default
    enableJournal: true,
    // Whether transactions force data to disk on commit; set false to reduce sync overhead
    persistRecoveryOnCommit: true,
  ),
);
encodingKey ändern: neuen Wert in EncryptionConfig setzen und erneut open aufrufen. Die Engine erkennt die Änderung und migriert Daten automatisch im Hintergrund—ohne Eingriff der Anwendung.
encryptionKey rotieren (regelmäßige Sicherheits-/Compliance-Rotation): keine Datenmigration; online ausführbar.
// If encryptionKey was never set explicitly, oldKey can be omitted
final result = await db.rotateEncryptionKey(newKey: 'new-secure-key');
// Or: await db.rotateEncryptionKey(oldKey: 'old-key', newKey: 'new-key');
if (result.hasErrors) {
  // Fehler behandeln (falscher oldKey, encodingKey-Migration läuft usw.)
  return;
}
// Erfolg: In-Memory-Konfiguration aktualisiert; beim nächsten ToStore.open aktuellen encryptionKey übergeben
Verschlüsselung auf Wertebene (ToCrypto)
Die vollständige Datenbankverschlüsselung schützt alle Tabellen- und Indexdaten, kann jedoch die Gesamtleistung beeinträchtigen. Wenn Sie nur wenige sensible Werte schützen müssen, verwenden Sie stattdessen ToCrypto. Es ist von der Datenbank entkoppelt, erfordert keine db-Instanz und ermöglicht Ihrer Anwendung das Kodieren/Dekodieren von Werten vor dem Schreiben oder nach dem Lesen. Die Ausgabe ist Base64, was natürlich in JSON- oder TEXT-Spalten passt.
key(erforderlich):StringoderUint8List. Wenn es nicht 32 Bytes sind, wird SHA-256 verwendet, um einen 32-Byte-Schlüssel abzuleiten.type(optional): Verschlüsselungstyp vonToCryptoType, z. B.ToCryptoType.chacha20Poly1305oderToCryptoType.aes256Gcm. Standardmäßig istToCryptoType.chacha20Poly1305.aad(optional): zusätzliche authentifizierte Daten vom TypUint8List. Wenn sie während der Codierung bereitgestellt werden, müssen genau dieselben Bytes auch während der Decodierung bereitgestellt werden.
const key = 'my-secret-key';
// Encode: plaintext -> Base64 ciphertext (can be stored in DB or JSON)
final cipher = ToCrypto.encode('sensitive data', key: key);
// Decode when reading
final plain = ToCrypto.decode(cipher, key: key);

// Optional: bind contextual data with aad (must match during decode)
final aad = Uint8List.fromList(utf8.encode('users:id_number'));
final cipher2 = ToCrypto.encode('secret', key: key, aad: aad);
final plain2 = ToCrypto.decode(cipher2, key: key, aad: aad);
Erweiterte Konfiguration erklärt (DataStoreConfig)
[!TIP] Zero-Config-Intelligenz ToStore erkennt automatisch die Plattform, Leistungsmerkmale, verfügbaren Speicher und E/A-Verhalten, um Parameter wie Parallelität, Shard-Größe und Cache-Budget zu optimieren. In 99 % der gängigen Geschäftsszenarien ist keine manuelle Feinabstimmung von
DataStoreConfigerforderlich. Die Standardeinstellungen bieten bereits eine hervorragende Leistung für die aktuelle Plattform.
| Parameter | Standard | Zweck & Empfehlung |
|---|---|---|
yieldDurationMs |
8ms | Kernempfehlung. Der Zeitabschnitt, der verwendet wird, wenn lange Aufgaben nachgeben. 8ms passt gut zum 120-fps-/60-fps-Rendering und trägt dazu bei, dass die Benutzeroberfläche bei großen Abfragen oder Migrationen reibungslos bleibt. |
maxQueryOffset |
10000 | Abfrageschutz. Wenn offset diesen Schwellenwert überschreitet, wird ein Fehler ausgelöst. Dadurch wird verhindert, dass pathologische E/A durch eine tiefe Offset-Paginierung verursacht werden. |
defaultQueryLimit |
1000 | Ressourcenleitplanke. Wird angewendet, wenn eine Abfrage nicht limit angibt, um ein versehentliches Laden großer Ergebnismengen und potenzielle OOM-Probleme zu verhindern. |
cacheMemoryBudgetMB |
(automatisch) | Feingranulare Speicherverwaltung. Gesamtcache-Speicherbudget. Die Engine nutzt es, um die LRU-Rückgewinnung automatisch voranzutreiben. |
enableJournal |
wahr | Selbstheilung bei Abstürzen. Wenn diese Option aktiviert ist, kann sich der Motor nach Abstürzen oder Stromausfällen automatisch erholen. |
defaultRecoveryDurability |
standard |
Wiederherstellungsgarantie bei Antwort. Definiert die Stufe der Selbstheilungswiederherstellung vor Rückgabe des Ergebnisses von Schreiboperationen: • standard (Standard): Vor der Antwort absturzsicher. Garantiert Selbstheilung gegen App-Abstürze, unbehandelte Ausnahmen und OOM-Kills.• durable: Vor der Antwort stromausfallsicher. Vor der Rückgabe physisch persistiert; garantiert Selbstheilung auch bei plötzlichem Stromausfall.• async: Maximaler Durchsatz. Antwortet sofort und speichert im Hintergrund; nach der Rückgabe bei kleinen Datenmengen meist nur ein extrem kurzes Fenster von wenigen Millisekunden bis zur persistenten Speicherung. |
persistRecoveryOnCommit |
wahr | Starke Haltbarkeitsgarantie. Wenn dies zutrifft, werden festgeschriebene Transaktionen mit dem physischen Speicher synchronisiert. Bei „false“ erfolgt die Löschung asynchron im Hintergrund, um die Geschwindigkeit zu erhöhen, wobei bei extremen Abstürzen ein geringes Risiko besteht, dass eine kleine Datenmenge verloren geht. |
ttlCleanupIntervalMs |
300000 | Globale TTL-Abfrage. Das Hintergrundintervall zum Scannen abgelaufener Daten, wenn die Engine nicht im Leerlauf ist. Niedrigere Werte löschen abgelaufene Daten früher, kosten aber mehr Overhead. |
kvCapacityConfig |
null | Space-KV-Kapazität. FIFO/LRU-Limit für space-bezogene Keys; kein sourceField. Siehe Kapazitätsbereinigung. |
globalKvCapacityConfig |
null | Globale KV-Kapazität. Gleiche Form wie kvCapacityConfig. |
maxConcurrency |
(automatisch) | Computing-Parallelitätskontrolle. Legt die maximale Anzahl paralleler Worker für intensive Aufgaben wie Vektorberechnung und Verschlüsselung/Entschlüsselung fest. Normalerweise ist es am besten, es automatisch zu lassen. |
final db = await ToStore.open(
  config: DataStoreConfig(
    yieldDurationMs: 8, // Excellent for frontend UI smoothness; for servers, 50ms is often better
    defaultQueryLimit: 50, // Force a maximum result-set size
    enableJournal: true, // Ensure crash self-healing
    defaultRecoveryDurability: RecoveryDurability.standard, // Vor der Antwort absturzsicher
  ),
);
Leistung und Erfahrung
Benchmarks
Highlights der 100K-Suite und Milliarden-Edge-Validierung (3 Runden, standard durability, 2026-10-08):
| Metric | Result |
|---|---|
| Cold start | ~35 ms (stable vs data scale) |
| PK Read (Hot Cache) | 4.5M ops/s |
| Batch Insert | 588K ops/s |
| Pagination (Hot Cache) | 579K ops/s |
| ANN @ depth 1 (~91%) | 36K ops/s |
Vollständige Diagramme und alle Operationen: Benchmarks.
- Basis-Performance-Demo (basic-demo.mp4): In der GIF-Vorschau wird möglicherweise nicht alles angezeigt. Bitte öffnen Sie das Video für die vollständige Demonstration. Selbst auf normalen Mobilgeräten bleiben Start, Paging und Abruf stabil und reibungslos, selbst wenn der Datensatz 100 Millionen Datensätze überschreitet.
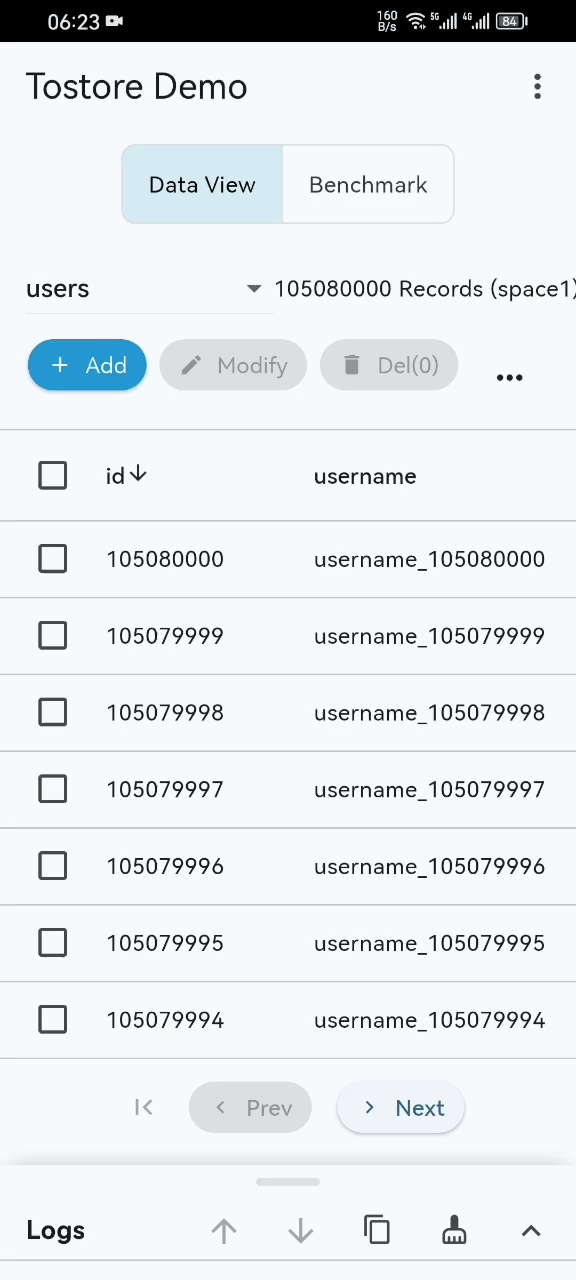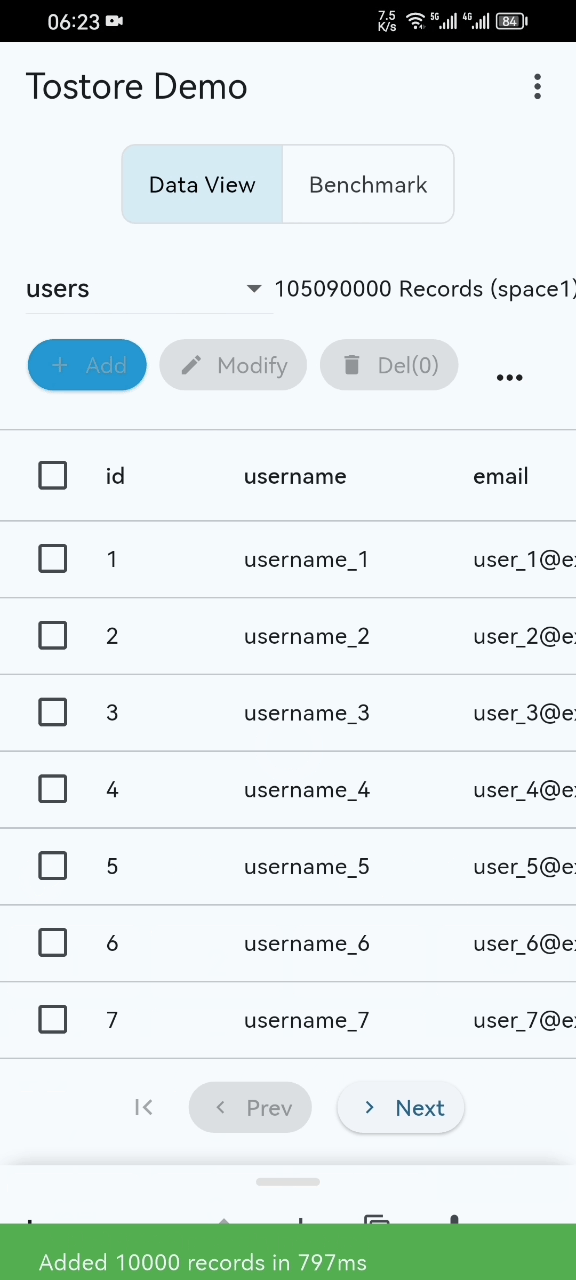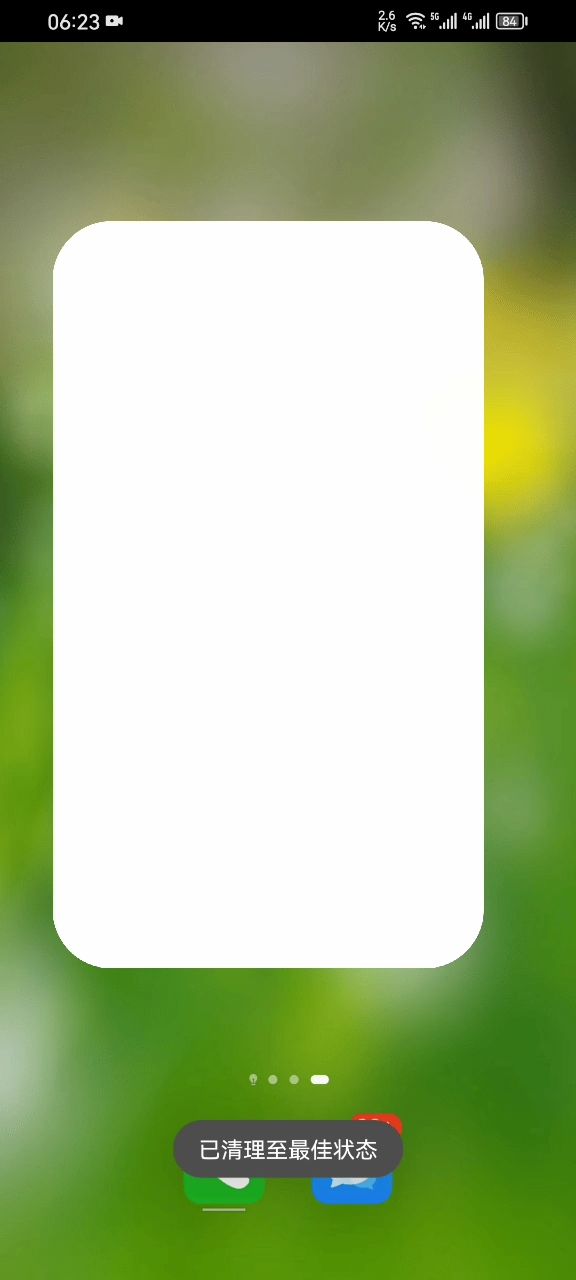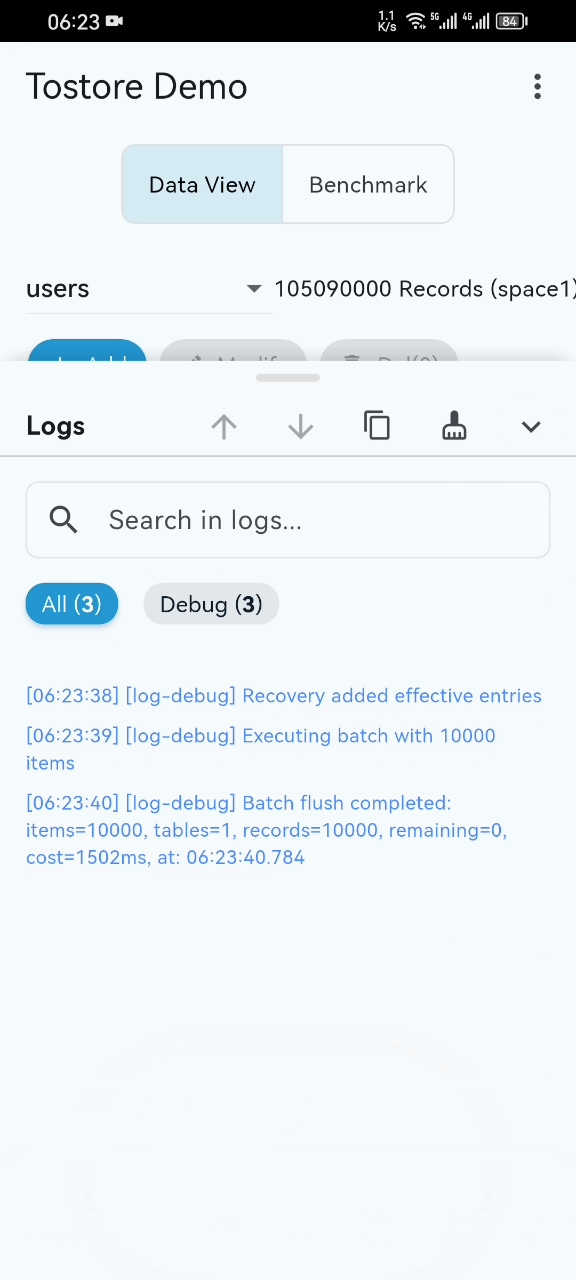
- Stresstest für die Notfallwiederherstellung (disaster-recovery.mp4): Bei hochfrequenten Schreibvorgängen wird der Vorgang absichtlich immer wieder unterbrochen, um Abstürze und Stromausfälle zu simulieren. ToStore kann sich schnell erholen.
Erlebnistipps
- 📱 Beispielprojekt: Das Verzeichnis
exampleenthält eine vollständige Flutter-Anwendung - 🚀 Produktions-Builds: Paket und Test im Release-Modus; Die Release-Leistung geht weit über den Debug-Modus hinaus
- ✅ Standardtests: Kernkompetenzen werden durch standardisierte Tests abgedeckt
Wenn ToStore Ihnen hilft, geben Sie uns bitte ein ⭐️ – das ist eine der besten Möglichkeiten, das Projekt zu unterstützen. Vielen Dank!
🤝 Mitwirken
ToStore ist eine sich stetig weiterentwickelnde moderne Daten-Engine, und wir begrüßen Community-Beiträge sehr. Ob Fehler beheben, Dokumentation verbessern, Architektur optimieren oder neue Ideen vorschlagen – Sie können über PR teilnehmen:
- 🔗 PR einreichen: Pull Requests
- 📖 Dokumentation: Wiki
- 📢 Problemberichterstattung: GitHub Issues
- 💬 Technische Diskussion: GitHub Discussions