
simplexai-labs/PolyStrata
simplexai-labs/PolyStrata has 982 GitHub stars and 133 forks. GitHot measured +22 stars in 24 hours and +148 in 7 days. Last checked 2026-11-11 05:23 UTC. Last push 2026-11-03.
So werden diese Zahlen gemessen
Führe große KI-Modelle auf deinem eigenen PC aus: Qwen3.8-Flash-Next mit der Engine von Strata sowie GLM 5.3 Flash, DeepSeek V4 Flash, LFM2.5, Qwen3.6, Ornith 1.5, Gemma 4, Tiel Coder und MiniCPM-V mit einer zweiten, für PolyStrata entwickelten Engine. Ein-Klick-Installation für Windows und Linux sowie die OpenAI-/Anthropic-API auf localhost.
Gemessener Sternzuwachs
- in 24h
- +22
- in 7 days
- +148
- in 15 days
- Aktualisierung verzögert
- in 1 month
- Aktualisierung verzögert
Nettoänderungen in überlappenden Zeiträumen, keine Tagessummen. Fehlende Messwerte bleiben leer. Sterne zeigen Interesse, nicht Qualität.
README.de.md
OriginalPolyStrata
English · 简体中文 · 日本語 · Deutsch · Français · Español · Português
Große KI-Modelle auf deinem eigenen PC
Qwen3.8-Flash-Next, GLM 5.3 Flash, DeepSeek V4 Flash, LFM2.5, Flint, Qwen3.6, Clover, Ornith 1.5, Gemma 4, Tiel Coder, MiniCPM-V und Kolibri 1 · kostenlos und Open Source
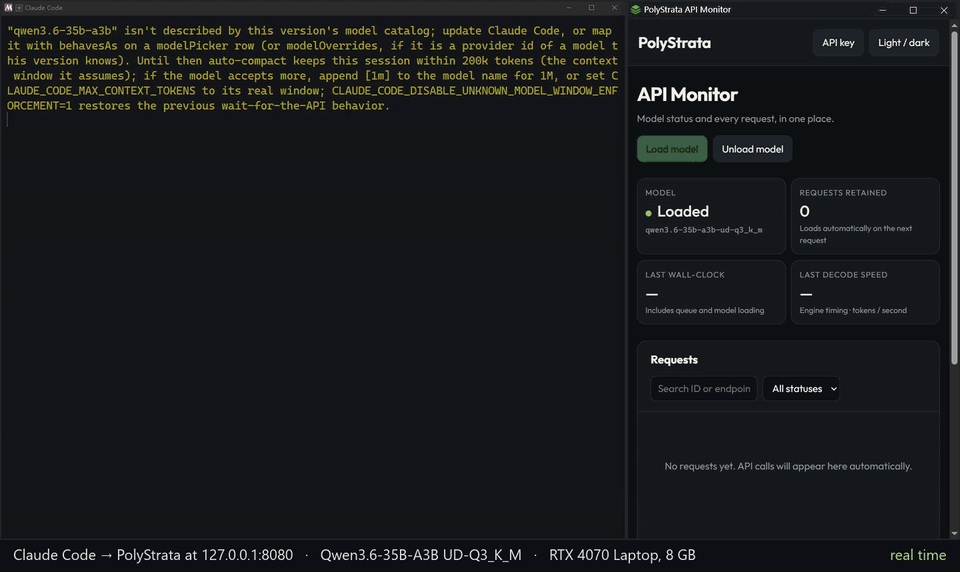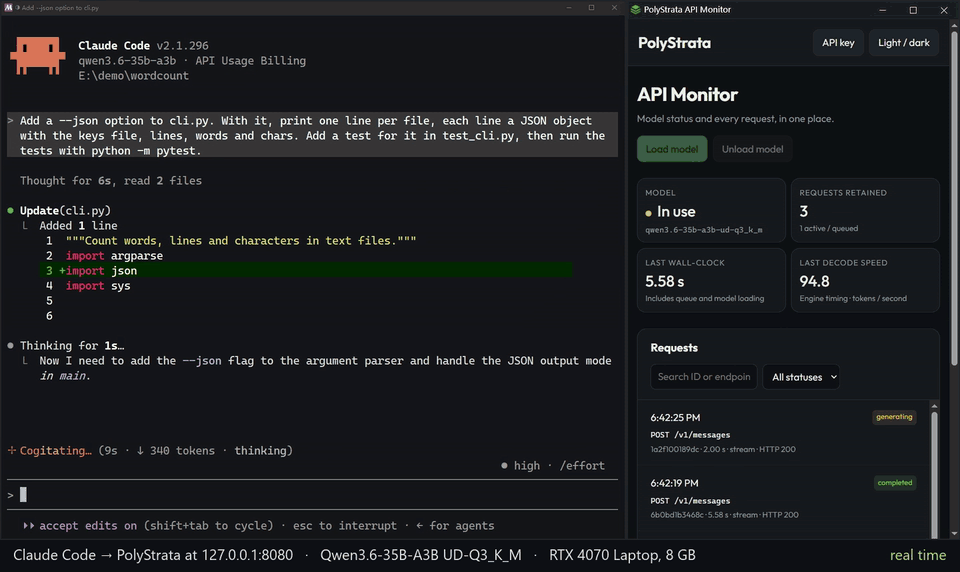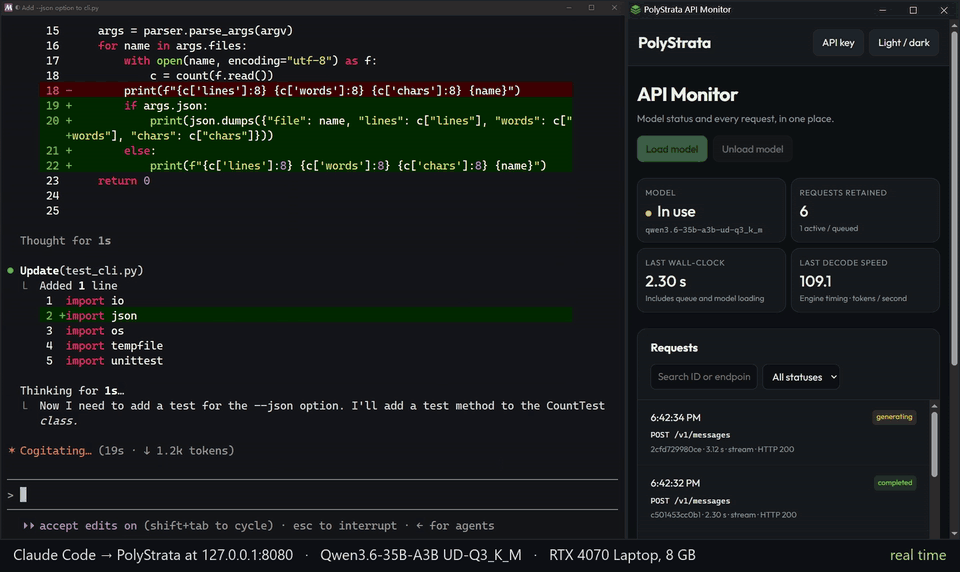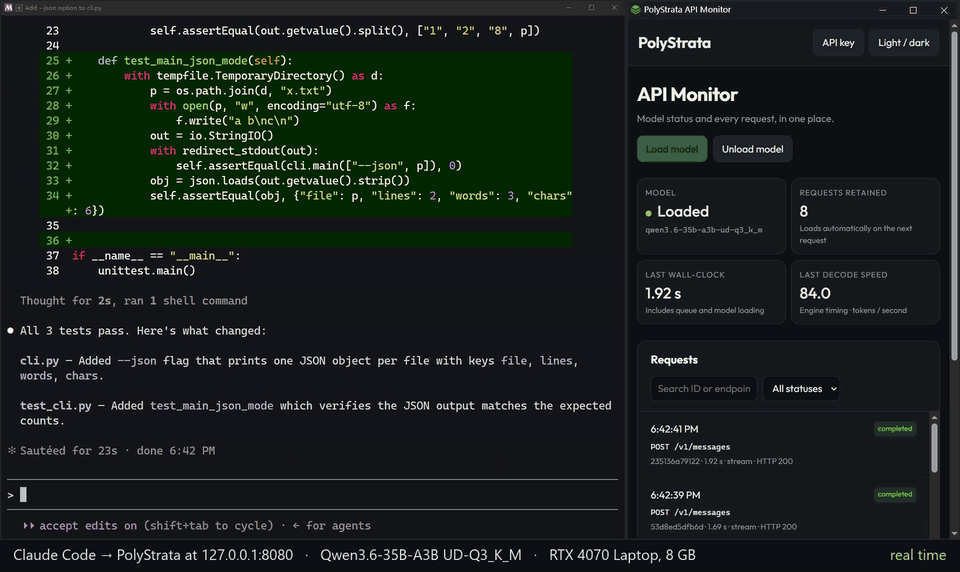
Claude Code mit Qwen3.6-35B-A3B UD-Q3_K_M auf dem Laptop mit der 8-GB-Karte, in Echtzeit: Es fügt einem kleinen Programm die Option --json hinzu, schreibt einen Test dafür und führt die Tests aus. Der Server hatte den Systemprompt von Claude Code beim Start gelesen ("warm_start": true).
Ein Voxel-Pagodengarten aus einem einzigen Prompt, auf einer RTX 5070 mit Strata (Qwen3.8-Flash-Next IQ3_S, 128K Kontext) ·
ganzes Video (49 s)
PolyStrata lässt große KI-Modelle auf einem normalen PC laufen, Modelle, die sonst meist einen Server brauchen. Sie chatten, schreiben Code und arbeiten mit deinen Apps und Coding-Agents zusammen. Nichts verlässt deinen PC.
Es lässt zwölf Modelle laufen, auf zwei Engines:
- Qwen3.8-Flash-Next auf einer NVIDIA- oder AMD-Grafikkarte ab 12 GB, unter Windows oder Linux. Es versteht auch Bilder. Seine Engine ist die von Strata, unverändert.
Die anderen elf laufen auf einer Engine, die für PolyStrata geschrieben wurde, mit einer NVIDIA-Karte oder zwei: alle elf unter Linux, alle außer GLM 5.3 Flash und DeepSeek V4 Flash auch unter Windows. Sie sind experimentell: Sie sind bisher auf einem einzigen PC mit einer 32-GB-Karte gelaufen, die acht kleineren außerdem auf einem Laptop mit einer 8-GB-Karte.
- GLM 5.3 Flash, das größte: eine Datei von 79 bis 114 GB, die zum größten Teil im RAM bleibt.
- DeepSeek V4 Flash, eine Datei von 91 GB, die ebenfalls zum größten Teil im RAM bleibt. Sein Gedächtnis für eine Unterhaltung ist klein: Ein Kontext von 128K braucht nur 0,7 GB mehr VRAM als 32K.
- LFM2.5-24B-A2B von Liquid AI, eine Datei von 11 bis 25 GB. Die meisten seiner Schichten haben keine Attention, darum braucht eine lange Unterhaltung wenig VRAM: Ein Kontext von 128K braucht nur 2 GB mehr als 32K. Seine Lizenz erlaubt die kommerzielle Nutzung nur Firmen mit weniger als 10 Millionen Dollar Jahresumsatz.
- Flint 40B-A2.5B von Recursive, gemacht für Coding-Agenten: eine Datei von 18 bis 42 GB. Die meisten seiner Schichten schauen nur 513 Tokens zurück, darum braucht eine lange Unterhaltung wenig VRAM: Ein Kontext von 128K braucht nur 2,6 GB mehr als 32K.
- Qwen3.6-35B-A3B, eine Datei von 13 bis 23 GB. Es versteht auch Bilder.
- Clover-35B-A3B-Preview von DiffuSpace, Qwen3.6-35B-A3B weiter trainiert, damit es auch einen Block von Tokens auf einmal schreibt: eine Datei von 13 bis 21 GB. Es liest nur Text.
- Ornith 1.5, mit der Architektur von Qwen3.6-35B-A3B und anderen Gewichten: eine Datei von 14 bis 24 GB. Es versteht auch Bilder.
- Gemma 4 26B-A4B, eine Datei von 11 bis 17 GB. Es versteht auch Bilder.
- Tiel Coder 35B-A3B, Ornith 1.5, von peculiar-ragdoll für Coding-Agents quantisiert: eine Datei von 14 bis 23 GB. Es versteht auch Bilder.
- MiniCPM-V 4.7 35B-A3B von OpenBMB, mit der Architektur von Qwen3.6-35B-A3B und eigenen Gewichten, gemacht, um Bilder zu lesen: eine Datei von 16 bis 29 GB.
- Kolibri 1 von Aleph Alpha, das Deutsch so gut schreibt wie Englisch: eine Datei von 29 bis 48 GB, die neben einer kleinen Karte größtenteils im RAM bleibt.
Der Server kann im laufenden Betrieb zwischen installierten Modellen wechseln (wie, englisch).
PolyStrata wurde von VecSzn erstellt. PolyStrata baut auf Strata von Niko1221 auf. Warum das ein eigenes Repo ist, AMD- und kleinere Karten, Fine-Tunes und andere Fragen: FAQ (englisch).
Wie schnell ist es?
Ein Token ist etwa ¾ eines Wortes.
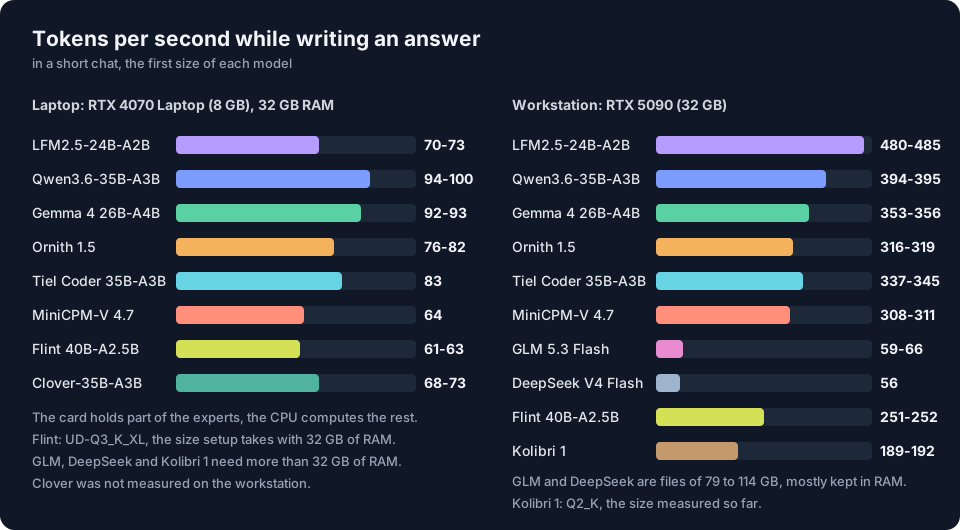
- Schreibt Antworten: wie schnell die Antwort in einem kurzen Chat erscheint. 60 Tokens pro Sekunde sind schneller, als du lesen kannst.
- Liest deinen Prompt: wie schnell es aufnimmt, was du schickst (hier ein Dokument, Code oder Chatverlauf mit 32K Tokens).
Die Tabelle zeigt für jedes Modell die Größe, die der Installer nimmt, in Tokens pro Sekunde. Die Zahlen jeder Größe, der Vergleich mit llama.cpp und wie gemessen wurde, stehen auf der Seite des Modells.
| Modell | Laptop mit 8-GB-Karte schreibt / liest |
RTX 5090 schreibt / liest |
Alle Größen |
|---|---|---|---|
| LFM2.5-24B-A2B | 70-73 / 3,590-3,620 | 480-485 / 23,390-23,460 | LFM2.5 |
| Flint 40B-A2.5B | 61-63 / 2,000-2,010 | 251-252 / 12,900 | Flint |
| Qwen3.6-35B-A3B | 94-100 / 1,690 | 394-395 / 7,800-7,810 | Qwen3.6 |
| Clover-35B-A3B-Preview | 68-73 / 1,560-1,700 | nicht gemessen | Clover |
| Ornith 1.5 | 76-82 / 1,620 | 316-319 / 8,040-8,110 | Ornith |
| Gemma 4 26B-A4B | 92-93 / 2,240 | 353-356 / 8,420-8,480 | Gemma 4 |
| Tiel Coder 35B-A3B | 83 / 1,700 | 337-345 / 8,080-8,110 | Tiel Coder |
| MiniCPM-V 4.7 35B-A3B | 64 / 1,150 | 308-311 / 7,910-7,950 | MiniCPM-V |
| Kolibri 1 | nicht gemessen | 189-192 / 4,980-5,070 | Kolibri 1 |
| GLM 5.3 Flash | läuft nicht: braucht eine 32-GB-Karte | 59-66 / 820 | GLM |
| DeepSeek V4 Flash | läuft nicht: braucht eine 32-GB-Karte | 56 / 1,040 | DeepSeek |
Laptop: RTX 4070 Laptop (8 GB), Core i7-14700HX, 32 GB RAM. Workstation: RTX 5090 (32 GB), Xeon Platinum 8470Q (25 vCPU), 90 bis 120 GB RAM. Flint ist auf dem Laptop UD-Q3_K_XL, die Größe, die der Installer bei 32 GB RAM nimmt, und auf der Workstation UD-Q4_K_XL. Kolibri 1 ist auf der Workstation Q2_K; der Installer nimmt dort Q4_K_M, das nicht gemessen wurde.
Qwen3.8-Flash-Next läuft auf der Engine des Projekts Strata und wurde von diesem Projekt auf einem PC mit RTX 5070 (12 GB) und 64 GB RAM gemessen: IQ2_XS schreibt mit 79 und liest einen 32K-Prompt mit 2,090 (alle Größen).
Die elf Modelle der eigenen Engine von PolyStrata wurden mit ihrem Benchmark gemessen, den du auch auf deinem PC
laufen lassen kannst: python polystrata.py benchmark --model <name> --prompt-tokens 24000
(was er schickt und ausgibt, englisch).
Was andere auf ihren eigenen Karten gemessen haben und wie du auf deinem PC mit llama.cpp vergleichst:
Ergebnisse aus der Community (englisch).
Auf dem Laptop las PolyStrata Prompts 2.7- bis 3.5-mal so schnell wie llama.cpp b11540 und schrieb 1.5- bis
1.8-mal so schnell, mit Qwen3.6 und mit Tiel Coder (die beiden Läufe, englisch).
Wie viel RAM es belegt
Seit 0.1.45-poly.7 belegt die Engine der elf Modelle weniger RAM: Sie hält die Teile der Modelldatei, die schon auf der Grafikkarte liegen, nicht mehr im Speicher. Auf dem Laptop belegte Qwen3.6-35B-A3B nach einem Prompt von 32,000 Tokens mit 0.1.45-poly.6 17.9 GiB, jetzt 13.1 GiB, und es schreibt genauso schnell. Unter Linux ging es von 17.8 auf 12.6 GiB.
Um weniger zu belegen, füge "--ram-experts-mib", "6144" zur "args"-Liste von strata-<model>.json hinzu
(wo) und starte neu. Die Engine hält dann so viele MiB RAM für die Experten
außerhalb des VRAM, auch während sie antwortet, und sagt das beim Start. Die übrigen bleiben im Dateicache des
Systems, wo andere Programme den Speicher nutzen können, und werden von dort gelesen, wenn ein Token sie braucht.
Standardmäßig ist das aus, weil es langsamer schreibt; wir arbeiten weiter daran. Auf dem Laptop (RTX 4070 Laptop
8 GB, 32 GB RAM, Windows 11), Qwen3.6-35B-A3B UD-Q3_K_M:
| Standard | --ram-experts-mib 6144 |
|
|---|---|---|
| RAM der Engine nach dem Laden | 11.7 GiB | 6.5 GiB |
| höchstens beim Schreiben: kurzer Chat / nach einem 32K-Prompt | 14.3 / 14.0 GiB | 6.7 / 7.3 GiB |
| zwischen Anfragen | 12.8 GiB | 7.1 GiB |
| Schreibt, Token/s: der erste kurze Chat | 71.6 | 69.4 (3 % langsamer) |
| nach dem 32K-Prompt | 65.4 | 63.7 (3 % langsamer) |
| ein kurzer Chat danach | 84.2 | 72.9 (13 % langsamer) |
| eine lange Antwort (1,024 Token eines kurzen Chats) | 90.6 | 78.3 (14 % langsamer) |
Bei dieser Messung belegten andere Programme einen Teil des VRAM, darum schreiben beide Spalten langsamer als mit freier Karte. In zwei anderen Läufen schrieb es nach dem 32K-Prompt 6 bis 8 % langsamer und im Chat danach 8 bis 10 %. Unter Linux (eine RTX PRO 6000, auf etwa 8 GB begrenzt) belegte es 7.0 bis 7.7 GiB statt 12.3 bis 14.3 und schrieb 7 bis 14 % langsamer. Mit festgehaltenem Experten-Cache, wie ein Release geprüft wird, sind die Antworten Token für Token gleich.
Zum Lesen von Prompts braucht die Engine außerdem 350 bis 400 MiB weniger VRAM: Der Expertencache nimmt sie (Qwen3.6
hält 2,712 statt 2,444 Experten im VRAM), oder --vram-reserve-mib lässt sie anderen Programmen. Wie es funktioniert
und gemessen wurde: docs/BACKENDS.md.
Was du brauchst
| Modell | Grafikkarte | RAM (Größe des Installers) | Festplatte | System |
|---|---|---|---|---|
| Qwen3.8-Flash-Next | NVIDIA RTX 20 bis 50, oder AMD RX 6800 / 6900, RX 7700 XT / 7800 XT / 7900 XT / XTX, RX 9060 XT / 9070 / 9070 XT, Radeon AI PRO R9700; ab 12 GB | ab 32 GB; mit 64 GB laufen alle Größen | etwa 80 GB | Windows, Linux |
| GLM 5.3 Flash | NVIDIA RTX 20 oder neuer; nur auf einer 32-GB-Karte gelaufen | 96 GB neben einer 32-GB-Karte | 79 bis 114 GB, auf einer SSD | Linux |
| DeepSeek V4 Flash | wie oben | 72 GB neben einer 32-GB-Karte | 91 GB, auf einer SSD | Linux |
| LFM2.5-24B-A2B | NVIDIA RTX 20 oder neuer, ab 8 GB | etwa 20 GB neben einer 8-GB-Karte | 11 bis 25 GB | Windows, Linux |
| Flint 40B-A2.5B | wie oben | etwa 22 GB neben einer 8-GB-Karte | 18 bis 42 GB | Windows, Linux |
| Qwen3.6-35B-A3B | wie oben; AMD als Beta | etwa 21 GB neben einer 8-GB-Karte | 13 bis 23 GB | Windows, Linux |
| Clover-35B-A3B-Preview | NVIDIA RTX 20 oder neuer, 8 GB oder mehr | etwa 20 GB neben einer 8-GB-Karte | 13 bis 21 GB | Windows, Linux |
| Ornith 1.5 | wie oben; AMD als Beta | etwa 22 GB neben einer 8-GB-Karte | 14 bis 24 GB | Windows, Linux |
| Gemma 4 26B-A4B | wie oben; AMD als Beta | etwa 18 GB neben einer 8-GB-Karte | 11 bis 17 GB | Windows, Linux |
| Tiel Coder 35B-A3B | wie oben; AMD als Beta | etwa 21 GB neben einer 8-GB-Karte | 14 bis 23 GB | Windows, Linux |
| MiniCPM-V 4.7 35B-A3B | wie oben; AMD als Beta | etwa 25 GB neben einer 8-GB-Karte | 16 bis 29 GB | Windows, Linux |
| Kolibri 1 | NVIDIA RTX 20 oder neuer, ab 8 GB | etwa 33 GB neben einer 8-GB-Karte | 29 bis 48 GB | Windows, Linux |
Der RAM ist die Schätzung des Installers; eine größere Karte braucht weniger. Alles andere richtet der Installer ein: Unter Windows lädt er die Engine fertig gebaut herunter und kompiliert sie nur auf einem Prozessor ohne AVX2 oder wenn die Engine deiner Kopie neuer als das letzte Release ist; fehlende Werkzeuge bietet er an. Zwei oder drei Karten können sich ein Modell teilen (Multi-GPU). Ältere Grafikkarten, Intel Arc, Strix Halo und ältere Prozessoren ohne AVX2: die ganze Liste. Karte, RAM und Größen jedes Modells im Detail stehen auf seiner Seite.
Was Qwen3.6, Clover, Ornith 1.5, Gemma 4, Tiel Coder und MiniCPM-V jeweils brauchen und wie es geprüft wurde: docs/BACKENDS.md (englisch).
Installieren
Lass deine KI es einrichten
Nutzt du einen KI-Coding-Assistenten (Claude Code, Cursor, Codex, GitHub Copilot, ...)? Füge dort diesen Text ein:
Set up PolyStrata on this PC for me: https://github.com/simplexai-labs/PolyStrata - follow docs/AI_SETUP.md in that repository.
Er prüft deine Grafikkarte, deinen RAM und deine Festplatte und wählt das passende Modell. Dann installiert und startet er es und sagt dir, wie du deine Apps verbindest. KI-Tools können PolyStrata auch über seinen MCP-Server installieren, starten und stoppen.
Oder mach es selbst
Lade PolyStrata herunter und entpacke es (oder nutze
git clone). Windows: Doppelklick auf START-HERE.bat. Linux: Führe im PolyStrata-Ordner ./setup.sh aus.
Mac (Apple Silicon, M1 bis M5, macOS 15 oder neuer): Installiere einmal Apples Command Line Tools (xcode-select --install im Terminal; Xcode selbst brauchst du nicht). Öffne dann das Terminal im PolyStrata-Ordner und führe ./setup.sh aus. Es baut die Mac-Engine auf deinem Mac (etwa 7 Minuten), stellt dieselben Fragen, lädt das Modell und startet es. Beim nächsten Mal startet ./setup.sh sofort. Welche Größe zu deinem Mac passt und wie schnell es ist: docs/MAC.md. Die Mac-Engine läuft nur mit Qwen3.8-Flash-Next; die anderen elf Modelle brauchen eine NVIDIA- oder AMD-Karte.
Die Schritte sind für NVIDIA und AMD gleich. Der Installer erkennt deine Karte und richtet die passende Engine dafür ein. Er stellt dir ein paar Fragen:
- welches Modell und welche Größe,
- wie viel Kontext (wie viel Text sich das Modell merkt),
- ob es Bilder lesen soll (GLM 5.3 Flash, DeepSeek V4 Flash, LFM2.5, Flint, Clover und Kolibri 1 lesen keine).
Drück jedes Mal Enter, um die empfohlene Antwort zu nehmen. Dann lädt er das Modell herunter (etwa 70 GB für
Qwen3.8-Flash-Next, 79 bis 114 GB für GLM 5.3 Flash, 91 GB für DeepSeek V4 Flash, 29 bis 48 GB für Kolibri 1, 11 bis 42 GB für die anderen acht) und
startet es. Bricht der Download ab, starte ihn einfach neu: Er macht dort weiter, wo er aufgehört hat. Dein Browser
öffnet die PolyStrata-App unter http://127.0.0.1:8080.
Alle zwölf stehen in der Modellliste des Installers. ./setup.sh --family glm, deepseek, lfm25, flint, qwen36, clover, ornith,
gemma4, tiel, minicpmv oder kolibri führt direkt zu einem davon (was er fragt und schreibt, englisch).
Während das Modell startet, kann dein PC 1-3 Minuten langsam sein oder nicht reagieren (beim ersten Mal am längsten). PolyStrata lädt 35-55 GB in deinen RAM und reserviert einen Teil davon für die Grafikkarte. Das ist normal. Warte und schließ das Fenster nicht. Im Fenster siehst du, was PolyStrata gerade tut.
Beim nächsten Mal startest du wieder START-HERE.bat (oder ./setup.sh). Es startet sofort und lädt nichts
doppelt herunter. Schließ das Fenster, um das Modell zu stoppen. UPDATE.bat (./update.sh) aktualisiert PolyStrata,
ohne es zu starten. Updates, Docker, mehrere Karten, wo die Dateien landen und alle Optionen:
docs/INSTALL.md.
Läuft es auf deinem PC schnell? Starte BENCH.bat (./bench.sh): etwa 5-10 Minuten; es misst Chat, 4K/16K-Prompts und eine Sitzung im Agenten-Stil mit deinen eigenen Einstellungen und schreibt einen Bericht zum Teilen (wie).
Welches Modell soll ich nehmen?
Dasselbe Modell gibt es in mehreren Größen, mehr oder weniger komprimiert: Kleinere sind schneller und brauchen weniger RAM, größere sind näher am Original. Der Installer nimmt eine passende für deinen RAM und deine Karte, wenn du Enter drückst; für eine andere Größe gib bei der Installation --model <Größe> an.
| Modell | Der Installer nimmt | Mit weniger RAM | Nur mit Namen |
|---|---|---|---|
| Qwen3.8-Flash-Next | 32 GB RAM: Coder; 48 bis 64 GB: IQ2_XS; ab 96 GB: IQ3_S | Q2_0, IQ3_XXS, Unsloths 4- bis 8-Bit-Dateien | |
| GLM 5.3 Flash | 3.0BIT | UD-IQ2_XXS, dann REAP50-Q3_K_M | |
| DeepSeek V4 Flash | UD-IQ2_XXS (die einzige Größe) | ||
| LFM2.5-24B-A2B | UD-Q4_K_XL | UD-Q3_K_XL | QAD-Q4_0, UD-Q6_K_XL, Q8_0 |
| Flint 40B-A2.5B | UD-Q4_K_XL ab etwa 40 GB RAM | UD-Q3_K_XL | UD-Q6_K_XL, Q8_0 |
| Qwen3.6-35B-A3B | UD-Q3_K_M | UD-Q2_K_XL | UD-Q4_K_M |
| Clover-35B-A3B-Preview | Q3_K_M | APEX-I-NANOPLUS | Q4_K_M |
| Ornith 1.5 | APEX-I-COMPACT | APEX-I-MINI | APEX-I-QUALITY |
| Gemma 4 26B-A4B | UD-Q3_K_M | UD-Q2_K_XL | UD-Q4_K_M, QAT-UD-Q4_K_XL |
| Tiel Coder 35B-A3B | UD-Q3_K_XL | UD-IQ3_XXS | UD-Q4_K_XL |
| MiniCPM-V 4.7 35B-A3B | Q4_K_M | mix_q3gud_im | Q6_K |
| Kolibri 1 | Q4_K_M ab etwa 48 GB RAM | Q2_K | Q3_K_M |
Was jede Größe ist, ihr Download, der RAM neben anderen Karten und wie nah sie an die größte kommt: die Seite jedes Modells, verlinkt in der Tabelle unter „Wie schnell ist es?“.
So benutzt du es
Alle zwölf Modelle benutzt du gleich: dieselbe App, dieselbe API.
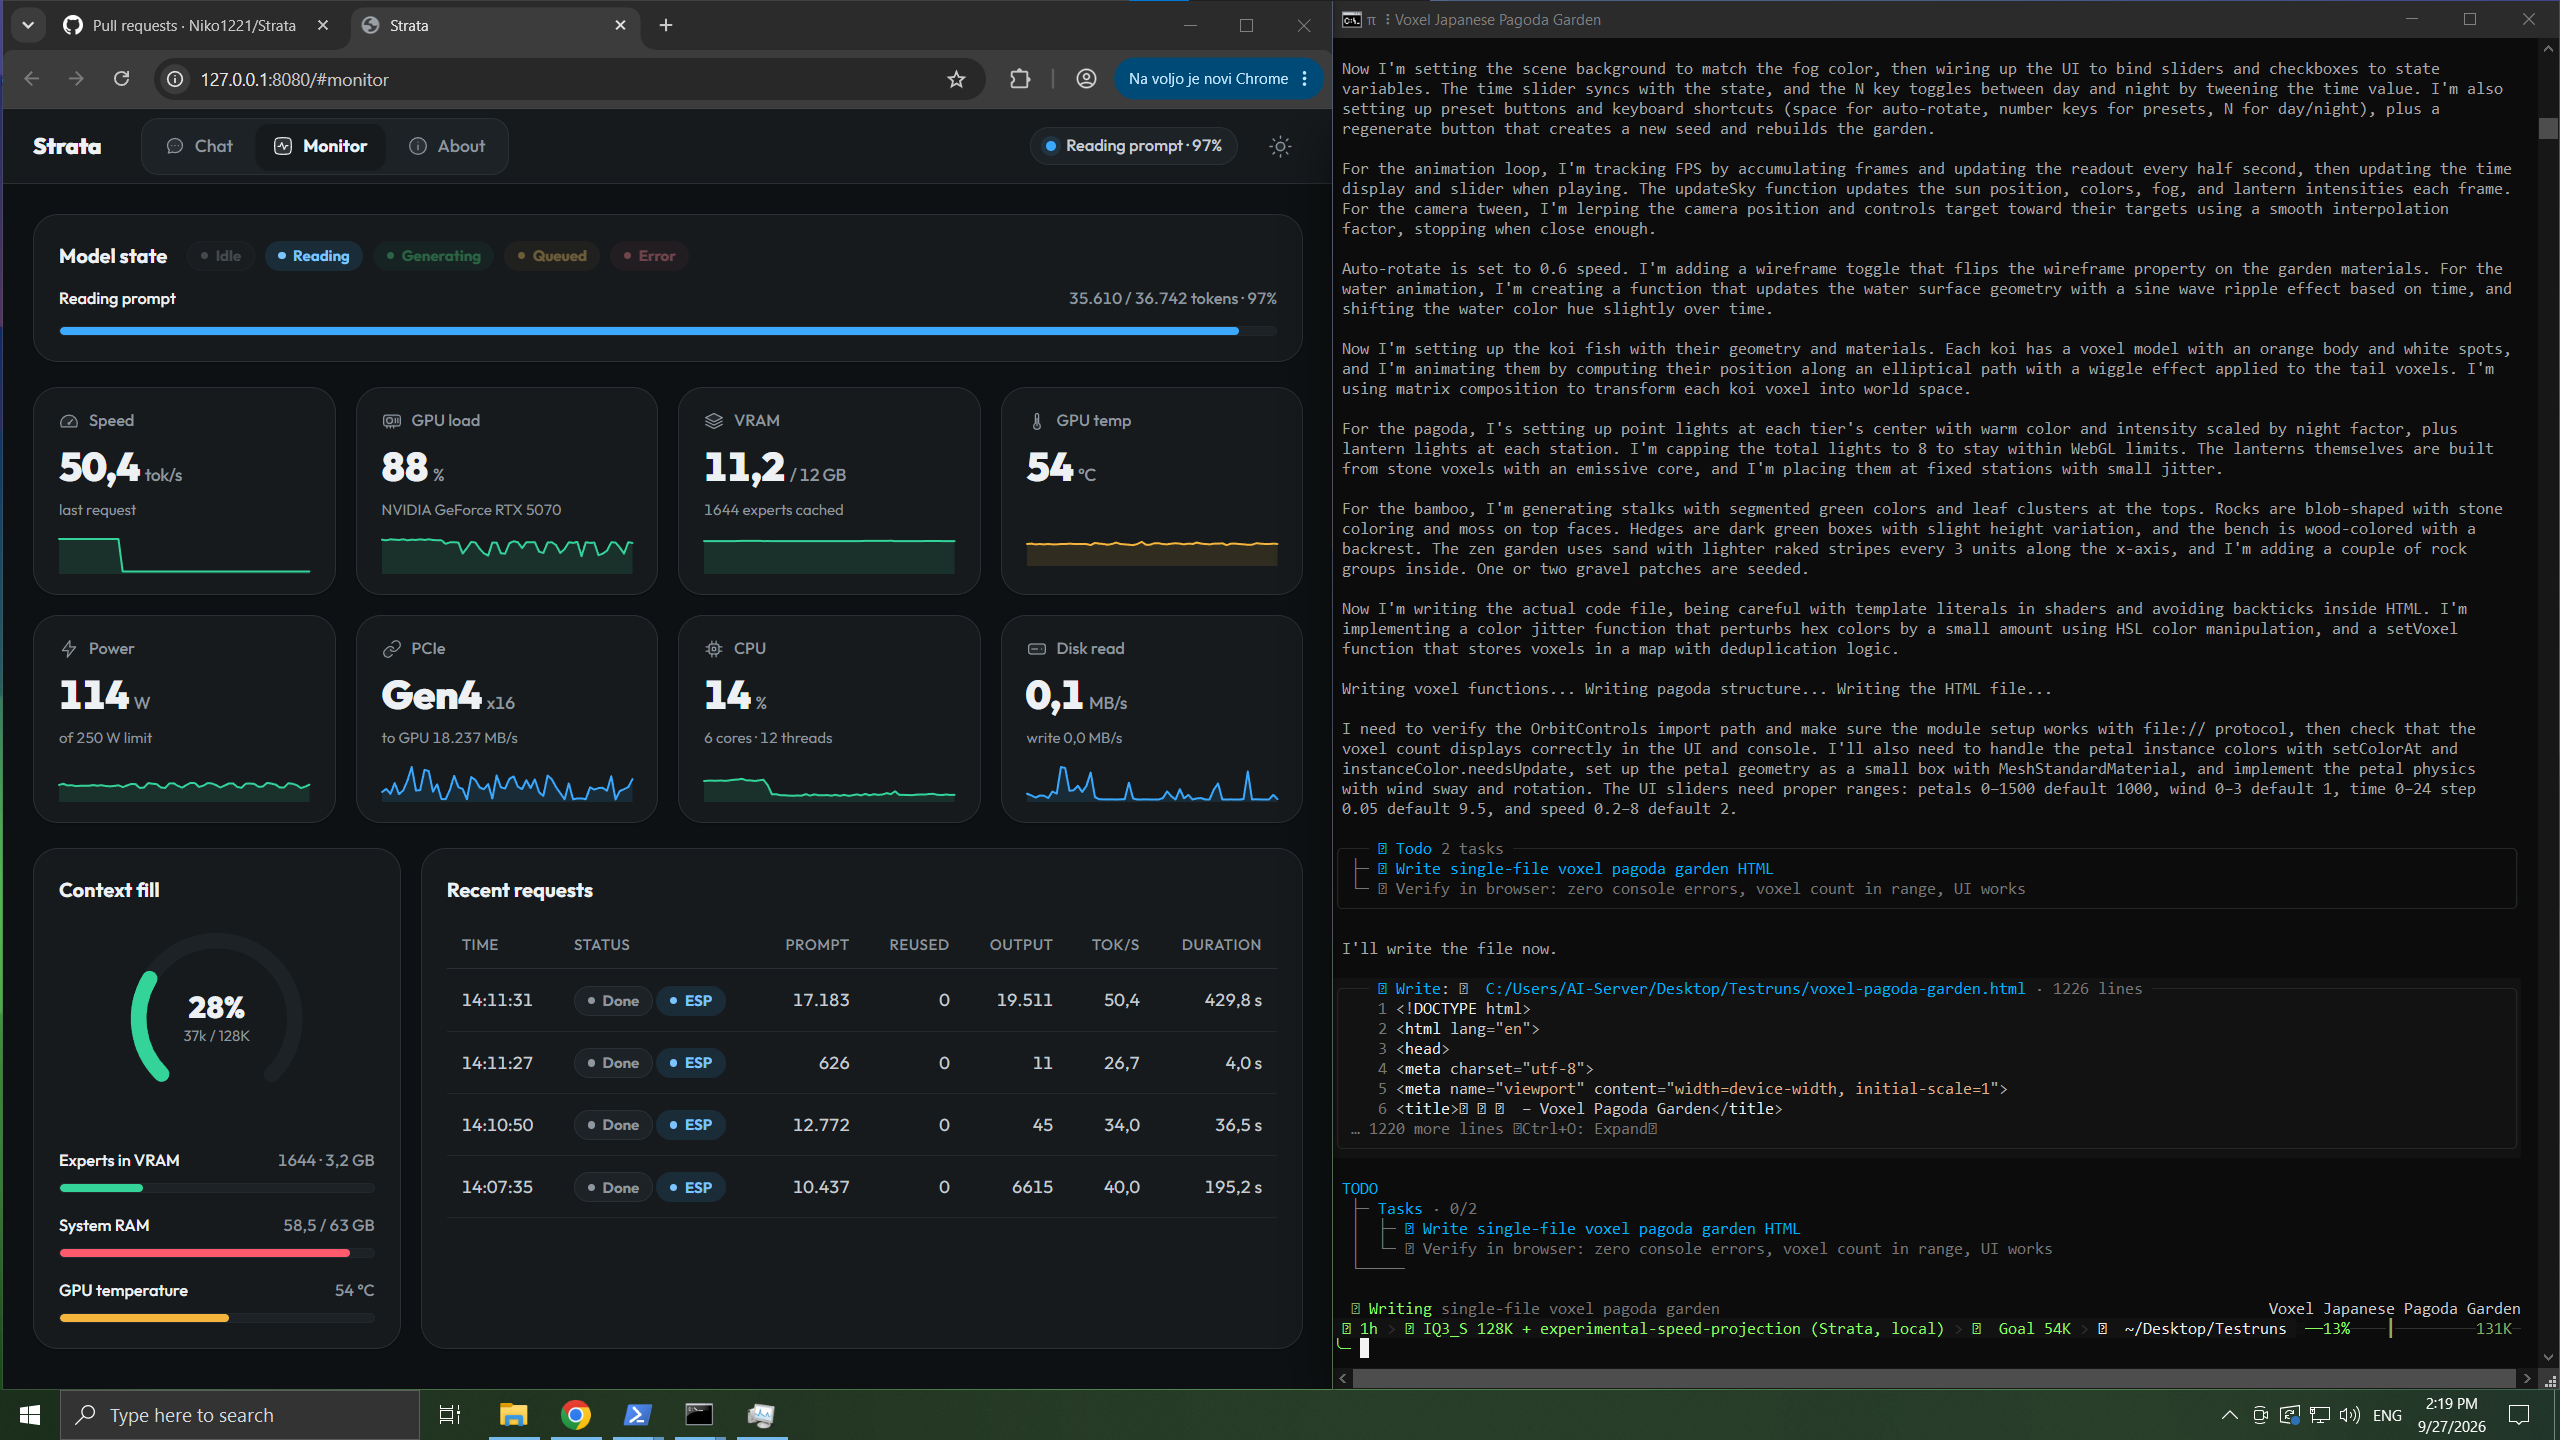
Der Monitor der PolyStrata-App (links), während ein Coding-Agent den Pagodengarten aus dem Video schreibt (rechts). Ein Screenshot aus Strata.
- Im Browser: Öffne
http://127.0.0.1:8080. Dort gibt es Chat, einen Live-Monitor für das Modell und deine GPU/CPU/RAM und About mit den Einstellungen und Adressen. - Deine Apps und Coding-Agents: Füge einen „OpenAI-kompatiblen“ Anbieter mit der Basis-URL
http://127.0.0.1:8080/v1hinzu. Jeder API-Key und jeder Modellname funktioniert.- Apps, die die API von Anthropic nutzen:
http://127.0.0.1:8080/v1/messages(Claude Code:ANTHROPIC_BASE_URL=http://127.0.0.1:8080, dazu"fit_max_tokens": trueinstrata-<model>.json(warum)). - Codex CLI und andere Apps, die die OpenAI Responses API nutzen:
/v1/responses(Einrichtung).
- Apps, die die API von Anthropic nutzen:
- Nachdenken: Wähle aus, niedrig, mittel oder hoch im Chat-Menü oder unter „Reasoning Effort“ in deiner App. Aus ist am schnellsten. Hoch ist am besten für schwierige Fragen.
- Vom Handy oder einem anderen PC:
START-HERE.bat --setup --host 0.0.0.0 --api-key <secret>. Setz immer einen Key.
Wo sie sich unterscheiden:
| Qwen3.8-Flash-Next | GLM 5.3 Flash | DeepSeek V4 Flash | LFM2.5-24B-A2B | Flint 40B-A2.5B | Kolibri 1 | Qwen3.6-35B-A3B, Clover-35B-A3B-Preview, Ornith 1.5, Gemma 4 26B-A4B, Tiel Coder 35B-A3B, MiniCPM-V 4.7 35B-A3B | |
|---|---|---|---|---|---|---|---|
| Bilder | Antworte im Setup mit Ja auf „Images?“. Klick dann im Chat auf Picture oder hänge Bilder in deiner App an. AMD-Karten lesen Bilder unter Linux über den Prozessor; unter Windows geht das noch nicht. | Noch nicht. | Es liest nur Text. | Es liest nur Text. | Es liest nur Text. | Es liest nur Text. | Antworte im Setup mit Ja auf „Images?“, dann wie bei Qwen3.8-Flash-Next. Auf einer Karte mit weniger als 16 GB läuft der Bild-Encoder auf dem Prozessor, und ein Bild dauert ein paar Sekunden. Clover liest nur Text. |
| Eine Anfrage nach der anderen | Standardmäßig beantwortet PolyStrata eine Anfrage, die anderen warten. Um mehrere gleichzeitig zu beantworten, setz "parallel": 2 (BATCHING.md). Auf einer 12-GB-Karte wird dadurch jede Antwort langsamer. |
Eine nach der anderen, die anderen warten. | Eine nach der anderen, die anderen warten. | Eine nach der anderen, die anderen warten. | Eine nach der anderen, die anderen warten. | Eine nach der anderen, die anderen warten. | Eine nach der anderen, die anderen warten. |
| Mehrere Unterhaltungen | Die letzte bleibt erhalten, Folgenachrichten starten also in Sekunden. Zwei Engine-Argumente halten mehrere im RAM (Details). | Die letzte bleibt erhalten. Das Setup fragt, ob mehrere im RAM bleiben sollen, damit ein Agent und seine Subagenten sich abwechseln, ohne dass ihre Prompts neu gelesen werden (wie). | Wie GLM 5.3 Flash. | Wie GLM 5.3 Flash. | Wie GLM 5.3 Flash. | Wie GLM 5.3 Flash. | Wie GLM 5.3 Flash. |
| Lange Prompts | PolyStrata liest die erste Nachricht eines Chats komplett, etwa 1 Minute pro 30,000 Tokens. Folgenachrichten starten in Sekunden. | Die erste Nachricht wird komplett gelesen, etwa 40 Sekunden pro 30,000 Tokens. | Die erste Nachricht wird komplett gelesen, etwa 29 Sekunden pro 30,000 Tokens. | Die erste Nachricht wird komplett gelesen: 30,000 Tokens brauchen 1,3 bis 1,5 Sekunden auf der Workstation und 8 bis 10 Sekunden auf dem 8-GB-Laptop. | Die erste Nachricht wird komplett gelesen: 30,000 Tokens brauchen etwa 2,3 Sekunden auf der Workstation und 15 bis 22 Sekunden auf dem 8-GB-Laptop. | Die erste Nachricht wird komplett gelesen: 30,000 Tokens brauchen auf der Workstation mit Q2_K etwa 6 Sekunden. | Die erste Nachricht wird ganz gelesen: 30,000 Tokens dauern auf der Workstation 4 bis 5 Sekunden und auf dem 8-GB-Laptop 14 bis 27 Sekunden. |
Mehr: wo deine Chats gespeichert werden, die API.
Optional: mehr Tempo mit einer Grafikkarte, wenn das ganze Modell in den RAM passt
Zwei Opt-in-Einstellungen (von RubenTorney, #1904 und #1905). Sie helfen, wenn du eine Grafikkarte nutzt und dein RAM alle Experten hält (Stratas Arena-Modus, zum Beispiel Q2_0 oder IQ3_XXS auf einem PC mit 64 GB). Öffne deine Konfiguration strata-<model>.json im PolyStrata-Datenordner (wo) und füge hinzu:
- Schnellere Ausgabe:
"--adapt-async", "1"in die Liste"args". Der Experten-Cache wird dann in einem Hilfs-Thread aktualisiert, statt die Antwort anzuhalten. Gemessen auf einer RTX 5070 (Windows, Q2_0): +4-5 % Ausgabe, +7-10 % bei Code und langen Dokumenten. Antworten können leicht vom Standard abweichen (sie bleiben von Lauf zu Lauf gleich). - Schnelleres Prompt-Lesen unter Windows:
"STRATA_PIN_BY_NEED": "1"im Block"env". Windows kann nur etwa den halben RAM für die Grafikkarte sperren; damit werden zuerst die Experten gesperrt, die die Karte wirklich braucht. Gemessen auf der RTX 5070: +4,4 % Prompt-Lesen.
"args": [ ..., "--adapt-async", "1" ],
"env": { "STRATA_PIN_BY_NEED": "1" }
Starte PolyStrata danach neu (START-HERE.bat oder ./setup.sh). Zum Rückgängigmachen entferne die beiden Einträge.
Etwas ist schiefgelaufen?
- Mein PC ist beim ersten Start von PolyStrata eingefroren. Das ist normal, während das Modell lädt. Warte und schließ das Fenster nicht. Nach 10 Minuten immer noch eingefroren? Starte den PC neu, schließ andere Programme und versuch es noch einmal, oder nimm eine kleinere Größe.
- Es hat beim Herunterladen oder Installieren aufgehört. Starte
START-HERE.bat(oder./setup.sh) noch einmal. Es macht dort weiter, wo es aufgehört hat. - Es ist sehr langsam und die Festplattenlampe blinkt ständig, oder es meldet „the engine stopped unexpectedly“. Dein PC hat nicht genug freien RAM. Schließ andere Programme (Browser brauchen viel) oder nimm eine kleinere Größe (Q2_0 oder IQ2_XS).
- Es meldet, dass Port 8080 schon belegt ist. PolyStrata läuft bereits. Such nach seinem Fenster.
Weitere Probleme und ihre Lösungen: docs/TROUBLESHOOTING.md. Kommst du nicht weiter?
Öffne ein Issue und hänge strata-<model>.log aus dem PolyStrata-Ordner
an. Du hast ein Sicherheitsproblem gefunden? Melde es vertraulich: SECURITY.md.
Wie funktioniert es?
Modelle wie dieses laufen normalerweise auf Servern mit Hunderten Gigabyte Grafikspeicher. Deine Grafikkarte hat 8-32 GB. PolyStrata bringt das Modell trotzdem unter, indem es die Arbeit auf deinen ganzen PC verteilt. Stell dir eine Küche vor: Was du ständig brauchst, bleibt auf der Arbeitsfläche, der Rest wartet in der Vorratskammer.
Bild und Erklärung für jedes Modell: docs/HOW_IT_WORKS_MODELS.de.md.
Danksagung und Lizenz
Qwen3.8-Flash-Next ist vom Qwen-Team. Komprimiert wurde es von ISTA-DASLab, UkisAI (Swift 1.5) und Unsloth. GLM 5.3 Flash läuft aus den Dateien von neuralll, Unsloth und patrickbdevaney. Qwen3.6-35B-A3B ist vom Qwen-Team, Gemma 4 von Google und DeepSeek V4 Flash von DeepSeek, alle drei in der Quantisierung von Unsloth. LFM2.5-24B-A2B ist von Liquid AI, in der Quantisierung von Unsloth und in Liquid AIs eigenem QAD-Q4_0. Flint 40B-A2.5B ist von Recursive, in der Quantisierung von Unsloth. Kolibri 1 ist von Aleph Alpha, in der GGUF-Umwandlung von Hob-forge. Clover-35B-A3B-Preview ist von DiffuSpace, in der Quantisierung von maternion und IsValorums APEX. Ornith 1.5 ist von ornith-ai, in der APEX-Quantisierung von mudler. Tiel Coder 35B-A3B ist Ornith 1.5 in der Quantisierung von peculiar-ragdoll; u/Sensitive_Song4219 hat herausgefunden, dass es auf PolyStrata läuft. MiniCPM-V 4.7 35B-A3B ist von OpenBMB, in ihrer eigenen Quantisierung; iMilnb hat es zu PolyStrata gebracht. PolyStrata baut auf Strata von Niko1221 und seinen Mitwirkenden auf und nutzt Teile von llama.cpp / ggml. Alle Danksagungen: docs/HOW_IT_WORKS.md. PolyStrata ist Open Source unter der MIT-Lizenz. Ein paar Teile und alle Modelle haben eigene Lizenzen (welche).
Ähnliche Projekte entdecken
affaan-m/ECC
System zur Leistungsoptimierung für das Ausführungs- und Steuerungsframework von Agenten. Es bietet Skills, Instinkte, Memory, Sicherheit und forschungsorientierte Entwicklung für Claude Code, Codex, Opencode, Cursor und darüber hinaus.
301,241 SterneNousResearch/hermes-agent
Der Agent, der mit dir wächst
262,687 Sternemultica-ai/andrej-karpathy-skills
Eine einzelne CLAUDE.md-Datei zur Verbesserung des Verhaltens von Claude Code, abgeleitet aus Andrej Karpathys Beobachtungen zu Fallstricken beim Programmieren mit LLMs.
232,167 Sternefirecrawl/firecrawl
Stärke deine KI-Agenten mit Daten aus dem Web und darüber hinaus. Wir bauen die Bibliothek für Superintelligenz. 🔥
200,444 Sterne