
openmake/openmake_llm
openmake/openmake_llm has 45 GitHub stars and 7 forks. Star changes are not measured yet. Last checked 2026-11-09 15:53 UTC. Last push 2026-11-08.
So werden diese Zahlen gemessen
Open-source, self-hosted AI workspace for local and open-weight LLMs with vLLM, LiteLLM, autonomous agents, MCP tools, deep research, artifacts, and BYOK.
What you can do
- Research a topic across several search sources and get a cited report you can export to PDF or DOCX.
- Chat with a local model while a separate vision model reads the images you attach.
- Ask for an image, a voice reading, or a transcript — each request goes to the model assigned to that capability.
- Hand an agent a goal — it plans, browses, edits files, runs code in a Docker sandbox, and stops for approval before risky steps.
Gemessener Sternzuwachs
- in 24h
- Aktualisierung verzögert
- in 7 days
- Aktualisierung verzögert
- in 15 days
- Aktualisierung verzögert
- in 1 month
- Aktualisierung verzögert
Nettoänderungen in überlappenden Zeiträumen, keine Tagessummen. Fehlende Messwerte bleiben leer. Sterne zeigen Interesse, nicht Qualität.
README.de.md
OriginalOpenMake
Open-Source-KI-Workspace und Agent-Runtime für lokale, Open-Weight- und OpenAI-kompatible Modelle.
OpenMake koordiniert spezialisierte Modelle, Agenten, MCP-Tools, Recherche und Sandbox-Ausführung
in einem einzigen selbst gehosteten Workspace.
Live-Demo · Dokumentation · Roadmap · Engineering Log
Local-first · Self-hosted · Multi-model · Agents · MCP · BYOK


English · 한국어 · 日本語 · 简体中文 · Deutsch
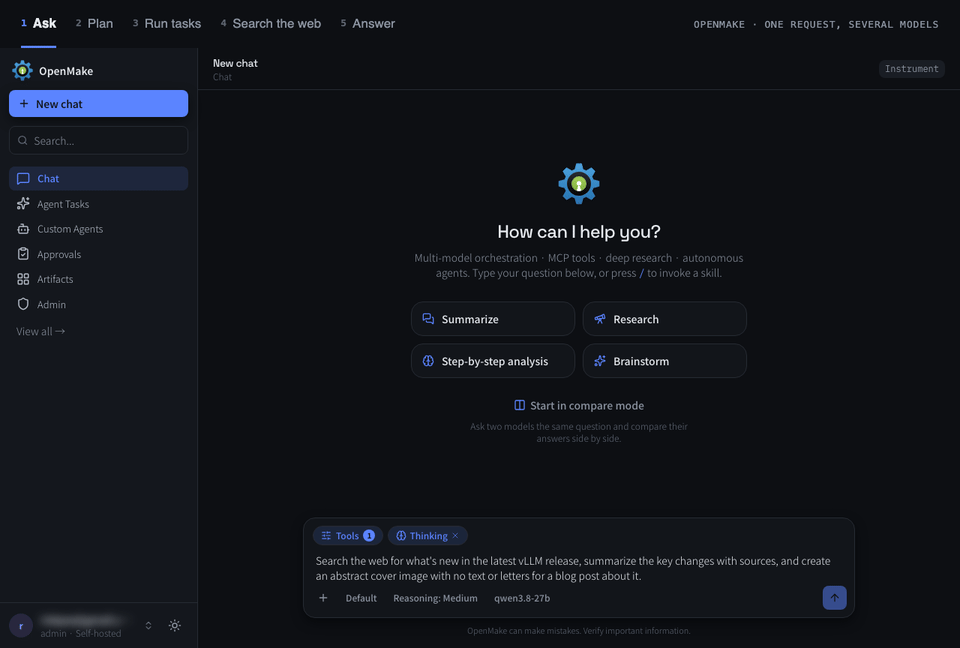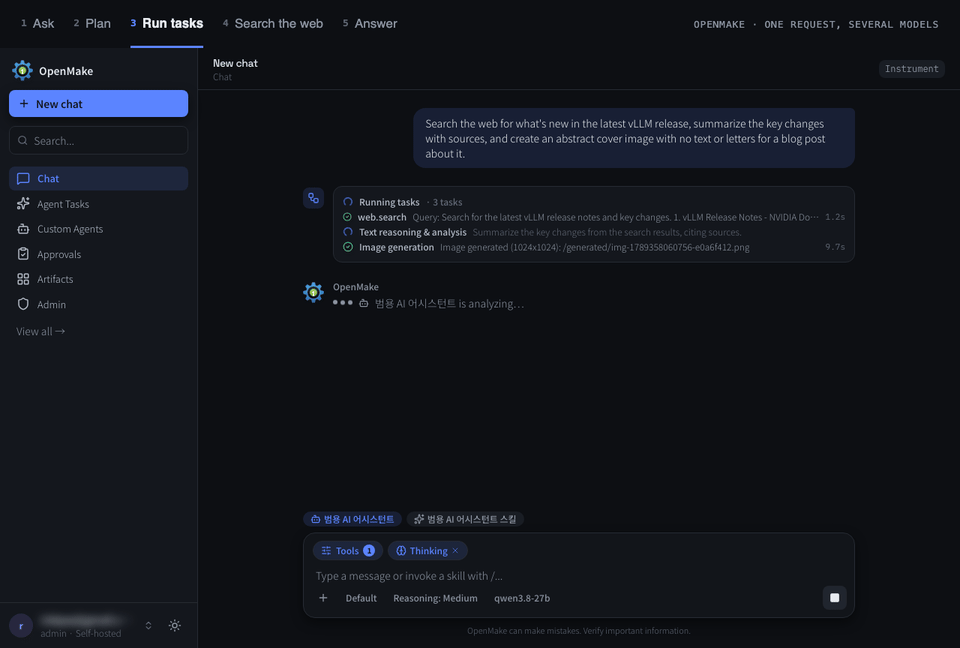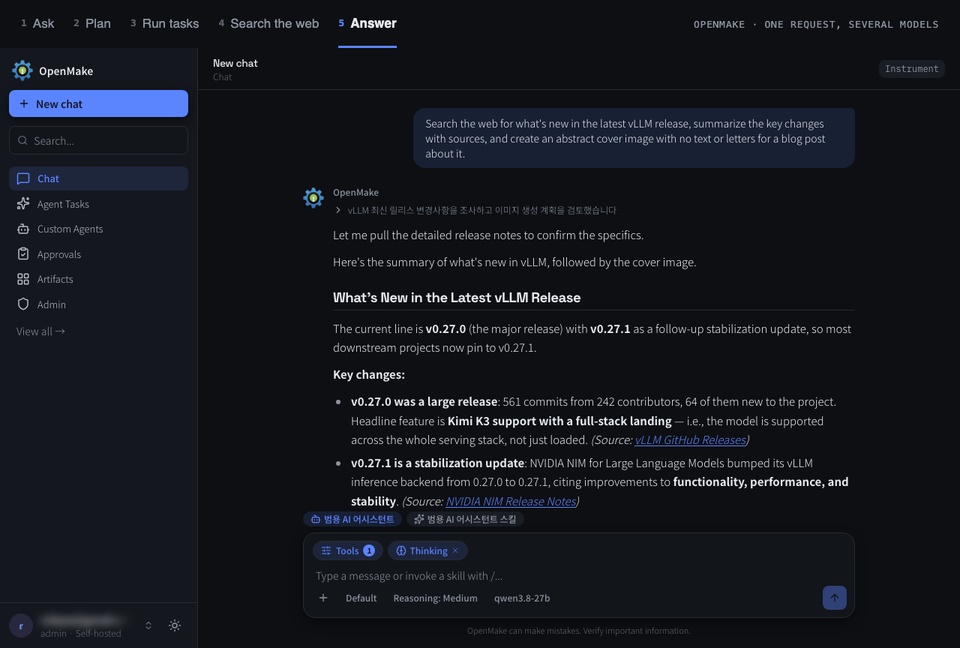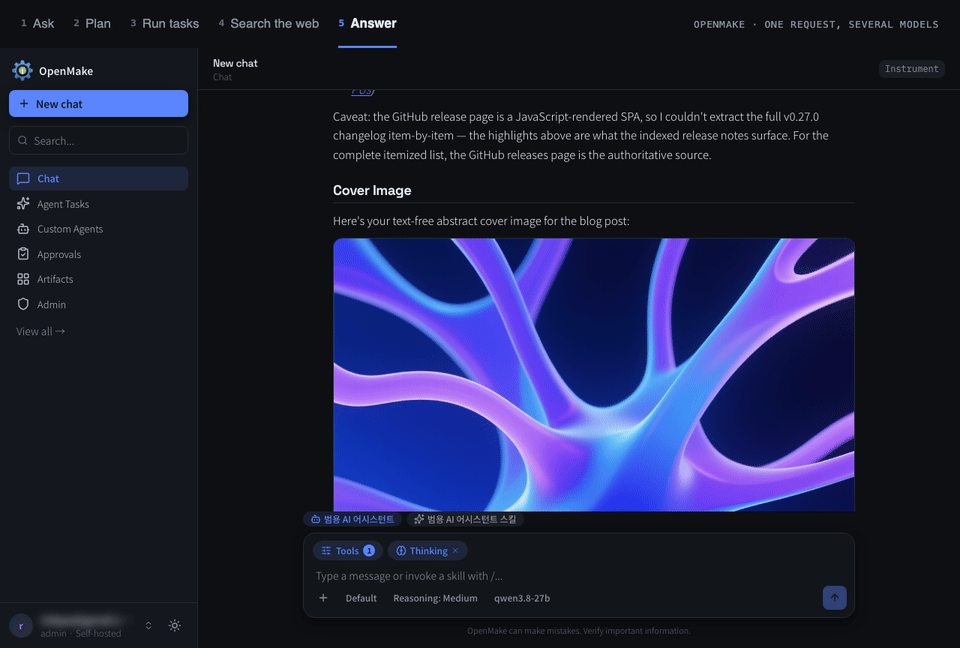
Eine Anfrage, mehrere Modelle: Der Planner führt eine Websuche, eine Reasoning-Aufgabe und eine Bilderzeugung aus; das Chat-Modell prüft die Quellen und antwortet mit Belegen und dem erzeugten Bild. Aufgenommen in der laufenden App (beschleunigt).
Dieses Dokument ist eine deutsche Übersetzung der englischen README.md. Bei Abweichungen gelten die englische Fassung und der Code. Die verlinkten Seiten auf openmake.cc sind auf Englisch.
Schnellstart
curl -fsSL https://raw.githubusercontent.com/openmake/openmake_llm/main/install.sh | bash
Auf einem frischen Rechner richtet das Installationsskript die Voraussetzungen und den kompletten Stack ein (siehe unten). Mit bash -s -- --minimal installiert es nur die App: Es prüft die Toolchain (Node.js 24, Docker, PM2), schreibt eine .env mit frisch erzeugten Secrets, startet PostgreSQL und Redis, baut OpenMake, startet es unter PM2 und führt einen Health-Check aus.
Öffnen Sie anschließend die ausgegebene URL, melden Sie sich als Administrator an und verbinden Sie ein Modell — einen lokalen vLLM- oder Ollama-Server oder einen beliebigen OpenAI-kompatiblen Endpunkt.
Läuft unter Linux und macOS (Windows: in WSL2). Manuelle Einrichtung, Optionen, Updates und Hinweise zum Reverse Proxy stehen im Self-Hosting-Leitfaden.
Der Einzeiler übergibt an das Installationsskript Ihres Betriebssystems — install_linux.sh unter Linux/WSL2, install_mac.sh unter macOS. Auf einem frischen Rechner stellt es seine Fragen einmal vorab und richtet dann die Voraussetzungen (macOS: Xcode Command Line Tools, Homebrew, Colima (Docker) · Linux: Distributionspakete, Docker Engine) und den kompletten Stack über scripts/env/omk.sh ein: LiteLLM-Gateway, SearXNG, Sandbox-Images, internes HTTPS, Backups und Autostart nach einem Neustart. Für eine Installation ohne Rückfragen geben Sie auch das Modell-Backend an: --yes --dgx-host <host> --vllm-api-key <key> oder --yes --llm-provider <name> --llm-model <id> --llm-api-key <key>.
Warum OpenMake?
Die meisten selbst gehosteten KI-Oberflächen helfen Ihnen, mit einem Modell zu sprechen. OpenMake ist darauf ausgelegt, Modelle, Tools und Agenten so zu koordinieren, dass sie die Arbeit erledigen — auf Infrastruktur, die Sie kontrollieren, und mit nachvollziehbaren Einzelschritten.
| Projekt | Hauptaufgabe |
|---|---|
| Ollama / vLLM | Modelle ausführen |
| Open WebUI | Modelle über eine selbst gehostete Oberfläche nutzen |
| Dify | KI-Apps und Workflows bauen |
| OpenHands | Agenten für die Softwareentwicklung |
| OpenMake | Modelle, Agenten und Tools für allgemeine KI-Arbeit koordinieren |
Diese Projekte liegen auf unterschiedlichen Ebenen und schließen sich nicht aus: OpenMake stellt lokale Modelle über vLLM bereit und kann einen Ollama-Server als Modell-Endpunkt nutzen.
Funktionsweise
flowchart TB
    R["Ihre Anfrage"] --> O["OpenMake<br/>planen · routen · freigeben"]
    O --> M["Modelle<br/>Text · Vision · Bild · Sprache · Embedding"]
    O --> A["Agenten<br/>Aufgaben · Sub-Agenten · Recherche"]
    O --> T["Tools<br/>MCP · Browser · Dateien · Code-Sandbox"]
    M --> X["Antwort · Code · Bericht · Artefakt"]
    A --> X
    T --> X
Eine einfache Frage geht direkt an Ihr Chat-Modell. Eine Anfrage, die mehr braucht — ein Bild, eine Transkription, eine Websuche, eine mehrstufige Aufgabe —, wird in Aufgaben zerlegt, die auf den von Ihnen zugewiesenen Modellen und Tools laufen; Ihr Chat-Modell schreibt aus den Ergebnissen die endgültige Antwort.
Sie wählen die Modelle. OpenMake koordiniert, wie sie zusammenarbeiten.
Was Sie damit tun können
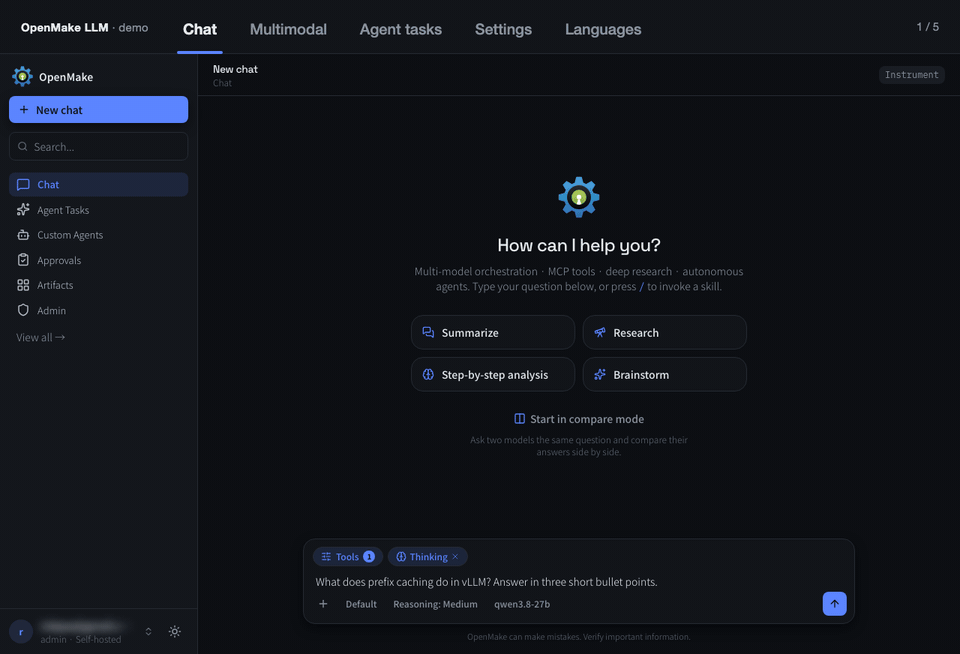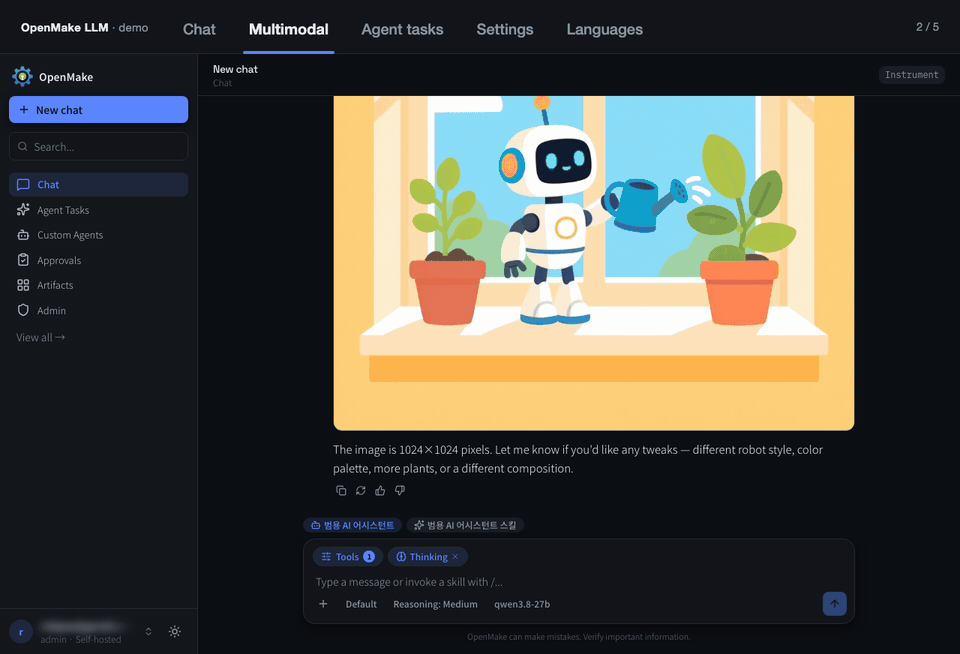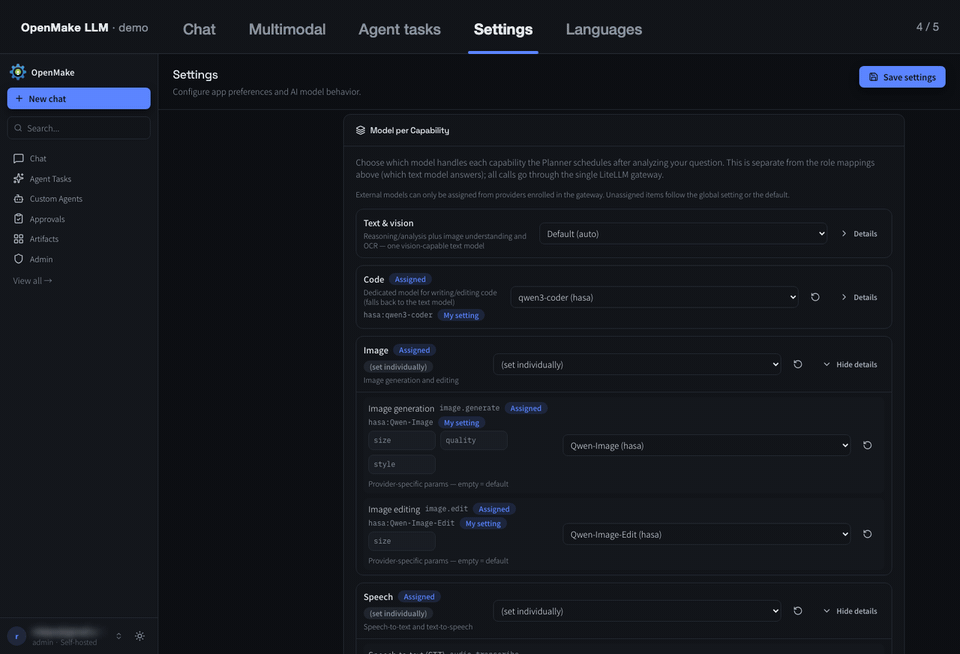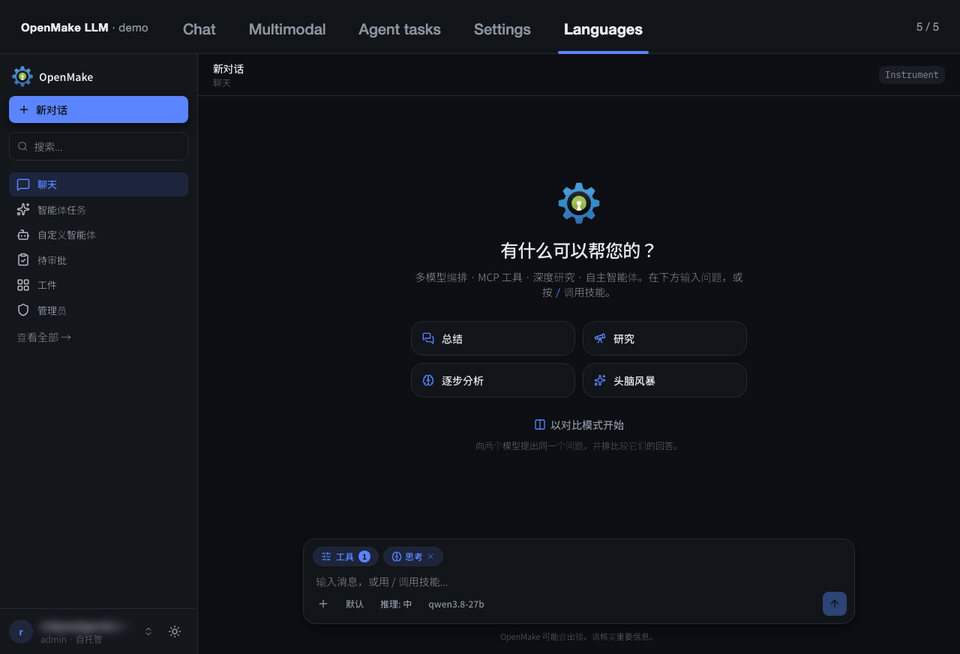
- Ein Thema recherchieren — über mehrere Suchquellen hinweg, mit einem Bericht samt Quellenangaben, der sich als PDF oder DOCX exportieren lässt.
- Mit einem lokalen Modell chatten, während ein separates Vision-Modell die angehängten Bilder liest.
- Ein Bild, eine Sprachausgabe oder eine Transkription anfordern — jede Anfrage geht an das Modell, das dieser Fähigkeit zugewiesen ist.
- Einem Agenten ein Ziel übergeben — er plant, recherchiert im Web, bearbeitet Dateien, führt Code in einer Docker-Sandbox aus und wartet vor riskanten Schritten auf eine Freigabe.
- Externe Dienste über MCP anbinden (Notion, Context7, Tavily, NotebookLM und weitere) oder Plugins und Skills im Claude-Code-Format installieren.
- Agentenarbeit in einem Ordner auf Ihrem eigenen Rechner ausführen — mit der App OpenMake Companion oder der OpenMake Code CLI.
| Bereich | Umfang |
|---|---|
| Modelle | vLLM + LiteLLM-Gateway, Ollama oder beliebiger OpenAI-kompatibler Endpunkt, BYOK-Anbieter, Login mit ChatGPT-Abo |
| Orchestrierung | Planner, Modellrollen, Modelle pro Fähigkeit, parallele Fähigkeitsaufgaben |
| Agenten | Mehrstufige Aufgaben, Sub-Agenten, Freigaben, Zeitpläne, Vorlagen, lokale Ausführung |
| Recherche & Tools | Deep Research, 23 integrierte Tools, MCP-Katalog, Skills, Erweiterungen |
| Ergebnisse | Gestreamte Antworten, Artefakte, HTML/PDF/DOCX-Berichte, Dateien, generierte Medien |
Die Anleitung nach Aufgaben steht im Benutzerhandbuch.
Modelle & Routing
OpenMake verlangt nicht, dass ein einziges Modell alles erledigt.
OpenMake
 ├── LiteLLM-Gateway (OpenAI-kompatibel)
 │    ├── vLLM ─────────── Ihre lokalen / Open-Weight-Modelle
 │    └── BYOK-Anbieter ── OpenRouter · NVIDIA NIM · Ollama Cloud · Open AI Service Hub · B.AI
 ├── Direkt ────────────── Login mit ChatGPT-Abo
 └── Spezialisierte Modelle, pro Fähigkeit zugewiesen
      ├── Text & Code
      ├── Vision & OCR
      ├── Bilderzeugung & -bearbeitung
      ├── Spracherkennung · Sprachausgabe · Video
      └── Embedding
- Modellrollen — wählen Sie ein Modell für
agent,judge,research,spawn,review,summaryundplanner. Nutzer wählen ihre eigenen; Administratoren legen Standards fest und können Server-Schlüssel mit täglichen und monatlichen Token-Budgets freigeben. - Modell pro Fähigkeit — weisen Sie das Modell zu, das Vision, Bilderzeugung, Sprache, Video und Code übernimmt. Fähigkeiten ohne Zuweisung werden als nicht verfügbar gemeldet, statt stillschweigend auf ein anderes Modell auszuweichen.
- Eigene Schlüssel (BYOK) — Anbieter-Schlüssel werden AES-256-GCM-verschlüsselt gespeichert und pro Anfrage über das Gateway übergeben. Rate-Limits, fehlendes Guthaben und eingeschränkte Modelle werden als solche gemeldet, nicht als allgemeiner Upstream-Fehler.
- Kontext-Schutz — Prompts (einschließlich Bildern) werden mit dem Kontextfenster des Modells abgeglichen; zu große Eingaben werden vor dem Aufruf gekürzt, und eine unerfüllbare Anfrage liefert
413mit einem Audit-Eintrag. - Automatische Modellerkennung — Modelle hinter dem Gateway werden beim Start erkannt, sodass ein Modellwechsel auf dem Inferenz-Host keine Codeänderung erfordert.
- Vergleichsmodus — denselben Prompt an zwei Modelle senden und die Antworten nebeneinander lesen.
Agent-Runtime
Eine Agentenaufgabe verfolgt ein Ziel über viele Runden mit Tool-Aufrufen. Agenten können:
- den Aufgabenzustand über Runden hinweg halten, mit einem Checkpoint am Ende jeder Runde
- Tools unter einer Freigaberichtlinie nutzen — manuell, automatisch oder übersprungen
- mit angehängten Dateien arbeiten und Ergebnisse wie Excel- und PDF-Dateien erstellen
- Shell- und Python-Code in einem isolierten Docker-Workspace ausführen
- aus einem separaten Browser-Container mit Egress-Allowlist im Web recherchieren
- unabhängige Arbeit auf parallele Sub-Agenten verteilen
- über einen Ziel-Prüfer nicht erreicht melden, statt fälschlich „erledigt“
Heute verfügbar
- ✓ Persistente Aufgaben mit Pausieren, Fortsetzen, Abbrechen und Wiederherstellung nach einem Serverneustart
- ✓ Ein Freigaben-Postfach für Agentenschritte, Skills, Erweiterungen und MCP-Server
- ✓ Vorlagen, geplante Ausführungen und teilbare Aufgabenergebnisse
- ✓ Lokale Ausführung über OpenMake Companion (macOS) oder die OpenMake Code CLI — mit Pfadbegrenzung, Bestätigung für Befehle und Isolation per Git-Worktree
Opt-in — diese Funktionen sind standardmäßig deaktiviert. Aktivieren Sie sie in der .env:
| Einstellung | Aktiviert | Voraussetzung |
|---|---|---|
TASK_SANDBOX_ENABLED=true |
Persistenter Docker-Workspace pro Aufgabe | Zuerst infra/mcp-runtime, dann infra/task-runtime bauen |
LOCAL_EXECUTOR_ENABLED=true |
Tool-Aufrufe auf dem Rechner eines Nutzers | OpenMake Companion oder CLI mit einem API-Schlüssel mit bridge-Scope |
AGENT_TASK_QUEUE_ENABLED=true |
Globale Limits und Limits pro Nutzer für parallele Aufgaben | — |
docker build -t openmake-mcp-runtime:latest infra/mcp-runtime
docker build -t openmake-task-runtime:latest infra/task-runtime
Geplant
- ○ Ausführungsgraph — Planknoten, die ihre Abhängigkeiten, Berechtigungen, Wiederholungen und Abschlusskriterien selbst tragen. Heute ist der gespeicherte Plan eine flache Liste von Schritten.
- ○ Deklarative Policy-Engine — serverseitig erzwungene Berechtigungsstufen über die heutige Freigabe hinaus.
- ○ Dauerhaftigkeit innerhalb einer Runde — ein Journal pro Tool-Aufruf, damit eine unterbrochene Runde sicher wiederholt werden kann.
- ○ Begrenzter Speicher — Arbeits-, episodisches und semantisches Gedächtnis mit Quelle und Ablaufdatum.
Recherche, Tools & Artefakte
Deep Research — zerlegt eine Frage in Unterthemen, durchsucht sie parallel, liest die Quellen, fasst sie abschnittsweise zusammen und schreibt einen Bericht mit Quellenangaben. Wikipedia, Google News und DuckDuckGo funktionieren ohne Schlüssel; SearXNG, Google Custom Search, Naver und Kakao erweitern die Abdeckung, sobald sie konfiguriert sind.
Integrierte Tools — 23 Tools für Websuche und Faktenprüfung, Seitenextraktion und Crawling, Bildanalyse und OCR, Planung, Code- und Sicherheitsreview, das Laden von Skills sowie Git-Importe. Die meisten Tools werden nur in Runden angeboten, die sie brauchen — so bleiben Prompts klein.
MCP — installieren Sie Server aus dem Katalog (Tavily, Context7, Notion, NotebookLM, Kakao Map, OpenDART und weitere) oder registrieren Sie eigene. Jeder stdio-Server kann in einem eigenen Docker-Container laufen — mit entzogenen Capabilities, Nicht-Root-Nutzer und optional schreibgeschütztem Dateisystem; Remote-Server melden sich per OAuth an.
Skills & Erweiterungen — installieren Sie Plugins, Skills, eigene Agenten und MCP-Server aus Git, einem Zip-Archiv oder einem Marketplace. Claude-Code-Konventionen — Tool-Namen, $ARGUMENTS, commands/, agents/, mitgelieferte Skripte — werden bei der Installation angepasst, und alles, was eine Prüfung braucht, landet im Freigaben-Postfach.
Artefakte — Antworten lassen sich als Live-Vorschau in einer Sandbox darstellen; Berichtsanfragen werden zu HTML-Artefakten, die als PDF und DOCX exportiert werden können, und ein Viewer auf separatem Origin liefert geteilte Artefakte aus.
Integrationen — eine OpenAI-kompatible API (/api/v1/chat/completions) mit API-Schlüsseln und Scopes, ein Discord-Gateway-Bot und OpenMake Bench, um Modelle vor der Zuweisung zu vergleichen.
Architektur
flowchart TB
    subgraph clients["Clients"]
        WEB["Web-App · Next.js"]
        NATIVE["Companion (macOS) · Code CLI"]
        APIC["OpenAI-kompatible API · Discord-Bot"]
    end
    clients -->|"REST · WebSocket"| API["API-Server · Express 5 + TypeScript"]
    API --> PIPE["Nachrichten-Pipeline<br/>Auth · Richtlinien · Prompt- & Tool-Aufbau"]
    PIPE --> PLAN["Planner"]
    PLAN --> CAP["Fähigkeitsaufgaben"]
    PIPE --> AGT["Agent-Runtime<br/>Aufgaben · Freigaben · Checkpoints"]
    PIPE --> TOOLS["Tools · MCP"]
    CAP --> LLM["LLMClient<br/>Kontext-Schutz"]
    AGT --> LLM
    TOOLS --> LLM
    LLM --> GW["LiteLLM-Gateway"]
    GW --> VLLM["vLLM · lokale Modelle"]
    GW --> EXT["BYOK-Anbieter"]
    API --- PG[("PostgreSQL")]
    API --- RD[("Redis")]
    AGT --- SB["Docker-Sandboxes<br/>Aufgaben · MCP · Artefakte"]
    TOOLS --- SB
- Ein Ausführungspfad — lokale und externe Modelle teilen sich dasselbe Streaming-Dispatch und dieselbe Tool-Schleife. Diskussion und Deep Research sind eigene Modi, die vor dem Dispatch abzweigen.
- Planner → Fähigkeiten → Zusammenführung — ein
simple-Plan verursacht keinen zusätzlichen Modellaufruf. Einmulti-Plan wird vorab geprüft (Zuweisungen, Schlüsselstatus, Kontingente), seine Aufgaben laufen nach Abhängigkeitsebenen parallel, und nur erfolgreich erzeugte Medien werden an die Antwort angehängt. - Modellauflösung — jedes Subsystem, das ein Modell aufruft, bestimmt es über eine Rolle oder Fähigkeit: Nutzereinstellung → Administrator-Standard → eingebauter Standard.
- Robustes Streaming — wenn ein Browser-Tab in den Hintergrund geht oder die Verbindung abbricht, läuft die Generierung weiter, und der Client verbindet sich wieder mit derselben Antwort.
- Single-Host-Design — die Anwendung läuft unter PM2; PostgreSQL, Redis und alle Sandboxes laufen in Docker.
| Ebene | Technologien |
|---|---|
| Backend | Node.js 24, Express 5, TypeScript (strict), Zod, Winston |
| Frontend | Next.js 16, React 19, Zustand, Tailwind CSS 4, next-intl (ko · en · ja · zh · de) |
| Daten | PostgreSQL über rohes, parametrisiertes SQL (kein ORM), Redis |
| LLM | vLLM, LiteLLM-Gateway, openai SDK |
| Agenten & Tools | Model Context Protocol Client v2, Docker-isolierte Sandboxes |
| Native Clients | SwiftUI (macOS Companion, iOS in Arbeit), Node-CLI — gemeinsam packages/local-bridge-core |
Designprinzipien
Ein Modell aufzurufen ist einfach. KI zuverlässig zu betreiben ist es nicht. Schwierig sind: Zustand halten, Berechtigungen durchsetzen, sicher ausführen, sich von Fehlern erholen und belegen, was passiert ist. Darauf ist OpenMake ausgerichtet:
- Zustand — Aufgaben, Schritte und Checkpoints werden persistiert, sodass Arbeit einen Neustart übersteht.
- Berechtigungen — RBAC, API-Schlüssel mit Scopes, Freigaberichtlinien und Schutz von Zugangsdaten-Dateien bei Agenten-Tools.
- Isolation — Agentencode, MCP-Server und Artefakte laufen in Docker mit begrenzten Capabilities, Speicher und Netzwerk.
- Wiederherstellung — klare Fehlergründe, Wiederholungen bei vorübergehenden Fehlern und fortsetzbare Aufgaben.
- Nachvollziehbarkeit — ein Audit-Log mit Alarmierung sowie ein Verlauf jeder Aufgabe auf Schrittebene.
- Wenige Zusatzaufrufe vor der Antwort — das Modell wählt Tools in derselben Runde statt über einen separaten Klassifikator; die verbleibenden Aufrufe vor der Antwort (der Planner und das LLM-Agenten-Routing) werden gemessen und laufend überprüft.
Deployment
Ein Referenz-Deployment besteht aus einem Anwendungs-Host und einem Inferenz-Host:
Application host                                   Inference host (GPU)
┌──────────────────────────────────────────┐       ┌──────────────────────┐
│ PM2: API · web                           │       │ vLLM                 │
│ Docker: PostgreSQL · Redis · sandboxes   │ ────► │ chat · embedding ·   │
│ LiteLLM gateway (OpenAI-compatible)      │       │ image models         │
└──────────────────────────────────────────┘       └──────────────────────┘
Alles kann auch auf einem einzigen Rechner laufen, oder der Modell-Endpunkt ist ein gehosteter Anbieter.
Der tägliche Betrieb läuft über openmake_llm.sh:
./openmake_llm.sh start     # PostgreSQL → Redis → App, danach Logs anzeigen
./openmake_llm.sh status    # Ports, Container und PM2-Status
./openmake_llm.sh update    # git pull (nur Fast-Forward) → Build → Migration → Neustart
./openmake_llm.sh deploy    # Build → Migration → Neustart (mit OMK_LITELLM_CONFIG in .env auch DGX-Modellnamen abgleichen)
./openmake_llm.sh stop
Das Installationsskript schreibt eine funktionsfähige .env. Das Wichtigste:
| Variable | Zweck |
|---|---|
LLM_BASE_URL · LLM_API_KEY · LLM_DEFAULT_MODEL |
OpenAI-kompatibler Modell-Endpunkt |
LLM_GATEWAY_PROVIDERS |
BYOK-Anbieter, die über das Gateway geroutet werden |
DATABASE_URL · REDIS_URL |
Datenspeicher |
JWT_SECRET · API_KEY_PEPPER · TOKEN_ENCRYPTION_KEY |
Secrets (werden beim ersten Start erzeugt, falls sie fehlen) |
.env.example ist die vollständige Referenz, und viele Betriebseinstellungen lassen sich zur Laufzeit unter Admin → Systemeinstellungen ändern. Datenbankmigrationen werden beim Start automatisch angewendet. Für eine öffentliche Adresse übergeben Sie dem Installationsskript --public-url https://chat.example.com; eine Caddy-Konfiguration liegt unter scripts/caddy/.
Entwicklung
git clone https://github.com/openmake/openmake_llm.git
cd openmake_llm
npm install

npm run dev                 # API + Web
npm test                    # gemeinsame Pakete bauen, dann Jest-Unit-Tests
npm run test:e2e            # Playwright (chromium + webkit)
npm run lint                # ESLint
apps/
├── api/             Express-5-API — Chat-Pipeline, Orchestrator, Agenten, MCP, Daten
├── web/             Next.js-Web-App
├── cli/             OpenMake Code — Local-Bridge-CLI
├── desktop-native/  OpenMake Companion — SwiftUI-Menüleisten-App (macOS)
├── ios/             SwiftUI-iOS-Client (in Arbeit)
└── discord-bot/     Discord-Gateway-Bot
packages/            gemeinsame Typen, API-Verträge, Konfiguration, API-Client, Local-Bridge-Kern
db/                  Basisschema und Migrationen
infra/               Docker-Images und Compose-Dateien für Sandboxes und Datenspeicher
Roadmap
| Aktuell — verfügbar | Als Nächstes | Später |
|---|---|---|
| Multi-Modell-Gateway mit Rollen- und Fähigkeits-Routing | Ausführungsgraph | Begrenzter Speicher |
| Dauerhafte Aufgaben-Runtime: Checkpoints, Pausieren/Fortsetzen, Wiederherstellung nach Neustart, Dauerhaftigkeit innerhalb einer Runde | Deklarative Policy-Engine und Freigabe-Wartezustände | Organisationen, Projekte und Mandantenfähigkeit |
| Add-on-Verträge & Manifeste, Tools, MCP-Gateway, Freigaben, Docker-Sandboxes | Wiederverwendbare Workflows & Wissensräume | SSO (OIDC, SAML), Budgets, Deployment-Freigaben |
| Deep Research, Artefakte, Local-Execution-Bridge, unabhängiger Knowledge Worker | Überprüfung mehrteiliger Aufgaben & Verifizierungs-Harness | Air-Gapped-Installation, Hochverfügbarkeit, Kubernetes |
Die Richtung steht fest, der Zeitplan ist kein Versprechen — was nicht in einem Release enthalten ist, gilt als Plan. Details: openmake.cc/roadmap.
Engineering Log
OpenMake wird offen entwickelt. Wir veröffentlichen laufend Implementierungsnotizen, Fehlschläge, Abwägungen und Erfahrungen aus dem Betrieb (Beiträge auf Englisch):
- Six months serving vLLM on a DGX Spark
- We built isolation, and in production it did nothing
- All four times, the tests were green
- Connecting the plan to the execution, in three increments
- Swapping the inference backend in a day, then paying for it
- There was nothing you could do after it failed
- Uploading beyond the proxy limit without bypassing the proxy
Jede Woche wird außerdem im wöchentlichen Entwicklungslog zusammengefasst — zuletzt: W42.
Mitwirken
Beiträge sind willkommen — Fehlerberichte, Fixes, Dokumentation sowie neue Skills oder MCP-Integrationen.
- Erstellen Sie einen Branch und öffnen Sie einen Pull Request gegen
main; Commits folgen den Conventional Commits (feat,fix,refactor,docs,test,chore). - Konventionen: TypeScript im Strict-Modus, Validierung mit Zod, rohes parametrisiertes SQL (kein ORM) und ausgelagerte Konfiguration — keine fest codierten Modellnamen, Magic Numbers oder Inline-Prompts.
- Vor dem Pull Request:
npm run lintundnpm testlaufen durch; Schemaänderungen enthalten eine Migration; neue Umgebungsvariablen sind in.env.exampledokumentiert; UI-Änderungen enthalten einen Screenshot.
Die CI führt bei jedem Push und Pull Request ein einziges CI Gate aus (Test → Build → Größe → Lint).
Community & Kontakt — Fragen und Hilfe beim Self-Hosting: [email protected]. Wenn Ihnen OpenMake hilft, hilft ein Stern anderen Entwicklern, das Projekt zu finden.
Lizenz
Veröffentlicht unter der Apache-Lizenz 2.0.
Ähnliche Projekte entdecken
affaan-m/ECC
System zur Leistungsoptimierung für das Ausführungs- und Steuerungsframework von Agenten. Es bietet Skills, Instinkte, Memory, Sicherheit und forschungsorientierte Entwicklung für Claude Code, Codex, Opencode, Cursor und darüber hinaus.
300,829 SterneNousResearch/hermes-agent
Der Agent, der mit dir wächst
262,464 Sternemultica-ai/andrej-karpathy-skills
Eine einzelne CLAUDE.md-Datei zur Verbesserung des Verhaltens von Claude Code, abgeleitet aus Andrej Karpathys Beobachtungen zu Fallstricken beim Programmieren mit LLMs.
231,882 Sternefirecrawl/firecrawl
Stärke deine KI-Agenten mit Daten aus dem Web und darüber hinaus. Wir bauen die Bibliothek für Superintelligenz. 🔥
200,444 Sterne