
maximilianfeix/proxy-scraper
maximilianfeix/proxy-scraper has 94 GitHub stars and 22 forks. GitHot measured +2 stars in 24 hours. Last checked 2026-11-15 16:31 UTC. Last push 2026-11-15.
Gemessener Sternzuwachs
- in 24h
- +2
- in 7 days
- Aktualisierung verzögert
- in 15 days
- Aktualisierung verzögert
- in 1 month
- Aktualisierung verzögert
Nettoänderungen in überlappenden Zeiträumen, keine Tagessummen. Fehlende Messwerte bleiben leer. Sterne zeigen Interesse, nicht Qualität.
Über uns
Free HTTP/SOCKS proxy list, rebuilt every hour, with the result of every check on record. CLI, Python API, rotating proxy server, MCP server.
EntwicklerwerkzeugeREADME.de.md
Original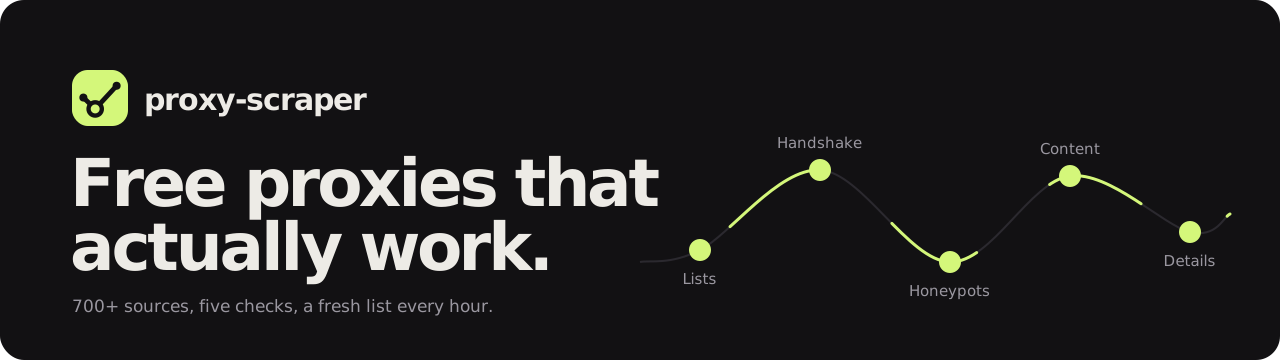





English · 简体中文 · Español · Deutsch · Русский · Português (Brasil) · Français
Installation · Stündliche Proxy-Liste · Proxy-Pool-API · Rotierender Proxy-Server · Python · KI-Agenten (MCP) · FAQ
Proxy-Prüfungen, die du einsehen kannst: was bestanden hat, was durchgefallen ist und wann. proxy-scraper sammelt öffentliche HTTP-, SOCKS4- und SOCKS5-Proxys aus Hunderten von Listen, führt an jedem bis zu vier Prüfungen durch und hält für die Proxys, die es auflistet, das Ergebnis jeder Prüfung fest (bei den übrigen zählt es, wie jede Prüfung ausging). „Funktioniert“ ist damit etwas, das du dir ansehen kannst, und kein Etikett, dem du glauben musst.
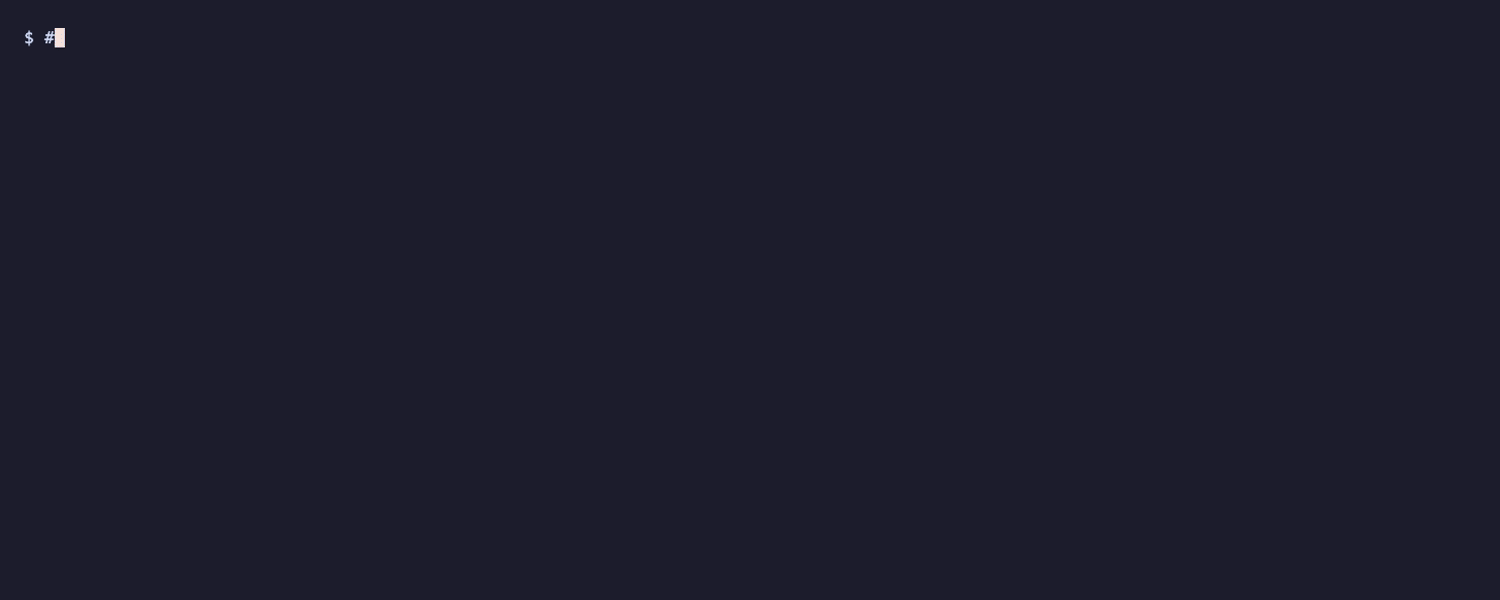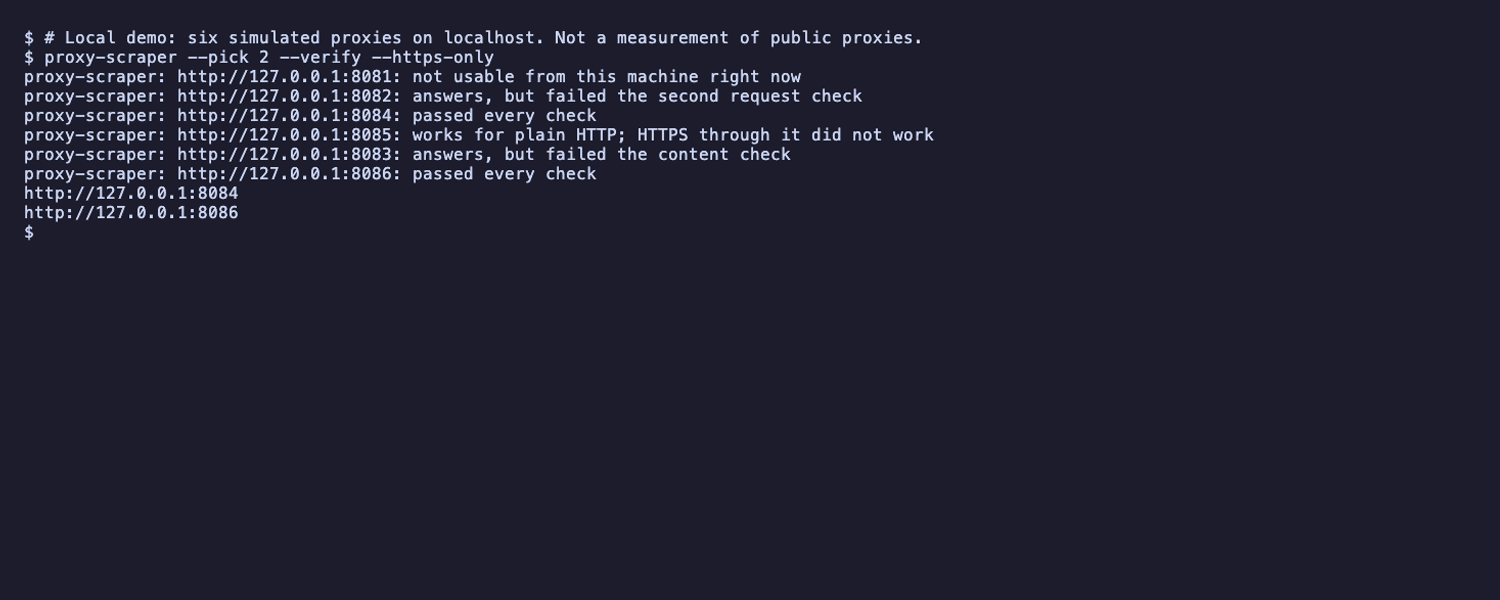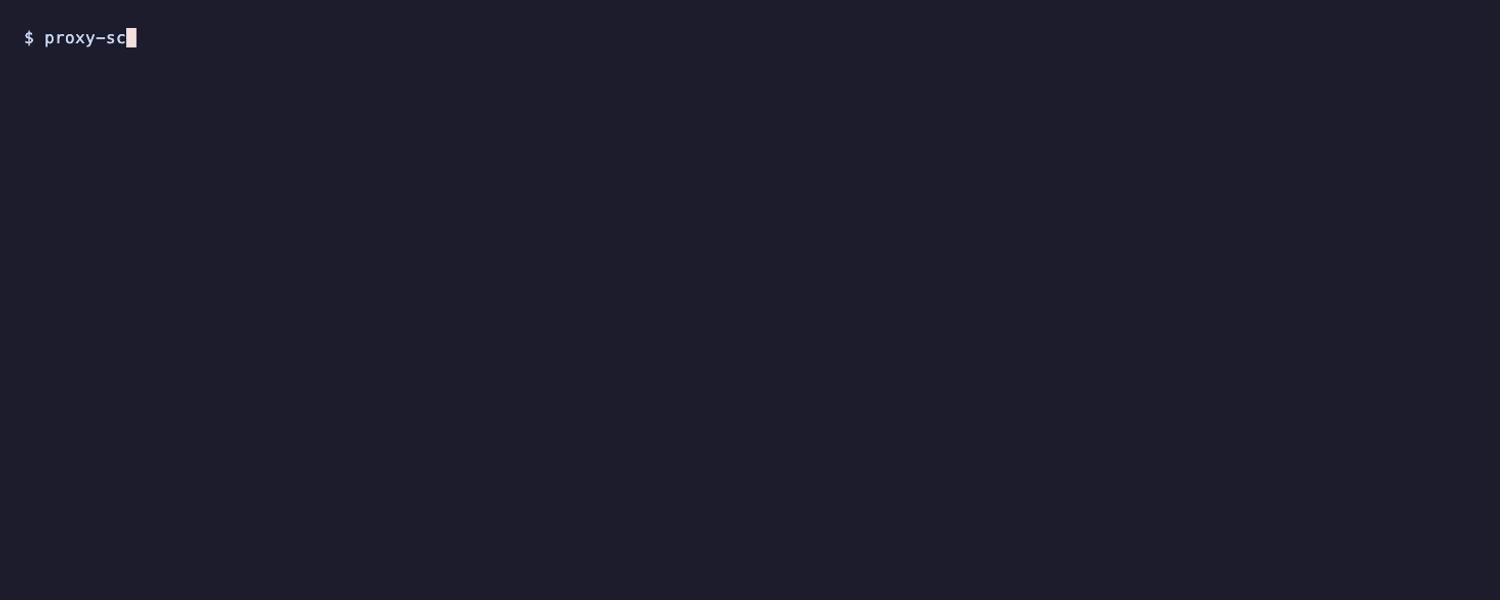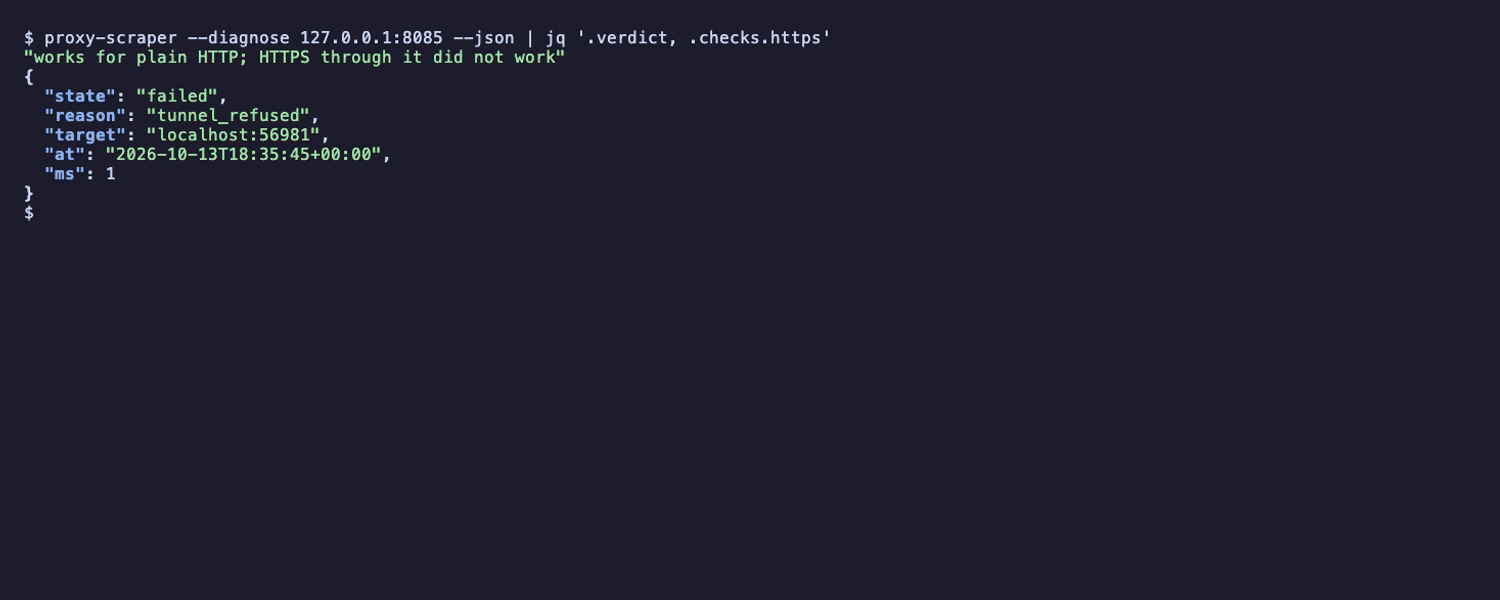
Eine echte Terminal-Aufnahme, entstanden mit sechs simulierten Proxys auf localhost (zum Nachstellen). Sie zeigt, wie Ergebnisse gemeldet werden. Über öffentliche Proxys misst sie nichts.
Ausprobieren – ohne Installation, uvx gibt es mit uv (pipx run tut dasselbe):
uvx proxy-scraper-cli --pick 3 --verify               # bis zu 3 Proxys aus der stündlichen Liste, die gerade jetzt funktionieren, geprüft aus deinem Netz
uvx proxy-scraper-cli --diagnose socks5://HOST:PORT   # ein Proxy, Prüfung für Prüfung: was er geschafft hat und was nicht
Das Paket heißt auf PyPI proxy-scraper-cli (der einfache Name ist vergeben). Nach der Installation heißt der Befehl proxy-scraper. --verify und --diagnose brauchen Version 1.30 oder neuer.
Drei Wege zu Proxys, und was „geprüft“ dabei jeweils heißt:
| Befehl | Woher die Proxys kommen | Geprüft | Dauer |
|---|---|---|---|
proxy-scraper --pick 5 |
aus der veröffentlichten Liste | von GitHubs Servern aus, als die Liste gebaut wurde, etwa jede Stunde | unter einer Sekunde |
proxy-scraper --pick 5 --verify |
aus der veröffentlichten Liste | jetzt, aus deinem Netz | Sekunden; die Prüfungen enden nach 90 s, dazu ein paar Sekunden für das Laden der Liste |
proxy-scraper -y |
aus allen Listen, die das Tool kennt | jetzt, aus deinem Netz | Minuten (ein paar in den stündlichen Läufen) |
Was du bekommst
- Jede Prüfung hat ein Ergebnis, das du lesen kannst.
passed,failed,unavailableoderskipped(bestanden, durchgefallen, nicht prüfbar, übersprungen), mit Ursachen-Code, Ziel und Zeitpunkt, im Terminal, in JSON und aus Python. Eine Prüfung, die nicht gelaufen ist, wird nie als bestanden angezeigt, und wenn ein Prüfziel ausfällt, gelten die dagegen geprüften Proxys nicht als durchgefallen. → Prüfzustände (englisch) - Frisch, wenn es darauf ankommt.
--pick --verifyprüft ein paar Proxys aus deinem eigenen Netz, meist in Sekunden.--recheckmacht dasselbe mit einer eigenen Liste, und--diagnosesagt dir, warum ein Proxy nicht funktioniert. - Mehr als eine Liste. Ein rotierender lokaler Proxy-Server, eine Python-API, ein MCP-Server für KI-Agenten, Docker und Exporte für curl, proxychains, Clash und sing-box.
Was es nicht kann. Kostenlose Proxys werden von Fremden betrieben, und von den Einträgen einer Stunde steht einen Tag später nur noch etwa ein Viertel auf der Liste. Eine bestandene Prüfung ist eine einzelne Messung, aus einem Netz, gegen Testziele: kein Versprechen für die nächste Stunde oder für die Seite, um die es dir geht. Die HTTPS-Prüfung ist eine verifizierte TLS-Verbindung zu einem Test-Host, keine Sicherheitsbewertung. Nutze kostenlose Proxys für öffentliche Daten und zum Testen, nie für Logins, Zahlungen oder irgendetwas Persönliches. → Was die Zahlen zeigen und was nicht (englisch) · Vergleich mit anderen Projekten (englisch) · Wer kostenlose Proxys betreibt
Nur die Listen gesucht? Dafür brauchst du dieses Tool nicht: free-proxy-list hat sie als einfache Dateien pro Protokoll und Land, etwa jede Stunde neu gebaut. Oder direkt von hier: all.txt · http.txt · socks4.txt · socks5.txt · proxies.json · weitere Formate
Wer es nutzt: Die stündliche Liste ist eine eingebaute Quelle von monosans/proxy-scraper-checker und gfpcom/free-proxy-list.
Die Prüfungen, die jeder Proxy bestehen muss
| Prüfung | Bedeutung |
|---|---|
| Echter Handshake | Der Proxy muss das HTTP-, SOCKS4- bzw. SOCKS5-Protokoll wirklich sprechen |
| Zweite Anfrage, dieselbe Exit-IP | Eine zweite Anfrage an eine andere Seite muss dieselbe Exit-IP zeigen. Wer nur die erste Anfrage beantwortet, instabil ist oder den Exit wechselt, fällt hier durch |
| Inhalt unverändert | Eine statische Testseite muss Byte für Byte ankommen. Warum sie abweicht, wird nicht ermittelt |
| HTTPS mit verifiziertem Zertifikat | Als HTTPS-fähig gilt ein Proxy nur, wenn durch seinen Tunnel ein TLS-Zertifikat ankommt, das sich für den Test-Host verifizieren lässt |
| Details | Anonymität (elite / anonymous / transparent), Land, ASN und Anbieter, Rechenzentrum ja/nein, Latenz, Download-Geschwindigkeit |
Installation
pipx install proxy-scraper-cli
proxy-scraper
Das Paket heißt auf PyPI proxy-scraper-cli (der einfache Name ist vergeben), der Befehl heißt proxy-scraper. Läuft mit Python 3.9–3.14 auf macOS, Linux und Windows und braucht nur rich und certifi.
Auf macOS und Linux auch mit Homebrew:
brew install maximilianfeix/tap/proxy-scraper
Oder mit Docker (linux/amd64 und linux/arm64):
docker run --rm ghcr.io/maximilianfeix/proxy-scraper --want 50 --https-only
Ohne Argumente gestartet, fragt ein Assistent, was du suchst – mit den Pfeiltasten wählst du eine Vorgabe (alles finden, Browsing & Web, maximale Anonymität, schnell & stabil …) und bekommst am Ende die passende Befehlszeile angezeigt.
Stündliche Proxy-Liste
Keine Lust, selbst zu scannen? GitHub Actions lässt das Tool etwa jede Stunde laufen und veröffentlicht die Treffer. Jeder Proxy auf der Liste hat im letzten Lauf die erste Anfrage, die zweite Anfrage und die Inhaltsprüfung bestanden (der HTTPS-Test wird pro Eintrag festgehalten, ist aber keine Bedingung), sortiert nach dem Motto „beste zuerst“: schnelle, die wahrscheinlich noch online sind, stehen oben.
- Website (filtern nach Protokoll, Land, HTTPS, Anbieter, Latenz): https://proxy-scraper.de/
- Nur die Listen (TXT pro Protokoll, Land und Website, dazu JSON/CSV): maximilianfeix/free-proxy-list
| Liste | Format | Adresse |
|---|---|---|
| Alle | socks5://1.2.3.4:1080 |
https://proxy-scraper.de/all.txt |
| HTTP · SOCKS4 · SOCKS5 | 1.2.3.4:8080 |
…/http.txt · …/socks4.txt · …/socks5.txt |
| Nur HTTPS-fähige | type://ip:port |
…/https.txt |
| Nur Elite | type://ip:port |
…/elite.txt |
| Kommt durch bei Google · Reddit · Amazon · Instagram · TikTok · Discord | type://ip:port |
…/works-with/google.txt · …/works-with/reddit.txt · … |
| Stabil (in mindestens 90 % der Läufe dieser Woche dabei) | type://ip:port |
…/stable.txt |
| Mit allen Details | Latenz, Land, HTTPS, Anonymität, Exit-IP, Uptime | …/proxies.json · …/proxies.csv |
Jedes Protokoll und jedes Land hat auch eine eigene Seite mit einfachem Download, z. B. SOCKS5 oder Deutschland (country/de/proxies.txt).
curl -s https://proxy-scraper.de/socks5.txt | head
[!TIP] Die Dateien liegen auch auf der Website, ohne das Rate-Limit von
raw.githubusercontent.comund mit CORS-Headern, funktionieren also direkt aus dem Browser. jsDelivr geht ebenfalls, kann aber ein paar Stunden hinterherhinken.
Geprüft wird von GitHub-gehosteten Runnern aus. proxy-scraper --recheck live lädt die Liste und prüft sie noch einmal aus deinem Netz – deutlich unter einer Minute statt eines vollen Scans. Wie viele aus deinem Netz noch funktionieren, weicht stark von der Zahl auf der Liste ab; genau deshalb lohnt sich die erneute Prüfung. Mit --serve wird daraus ein rotierender Proxy.
Proxy-Pool-API: kompatibel mit jhao104/proxy_pool
Du nutzt jhao104/proxy_pool? Die Endpunkte, der Parameter type=https und die meisten JSON-Felder (proxy, https, region, check_count, fail_count, …) sind dieselben – richte deinen Code auf Port 8899 und das meiste läuft weiter (drei Unterschiede: last_time gibt es nicht, anonymous ist true/false, kein String, und source ist immer proxy-scraper). Ohne Redis, und jeder Proxy hat die zweite Anfrage und die Inhaltsprüfung bestanden; die als HTTPS-fähig markierten zusätzlich die TLS-Prüfung.
proxy-scraper --recheck live --serve # startet mit der stündlichen Liste, nach ~30 s bereit
curl http://127.0.0.1:8899/get                                    # ein Proxy als JSON
curl "http://127.0.0.1:8899/get?country=DE&https=1&format=txt"    # → http://203.0.113.7:8080
curl "http://127.0.0.1:8899/all?protocol=socks5&limit=20"         # die 20 besten SOCKS5-Proxys
curl "http://127.0.0.1:8899/report?proxy=203.0.113.7:8080&ok=0"   # hat versagt – dreimal, und er fliegt raus
| Endpunkt | Funktion |
|---|---|
/get |
ein Proxy, gewählt nach der --rotate-Strategie |
/pop |
wie /get, der Proxy verlässt dabei den Pool |
/all |
alle nutzbaren Proxys, beste zuerst (limit=N) |
/count |
Zahlen nach Typ und Land |
/delete?proxy=IP:PORT |
einen Proxy entfernen |
/report?proxy=IP:PORT&ok=0 |
Rückmeldung aus deinen eigenen Anfragen |
Filter gelten für /get, /pop und /all: country=DE,AT, protocol=socks5, https=1, anonymity=elite, max_latency=1500, und format=txt für reine URLs.
import requests
proxy = requests.get("http://127.0.0.1:8899/get?type=https").json()["url"]   # z. B. socks5://…, inklusive Typ
requests.get("https://example.com", proxies={"http": proxy, "https": proxy})
Rotierender Proxy-Server
Derselbe Port ist auch ein lokaler Proxy: Jede Verbindung geht über einen anderen Proxy, und wenn einer ausfällt, kommt der nächste dran.
curl -x http://127.0.0.1:8899 https://api.ipify.org                  # jedes Mal eine andere IP
curl -x socks5h://127.0.0.1:8899 https://api.ipify.org               # SOCKS5 am selben Port
curl -x http://country-de:[email protected]:8899 https://api.ipify.org     # nur deutsche Exits
curl -x http://session-cart42:[email protected]:8899 https://shop.example  # derselbe Proxy für diese Sitzung
Wie bei kommerziellen rotierenden Proxys steckt der Wunsch im Benutzernamen: country-XX, type-http|socks4|socks5 und session-NAME, kombinierbar. Für HTTPS bevorzugt der Server Proxys mit geprüftem TLS; passt gerade keiner (etwa weil keiner den Wunsch wie country-de erfüllt oder alle ausgefallen sind), nimmt er die anderen – die Zertifikatsprüfung deines Clients fängt trotzdem jeden Proxy, der die Verschlüsselung aufbricht, also lass sie an. Drei Fehler in Folge, und ein Proxy verlässt die Rotation; alle fünf Minuten wird er neu geprüft und kommt zurück, wenn er wieder läuft. Standardmäßig lauscht der Server nur auf 127.0.0.1; für den Zugriff von anderen Rechnern setzt du mit PROXY_SCRAPER_SERVE_PASSWORD ein Passwort. Alle Optionen in der englischen README.
Live-Dashboard: http://127.0.0.1:8899/__proxy-scraper/ im Browser zeigt Pool, Erfolgsquote, Traffic, Länder, die besten Proxys und die letzten Verbindungen – alle zwei Sekunden aktualisiert.
Aus Python
from proxyscraper import ProxyRotator, live_proxies

# die stündliche Liste, ohne Prüfung, in etwa einer Sekunde
proxies = live_proxies(types=["socks5"], https=True, min_uptime=90)

# automatische Wiederholung und Proxy-Wechsel
with ProxyRotator(country="DE") as rotator:
    r = rotator.get("https://httpbin.org/ip")
    print(r.status, r.text, "via", r.via)

# eine lokale Proxy-Adresse für requests / httpx / Playwright / Scrapy, rotiert im Hintergrund
with ProxyRotator() as rotator:
    proxy = rotator.proxy_url()
Für eine frische Prüfung aus deinem eigenen Netz gibt es find_proxies() und check_proxies(). Die vollständige Beschreibung steht in der englischen README.
Häufige Befehle
proxy-scraper --want 50 --https-only                   # aufhören, sobald 50 HTTPS-fähige gefunden sind
proxy-scraper --types socks5 --anonymity elite         # nur Elite-SOCKS5
proxy-scraper --country DE,AT,CH --max-latency 1500    # bestimmte Länder, maximale Latenz
proxy-scraper --target www.google.com --want 20        # nur Proxys, die die Zielseite erreichen
proxy-scraper --pick 5 --types socks5                  # 5 aus der stündlichen Liste, ohne Scan
proxy-scraper --export clash                           # Clash-Konfiguration (auch proxychains, sing-box, curl)
Alle Optionen: proxy-scraper --help oder die englische README.
KI-Agenten (MCP)
proxy-scraper-mcp ist ein MCP-Server: Claude Code, Claude Desktop, Cursor, VS Code, Codex und jeder andere MCP-Client können damit funktionierende Proxys abrufen und Seiten durch sie laden.

| Tool | Funktion |
|---|---|
get_proxies |
Proxys aus der stündlichen Liste, so wie sie in ihrem letzten Lauf geprüft wurden – filterbar nach Protokoll, Land, HTTPS, Elite, Rechenzentrum, Stabilität, Latenz |
check_proxies |
prüft Proxys aus deinem eigenen Netz, damit sie dort laufen, wo dein Code läuft |
fetch_url |
lädt eine Seite über einen Proxy aus der geprüften Liste, wechselt bei Fehlern selbst und liefert lesbaren Text |
Claude Code:
claude mcp add proxy-scraper -- uvx --python ">=3.10" --from "proxy-scraper-cli[mcp]" proxy-scraper-mcp
Claude Desktop, Cursor und die meisten anderen Clients – in die MCP-Konfiguration eintragen:
{
  "mcpServers": {
    "proxy-scraper": {
      "command": "uvx",
      "args": ["--python", ">=3.10", "--from", "proxy-scraper-cli[mcp]", "proxy-scraper-mcp"]
    }
  }
}
Kein Python gewünscht? Das Docker-Image bringt alles mit: "command": "docker", "args": ["run", "-i", "--rm", "ghcr.io/maximilianfeix/proxy-scraper", "--mcp"]. Der Server steht auch in der offiziellen MCP-Registry als io.github.maximilianfeix/proxy-scraper.
FAQ
Wer betreibt kostenlose Proxys – und sollte man sie nutzen? Fast niemand betreibt einen kostenlosen Proxy für dich. Auf öffentlichen Listen landen meist: falsch konfigurierte Server mit einem offen gelassenen Port; ein paar absichtlich offene Proxys; infizierte Rechner und IoT-Geräte, deren Besitzer nichts davon wissen; und Fallen: Proxys, die aufgesetzt wurden, um den Verkehr zu protokollieren, und Proxys, die Seiten umschreiben. Das ist allgemeiner Hintergrund, nichts, was dieses Projekt gemessen hat: Eine Prüfung sieht nicht, wer einen Proxy betreibt oder warum. proxy-scraper kann einen infizierten Heimrouter nicht von einem offenen Büro-Proxy unterscheiden, filtert aber, was messbar ist: Zwei unabhängige Anfragen müssen dieselbe Exit-IP zeigen, eine bekannte Seite muss Byte für Byte ankommen, und HTTPS zählt nur mit einem Zertifikat, das sich für den Test-Host verifizieren lässt. Gut für öffentliche Daten, den Blick auf eine Seite aus einem anderen Land, das Testen eigener Sperren und Forschung. Niemals Passwörter, Cookies, Zahlungs- oder persönliche Daten durch einen kostenlosen Proxy schicken.
Warum findet es weniger Proxys als andere Listen behaupten?
Weil nur Proxys bleiben, die jede Prüfung bestehen: zwei unabhängige Anfragen, die dieselbe fremde Exit-IP zeigen, und eine Testseite, die unverändert ankommt. In den stündlichen Läufen ist das deutlich unter 1 % der 150.000 geprüften Kandidaten (zwischen 0,2 % und 1,3 % pro Lauf vom 3. bis 10. Nov. 2026; die aktuelle Zahl steht als total in stats.json). Bestanden haben sie aus Sicht des Netzes, das sie geprüft hat, und zu diesem Zeitpunkt.
Es kommt fast nichts durch? Viele Firmen-, Schul- und Uni-Netze blockieren Proxy-Verbindungen. Das Tool bemerkt eine Trefferquote unter 0,2 % und warnt dich – ein anderes Netz wie ein Handy-Hotspot hilft.
Läuft es unter Windows?
Ja, in PowerShell und Windows Terminal. uvloop gibt es dort nicht und wird automatisch übersprungen.
Wie frisch ist die Liste?
Sie wird etwa jede Stunde neu gebaut. Kostenlose Proxys kommen und gehen schnell – für alles Wichtige vorher proxy-scraper --recheck laufen lassen.
Sind kostenlose Proxys sicher? Nur für Dinge, die nicht wichtig sind. Öffentliche Proxys betreiben Fremde, die alles mitlesen können, was nicht verschlüsselt ist. Keine Passwörter oder persönlichen Daten hindurchschicken, und nur dort nutzen, wo es erlaubt ist.
Mitmachen
Issues und Pull Requests sind willkommen, auf Deutsch oder Englisch. Es gibt einsteigerfreundliche Issues. Wenn dir proxy-scraper Zeit spart, hilft ein ⭐ anderen, es zu finden.
Haftungsausschluss
Dieses Tool sammelt nur öffentlich gelistete Proxys und prüft, ob sie funktionieren. Für die Nutzung bist du verantwortlich – halte dich an die Bedingungen der Seiten, die du besuchst, und an die Gesetze, die für dich gelten. MIT-Lizenz.