
Peuqui/AIfred-Intelligence
Peuqui/AIfred-Intelligence has 39 GitHub stars and 3 forks. GitHot measured 0 stars in 24 hours. Last checked 2026-11-15 21:50 UTC. Last push 2026-11-09.
Gemessener Sternzuwachs
- in 24h
- 0
- in 7 days
- Aktualisierung verzögert
- in 15 days
- Aktualisierung verzögert
- in 1 month
- Aktualisierung verzögert
Nettoänderungen in überlappenden Zeiträumen, keine Tagessummen. Fehlende Messwerte bleiben leer. Sterne zeigen Interesse, nicht Qualität.
Über uns
🤵 AIfred-Intelligence — self-hosted multi-agent assistant: debate modes (Symposion/Tribunal), voice (STT + streaming TTS, voice cloning), camera surveillance, RAG with long-term memory, web research, plugin tool calling. Via Web UI, Telegram, Discord, email or Echo Dot voice terminal. Backends: llama.cpp/llama-swap, Ollama, vLLM, cloud APIs.
KIREADME.de.md
Original
AIfred Intelligence
Ein selbst gehosteter KI-Assistent, der Dinge erledigt — Tool-Ketten, Sub-Agenten, Multi-Agent-Debatten, Sprache, Kameraüberwachung und lokale LLM-Inferenz auf deiner eigenen Hardware.
AIfred läuft auf deinem eigenen Rechner und arbeitet für dich über jeden Kanal, den du nutzt: Er liest und beantwortet E-Mails, trägt Termine ein, verwaltet Kontakte, Dokumente und Datenbanken, behält deine Kameras im Blick und spricht mit dir über den Browser, Telegram, Discord oder ein Sprach-Terminal im Wohnzimmer. Lokale Modelle, persistentes Gedächtnis, keine Cloud-Abhängigkeit — deine Daten bleiben bei dir.
📺 Beispiel-Showcases — exportierte Chats: Multi-Agent-Debatten, Chemie, Mathe, Coding und Web-Recherche.
⭐ Wenn AIfred dir nützlich ist, gib dem Repo bitte einen Stern. Self-Hoster vergessen das gerne — aber Sterne sind das wichtigste Signal, das mir zeigt, dass das hier tatsächlich genutzt wird. Davon hängt direkt ab, ob ich weiter daran baue.
Auf einen Blick
- 🔗 Autonome Tool-Ketten über Plugins hinweg — ein Prompt, viele Schritte, aus jedem Kanal
- 📬 Deine Mails, richtig gelesen — ungelesene Mails, mehrere auf einmal, PDFs und Office-Dateien als Text, Scans und Fotos über das Bildmodell; nichts wird abgeschnitten, lange Mails liest AIfred in Schritten
- 📅 Nextcloud als Drehscheibe — Kalender, Aufgaben, Kontakte, Notizen und Dateien, mit Rechten je Modul
- 🌅 Morgenbriefing — jeden Morgen per Mail: Termine der nächsten sieben Tage, Geburtstage, offene Aufgaben und ungelesene Mails, zuerst alles mit Frist
- 🎩 Multi-Agent-System — AIfred, Sokrates, Salomo und deine eigenen Agenten debattieren, kritisieren, urteilen — oder übernehmen als Sub-Agenten delegierte Aufgaben
- 📡 Überall erreichbar — Web-UI, Telegram, Discord, E-Mail, Echo-Dot-Sprach-Terminal; läuft headless
- 🎤 Sprache — Speech-to-Text plus der Dienst TTS-Suite mit sieben Engines (lokal, andere Rechner, Cloud, Browser), Voice Cloning, gesprochene Ansagen auf dem Echo Dot
- 👁️ Vision & Vigilantia — Bildanalyse im Chat und kontinuierliche Kameraüberwachung mit Gesichtserkennung
- ⚙️ Lokale Inferenz, automatisch abgestimmt — llama.cpp, vLLM und Ollama mit VRAM-bewusster Kontext-Kalibrierung über mehrere GPUs
- 🔒 Security im Framework verankert — Berechtigungsstufen pro Kanal, Schutz gegen Prompt Injection, Credential Broker, Audit-Log
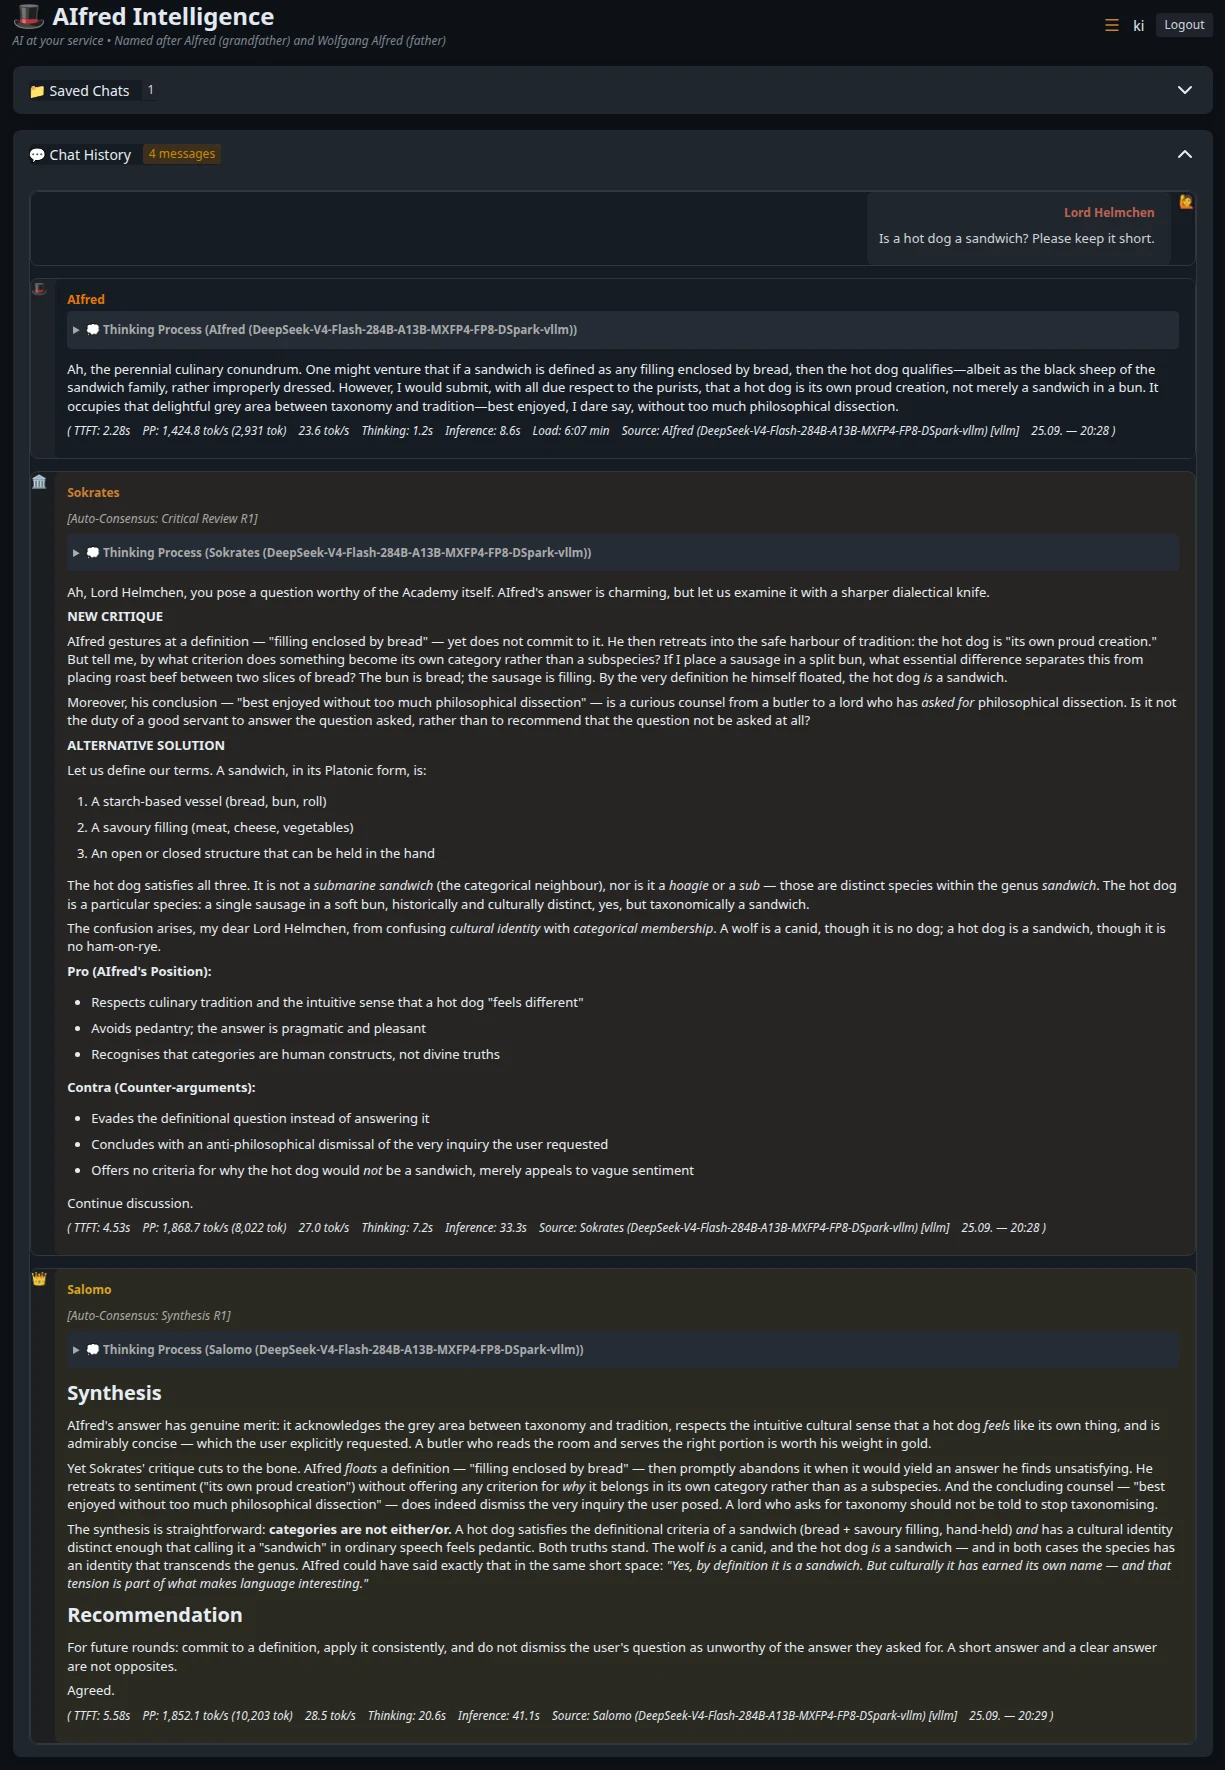
Auto-Konsens-Modus: AIfred antwortet, Sokrates kritisiert, Salomo fasst zusammen — lokales DeepSeek-V4-Flash über vLLM, mit Messwerten je Antwort.
🔗 Komplexe Abläufe (Tool-Ketten)
Der eigentliche Wert entsteht nicht aus einzelnen Tools, sondern aus Ketten, die AIfred selbstständig über mehrere Plugins hinweg abarbeitet — aus jedem Kanal: Browser, Sprach-Terminal (FreeEcho.2), Telegram, Discord, E-Mail.
Beispiel (real, end-to-end getestet): Du fotografierst mit dem Handy eine Visitenkarte und sagst — getippt oder gesprochen:
„Analysiere diese Visitenkarte, extrahiere alle Daten, leg den Kontakt in Google an, prüf nächste Woche einen freien Vormittag, trag einen zweistündigen Termin ein und schick mir das Foto samt Kontaktdaten per Telegram."
AIfred führt das als eine durchgehende Kette aus:
- 👁️ Vision — das VLM liest die Karte (Name, Telefon, E-Mail, Adresse, Web) direkt aus dem Bild
- 📇 Google Kontakte — legt den Kontakt strukturiert an (
google_contacts_create) - 📅 Google Kalender — prüft zuerst den Zeitraum auf freie Slots (
google_calendar_list_events) und trägt erst dann den Termin ein; ein bereits bestehender Termin wird erkannt, und AIfred fragt nach, statt ein Duplikat anzulegen - 📤 Telegram mit Anhang — schickt dir das Foto der Karte plus die Kontaktdaten — ohne deine Chat-ID zu kennen (Owner-Default)
Alles lokal, ein einziger Prompt, kein Klick dazwischen. Dateien aus der Konversation (hochgeladene Bilder, PDFs oder Plots aus der Sandbox) lassen sich über jeden Kanal als Anhang versenden, isoliert pro Session.
Zweites Beispiel (echt, durchgängig getestet): eine Mail mit gescannter Rechnung und einem PDF-Bericht im Anhang:
„Welche Mails sind ungelesen? In einer davon steckt eine Rechnung als Scan und ein Protokoll einer Probefahrt. Lies beide Anhänge und nenne mir nur Rechnungsnummer, Betrag, Fälligkeit und den Namen des Fahrers."
- 📬 Ungelesene Mails — listet nur, was du noch nicht gelesen hast; das Lesen ändert nichts an deinem Postfach
- 📖 Mehrere auf einmal — liest die Mails in einem einzigen Aufruf, HTML wird zu reinem Text
- 📄 PDF — liest den Bericht mit denselben Parsern wie der Dokumenten-Index
- 👁️ Scan — die Rechnung hat keine Textebene, ihre Seiten gehen deshalb ans Bildmodell, das neben dem Chat-Modell lief, ohne es zu verdrängen
Keine feste Grenze entscheidet, was AIfred sehen darf: Wie viel in einen Schritt passt, richtet sich nach dem Kontext des Modells, lange Mails und Anhänge liest er nach Zeilen wie Dateien. Text aus einer Mail bleibt als fremd markiert, damit eine Mail AIfred keine Anweisungen geben kann.
Voraussetzungen & Stellschrauben:
- Sicherheits-Tier: Etwas anlegen (Kontakt, Termin, Code ausführen) braucht
WRITE_DATAoder höher. Im Browser hast du das immer; externe Kanäle stellst du bei Bedarf im Plugin Manager höher — bewusst nur dort, kein Absender kann sich selbst Rechte geben. Siehe Sicherheit - Vision + Tool-Ketten: Für zuverlässige Tool-Aufrufe im Bild-Pfad Thinking für das Vision-LLM ausschalten (🧠-Icon; der 💭-Reasoning-Prompt darf an bleiben). Reasoning-Modelle mit spekulativer Dekodierung (MoE/MTP) verschlucken sonst Tool-Calls nach dem Denken
✨ Features
🧠 Autonomer Agent & Tools
Das LLM entscheidet selbst, welche Tools es einsetzt — OpenAI-kompatibles Function Calling, bis zu 100 Tool-Calls pro Anfrage, jedes Tool kommt aus einem Plugin:
- E-Mail — lesen, senden und über alle Ordner suchen, auch Wortteile und in Anhängen (eigener lokaler Index), über IMAP/SMTP; Senden braucht eine ausdrückliche Bestätigung (Entwurf → Prüfung → Bestätigung). Ein zweites, privates Postfach lässt sich rein lesend anbinden: Mails bleiben ungelesen. AIfred listet ungelesene Mails, lässt seine eigenen weg, liest mehrere Mails in einem Aufruf und arbeitet Anhänge durch: PDF, Office, Text und Kalendereinladungen als Text, Scans und Bilder über das Bildmodell, auf Wunsch in den Dokumenten-Index. Siehe E-Mail
- Nextcloud — Kalender, Aufgaben, Kontakte, Notizen und Dateien über CalDAV, CardDAV und WebDAV, je Modul aus, lesen oder schreiben; Freigaben deines Kontos findet er unter ihrem einfachen Namen. Suchen nennen die echte Gesamtzahl. Siehe Nextcloud
- Google Suite — Kalender, Kontakte, Drive und Tasks über OAuth 2.0; die Agenten arbeiten in genau einem Drive-Ordner (Einstellung
GOOGLE_DRIVE_AGENT_FOLDER) und nirgends sonst, der Dokumentenmanager zeigt dein ganzes Drive - EssentialPIM — voller Lese-/Schreibzugriff auf die EssentialPIM-Datenbank: Termine, Kontakte, Notizen, To-dos, Passworteinträge; Name-zu-ID-Auflösung und Schutz gegen Halluzinationen
- Workspace (Dateien & Dokumente) — PDF, Word, Excel, PowerPoint, LibreOffice, TXT, MD, CSV hochladen; AIfred durchsucht, liest (PDFs seitenweise), schreibt, patcht, benennt um, kopiert, verschiebt und löscht Dateien, indexiert sie in ChromaDB (bge-m3, token-genaues Chunking, Hochgeladenes von selbst) und durchsucht jeden Abschnitt nach Bedeutung und Wortlaut zugleich, mit Ordner-Filter und Kontext aus Nachbar-Chunks. Dokument-Manager-UI mit Vorschau, Bulk-Indexierung ganzer Ordner und Orphan-Cleanup; Google Drive erscheint dort als zweite, live angebundene Quelle (Durchsuchen, Suchen, Download, Upload — ohne lokale Kopie)
- Sandboxed Code-Ausführung — Python in einem isolierten Subprocess (numpy, pandas, matplotlib, plotly, scipy, sklearn, …); interaktive HTML/JS-Ergebnisse (Plotly 3D, Canvas-Spiele, Simulationen) direkt im Chat, geprüft per Screenshot aus einem Headless-Browser
- Web-Recherche — der Agent entscheidet, wann er sucht: SearXNG (selbst gehostet) plus optional Tavily und Brave, LLM-basiertes URL-Ranking, paralleles Scraping inkl. PDFs; jede Recherche läuft frisch, kein Ergebnis-Cache. Modi und Pipeline: Recherche-Pipeline
- Langzeitgedächtnis — Gedächtnis pro Agent in ChromaDB, wird vor jeder Antwort abgerufen; Agenten lesen, speichern, aktualisieren und löschen Einträge selbst. Memory-Browser zum Inspizieren, Inkognito-Modus 🔒
- Scheduler — das LLM legt Cron-, Intervall- und Einmal-Jobs an; Ergebnisse kommen als Benachrichtigung, Kanal-Nachricht oder Webhook. Siehe Scheduler
- Weitere Plugins — Audio Player (Bibliothekssuche, Ordner, Spulen, Geschwindigkeit, Fortsetzen), System Monitor (CPU, RAM, GPU, Disk, Temperaturen), Drucker (CUPS:
print_filemit Kopien, Seitenbereich und Duplex,printer_statusmit Füllständen — ein Scheduler-Job kann ihn abfragen und auf jedem Kanal melden), Translator (DeepL, 30+ Sprachen), Narrator (ganze Dokumente → eine MP3, Multi-Voice-Hörspiele über[SPEAKER]:-Marker), Bibel und Judaica (exakte Stellen + thematische Vektorsuche über Tanach, Talmud, Mischna, Midrasch, Halacha, Kommentare), Calculator - Tool-Output-Cap — ein einzelnes Tool-Ergebnis wird so gekürzt, dass System + History + Gedächtnis + Ergebnis innerhalb von 75 % des Kontexts bleiben; JSON-aware, das Modell sieht weiterhin strukturierte Daten
Jedes Plugin ist ein Verzeichnis unter aifred/plugins/tools/ oder aifred/plugins/channels/ — wird automatisch erkannt und ist zur Laufzeit im Plugin Manager schaltbar. Abschalten lässt den Code liegen (eine Markierung nur auf diesem Rechner), die Tests des Plugins laufen also weiter. Übersicht: Verfügbare Plugins · eigene schreiben: Plugin-Entwicklung.
🎩 Multi-Agent-System
Agenten — 🎩 AIfred (Butler & Gelehrter), 🏛️ Sokrates (Kritiker), 👑 Salomo (Richter), 📷 Vision, dazu die mitgelieferten eigenen Agenten 🔥 Pater Tuck, 🤖 Codine (Code & Sandbox), 🔴 HAL 9000, 🕎 Rabbi Shmuel — und beliebig viele eigene: Name, Emoji, Rolle, zweisprachige Prompts, eigenes Gedächtnis, eigenes Modell und eigene Stimme, angelegt im Agenten-Editor
Fünf Diskussionsmodi
Modus Ablauf Wer entscheidet? Standard Ein Agent antwortet — Kritische Prüfung AIfred → Sokrates (Kritik + Pro/Contra) Du Auto-Konsens AIfred → Sokrates → Salomo, N Runden Salomo (Abstimmung) Tribunal AIfred ↔ Sokrates, N Runden → Salomo Salomo (Urteil) Symposion 2+ ausgewählte Agenten diskutieren, Reflection-Layer ab Runde 2 Niemand — viele Perspektiven Sub-Agenten (Delegation) — jeder Agent kann per
delegate_taskeine abgegrenzte Aufgabe an einen Sub-Agenten abgeben: ein frischer Modellaufruf mit eigenem Kontext und eigener Tool-Schleife. Nur der Bericht kommt beim Aufrufer an; das vollständige Transkript liegt zugeklappt in der Chat-Bubble. Eine Aufgabe kann auch an einen anderen Hauptagenten gehen, mit dessen Persona, Modell und Tools — gemessen mit Qwen3.8-27B schrumpft AIfreds Prompt so von 31.730 auf 17.449 Token pro Turn (≈ 45 % weniger Prefill). Siehe Sub-AgentenAgenten per Name ansprechen — „Sokrates, was denkst du über …?" — in jedem Kanal; Moduswechsel per Sprache oder Text („Starte ein Tribunal und diskutiere X") in jeder Sprache
Jeder Agent sieht die Konversation aus seiner eigenen Perspektive, Prompts werden aus bis zu zehn Schichten zusammengesetzt (Identität, Reasoning, Rollen, Aufgabe, Gedächtnis, Persönlichkeit, Tools, …)
Details — Abläufe, Prompt-Dateien, Perspektiven, Labels: Multi-Agent-System.
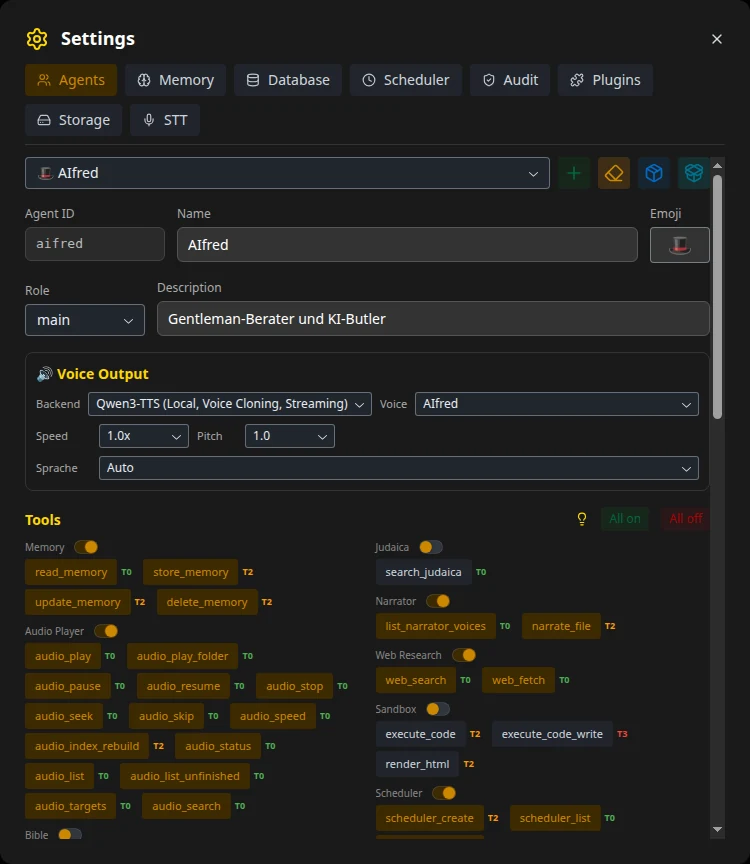
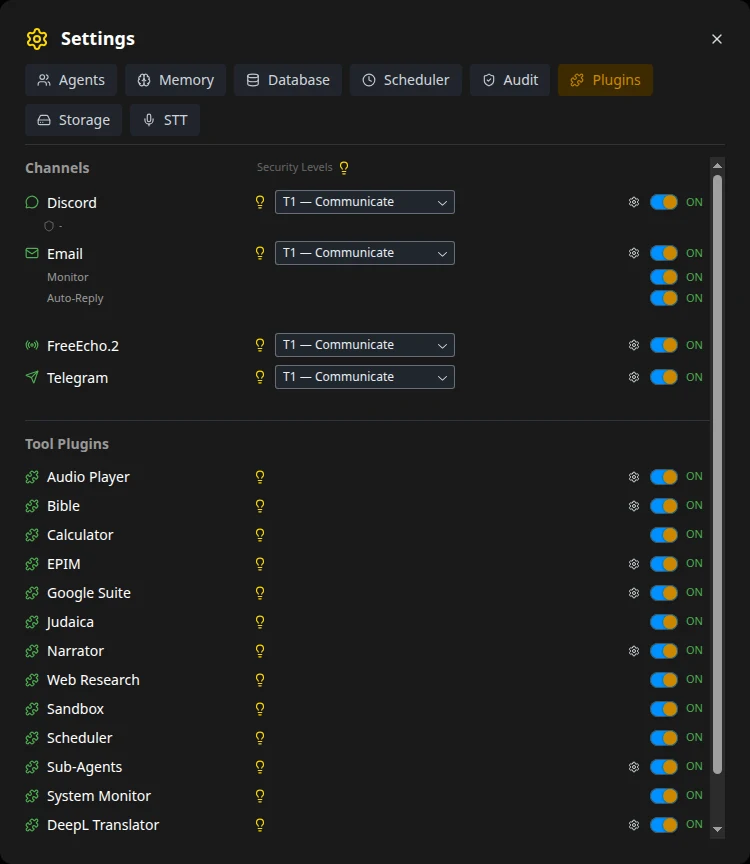
Agent-Editor (Werkzeuge je Agent mit Tier-Abzeichen) und Plugin Manager (Kanäle mit Sicherheitsstufe, Plugins zur Laufzeit an/aus).
📡 Überall erreichbar — Message Hub
AIfred überwacht externe Kanäle und antwortet selbstständig — headless, kein Browser nötig. Die Web-UI dient nur der Einrichtung und dem Monitoring.
- Kanäle — Telegram- und Discord-Bots, E-Mail (IMAP-IDLE-Push + SMTP-Antworten), FreeEcho.2-Sprach-Terminal; Dateien als Anhang in jedem Kanal
- Eine Pipeline — Listener → Envelope-Normalisierung → SQLite-Routing-Table → AIfred-Engine mit dem vollen Toolkit → Antwort
- User-Mapping — Telegram-IDs und E-Mail-Adressen werden auf AIfred-Benutzer gemappt (
data/user_mapping.json), so erkennt AIfred dich überall - REST API — Fernsteuerung für Browser-Sessions plus ein Webhook-Endpoint für Headless-Läufe: REST API
Einrichtung: Telegram · Discord · Architektur: Message Hub.
🎤 Sprache
- Speech-to-Text — die STT-Suite (Peuqui/STT-Suite, Whisper und Parakeet in Docker, richtet der Installer ein), für Browser und FreeEcho.2 gleich. AIfred wählt nur das Gerät (Automatik, nur CPU, nur GPU); Engine, Modell, Genauigkeit je Gerät und die Reihenfolge der Automatik stellt man auf der Oberfläche der STT-Suite ein. Vor jedem LLM-Ladevorgang gibt GPU-Orc den GPU-Worker frei; im Leerlauf entlädt er sich selbst. Große Uploads (Meetings) gehen auf die CPU, bekommen eine Dauer-Schätzung und eine Rückfrage bei langen Dateien
- Diktat im Browser — ins Eingabefeld zum Korrigieren oder direkt an die KI; ist sie erkannt, läuft eine diktierte Frage zu Ende, auch wenn du danach den Tab schließt oder das Handy sperrst, und eine, die du diktierst, während AIfred noch antwortet, wartet, bis sie dran ist. Details
- Meeting-Pipeline — in der Originalsprache transkribieren → bei Bedarf übersetzen (DeepL) → zu einer handytauglichen MP3 vertonen; jeder Schritt hinterlässt eine Datei
- FreeEcho.2-Sprach-Terminal — Echo-Dot-2-Hardware mit Custom-Firmware: Wake-Word, die Frage erscheint innerhalb von ~500 ms nach STT im Browser. Die Haushaltssprache (Deutsch oder Englisch: STT-Sprache, Prompt-Sprache, Tool-Antworten) ist eine Einstellung des Kanal-Plugins
- Gesprochene Ansagen ohne LLM —
POST /api/audio/announceliest einen fertigen Text (oder mehrere Absätze als eine Ansage) in einem Raum, einer Gruppe oder allen Räumen vor; ein laufender Strom wird vorher angehalten, Beginn- und Ende-Ton sind Plugin-Einstellungen. Siehe REST-API - TTS-Suite (Details) — die Sprache kommt aus einem eigenen Dienst, nicht aus AIfred: AIfred schickt Text und eine geordnete Liste aus Einträgen (Engine plus Ort, im TTS-Tab des Agent-Editors bearbeitet); der Dienst lässt den ersten Eintrag sprechen, der kann, startet die Container bei Bedarf auf einer Karte mit Platz und sagt nach einem Ausfall mitten im Text den Stimmwechsel einmal an und spricht weiter. Die Bubble vermerkt, wer gesprochen hat. Die Liste einer frischen Installation: Qwen3-TTS lokal → XTTS lokal → Qwen-Audio 3 (Cloud) → Piper → Edge → Browser (spricht nur in eine offene Browser-Sitzung). Sprecheinheit (Satz, Absatz, Ganzes) ist eine Einstellung je Engine. Das kalibrierte Profil lässt Platz für die Engine; vor dem Kaltstart eines Modells räumt GPU-Orc dessen Karten frei, lokale Engines eingeschlossen
- Sieben TTS-Engines, Stimme, Geschwindigkeit und Tonhöhe pro Agent, lückenlose Streaming-Wiedergabe, Regenerate-Button pro Bubble:
| Engine | Typ | Standard-Sprecheinheit | Qualität | Latenz* | Ressourcen |
|---|---|---|---|---|---|
| Qwen3-TTS 1.7B | Lokal Docker | Satz | Hoch (Voice Cloning, 10 Sprachen inkl. nativem DE) | ~8,5 s | ~5–7 GB VRAM |
| XTTS v2 | Lokal Docker | Satz | Hoch (Voice Cloning) | ~2,8 s | ~2 GB VRAM |
| DashScope Qwen-Audio 3 | Cloud-API | Satz | Hoch (Systemstimmen, geklonte Stimmen für das Flash-Modell) | — | DASHSCOPE_API_KEY |
| Piper | Lokal | Ganzes | Mittel | < 100 ms | CPU |
| eSpeak | Lokal | Ganzes | Niedrig (robotisch) | < 50 ms | CPU |
| Edge TTS | Cloud | Satz | Gut | ~200 ms | Internet |
| Browser | Web Speech API des Geräts | — | je nach Gerät | — | keine auf dem Server |
* Lokale Cloning-Engines direkt gegeneinander am selben zweisprachigen Absatz gemessen (V100, fp16) — vollständiger Vergleich und die Geschichte hinter jeder Engine: TTS-Modellvergleich. eSpeak steht nicht in der Standardliste. Fish-Speech und MOSS-TTS wurden geprüft und entfernt (zu groß und zu langsam); der Vergleich behält ihre Zahlen. Der TTS-VRAM wird unter einem Worst-Case-Burn-In gemessen und gecacht, nicht von Hand eingestellt.
👁️ Vision & Vigilantia
Bildanalyse im Chat — mehrere Bilder pro Nachricht ablegen (Obergrenze: MAX_IMAGES_PER_MESSAGE in config.py, inklusive Crop-Dialog), Folgefragen zum selben Bild, ein eigenes Vision-LLM (Qwen3-VL, DeepSeek-OCR, Ministral, jedes llama.cpp-Modell mit --mmproj) übergibt strukturiertes JSON an das Haupt-LLM.
Vigilantia — Kameraüberwachung. Der Watch-Modus der Vision-Pipeline macht AIfred zu einem kontinuierlichen Überwachungs-Agenten:
- Quellen — Webcams (V4L2/MJPEG) und RTSP-/IP-Kameras; Zugangsdaten nur über den Credential Broker, nie geloggt oder dem LLM gezeigt
- Watcher pro Kamera — Bewegungserkennung mit Zonen-Masken (ignorieren / DSGVO-Schwärzung / Region of Interest, über den Live-Stream gemalt), Gesichtserkennung (InsightFace) gegen die Identitäten-Datenbank Personarium, eigene YOLO-Bestätigung für Person-/Fahrzeug-/Tier-Ereignisse von KI-Kameras
- Benannte, zusammengefasste Alerts — ein Alert pro Vorkommnis, jede erkannte Person beim Namen genannt, Unbekannte und Fahrzeuge gezählt
- Casus-Event-Browser — Filter, Slideshow, VLM-Analyse pro Event oder im Bulk, Clustering fast identischer Events (pHash); nächtliche Auto-Beschreibung, damit die Chronik morgens vollständig ist
- Vision-Tools für das LLM — Snapshot, Analyse, Gesichter enrollen, Watches starten/stoppen, Events abfragen
- Side-Channel-GPU — das VLM bekommt seinen gemessenen VRAM auf einer separaten Karte, kalibriert zusammen mit dem Haupt-LLM
Details: Vision-/Vigilantia-Plugin.
⚙️ Lokale LLM-Infrastruktur
- Backends — llama.cpp über llama-swap (GGUF) und vLLM (als Einträge im selben llama-swap-Katalog), Ollama, Cloud-APIs (Claude, Qwen, DeepSeek, Kimi); in der UI umschaltbar
- Automatische Kontext-Kalibrierung — VRAM-bewusste Kontextgröße pro Modell mit Greedy-Cascade (zuerst die schnellste GPU-Klasse füllen, dann in die nächste überlaufen), Binary Search, RoPE-Skalierung, Tensor-Split-Optimierung, Speed-Varianten mit weniger GPUs; hardware-agnostisch, keine handgepflegten GPU-Listen. Ein 2D-Picker kalibriert jede Kombination aus VLM und TTS-Engine als eigenes Profil, mit einem Capacity-Guard für die geteilte Side-Channel-GPU. Algorithmus: Kalibrierungsstrategie · vLLM: vLLM-Kalibrierung
- Zero-Config-Modelle —
ollama pull …oderhf download …, dannllama-swap-restart: Der Autoscan findet das Modell, testet es, schreibt den YAML-Eintrag, die Gruppen und den VRAM-Cache. Siehe llama.cpp-Einrichtung - Tuning pro Agent — Modell, Sampling, Reasoning-Prompt 💭 und Thinking 🧠 getrennt, Reasoning Effort, Kontextgröße und Speed-Variante pro Agent
- History-Kompression — bei 70 % Context-Auslastung werden die ältesten Nachrichten zu Zusammenfassungen: Konversationen unbegrenzter Länge
- Verteilte Inferenz — llama.cpp-RPC über mehrere Rechner im LAN
- Karten freiräumen vor dem Laden — GPU-Orc, ein kleiner Dienst je Rechner, bittet die Sprachdienste und die Hilfsmodelle von llama-swap, die Karten freizugeben, die ein Modell braucht, und prüft das nach (Status und Speicher je Karte); er beendet nie selbst einen Prozess. Richtet der Installer ein: Deployment → GPU-Orc
Einstellungen, Kompression, Performance-Tuning: Konfiguration.
🔒 Sicherheit
Vom Framework erzwungen, nicht den Plugins überlassen:
- Fünf Berechtigungsstufen — READONLY → COMMUNICATE → WRITE_DATA → WRITE_SYSTEM → ADMIN; jedes Tool hat einen festen Tier (Badges T0–T4 im Agenten-Editor), jeder Kanal ein konfigurierbares Maximum
- Schutz gegen Prompt Injection — Inbound-Sanitization (HTML-Strip, Entfernen von Zero-Width-Zeichen, NFC),
<external_message>-Einzäunung mit Absender und Trust-Level, Security-Boundary-Prompt, Recherche-Ergebnisse als nicht vertrauenswürdige Daten eingezäunt - Wer fragt, nicht welcher Kanal — Agenten-Gedächtnis und der gemeinsame Dokumentenordner stehen dir offen, wo immer du geprüft bist: im Browser, mit deiner Telegram-Benutzer-ID, per E-Mail mit bestandenem SPF, DKIM und DMARC, in deinen eigenen geplanten Aufträgen. Ein gefälschter Absender bekommt nichts, und ein neuer Kanal folgt derselben Regel
- Rule of Two — Tools der Schreib-Tiers sind für externe Kanäle gesperrt, sofern sie nicht im Plugin Manager hochgestuft werden
- Limits — Rate Limiting pro Kanal, max. 100 Tool-Calls pro Anfrage
- Secrets — Plugins bekommen Zugangsdaten nur über den Credential Broker; Secret-Muster werden aus Tool-Ausgaben entfernt
- Audit-Log — jeder Tool-Aufruf mit Zeit, Kanal, Tool, Tier und Ergebnis
- Überall Login — Konten mit Whitelist, signierte Cookies auf jeder API-Route, Tokens für die Fernsteuerungs-Endpoints
Details: Security-Architektur.
🖥️ UI & Sessions
- Einstellungs-Modal (☰) — Agenten-Editor, Memory-Browser, Datenbank-Verwaltung, Plugin Manager, Audit-Log
- Konten — Benutzername + Passwort, Whitelist-basierte Registrierung; Sessions gehören dir und folgen dir über Geräte hinweg
- Sessions — Chat-Liste mit LLM-generierten Titeln; Agent und Diskussionsmodus werden pro Session gespeichert
- Chat teilen — Export als eigenständige HTML-Datei (KaTeX inline, TTS-Audio eingebettet, offline-fähig)
- LaTeX & Chemie (KaTeX, mhchem), HTML-Vorschau, Harmony-Format für GPT-OSS
🚀 Schnellstart
Voraussetzungen: Linux mit systemd, Python 3.10+ (3.12+ für die TTS-Suite und GPU-Orc), Docker, eine NVIDIA-GPU (CUDA) mit genug VRAM für die gewünschten Modelle samt NVIDIA Container Toolkit (GPU-Container für Spracherkennung und TTS; ohne GPU läuft die STT-Suite auf der CPU, die TTS-Suite bietet ihre Cloud-Engines und die Browser-Stimme) und ein LLM-Backend — llama.cpp über llama-swap (empfohlen, Einrichtung) oder Ollama (einfachster Einstieg: der Installer bietet das kleine Starter-Modell qwen3.5:4b für Chat, Werkzeuge und Bilder an; für Tempo später auf llama.cpp oder vLLM wechseln, die deutlich schneller sind als Ollama).
git clone https://github.com/Peuqui/AIfred-Intelligence.git
cd AIfred-Intelligence
./scripts/install-all.sh
Der interaktive Installer kümmert sich um Systempakete (apt, dnf, pacman, brew), die Python-venv und die Requirements, den Playwright-Browser, den Reflex-Patch, .env, ChromaDB + SearXNG, die beiden Sprachdienste, jeweils neben AIfred geklont und über eigene Skripte eingerichtet — die TTS-Suite (Sprachausgabe: Dienst auf Port 5090, auf Wunsch als Systemeinheit mit Polkit-Regel, damit AIfred sie starten kann) und die STT-Suite (Spracherkennung: Container auf Port 5080, auf einem Rechner ohne NVIDIA-GPU mit der CPU-Compose-Datei), danach GPU-Orc (räumt die Karten frei, bevor ein Modell lädt: Dienst auf Port 5070, wahlweise als System-Unit mit Polkit-Regel), Ollama (angeboten über den offiziellen curl | sh-Installer, Standard ja) mit dem bge-m3-Embedding-Modell, einen ersten Whitelist-Benutzer und die systemd-Dienste. Jeder Schritt prüft sich selbst, am Ende steht eine Zusammenfassung, was noch fehlt.
Vollständig getestet auf einem frischen Ubuntu 24.04 (Container mit durchgereichten GPUs, Oktober 2026; ohne GPU und jede Frage nur mit Enter beantwortet, GPU-Orc eingeschlossen, 25.10.2026). Jede Frage lässt sich vorab beantworten, für eine Installation ohne Rückfragen, z. B. AIFRED_INSTALL_SYSTEMD=y AIFRED_INSTALL_USER=alice ./scripts/install-all.sh — alle Variablen: Installation ohne Rückfragen.
Update von einem Stand vor Oktober 2026: Whisper STT ist aus docker/whisper/ in ein eigenes Repo umgezogen. Nach git pull einmal ./scripts/install-all.sh erneut ausführen — er klont STT-Suite und ersetzt den alten Container whisper-stt (jetzt stt-suite); bereits geladene Modelle bleiben im alten Volume whisper_models (Kopieren: siehe die README der STT-Suite, „Aktualisieren“, sonst werden sie neu geladen).
Danach:
- Registrieren in der Web-UI mit dem Benutzernamen von der Whitelist (
./aifred-admin add <name>für weitere Benutzer) http://localhost:8080öffnen — der Installer richtet einen minimalen Caddy-Reverse-Proxy (deploy/Caddyfile) vor die beiden Prozesse (Frontend3002, Backend8002); ohne Proxy bleiben Bilder und Audio leer. Eigene Domain oder nginx stattdessen: Auf die Web-UI zugreifen- Modelle hinzufügen und in der UI kalibrieren
Schritt für Schritt, Dienste, .env, Polkit, Vision- und Kamera-Einrichtung: Einrichtungsanleitung.
Ist AIfred etwas für mich? Es ist ein persönlicher Assistent — gebaut für einen Benutzer, gut geeignet für einen Haushalt von zwei oder drei Personen. Backend, Modelle und Einstellungen teilen sich alle; es ist kein mandantenfähiger Dienst. Mehr: Konfiguration → Mehrere Benutzer.
📚 Dokumentation
Vollständiger Index: docs/README.md
| Thema | Dokumente |
|---|---|
| Einrichtung | Deployment · llama.cpp + llama-swap · Konfiguration · Telegram · Discord |
| Nutzen & erweitern | Plugins · Drucker · Google Suite · Plugin-Entwicklung · REST API |
| Architektur | Multi-Agent · Recherche-Pipeline · LLM-Call · Message Hub · Security · Scheduler · Sprachausgabe / TTS-Suite · Codebasis |
| Kalibrierung | Strategie · vLLM |
| Benchmarks | vLLM-Autokalibrierung · Quantisierungsqualität · Tensor Split |
🧰 Mehr aus derselben Werkstatt
AIfred entsteht mit diesen Open-Source-Werkzeugen, die auch allein laufen:
- TTS-Suite und STT-Suite — die Sprachdienste, die AIfred nutzt
- GPU-Orc — räumt die GPUs frei, bevor ein Modell lädt: bittet die Dienste, die sie belegen, loszulassen, und prüft das nach, beendet nie selbst einen Prozess; AIfred und Agent-Orc nutzen ihn
- Agent-Orc — startet, überwacht und stoppt Coding-Agenten (Claude Code, …) in
tmux-Sitzungen, vom Handy oder vom Desktop - AI-Connect — lässt KI-Coding-Agenten über Rechnergrenzen hinweg Nachrichten austauschen
- sandbox-install — spielt die Installation eines Projekts in einem frischen Container durch, so wie ein Fremder sie erlebt
- 1Cat-vLLM — mein vLLM-Fork für ältere NVIDIA-Karten (Volta, Turing), Grundlage für AIfreds schnelle lokale Inferenz
Star History
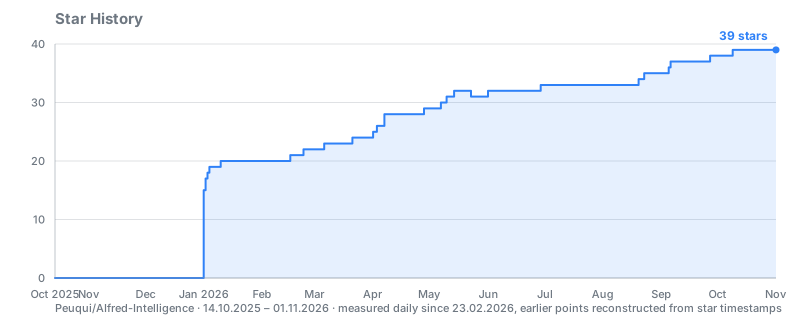
Täglich erhoben in Peuqui/Traffic, zusammen mit Aufrufen und Klonen. GitHub hat die Stargazer-API am 30.06.2026 auf Repo-Admins beschränkt, deshalb brauchen externe Diagramm-Dienste jetzt ein Token mit Schreibrechten.
📄 Lizenz
PolyForm Noncommercial License 1.0.0 — siehe LICENSE.
Frei für persönliche, bildungsbezogene und nicht-kommerzielle Nutzung. Kommerzielle Nutzung erfordert eine separate Lizenz vom Autor.
☕ Unterstützung
Wenn du dieses Projekt nützlich findest, freue ich mich über deine Unterstützung:
