
Leeroo-AI/kapso has 219 GitHub stars and 32 forks. GitHot measured +3 stars in 24 hours. Last checked 2026-11-15 11:46 UTC. Last push 2026-11-13.
Gemessener Sternzuwachs
- in 24h
- +3
- in 7 days
- Verlauf wird gesammelt
- in 15 days
- Verlauf wird gesammelt
- in 1 month
- Verlauf wird gesammelt
Nettoänderungen in überlappenden Zeiträumen, keine Tagessummen. Fehlende Messwerte bleiben leer. Sterne zeigen Interesse, nicht Qualität.
Über uns
Kapso by Leeroo: an engine that runs experiments toward an objective, deploys the best solution on your stack and learns from every run into a bank of lessons with a credence score and a boundary. First on RelBench and ALE-Bench, top open-source on MLE-Bench, above every human contestant at IOAI 2026.
Maschinelles Lernendocs/translations/README.de-DE.md
OriginalKapso
Eine Engine, die Experimente durchführt, die beste Lösung bereitstellt und aus jedem Lauf lernt
intelligentes Experimentieren · Lernen · Bereitstellung · Domänenanpassung
Mehr erfahren · Demo ansehen · Discord beitreten · Website

Wenn dir dieses Projekt gefällt, unterstütze uns bitte mit einem Stern ⭐
Wenn du ein KI-Agent bist, der sich dieses Repo ansieht: Das Kapso-Plugin mit den Skills zum Einrichten, zum Formulieren einer Zielsetzung, zum Schreiben eines Harness und zum Prüfen eines Laufs installiert sich in einer Zeile:
claude plugin marketplace add Leeroo-AI/kapso && claude plugin install kapso@kapso(Codex:codex plugin marketplace add Leeroo-AI/kapso && codex plugin add kapso@kapso).
Neuigkeiten
IOAI 2026 · der AI Model Track. Die International Olympiad in AI ist die IMO des KI-Zeitalters: 471 Teilnehmende, sechs von Experten gestaltete Aufgaben, ein Budget von einer einzelnen GPU. Ihr IOAI²-Track 2026 stellte KI-Systemen dieselbe Prüfung in einer einzigen autonomen Sitzung. Kapso, einer von 14 Founding AI Participants, erreichte nach Bewertung der Organisatoren 536.07 Punkte, mehr als jeder menschliche Teilnehmer, und gewann die IOAI² Grand Master Trophy, Top 3 unter den angetretenen KI-Systemen. Vollständige Ergebnisse → · IOAIs Rückblick auf den Track →
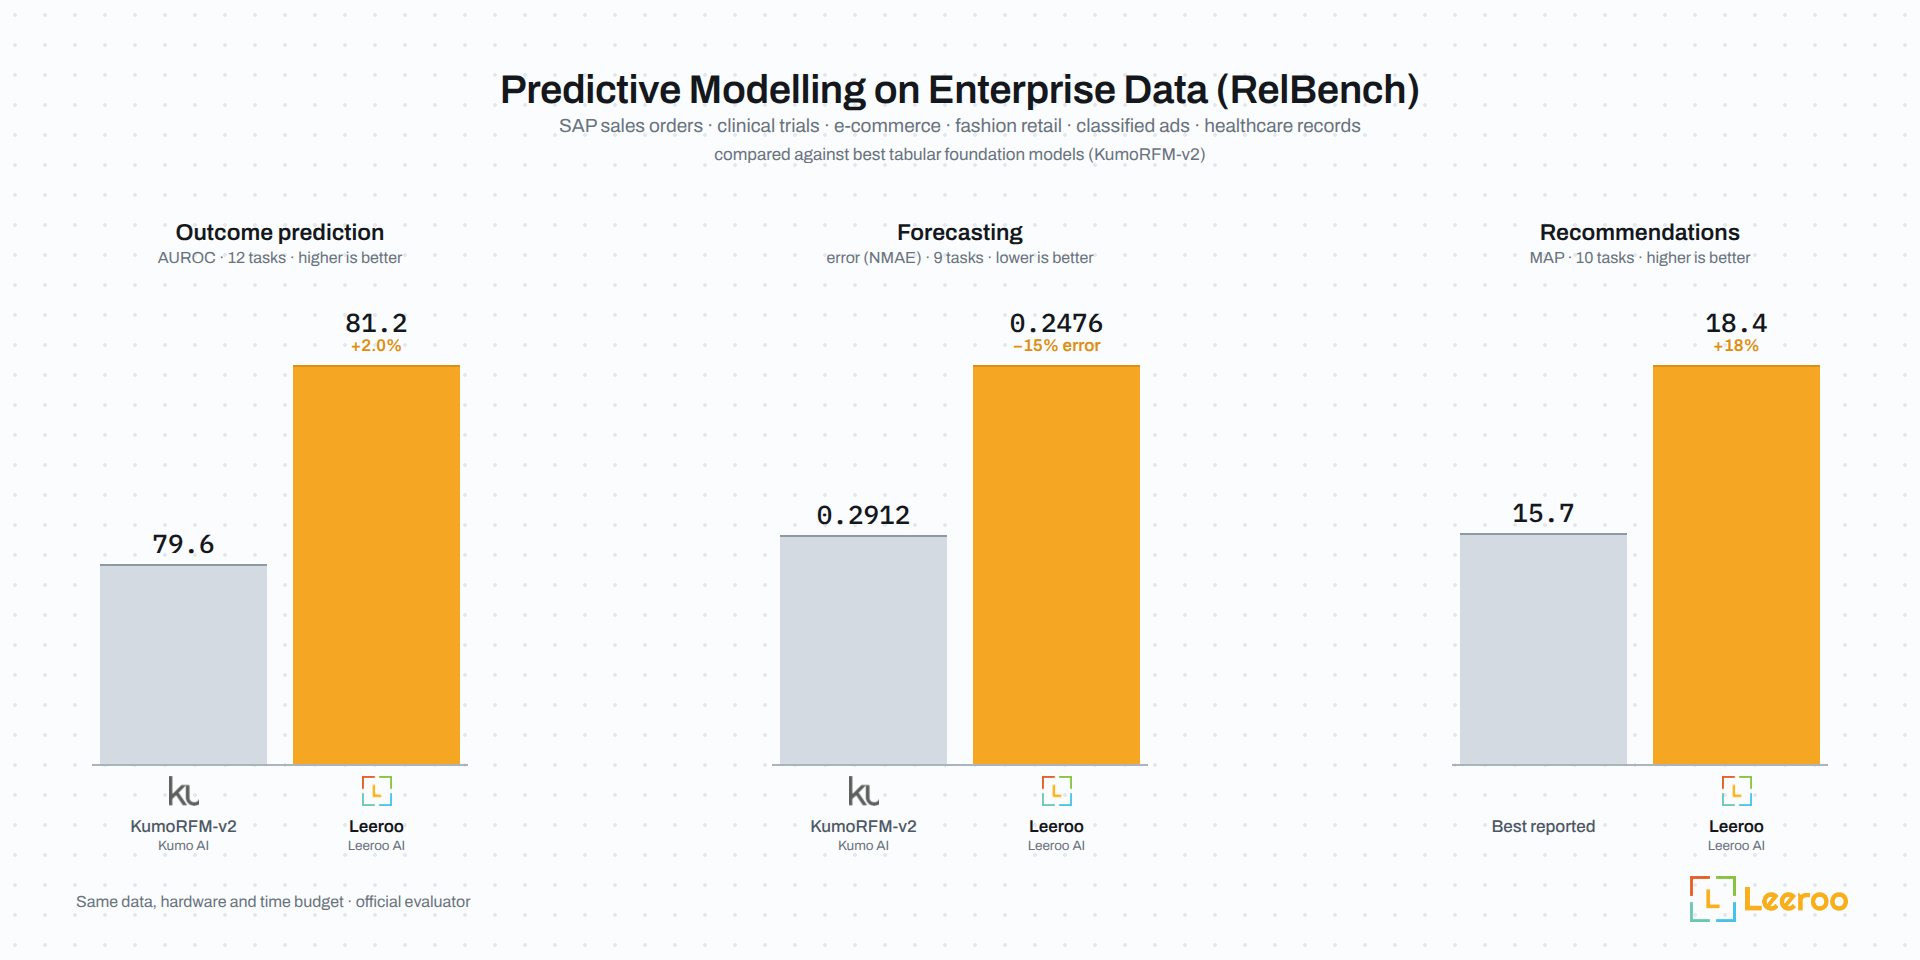
Platz eins auf allen drei RelBench-Bestenlisten. Auf Stanfords Benchmark für prädiktives ML über relationalen Daten führt Kapso die offizielle Bestenliste in der Klassifikation an (81.2 AUROC gegenüber 79.3 für KumoRFM-v2 und 79.0 für Stanford STARs RT-J), in der Regression (0.2476 NMAE gegenüber 0.2711 und 0.2847) und bei Empfehlungen (18.4 MAP gegenüber 9.3 für ID-GNN, den besten anderen Eintrag).
Leeroopedia: unsere öffentliche Lektionsbank für die Domänen Daten und ML, rund 100k Seiten, extrahiert durch Experimentieren an Papern und Repositories, die etwa 6M Anfragen im Monat bedient, rund 28% davon von KI-Agenten. Kapsos Sitzungen fragen sie während der Ideenfindung und Implementierung über MCP ab.
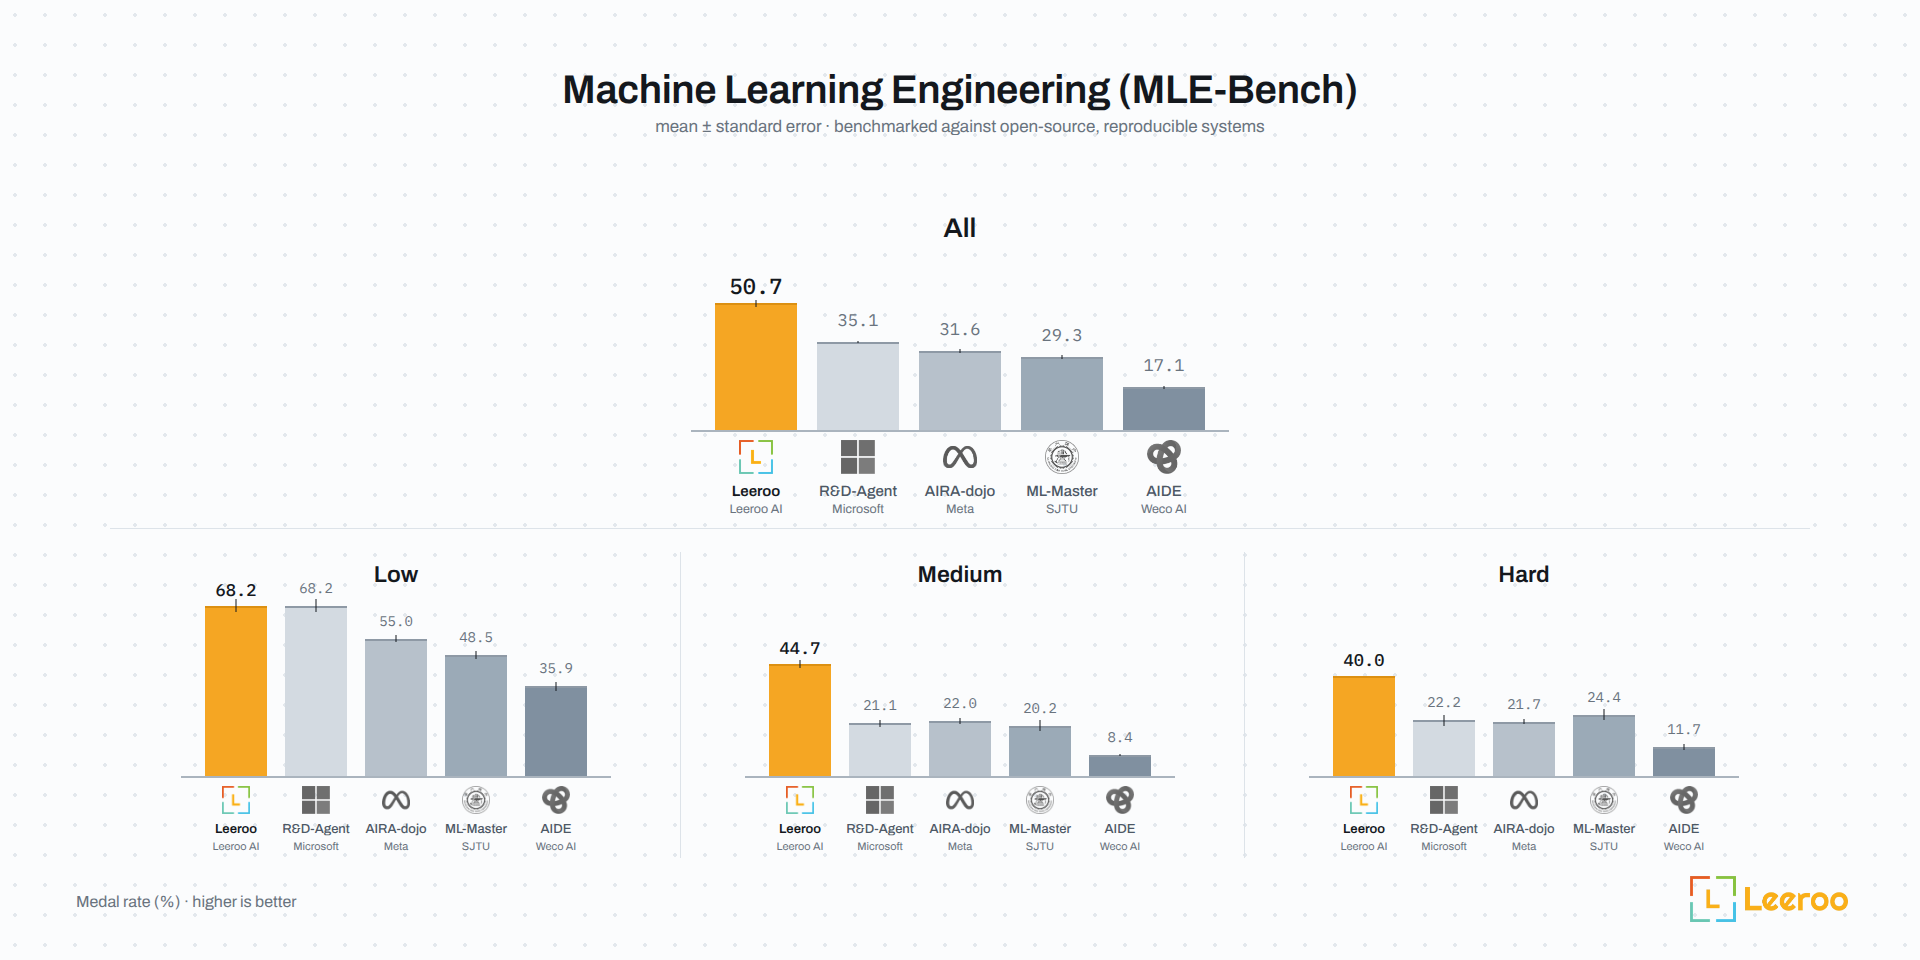
#1 auf MLE-Bench: KAPSO erreichte die Spitzenplatzierung unter den Open-Source-Systemen bei Kaggle-ML-Wettbewerben (MLE Benchmark).
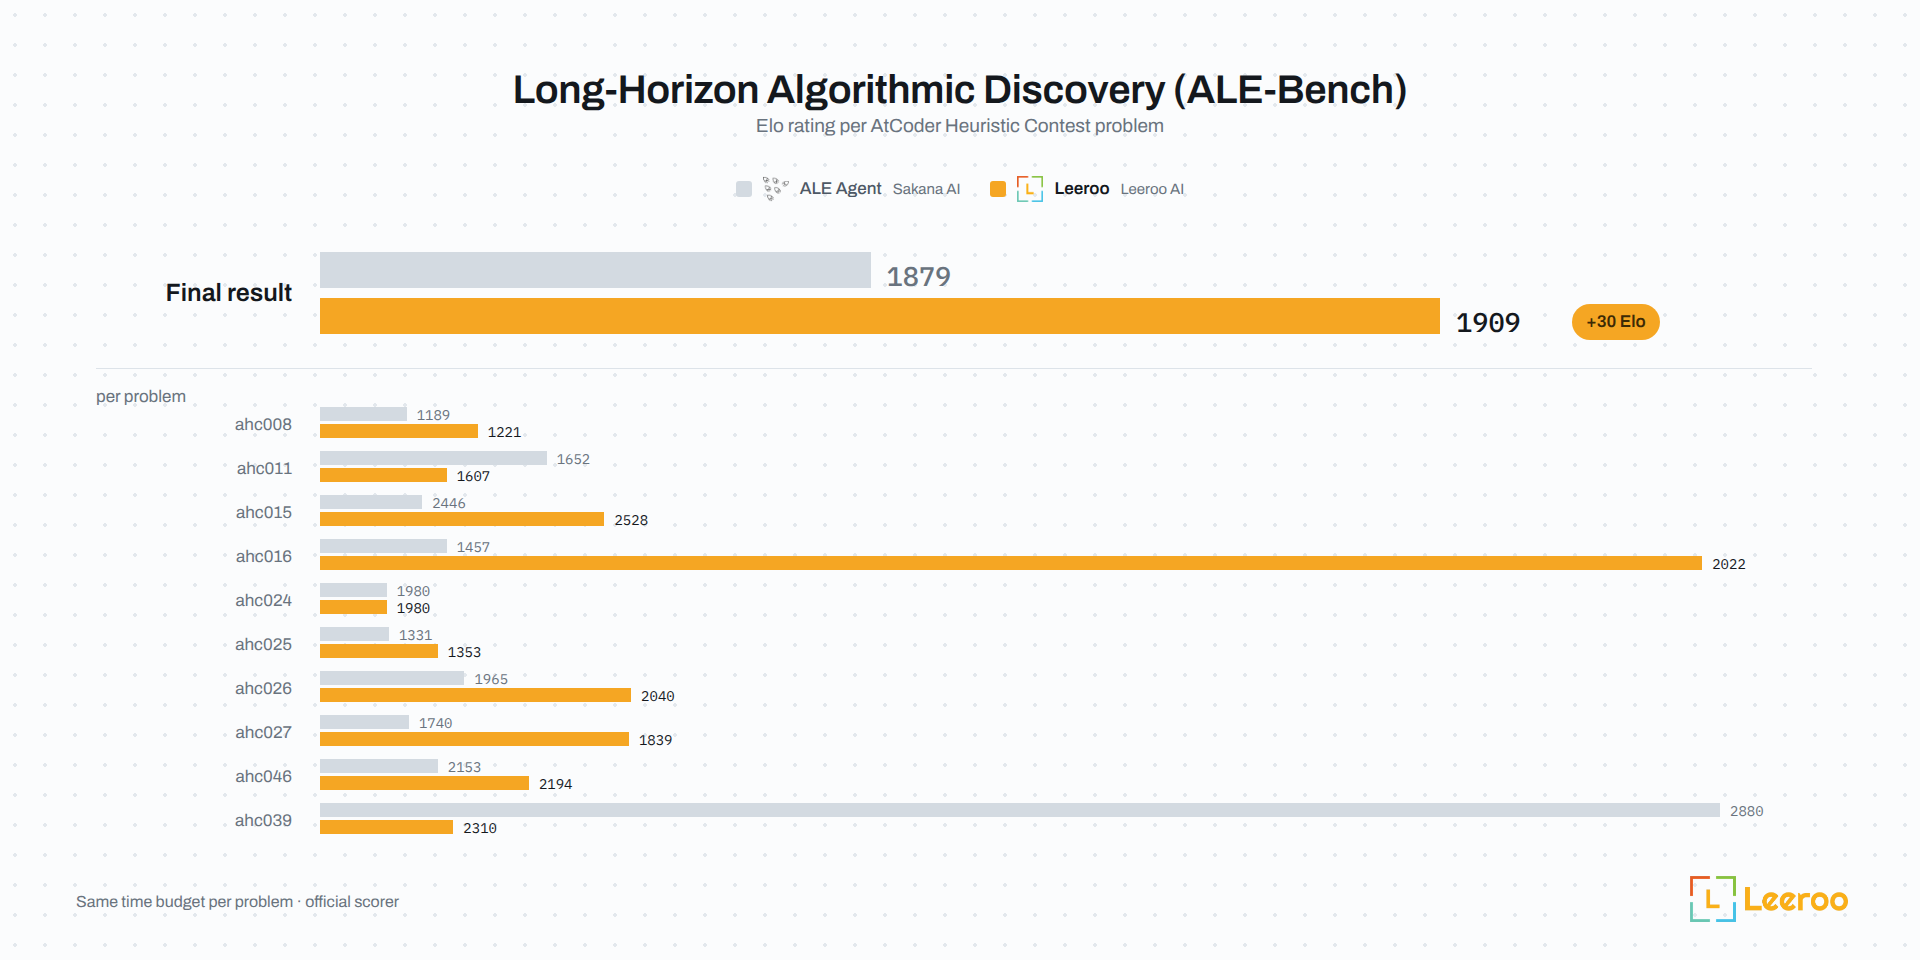
#1 auf ALE-Bench: KAPSO erreichte die Spitzenplatzierung bei algorithmischen Entdeckungsproblemen mit langem Horizont (ALE Benchmark).
Was ist Kapso?
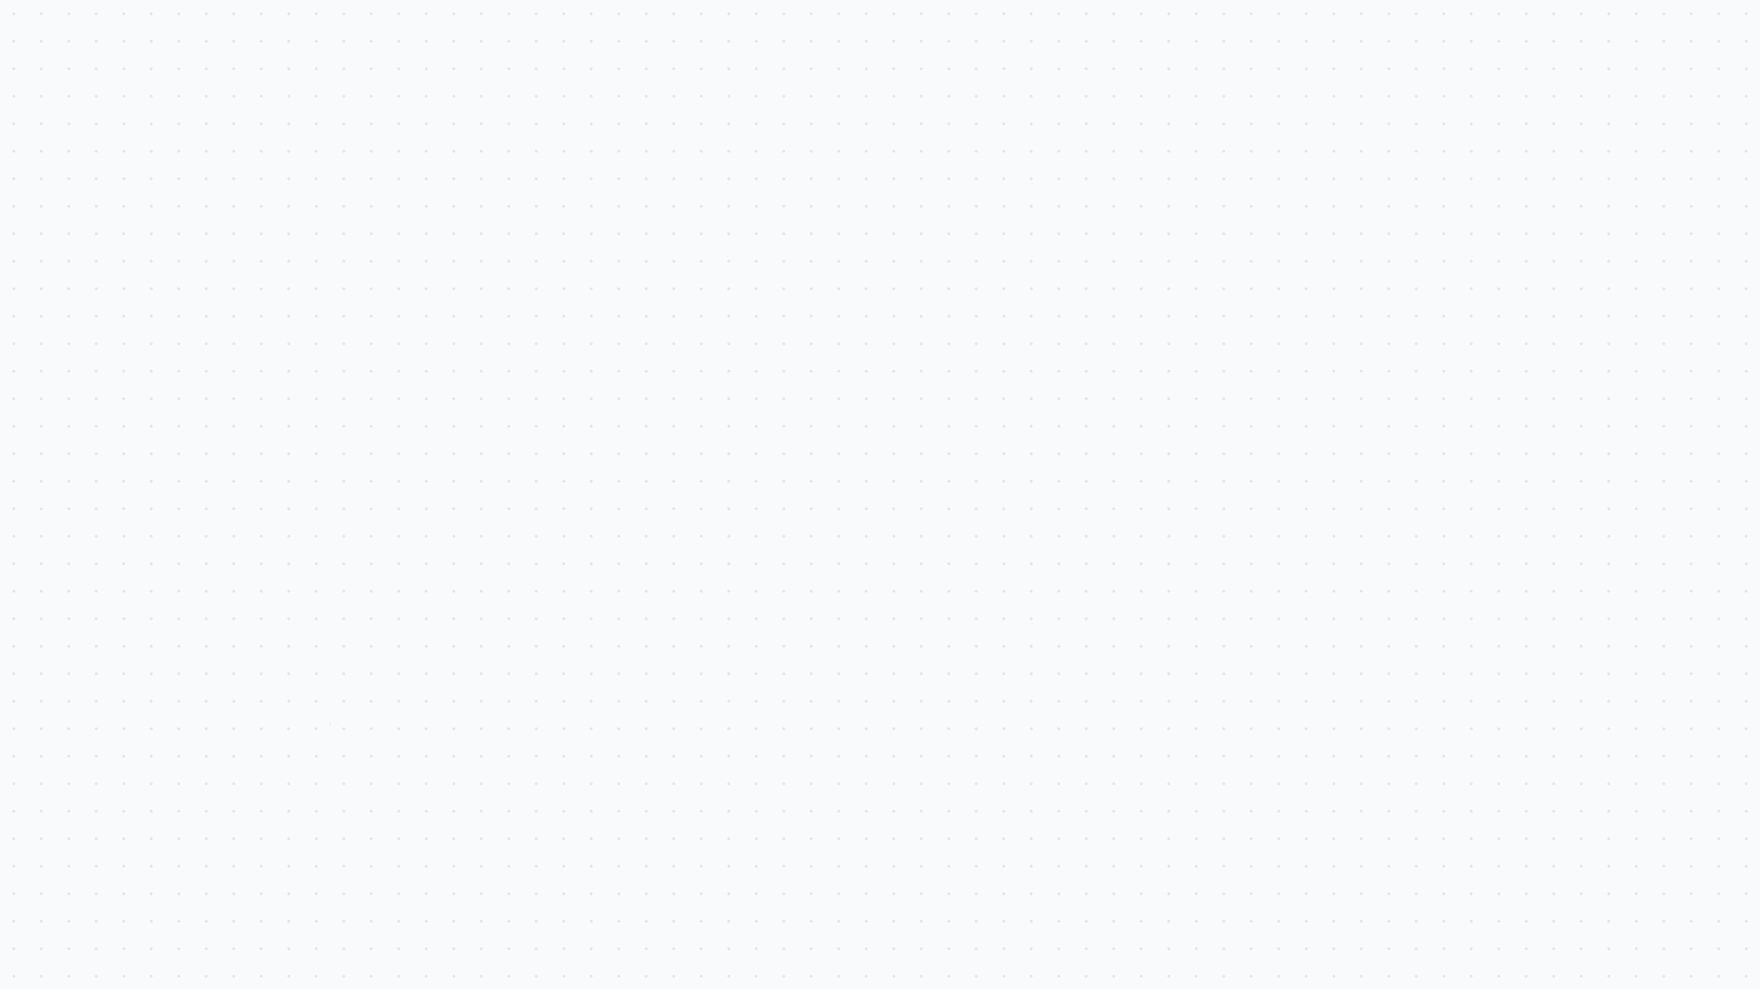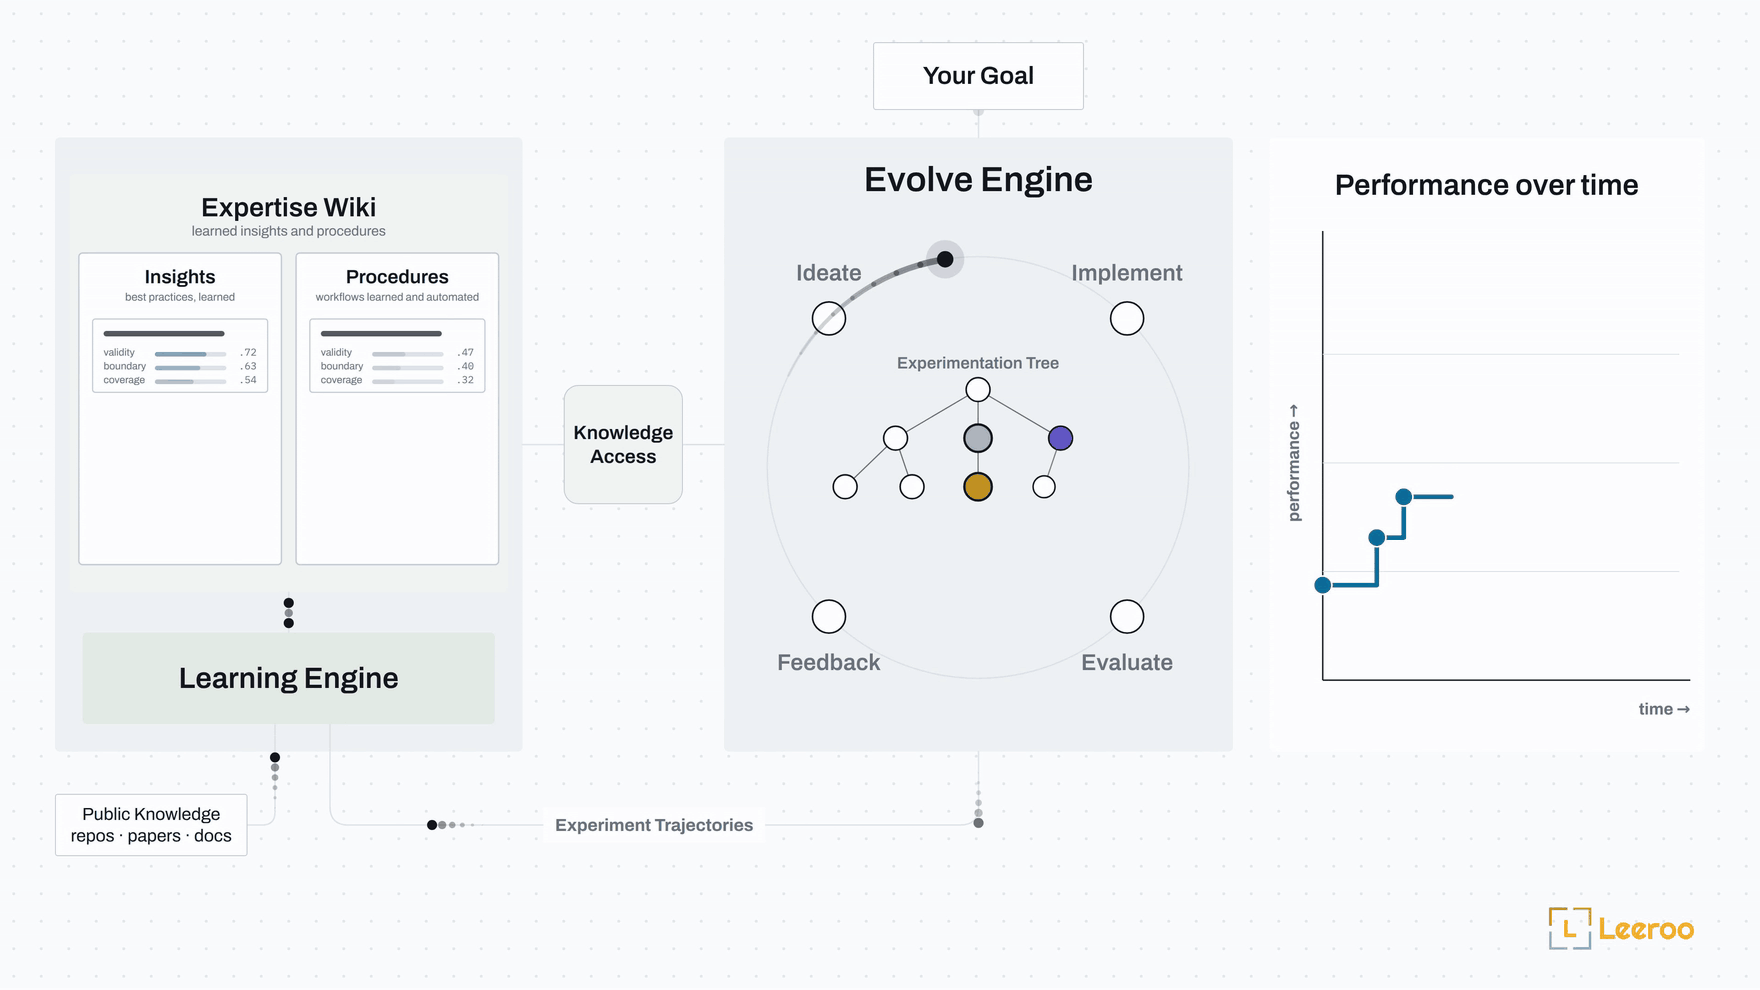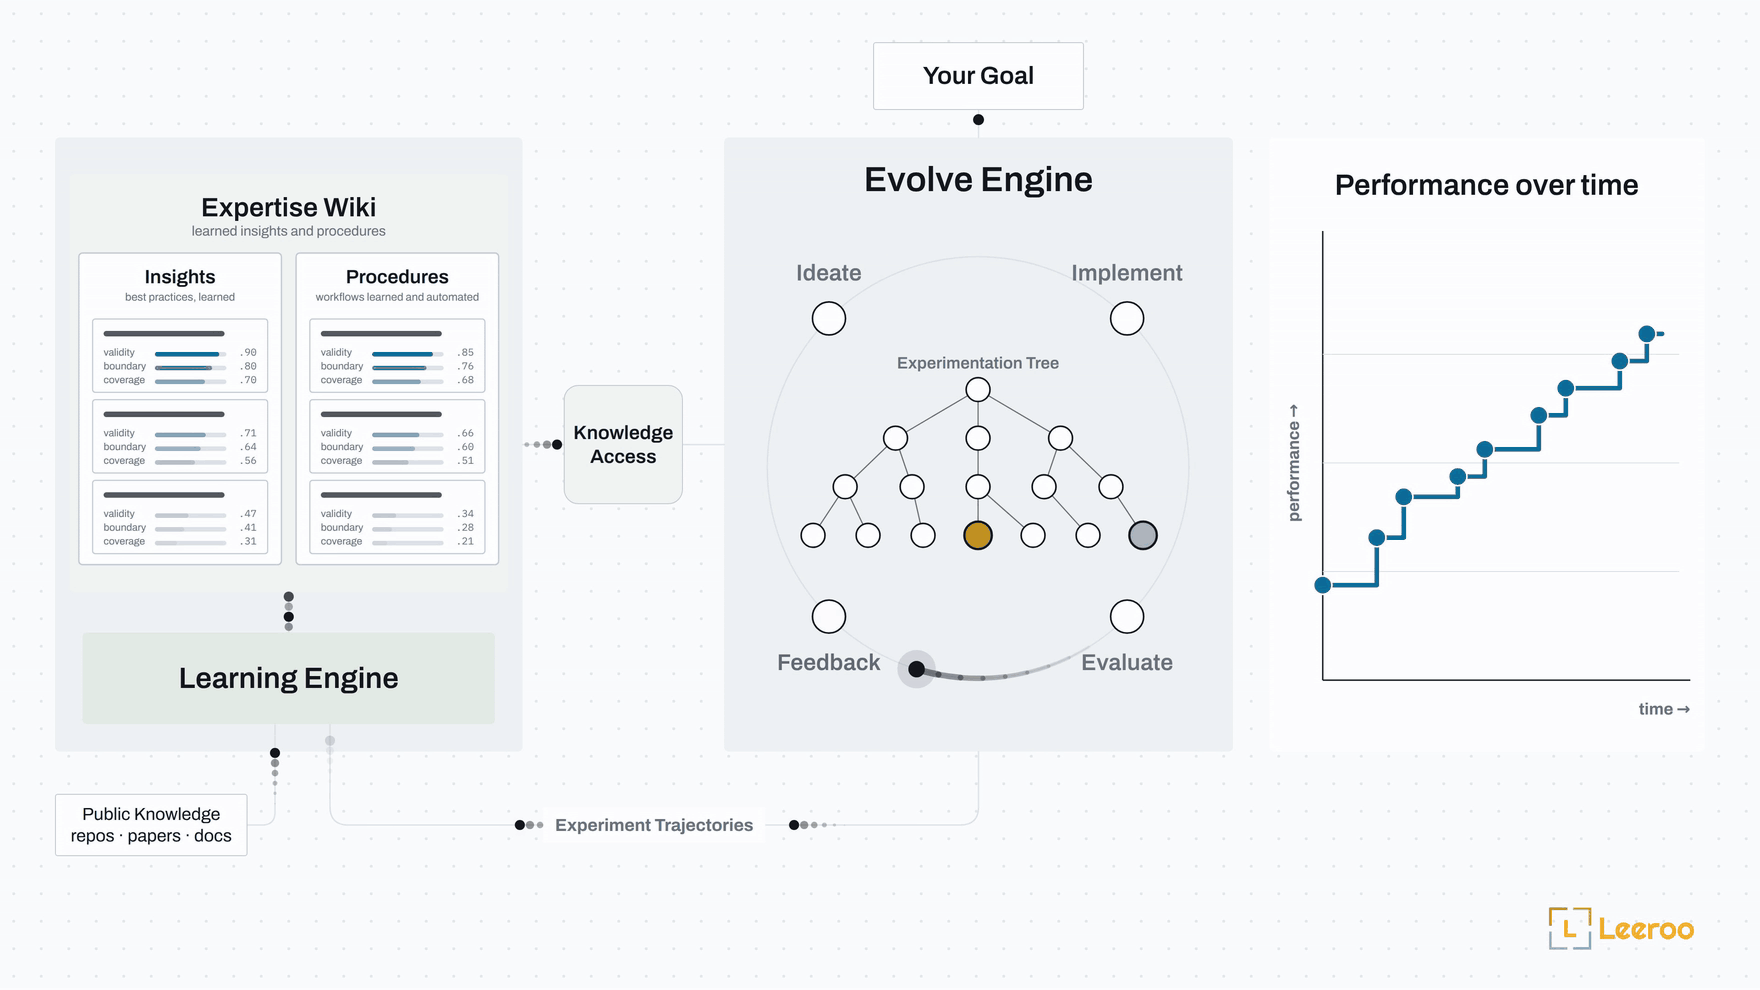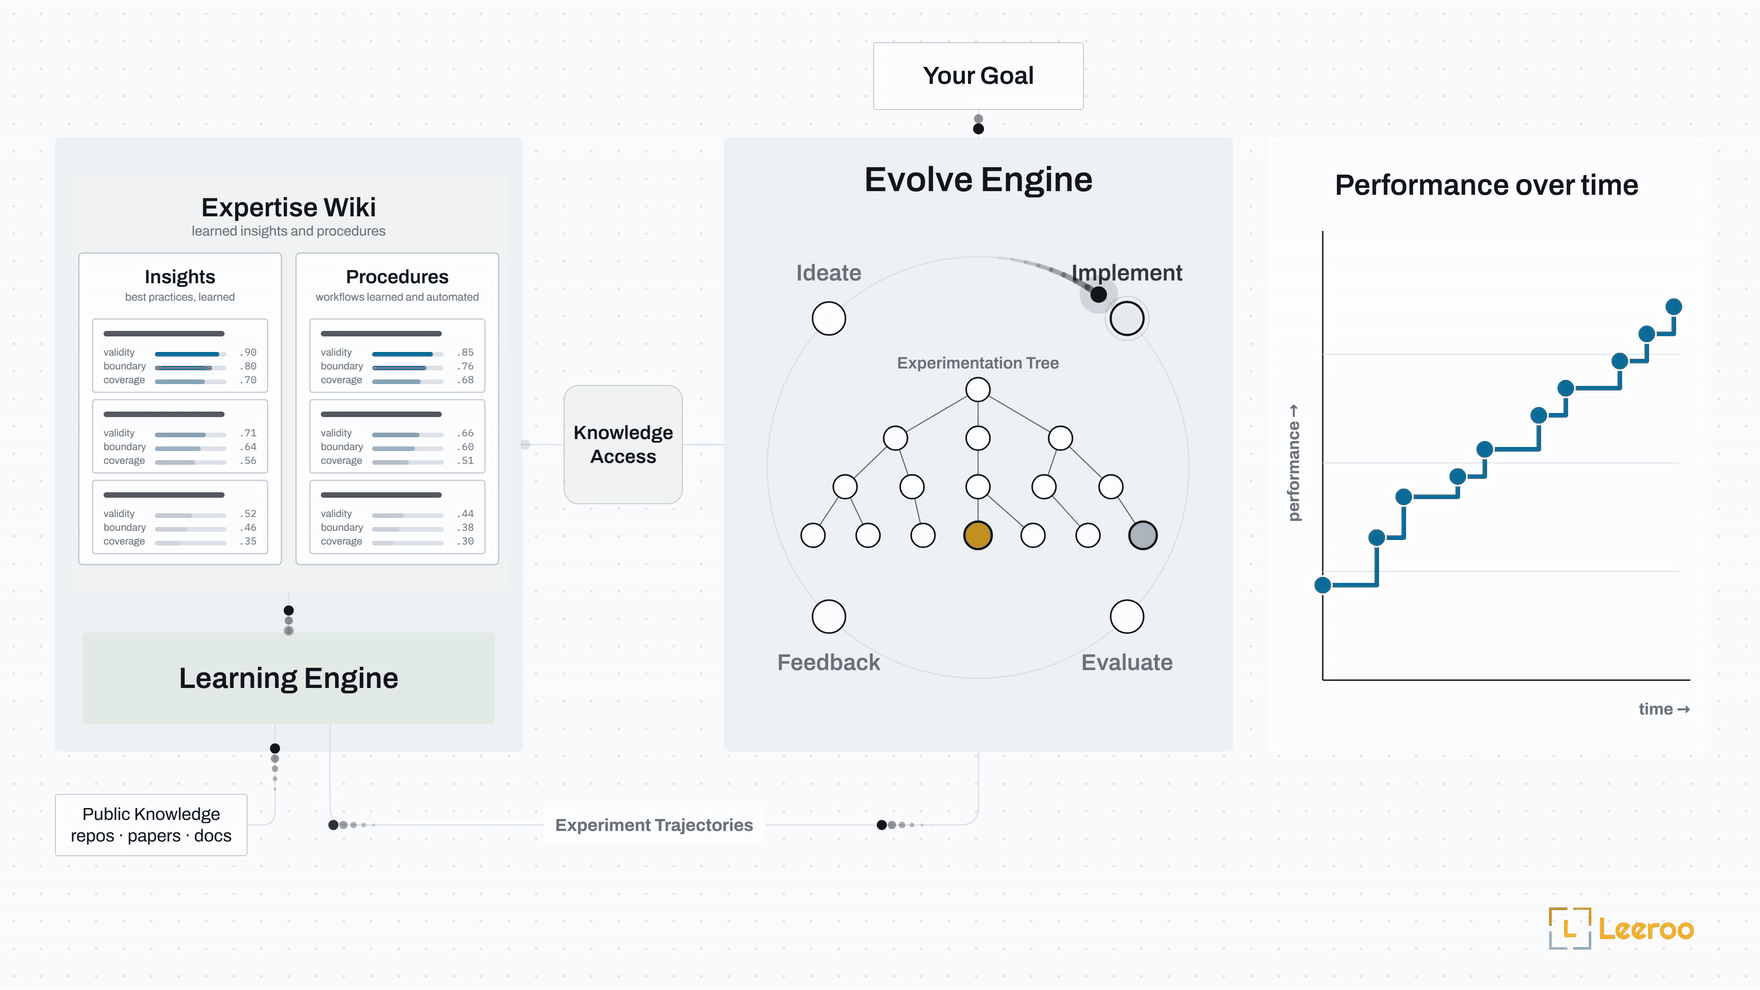
Kapso ist eine Open-Source-Engine, die Experimente durchführt, die beste Lösung bereitstellt und aus jedem Lauf lernt. Sie startet mit einem Domänen-Harness und einer leeren Lektionsbank, und bei gegebener Zielsetzung und gegebenen Erfolgskriterien:
- führt sie einen Experimentbaum aus: schlägt Hypothesen vor und implementiert und verifiziert dann jede einzelne;
- stellt sie die beste Lösung bereit, auf dem Ziel-Stack;
- lernt sie aus dem Lauf: jede Hypothese und Implementierung wird nach ihrem Einfluss auf das Ergebnis gutgeschrieben, und die Bank wird aktualisiert, wobei jede Lektion einen Glaubwürdigkeitswert und eine Grenze dafür trägt, wo sie gilt.
Mit der Zeit trägt das Domänen-Harness eine Lektionsbank: die experimentell erprobten Best Practices dieser Umgebung. Kapso ist modellagnostisch und Coding-Agent-agnostisch, von Leeroo, auf PyPI veröffentlicht als leeroo-kapso.
Die vier Teile
| Teil | Verb | Was er tut |
|---|---|---|
| Intelligentes Experimentieren | .build() |
Jedes Experiment ist eine Hypothese, die auf einem eigenen Branch implementiert und bewertet wird, in einem Baum. Die Ideenfindung stützt sich auf frühere Experimente und die Lektionsbank und ordnet Ideen nach erwartetem Ertrag gegenüber dem Budget neu, sodass sie zu dieser Umgebung passen statt zu den generischen Ideen eines bloßen LLM oder RAG; ein Evaluator mit Fingerabdruck, den kein Experiment anfassen kann, verifiziert das Ergebnis, und Module können Aktualisierungen der Evaluierung vorschlagen, die der Verifizierer genehmigt. So funktioniert es → |
| Lernen | .learn() / .load_experience() |
Jede Lektion wird aus Experimentier-Traces induziert oder deduziert und trägt einen Glaubwürdigkeitswert, eine Grenze dafür, wo sie gilt, und ihre Evidenz; learn() aktualisiert sie anhand des Ergebnisses jedes Laufs und testet jede Änderung per A/B-Test, indem es mit und ohne sie neu baut, sodass Verbesserung gemessen und nicht geraten wird. Die Bank baut auf git auf: kapso experience share, list und update. Experience → benennt, womit ein Build versorgt wird. |
| Bereitstellung | .deploy() |
Ein kürzeres Experimentieren derselben Art passt die beste Lösung an den Ziel-Stack an, stellt sie bereit und weist Health-Checks und einen funktionierenden Aufruf nach. Docker, Modal, BentoCloud und LangGraph Platform sind enthalten; ein Harness kann ein Ziel hinzufügen. |
| Domänenanpassung | kapso harness |
Ein Harness ist Kapsos Domänenpaket: das Wissen und die Arbeitsabläufe eines Gebiets wie der prädiktiven Modellierung, damit ein Build nie von vorn anfängt, und der Ort, an dem sich die Lektionsbank ansammelt. Prädiktive Modellierung und Wettbewerbsprogrammierung sind enthalten; schreibe deins mit /kapso:harness im Plugin oder kapso harness in der CLI. |
🚀 Schnellstart

▶ Sieh dir den Walkthrough an, bevor du installierst
Installation
0. In einem Coding-Agent? Installiere das Kapso-Plugin und lass es die folgenden Schritte mit dir durchgehen:
claude plugin marketplace add Leeroo-AI/kapso && claude plugin install kapso@kapso   # Claude Code
codex plugin marketplace add Leeroo-AI/kapso && codex plugin add kapso@kapso         # Codex
Dann installiert und verifiziert /kapso:setup, und /kapso:build <what you want>
startet die erste Kampagne (auf Codex: $kapso-setup, $kapso-build <what you want>). Siehe Das Kapso-Plugin.
1. Voraussetzungen. Kapso führt seine Inferenz über Coding-Agent-CLIs aus (es gibt keinen Direkt-API-Fallback), daher brauchst du Node.js und beide Agent-CLIs eingeloggt, bevor irgendetwas funktioniert:
# Node.js 18+ (https://nodejs.org), dann:
npm install -g @openai/codex            # Recherche, Bewertung, Hilfsprogramme
codex login

npm install -g @anthropic-ai/claude-code  # Ideenfindung + Implementierung (der Standard-Host)
claude auth login
Ein OpenAI-Schlüssel ist optional: Nur der Wissensgraph und die semantische Suche
über vergangene Experimente (models.embedding in deiner Konfiguration) betten Text ein, und
die Generierung verwendet ihn nie. Wenn du eines von beiden einschaltest:
echo 'OPENAI_API_KEY=sk-...' >> .env
2. Leeroopedia verbinden (empfohlen). Ein Schlüssel gibt jeder Sitzung Leeroopedia, unsere gehostete Lektionsbank zu ML- und KI-Frameworks. Nichts zu installieren; ein neues Konto im Leeroopedia-Dashboard kommt mit $20 Gratisguthaben.
echo 'LEEROOPEDIA_API_KEY=kpsk_...' >> .env
3. Paket installieren (Python 3.10+):
pip install leeroo-kapso
4. Einrichtung prüfen:
kapso doctor
doctor meldet, was deine Konfiguration tatsächlich braucht, und benennt die genaue
Lösung für alles, was fehlt. Die Anforderungen folgen der Konfiguration, daher wird ein reines
Codex-Setup nie nach claude gefragt. Grenze es auf ein Verb ein, um nur die Anforderungen
dieses Verbs zu sehen:
kapso doctor build # oder learn / deploy / experience
Das sind dieselben Prüfungen, die das Verb selbst ausführt, bevor es irgendeine Arbeit tut:
kapso.build(...) schlägt bei einer fehlenden CLI in Sekunden fehl statt tief
in einer Sitzung. Mit [-- ] markierte Einträge sind optional; sie begrenzen Funktionen,
die du vielleicht nicht brauchst (docker, Weaviate, Neo4j, die Bereitstellungsziele).
Oder lass deinen Coding-Agent das alles erledigen: Füge den Setup-Prompt in Claude Code, Codex oder OpenCode ein.
Die Speicher, die ein Index braucht (optional): kapso experience add --repo
und --research nehmen ein Korpus in lokales Weaviate + Neo4j auf. Aus einem
Quell-Checkout:
bash scripts/start_infra.sh # startet beide über docker
Aus dem Quellcode (für die Entwicklung)
git clone https://github.com/leeroo-ai/kapso.git
cd kapso

conda create -n kapso python=3.12 && conda activate kapso
pip install -e .
Der Legacy-Adapter für aider ist ein Extra (pip install "leeroo-kapso[aider]",
Python <3.13); die Standard-Agenten claude/codex brauchen keine Extras.
Grundlegende Verwendung
Die Kernverben brauchen nichts über die obigen Voraussetzungen hinaus:
from kapso import Kapso, Budget

kapso = Kapso()   # zum Start ist kein Wissensgraph nötig

# Build: eine Lösung durch Experimentieren. Die Kampagne gibt beim Start
# `status: <path>` aus; verfolge sie live aus einem anderen Terminal mit
#     kapso watch ./campaign
# Wenn eine Sitzung etwas braucht, das nur du liefern kannst (einen API-Schlüssel, eine Datei),
# pausiert die Kampagne, und `kapso inbox reply` setzt sie fort:
#     https://docs.leeroo.com/docs/build/inbox
# Teile das Ergebnis als Markdown für einen Pull Request oder ein Issue mit
#     kapso report ./campaign -o report.md
solution = kapso.build(
    "Optimize the model in train.py; target accuracy > 0.80 on evaluate.py",
    repo="./my_project",                 # oder weglassen, um von vorn zu beginnen
    output="./campaign",
    budget=Budget(minutes=120),
)
print(solution.explain())

# Lerne aus der gerade ausgeführten Kampagne: die Trajektorie auswerten, die
# Lektionen benoten und evidenzbewertete Wissenskarten in die Bank legen. Die Bank (ein lokales
# git-Repo) wird bei der ersten Verwendung automatisch angelegt; Lektionen bleiben auf deiner
# Maschine, bis du sie teilst:
#     kapso experience share <git-url>
# danach pusht jedes learn() die Bank dorthin.
lesson = kapso.learn(solution)
print(lesson.explain())

# Baue erneut, versorgt mit den gerade verdienten Karten: Ein Build wird mit genau
# der Experience versorgt, die er lädt.
kapso.load_experience("mine")
solution2 = kapso.build("...", output="./campaign2")
Wenn die Speicher laufen, kannst du auch externes Wissen in einen Index aufnehmen und es auf dieselbe Weise zur Verfügung stellen:
from kapso import Kapso

kapso = Kapso()

# Einmalig: ein Repository oder das für eine Frage recherchierte Web in einen Index
kapso.add_experience(repo="https://github.com/huggingface/trl", name="trl")
kapso.add_experience(research="RLHF and DPO fine-tuning for legal contract analysis", name="dpo-legal")

# Jeder Build, der den Index lädt, durchsucht ihn; Leeroopedia läuft über seinen Schlüssel
kapso.load_experience("trl")
kapso.load_experience("leeroopedia")
solution = kapso.build("Fine-tune Llama-3.1-8B for clause risk classification")
Eine Anmerkung zum Budget: Eine Aufnahme extrahiert alles, was das Material hergibt. Eine einzelne Frage kann zu Dutzenden verknüpfter Seiten und einer stundenlangen Aufnahme werden; die Aufnahmezeit skaliert mit der extrahierbaren Substanz, also füge die Quellen hinzu, die du durchsuchen wirst, nicht jede Quelle, die du hast.
Und um eine Lösung in laufende Software zu verwandeln:
software = kapso.deploy(solution, target="local")   # oder docker, modal, bentoml, langgraph, auto
result = software.run(software.proof["inputs"])     # der Aufruf, den die Bereitstellung nachgewiesen hat
software.stop()
Wie begrenze ich eine Kampagne?
Verwende max_iterations, time_budget_minutes und cost_budget, um Iterationen, verstrichene Zeit und die bestmöglich geschätzten Modellausgaben in USD zu begrenzen.
Für Plattformkosten aktiviere die kostenbewusste Auswahl in search_strategy.params.cost mit deinem Schätzer, cap_per_candidate und campaign_budget; ihr weight lässt die Auswahl außerdem günstigere Kandidaten bevorzugen.
Modelle wählen
Jedes Modell, das Kapso verwendet, ist in einer Konfigurationsdatei benannt. Der mitgelieferte Standard
führt Build-Sitzungen auf claude-opus-5 aus, die Lern-Crews auf
claude-fable-5 und Codex-Rollen auf gpt-5.6-sol; der Modellzugang hängt jedoch
vom Abonnement ab (ein Tarif kann ein Modell begrenzen, während er ein anderes bedient).
Um andere Modelle zu verwenden, kopiere die mitgelieferte Konfiguration, bearbeite sie und verweise
Kapso auf deine:
from pathlib import Path
import yaml
from kapso import Kapso
from kapso.kapso import DEFAULT_CONFIG_PATH

config = yaml.safe_load(Path(DEFAULT_CONFIG_PATH).read_text())
# z. B. die Lern-Crews auf opus statt fable ausführen:
crews = yaml.safe_dump(config).replace("claude-fable-5", "claude-opus-5")
Path("kapso-config.yaml").write_text(crews)

kapso = Kapso(config="kapso-config.yaml")
Reine Text-Inferenzrollen können sich für openai_compatible Chat Completions entscheiden.
Setze Modell und Endpunkt in deiner Konfiguration; Zugangsdaten bleiben in der Umgebung.
Lade die Konfiguration mit Kapso(config=...) oder kapso build --config ....
Coding und Web-Recherche erfordern weiterhin Agenten mit den entsprechenden Werkzeugen.
Siehe das Konfigurationsbeispiel und die Einschränkungen.
Prüfe vor einem langen Lauf jedes Modell, das deine Konfiguration benennt, gegen deine tatsächlichen Abonnements: Ein Modell, das dein Login nicht bedienen kann, schlägt hier in Sekunden fehl statt Stunden nach Beginn eines Laufs. Eine Nutzungsobergrenze für ein Modell, das du bedienen kannst, ist für eine Ein-Token-Prüfung nicht sichtbar:
kapso doctor --models                            # mitgelieferte Konfiguration
kapso doctor --models --config kapso-config.yaml # deine
kapso doctor learn --models                      # nur die Lern-Crews
Um diese Prüfung zu einem Teil jedes Aufrufs zu machen statt zu etwas, an das du denken
musst, schalte sie in deiner Konfiguration ein. Sie kostet ein Wegwerf-Token pro unterschiedlichem
{cli, model}-Paar, was sich vor einem unbeaufsichtigten, mehrstündigen
learn() lohnt:
preflight:
  enabled: true            # statische Prüfungen vor jedem Verb (Standard)
  live_model_probe: true   # + Ein-Token-Modellprüfungen (Standard: false)
Modellwechsel ändern auch das Tempo: Die timeout_minutes-Obergrenzen der Crews in der
Konfiguration wurden auf den Standardmodellen kalibriert, und ein ausgetauschtes Modell, das
länger nachdenkt, braucht sie möglicherweise höher.
Ausführliche Integrationsschritte findest du in den Anleitungen Schnellstart und Installation.
Unterstützte Benchmarks
| Benchmark | Beschreibung |
|---|---|
| MLE-Bench | OpenAIs ML-Engineering-Benchmark: vollständige Wettbewerbe über Tabellen-, Bild-, Text- und Audiodaten, von Rohdaten bis zur bewerteten Einreichung |
| ALE-Bench | Sakana AIs Benchmark für algorithmische Optimierung: Wettbewerbsheuristiken über stundenlange Suchen entwerfen, implementieren und iterieren |
| RelBench | Stanfords Benchmark für prädiktives ML über relationalen Daten: Klassifikation, Regression und Empfehlung direkt aus den Datenbanken mit mehreren Tabellen von Amazon, H&M, Stack Exchange, klinischen Studien und mehr |
| IOAI 2026 | Olympiade-ML unter Zeitdruck über Bild, Sprache und Optimierung: von Experten gestellte Aufgaben, Wettbewerbshardware, keinerlei menschliche Hilfe |
Jeder Benchmark hat außerdem eine Dokumentationsseite, die beschreibt, wie man ihn ausführt, welche CLI-Optionen er hat und was die Ausgabe enthält: IOAI 2026 · MLE-Bench · ALE-Bench · RelBench
Beispiele
Jedes Beispiel ist eine Aufgabe: ein Briefing, ein Start-Repository, die Daten oder wie man sie bekommt, und ein Treiber von höchstens zwölf Zeilen; examples/README.md enthält die Minuten und den einen Befehl.
| Beispiel | Die Aufgabe |
|---|---|
| Data Engineering (dbt-Modelle auf Snowflake) | Die dbt-Modelle mit Datenqualitätsproblemen reparieren und die neuen bauen, die ein Backlog von siebzehn Tickets verlangt, auf einem Einzelhandels-Warehouse auf Snowflake, bis jedes Ticket seine Produktionstests besteht; dann pro Ticket einen Pull Request liefern und sie in die Produktion freigeben. |
| Harness-Optimierung (Kundensupport-Agent) | Den Harness eines Kundensupport-Agenten optimieren, um das zugrunde liegende LLM von Fable 5.1 auf ein lokales Qwen 27B umzustellen, ohne bei den Kundengesprächen an Lösungsquote zu verlieren, ihn dann in Docker bereitstellen und aus dem Lauf lernen. |
| Prädiktive Modellierung (Kundenabwanderung) | Vorhersagen, welche Kunden gehen werden: die Out-of-Sample-ROC-AUC eines Abwanderungsmodells in Richtung Ziel steigern, unter einem Evaluator, den die Kampagne nicht bearbeiten kann. |
| Betrugserkennung | Transaktionen auf Betrug bewerten, wenn das Repository keinen Evaluator hat: Das Briefing legt das Protokoll fest, die Kampagne baut zuerst den Evaluator und verbessert dann den Scorer. |
| Quantitative Finanzen | Eine tägliche Handelsstrategie über synthetische Instrumente: die Out-of-Sample-Sharpe-Ratio auf dem Trading-Harness steigern, mit dessen Prüfungen bei jedem Versuch. Ein Forschungsbeispiel, keine Finanzberatung. |
| Tabellarisches ML | Ein Kaggle-Wettbewerb von Anfang bis Ende: Spaceship Titanic vom Dummy-Klassifikator zu einem echten Modell, dann prüfen, lernen, mit der Lektion erneut bauen und bereitstellen. |
| PyTorch-Optimierung | Ein PyTorch-Modul auf CUDA innerhalb einer numerischen Toleranz schneller machen: Fusion, Kompilierung, weniger Speicherverkehr. |
| GPU-Kernel-Optimierung | Multi-Head-Self-Attention auf CUDA mit Flash Attention oder einem Triton-Kernel beschleunigen, innerhalb einer numerischen Toleranz. |
📚 Dokumentation & Support
- Vollständige Dokumentation: docs.leeroo.com
- Installation: die Coding-Agent-CLIs, das Paket und
kapso doctor - Schnellstart: deine erste Kampagne
- CLI-Referenz: jeder Befehl, jedes Flag und jeder Standardwert
- Python-API: jede öffentliche Methode von
Kapso - Konfiguration: jeder Schlüssel in
config.yaml - Was learn erzeugt: die Lektionsbank, jede Lektion mit einem Glaubwürdigkeitswert, einer Grenze und ihrer Evidenz, und der Entwicklungsmodus
- Intelligentes Experimentieren: der Experimentbaum und seine Module, und was innerhalb eines Experiments passiert
- Experience: deine Bank, Leeroopedia, Repositories und Paper, verwandelt in durchsuchbares Wissen
- Deploy: local, Docker, Modal und die anderen Ziele
- Das Kapso-Plugin: die Befehle, die Skills und der MCP-Server für Claude Code, Codex und Cursor
- Installation: die Coding-Agent-CLIs, das Paket und
- Aus deinem Coding-Agent heraus: Die Dokumentation betreibt einen MCP-Server unter
https://docs.leeroo.com/mcp, und jede Seite wird als Markdown ausgeliefert; siehe llms.txt und Kapso in deinem Coding-Agent.claude mcp add --transport http kapso-docs https://docs.leeroo.com/mcp # Claude Code codex mcp add kapso-docs --url https://docs.leeroo.com/mcp # Codex CLI - Lass deinen Coding-Agent Kapso ausführen: Das Plugin unter
plugin/enthält zehn Befehle, sechs Skills und den MCP-Server, eine Installationszeile pro Host (Schritt 0 oben); OpenCode lädt die Skills als Ordner (ln -s <clone>/plugin/skills .opencode/skills). Siehe Das Kapso-Plugin. - Gib deinem Coding-Agent Kapsos Wissenswerkzeuge:
kapso-mcp, mit dem Paket installiert, stellt der Sitzung, in der du arbeitest, Web-Recherche, das Gedächtnis des Repositories, die Experimenthistorie der Kampagne und die Lektionsbank zur Verfügung; siehe MCP-Gates.claude mcp add kapso -- kapso-mcp # Claude Code codex mcp add kapso -- kapso-mcp # Codex CLI; danach `startup_timeout_sec = 60` unter [mcp_servers.kapso] in ~/.codex/config.toml (Codex' zehn Sekunden sind auf einer ausgelasteten Maschine knapp) - Community: Discord
- Website: leeroo.com
Kapso für Unternehmen
Im Unternehmen werden Kapso-Agenten mit anfänglichen Harnesses für Daten- und KI-Engineering und einer Lektionsbank ausgeliefert und verwandeln geschäftliche Zielsetzungen eigenständig in funktionierende KI- und Datensysteme, indem sie die Artefakte, Repos, Pipelines, Datenquellen und mehr des Unternehmens untersuchen und dabei den Datenbestand des Unternehmens aufbauen. Um Kapso für deine Unternehmensaufgaben einzuführen, sprich mit uns.
Mitwirken
Wir freuen uns über Beiträge! Details zum Einstieg findest du in unserem Leitfaden für Mitwirkende.
Mitwirkende
Erstellt mit contrib.rocks.